LoRA微调技术深度解析
摘要
LoRA 是参数高效微调的事实标准------冻结基座、仅注入低秩可训练矩阵,把可训练参数量缩小约三个数量级,绕开全参微调的显存墙与灾难性遗忘;QLoRA 再叠加 4-bit NormalFloat 量化、双重量化与分页优化器,把 65B 模型微调显存从 780GB 以上压到 48GB 以内。完整流程通常分三个阶段:数据工程(SFT 指令集与 DPO 偏好对的构造与去噪)、SFT(负对数似然把基座变成 instruct 模型,同时也是 DPO 的参考模型)、DPO(以隐式奖励 + Bradley-Terry 目标直接做偏好对齐,通常省去奖励模型与 PPO)。本文给出各阶段损失函数、关键超参(rank/α/β/学习率)、显存构成与避坑清单,并依据 2026 年条件等价性理论指出 DPO 与 RLHF 仅在特定 misspecification 场景下等价,输出 LoRA(本地验证)/QLoRA(显存受限)/全参(指令微调标准)的选型边界。
关键词:LoRA;QLoRA;NF4;参数高效微调;SFT;DPO;偏好优化;rank 缩放;RLHF
1. 引言与问题根源
全参微调(FT)更新全部权重,单个任务即需一份完整副本,且训练时需保存权重、梯度与优化器状态三重拷贝;对 7B 级模型约需 96GB+ 显存,而多数垂直场景只有数百到数万条数据,存在显著过拟合与灾难性遗忘风险 1。PEFT 通过冻结基座、只训练极小参数量子集解决这一矛盾,其中 LoRA 是事实标准 2 8,三条技术路线的定位如图1 所示。
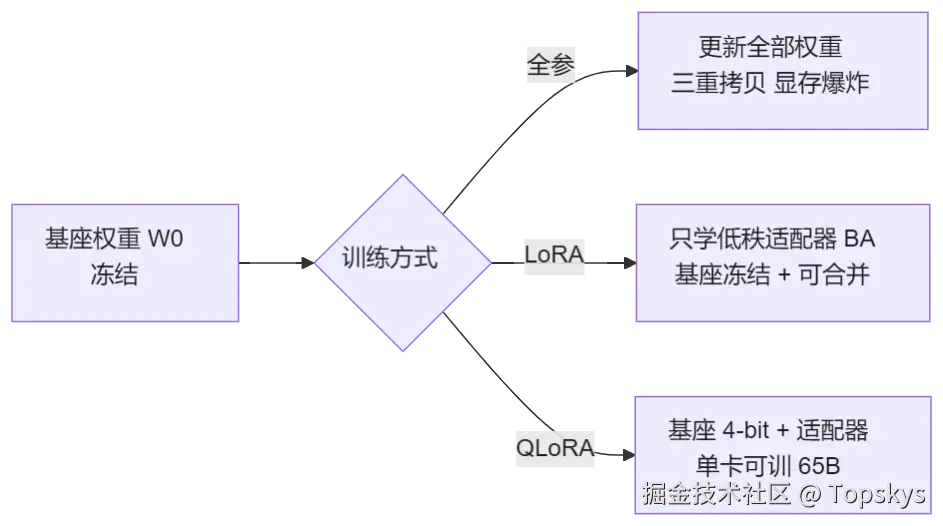
图1 LoRA 技术路线定位
2. 低秩适配的数学原理
2.1 LoRA 形式
对冻结矩阵 W0,LoRA 注入一个低秩分解 ΔW=BA(仅 A,B 可训练),前向结构如图2 所示,数学形式为:
h=W0x+rαBAx,W0∈Rd×d,B∈Rd×r,A∈Rr×d,r≪d
初始化惯例为 A 取零(或高斯、 B 取零),使初始化时刻 ΔW=0、前向与基座一致,训练中再缓慢偏离 1 2。推理期可将 W0+BA 合并回同一矩阵,零额外延迟 8。
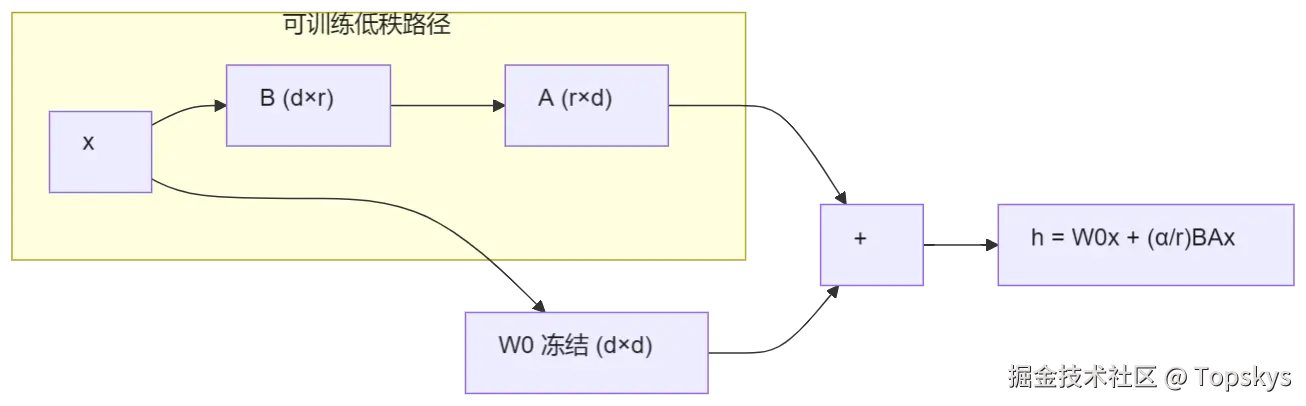
图2 LoRA 前向结构
2.2 可训练参数量与显存构成
可训练参数 = rank × (输入维 + 输出维) × 注入层数。LoRA 可将可训练参数量降低约 10000 倍 2;一份 0.5B 级适配器常仅数十 MB 2。QLoRA 进一步压缩显存:基座权重以 NF4 存储(约 4 bit/参数),梯度只随可训练的适配器计算、冻结基座无需保存梯度与优化器状态,长序列的梯度尖峰由分页优化器换出到主机内存吸收,65B 模型微调显存从全参 16-bit 的 780GB 以上压到单卡 48GB 以内 3。
2.3 缩放因子与 rsLoRA
原实现缩放因子 γr=α/r。Kalajdzievski 证明该设置会使大 rank 出现梯度塌缩,导致 rank 增大几乎无收益;修正为 rank 稳定缩放 后大 rank 才可用:
γr=r α
即 use_rslora=True 时 LoraConfig 内部按 α/r 计算缩放 4 8。
2.4 学习率与 rank 的耦合
LoRA 更新关于 A,B 双线性,初始化与 α 的选择决定最优学习率对 rank 的依赖方向:InitA( A 高斯、 B 零)+ 常数 α 时学习率应随 rank 增大而减小;InitB + 常数 α 时学习率近似 rank 不变。作者给出 μA 参数化,使学习率可在 LoRA 与全参微调之间直接迁移,省去重调 5。
3. 数据工程:全流程的地基
3.1 规模经验
微调数据缩放研究(1B--16B 模型、至多 2000 万条样本)给出乘性联合缩放律:模型规模增大收益 > 数据量增大收益 > PEFT 参数增大收益 ------LoRA/Prompt 参数规模增大对性能提升边际极小(指数 ≪1×10⁻²,某些任务甚至反向)13。结论:先扩模型、再扩数据,而非盲目加大 rank。
3.2 SFT 数据
- 形态:指令-回答对;常用套件格式 ShareGPT(多轮、带角色)、Alpaca(指令/输入/输出)、JSONL;多轮须按模型 chat template 拼接。
- 质量优先于数量:入集前做难度与去重过滤,避免低信息量样本稀释指令跟随能力;QLoRA 即在小规模高质量数据集上微调仍可达到 SOTA 3。
3.3 DPO 偏好数据
DPO 输入为三元组 (prompt, chosen, rejected) 6。构造要点:
- 候选来源:SFT 模型对同一 prompt 采 2~4 条回复,或混合人工撰写;
- 标注:领域专家评选 chosen/rejected(如资深销售按专业度与转化引导打分);
- 去噪:含标注分歧(noisy pair)的样本显著拖累 DPO;可借助 DPO 隐式奖励差 ΔrDPO=r(x,yw)−r(x,yl) 做难度选择 ------奖励差小者为难点,优先训练可提升对齐质量 15。
4. SFT 阶段
SFT 以负对数似然监督训练(训练流程如图3 所示),使基座从"原样续写"变成"按指令作答":
LSFT=−E(x,y)∼D∑tlogπθ(yt∣x,y<t)
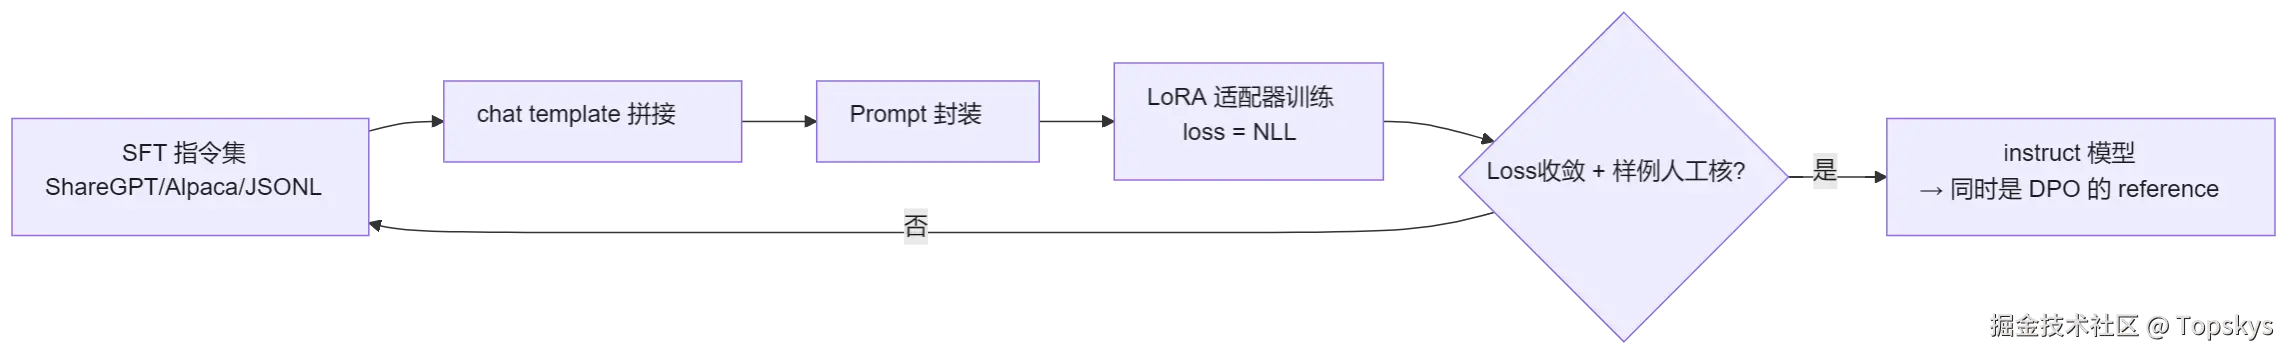
图3 SFT 训练流程
超参经验:学习率 10−5~ 4×10⁻⁴(本地验证取高、量产取低防过拟合);epochs 13;rank 8 64;lora_alpha 常设为 2×rank;target_modules 覆盖注意力(q/k/v/o)与 MLP 门控/输出投影 7 8。SFT 产物即 DPO 的参考模型 πref(冻结)与策略模型 πθ 的共同起点。
5. DPO 阶段
5.1 动机
RLHF 需要先训奖励模型再用 PPO 走在线强化循环:结构复杂、超参敏感、计算昂贵。DPO 把奖励函数重参数化为策略与参考策略的对数比,直接在对偏好数据上优化,省去奖励模型与 RL 回路 9 11。
5.2 形式推导
DPO 的隐式奖励: rθ(x,y)=βlogπref(y∣x)πθ(y∣x)+βlogZ(x)( Z 为分配函数,与 y 无关)9 11。将该奖励代入 Bradley-Terry 模型:
p(yw≻yl∣x)=σ(r(x,yw)−r(x,yl))
分配函数互相抵消,得到 DPO 目标如下,整体训练结构与数据流如图4 所示:
LDPO(πθ;πref)=−E(x,yw,yl)∼Dlogσ(βlogπref(yw∣x)πθ(yw∣x)−βlogπref(yl∣x)πθ(yl∣x))
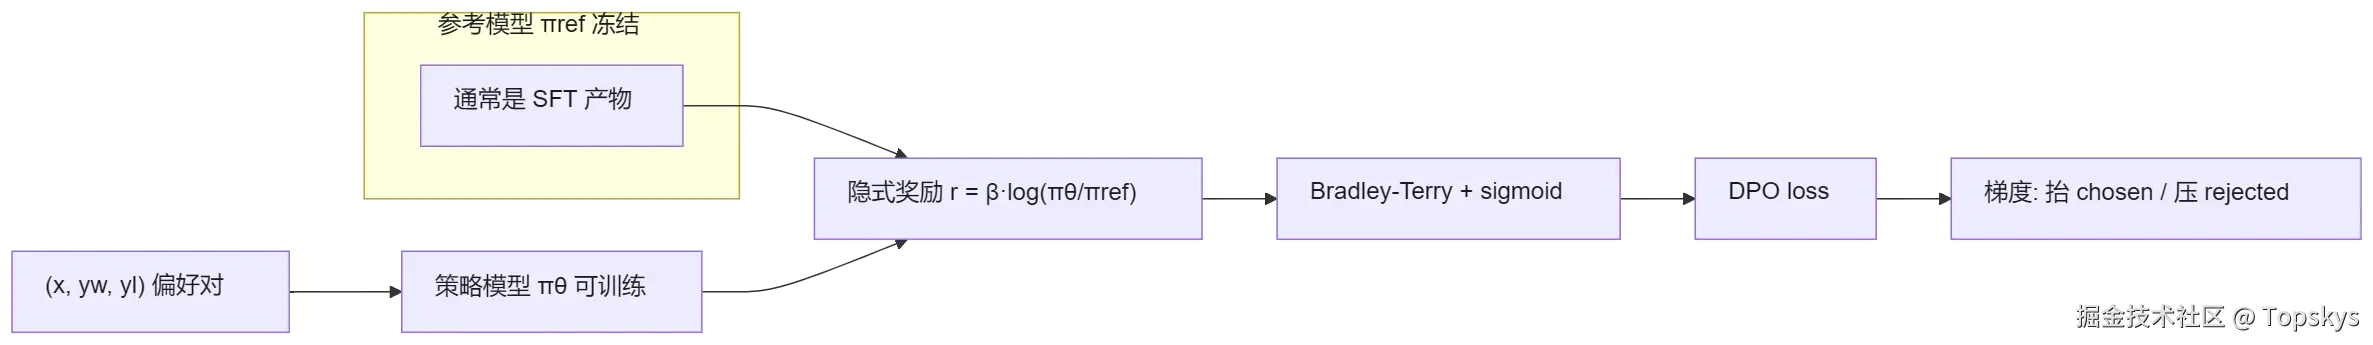
图4 DPO 训练结构与数据流
5.3 关键实操
- reference model 必须冻结 :作为基线约束策略不漂移;TRL 未提供时自动复制一份同构模型 6。
- β 温度系数 :控制偏离参考模型的程度,β 越大 KL 约束越强、偏离越小;常见范围 0.1~0.5 ;β→0 时参考模型作用趋近于零 6 10。
- NLL 项 :纯 DPO 存在 chosen 与 rejected 似然同时下滑的失效模式,添加 SFT 负对数似然项(
DPO + NLL)后输出更均衡,是目前主流推荐组合 10。 - 监控指标 :
rewards/chosen、rewards/rejected、accuracies(chosen>rejected 的比例)、margins------margin 单调增长且 accuracy 上升是健康信号;chosen/rejected 双降提示需要 NLL 项或数据去噪 6。
5.4 DPO、RLHF 与选择边界
2026 年的理论二分明确:DPO 与 RLHF 并非无条件等价 ,四情形下胜负反转 11:
表1 DPO 与 RLHF 的四情形胜负
| 场景 | RLHF | DPO / 在线 DPO |
|---|---|---|
| 无模型 misspec | 等价 | 等价(在线 DPO 可加速收敛) |
| 策略模型 misspec | 优(数据效率更高) | 可能次优 |
| 奖励模型 misspec | 可能次优(奖励建模误差) | 优(直接拟合偏好) |
| 双 misspec 且同构 | --- | 在线 DPO 可双双超越 |
当"RLHF 最优策略不偏好人类首选"这一隐含假设被违反时,DPO 会优化出病态收敛(降低 DPO loss 却偏好 rejected),CPO 通过给 RLHF 加约束来保证可证明对齐 12。工程选型:偏好数据充足且只关心结果 → DPO;需要严格可证明对齐或对数据效率敏感 → RLHF/CPO。另有 SimPO(免参考模型、按序列平均对数概率 + 目标奖励余量 γ)等免参考实现可省显存与计算 14。
6. 全流程串联
全流程按「数据工程 → SFT → 候选生成与专家标注 → DPO + NLL → 评测门禁」五步串联,如图5 所示:
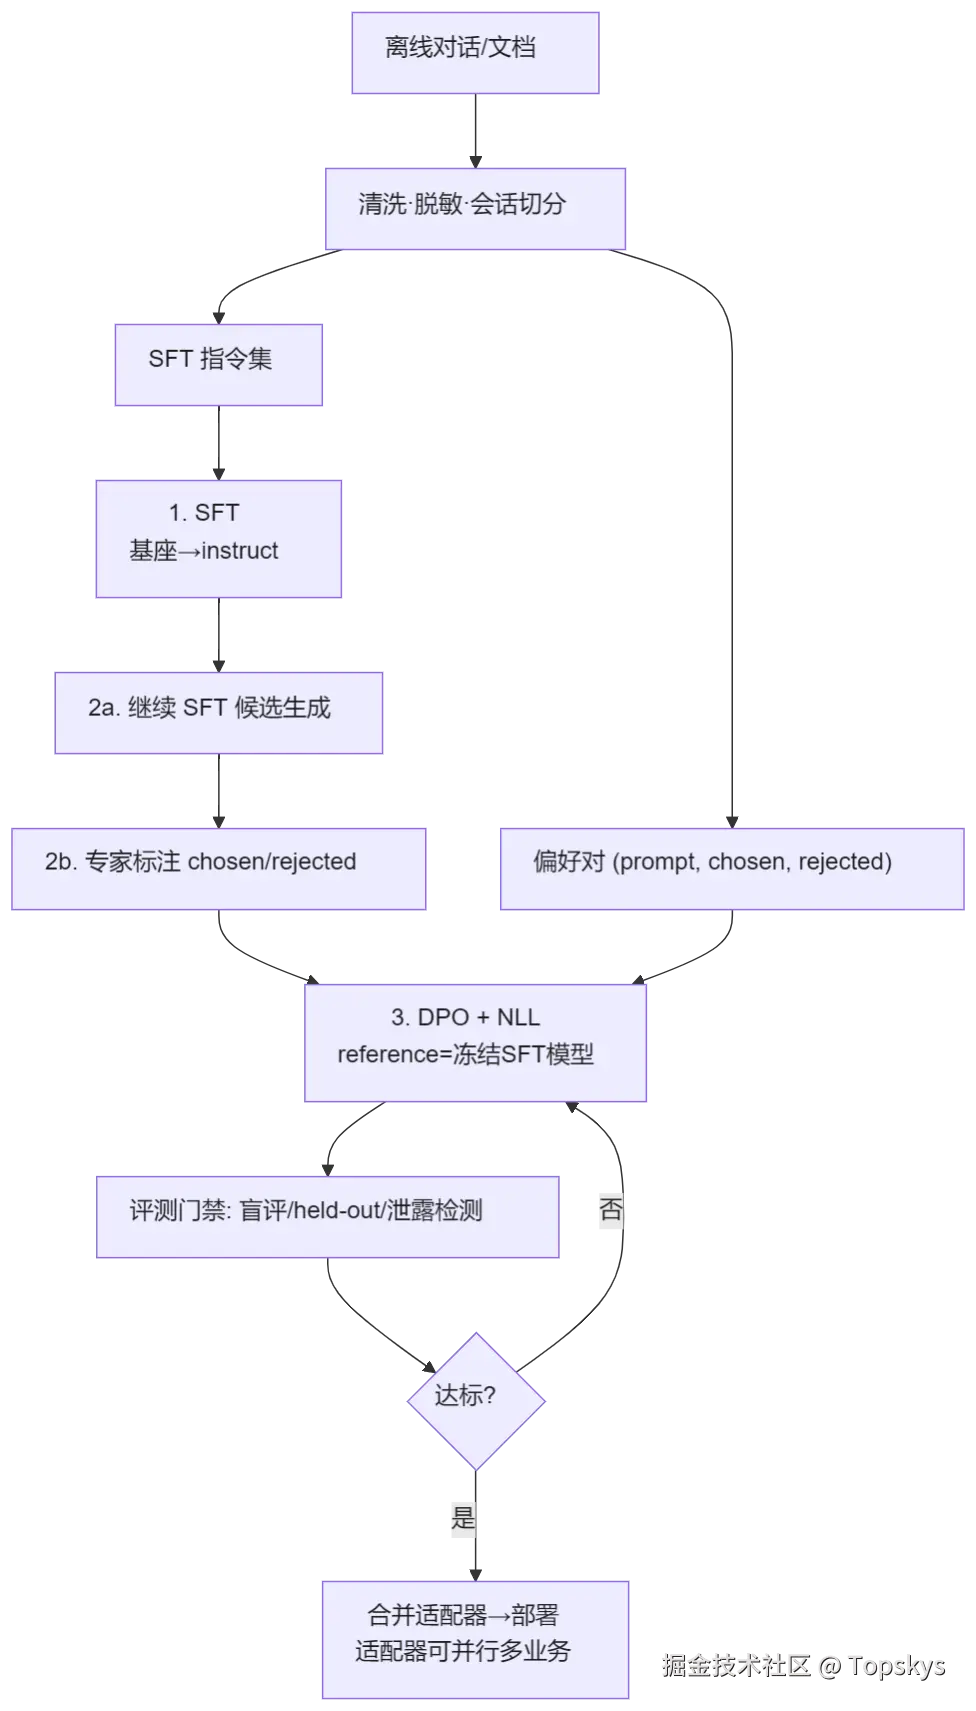
图5 LoRA 微调全流程
值得强调:推理时适配器可合并进基座(零延迟),也可不合并以服务端加载、一份基座切换多业务适配器 ,这正是垂直场景低成本复用模型的根本优势 2 8。
7. 工程实现:普通 LoRA 与 QLoRA 双方案代码(Agent 工具调用场景)
以"Agent 需输出 JSON 工具调用"这一典型垂类(查询天气 → 输出 {"name":"get_weather","params":{...}})为示例,给出基于 trl + peft 的原生双方案实现 18。核心思想:SFT/DPO 训练逻辑完全一致,仅基座加载方式不同(FP16 冻结 vs 4bit NF4 量化冻结),产出 LoRA 适配器格式相同、Merge/推理代码完全通用。
7.1 公共配置
普通 LoRA 与 QLoRA 共用同一份 LoraConfig,仅 QLoRA 额外套用 BitsAndBytesConfig 18:
python
lora_config = LoraConfig(r=16, lora_alpha=16,
    target_modules=["q_proj", "v_proj"], lora_dropout=0.05,
    bias="none", task_type="CAUSAL_LM")
tokenizer.pad_token = tokenizer.eos_token     # 必须:CausalLM 训练需要 pad
tokenizer.padding_side = "right"

bnb_config = BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16, bnb_4bit_use_double_quant=True)  # 仅 QLoRA 使用
注:此示例
lora_alpha=16(=r)且target_modules仅 q/v,属精简场景配置;通用实践可增大 r 至 32~64、α 取 2r、覆盖更多投影层,按 2.4 节注意与学习率的耦合 7 18。
7.2 数据格式与预处理
SFT 用 ShareGPT 风格多轮对话;DPO 用三元组,chosen 为正确工具调用、rejected 为"闲聊式"错答,可防模型把工具调用学成对话 18:
json
{"conversations": [{"role":"system","content":"你是工具调用Agent,需要调用工具时输出JSON"},
                   {"role":"user","content":"查询深圳天气"},
                   {"role":"assistant","content":"{\"name\":\"get_weather\",\"params\":{\"city\":\"深圳\"}}"}]}
{"prompt":"查询深圳天气","chosen":"{\"name\":\"get_weather\",...}","rejected":"深圳今天晴天。"}
7.3 两方案统一训练代码骨架
表2 普通 LoRA 与 QLoRA 统一训练骨架
| 阶段 | 普通 LoRA(FP16) | QLoRA(4bit NF4) |
|---|---|---|
| 基座加载 | AutoModelForCausalLM.from_pretrained(..., torch_dtype=float16, device_map="auto") |
追加 quantization_config=bnb_config |
| SFT | get_peft_model(model, lora_config) → SFTTrainer;lr=2e-4、epochs=2、fp16=True、optim="adamw_torch" |
同左;bf16=True、optim="paged_adamw_8bit" |
| DPO | PeftModel.from_pretrained(base, SFT_LORA_OUT) 挂载 SFT 适配器 → DPOTrainer(beta=0.1, lr=1e-4, epochs=1) |
同左;仅基座为量化加载 |
| 显存 | 7B 约 13G+ | 7B 单卡约 10G |
关键点:DPO 阶段不再从零训练 ,而是把 SFT 产出的 LoRA 适配器经 PeftModel.from_pretrained 挂到冻结基座上继续偏好对齐;DPOTrainer 的 ref_model=None 时自动克隆当前模型为参考策略。QLoRA 必须安装 bitsandbytes,普通 LoRA 不需要 18。
7.4 部署与评估
- Merge :
model.merge_and_unload()把适配器并入基座(不可逆),两种方案代码根本一致; - 免 Merge 部署 :基座 +
PeftModel热加载任意适配器,一份基座多业务;生产可用 vLLM LoRA 热插拔; - 评估 :工具调用场景用两把尺 ------ JSON 合法率(
json.loads硬指标)+ LLM-as-judge 语义评分;先过前者再过后者 18; - 排查顺序:数据 → 超参 → 配置 → loss → badcase,避免一上来调 rank。
8. 工程要点与避坑指南
8.1 显存与速度
- QLoRA 三大件:NF4 (信息论最优的 4-bit 正态量化)、Double Quantization (二次量化量化常数,每参数再省约 0.373 bit)、Paged Optimizers (NVIDIA 统一内存吸收长序列梯度尖峰)3。
- QLoRA 省显存但每步都需反量化 4-bit 权重,训练更慢 ;AQLoRA 用零搜索 CPU 遍历,按块重建误差只把最受损层回存 fp16,可换回约 5~11% 速度 17。
8.2 数据与安全
- 训练/评测/偏好对三集严格隔离,避免 benchmark 泄漏;
- 对话数据含手机号、定价、内部编码等,须在入参与导出两处脱敏,防止模型背出敏感字段;
- held-out 集监控遗忘:LoRA 只动少量参数、遗忘通常轻于全参,但仍需抽样复核。
8.3 常见误区
- α 越大越好、rank 越大越好:缩放实验显示 PEFT 参数规模收益封顶,优先扩模型与数据 13;rank 与 lr 耦合需按 2.4 节重调 5;
- DPO 结果不佳先怀疑超参:先查数据噪声、样本难度分布 15 与 NLL 项,再动 β;
- β→0 当免参考用:会丢 KL 约束,退化为接近 SimPO 但未做长度归一,反而不稳 6 14。
9. 演进与变体
表3 LoRA 与偏好优化变体一览
| 变体 | 一句话定位 | 关键技术点 | 来源 |
|---|---|---|---|
| rsLoRA | 修正缩放因子 | 缩放 α/r ,大 rank 可用 | [4](#变体 一句话定位 关键技术点 来源 rsLoRA 修正缩放因子 缩放 α/r \alpha/\sqrt{r} α/r ,大 rank 可用 [4] QLoRA 显存版 LoRA NF4 + 双重量化 + 分页优化器 [3] TTL/TPO 拓扑增强对齐 SFT 加轨迹拓扑损失、DPO 换拓扑偏好优化 [16] SimPO 免参考 DPO 平均对数概率奖励 + 目标余量 γ [14] IPO 校准与抗噪 二次目标替换 sigmoid [11] CPO 可证明对齐 约束 RLHF,修复 DPO 假设失效 [12] 在线 DPO 在线数据采样 策略自身采样偏好对,双 misspec 反超 [11] "#ref-4") |
| QLoRA | 显存版 LoRA | NF4 + 双重量化 + 分页优化器 | [3](#变体 一句话定位 关键技术点 来源 rsLoRA 修正缩放因子 缩放 α/r \alpha/\sqrt{r} α/r ,大 rank 可用 [4] QLoRA 显存版 LoRA NF4 + 双重量化 + 分页优化器 [3] TTL/TPO 拓扑增强对齐 SFT 加轨迹拓扑损失、DPO 换拓扑偏好优化 [16] SimPO 免参考 DPO 平均对数概率奖励 + 目标余量 γ [14] IPO 校准与抗噪 二次目标替换 sigmoid [11] CPO 可证明对齐 约束 RLHF,修复 DPO 假设失效 [12] 在线 DPO 在线数据采样 策略自身采样偏好对,双 misspec 反超 [11] "#ref-3") |
| TTL/TPO | 拓扑增强对齐 | SFT 加轨迹拓扑损失、DPO 换拓扑偏好优化 | [16](#变体 一句话定位 关键技术点 来源 rsLoRA 修正缩放因子 缩放 α/r \alpha/\sqrt{r} α/r ,大 rank 可用 [4] QLoRA 显存版 LoRA NF4 + 双重量化 + 分页优化器 [3] TTL/TPO 拓扑增强对齐 SFT 加轨迹拓扑损失、DPO 换拓扑偏好优化 [16] SimPO 免参考 DPO 平均对数概率奖励 + 目标余量 γ [14] IPO 校准与抗噪 二次目标替换 sigmoid [11] CPO 可证明对齐 约束 RLHF,修复 DPO 假设失效 [12] 在线 DPO 在线数据采样 策略自身采样偏好对,双 misspec 反超 [11] "#ref-16") |
| SimPO | 免参考 DPO | 平均对数概率奖励 + 目标余量 γ | [14](#变体 一句话定位 关键技术点 来源 rsLoRA 修正缩放因子 缩放 α/r \alpha/\sqrt{r} α/r ,大 rank 可用 [4] QLoRA 显存版 LoRA NF4 + 双重量化 + 分页优化器 [3] TTL/TPO 拓扑增强对齐 SFT 加轨迹拓扑损失、DPO 换拓扑偏好优化 [16] SimPO 免参考 DPO 平均对数概率奖励 + 目标余量 γ [14] IPO 校准与抗噪 二次目标替换 sigmoid [11] CPO 可证明对齐 约束 RLHF,修复 DPO 假设失效 [12] 在线 DPO 在线数据采样 策略自身采样偏好对,双 misspec 反超 [11] "#ref-14") |
| IPO | 校准与抗噪 | 二次目标替换 sigmoid | [11](#变体 一句话定位 关键技术点 来源 rsLoRA 修正缩放因子 缩放 α/r \alpha/\sqrt{r} α/r ,大 rank 可用 [4] QLoRA 显存版 LoRA NF4 + 双重量化 + 分页优化器 [3] TTL/TPO 拓扑增强对齐 SFT 加轨迹拓扑损失、DPO 换拓扑偏好优化 [16] SimPO 免参考 DPO 平均对数概率奖励 + 目标余量 γ [14] IPO 校准与抗噪 二次目标替换 sigmoid [11] CPO 可证明对齐 约束 RLHF,修复 DPO 假设失效 [12] 在线 DPO 在线数据采样 策略自身采样偏好对,双 misspec 反超 [11] "#ref-11") |
| CPO | 可证明对齐 | 约束 RLHF,修复 DPO 假设失效 | [12](#变体 一句话定位 关键技术点 来源 rsLoRA 修正缩放因子 缩放 α/r \alpha/\sqrt{r} α/r ,大 rank 可用 [4] QLoRA 显存版 LoRA NF4 + 双重量化 + 分页优化器 [3] TTL/TPO 拓扑增强对齐 SFT 加轨迹拓扑损失、DPO 换拓扑偏好优化 [16] SimPO 免参考 DPO 平均对数概率奖励 + 目标余量 γ [14] IPO 校准与抗噪 二次目标替换 sigmoid [11] CPO 可证明对齐 约束 RLHF,修复 DPO 假设失效 [12] 在线 DPO 在线数据采样 策略自身采样偏好对,双 misspec 反超 [11] "#ref-12") |
| 在线 DPO | 在线数据采样 | 策略自身采样偏好对,双 misspec 反超 | [11](#变体 一句话定位 关键技术点 来源 rsLoRA 修正缩放因子 缩放 α/r \alpha/\sqrt{r} α/r ,大 rank 可用 [4] QLoRA 显存版 LoRA NF4 + 双重量化 + 分页优化器 [3] TTL/TPO 拓扑增强对齐 SFT 加轨迹拓扑损失、DPO 换拓扑偏好优化 [16] SimPO 免参考 DPO 平均对数概率奖励 + 目标余量 γ [14] IPO 校准与抗噪 二次目标替换 sigmoid [11] CPO 可证明对齐 约束 RLHF,修复 DPO 假设失效 [12] 在线 DPO 在线数据采样 策略自身采样偏好对,双 misspec 反超 [11] "#ref-11") |
10. 相关文档
- QLoRA与LoRA微调:本仓库电商微调落地页
- 微调与RAG分工:微调"怎么说"与 RAG"知道什么"的分工
- ModelForge-AI:本地验证 + 云端量产两阶段工程案例
- 上下文爆炸治理方案对比:上下文治理与微调对照
11. 参考文献
1 E. J. Hu et al. "LoRA: Low-Rank Adaptation of Large Language Models." ICLR , 2022.\ 2 K. Nishant. "Fine-tuning large language models (LLMs) in 2026." Medium , 2025.\ 3 T. Dettmers et al. "QLoRA: Efficient Finetuning of Quantized LLMs." NeurIPS , 2023.\ 4 D. Kalajdzievski. "A Rank Stabilization Scaling Factor for Fine-Tuning with LoRA." arXiv:2312.03732 , 2023.\ 5 N. Chen et al. "Learning Rate Scaling across LoRA Ranks and Transfer to Full Finetuning." arXiv:2602.06204 , 2026.\ 6 Hugging Face. "DPO Trainer." TRL Documentation , 2024.\ 7 Unsloth. "LoRA fine-tuning Hyperparameters Guide." Unsloth Documentation , 2025.\ 8 Hugging Face. "PEFT - LoRA." PEFT Documentation , 2024.\ 9 R. Rafailov et al. "Direct Preference Optimization: Your Language Model is Secretly a Reward Model." NeurIPS , 2023.\ 10 AgileRL. "LLM Fine-Tuning with SFT and DPO." AgileRL Tutorials , 2024.\ 11 R. Shi et al. "Understanding the Performance Gap in Preference Learning: A Dichotomy of RLHF and DPO." ICML , 2026.\ 12 Z. Yang et al. "Conditional Equivalence of DPO and RLHF: Implicit Assumption, Failure Modes, and Provable Alignment." ICML , 2026.\ 13 H. Liu et al. "When Scaling Meets LLM Finetuning: The Effect of Data, Model and Finetuning Method." ICLR , 2024.\ 14 Y. Meng et al. "SimPO: Simple Preference Optimization with a Reference-Free Reward." NeurIPS , 2024.\ 15 X. Qi et al. "Difficulty-Based Preference Data Selection by DPO Implicit Reward Gap."([arxiv.org/abs/2508.04...](https://link.juejin.cn?target=https%3A%2F%2Farxiv.org%2Fabs%2F2508.04149 "https://arxiv.org/abs/2508.04149")) *arXiv:2508.04149* , 2025.\\ [](https://link.juejin.cn?target= "")\[16 Y. Pan et al. "Topology-Enhanced Alignment for LLMs: Trajectory Topology Loss and Topological Preference Optimization." Findings of ACL , 2026.\ 17 M. R. Islam. "AQLoRA: A Zero-Search Recipe for Fast Quantized LoRA Fine-Tuning." arXiv:2608.23816 , 2026.\ 18 豆包. "普通LoRA与QLoRA的SFT-DPO双方案全流程." 豆包对话, 2026.