摘要
本文提出一种将 APK mmap 增长从 VMA 级下钻到 APK entry / DEX 结构级的归因方法。方法利用:
-
smaps 中的 offset 字段建立 VMA 到 APK 文件偏移的线性关系;
-
/proc/pid/pagemap 的 present 位判断 page 是否驻留;
-
ZIP 格式解析 APK entry 边界;
-
DEX 结构解析判断驻留 page 属于哪个 DEX 结构、类、方法或字符串。
最终输出测试前后新增驻留 page 在 APK entry / DEX 结构上的分布。 其中,pagemap 给出的是 RSS / 驻留页口径;PSS 需结合 smaps,按 VMA 比例估算
一、背景与问题
SystemUI 进程的内存分析工作中,常见如下分析场景:设备开机完成后解锁并静置5分钟,采集进程的meminfo与smaps数据;执行特定测试脚本;测试结束后再次静置5分钟并采集相同数据。对比前后两组数据,发现SystemUI.apk多段映射的PSS增量合计10MB,问题随之而来,这部分增量具体由APK内部哪段代码或者资源引起,以及如何针对性的优化。
现有分析手段在粒度上存在限制。showmap -v与 smaps仅提供VMA(Virtual Memory Area)级别的统计信息,能够确认"SystemUI.apk文件映射整体增长10MB",但是无法进一步定位至APK内部结构。APK本质为ZIP容器,内部也包含了多个DEX文件,资源,SO库文件以及ARSC等多种 entry。VMA级粒度无法反映其内部组成,而meminfo粒度更粗,仅能到较大的类别。该问题的核心难点在于:APK内部具体哪一段代码或者资源的加载导致mmap区增加,现有的手段无法直接回答。
smaps中的offset 字段为该问题提供了分析入口。典型的映射行如下:
bash
73722b9000-7372846000 r--p 00a3a000 fe:02 197 /system_ext/priv-app/SystemUI/SystemUI.apk与APK mmap定位相关的核心字段说明如下:
| 字段 | 含义 | 本文意义 |
|---|---|---|
| RSS | 驻留物理内存(独占+共享) | 实际占用 |
| PSS | 比例均摊后占用 | 优化关注的核心数据指标 |
| Private_Clean | 未被修改的私有页面大小 | APK mmap 多为该类型 |
| Referenced | 最近访问过的页面 | 驻留依据 |
| offset | 文件偏移量 | 本文解决思路成立的关键字段 |
| path | 映射来源 | 文件路径 |
offset 字段建立了虚拟地址空间到APK 文件偏移的对应关系,是后续归因方法成立的几何基础。其余字段(Anonymous,Swap,THP,HugeTLB)等于APK mmap的定位关联度较低,本文不展开讲述。
本文提出一种基于 /proc/pid/pagemap 与 DEX 文件结构联合分析的归因方法,将 VMA 级粒度下探至字节级,用于回答"APK mmap 区增长的具体构成"这一问题。
二、适用条件与前提
2.1 适用条件
-
APK entry 必须为非压缩存储: 需逐 entry 检查 ZIP_STORED。 若 entry 为 Deflate,mmap 的是压缩数据,虚拟地址到未压缩 DEX 结构不再保持线性对应,方法失效。
-
具备 root 或 CAP_SYS_ADMIN 权限: 读取 /proc/pid/pagemap 通常需要 root。Android 上还可能受 SELinux 限制。 无权限时 PFN 可能为 0,present 位不可靠,甚至直接读取失败。
-
APK entry 偏移可解析: ZIP 格式原生支持。需注意本地文件头不是 data 起始,需加 30 + name_len + extra_len。
-
目标 VMA 为文件线性映射: smaps 中 offset 对应 APK 文件偏移。
-
目标 APK 未加固、未运行时解密 DEX: 若 DEX 被壳加密或动态加载,文件偏移与内存结构不一致,方法不适用。
2.2 三块理论基础
方法成立依赖以下三个基础:
- 基础1:APK的smaps映射为文件线性映射,offset字段对应APK文件偏移。
- 基础2:APK内每个entry(DEX,RES,SO,ARSC)的文件偏移可由ZIP格式解析得到。
- 基础3 :
/proc/pid/pagemap提供page级驻留信息,bit63表示物理驻留状态。
三块基础各自提供的信息:
- pagemap 提供4KB page的物理驻留状态
- APK entry偏移提供 Dex、Res、so等在APK文件内的位置
- Dex 结构提供DEX内每个字节所属的结构类型(STRING、METHOD、CLASS等)
任一基础缺失,方法链路无法闭环-- 没有pagemap无法知晓哪些page真正驻留,没有entry偏移无法判断page归属哪个文件,没有DEX 结构无法判断page内存字节归属哪个结构。
三、理论原理
3.1 线性映射关系
smaps 一行映射的几何含义为:
sql
start - end r--p offset path该VMA对应APK文件区间[offset,offset + (end - start))的线性映射。已知page在VMA内的位置,加上VMA的offset,即可计算该page对应APK文件内的偏移。线性映射将"虚拟地址空间"与"APK文件"两个独立的坐标统一为同一参照系 ------ VMA中的第N个page,对应APK文件内偏移为offset + N * 4096 至 offset + (N + 1) * 4096的字节区间。
3.2 完整链路
rust
page 在VMA内的位置
  -> 加上VMA的offset
  -> page对应APK文件内的位置
  -> 落入某个entry(DEX/RES/SO/ARSC)
  -> 若为DEX entry,按DEX结构解析
  -> 得到该驻留page内存字节所属类/方法
链路各环节的执行步骤:
- 从smaps解析VMA的start、end、offset、path
- 读取该段VMA对应的pagemap,得到驻留page集合
- 对每个驻留page计算APK文件偏移(VMA offset + page在VMA内的位置)
- 通过APK entry偏移表定位所属entry
- 若为DEX entry,根据字节级解析结果统计该page内驻留的结构
- 汇总所有驻留page,得到各DEX结构,各entry,各类,方法的驻留字节数
任一环节缺失则链路无法闭环。
3.3 三轴对齐示意
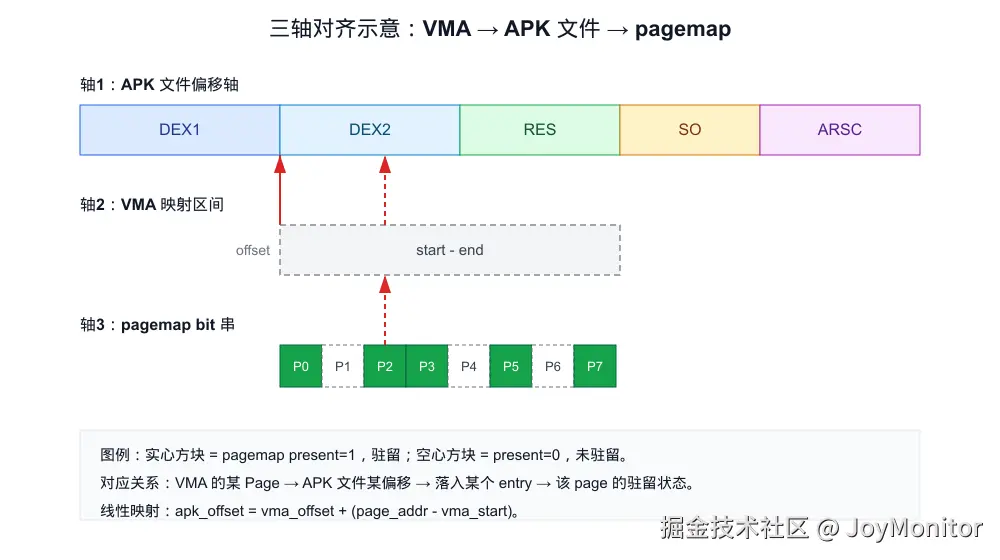 三条横向平行轴自上而下排列:
- 轴1: APK 文件偏移轴,标注entry边界(DEX1、DEX2、RES、SO、ARSC)
- 轴2: VMA 映射区间,标注 start -end 与offset ,以箭头标示对应 APK 文件内的位置
- 轴3: pagemap bit串,present =1 时的page 以实心方块表示,present =0 以空心方块表示
三轴横向对齐,箭头标示对应关系:VMA的某Page ->APK 文件某偏移 -> 落入某个entry -> 该page的驻留状态。该图直观呈现线性映射作为粘合剂的作用。
3.4 几何基础总结
已知page在VMA内的位置与VMA的offset,可反推page在APK文件内的位置。该线性对应关系是整个归因方法的几何基础,也是后续所有归因分析的起点。
四、pagemap与 DEX 结构说明
4.1 pagemap 接口
Linux 内核为每个进程提供/proc/pid/pagemap伪文件,按页序记录每个page的物理映射状态。该接口提供比smaps更细一档的page级粒度信息。
关键属性:
- 每个page由 8字节(64 bit)表示
- 第N个8字节对应第N个page,page序号等于虚拟地址除以4096
- bit63 为present位,1 表示该page驻留物理内存,0 表示未驻留(swapped或者unmapped)
- bit0-bit55为物理页帧号(PFN),普通用户不可读。
单page读取:
- page 序号
N = vaddr / 4096 dd if=/proc/pid/pagemap bs=8 skip=N count=1- 检查返回8字节的bit63
VMA 批量读取:
- page 起点
start_N =vma_start / 4096 - page 数
count = (vma_end -vma_start)/ 4096 dd if=/proc/pid/pagemap bs=8 skip=start_N count=count- 遍历返回字节流,每8字节检查bit63,构造驻留page集合。
权限要求:读取需要root权限
实现注意事项:
- adb shell 二进制传输存在乱码问题,需要通过
| base64编码后传输至PC端解码 - 单 page读取方式在大VMA上存在严重的性能问题(逐page读取较批量读取慢约1000倍),SystemUI 单个 VMA可能包含数万个page,必须采用批量读取。
4.2 DEX 文件结构
DEX文件布局:
scss
header (0x70)
string_ids (4B/项)
type_ids (4B/项)
proto_ids (12B/项)
field_ids (8B/项)
method_ids (8B/项)
class_defs (32B/项)
data(string_data/code_item/class_data/map_list, 变长)
header 偏移表关键段:
| 偏移 | 字段 | 含义 |
|---|---|---|
| 0x34 | map_off | map_list 偏移 |
| 0x38 | string_ids_size | 字符串表项数 |
| 0x3C | string_ids_off | 字符串表偏移 |
| 0x40 | type_ids_size | 类型表项数 |
| 0x44 | type_ids_off | 类型表偏移 |
| 0x48 | proto_ids_size | 原型表项数 |
| 0x4C | proto_ids_off | 原型表项偏移 |
| 0x50 | field_ids_size | 字段表项数 |
| 0x54 | field_ids_off | 字段表偏移 |
| 0x58 | method_ids_size | 方法表项数 |
| 0x5C | method_ids_off | 方法表偏移 |
| 0x60 | class_defs_size | 类定义项数 |
| 0x64 | class_defs_off | 类定义偏移 |
字节解析核心段(部分):
| 段名 | 每项大小 | 内容 | 标签 |
|---|---|---|---|
| string_ids | 4B | 字符串数据偏移指针 | STRING_ID |
| method_ids | 8B | 方法定义 | METHOD_ID |
| class_defs | 32B | 类定义 | CLASS_DEF |
| code_item | 变长 | 方法字节码 | METHOD |
| class_data | 变长 | 类的字段/方法列表 | CLASS_DATA |
| string_data | 变长 | 字符串实际内容 | STRING |
定长段(string_ids,method_ids,class_defs)按 item size 直接遍历,变长段(code_item,class_data,string_data)需要单独解码ULEB128与MUTF8编码。
4.3 DEX header 偏移表示意
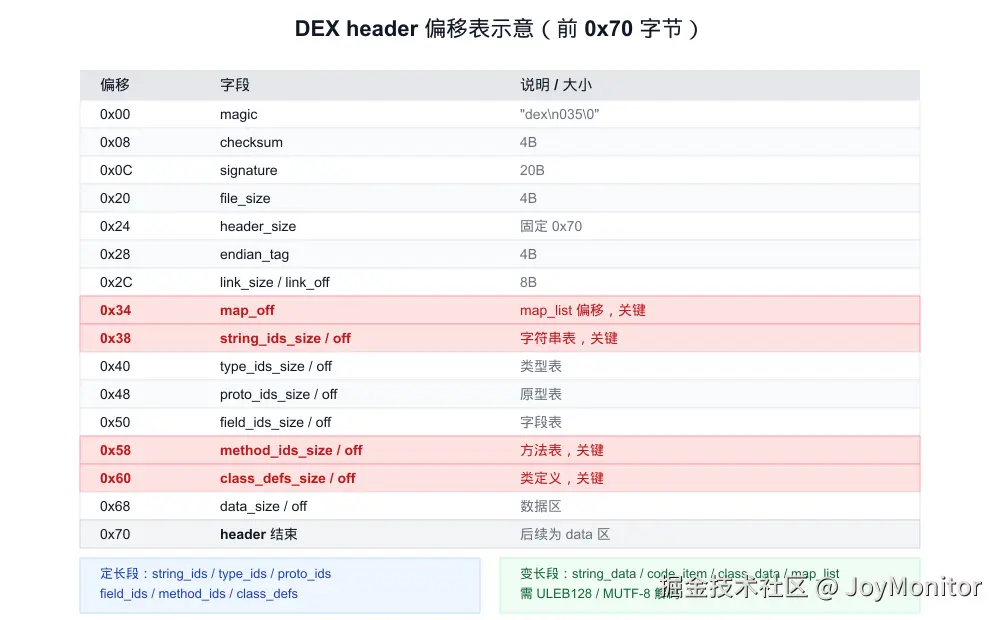
标红段为解析核心,下方标注每项大小与对应的标签,并区分定长段与变长段。
4.4 pagemap bit 串示意
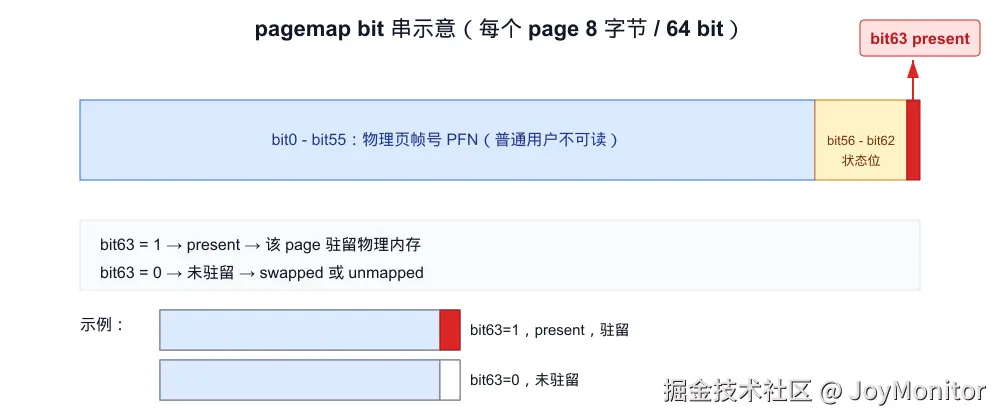
8字节方块(64 bit),从bit0到bit63:
- bit0 - bit55 :物理页帧号 (PFN,普通用户不可读)
- bit56 - bit62:状态位(soft_dirty,swapped等)
- bit63 :present(高亮),1表示驻留,0表示未驻留
4.5 解析流程
- 读取header,获取各段offset 与 size
- 按段遍历,对每个字节区间打
(类别,名称)标签 - 定长段按 item size 遍历
- 变长段特殊处理:code_item(16B头 + 字节码)、class_data(ULEB128编码)、string_data(MUTF8编码)
- 实现建议使用 androguard 或者 dexdump,自实现容易在ULEB128边界处理出错
五、实现细节
5.1 pagemap 批量读取
按page顺序读取8字节并检查bit63,实现需处理两个工程问题:adb shell二进制传输乱码 和大VMA性能
python
import subprocess,base64,struct

PAGE = 4096

def read_pagemap(pid,vma_start,vma_end):
  """ 批量读取一段VMA的pagemap,返回驻留page起始地址集合"""
  page_start = vma_start // PAGE
  count = (vma_end - vma_start + PAGE - 1) // PAGE
  # dd 一次性读取整段,base64编码规避adb shell 二进制传输乱码
  cmd = f"dd if=/proc/{pid}/pagemap bs=8 skip={page_start} count={count} 2>/dev/null | base64"
  b64 = subprocess.check_output(f'adb shell "{cmd}"',shell=True).decode().strip()
  data = base64.b64decode(b64)
  pages = set()
  for i in range(count):
    if i * 8 + 8 > len(data):
      break # pagemap读取不完整,截断处理
    entry = struct.unpack_from("<Q",data,i * 8)[0]
    if (entry >> 63) & 1: # bit63 = present
      pages.add(vma_start + i * PAGE)
  return pages
base64 编码用于规避adb shell二进制传输乱码问题;批量读取避免逐page读取的性能损耗
5.2 APK entry 解析
APK 为 ZIP格式,每个entry的data起始位置不等于header_offset,需要加上30字节的固定头与name_len,extra_len。这是ZIP本地文件头的固定结构。
python
import zipfile,struct

def get_apk_entry_offsets(apk_path):
  """解析apk内每个entry的data起始与结束偏移"""
  entries = {}
  with zipfile.ZipFile(apk_path) as z:
    for info in z.infolist():
      # zip 本地文件头:30B固定 + name_len + extra_len 后为data起始
      with open(apk_path,'rb') as f:
        f.seek(info.header_offset + 26)
        name_len,extra_len = struct.unpack("<HH",f.read(4))
        data_start = info.header_offset + 30 + name_len + extra_len
      # 按文件名识别entry类别
      if info.filename.startswith("classes") and info.filename.endswith(".dex"):
        t = "DEX"
      elif info.filename == "resources.arsc":
        t = "ARSC"
      elif info.filename.endswith(".so"):
        t = "SO"
      elif info.filename.startswith("res/"):
        t = "RES"
      elif info.filename.startswith("assets/"):
        t = "ASSETS"
      else:
        t = "OTHER"
      entries[info.filename] = {"type":t,
                                "data_start":data_start,
                                "data_end":data_start + info.compress_size,
                                "stored":info.compress_type == zipfile.ZIP_STORED}
  return entries
注意:header_offset为zip本地文件头起始,非data起始,差值为 30 + name_len + extra_len。直接用header_offset作为data_start 会导致整体偏移。
5.3 DEX 字节打标记
建议基于 map_list 遍历所有 item,或使用 androguard
简单示例:
python
import struct
from collections import Counter

def build_dex_byte_map(data):
  """为 dex 每个字节打(类别,名称)标签 """
  size = len(data)
  byte_map = [("METADATA","UNKNOWN")] * size
  string_ids_size,string_ids_off = struct.unpack_from("<II",data,0x38)
  method_ids_size,method_ids_off = struct.unpack_from("<II",data,0x58)
  class_defs_size,class_defs_off = struct.unpack_from("<II",data,0x60)

  # 定长段:按照item size 遍历
  for i in range(string_ids_size):
    off = string_ids_off + i * 4
    if off + 4 <= size:
      byte_map[off : off + 4] = [("STRING_ID",f"str_{i}")] * 4
  for i in range(method_ids_size):
    off = method_ids_off + i * 8
    if off + 8 <= size:
      byte_map[off : off + 8] = [("METHOD_ID",f"method_{i}")] * 8
  for i in range(class_defs_size):
    off = class_defs_off + i * 32
    if off + 32 <= size:
      byte_map[off : off + 32] = [("CLASS_DEF",f"class_{i}")] * 32

  # 变长段(code_item/class_data/string_data)单独遍历
  # 边界处理需ULEB128/MUTF8 解码,建议使用androguard
  # 待补充

  return byte_map
生产建议:
-
使用 androguard;
-
解析 map_list 获取所有 item 类型、数量、偏移;
-
对 code_item 建立 offset -> 方法映射;
-
对 string_data 建立 offset -> 字符串映射;
-
对 class_data 建立 offset -> 类映射。
5.4 交叉归因
按 page 文件区间与 entry 区间求交集
python
from collections import defaultdict, Counter

PAGE = 4096

def cross_allocate(pages, vma_start, vma_offset, apk_entries, dex_byte_maps):
    """对驻留 page 集合做交叉归因,统计各 DEX 结构与 entry 的驻留字节数。"""
    stats = defaultdict(float)

    for page_addr in pages:
        file_start = vma_offset + (page_addr - vma_start)
        file_end = file_start + PAGE

        for name, info in apk_entries.items():
            if not info.get("stored", False):
                continue

            s = max(file_start, info["data_start"])
            e = min(file_end, info["data_end"])
            if s >= e:
                continue

            inter_len = e - s

            if info["type"] == "DEX":
                bmap = dex_byte_maps[name]
                dex_start = s - info["data_start"]
                dex_end = e - info["data_start"]
                counts = Counter(bmap[dex_start:dex_end])
                for (cat, sym), cnt in counts.items():
                    stats[(cat, sym)] += cnt
            else:
                stats[(info["type"], name)] += inter_len

    return stats
已知偏差:
-
pagemap 是页级信息,无法知道页内哪个字节真正触发驻留;
-
若 page 内 METHOD 100B 与 STRING 3900B 共存,按字节占比会偏向 STRING;
-
但实际驻留可能由 METHOD 调用触发;
-
因此输出应理解为"驻留页结构分布",不是"精确触发点"
5.5 新增驻留页的 PSS 估算
PSS 不能由单进程 pagemap 直接得到,只能结合 smaps 中的 PSS 增量估算。 设 T0/T1 两次采集中某 VMA 的 PSS 差值为:
VMA_PSS_delta = PSS_t1 - PSS_t0
新增驻留页为:
ini
new_pages = pages_t1 - pages_t0若按归因字节归一化,则:
ini
total_attr = sum(stats.values())
pss_factor = VMA_PSS_delta / total_attr if total_attr else 0.0
pss_est = {k: v * pss_factor for k, v in stats.items()}
注意:
- total_attr 为 0 时,pss_factor 记为 0;
- 若 stats 只统计 stored entry,则 total_attr 可能小于新增驻留页字节;
- 该估算假设 VMA 内新增驻留页的共享均摊比例一致。 其中 total_attr 为 stats 中所有归因字节之和。
六、局限性与准确性
6.1 适用范围
- 系统 priv-app APK;
- entry 非压缩存储;
- 有 root 权限;
- 未加固、未运行时解密;
- 目标是定位 mmap 驻留增长,而不是精确定位调用栈。
6.2 已知偏差
- pagemap 只有页级粒度,页内归属靠字节占比摊派;
- present 只表示驻留,不表示访问频率;
- PSS 是进程间均摊,单进程 pagemap 无法直接得到 PSS;
- page cache 回收、内存压缩、swap 会影响采集结果;
- ZIP entry 跨页时存在摊派误差;
- DEX 变长段解析错误会导致结构归属错误。
6.3 改进方向
- 使用 /proc/pid/clear_refs 与 soft-dirty 位做访问页跟踪;
- 结合 perf、simpleperf、ART profiler 获取方法调用;
- 结合多进程 smaps 计算 PSS 共享均摊;
- 使用 androguard 完整解析 DEX map_list;
- 对 odex / vdex 单独建模;
- 对 page 内多结构使用"包含即归因"与"字节占比"双口径输出。
6.4 方法定位
本方法定位为: 一种从 VMA 级下钻到 APK entry / DEX 结构级的驻留增长归因方法。
它回答的问题是:
- 新增驻留页主要落在哪个 entry;
- 若为 DEX,主要落在哪些 DEX 结构、类、方法、字符串;
- 这些新增驻留页大致对应多少 RSS / 估算 PSS。
它不能单独回答:
- 是哪次函数调用导致 page 驻留;
- 是哪条业务逻辑触发;
- 精确的 PSS 增量来源。
因此,本方法应与调用栈采样、perf、业务埋点联合使用。
七、结论
本文提出的 pagemap 与 DEX 结构联合定位方法,能够将 APK mmap 增长从 VMA 级下钻到 entry / DEX 结构级,输出新增驻留页在 APK 内部的分布,并结合 smaps 估算 PSS。该方法适用于系统 priv-app APK、entry 非压缩存储、具备 root 权限且未加固的场景。实际使用中应结合 T0/T1 两次采集、soft-dirty 访问页跟踪以及 perf / simpleperf 等调用栈工具,以弥补页级归因的固有偏差