按系列惯例,文中自家项目的 skill 脱敏成「评审类 skill A」「测试类 skill B」,其余标本一律实名。skill-audit 是这一课现搓的,经允许,你可以照着复现。
体检的活,我手搓了三课
前三课攒下一份检查单:wc 数行数,grep 沿点名链爬,翻目录找没被点名的孤儿文件。10 月 7 日那天,我拿它给自家 skill 做体检,做完两个。这活从头到尾是机械劳动,我却每次亲手来。我原以为脚本跟正文一样,是被模型「读」进去的一部分。错了,脚本一辈子不进模型上下文,这就是本课要立的靶。想通之后我把检查单翻成了脚本,从零搓出一个装上就触发正确、跑完吐 JSON 报告的带脚本 skill,这一课把整条路摊开给你看。
机制:脚本的一生,全程不进门
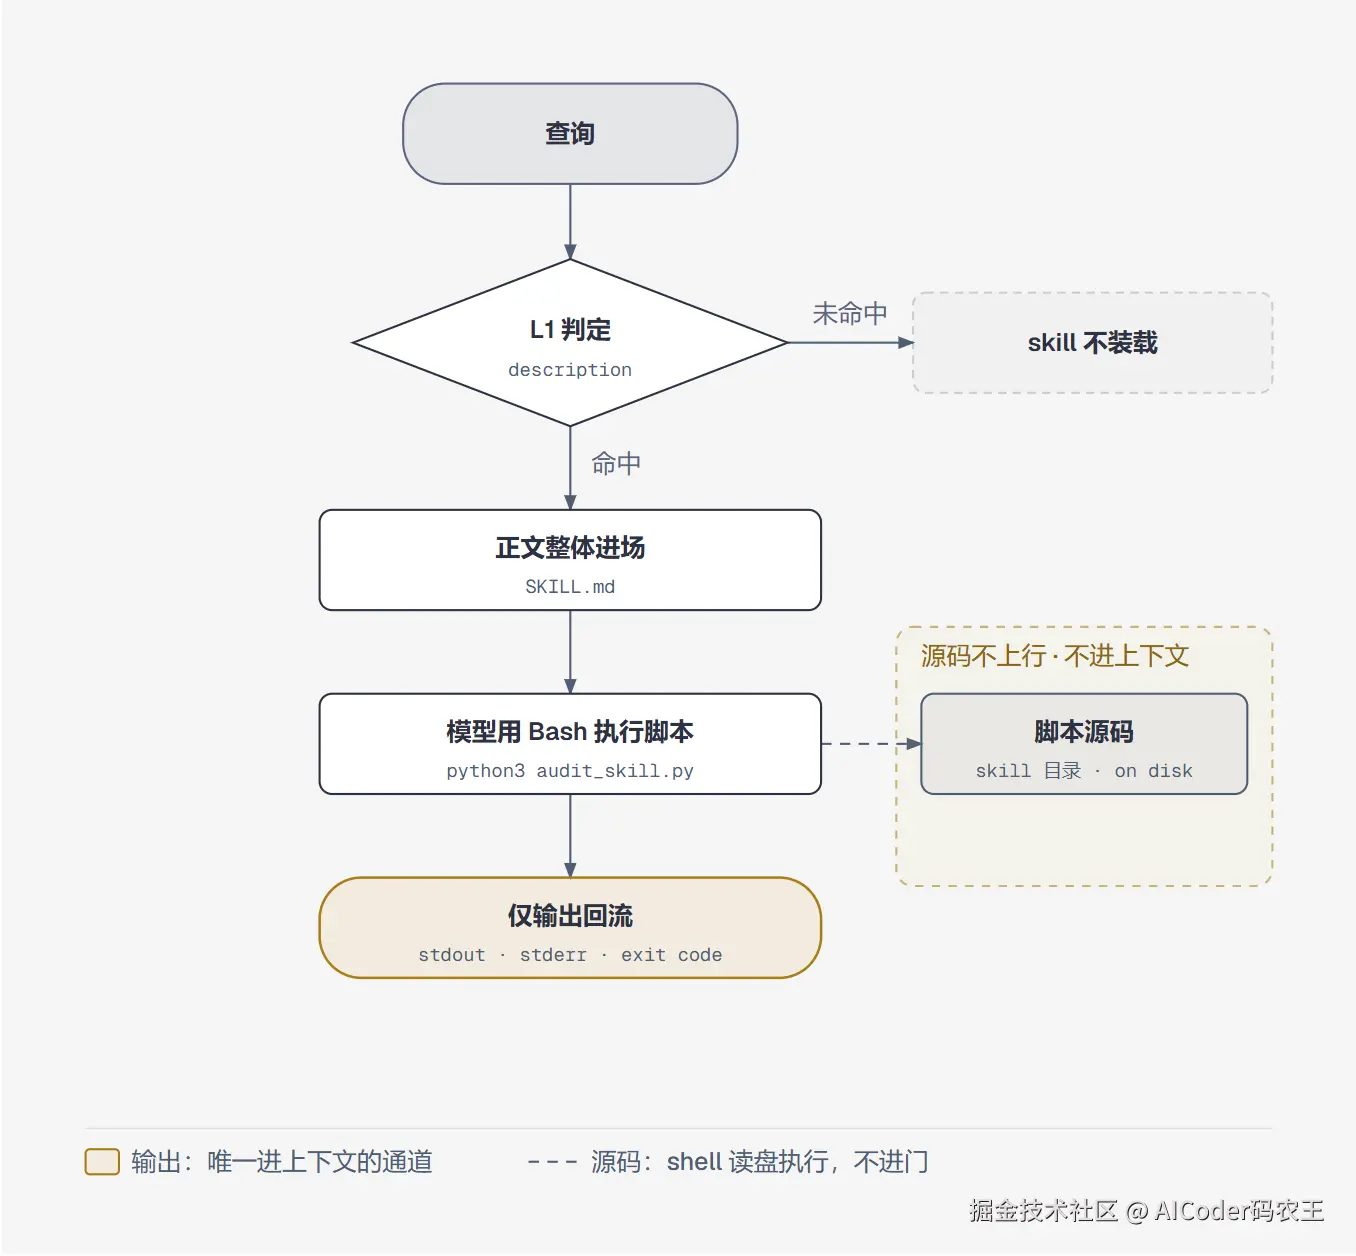
先把机制的最小模型立住:脚本永不装载。它躺在 skill 目录里,由 shell 执行,回到模型手里的只有 stdout、stderr、退出码三样------这是脚本与模型之间唯一的通道。
为什么必须这样设计?倒推一遍。第三课讲过,正文整体进场、跨轮留存,进了上下文的东西逐轮复发。pdf 的正文 1004 行,配的脚本 12386 行,是正文的 12.3 倍;docx 正文 315 行,脚本 3546 行,11.3 倍。这组数回答一个问题:重活在哪。解析、转换、校验这些机械活全在脚本里,脚本若装载,这两个 skill 光源码就压垮上下文。把「执行」和「装载」劈开,源码留在盘上,token 只付输出那几行。所以这是结构设计,不是性能优化。
借一个我熟的类比:脚本之于模型,就像远端 HTTP 服务之于客户端。你收响应体和状态码,没人把服务端源码塞进你的工程。退出码就是那个状态码。顺带一个反直觉细节:脚本不需要可执行位,真正执行它的是解释器,系统从头到尾没直接跑过它。
有同事问我:「脚本怎么触发?执行结果是直接喂给 LLM 吗?」两个问题都错位了。脚本没有自己的触发机制。查询进来,L1 的 description 判定要不要触发这个 skill(第二课讲过路由,不重讲),正文进场,模型读到正文里「跑某脚本」的指令,自己用 Bash 去执行。触发永远是描述和正文的事,脚本只管被调。输出也不是「喂」,它就是 Bash 工具的返回值,和模型自己跑 ls 看到的东西走同一条路。
正因输出是唯一通道,输出契约成了脚本设计的核心:日常给摘要,加 --offset 才翻全量;要机器读的给 JSON;产物落盘,只打印路径------报告几百行,路径一行。
五形态:门牌、说明书、仓库、工人、借的工具
到这里,skill 里的五种形态可以拼成一张总表。
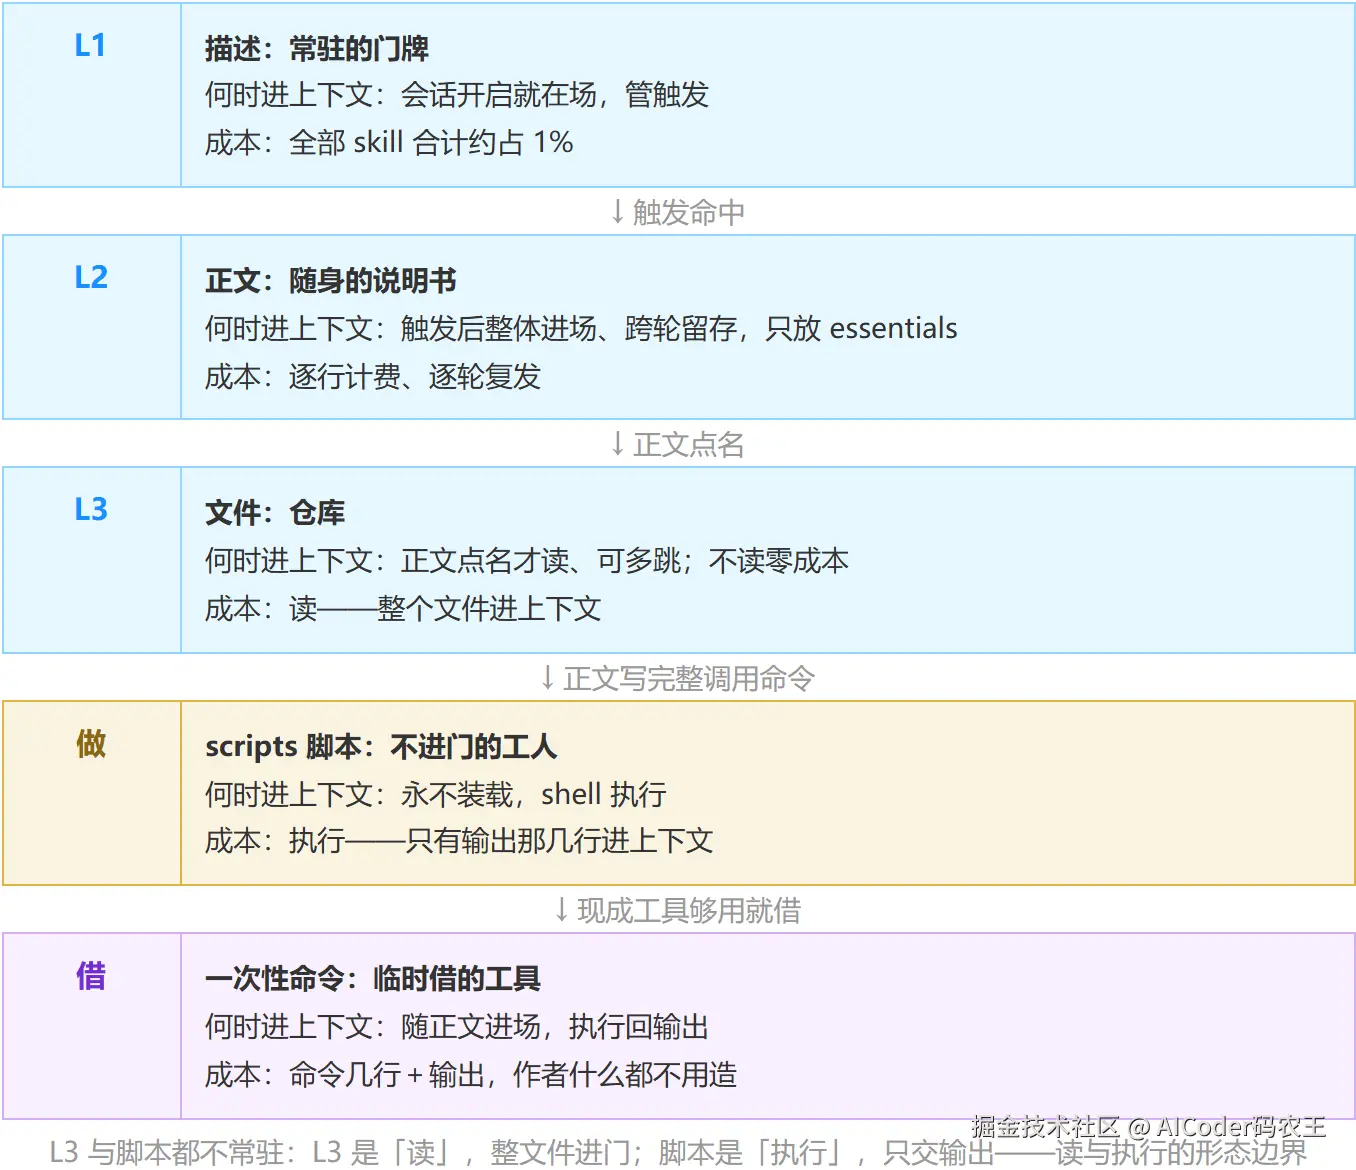
前三行第一到三课讲过,一句带过:描述常驻,正文触发后整体进场,L3 点名才读。增量在后两行。我当天在现场总结过一句口诀:描述是门牌,正文是随身的说明书,L3 是仓库(点名才开),脚本是不进门的工人(只交成品),一次性命令是临时借的工具(连门都不用造)。口诀顺口,但会抹平一处关键差异,补一句机制:L3 和脚本都不常驻,可 L3 是「读」,整个文件进上下文;脚本是「执行」,只有输出进上下文。这就是「L3 文件和 scripts 什么区别」的答案:读与执行的形态边界。
一次性命令单独说,它最容易被高估。它没有任何特殊机制:不是语法,不是协议,就是正文里一行普通文字,内容是现成工具的命令,比如「用 pandoc 把这份 Markdown 转成 docx」。它随正文进场,执行时回输出,成本只在命令几行加输出,因为作者什么都不用造。借的正确姿势是「工具大、逻辑小」:转换、抓取、格式化这类现成能力,一行命令换一个结果;一旦你要在命令外面再补一层判断或组装,就是在自家逻辑上搭违建。什么时候该搬家,下一节归位表细说。
借东西还有条纪律:钉死版本。不钉版本,半年后工具行为变了,你还以为是自己写错了。
归位表:想、查、做、借
四格各装什么:「想」管权衡取舍,留在正文;「查」交给脚本,专干数行数、比对字段、爬引用链这类确定性检查。自家逻辑的管线捆绑成脚本,归「做」;至于现成工具的一次调用,写成一次性命令就是「借」。
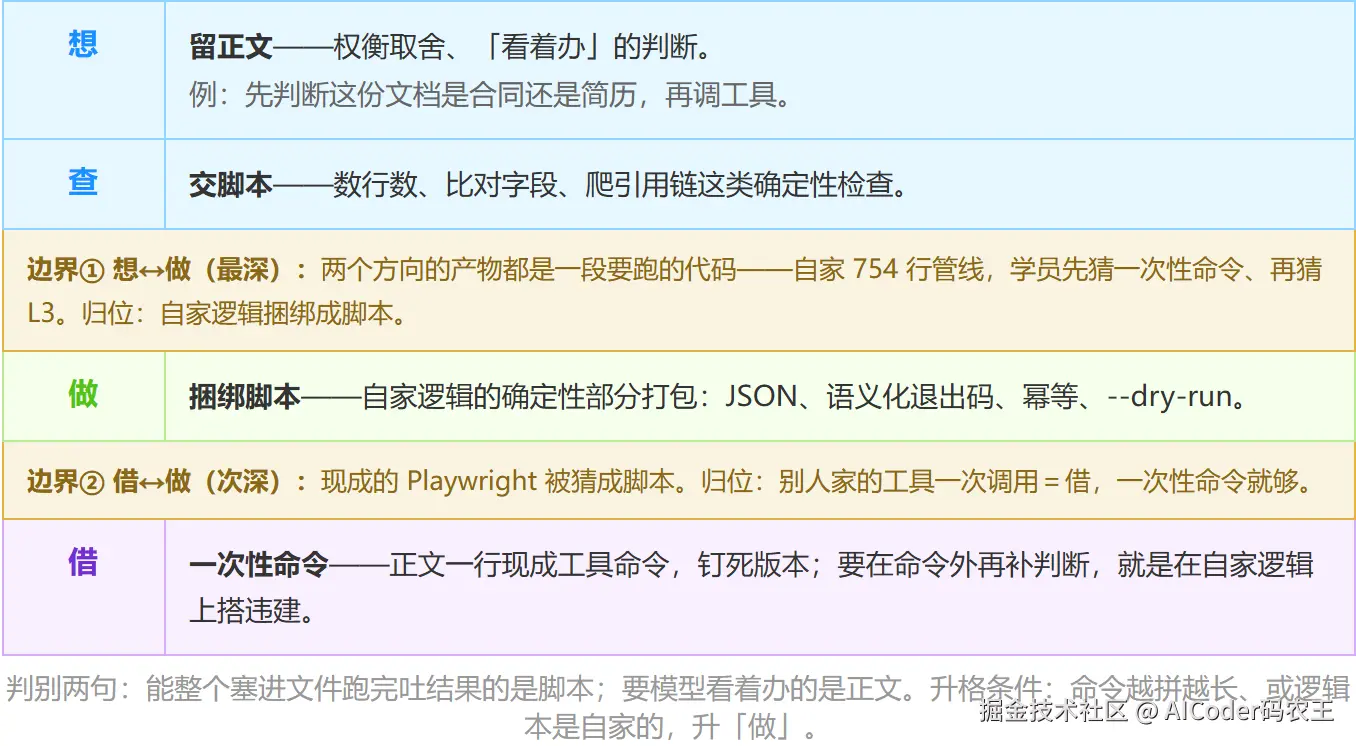
先说实话:四分法不难懂,难用。我把它出成 6 道归位题,有个学员对 3 错 3,错的全挤在两条边界上:自家 754 行管线,先猜一次性命令、再猜 L3,就是没想到捆绑脚本;运行时的回退判断,猜成脚本;现成的 Playwright,也猜成脚本。想/做、借/做这两条边界最深,我的看法是:四个方向里只有这两对的产物长得一样,都是一段要跑的代码。形态相同,归属不同,靠机制区分,不靠直觉。
把判据压成两句话,工位上就能用:能整个塞进文件跑完吐结果的是脚本;要模型看着办的是正文。自家逻辑捆绑,别人家的工具才叫借。回头对那三道错题:管线是自家逻辑,该捆绑;回退判断要模型看着办,留正文;Playwright 是别人家的工具,借,一次性命令就够。归位也不是终审判决,有升格条件:一次性命令越拼越长,或者逻辑根本是自家的(不是调工具,是自己的规则),就升成捆绑脚本。
标本谱系:判断型不带脚本,管线型重装
这套归位在真实标本上长什么样?我用 wc 拉了一遍谱系。tdd、code-review、pr 三个,脚本 0 行,是纯判断型,全文都在教模型怎么判断,没有一步机械活值得下沉。tdd 正文 38 行(3.6 KB),轻到这个量级,就是判断型的体重。baoyu 正文 255 行、脚本 514 行,还带单测,是转换型,格式转换规则确定,适合打包。docx 和 pdf 是管线型,重装上阵,前面的 11.3 倍和 12.3 倍就出自这两家。
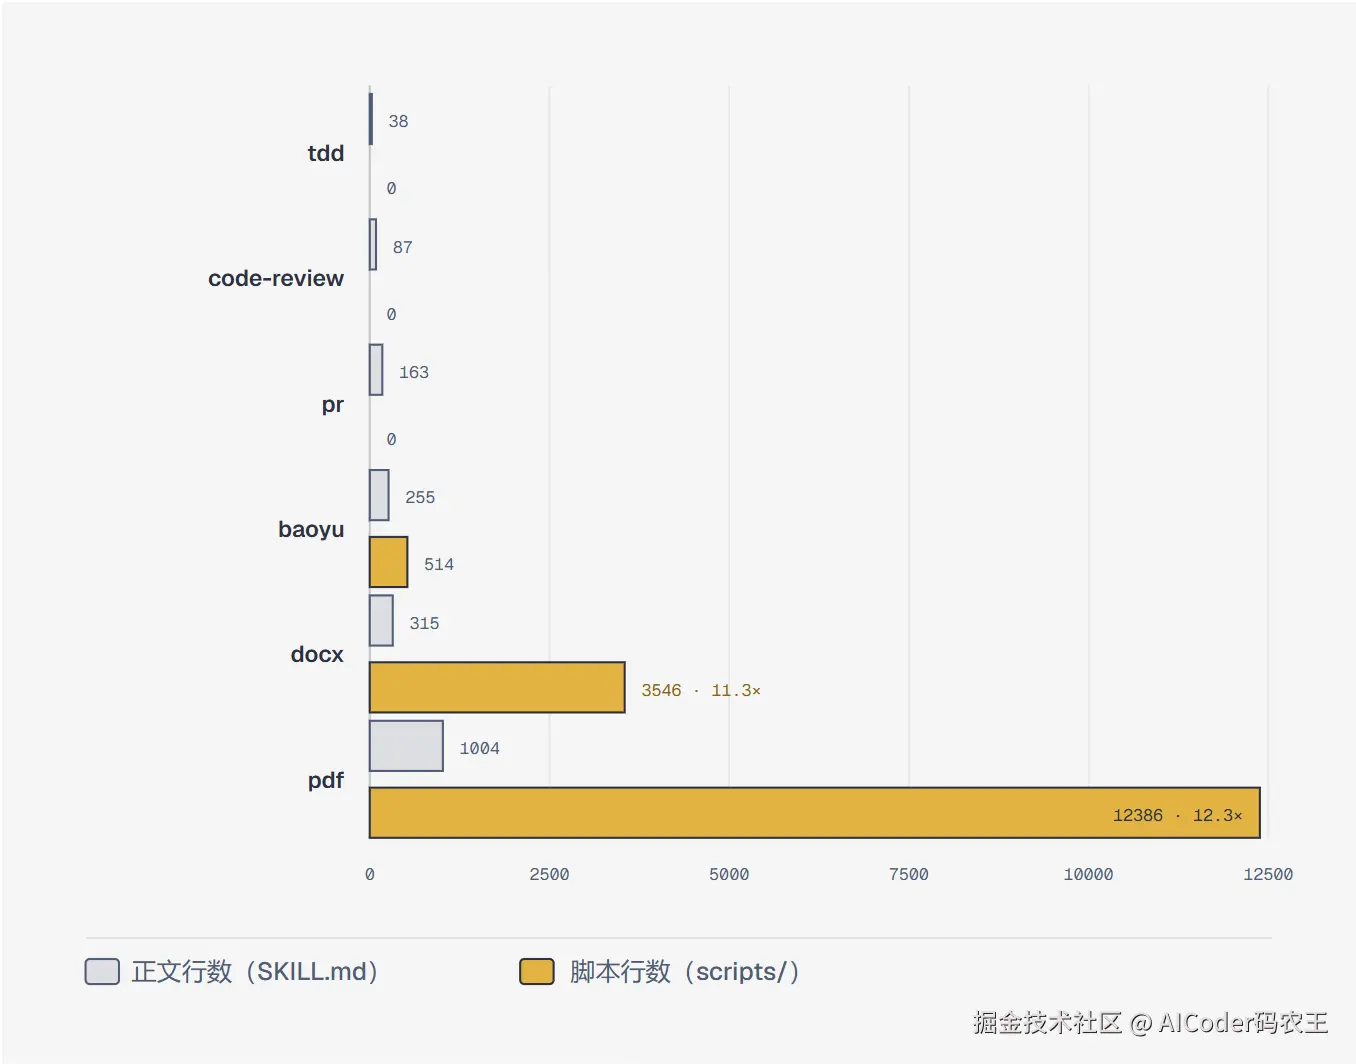
谱系回答的是「我要不要给 skill 加脚本」:先看你的是哪型。判断型不需要脚本,模型要看着办的留正文。看到高级标本都带脚本,就往自己的判断型里塞,是我见过的最常见误读。三个带脚本的标本各留了一句「判断留在哪」的答案:pdf 正文立了条 Iron rule;docx 规定转换完 MUST postcheck;baoyu 把「哪一步回退」的判断写在正文。三个答案指向同一处:判断留在模型那里,脚本只承包确定性部分。
工艺与编址:脚本怎么写才靠得住
先答被问得最多的:脚本能用什么语言?Python、Node 都行,条件只有一个:目标机有解释器。有同事接着问 Windows 的 bat 行不行:机制上成立,cmd 就是它的解释器;但我手头标本里没有一个带 bat 的,这条只能说到机制为止。Python 还有 Windows 实情:有时只有 py 启动器,没有 python3,所以调用命令要写 python3/py 回退。环境假设是设计项,要写进正文。
编址这一课是工业标本教我的。docx 正文里有句原话:「NEVER use bare python3 scripts/...」。教科书教相对路径,工业标本全部绝对解析,为什么?
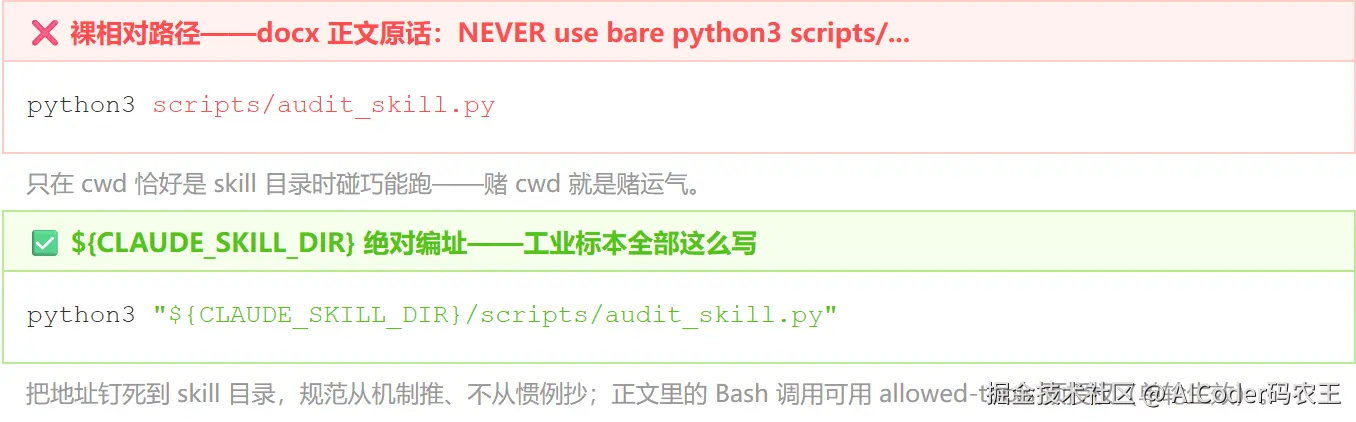
裸相对路径不是不能跑,是只在 cwd 恰好是 skill 目录时碰巧能跑,赌 cwd 就是赌运气。${CLAUDE_SKILL_DIR} 把地址钉死,规范从机制推,不从惯例抄。另外正文里的 Bash 调用可以用 allowed-tools 预授权,省一次人工确认。它单轮生效,别指望跨轮。
工艺清单我按「每条回答一个问题」收了六条:
- 零依赖,纯标准库起步,要第三方就在脚本头用 PEP 723 声明,回答换台机器还能不能跑。
- JSON 加语义化退出码,0 正常、1 查出问题、2 脚本自身故障,回答模型怎么分清「你没干成」和「你查出了问题」。
- 幂等,回答重跑会不会把现场搞坏。
- --dry-run,回答敢不敢先看再跑。
- 避免交互,agent 环境里没人按回车。
- 安全默认,出错宁可不写盘,回答挂了会不会留残骸。
还有一条藏在脚本身上:输出钉死 UTF-8。Windows 控制台的默认编码多半会把中文报告搅成乱码(这是我的推断,没有逐台机器验证),而输出是唯一通道,乱码等于这一跑白干。
工坊·上半场:写脚本、埋坑、差分
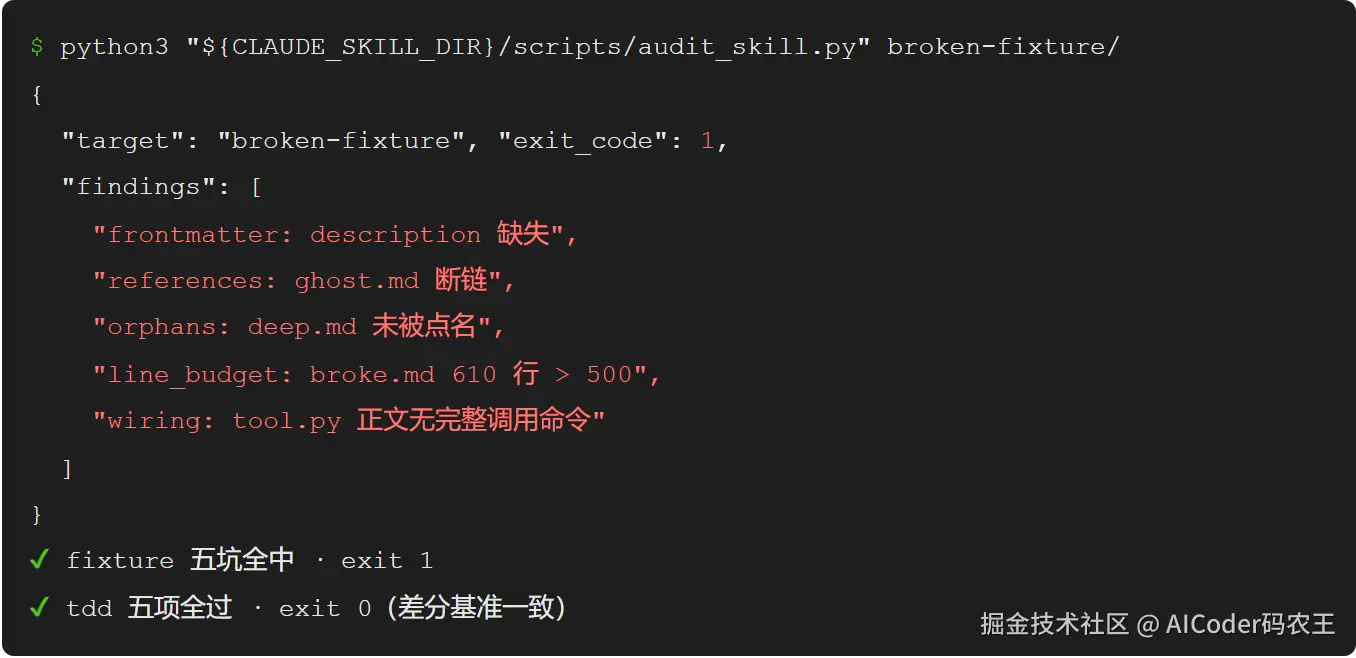
铺垫到此,开搓。开场那笔手工账,我翻译成了 audit_skill.py,五项确定性检查:frontmatter 必填字段、description 1536 字符预算、500 行线、引用链可达性、脚本接线(正文里有调用它的完整命令才算接线)。零依赖纯标准库,输出 JSON,退出码 0/1/2。然后我干了一件事:造一个 broken fixture,故意埋五个坑。缺 description、ghost.md 断链、deep.md 孤儿、610 行超线、tool.py 没接线。
再拿第 3 课人工审计的结论当基准,做差分对账:fixture 五坑全中,exit 1;tdd 五项全过;评审类 skill A 的 11 个 .md 全可达;测试类 skill B 的 12 个 .md 全可达;baoyu 唯一的 warn 是个良性真发现。差分为什么比「自己写自己测」可信一个量级?自测的盲区和你写码时的盲区是同一个;基准是第 3 课那个人工审计的我得出的,两套脑子对不上,错的一定是脚本。
事实也确实如此,第一版对账就暴露了我三个 bug。最典型的是互斥漏报:if/elif 让断链和孤儿只报一头,fixture 里两个坑漏了一个,埋坑测试当场把它摁了出来。另两个,一个是环境路径误杀合法引用,一个是单跳可达不等于多跳可达,先按下不表,坑节细说。这三个 bug 一个没漏,全被差分对账当场揪出,那五个坑埋得太值了。
工坊·下半场:写正文、装上、盲测
脚本只是半成品,另一半是正文。audit 这份 SKILL.md 我只写了 27 行,触发面、红线、编址写全就够,不需要更多。description 用 pushy 口吻加中文关键词,因为触发面只有它;负边界「不替代 skill-creator 的创建流程」也写进 description,防误触发;正文带常驻红线、${CLAUDE_SKILL_DIR} 编址和 python3/py 回退。正文里关于脚本必须写全两样:完整调用命令,和输出怎么读。模型是照着正文敲命令的,它不猜你的参数,也不猜你 JSON 里哪个字段是结论。装进 .agents/skills/ 后第一件事是吃狗粮:让 skill-audit 体检它自己,5/5。
然后是盲测:开全新的 general-purpose 子 agent,只给用户口吻的查询。实际跑了 4 次、烧了约 153 万 token。留全记录的是前两跑,编号 S1、S2:S1 没触发,S2 触发了。n=1 归因不了,我到今天也不知道 S1 那次为什么不触,只能加跑;后两跑没留完整痕,这笔账一并记进坑 6,后面单说。S2 那一跑把整条链走完:第一个工具调用就是 Skill(skill-audit),接着按正文全流程执行,跑脚本,读全文(包括 324 行的 rules.md),判四问(第 3 课那套检查单),出三节报告。第 3 课人工诊断出的病灶,全被复挖了一遍。
报告里看得见这条分界:机械检查 5/5 全过,脚本干的;四问判断带行号,模型干的。更能说明问题的是脚本盲区三项(运行时产物污染【中】、锚点空间分裂【低】、非 .md 孤儿【低】),全是模型补位的,这几样脚本结构上看不见。报告的处方部分遵守正文红线,只开方、不动手,一条没改。工坊到此收工。JSON 报告的账兑现了;触发的账要拆开记:S2 端到端跑通,是「装上就触发正确」的一例实证;S1 同构未触、n=1 归因不了,后两跑又没留全痕,这条已知不稳定,坑 6 交底。那 153 万 token 记的是「从零验证一遍」的账,不是日常体检的账,日常就一条命令。
坑节:六个坑,两条最深
坑全收在这一节,每条只管一个症状,现象、根因、修法。
坑 1|环境路径误杀合法引用。 现象:./orchestrator.md 被报断链。根因:环境路径启发式一刀切。修法:给显式相对路径留例外,直接放行。
坑 2|单跳可达不等于多跳可达。 现象:评审类 skill A 被报大面积断链,实际全可达。根因:L3 能点名 L3,我的检查只走一跳。修法:改 BFS,加访问去重。
坑 3|断链与孤儿互斥漏报。 现象:有断链的 fixture 不报孤儿,有孤儿的反而不报断链。根因:if/elif 把两类发现写成了二选一。修法:两类发现并列输出。
坑 4|误报两连。 这条是对账真标本时冒出来的。现象:运行时路径、文档示意路径被当包内断链。根因:脚本没有「包内引用」的判定规则。修法:立可信度规则,首段目录真实存在才算包内引用。划一句界:修的是误报,不等于运行时产物这个盲区补上了,那是模型补位的活。
坑 5|Windows 两坑。 这对坑是装上实测才撞上的。现象:Git Bash 的 /tmp 传给 Windows Python 打不开;python3 命令找不到。根因:两个运行时的路径语义、解释器名都不同。修法:解释器回退写进 SKILL.md,临时目录交给 tempfile。又一次,环境假设是设计项。
坑 6|触发不稳定+测试事故。 现象:S1、S2 同构查询一触一不触;四跑里后两跑没留完整痕;测试子 agent N1 自主改写了 tdd 的 description。根因:n=1 无法归因,测试没留痕;测试代理没有围栏。修法:单发查询不算数,加跑到稳定,每跑留痕;测试代理圈在沙里,出事当日回滚,N1 那次我就是当天发现、当天回滚的。
六条里第 2 和第 6 最深。第 2 条教我敬畏「查」这个字:点名链的语义没想透,代码再干净也是错的,归位表里「查」的门槛就在这。第 6 条是测试纪律:触发判定是概率行为,单发样本说明不了任何事,不留痕的跑等于白跑;放出去的测试代理还会自己动手,围栏不是可选项。
收口:归位一遍,照六步搓你自己的
现在轮到你,两件事都不难。第一件是微实操,把你手头某个 skill 的内容清单拉出来,逐条归位:这条判断留正文,这条确定性检查下沉脚本,这条借工具写成一次性命令。归完位,缺什么、错位什么,一目了然。第二件是照六步链路搓你自己的:
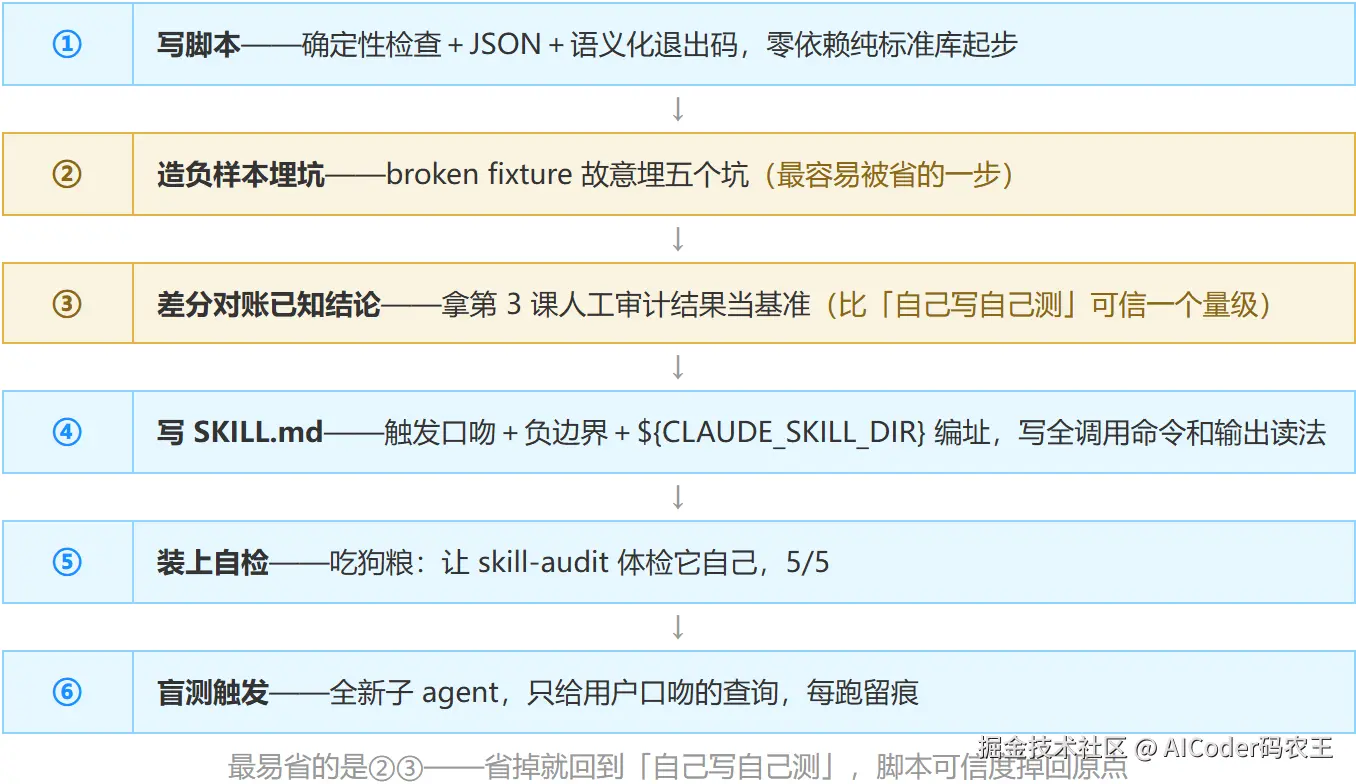
六步里最容易省的是第二步埋坑和第三步差分。省掉它们,你就回到「自己写自己测」,脚本的可信度掉回原点。
回到开场那笔账:wc、grep、翻目录的活外包给了脚本,手工体检变成一条命令;哪个 skill 有病、病得多重,判断还在模型和四问那里。体检外包成立了,开处方的还是人。
带走三样
一,脚本 executed, not loaded:源码不进门,stdout+stderr+退出码是唯一通道,输出契约是脚本设计的核心,token 只付输出。二,想/查/做/借四分法加两句判别句:判断留正文,确定性检查进脚本,自家逻辑捆绑,借工具钉死版本,半年后工具变了别错怪自己。三,六步链路:写脚本→埋坑→差分→正文→装上→盲测。差分是验证脚本的正确姿势。
临走三问
一问:你的脚本要扫一份 3000 行的目录清单,全量输出 800 行,模型读着费劲。输出契约怎么改,让它每次只看自己要的那段?二问:同事的 skill 里有这么一段,「先判断这篇文档是合同还是简历,再调用 pandoc 转成 PDF」,判断和转换各归哪一格?三问:你的脚本自测五遍全过,零依赖、有 JSON、有退出码,今天装还是不装?还差哪两步?
三道都答对了,这一课才算真的带走。
第一课算上下文的账,第二课修触发,第三课管正文,这一课把 skill 里唯一「被执行」的形态接了进来。它不进门,只交活。下一课是第 5 课,讲输入/输出接口:$ARGUMENTS 怎么把用户参数接进 skill,!command 怎么在正文进场前先跑一条命令,context:fork 怎么把执行 fork 进子上下文。脚本之后,这是 skill 仅剩的机关。
08-定稿
2026.10.12 · 阅读约 11 分钟
如果这篇文章对你有帮助,欢迎转发给需要的同事和朋友。