一、一张工单,8 项检查,智能体只对 1 项
Tessl 团队在 2026 年 10 月 12 日的博客里放了一个对照实验:给编码智能体一张工单,仓库被刻意设计成「三个年代」------2026 年的领域层写法正确,但 2023 年的神文件和 2021 年的冻结模块加起来 outnumber 它 10 比 1。
智能体没有打开正确的领域层。它进神文件,用 random.randint 掷骰子,把一个有现成助手的日志重写成自己的写法,还两次伸进冻结模块。8 项检查,只过 1 项,通过率 12.5%。仓库里没有坏代码,它也没报错------它只是照抄了眼前看到的写法。作者 Ian Johnson(Tessl 的工程主管、《Harness Engineering》一书作者)给这套实验下的结论就一句:你没写下来的规矩,对它而言不存在。
他的答案不止一个。他把约束拆成四个杠杆:指令、约束、能力、检查------都是你仓库里自己拥有的文件,且都在智能体动手之前就会被读到。这套「四杠杆法」是本文主线。它比「写好 CLAUDE.md」的常见建议多走了一步:前三个杠杆只能说服,第四个才有拒绝权。
二、为什么「写好 CLAUDE.md」听起来没毛病
CLAUDE.md 是共识里最顺的那个答案:1 个文件,放仓库根目录,智能体开跑前自动读。写标准、写风格、写禁区,成本低,见效快。很多团队到这一步就停了------「规矩写下来了」。
它之所以听起来对,是因为机制站得住:智能体每次开工都会读根目录指令,所以 CLAUDE.md 是到达率最高的那类文件。但「到达」只解决一半问题。剩下的一半是「它具体该做什么、不该碰什么」,这需要路径级约束;「它够得着哪些工具」,这需要能力层设计;「做错了怎么办」,这需要一个会拒绝的环节。说服型杠杆有个天然上限:模型可以不听。一旦模型不听,说服链就断了,后面没有任何环节能拦。
- 指令(CLAUDE.md):管「这个仓库是什么」,只建议。
- 约束(.claude/rules/):按路径限定「这个目录不能怎么改」,也只建议。
- 能力(commands/skills/MCP):限定「够得着什么工具」。
- 检查(.claude/hooks/):「做完之后拒不拒」------四者里唯一能拒绝的。
更关键的是:能力杠杆是四个里最少被设计的一个。原文给了个家庭测试,把某个文件从仓库拿走------智能体能做的事变少了,它是能力;它只是做得更差,你写的其实是条规则,只是把它包装成了工具。多数团队踩的就是一脚把能力当规则用。
三、翻车点:说服到不了的地方
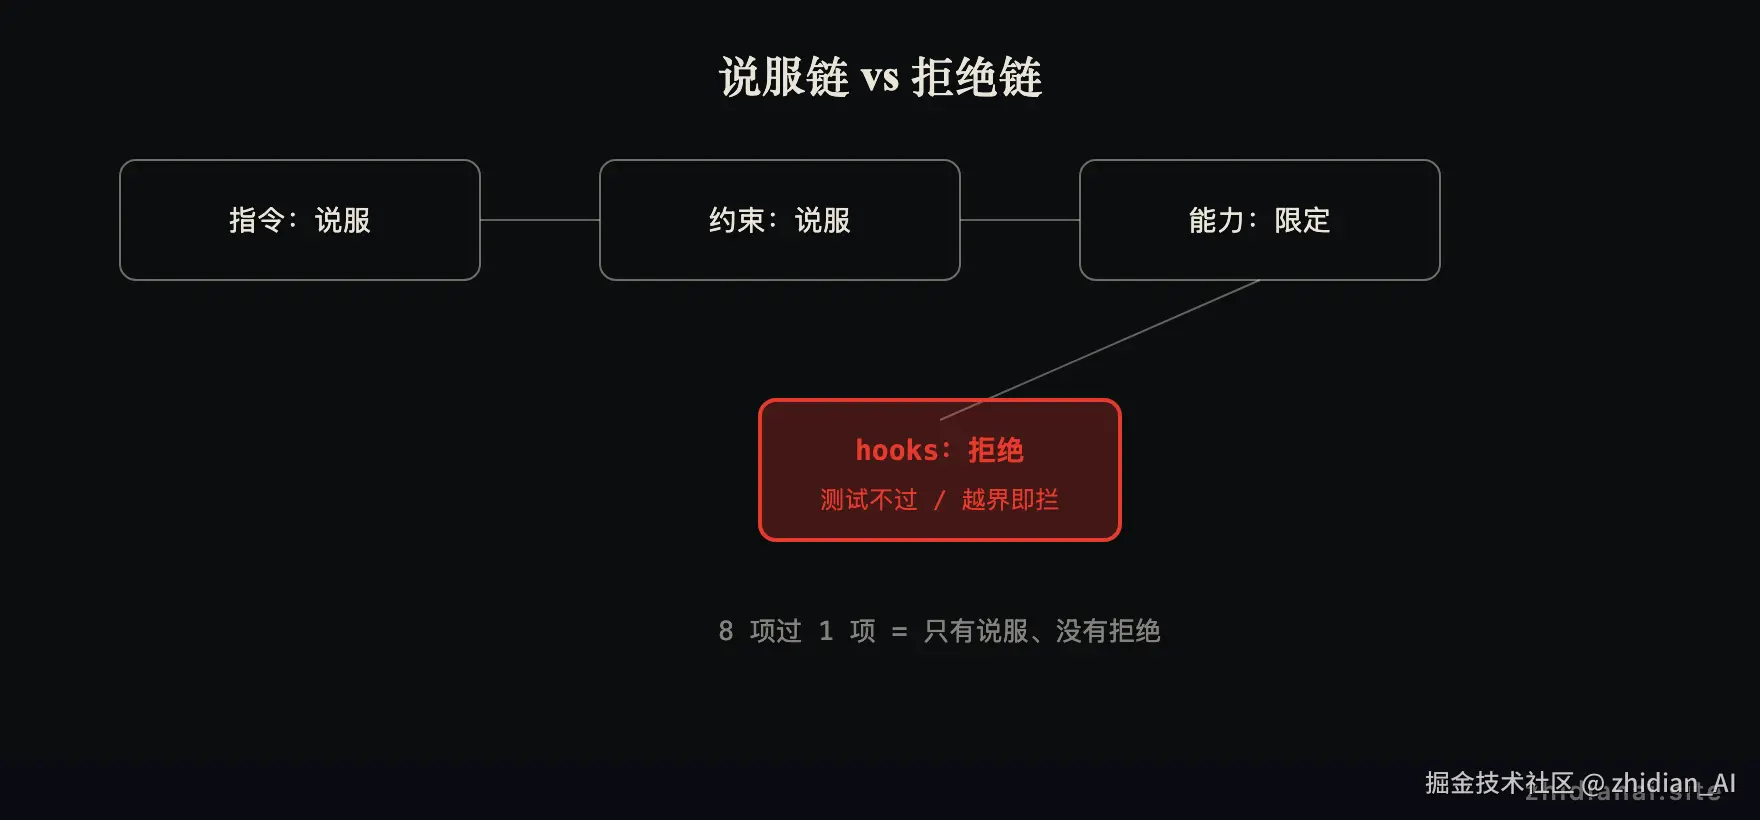 回看那 8 项检查:过的那 1 项是「测试能不能过」,没过的 7 项全在「你期望它做对、但它没有依据」的位置------神文件名、冻结模块边界、日志助手该不该直接照搬,没有一个出现在任何文件里。机制很清楚:智能体只能依据读到的东西做决定,读不到,就只能照抄眼前代码的样子。12.5% 的通过率,根因是章程缺口:能力在,依据缺。一旦读不到规矩,智能体就会默认照抄眼前代码------后果是全队一起继承旧代码的坏味道。
- 规则没写事故日期 = 下次没人查。
- 能力项没做过家庭测试 = 工具面只宽不窄。
- 合码前没有 1 个 hooks 拒绝点 = 说服型杠杆上限封顶。
要点:判断规则文件里最值钱的信息,是触发它的那次事故。路径级约束写「这个目录 2023 年 8 月炸过 1 次,改动前先读 XX」,比写「注意安全」多一条拒绝的依据。
还有一类翻车更隐蔽,也是少有人自查的:把「能力」和「规则」混写。按家庭测试过一遍团队里的每个 commands/skills/MCP 条目------原文说,真正能砍掉的能力项往往占已装工具的一半左右(他自己的口径,见文末来源行),砍掉的每一条都等于把智能体够得到的东西收窄一档。
| 翻车信号 | 背后缺的杠杆 | 该补什么 |
|---|---|---|
| 智能体照抄旧代码的坏味道 | 约束(路径级规则) | 在对应路径放规则,写清触发事故 |
| 反复调不该调的外部服务 | 能力(工具授权) | 收紧 settings / mcp 的允许列表 |
| 改完没人验证就合进主干 | 检查(hooks) | pre-commit 跑测试 + 禁区扫描 |
| 团队各写各的提示词 | 指令(CLAUDE.md) | 把共性规矩上收到根文件 |
四、换一种做法:按四个杠杆分别下手
四杠杆法落到仓库里,就是 4 类目录、4 类动作。这张表可以直接照着做------每个杠杆的最小可用版都不超过 1 个下午:
| 杠杆 | 放在哪 | 管什么 | 能否拒绝 | 最小可用版 |
|---|---|---|---|---|
| 指令 | CLAUDE.md | 仓库是什么、往哪走 | 否(建议) | 1 屏内写清定位与边界 |
| 约束 | .claude/rules/ | 哪个路径不能怎么改 | 否(建议) | 每条带事故日期 |
| 能力 | commands / skills / mcp | 够得着什么工具 | 否(限定) | 按家庭测试逐个过一遍 |
| 检查 | .claude/hooks/ | 做完之后拒不拒 | 是 | 测试 + 禁区扫描双钩 |
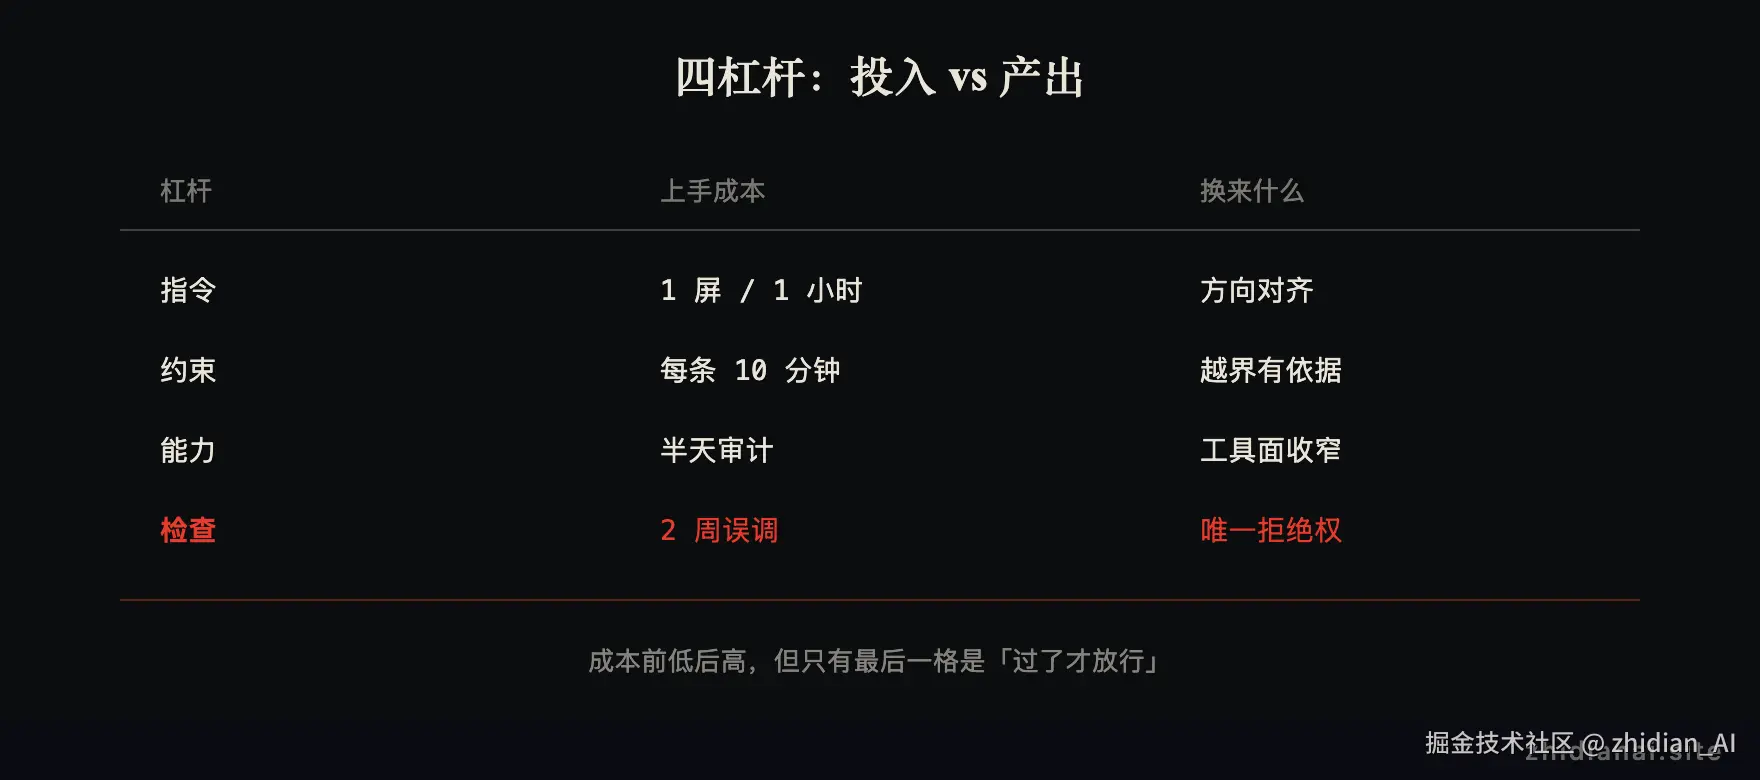 取舍在这里:检查杠杆的工程量是四个里最大的------钩子要写、要维护、要跟 CI 流程保持一致,前 2 周基本都在处理误报。换来的是唯一能拦下「7 项没过」的环节。我的判断是这笔账划算:说服型杠杆再加 10 条,上限依然是「模型可以不听」;1 个拒绝点把下限从 0 抬到「过不了就合不进主干」。它看起来最贵,恰恰是被低估最狠的那一个。我认为这笔账划算:说服型杠杆再加 10 条,上限还是「模型可以不听」;1 个拒绝点把下限从 0 抬到「过不了就合不进主干」。
我们自己的踩坑印证过这个结构。之前维护视频采集流水线时,一次改正则写在模板字符串里,反斜杠被解析器吃掉,同样 1 份代码连跑 2 次出 2 种结果------当时靠「跑通就合」放行,事后才发现真正的防线应该是:改完自动跑 1 次旧样本做回归,不过就不让合。这是 1 个检查杠杆的最小可用版,成本 20 分钟,拦住的是整类事故。
整节压缩成一句话:三个杠杆管「读什么、够什么」,第 4 个杠杆管「放不放行」------只建前三层的仓库,翻车率取决于模型心情。
最小可运行示例,10 行以内:
边界也划清楚:四杠杆法在 3 种情况下不管用。小仓(少于 50 个文件)没有神文件可隔离,约束杠杆无事可做;一次性脚本型智能体不读仓库文件,杠杆全部失效;团队还没到「智能体每天合代码」的阶段时,上 hooks 的维护成本高于收益------先做指令与能力两层就够。