一份实用 SciPy 参考资料,覆盖科学计算、数值方法和可复现工作流程。
- 根据问题选择优化、积分、插值、统计、信号和稀疏数据等 SciPy 子模块。
- 理解数值假设、容差、收敛条件和边界条件。
- 把 NumPy 数组与 SciPy 算法结合,编写清晰、可测试的代码。
- 解释求解器或统计检验的结果,而不是把它们当作黑盒。
示例均为独立代码片段,可复制到 Python 3 环境中运行。
1. SciPy 架构与数值计算流程
SciPy 在 NumPy 基础上提供科学和工程计算算法。它包含优化、积分、插值、线性代数、统计、信号处理、稀疏矩阵、空间算法等子模块。可靠的工作流程应把数据准备、模型定义、数值计算、结果验证和报告分开。
|-------------------|------------|---------------------------------|
| 子模块 | 典型问题 | 代表工具 |
| scipy.optimize | 最小值、根、约束优化 | minimize、least_squares、root |
| scipy.integrate | 定积分、常微分方程 | quad、solve_ivp |
| scipy.interpolate | 样本之间的数值估计 | interp1d、CubicSpline、griddata |
| scipy.linalg | 矩阵分解和方程求解 | solve、svd、eig、cholesky |
| scipy.stats | 分布和统计推断 | norm、ttest_ind、chi2_contingency |
| scipy.signal | 滤波和频谱分析 | butter、sosfiltfilt、welch |
| scipy.sparse | 大规模稀疏矩阵 | csr_matrix、sparse.linalg |
可重复的基本模式
- 验证输入:维度、单位、有限性、排序和物理边界。
- 选择匹配问题假设的算法:光滑性、稀疏性、可微性或分布形式。
- 当默认精度不合适时,显式设置容差和迭代限制。
- 检查收敛、残差、警告和状态信息,而不只查看最终数值。
- 在信任生产结果前,用已知案例或独立计算进行验证。
import numpy as np
from scipy import optimize
objective = lambda x: (x0 - 2.0)**2 + (x1 + 1.0)**2
result = optimize.minimize(objective, x0=np.array(0.0, 0.0))
print(result.x, result.fun, result.success)
print(result.message)
2. 优化、求根与最小二乘
优化用于寻找使目标函数最小或最大的参数。求根用于寻找满足 f(x) = 0 的 x。最小二乘通过最小化观测值与模型之间残差的平方来估计参数。问题的建模方式非常重要:边界、约束、变量尺度、初始值以及局部或全局结构都会影响结果。
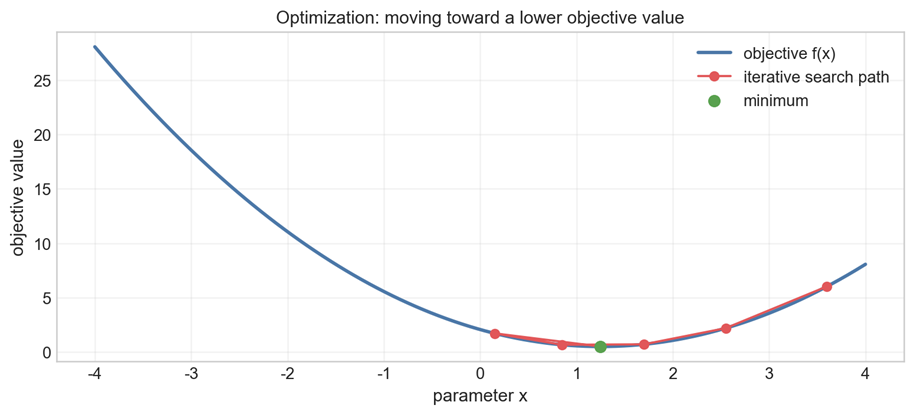
图 1:迭代搜索逐步逼近一维目标函数的较低值。
|--------|---------------------------|-----------------|
| 任务 | SciPy 选择 | 关键问题 |
| 无约束最小值 | optimize.minimize | 目标是否光滑?初始点是否合理? |
| 有界最小值 | minimize 配合 bounds | 边界是否有物理意义? |
| 非线性求根 | optimize.root | 是否可能存在多个根? |
| 标量区间求根 | brentq | 区间是否包含符号变化? |
| 参数拟合 | least_squares / curve_fit | 残差和参数尺度是否合适? |
from scipy.optimize import brentq, least_squares
root = brentq(lambda x: np.cos(x) - x, 0.0, 1.0)
print(root)
def residuals(params, x, y):
slope, intercept = params
return slope * x + intercept - y
x = np.arange(5.0)
y = 2.0 * x + 1.0 + np.array(0.1, -0.1, 0.0, 0.05, -0.05)
fit = least_squares(residuals, x0=0.0, 0.0, args=(x, y))
print(fit.x, np.linalg.norm(fit.fun))
优化诊断
- 成功标志是必要条件但不是充分条件;还要检查最优性、残差范数、迭代次数和警告。
- 当一个坐标远大于另一个坐标时,应考虑缩放参数和变量。
- 可能存在局部最小值或多个根时,应尝试多个初始点。
- 超出物理边界的结果通常是建模问题,而不只是求解器问题。
3. 数值积分与常微分方程
当解析原函数不可得或不方便时,数值积分可以近似计算积分。quad 会根据标量被积函数的变化自适应选择采样点。对于随时间演化的系统,solve_ivp 可以积分初值问题 y′ = f(t, y)。
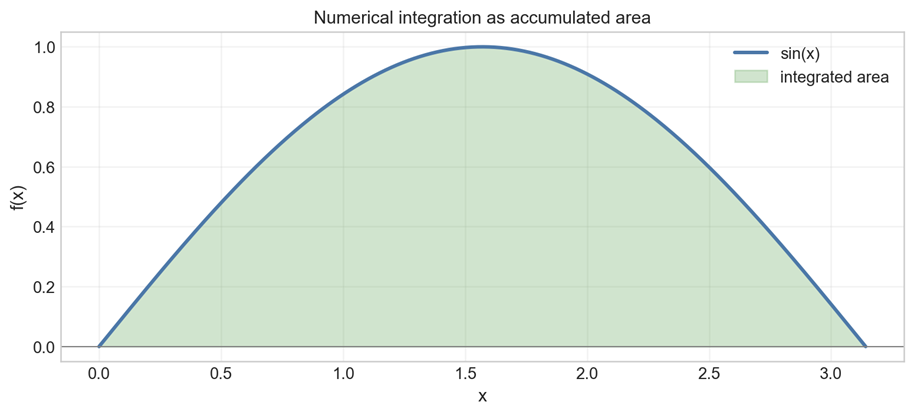
图 2:数值积分估计 sin(x) 从 0 到 π 的累积面积。
from scipy.integrate import quad, solve_ivp
area, error = quad(np.sin, 0.0, np.pi, epsabs=1e-10)
print(area, error)
def oscillator(t, state):
position, velocity = state
return velocity, -position
t_eval = np.linspace(0.0, 10.0, 300)
solution = solve_ivp(oscillator, (0.0, 10.0), 1.0, 0.0, t_eval=t_eval,
rtol=1e-8, atol=1e-10)
print(solution.success, solution.y.shape)
|-------------------|-------------|--------------|
| 参数或结果 | 含义 | 重要性 |
| epsabs | 绝对误差容差 | 控制接近零时的误差 |
| epsrel | 相对误差容差 | 控制相对于数值大小的误差 |
| t_eval | 需要输出的时间点 | 把内部步长与报告网格分开 |
| rtol / atol | ODE 相对和绝对容差 | 平衡精度与计算成本 |
| success / message | 求解状态 | 说明积分是否按预期完成 |
边界与稳定性检查
遇到不连续点或尖锐特征时,必要时应把积分区间分段。对于 ODE,要检查步长、守恒关系、预期边界以及对容差的敏感性。曲线看起来平滑,并不能证明数值解是准确的。
4. 插值与近似
插值用于估计已知数据点之间的数值。线性插值简单且稳定;样条插值更光滑,但可能过冲,边界行为也可能不理想。多维插值还需要关注网格结构、缺失点,以及目标点是否位于数据支持的凸区域内。
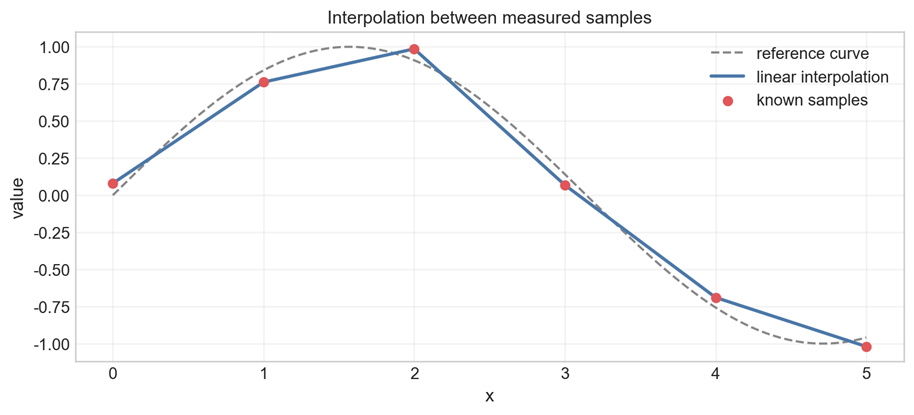
图 3:插值在测量样本之间生成估计值,虚线表示参考曲线。
from scipy.interpolate import CubicSpline, griddata
x_known = np.array(0.0, 1.0, 2.0, 3.0)
y_known = np.array(0.0, 0.8, 0.9, 0.1)
curve = CubicSpline(x_known, y_known)
x_dense = np.linspace(x_known.min(), x_known.max(), 100)
y_dense = curve(x_dense)
散点二维插值
points = np.array(\[0, 0, 1, 0, 0, 1, 1, 1])
values = np.array(0.0, 1.0, 1.0, 2.0)
target = np.array(\[0.25, 0.75])
print(griddata(points, values, target, method="linear"))
|-----------------|-------------|---------------|
| 方法 | 优点 | 风险或限制 |
| 线性 | 直观且通常稳定 | 角点处不光滑 |
| 三次样条 | 曲线和导数更平滑 | 可能过冲,对端点敏感 |
| 最近邻 | 结果保持在观测值集合中 | 结果不连续 |
| griddata linear | 支持二维散点 | 支持区域外可能返回 NaN |
插值与外推的区别
- 插值位于观测数据支持范围内;外推超出该范围,通常可靠性更低。
- 选择插值器时,可绘制残差或使用留出观测进行比较。
- 保留原始 x 的排序;方法要求唯一坐标时,应处理重复坐标。
- 记录单位和采样密度;数学上的平滑曲线不一定代表物理过程平滑。
5. 线性代数、稀疏矩阵与空间算法
SciPy 提供了比基础 NumPy 运算更丰富的数值线性代数方法。当矩阵大部分元素都有意义时使用稠密矩阵;当大部分元素为零时,稀疏格式只存储非零元素和索引,能够节省内存。空间工具则支持距离、近邻、几何结构和聚类。
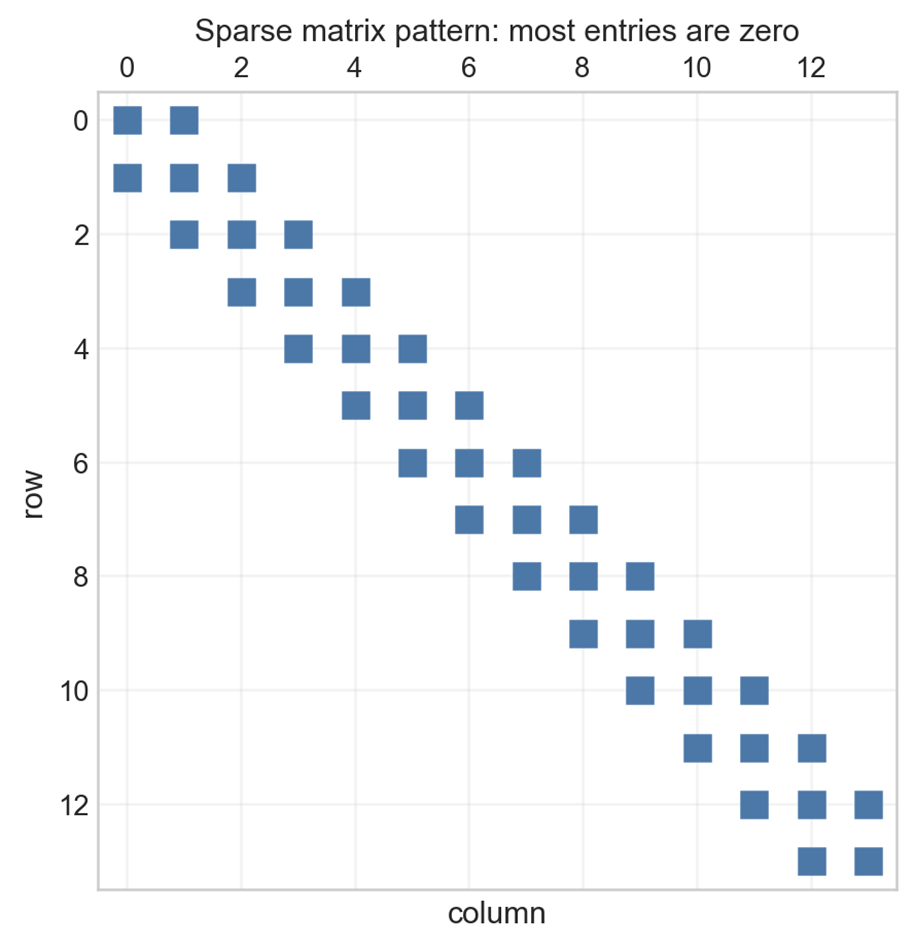
图 4:带状稀疏矩阵只存储少量非零对角线。
import numpy as np
from scipy import linalg, sparse
from scipy.sparse.linalg import spsolve
A = np.array(\[4.0, 1.0, 1.0, 3.0])
b = np.array(1.0, 2.0)
x = linalg.solve(A, b, assume_a="sym")
print(x)
三对角稀疏系统
n = 100
main = 2.0 * np.ones(n)
off = -1.0 * np.ones(n - 1)
K = sparse.diags(off, main, off, -1, 0, 1, format="csr")
solution = spsolve(K, np.ones(n))
print(solution:3)
|------------|----------------|-----------|
| 格式 | 适用场景 | 典型操作 |
| CSR | 快速按行切片和矩阵-向量乘法 | 稀疏线性系统 |
| CSC | 快速按列切片及部分分解 | 按列处理的流程 |
| COO | 从坐标列表构造 | 组装后再转换 |
| 稠密 ndarray | 非零元素很多的矩阵 | 小型或完全填充系统 |
线性代数习惯
- 线性方程组优先使用 solve(A, b),不要直接使用 inv(A) @ b。
- 求解后检查残差 A @ x - b 及其范数。
- 当输入的小误差导致输出大幅变化时,应检查矩阵条件数。
- 根据构造和计算模式选择稀疏格式,而不只依据矩阵大小。
6. 统计、分布与推断
scipy.stats 包含概率分布、描述性统计、假设检验、相关性和拟合工具。分布对象可以计算密度或质量函数、累计概率、分位数和随机样本。统计检验应依据数据生成假设选择,并结合效应量、不确定性和实际背景进行解释。
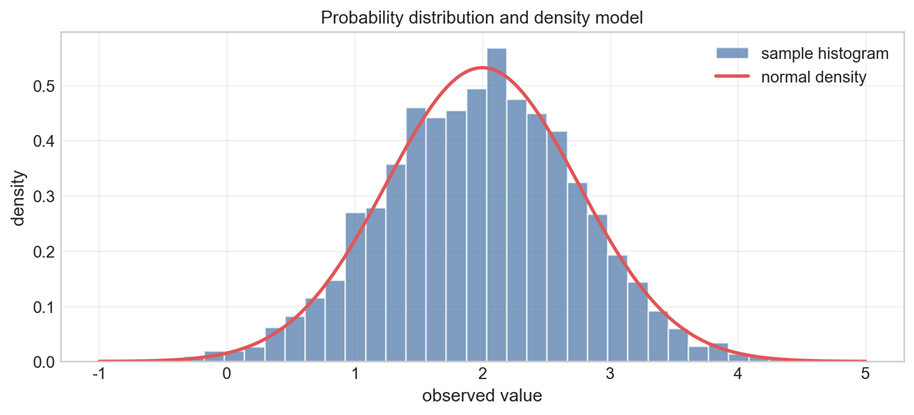
图 5:样本直方图与正态概率密度的比较。
from scipy import stats
sample = np.array(2.1, 1.8, 2.4, 2.0, 1.7, 2.3)
mean = sample.mean()
ci = stats.t.interval(0.95, df=len(sample) - 1,
loc=mean, scale=stats.sem(sample))
print(mean, ci)
z = np.linspace(-3, 3, 7)
print(stats.norm.pdf(z))
print(stats.norm.cdf(1.96)) # 约为 0.975
|------------------|---------------|--------------|
| 工具 | 问题 | 解释提醒 |
| stats.norm | 正态模型分配了多少概率? | 模型不能自动证明自身有效 |
| ttest_ind | 两个独立均值是否不同? | 检查独立性和方差假设 |
| pearsonr | 是否存在线性关联? | 相关不等于因果 |
| chi2_contingency | 分类变量是否有关联? | 检查期望频数 |
| bootstrap | 统计量在重采样下如何变化? | 重采样反映当前样本 |
可靠的推断报告
应报告样本定义、估计量或检验、置信水平、区间或 p 值、效应量以及假设。小 p 值本身不能证明实际重要性、因果关系或有效预测关系。
7. 信号处理、测试与生产检查表
scipy.signal 支持滤波、卷积、峰值检测、传递函数和频谱分析。滤波会改变信号,因此必须记录截止频率、相位行为、边界处理和采样频率。这个原则也适用于整个 SciPy:只有理解假设和诊断信息,数值输出才有意义。
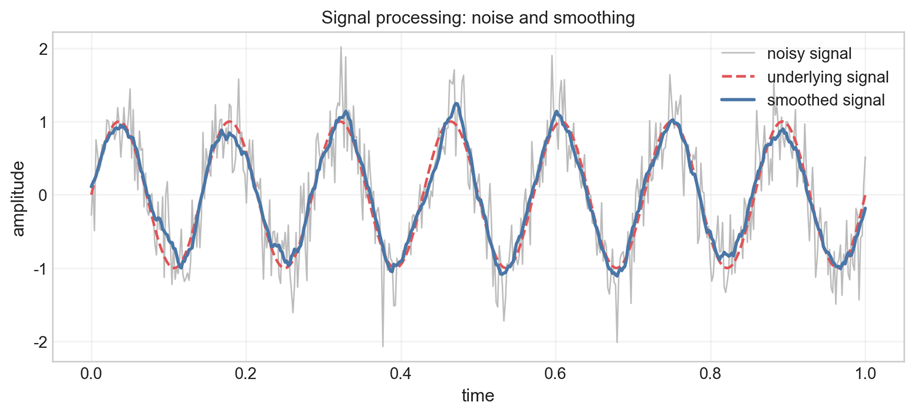
图 6:平滑可以减少高频噪声,同时尽量保留底层信号。
from scipy import signal
fs = 200.0
b, a = signal.butter(4, 20.0, btype="low", fs=fs)
t = np.arange(0.0, 2.0, 1.0 / fs)
raw = np.sin(2 * np.pi * 5 * t) + 0.4 * np.sin(2 * np.pi * 60 * t)
filtered = signal.sosfiltfilt(signal.tf2sos(b, a), raw)
frequencies, power = signal.welch(raw, fs=fs)
print(filtered.shape, frequenciesnp.argmax(power))
|---------|-------------------|------------------------|
| 检查项 | 问题 | 证据 |
| 输入验证 | 数值是否有限、排序正确且尺度合理? | 断言和汇总统计 |
| 算法匹配 | 算法假设是否符合数据或模型? | 文档和探索性图形 |
| 容差 | 精度是否满足决策需求? | 对 rtol、atol 或 eps 的敏感性 |
| 诊断 | 是否收敛或产生警告? | status、message、残差、条件数 |
| 可复现性 | 能否重新得到结果? | 版本、随机种子、参数和输入 |
| 验证 | 是否与已知或留出案例一致? | 单元测试和独立检查 |
SciPy 最终检查表
- 明确数组形状、单位和坐标约定。
- 使用有意义的容差,并记录为什么该容差足够。
- 把警告和不收敛视为需要调查的结果。
- 重要计算应比较多种方法或极限情况。
- 记录 SciPy/NumPy 版本和数值设置,确保可重复。