"优化 KV Cache"到底在优化什么?vLLM、SGLang、Strata 优化的是三个不同的维度
作 者:吴佳浩Alben
撰稿时间:2026.10.10 更新时间:2026.10.11
引言
vLLM 说自己优化了 KV Cache,SGLang 说自己优化了 KV Cache,Strata 也说自己优化了 KV Cache。读完三份文档、三套术语,很容易得出一个印象:它们在做同一件事,只是做得有好有坏。
这个印象是错的。
它们各自把力气花在了三个不同的维度上:
一个管怎么存,一个管怎么共享,一个管怎么放。
维度不同,收益就不同,代价也不同。混在一起谈,最典型的结果就是那句经典的困惑:"我明明优化了 KV Cache,为什么 TTFT 一点没降?" ------ 因为你优化的是另一个维度上的东西。
先说明对象。 本文的 Strata ,指 arXiv:2508.18572(OSDI '26)的论文版 ,一个长上下文场景下的 KV 分级缓存系统,构建在 SGLang 之上 。所以严格地说,本文对比的是"两个引擎的实现 + 一个跑在引擎之上的系统 ",不是三个独立引擎。这也说明维度 C 的优化可以叠加在维度 B 的实现之上。(另有一个同名但不同源的单机项目也叫 Strata,血缘、论文、代码都与上面这个无关,它的分层对象甚至不是 KV,放在第六章讲。)
本文的证据分三类,正文会逐处标注:
- 【实测】 本机跑出来的数据(RTX 5090,vLLM 与 SGLang 两个引擎)
- 【源码】 镜像内源码逐行核对
- 【论文】 引用论文的数字,我没有复现
读完你会得到:
- "优化 KV Cache"拆成 A / B / C 三个维度,收益不可互换(第一、二章)
- vLLM 的 78.4% 和 SGLang 的 94.1% 为什么不能比,以及怎么读才对(第三章)
- 一个模型的 KV 到底多大,决定了要不要搬(第五章)
- 按症状找维度的选型判据(第七章)
- 压测时缓存污染的一个真实案例,以及怎么避免(第三、八章)
目录
- [先拆词:"优化 KV Cache"至少是三个维度](#先拆词:“优化 KV Cache”至少是三个维度 "#%E4%B8%80%E5%85%88%E6%8B%86%E8%AF%8D%E4%BC%98%E5%8C%96-kv-cache%E8%87%B3%E5%B0%91%E6%98%AF%E4%B8%89%E4%B8%AA%E7%BB%B4%E5%BA%A6")
- 三个维度分别对应哪些旋钮
- [维度 B:怎么共享------两家在这里分了岔](#维度 B:怎么共享——两家在这里分了岔 "#%E4%B8%89%E7%BB%B4%E5%BA%A6-b%E6%80%8E%E4%B9%88%E5%85%B1%E4%BA%AB%E4%B8%A4%E5%AE%B6%E5%9C%A8%E8%BF%99%E9%87%8C%E5%88%86%E4%BA%86%E5%B2%94")
- [维度 C:怎么放------论文版 Strata 换了一个维度](#维度 C:怎么放——论文版 Strata 换了一个维度 "#%E5%9B%9B%E7%BB%B4%E5%BA%A6-c%E6%80%8E%E4%B9%88%E6%94%BE%E8%AE%BA%E6%96%87%E7%89%88-strata-%E6%8D%A2%E4%BA%86%E4%B8%80%E4%B8%AA%E7%BB%B4%E5%BA%A6")
- [KV 到底有多大?决定「要不要搬」的是模型架构,不是引擎](#KV 到底有多大?决定「要不要搬」的是模型架构,不是引擎 "#%E4%BA%94kv-%E5%88%B0%E5%BA%95%E6%9C%89%E5%A4%9A%E5%A4%A7%E5%86%B3%E5%AE%9A%E8%A6%81%E4%B8%8D%E8%A6%81%E6%90%AC%E7%9A%84%E6%98%AF%E6%A8%A1%E5%9E%8B%E6%9E%B6%E6%9E%84%E4%B8%8D%E6%98%AF%E5%BC%95%E6%93%8E")
- 延伸:同一个「分层」思想,单机端的对象换成了权重
- 三个维度怎么选
- 实测边界:这次数据是怎么来的、哪里不干净
- 总结
一、先拆词:"优化 KV Cache"至少是三个维度
"KV Cache 优化"是一句被用滥的话。把它拆开,至少有三个互不重叠的问题:
| 维度 | 回答的问题 | 典型手段 | 收益形式 |
|---|---|---|---|
| 维度 A:怎么存 | 每个 token 的 KV 占多少字节?放在内存里的什么位置? | KV 量化(bf16 / int8 / q4)、块大小、页大小、内存布局 | 同样的显存装下更多 token |
| 维度 B:怎么共享 | 多个请求之间的重复前缀,怎么让它们不重复算? | 前缀缓存、块级哈希、基数树、驱逐策略 | 同样的算力处理更多请求 |
| 维度 C:怎么放 | 装不下的 KV,往哪一级放、怎么搬、什么时候搬? | 分级缓存(VRAM→RAM→SSD)、卸载/预取、缓存感知调度 | 同样的显存装下更长的上下文 |
三个维度是正交 的:你可以同时做 A、B、C。但它们的收益不可互换------这是本文最想讲清的一句话。
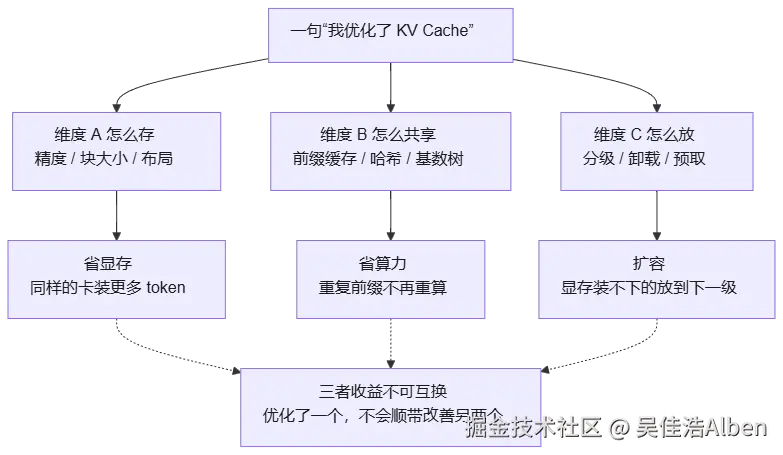
为什么必须分开谈?举一个本文实测过的例子。
压测里最容易被误读的一个数字是前缀缓存命中率 。第三章会讲到:vLLM 与 SGLang 在同一份负载下分别报出 78.4% 和 94.1%。如果不看定义,很容易得出"SGLang 的前缀缓存实现更好,领先 16 个百分点"。
但这两个数根本不是同一种统计:一个是累计计数器 (必须差分读),另一个是单次上报的瞬时值 (空闲会衰减)。口径不同、分母不同、匹配粒度还差 16 倍。它们放一起没有意义。
这就是"三个维度"之外的第二个陷阱:同一个名字底下,量的定义可能完全不同。 本文在每一处涉及数字的地方都会标注口径。
二、三个维度分别对应哪些旋钮
把三个项目按维度摆好,格局就很清楚了:它们的主战场不在同一个维度上。
| 维度 | vLLM 0.28.0 | SGLang 0.5.21 | Strata(论文版) |
|---|---|---|---|
| A 怎么存 | --kv-cache-dtype、--block-size(默认 16) |
--kv-cache-dtype、--page-size(默认 1) |
布局解耦:GPU 侧 layer-first,宿主/存储侧 page-first |
| B 怎么共享 | --enable-prefix-caching + 链式块哈希 |
Radix Cache(默认开)+ --radix-eviction-policy |
不是它的主战场 |
| C 怎么放 | --kv-transfer-config、--num-gpu-blocks-override |
HiCache:--hicache-mem-layout 等一族参数 |
主战场:GPU 辅助 I/O + 缓存感知调度 |
注意第三列:论文版 Strata 的力气几乎全在维度 C 上。它不是"又一个更快的前缀缓存",而是把 KV 从显存里抬出去、并在抬出去之后让 GPU 别闲着。
一句话概括三家的分工:
vLLM 在维度 B 上做了一个偏"粗粒度但便宜"的取舍;SGLang 在维度 B 上做了一个偏"细粒度但贵"的取舍;Strata 干脆换了维度,去做 C。
第三、四章分别展开 B 和 C。
三、维度 B:怎么共享------两家在这里分了岔
维度 B 要解决的是:多个请求带同一段前缀时,怎么让后来的请求不再重算。
这一章是两家分歧最大、也最容易被比错的地方。本章的结论来自【源码】与【实测】。
3.1 SGLang 的答案:基数树(RadixAttention)
SGLang 的做法是把所有请求的 token 序列组织成一棵基数树(radix tree),每个节点代表一段被共享的 token 序列。新请求进来时,沿着树往下匹配,能匹配到多长就把那部分的 KV 直接复用,剩下的部分才计算,算完再挂回树上。
几个实测确认的细节:
| 项目 | 实测值 | 取证方式 |
|---|---|---|
| 默认开关 | 默认就是开的 | --disable-radix-cache 才能关;启动参数 dump 里 disable_radix_cache: False |
| 淘汰策略 | lru |
启动参数 dump 里 radix_eviction_policy: 'lru',可选 lfu |
| 匹配粒度 | 单 token | page_size: 1,KV 池按单 token 分页 |
| 实现类名 | UnifiedRadixCache + RustUnifiedTreeCore |
启动日志里写的就是这个名字 |
那一行值得单独说一句:不要按文档和博客里的旧名字去找 SGLang 的前缀缓存实现 。它在容器启动日志里给自己的名字是 UnifiedRadixCache,底层核心已经换成 Rust 实现(RustUnifiedTreeCore)。以你机器上的日志为准。
3.2 共享的粒度:越细越好吗?
先给结论:不是。粒度是一个取舍,不是一道对错题。
| SGLang(token 级) | vLLM(16 token 块级) | |
|---|---|---|
| 匹配精度 | 高------只差 1 个 token 的前缀也能吃到前面那部分 | 低------不满一块的部分不算命中 |
| 管理开销 | 高------树的插入、分裂、合并、淘汰都要维护 | 低------哈希 + 字典,结构简单 |
| 实现复杂度 | 高(核心已用 Rust 重写,可作侧面印证) | 低 |
把这张表读成"SGLang 更好"是误读。它多花的管理成本换来的是更细的匹配精度,而这份精度只在"前缀高度重复且对齐得很刁钻"的负载上才回本。
也正因为两家的匹配单位不同(16 token 对 1 token,差 16 倍),同一句"命中率"在两边指的东西本来就不一样。下一节先从 vLLM 的实现讲起。
3.3 同维度里 vLLM 怎么做:块级哈希,而且是链式的
SGLang 用基数树按 token 逐层匹配,vLLM 走的是另一条路:把 KV 切成固定大小的块,对每个块算哈希,而哈希里带上父块的哈希。
vLLM 0.28.0 里这个函数只有几行(vllm/v1/core/kv_cache_utils.py:577-604):
python
def hash_block_tokens(
    hash_function: Callable[[Any], bytes],
    parent_block_hash: BlockHash | None,
    curr_block_token_ids: Sequence[int],
    extra_keys: tuple[Any, ...] | None = None,
) -> BlockHash:
    """Computes a hash value corresponding to the contents of a block and
    the contents of the preceding block(s). The hash value is used for
    prefix caching. ...

    The current block is assumed to be full.
    """
    if not parent_block_hash:
        parent_block_hash = NONE_HASH
    curr_block_token_ids_tuple = tuple(curr_block_token_ids)
    return BlockHash(
        hash_function((parent_block_hash, curr_block_token_ids_tuple, extra_keys))
)四个细节决定了它的全部行为,而且都写在源码和注释里,不需要猜:
① 哈希是链式的。 哈希 = hash(父块哈希, 本块 token, extra_keys)。所以只要任何一个块 的内容不同,它自己的哈希变了,它后面所有块的哈希也跟着全变 ------哪怕后面那些块的 token 一模一样。"前缀必须从第一个 token 开始完全一致"不是实现偷懒,是链式哈希的数学后果:中间断一次,后面全废。
② 只对完整块算哈希。 docstring 原话:The current block is assumed to be full. 不足一整块的末尾那段不参与缓存键的计算。
③ 命中同样只能是完整块。 vllm/v1/core/kv_cache_manager.py:232-234:
python
def get_computed_blocks(self, request: Request) -> tuple[KVCacheBlocks, int, int]:
    """Get the computed (cached) blocks for the request.
    Note that the computed blocks must be full.
④ 块大小默认 16。 vllm/config/cache.py:48:
python
DEFAULT_BLOCK_SIZE: ClassVar[int] = 16(第 263-264 行在 block_size is None 时套用这个值。)
把①②③④拼起来,vLLM 侧的"前缀利用率"这个量的真实含义就清楚了:
它是"这一次请求有多少个完整块,能和历史请求逐块对齐"。
不是"有多少 token 重复",也不是"公共前缀有多长"。两个 4096 token 的请求,前 4088 个 token 完全相同、只有末尾 8 个不同:按 token 算重复率 99.8%,但按 16 token 的块算,第 256 个块已经把差异带进来了 ,而由①链式哈希,从这一块往后的哈希全部不同------能命中多少,取决于从 token 0 起连续一致的完整块有几个,剩下的一律不算。
避坑 :在 vLLM 上算前缀复用收益时,不要用"公共前缀 token 数 ÷ 总 token 数",要用 "公共前缀长度向下取整到 16 的倍数" ÷ 总 token 数;且一旦中间有任何一处差异,其后的共享全部作废,不要按"多处局部重复"累加。
3.4 同一个负载,两家报出的"命中率"不是一个量
先用同一台机器、同一个压测客户端、同一份"前缀重复"数据集,两边各跑一轮【实测】:
| vLLM 0.28.0 | SGLang 0.5.21 | |
|---|---|---|
| 引擎自报的命中率 | 78.4% | 94.1% |
| 指标名 | vllm:prefix_cache_hits_total ÷ queries_total |
sglang:cache_hit_rate |
| 指标类型 | counter(累计计数器) | gauge(瞬时值) |
差了将近 16 个百分点。如果不看定义,很容易得出"SGLang 的前缀缓存实现更好"------这个结论是错的,因为这两个数根本不是同一种统计。
两个数的来源与算法(都是原始证据文件,可复核): vLLM 侧取差分 ------
results/metrics_vllm_prefix.txt的queries=1,916,417 / hits=314,384减去results/metrics_vllm_after.txt的queries=1,785,856 / hits=212,000,得本轮增量queries=130,561 / hits=102,384,102,384 ÷ 130,561 = 78.42%。 注意:直接读前缀轮快照的绝对值会得到314,384 ÷ 1,916,417 = 16.4%,那是错的 ------它包含了前面四轮随机压测的累计量。 SGLang 侧直接读results/metrics_sglang_prefix.txt的sglang:cache_hit_rate = 0.9411764705882353,即 94.1%(gauge 按上报语义,无需差分)。 这一条对照本身就说明了本节要讲的事:同一个量,一边必须差分、一边不能差分。
口径 A:vLLM 报的是"累计计数器",你必须自己差分
vLLM 导出的是两个单调递增的计数器(vllm/v1/metrics/loggers.py:584-601 定义,:1125-1130 从 scheduler_stats.prefix_cache_stats 累加)。它们的语义,源码里写得很具体。
分母是整个请求的输入 token 数 ,不是"被查询的块数"(vllm/v1/core/kv_cache_manager.py:221-230):
python
def record_prefix_cache_stats(self, request, num_hits):
    num_tokens = request.num_tokens   # 整个请求长度,含末尾那段不足整块的
self.prefix_cache_stats.record(num_tokens=num_tokens, num_hits=num_hits, ...)分子则只能是完整块的命中 (见 3.3 中 get_computed_blocks 的 docstring)。而 vLLM 默认块大小是 16------分子只数 16 token 的完整块,分母却是请求的全部 token,这个比值天然被轻微低估,每个请求最多差 15 个 token。
还有两条容易踩的:
- 只在准入时记录一次。
vllm/v1/core/sched/scheduler.py:1076-1080注释原文:# Record at admission so unscheduled lookups are not counted. - 被抢占的请求不进这两个计数。
vllm/v1/metrics/stats.py:114-142把preempted=True的样本记进preempted_queries/preempted_hits,不写queries/hits。
既然是计数器,正确读法只有一种:跑完的值减跑前的值 。直接读绝对值,你拿到的是"进程启动至今的累计量",跟本次压测无关。本节开头那个 16.4% 就是这么来的------一个纯粹由读法造成的错误数字。
口径 B:SGLang 报的是"单次上报的瞬时值",而且空闲会衰减
SGLang 导出的是 gauge(python/sglang/srt/observability/metrics_collector.py:305-306),它的语义在源码里有注释兜底(python/sglang/srt/managers/scheduler_components/metrics_reporter.py:1040):
bash
# cache_hit_rate is prefill-owned (per-report semantics)公式在 metrics_reporter.py:782-791,注意它显式扣掉了"重算"的部分:
python
effective_input_tokens = prefill_stats.log_input_tokens - prefill_stats.reprocessed_log_input_tokens
effective_hit_tokens   = prefill_stats.log_hit_tokens   - prefill_stats.reprocessed_log_hit_tokens
total_tokens   = effective_input_tokens + effective_hit_tokens
cache_hit_rate = effective_hit_tokens / total_tokens if total_tokens > 0 else 0.0这一步最要命(metrics_reporter.py:823 注释原文):
bash
# the gauge must decay rather than hold.空闲要衰减,不能挂住。 也就是说:这个数字反映的是"最近一次上报周期"的命中情况,不是"从启动到现在"。实测中,纯随机负载下它读数是 0.0;而"前缀重复"数据集刚跑完读数是 0.9412。
还有一个同名但不同用途 的量要分清:
metrics_reporter.py:55定义了CACHE_HIT_RATE_WINDOW_SECONDS,:65-83的_CacheHitRateWindow(deque + 过期popleft)算出recent_cache_hit_rate,它是给路由和负载均衡决策用的 (managers/load_inquirer.py:83:cache_miss_rate = 1.0 - self.get_recent_cache_hit_rate()),不是 Prometheus 上那个sglang:cache_hit_rate。
为什么这两个数不可对撞
| 维度 | vLLM | SGLang |
|---|---|---|
| 类型 | counter(累计) | gauge(单次上报瞬时值) |
| 空闲时 | 计数不变,等你差分 | 衰减(源码原话 decay rather than hold) |
| 分母 | 请求全部输入 token(含不满整块) | input + hit,已扣除重算 |
| 抢占 / 重算 | 记入 preempted_*,不进导出的计数 |
从分子分母同时减掉 |
| 匹配粒度 | 16 token 的完整块 (block_size=16) |
本次实测 page_size=1,单 token 分页 |
三条差异各自独立,任意一条都足以让两个数无法直接比较。粒度那一行尤其要注意:同一段"只差末尾几个 token"的公共前缀,两边损失不一样,这不是实现优劣,是取舍不同。
避坑 :SGLang 的
page_size自 0.5.21 起可以按模型族 override (srt/arg_groups/overrides.py里出现过 64 与 128)。本文的page_size=1是本次这个模型 + 这套参数下的实测值,换模型必须重新确认,不要当成恒定默认值引用。
一个反面教材:纯随机负载怎么会报出 11.9% 命中率?
第一次扫描时,我在纯随机 数据集上看到 vLLM 报出 11.9% 的前缀缓存命中率(212,000 / 1,785,856)。纯随机生成的 prompt 之间不可能有公共前缀,这个数字本身就该报警。
根因不在引擎,在压测方法 :vllm bench serve 的随机数据集是可复现 的,且 --seed 默认 0(vllm/benchmarks/datasets/datasets.py:1608)。同一个随机种子必然生成同一批 prompt(datasets.py:567-568 的 token 序列是 (offset + index + arange(input_len)) % vocab_size,offset 来自 np.random.default_rng(random_seed))。而服务端的前缀缓存跨轮次不重置,于是后面的轮次命中了前面轮次留下的 KV。
我在当初那台压测客户端里直接实例化了同一个 RandomDataset 做验证:同一个 num_prompts 跑两次,prompt 序列逐 token 完全相同。
对账(按 16 token 完整块模拟,缓存容量取实测的 194,896 token):
| 轮次 | 并发 | 预测命中 token | 占该轮输入 |
|---|---|---|---|
| 第 1 轮 | 1 | 0 | 0%(冷启动) |
| 第 2 轮 | 16 | 81,840 | 62% |
| 第 3 轮 | 64 | 130,944 | 25% |
| 第 4 轮 | 128 | ~0 | ~0%(第 3 轮插入 524,288 token,把池子冲干净了) |
| 合计 | 212,784 | 实测 212,000,差 0.37% |
也就是说:那次扫描的四个点里,只有并发 1 和并发 128 是干净的,并发 16 有 62% 的输入吃了缓存、并发 64 有 25%。这直接决定了第八章引用那批数字时必须带的偏差标注。
vLLM 官方基准工具正是这么防的 :vllm/benchmarks/sweep/server.py:15-19 定义了 VLLM_RESET_CACHE_ENDPOINTS = ["/reset_prefix_cache", "/reset_mm_cache", "/reset_encoder_cache"],:121-131 的 reset_caches() 在每轮压测后逐个 POST;如果服务器不是 vLLM,它直接抛 NotImplementedError,要求你自己用 --after-bench-cmd 补上。官方的立场很清楚:轮次之间不重置缓存,数据不可比。
SGLang 侧的对应端点是 /flush_cache,官方还给了 CLI:
bash
python3 -m sglang.srt.mem_cache.flush_cache --url http://localhost:30000(python/sglang/srt/mem_cache/flush_cache.py:20,32)
避坑 :多轮压测扫描时,每一轮之间必须重置缓存 (vLLM:
POST /reset_prefix_cache;SGLang:POST /flush_cache),并且给每一轮换一个--seed。两条都做才算干净。只做一条会有残留:只换 seed 不重置,池里的旧块还在;只重置不换 seed,prompt 仍是同一批(只是这一轮自己冷启动了)。
本节结论
引擎自报的"缓存命中率"不是一个可以横向比较的量。 口径不同(累计 vs 瞬时)、分母不同(全部 token vs 扣重算)、粒度不同(16 token vs 1 token),三个差异叠加,数值放在一起没有意义。
需要横向比较时,统一改用外部可观测指标:TTFT、端到端时延、吞吐。这些量由压测客户端独立测量,不依赖引擎自己的统计口径。
四、维度 C:怎么放------论文版 Strata 换了一个维度
本章证据说明 :除 4.4 节的 SGLang 参数(【实测】,取自本机
--help与启动 dump)外,本章的性能数字(22%、50 GB/s、5 倍 TTFT 等)均为 【论文】 数据,我没有复现 。4.2 节与 4.5 节中基于论文平台带宽的换算,是类比推算,不是本机实测。
4.1 维度 C 要解决的是容量,不是速度
维度 A 和 B 都在同一级内存内部 做文章:A 让每个 token 占得更少,B 让同样的前缀不用重算。维度 C 换了一个问题:显存装不下的那部分 KV,放到下一级去。
这笔账的物理事实很简单:搬出去省的是容量,付出的是带宽和延迟。
论文给了一个很直观的容量账:40 GB 的 HBM,对 Llama-8B 只能装大约 0.3M token(arXiv:2508.18572 第 2 节)。也就是说几十份长文档、几百轮对话就能把它吃干净。
而"搬"这件事如果不解决,后果不是变慢一点,而是变得更慢 :论文 Figure 1 展示的是把 KV 卸载到 CPU 内存后,TTFT 被直接抬高------加载本身成了瓶颈 。这就是维度 C 的全部难点:它不是"能不能搬",而是"搬的时候 GPU 别闲着"。
4.2 先看一个残酷的数字:22%
论文第 3.1 节的标题就叫"KV Cache 传输中的低带宽利用率"。里面的实测结论是:
传输 8192 个 token 的 KV 数据,只能跑到理论 PCIe 5.0 带宽的约 22%(page size 设为 32,这是前人分级 KV 缓存工作推荐的值)。
原因在碎片化:KV 在显存里往往是非连续页,导致单次传输只有几 KB,撑不满 PCIe 。论文给的另一个方向性结论是:想跑到理论带宽的 75--80%,单次传输量得做到 1--2 MB 级别。
把这个数字套到 Qwen2.5-7B 上做一个类比推算 (用的是论文平台的带宽,不是我本机 RTX 5090 的实测值):
text
Qwen2.5-7B 的 KV = 57,344 B/token(第五章会算)
8192 token 的 KV = 8192 × 57,344 B ≈ 448 MiB

论文平台单卡 PCIe 5.0 x16 峰值 = 64 GB/s(论文平台参数)
  跑到 22% → 14.1 GB/s → 448 MiB 需要约 33 ms
  跑到 75% → 48 GB/s   → 448 MiB 需要约 9.7 ms
同一块数据,仅仅因为"传得整不整",差 3 倍以上。 而这 30 毫秒级的差异,在 TTFT 里是直接可见的------尤其当你要为每个新请求搬一遍上下文的时候。
论文还给了理论工具:按 Little 定律,并发度 C = λ · L,而吞吐 X = λ · S(S 是单次 I/O 的平均数据量)。两式合并说明:要维持吞吐,就得把 S 做大,或者把并发度做高。 碎片化刚好把 S 压到了最小。
4.3 Strata 的四个机制
论文摘要里一句话概括了它的做法(原文):
Strata introduces GPU-assisted I/O to combat KV cache fragmentation, decoupling GPU and CPU memory layouts and employs cache-aware request scheduling to balance compute with I/O latency and overlapping unavoidable stalls with complementary tasks. Built on SGLang...
拆成四条:
| 机制 | 解决什么 | 论文位置与关键数字 |
|---|---|---|
| GPU 辅助 I/O | 代替反复调用小粒度的 cudaMemcpyAsync,用 GPU 自己来搬,专治碎片化小传输 |
§4.2:只用 2 个 CUDA block × 1024 线程 ,达到接近 50 GB/s 的传输吞吐,而 prefill 性能损失 不到 5% 、decode 损失 10% |
| 布局解耦 | GPU 里保持算得快、宿主/磁盘上保持搬得快 | §4.2.1、§5.3.4:GPU 侧保留 layer-first (贴合逐层计算),宿主内存与外部存储改用 page-first(大块连续、传输效率高) |
| 缓存感知调度 | 让计算与 I/O 重叠,而不是排队等 | §4.3:含延迟命中时的让路(4.3.1 Deferral on Delay Hit)、均衡批次构造(4.3.2 Balanced Batch Formation) |
| 气泡填充 | 把"不可避免的加载停顿"用别的任务填满 | §4.3.3 Hide Loading Stall with Bubble Filling |
第三条和第四条值得单独强调:前面两条是把 I/O 做快 ,后面两条是在 I/O 快不了的时候别浪费 GPU。真正做过长上下文服务的人会知道,后半句往往比前半句更难------因为调度器必须知道"哪块 KV 在显存里、哪块在下一级、这次请求要等多久"。
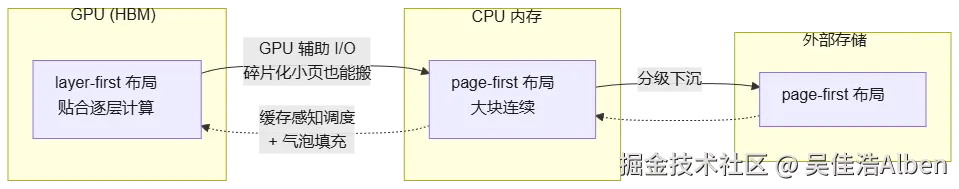
4.4 维度 C 早就被工程化了:看 SGLang 的 HiCache
必须说清一点:"把 KV 分级"不是论文的发明,工程上早就在做了。 本文实测的 SGLang 0.5.21 里就有一整套 HiCache 参数,其中内存布局这一项直接就有五个取值:
text
--hicache-mem-layout {layer_first,page_first,page_first_direct,page_first_kv_split,page_head}(取自本文环境里的 sglang.launch_server --help 实际输出。)
而本次实测的启动参数 dump 里,它是 hicache_mem_layout: 'page_first'------默认就选了"搬得快"的那一侧。
把论文和工程参数对照一下,会看到同一件事的两种说法:
| 论文里的机制 | SGLang 里的对应物 |
|---|---|
| 布局解耦 | --hicache-mem-layout layer_first / page_first / page_first_kv_split / ... |
| 分级下沉到宿主 | HiCache 的 host 层参数家族 |
| 让计算与 I/O 重叠 | --enable-overlap-schedule(实测默认开) |
所以论文版 Strata 的价值不在于"发明了分级",而在于把"为什么不快、怎样才能快"量化清楚了------22% 那个数字、1--2 MB 的传输量门槛、以及把加载停顿显式当成一个调度对象来处理。这是工程实现里通常不会写进文档的部分。
4.5 但维度 C 有硬件前提
论文的两套实验平台,带宽差一个量级【论文】:
| 平台 | 内存/链路 | 论文原文给出的带宽 |
|---|---|---|
| PCIe 平台 | 每张 GPU 通过 PCIe 5.0 x16 连 CPU | 64 GB/s(单向峰值) |
| GH200 | H100 + Grace 64 核 ARM,464GB LPDDR5X | 384 GB/s(单向) |
按这个换算搬 1 GiB KV 的时间(数量级,同样是类比推算):
text
1 GiB ÷ 384 GB/s ≈ 2.8 ms     ← GH200 的 CPU 内存
1 GiB ÷  64 GB/s ≈ 16.8 ms    ← 普通 PCIe 平台
差 6 倍。所以论文那个"TTFT 最多降低 5 倍"(对比 vLLM + LMCache)是在它那套硬件 + 长上下文负载 下测出来的,不能直接搬到单卡消费级平台上期待同样的倍数。
这也解释了为什么维度 C 在个人开发者眼里常常"听着很美、用起来不划算":它的收益上限由你的内存带宽和 KV 体量共同决定。 而 KV 有多大,正好是下一章的内容。
本文的一个局限:维度 C 这一章,我没有做自己的分级缓存 TTFT 实测,结论依赖论文数据与参数/源码核对。
五、KV 到底有多大?决定「要不要搬」的是模型架构,不是引擎
谈了一整章「KV 可以搬出 GPU」,但有个问题得先回答:这块 KV,值得搬吗?
答案不在引擎里,在模型架构里。KV 的大小可以用一个公式直接算出来:
每 token KV 字节数=2(K+V)×全注意力层数×KV 头数×head_dim×每元素字节数
把两个模型代进去,差别会比直觉大。
5.1 两个模型,同一台机器,同一个公式
| 项 | Qwen2.5-7B-Instruct | Qwen3.8-Flash-Next (IQ3_S) |
|---|---|---|
| 类型 | Dense | MoE,125B 级 / 24,576 experts |
| 全注意力层数 | 28 / 28 | 12 / 48(其余 36 层为 GDN) |
| KV 头数 | 4 | 2 |
| head_dim | 128 | 256 |
| KV 精度 | bf16(2 字节) | int8(1 字节) |
| 公式值 | 57,344 B = 56.0 KiB | 12,288 B = 12.0 KiB |
| 实测口径 | 56.0 KiB/token | 20.3 KiB/token |
| 数据来源 | vLLM 10.41 GiB ÷ 194,896 token = 57,352 B(偏差 0.014%);SGLang 11.2534 GiB ÷ 210,714 token = 57,344 B(偏差 0.000%) | docs/INTEL.md:81 实测约 20 KiB/token;32K→128K 显存增量 1.90 GiB ÷ 98,304 token = 20.27 KiB/token(docs/INTEL.md:84-89 表格差值:30.3 − 28.4) |
两个数字都是反算出来的,不是抄文档:7B 那一侧用两个引擎自己的显存记账倒推,125B 这一侧用仓库实测的显存增量倒推,两条路互不依赖。
顺带一个单位坑:SGLang 的指标名是
kv_cache_memory_usage_gb,实际单位是 GiB。按 GB 算,公式对不上。
5.2 结论:大 17.9 倍的模型,KV 反而小 2.8 倍(统一精度后约 1.4--1.8 倍)
go
模型规模比    125B ÷ 7B                    ≈ 17.9 倍
KV 每 token   20.3 KiB ÷ 56.0 KiB         ≈ 0.36  →  小 2.8 倍(bf16 对 int8 的口径)
口径提醒 :2.8 倍里有相当一部分是精度差(bf16 对 int8)贡献的。统一到同一精度后约为 1.4--1.8 倍,取决于 indexer keys 是否随精度变化,折算过程见 5.5。
参数量涨了 18 倍,KV 反而更小。这不反常识 ------ 它只是说明参数量和 KV 容量是两件不相干的事,前者由专家数量决定,后者由注意力结构的形状决定。
5.3 三个因素叠乘
125B 这一侧的 20.3 KiB 不是压缩出来的,是三层结构叠出来的:
| 因素 | 效果 | 出处 |
|---|---|---|
| 48 层里只有 12 层是全注意力 ,其余 36 层是 gated-delta-net,固定尺寸循环状态,不随上下文增长 | 只算 1/4 的层 | docs/INTEL.md:78-79 |
| GQA 48 : 2 = 24 : 1(48 个 query 头对 2 个 KV 头) | 极端共享 | setup5.log:266-270 张量形状:q_proj 12288 = 48 × 256,k_proj / v_proj 512 = 2 × 256 |
| int8 KV(不是 fp16) | 再省一半 | 运行配置 strata-iq3_s.json 的 --kv int8 |
前两项是训练时就定下的架构,改不了;第三项(精度)引擎可调,但代价直接体现在质量上。
5.4 那 7.5 KiB 的差额是 indexer 的 keys
按公式,125B 的 QSA 层只需要 12.75 KiB/token(含 q8_0 分块开销),但实测是 20.3 KiB。差的 7.5 KiB 有明确出处:
ini
self_attn.indexer.index_qk_proj.weight   q8_0   640 × 2560
self_attn.indexer.k_layernorm.weight     f32      1 × 128
self_attn.indexer.q_layernorm.weight     f32      1 × 128
        → indexer head_dim = 128,640 = 5 × 128
        → indexer keys = 640 元素 × 12 层 = 7.5 KiB/token

12.75(QSA 的 K/V) + 7.5(indexer keys) = 20.25 KiB  ≈  实测 20.3 KiB
稀疏注意力的 indexer 需要自己一份 key 索引,这份索引跟着上下文一起长,所以它必须算进 KV 账里。差值闭合到 0.05 KiB。
5.5 口径声明
| 必须说明 | 内容 |
|---|---|
| 精度不同 | 7B 是 bf16,125B 是 int8。把两边统一到同一精度,倍数从 2.8 降到约 1.8 倍 (折算:QSA 的 K/V 脱掉 q8_0 分块开销按公式值 12.0 KiB 翻倍为 24.0,indexer keys 视为不随 --kv 变化仍为 7.5,合计 31.5 KiB,56.0 ÷ 31.5 ≈ 1.8)------ 2.8 倍里有相当一部分是精度差贡献的,架构差是剩下的那 1.8 倍。该折算依赖"indexer keys 不随精度翻倍"这一假设;若 indexer keys 也随精度翻倍(合计 40.5 KiB),倍数为 1.4 倍 |
| 架构不同 | 一个是 28/28 层全注意力的 Dense,一个是 12/48 层的混合架构。这正是本章的论点,不是缺陷 |
| 12.75 KiB 的地位 | 它只算 12 层 QSA 的 K/V,不含 indexer keys。引用时必须带上这句,否则会低估 37% |
| 单引擎、单版本 | 7B 那两个数来自 vLLM 0.28.0 / SGLang 0.5.21;125B 那个数来自 Strata v0.1.40.2。换版本、换量化档都要重算 |
| 与第 3.4 节的口径 | 本章这两个数都是从显存记账反算 的(vLLM 的 KV 池容量、Strata 的显存增量),不是引擎自报的命中率,因此不受"两个口径不可对撞"影响。凡要引用命中率,请先看 3.4 节的口径定义(vLLM 是需差分的累计计数器,SGLang 是会衰减的瞬时 gauge,两者不可直接对比) |
5.6 推论:值不值得搬,看模型
- 7B 这类 Dense 模型:28 层全是全注意力、4 个 KV 头,KV 是货真价实的容量瓶颈 ------ 32K 上下文就要 1.75 GiB,128K 要 7 GiB。把 KV 搬出 GPU,省下的是实打实的显存
- 12/48 层的混合 MoE :128K 上下文的 KV 一共约 2.5 GiB。搬它省不下多少,它的容量压力在权重那一侧
这就是为什么「KV 能不能离开 GPU」这个问题的答案,取决于你先问「这是哪个模型」。
六、延伸:同一个「分层」思想,单机端的对象换成了权重
本章是主线之外的延伸,讲的是另一个同名项目。只关心三维度的读者可以直接跳到第七章。
第五章算出了单机模型的 KV 只有约 2.5 GiB。那这台机器的显存到底被什么吃掉的?
答案把「分层」这件事从 KV 拉到了另一个对象上。
6.1 先把两个同名项目分掉
本文提到「Strata」时,指的是两个同名、但不同源的项目:
| Strata(服务器端) | Strata(单机端) | |
|---|---|---|
| 载体 | arXiv:2508.18572 / OSDI '26 正式论文 | github.com/Niko1221/Strata |
| 定位 | 长上下文 KV 分级缓存 | 单机跑 125B 级 MoE |
| 底座 | built on SGLang | llama.cpp / ggml 血统 |
| 分层的对象 | KV | 专家权重 + KV |
两者无代码、无论文、无血缘关联,只是都选了「Stratified / 分层」这个词。第四章讲的是左边那个,本章讲右边那个。
6.2 单机端的三层各装什么
| 层 | 装什么 | 出处 |
|---|---|---|
| VRAM | 热专家(11,754 个 / 22.30 GiB)+ 注意力与 GDN 层 + MTP 草稿层 + KV 最热的 32K 窗口 | server.log:16 |
| RAM | 全部 24,576 个专家 (pinned,46.84 GiB);没上卡的专家由 CPU 就地计算,与 GPU 同时跑(AVX-512 / AVX2 kernel) | server.log:15、docs/HOW_IT_WORKS.md:27-28 |
| SSD | 28.8 GB 的 n-gram 表 ------ 是权重,不是 KV | docs/HOW_IT_WORKS.md:31 |
注意 SSD 那一行:单机端的第三层装的是权重表,不是 KV。这和服务器端的分层结构形状相同、对象不同。
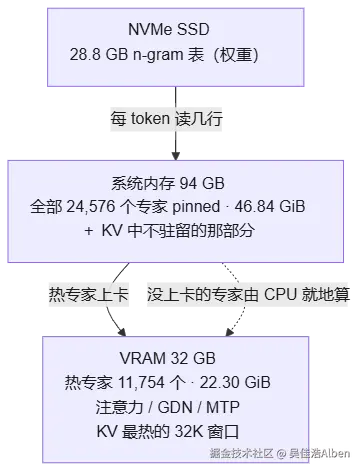
6.3 为什么单机端分层的是权重
把全量账摊开(这台机器的 IQ3_S):
磁盘总计  88.83 GB
  ├─ models 83.62 GB(shard1 54.82 + shard2 28.80)
  ├─ MTP     5.21 GB
  │
  ├─ 专家权重        50.30 GB(46.84 GiB)  → 常驻 RAM
  ├─ PLE / n-gram 表 28.80 GB               →  SSD
  └─ dense + MTP     约 9.7 GB             →  VRAM
对比一下同一次运行里的 KV:
| 对象 | 大小 | 比值 |
|---|---|---|
| 专家权重(RAM) | 46.84 GiB | 19 × |
| 128K 上下文的 KV | 约 2.5 GiB | 1 × |
19 倍。 所以单机端的主战场是权重,不是 KV。KV 确实也做了分级 ------ 从 64K 起只把最常读的部分留在显存、其余从 RAM 流式取(docs/HOW_IT_WORKS.md:23,对应宿主机 运行配置里的 --kv-resident 32768)------ 但它是顺手做的第二件事,不是这个引擎存在的理由。
容器与宿主机不是同一种行为,KV 数字不能混用 :上述
--kv-resident 32768与「64K 起分级」来自宿主机 运行(strata-iq3_s.json:22-27;setup5.log:274的KV cache lives in RAM (1.8 GB))。在容器(WSL)里跑时,setup 打的是WSL: KV streaming off (the driver pins only about 1 GB of RAM); the KV cache stays in VRAM,且 settings dump 里没有--kv-resident------ 容器里 KV 常驻显存、不做流式分级。本章的 2.5 GiB 与 1.8 GB 都取宿主机口径,引用容器数字时必须重新标注。
一个引用细节:引擎日志里的46.84 GiB是专家权重 (experts loaded),不是「125B 模型的全部参数」。把两者划等号会低估磁盘和显存账,也让「参数多大、KV 多大」的关系失真。
6.4 一条可迁移的经验
把两章放在一起,会看到同一个判断在两边都成立:
瓶颈在哪一层,就对哪一层做分层。
| 场景 | 容量瓶颈 | 分层的对象 |
|---|---|---|
| 服务器端多并发长上下文 | KV 池被并发请求撑爆 | KV(GPU → RAM → SSD) |
| 单机端跑超大 MoE | 24,576 个专家塞不进显存 | 专家权重(热的上卡,全量在 RAM,表在 SSD) |
这也是为什么「分层缓存」不是一个特定引擎的发明,而是一个随瓶颈移动的手段。谁在读这篇文章、跑的是什么模型,答案就不同。
七、三个维度怎么选
三个维度不是三选一,而是三个可以叠加的旋钮 。但顺序有讲究:先省、再复用、才轮到扩容。
理由很实际:能不能装下是硬约束,装不下的部分再去复用也是白搭;而扩容(维度 C)要付出带宽代价,只有在 A 和 B 都做满之后才划算。
7.1 按症状找维度
| 你遇到的现象 | 瓶颈维度 | 先动什么 |
|---|---|---|
| 上下文一加长就 OOM,并发提不上去 | A | --kv-cache-dtype 降精度、确认块/页大小;先算清每 token 占多少(第五章) |
| 显存够、并发也上去了,但 TTFT 高 | B | 前缀缓存是否开、前缀是否按块对齐(3.3 节) |
| 预算够、显存够,就是装不下 128K | C | 分级(HiCache 一族参数);先确认内存带宽账(4.5 节) |
| 长上下文首 token 特别慢,明显在"等加载" | C | 分级 + 调度重叠,而不是继续调并发 |
| 单机跑超大 MoE,显存被权重吃光 | 不在 KV 维度 | 那是权重分层,见第六章 |
| 引擎自报命中率低,但吞吐看着还行 | 先查口径 | 可能是口径问题,不是性能问题(3.4 节) |
7.2 三个常见误判
误判一:把 A 的收益算成 B 的。
"我把 KV 精度降到 int8 了,为什么前缀缓存命中率一点没变?"
因为精度属于维度 A,命中率属于维度 B。降精度让每个 token 占得更少 (于是同样显存能装更多 token,并发上限提高),但它不会让两个请求的前缀变得更像。收益不会跨维度转移。
误判二:把 C 的需求当成 B 的需求。
"我装不下 128K,是不是前缀缓存没开好?"
前缀缓存省的是重复计算 ,不是容量。请求之间没有公共前缀时(比如每个用户问的都是全新的长文档),前缀缓存命中率接近 0,维度 B 一点忙都帮不上------这时候该做的是维度 C。
反过来也一样:如果请求高度重复(比如同一个长系统提示词加不同问题),维度 B 的收益可能远大于 C,而且便宜得多(不需要搬数据)。
误判三:用引擎自报的命中率做横向对比。
第三章已经算过这笔账:口径不同(累计对瞬时)、分母不同、粒度差 16 倍。要比就比外部可观测指标。
7.3 一条判据
如果只记一句话:
先问"省不省得下"(A),再问"要不要重算"(B),才轮到问"搬不搬得动"(C)。
省得下且不用重算,就没必要搬;省不下又必须支持长上下文,才轮到 C 出场。
7.4 避坑速查表
| 场景 | 坑 | 正确做法 | 详见 |
|---|---|---|---|
| 算 vLLM 前缀复用收益 | 用"公共前缀 token ÷ 总 token" | 向下取整到 16 的倍数;中间一处不同,其后全作废 | 3.3 |
| 读 vLLM 命中率 | 直接读累计计数器的绝对值(得到 16.4%) | 跑完的值减跑前的值 | 3.4 |
| 读 SGLang 命中率 | 当成累计值,或在空闲后读取 | 它是单次上报的瞬时 gauge,空闲会衰减 | 3.4 |
| 横向比较两个引擎 | 比引擎自报的命中率 | 比 TTFT、端到端时延、吞吐 | 3.4 |
| 多轮并发扫描 | 轮次之间不重置缓存,且 seed 不变 | 每轮 reset(/reset_prefix_cache / /flush_cache)并换 seed |
3.4、8.3 |
| SGLang 取指标 | --enable-metrics 默认 False |
显式打开 | 8.4 |
引用 page_size |
把 1 当成恒定默认值 | 换模型必须重新确认 | 3.4 |
| 估算 KV 大小 | 只看公式、不看 indexer keys | 把 indexer keys 算进去 | 5.4 |
| 引用日志行 | 直接引用二手日志 | 自己先 grep 一遍 | 8.4 |
八、实测边界:这次数据是怎么来的、哪里不干净
这一章交代本文所有实测数字的来源与限制。包括已知的偏差------因为一份不写边界的压测数据,比没有数据更危险。
8.1 环境(实跑取证)
| 项目 | 实测值 | 取证方式 |
|---|---|---|
| GPU | RTX 5090,32607 MiB,sm_120(Blackwell) | nvidia-smi + torch.cuda.get_device_capability() |
| 驱动 | 617.14 | nvidia-smi |
| 容器环境 | Docker Desktop 4.47.0 / Engine 28.4.0 | docker info |
| 模型 | Qwen2.5-7B-Instruct,bf16,28 层 / 4 个 KV 头(GQA) | config.json |
| vLLM | vllm/vllm-openai:v0.28.0-cu129 |
容器内 vllm.__version__ |
| SGLang | lmsysorg/sglang:latest,容器内实际是 v0.5.21 |
容器内 sglang.__version__ |
8.2 两边对齐的参数
| 维度 | vLLM | SGLang | 取值 |
|---|---|---|---|
| 上下文长度 | --max-model-len |
--context-length |
32768 |
| 显存占用比例 | --gpu-memory-utilization |
--mem-fraction-static |
0.85 |
| 最大并发 | --max-num-seqs |
--max-running-requests |
128 |
| 单步 token 预算 | --max-num-batched-tokens |
--max-prefill-tokens |
8192 |
| chunk 切分 | (V1 默认开) | --chunked-prefill-size |
8192 |
| 前缀缓存 | --enable-prefix-caching |
(Radix 默认开) | 开 |
| 指标端点 | /metrics 默认可用 |
--enable-metrics |
开 |
8.3 已知偏差:四点扫描存在前缀缓存污染(必须标注)
本文引用的 vLLM / SGLang 四点并发扫描数据(并发 1 / 16 / 64 / 128),是在没有重置前缀缓存的情况下连续跑出来的,因此存在跨轮次污染:
| 轮次 | 并发 | 该轮输入中被缓存命中的比例 | 是否干净 |
|---|---|---|---|
| 第 1 轮 | 1 | 0% | 干净 |
| 第 2 轮 | 16 | 62% | 被污染 |
| 第 3 轮 | 64 | 25% | 被污染 |
| 第 4 轮 | 128 | ~0% | 干净 |
原因在 3.4 节已交代:vllm bench serve 的随机数据集默认 --seed 0 且可复现,服务端前缀缓存跨轮次不重置,后一轮命中了前一轮留下的 KV(预测 212,784 对实测 212,000,差 0.37%)。
这个偏差对结论的影响,必须说清楚:
- 不能用的 :那条"吞吐在并发 64 见顶、128 回落"的曲线形状。因为 64 那个点吃了 25% 的缓存红利,而 128 那个点没有------三个点不在同一个口径上,形状自然不可信。
- 可以用的 :并发 1 与并发 128 这两个端点(0% 污染),以及两边的 KV 池容量、每 token KV 字节数这类与命中率无关的静态量。
- 需要标注的 :凡本文出现"同负载""同一份负载"之类的表述,都指压测客户端、数据集、参数对齐 ,不表示缓存状态干净。
如果要把这条曲线重新做干净,正确做法是每一轮之间都做两件事(缺一不可):
bash
# vLLM:每轮之间重置前缀缓存
curl -X POST http://vllm-host:8000/reset_prefix_cache

# SGLang:每轮之间刷缓存(官方也提供了 CLI)
python3 -m sglang.srt.mem_cache.flush_cache --url http://sglang-host:30000
外加给每一轮换一个 --seed。本文没有重跑这组数据,所以这里如实标注,而不是把它当成干净的曲线引用。
8.4 只有实跑才会踩到的坑
| 现象 | 实测 | 教训 |
|---|---|---|
| vLLM 容器启动即崩 | RuntimeError: UVA is not available |
WSL2 上 pinned memory 默认关,必须加 -e VLLM_WSL2_ENABLE_PIN_MEMORY=1 |
| 两个引擎同时起 | 32GB 卡放不下两份 0.85 显存配额 | 必须串行:一个压完停掉、显存回落,再起下一个 |
| 三个 GPU 租客同时在卡上 | vLLM 等了 8 分钟 未就绪,最终 Exited(255) |
起任何引擎前先 nvidia-smi 确认显存回落,否则白等 |
| 多轮压测没重置缓存 | 后续轮次命中率被前面轮次污染(最高 62%) | 每轮之间重置缓存加换 seed,缺一不可 |
| SGLang 指标端点取不到 | --enable-metrics 默认 False |
不显式打开,/metrics 里什么都没有 |
| 二手日志里的"KV 分级"那一行 | 在宿主机与容器两种运行的日志里全量 grep 均无命中 | 那行是伪日志 ;真实出处是运行配置与 setup 日志里的 KV cache lives in RAM (1.8 GB)。引用任何日志行之前先自己 grep 一遍 |
SGLang 的 page_size |
本次实测为 1 |
0.5.21 起它可按模型族 override(出现 64 与 128),换模型必须重新确认 |
8.5 想复现或再往深挖
四条最低要求:
- 固定硬件与驱动,并在报告里写明(本文:RTX 5090 / 617.14 / sm_120)
- 两边参数对齐 (8.2 的表就是为此存在),尤其别漏
--enable-metrics与并发上限 - 每一轮之间重置缓存加换 seed(8.3 的脚本)
- 写清口径:命中率一律注明是"累计差分"还是"单次上报瞬时值",两者不放在同一张表里比
九、总结
核心论点:
- vLLM、SGLang、Strata 优化的是 KV Cache 的三个不同维度(存 / 共享 / 放),收益不可互换。"优化了 KV 却不见 TTFT 下降",通常是维度错配,不是实现问题。
- 在"共享"这一维,两家取舍不同:vLLM 是 16 token 的链式块哈希(便宜、粗粒度),SGLang 是单 token 的基数树(精细、管理成本高)。这是取舍,不是优劣。Strata 则换到"放"这一维,用 GPU 辅助 I/O 和缓存感知调度压低搬数据的代价。
方法论提醒:
- 引擎自报的命中率不能横向比。78.4% 对 94.1% 不是 16 个百分点的差距,而是累计计数器与瞬时 gauge 两个不同的量。要比,就用 TTFT、端到端时延、吞吐。
- 本文四点并发扫描带有已知的前缀缓存污染(并发 16 有 62%、并发 64 有 25% 的输入命中了前一轮的缓存)。曲线形状不可用于结论,两个端点和静态量可用。
一句话判据: 先问"省不省得下"(A),再问"要不要重算"(B),才轮到问"搬不搬得动"(C)。
声明
本文数据来自本机实跑与镜像内源码核对,论文数据已单独标注、未复现。第八章标注的缓存污染是我自己测出的偏差,如实保留。文中两个 Strata 为同名不同源的项目,请注意区分。如有疑议,欢迎留言讨论。