作者:载云
一次 AI 请求返回了 200,监控显示总耗时 3 秒,用户却说"回答卡住了"。问题可能是前 2.4 秒没有任何内容,也可能是 200 毫秒就开始输出、随后在中途停顿了近 2 秒。两次请求的总耗时相同,体验和排查方向却完全不同。
大模型对话、智能客服和 Agent 应用越来越多地通过 Server-Sent Events(SSE)逐段输出结果。传统 HTTP(S) 拨测能回答请求是否成功、DNS 和建连是否正常、整体耗时多少;但在流式响应中,收到响应头不代表用户已经看到内容,总耗时也不能说明内容输出是否连续。
阿里云云监控云拨测是一款面向网络探测的监控产品,通过不同地域、运营商的探测点模拟真实用户访问,持续监测目标服务的可用性、访问时延与网络质量,支持 HTTP(S)、DNS、PING 等多种协议,帮助用户发现服务异常、评估访问体验,并为部署架构优化提供依据。
面向 AI 应用的流式交互场景,SSE 拨测进一步将观察点从"响应是否返回"推进到"响应流如何到达":从选定探测点主动发起真实 HTTP(S) 请求,识别 SSE 响应,按完整事件计时,提供首事件等待时间、事件间隔分布、事件数量和流持续时间等指标。本文介绍这套能力解决的诊断盲点、指标口径、使用方法与适用边界。
传统拨测在流式场景中的三个断点
SSE 响应的 MIME 类型为 text/event-stream。服务端可以在同一条 HTTP 响应中持续发送事件;一个事件可以包含多行 data:,由空行结束。注释行也可作为心跳,而不会形成业务 data 事件。(SSE 协议格式 ** **1 。)
对于这种响应,只看 HTTP 状态和一次请求的总耗时,会留下三个断点:
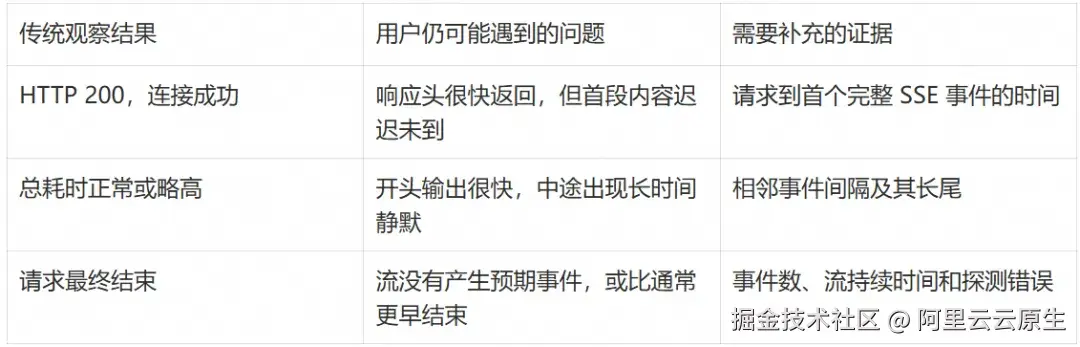
这些断点不能只靠"再加一个总耗时阈值"解决。一个阈值同时覆盖首事件等待和流内停顿时,既难解释异常,也容易把两种不同的问题混为一谈。
从探测点到指标:AI SSE 拨测的工作链路
云拨测从探测点模拟用户访问,可观察不同地域和运营商线路到目标服务的访问表现。(站点监控产品说明 ** **2 。)AI SSE 拨测沿用 HTTP(S) 请求能力:可配置目标地址、请求方法、请求头、请求体、探测点、频率和超时;在此基础上增加对流式事件的读取与计时,不要求在被测应用中安装专用 SDK。
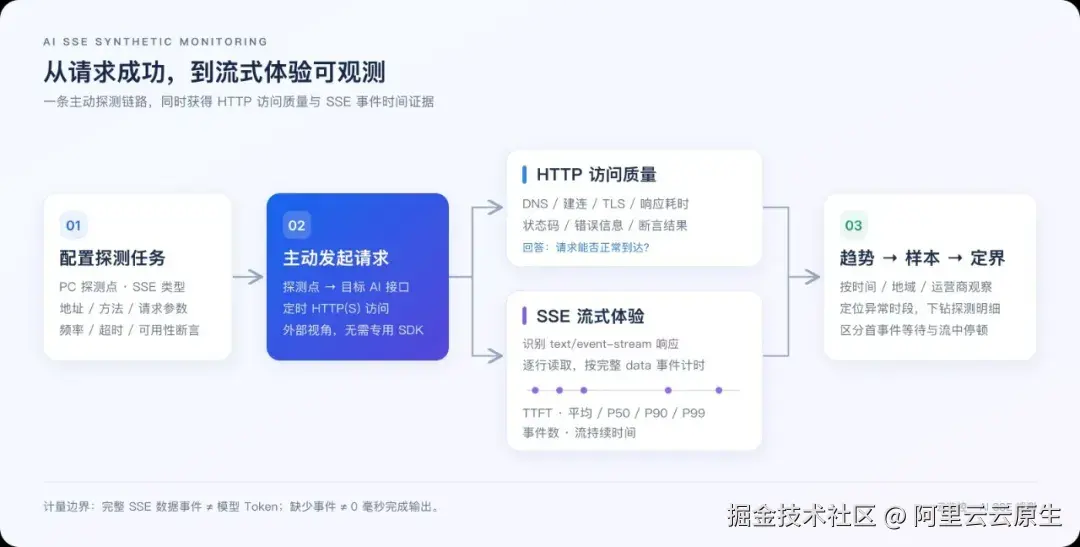
图 1:一条探测链路同时保留 HTTP 访问质量与 SSE 流式体验证据。
这里有一个重要区别:任务选择 SSE 是配置入口,响应是否具备 SSE 指标仍取决于实际返回的内容类型和事件数据。 如果目标没有返回 text/event-stream,不能把"没有 SSE 指标"解释为"流式响应速度为 0 毫秒"。
以如下响应为例:
vbnet
HTTP/1.1 200 OK
Content-Type: text/event-stream
: heartbeat
data: {"delta":"你好"}
data: {"delta":",请问有什么可以帮你?"}
data: [DONE]
探针按完整 data 事件计数和计时:注释心跳不作为数据事件;同一事件内的多行 data: 合并为一个事件;如果结束标记以 data: 形式发送,它也属于统计口径中的事件。因此,事件数不是生成的 Token 数,更不能直接用来计算模型吞吐量。
七项指标分别测到了什么
令 t₀ 为发起请求的时刻,t₁ ... tₙ 为各完整 data 事件到达的时刻,t_end 为响应流结束的时刻。相邻事件间隔定义为 Δᵢ = tᵢ − tᵢ₋₁,其中 i ≥ 2。
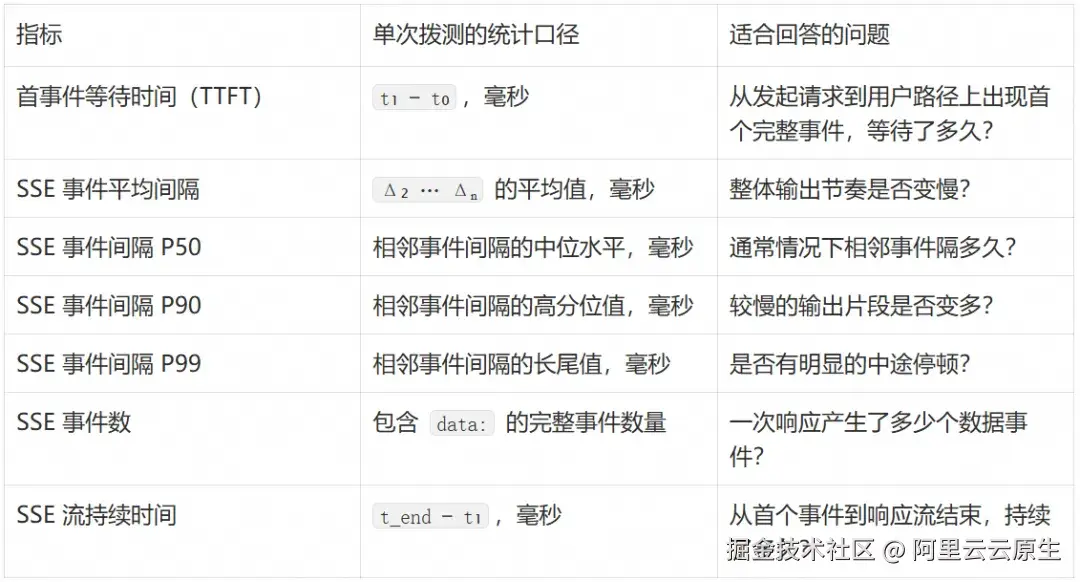
P50、P90 和 P99 首先描述的是一次拨测内部的相邻事件间隔分布,不应误读为"所有用户请求的全局分位数"。在任务分析页观察它们的时间趋势时,还应同时关注探测次数、探测点与时间范围;事件数量很少的单次请求,其 P99 往往接近最大间隔,不宜单独用一个尖刺断言持续故障。
TTFT 也不是模型服务内部的"首 Token 生成耗时"。它是探测点视角的端到端时间,可能包含 DNS、TCP、TLS、网关、服务端排队、推理以及事件传输等阶段。若要继续归因,应把它与同次拨测的网络和 HTTP 阶段信息、必要时的服务端观测数据对齐。
相同的 3 秒总耗时,为什么是两种不同故障
下面是示意数据,不代表产品实测效果 。假设两次请求都在第 3000 ms 结束,并且各产生 5 个完整 SSE 事件:
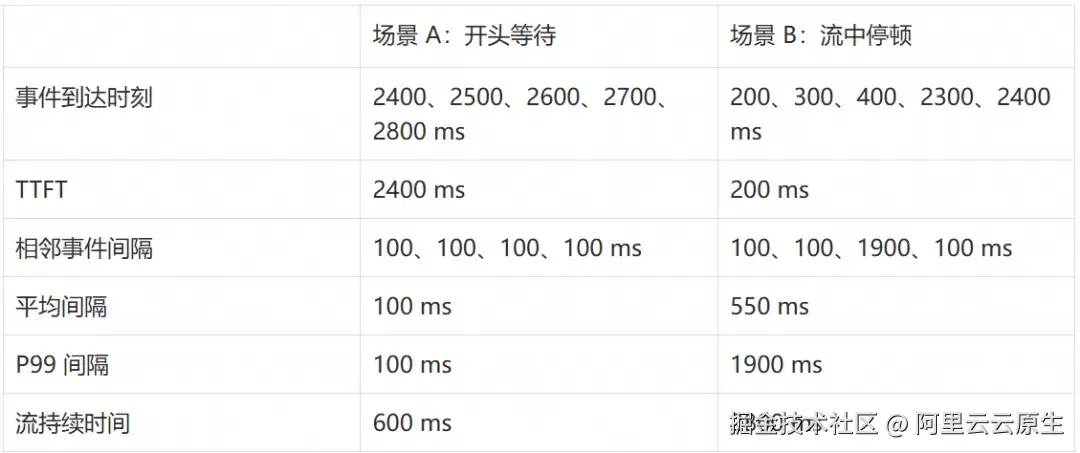
两次请求的 HTTP 状态和总耗时可以完全一样,但用户体验不同:
- 场景 A: 用户长时间看不到任何内容。一旦开始输出,后续节奏稳定。应先检查网络阶段与响应流开始前的等待,再结合后端日志或 Trace 分辨网关、排队和推理耗时。
- 场景 B: 用户很快看到开头,却在生成途中等待近 2 秒。此时只优化首事件时间没有意义;应进一步检查服务端生成节奏、上游依赖、代理缓冲和特定网络路径。
SSE 指标的价值不在于仅把"3 秒"拆成更多数字,而在于把排查起点放在正确的时间段。
控制台实战:为 AI 对话接口建立持续拨测
下面以我们在云监控控制台 ** **3 运行的 sse探测-chat 为例,串起"创建配置---持续执行---趋势查询---异常下钻"的完整使用过程。目标是一个通过 POST 调用的 AI 对话接口,而不是静态页面或仅返回 HTTP 200 的健康检查地址。
1. 从"单步探测"进入,选择 SSE
进入云监控 → 网络分析与监控 → 站点监控 → 新建任务 → 单步探测 ,在基本信息中选择 PC 端(PC) 和 SSE。
示例的基础配置如下:
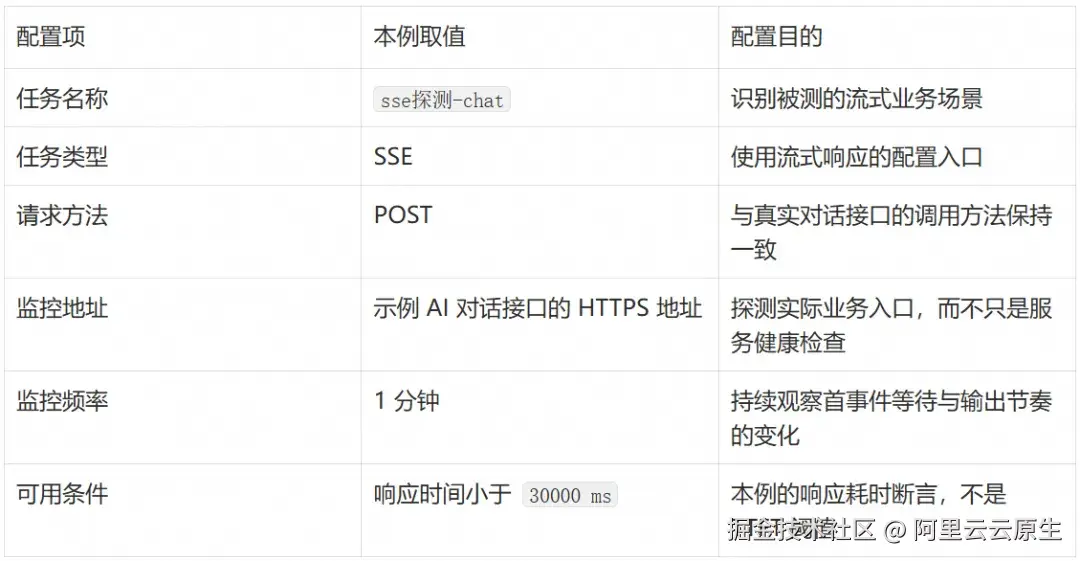
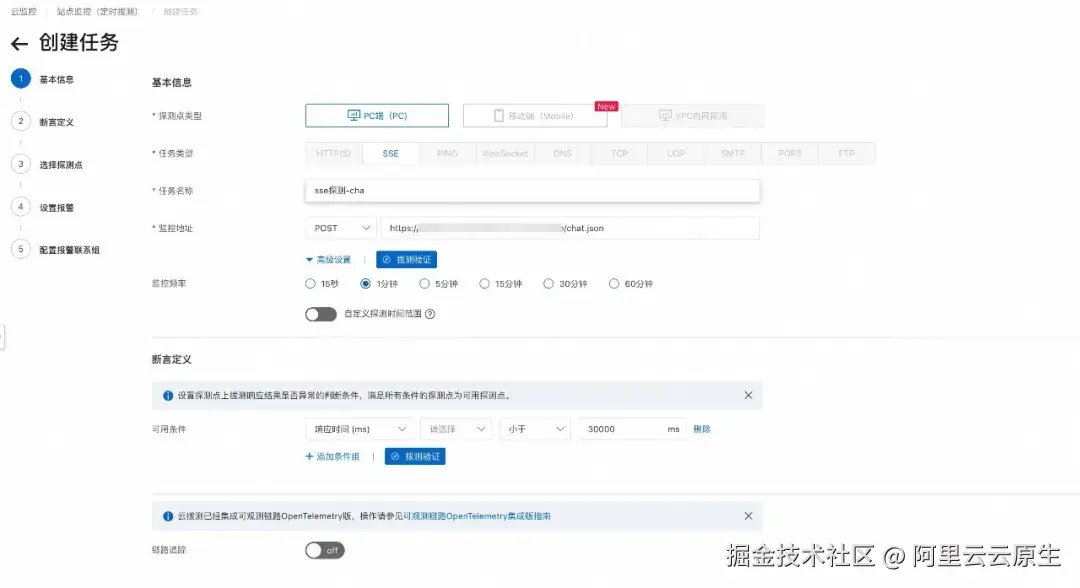
图 2:在真实创建页演示填写示例任务的基础参数。接口地址仅作场景展示,读者应替换为自己的业务接口。
选择 SSE 不会替目标服务"开启流式输出"。仍需让请求满足目标 API 的协议要求,并确认响应返回 Content-Type: text/event-stream。只选中 SSE、却调用一个普通 JSON 接口,不能得到有意义的流式指标。
2. 配置完整业务请求,分清超时和断言
展开高级设置 → 请求参数 ,配置 HTTP 请求头、Cookie(如业务需要)和请求内容。POST 接口的请求体应采用目标服务支持的结构;只有当该接口约定通过 stream 参数控制流式输出时,才按其协议传入 stream: true,不能把某一种模型 API 的请求格式套到所有 AI 对话接口上。
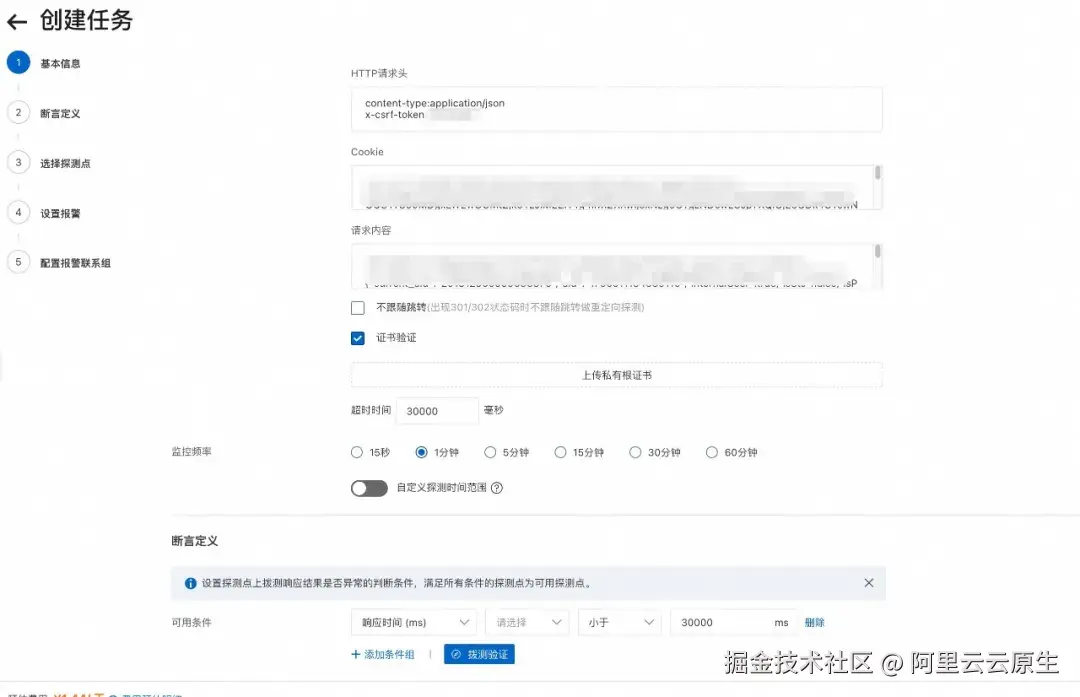
图 3:请求参数与超时配置入口。为避免公开认证与业务内容,演示表单未填入请求头、Cookie 和请求体;这不代表实际接口无需这些参数。
配置中有两个容易混淆的"时间":
- 超时时间控制一次探测最多等待多久,应覆盖业务预期的完整响应流。超时过短,会把正常的长回答截断。
- 断言中的响应时间 用于判断此次结果是否满足可用条件。本例填写
30000 ms,不能将其解释为"首事件必须在 30 秒内出现",更不能因此认为已经配置了 TTFT 告警。
正式创建前,可通过页面的拨测验证检查请求和断言是否符合预期。建议固定测试输入的业务含义和大致输出长度,并使用专用、最小权限的测试身份。定时拨测可能产生模型调用消耗;频率、探测点数量和输出长度应一起评估。不要把真实用户的敏感对话放进测试请求。
3. 选择探测点,明确这条基线代表谁
在选择探测点中配置 IP 探针类型及目标地域、运营商节点。已有示例任务选择了一个测试探测点,用来验证从请求到指标的链路;因此,它的趋势只能说明这一条探测路径的表现,不能据此推断所有地域用户的体验。
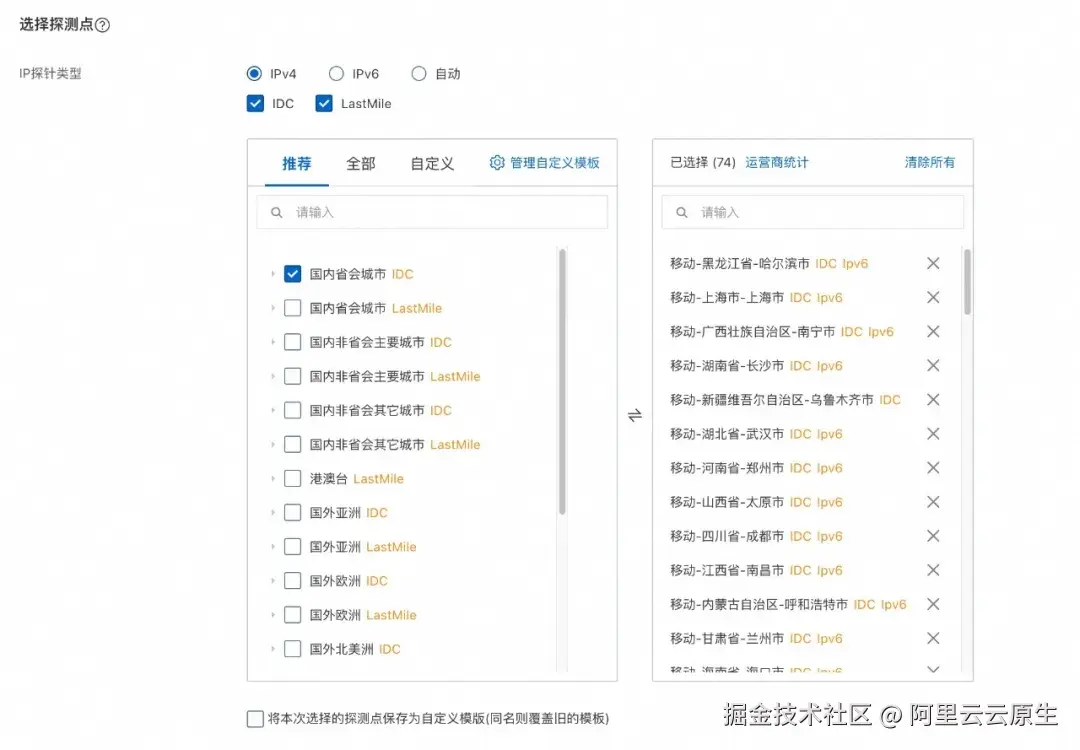
图 4:已有任务的实际探测点配置。本例是单探测点验证场景;生产监控应根据用户分布选择多个有代表性的探测点。
生产使用时,可将核心用户所在地域和运营商纳入同一组观测,并保持请求内容、频率及成功条件可比。这样,后续才能区分"某条路径变慢"与"多个访问入口同时退化"。如需通知,再按业务要求配置报警规则和联系组;看到指标图表与完成报警配置是两件事。本示例任务未配置报警规则,不能把趋势截图当作告警已经生效的证据。
4. 查询总览:先确定异常时段,再阅读 SSE 指标
任务持续执行后,在任务详情的总览信息中选择时间范围,并按需要筛选运营商、探测点城市与聚合周期。先保留全量样本,观察可用率与响应时间;如果切换了"过滤出错,超时的响应",分析时应注明口径,避免把失败样本过滤后的曲线误当作全量表现。
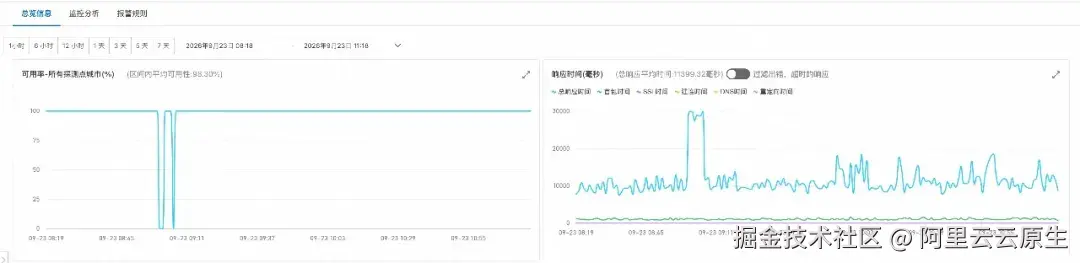
图 5:示例任务在 2026 年 9 月 22 日所选 3 小时时间窗口内的真实总览。可用率下降与响应时间尖刺为进一步下钻提供了时间线索。
继续查看下方两组 SSE 图表:左侧以毫秒展示事件间隔、TTFT 和流持续时间,右侧单独展示事件数。这样可以避免把"个数"和"时间"混在同一个纵轴上。
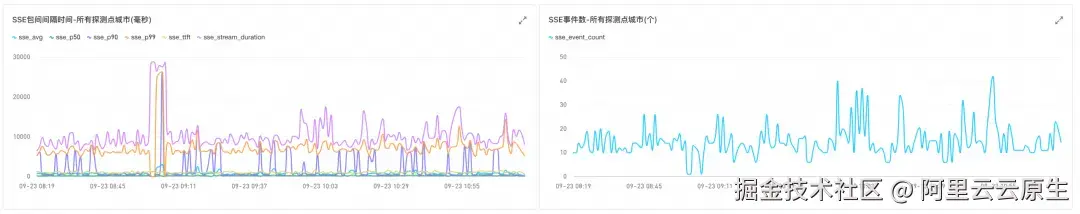
图 6:同一任务、同一时间窗口下的七项 SSE 指标。左侧六条时间序列,右侧事件数序列。
读图时可按以下顺序形成假设:
-
看
sse_ttft:首个完整事件的等待是否抬升?结合 DNS、连接、TLS 等阶段判断是否伴随接入耗时变化。 -
看
sse_avg与sse_p50/p90/p99:平均节奏是否整体变慢,还是只有少数较长停顿?平均值平稳并不能排除长尾。 -
看
sse_stream_duration与sse_event_count:时间变长的同时,事件是否也变多?事件数稳定而持续时间增长,更值得检查流内等待;但这仍是排查线索,不是根因结论。 -
回到单次样本:时间窗口内的聚合趋势不能代替某次请求的完整证据,应继续查看相应时刻的探测明细。
图中的流持续时间明显大于部分事件间隔,较小的曲线会被同一纵轴压在底部。贴近横轴不等于指标为 0: 应查看具体数据点的数值,再判断是尺度差异、有效的零值还是数据缺失。
5. 从趋势回到错误明细,验证"卡住"发生在哪一段
在同一页面的结果列表切换所有 / 正常 / 报警 / 错误 ,找到异常时刻并进入详情 。本次截图对应的窗口中,错误列表确实存在约 30000 ms 的超时记录,其中有样本提示 Client.Timeout or context cancellation while reading body。
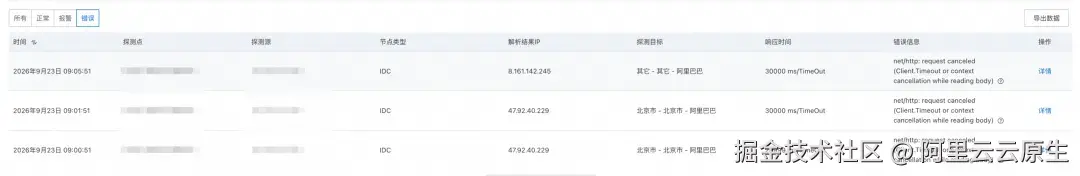
图 7:结果列表错误详情
这条信息的价值是把问题从"图表有尖刺"推进到"该样本在读取响应正文阶段触及了超时或取消边界"。它不能单独证明模型推理慢: 还需要对齐该次结果的 SSE 事件数、首事件等待和流持续时间,并结合服务端日志核验,是迟迟没有首事件、输出途中停顿,还是迟迟没有结束响应流。针对此例,经服务端排查,这段时间确实存在模型推理慢的问题,这也证实了我们的探测有效性。
建议保留一条清晰的核验路径:同一时间窗口 → 同一探测点 → 同一次探测结果 → HTTP 阶段与 SSE 指标 → 服务端证据。 DNS 失败的样本不应被解释为模型生成慢,HTTP 200 的样本也不能因为状态码成功就跳过流式体验检查。
把一次异常变成可验证的证据链
AI SSE 拨测提供的是外部访问视角,不是自动给出服务端根因。实际排查可遵循"总体趋势 → 影响范围 → 代表样本 → 协议阶段 → 服务端证据"的路径:
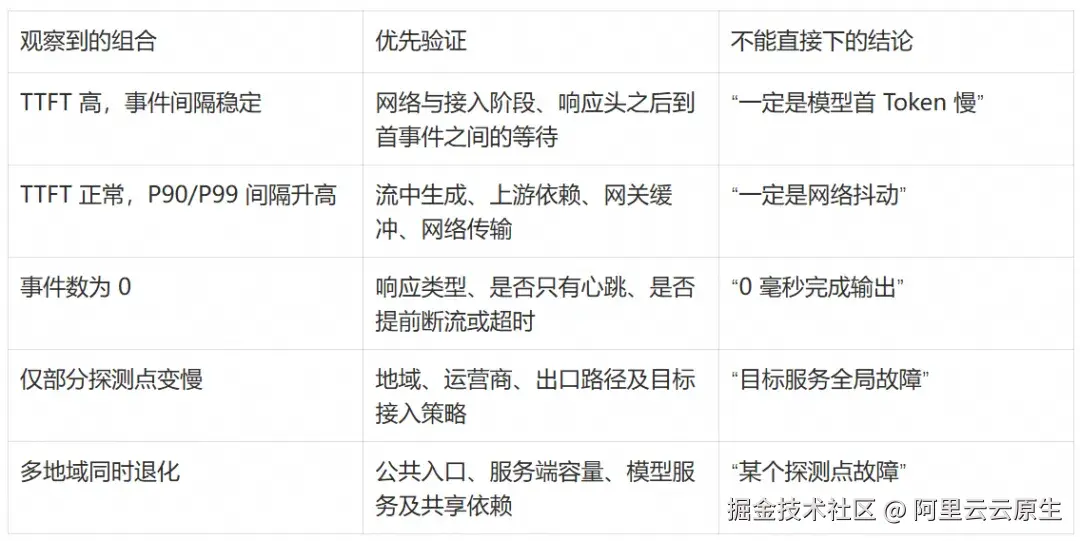
如应用已具备服务端日志或链路追踪能力,还可以用相同时间窗口、请求标识等线索做进一步对齐。拨测证据说明"外部用户路径上发生了什么",服务端证据才可能解释"等待发生在哪个内部组件"。如果缺少后端证据,应将结论保持为可观察现象及待验证假设。
这套方法也适合发布验证:固定测试输入、探测点与频率,对比发布前后的多个时间窗口;同时记录样本量,比较 TTFT 与间隔长尾,而不是用一次最慢请求或单个平均值宣称优化成功。
理解产品边界,才能正确解读数字
- 以完整
data事件为计量单位: 心跳注释不算事件;data: [DONE]这类结束标记可能计入事件数。事件数不等于 Token 数,指标也不判断回答质量。 - SSE 指标依赖实际响应: 目标需要返回
text/event-stream;没有完整数据事件时,TTFT 和事件间隔不具备正常的性能解释意义。缺少数据不能简单当作"0 毫秒"。 - 流持续时间以实际响应结束为边界: 服务端主动关闭、网络断开和任务超时会影响读数,必须与错误信息一起看。
- 响应正文不是无限保存: 探针会持续读取流以计算指标;如开启响应正文保存,用于探测明细的正文最多保留前 64 KiB。这不等于只测量前 64 KiB 的流。
- 主动拨测与真实用户监控互补: 它能提供稳定、可重复、可跨探测点比较的请求,但不能覆盖所有真实用户输入、客户端渲染和模型内部状态。
结语
AI 应用的"可用"已经不只是 HTTP 200。用户在意的是第一段内容何时出现、之后是否持续输出,以及不同访问路径上是否都能得到稳定体验。
AI SSE 拨测把一次流式请求拆成可核验的时间证据:首事件等待、事件间隔分布、事件数和流持续时间,再与既有 HTTP(S) 网络阶段、可用性和探测点维度结合。它不替代服务端诊断,却能帮助团队更早发现体验退化,并让排查从"整个请求有点慢"前进到"首事件之前慢,还是流中某一段停了下来"。
相关链接:
1 SSE 协议格式
html.spec.whatwg.org/multipage/s...
2 站点监控产品说明
help.aliyun.com/zh/cms/clou...
3 云监控控制台