大家好,我是老刘
做Flutter的兄弟可能都有过这种体会,让AI帮你写JS或者Python,那叫一个行云流水。换成Dart多少就差点意思,有时候需要人工纠偏。
老刘一直盼着有顶级模型专门针对Flutter做优化。毕竟谷歌手里既有算力又有模型,Flutter和Dart的全部数据也都在它手里,这事它不干谁干?
结果Flutter没等到,RN先等到了。
RN生态的Callstack公司前段时间发布了一个叫Apex的模型,专门针对React Native场景做了后训练。今天老刘就来聊聊这件事,顺便说说咱们Flutter开发者在等来专属模型之前,自己能做点什么。
Apex是个什么东西
模型官网在这里
一句话概括,Apex等于Qwen开放权重底座加上Callstack的RN领域后训练。
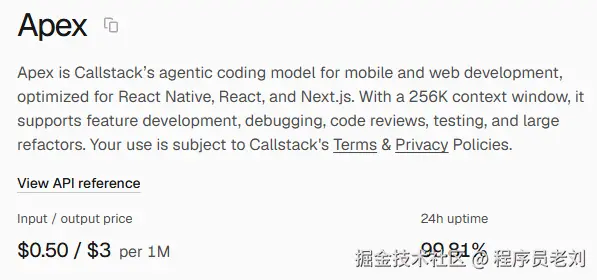
模型ID是callstack/apex,背后的Callstack是一家波兰软件咨询公司。注意它不是Meta,也不是React Native官方团队。
不过Callstack在RN生态里确实是核心贡献者,React Native Paper、Re.Pack、react-native-webview这些知名库都是它在维护,也常年参与RN核心代码贡献。所以它在RN领域的发言权是实打实的,你可以理解成RN生态里最有名望的公司之一出来做了个专用模型,但不是官方出品。
它自称的优化方向是React Native加React、Next.js,256K上下文,主打RN场景接近前沿模型质量,同时成本低得多。输入 0.5每百万token,输出3每百万token。
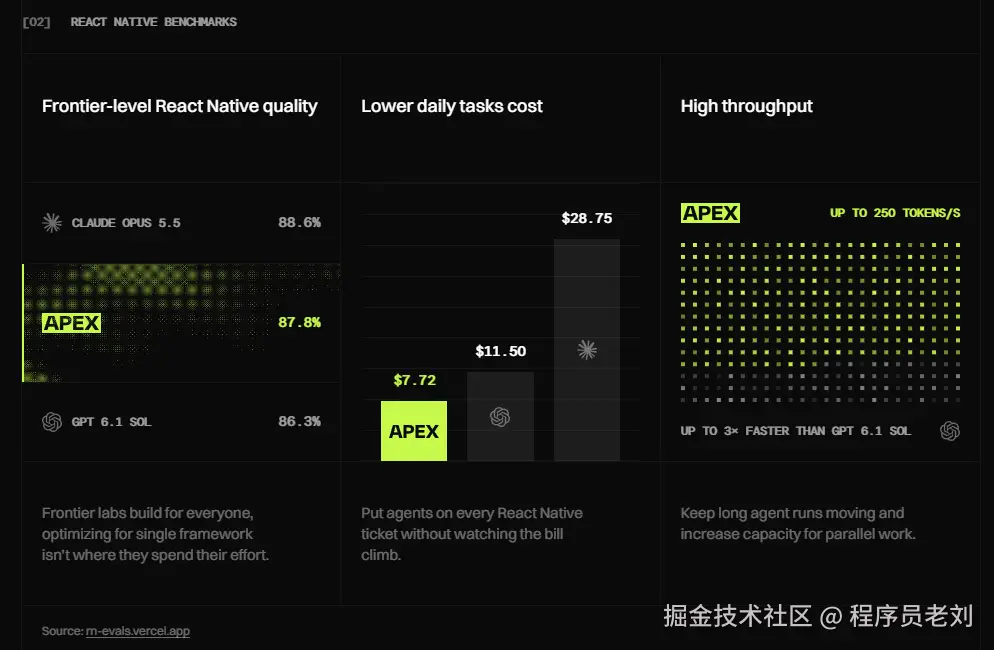
这里老刘要提醒一句,官网上那些benchmark、3.7倍更便宜、接近Opus之类的数字全是厂商自报的,数据来自rn-evals.vercel.app和nextjs.org/evals,跟竞品大概率不是同一套口径。参考一下就行,别当成第三方独立结论。
现在有哪些使用入口
官方直连API,主渠道
platform.callstack.ai,这是Callstack自己的平台,注册拿key就能用。
接口同时提供OpenAI兼容和Anthropic兼容两种配置,所以能直接塞进Claude Code、Cursor、Codex、Zed这些工具,官方还给了npx @callstack/apex init一键配置。
提醒一下,Claude Code和Cursor这些是客户端集成,不是分发渠道,底层调的还是官方API。
自托管和私有部署,企业渠道
可以跑在客户自己的云或者机房里,支持EU数据驻留和SOC 2合规,签商业协议。对数据合规要求高的团队主要走这条路,也是官网"Ready for enterprise"那一块的核心。
注意Apex不是开源模型,私有化部署是付费服务。
Vercel AI Gateway
顺便说个有意思的背景,Apex最早是匿名以Pixel Canary的名字先上的Vercel AI Gateway做公测,跑了5天、200B以上token,正式发布时才揭晓背后是Callstack。也算是蹭了一波匿名模型的新玩法。
其实Flutter比RN更需要定制模型
RN用的语言是JS,而几乎所有主流编程模型在训练时都吃了海量JS代码,天然对RN友好。所以Apex最大的意义可能不在于提升编程能力,而在于把RN场景的速度和成本优势做上去。
Flutter完全是另一回事。从Dart语言到整个生态,都是一个相对独立的体系。模型训练语料里Dart代码的占比跟JS、Python根本不在一个量级,这才是AI写Flutter代码时经常水土不服的根源。
所以说,Flutter才是真正在编程能力上最需要后训练来补救的那个框架。RN做定制模型是锦上添花,Flutter做定制模型是雪中送炭。
可惜谷歌今年在模型上的进展似乎进入了某种僵局。Gemini 4.0推迟了很久才发,能力也谈不上惊艳。Gemini Flash最新是3.8版本,被称为美国版豆包,老刘自己用了一阵,速度确实飞快,但整体能力也确实还差点意思。
不过说实话我还挺爱用的,Bug多不多先不说,你就说快不快吧。
而最适合做Flutter针对性微调的主体就是谷歌,整个生态里没有比它掌握更多数据和素材的了。它不动,别人想动也没那个本钱。
等不来模型,我们能做什么
抱怨归抱怨,活还得干。本质上想让模型在Flutter工作里表现得更好,就一句话,提供精确且充分的上下文。
老刘举个简单的例子。
我让opencode在配置文件里隐藏一批用不到的模型,这事隔一阵就要做一次,用的是GLM 5.3 flash。
最开始我只告诉它要隐藏哪些模型。于是它的工作流程是先在本机查找opencode配置文件的位置,Windows的配置文件存放路径跟Linux不一致,模型会连着执行好几条命令去找,上下文里塞满了命令行输出。钱花了不少,事还办得不利索。
后来我把提示词改了,除了列出要隐藏的模型,还明确指定了配置文件的完整路径。其实放在memory里也是同样的效果。
效果是立竿见影的,token省了,速度快了,上下文更干净了。
想提升模型在Flutter项目里的编程表现,道理一模一样。
明确告知位置
要修改的模块、文件、类、函数,直接在提示词里写清楚,别让模型自己满项目去找。
明确编码规范
所有页面都要继承BasePage,所有bloc都要继承BaseBloc,这类项目通用约定要提前交代。放在skill或者AGENTS.md里长期生效。
补齐模块文档
模块间的API要有明确的功能说明文档,模型看不见你的架构图,只能从文字里理解系统。
再进一步,可以用擅长推理的顶级模型先生成精确的修改方案,再交给擅长coding的模型去执行具体修改。一个负责想清楚,一个负责干利索,各司其职。
上下文给得到位,模型的表现就能好上一截。专属的Flutter模型也许明天就来,也许还要等很久,但把手里的模型用好,是今天就能做的事。
写在最后
RN等来了Apex,老刘替RN的朋友们高兴,也替Flutter着急。谷歌手里的牌明明最好,却一直没打出来。
不过换个角度想,专属模型只是加分项,上下文工程才是基本盘。基本盘扎实了,换什么模型都顺手。
你们团队在用AI写Flutter代码时踩过哪些坑?有没有自己的一套提示词心得?评论区聊聊。
🤝 如果看到这里的同学对客户端或者Flutter开发感兴趣,欢迎联系老刘,我们互相学习。
🎁 私信免费领老刘整理的《Flutter开发手册》,覆盖90%应用开发场景。可以作为Flutter学习的知识地图。
💬 : laoliu_dev
📂 老刘也把自己历史文章整理在GitHub仓库里,方便大家查阅。