作者:桂楚
AI 应用正从单轮文本问答走向长上下文、多模态和 Agent 调用。一次请求可能携带整段对话、检索材料或多张图片,并访问不同模型与工具。请求体积增大、调用链路变长,对 AI 网关的处理效率和运行稳定性提出了更高要求。
本文对比阿里云 AI 网关 Serverless 企业版与开源 Higress 自建部署,下文分别简称"Serverless 企业版"和"开源 Higress"。两组实验考察 1 MB 与 10 MB 请求的网关处理时延,并结合两种部署方式讨论费用、维护投入与生产保障。
从常见模型调用到大报文处理
请求内容变化,网关负载也在变化
用户向 AI 助手提问,通常只关心多久能得到答案。对系统而言,一次调用却可能带着长上下文和大请求负载经过网关,再到模型后端。模型还没有开始推理,链路中的等待就已经发生。
AI 网关位于应用与模型服务之间,负责鉴权、路由和流量治理。文本问答、知识助手和 Agent 的请求大小、调用频率各不相同;当网关插件需要读取和解析请求体,完成模型协议转换或内容检查时,就会产生数据复制和对象分配的开销。长上下文、直接嵌入请求体的图片等内容,会增加这部分开销,多个大请求同时到达时,处理效率和内存使用也就更值得关注。
开源提供丰富能力,企业场景需要针对性优化
开源 Higress 已提供丰富的模型代理与流量治理能力,是自建 AI 网关的良好选择。常见的模型接入、鉴权、路由和限流需求,通常可以通过已有能力满足,团队也能结合自身的部署与运维体系使用。
从模型接入到稳定承载生产流量,团队还要解决更多问题。尤其是需要持续解析大请求体的业务,插件处理效率、内存占用和并发表现,会影响应用响应。开源 Higress 可以通过调整插件、版本和资源配置进行优化;Serverless 企业版则针对这类负载提供了专门的处理优化。两者在长上下文、多模态等大请求体场景下的差异,可以通过时延测试观察。
在 10~100 并发测试中,Serverless 企业版的平均网关处理时延均低于开源 Higress:1 MB 请求最高降低 97.1%,10 MB 请求最高降低 90.2%。
两组实验:较小请求与大报文的时延表现
两侧使用相同压测源码和合成 JSON 请求,访问同一个不增加人工等待的 Mock 后端,排除真实模型推理耗时的影响。两组实验分别固定 1 MB 和 10 MB 请求体,逐步增加并发。图中展示各档位的平均网关处理时延;两侧部署资源与访问入口不同,结果反映对应部署下的表现。
1 MB 请求:网关处理时延最高降低 97.1%
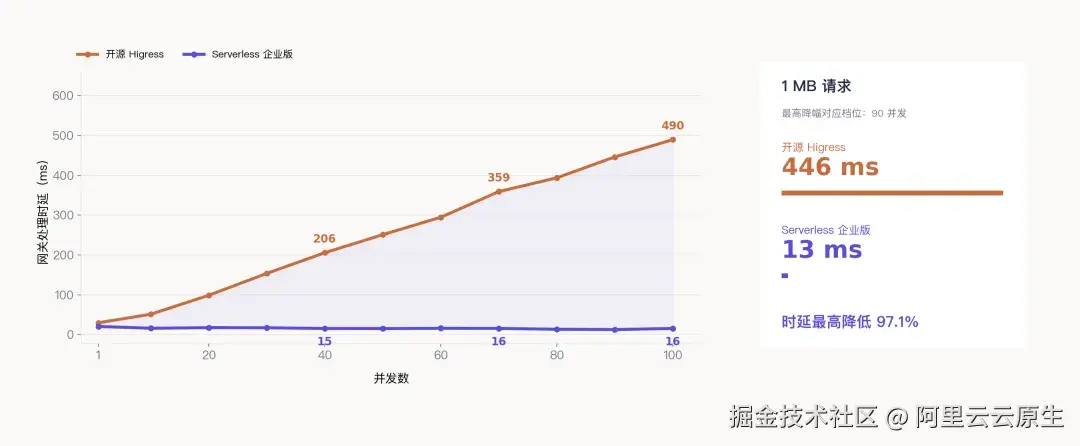
在 10~100 并发测试中,Serverless 企业版平均处理时延保持在 13~18 ms,比开源 Higress 低 68.8%~97.1%。最高降幅出现在 90 并发:平均时延从 446.2 ms 降至 12.7 ms,降低 97.1%。
1 MB 是两组实验中相对较小的请求体。随着并发增加,开源 Higress 的平均时延逐步上升,Serverless 企业版则保持在较窄的毫秒级范围内。两者的差异在这一请求规模下已经显现。
10 MB 请求:网关处理时延最高降低 90.2%
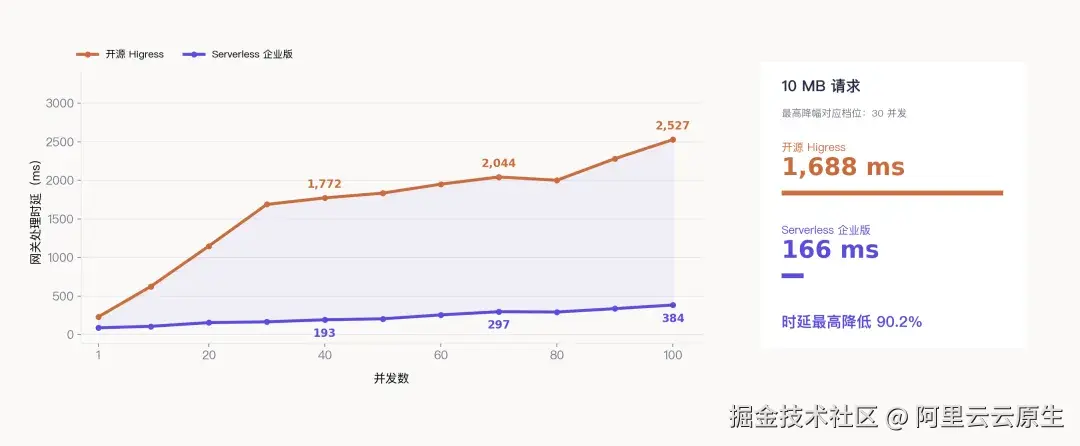
在 10~100 并发测试中,Serverless 企业版平均处理时延比开源 Higress 低 82.7%~90.2%。最高降幅出现在 30 并发:平均时延从 1,688.1 ms 降至 166.1 ms,降低 90.2%。
长上下文和内嵌媒体会增加单次传输的数据量。如果插件还需要解析这些内容,大报文的复制与处理开销就更容易显现。在 100 并发时,Serverless 企业版平均时延仍为 384.3 ms,相比开源 Higress 的 2,527.4 ms 降低 84.8%,减少约 2.14 秒等待。
性能优势背后:AI 请求处理优化
性能差异需要结合具体的插件处理路径理解。当插件读取、解析或改写完整请求体时,网关除了转发数据,还要承担缓冲、复制和对象分配的开销。对于使用 Wasm 插件的开源 Higress,如果多个插件分别处理同一份大报文,重复复制和分配的负担可能随请求体积与并发增长而放大。这类负载需要专项调优,常见模型调用并不一定会遇到同等程度的压力。
传统 Wasm 线性内存可以增长,却无法直接收缩;插件释放对象后,空间通常可在实例内部复用,但未必立即归还宿主系统。如果插件在等待模型响应期间仍持有请求体,数据占用的时间还会延长。在持续并发访问下,未及时释放的数据与新增分配叠加,可能使内存维持高位或继续攀升。若缺少相应优化、资源逐渐趋紧,处理效率和排队时延就可能受到影响。
Serverless 企业版采用 Envoy 原生插件机制,针对这类 AI 请求处理流程与内存使用进行优化,减少重复数据复制和不必要的内存占用。这些专项优化由平台持续维护,为需要解析大请求体的生产业务提供更高效的处理方式。
自建与托管:费用、维护与生产保障
性能之外,两种部署方式也意味着不同的资源准备和维护分工。开源 Higress 由团队部署和维护,可以纳入已有基础设施体系;Serverless 企业版由平台管理底层资源,团队主要配置模型、路由和业务策略。
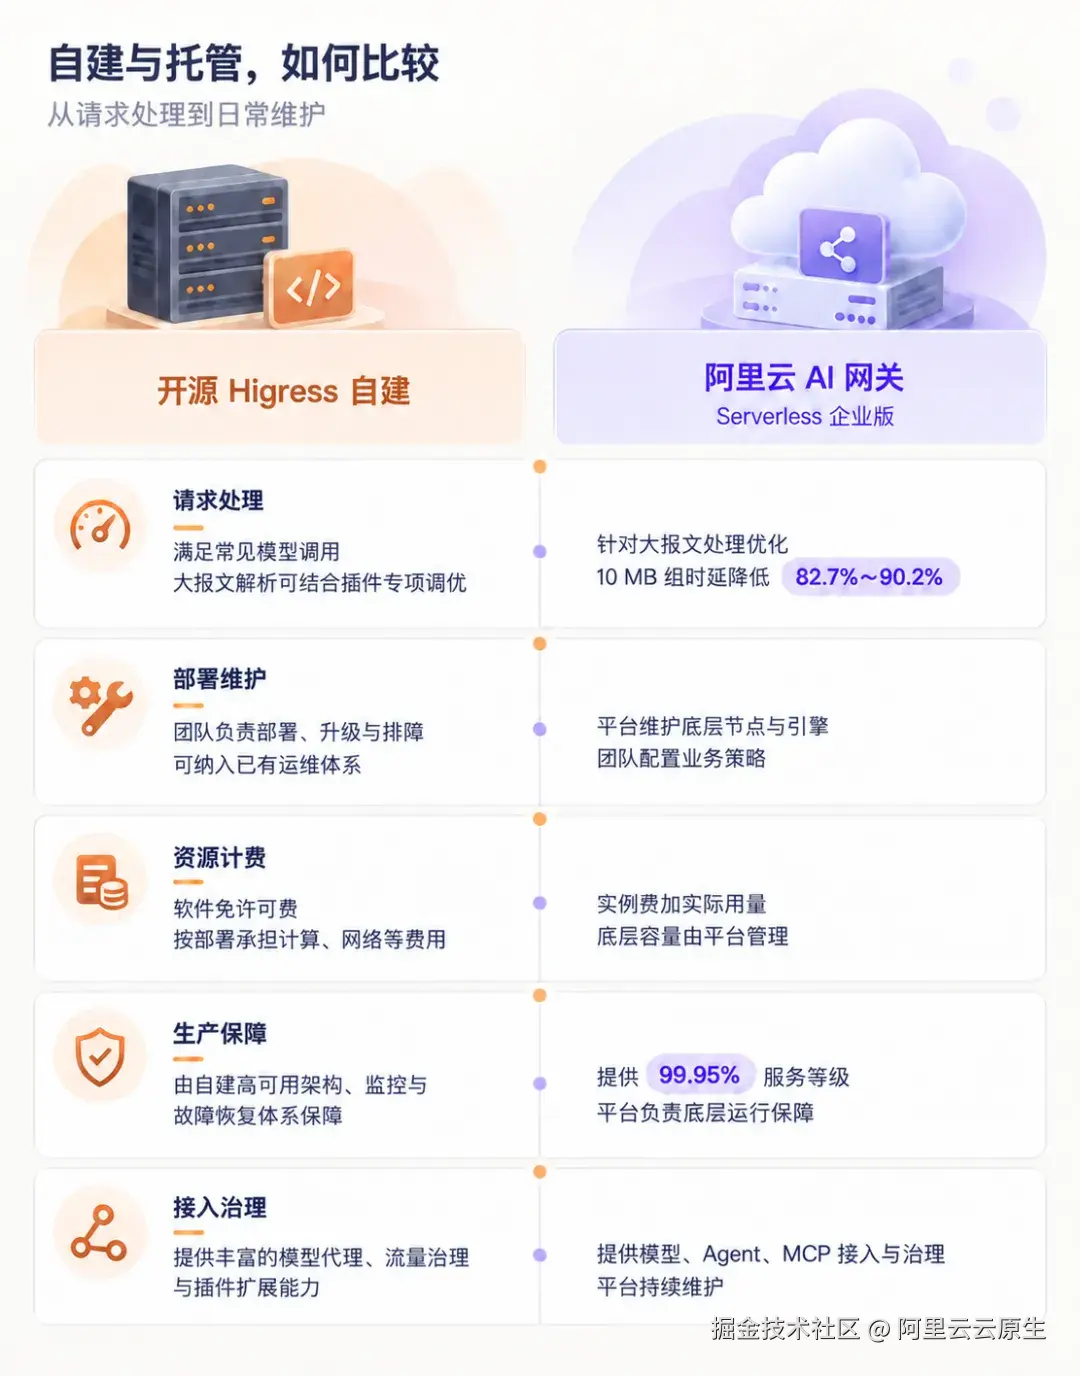
性能对比侧重需要处理大请求体的负载,图中降幅对应本文 10 MB 组。
开源 Higress 自建的费用主要来自计算、网络与冗余副本,还需要为流量高峰预留容量。镜像维护、插件兼容性检查、升级回归和异常排查所需的人力,也构成长期投入。Serverless 企业版由平台管理底层容量与节点,减少团队自行准备资源和维护基础设施的工作。
生产运行还需要高可用和故障恢复能力。开源 Higress 可以依托团队已有的监控与应急体系;AI 网关 Serverless 企业版提供 99.95% 服务等级,由平台承担底层运行保障和版本维护,有助于减少基础设施故障处置工作及服务中断带来的损失风险。对于希望减少节点运维与底层排障投入的团队,托管服务也让工程师能将更多时间用于应用开发和业务迭代。
关于阿里云 AI 网关
阿里云 AI 网关为大模型、Agent 和 MCP 服务提供统一的访问入口,集中处理鉴权、智能路由、流量治理与安全防护,并提供调用观测和 Token 用量统计。应用通过网关接入服务,团队可以统一配置调用策略、查看运行情况,减少重复的接入与治理开发。
针对不同阶段的业务需求,产品提供三种主要实例类型:
- Serverless 标准版:适合试用、开发测试和低流量业务,0 元起步、无实例费,按实际用量计费。
- Serverless 企业版:本文参与对比的版本,面向生产业务,提供独立入口,支持自定义域名和传输加密配置,底层运行与维护由平台负责。采用实例费加实际用量计费,实例费参考价为 0.245 元/小时,请求调用、数据处理和公网流量等费用按使用情况收取。
- 实例型独享版:适合对资源隔离、性能规格和高级治理能力有更高要求的业务。
参考资料:
1 AI 网关类型与版本能力
help.aliyun.com/zh/api-gate...
2 Serverless 新版本计费说明
help.aliyun.com/zh/api-gate...
3 AI 网关引擎版本说明
help.aliyun.com/zh/api-gate...
点击此处获取价值 400 元的 AI 网关免费试用(限 AI 网关新客)。