专栏:AI Agent 开发|18
|----------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| 上一篇 17《实现 Agent 最大执行步数》解决了"什么时候必须停"。但进入真实工具执行后,失败并不是边缘情况:网络会超时、上游会 429/5xx、业务参数会非法,工具也可能只返回一个空结果。A18 只做一件事:把这些失败变成 Agent 能理解、能继续决策的 Observation,同时让超时、重试和错误文本都有明确上限。 |
一、先看两个最危险的 except
工具失败时,最直觉的两种写法恰好都不适合 Agent:一种把异常继续向上抛,直接炸穿整个 Loop;另一种把异常吞掉,让模型误以为工具已经成功。
|--------------------------------------------------------------------------------------------------------------------------------------------------------|
| try: result = tool(**args) except Exception: raise # 反模式 1:整个 Agent Loop 被终止 try: result = tool(**args) except Exception: pass # 反模式 2:模型根本不知道调用失败 |
Agent 需要第三种结果:系统捕获失败,但不伪装成功;把它转换成一条结构化错误 Observation,再像普通 Tool Result 一样回填给模型。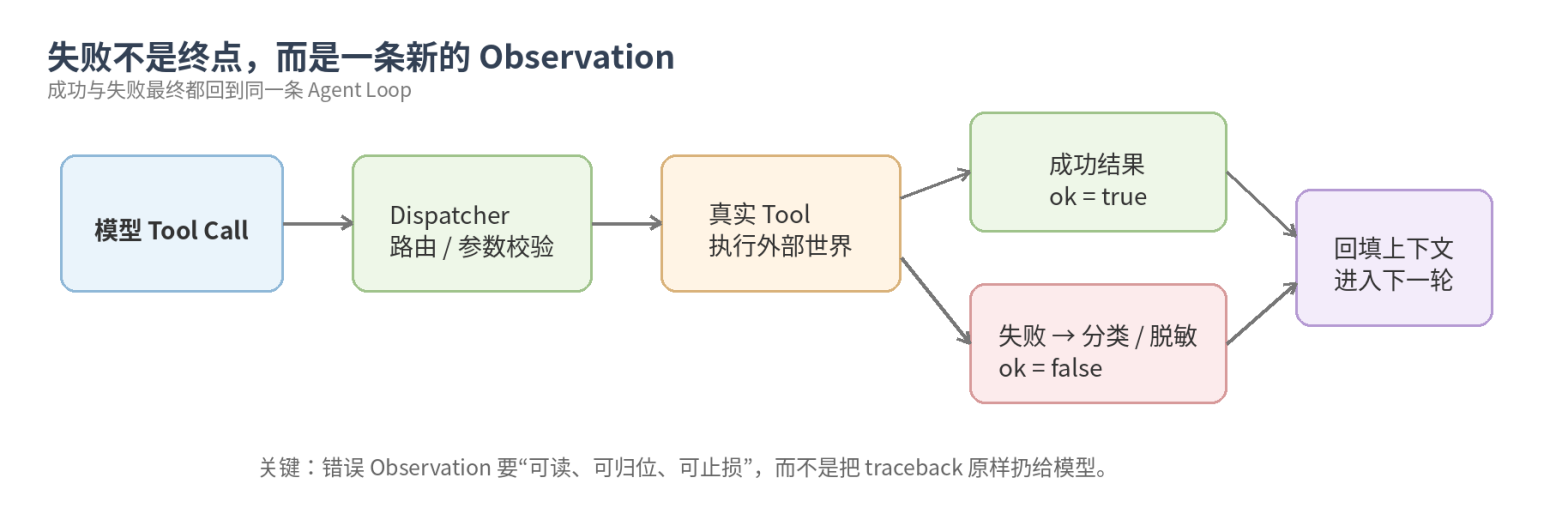
图 1 成功与失败都应该回到同一条 Observation 通道,区别只是 ok 与错误类别
二、失败应该变成 Observation,而不是异常终点
对 Agent 来说,成功结果和失败结果都只是"下一轮可观察到的新事实"。
因此错误消息至少要回答四件事:哪个工具失败了、属于什么类型、模型下一步能不能通过换参数或稍后重试修正、这条结果对应哪个 tool_call_id。
一个够用的错误 Observation
{
    "ok": false,
    "tool": "search",
    "tool_call_id": "call_12",
    "kind": "timeout",
    "message": "上游在 5s 内未返回",
    "retryable": true
}
这里最重要的不是字段名本身,而是"错误和成功走同一条返回路径"。上层 Loop 不需要再维护一套异常分支,它只消费 Observation。
三、先把执行失败分成 5 类
|-----------|-----------------|-------------------|
| kind | 典型场景 | 默认动作 |
| bad_args | 缺字段、未知字段、签名绑定失败 | 不自动重试;让模型修正参数 |
| timeout | 工具或上游在时间预算内未返回 | 可有限重试;先退避 |
| api_error | 429/5xx/短暂网络错误 | 按具体状态决定是否重试 |
| empty | 调用成功但没有可用结果 | 不当作成功;让模型换条件或澄清 |
| internal | 代码 bug、未预期异常 | 不盲目重试;安全回灌并记录内部日志 |
一个细节要钉死:不要把所有 TypeError 都当成"模型参数错"。正确做法是执行前先用签名或参数模型做绑定校验;如果绑定已经通过,函数内部再抛 TypeError,更可能是工具实现自己的 bug,应归到 internal。
四、最小实现:先跑通 safe_call
最小 safe_call:参数预校验 → 执行 → 错误折叠
import inspect

def _err(kind, message, retryable=False):
    return {"ok": False, "kind": kind,
            "message": message, "retryable": retryable}

def safe_call(fn, args):
    # 1) 执行前识别真正的参数错误
    try:
        inspect.signature(fn).bind(**args)
    except TypeError as e:
        return _err("bad_args", "参数与签名不匹配: " + str(e))

    # 2) 真正执行;最小版假设底层自己会抛 TimeoutError
    try:
        value = fn(**args)
    except TimeoutError:
        return _err("timeout", "工具执行超时", retryable=True)
    except Exception as e:
        return _err("internal", type(e).__name__ + ": " + str(e))

    if value is None:
        return _err("empty", "工具执行成功,但没有返回可用结果")
    return {"ok": True, "value": value}
这段代码还没有真正的"外层超时"和重试,但已经把最重要的契约固定下来:调用方永远拿到一个结果对象,而不是在成功返回值与随机异常之间二选一。
五、重试之前先问:重来一次真的可能变好吗
重试不是错误处理的默认动作。参数错、权限拒绝、业务规则不允许,这些错误重来十次仍然一样;超时、429、5xx、短暂网络断开才可能因为"下一次环境变了"而恢复。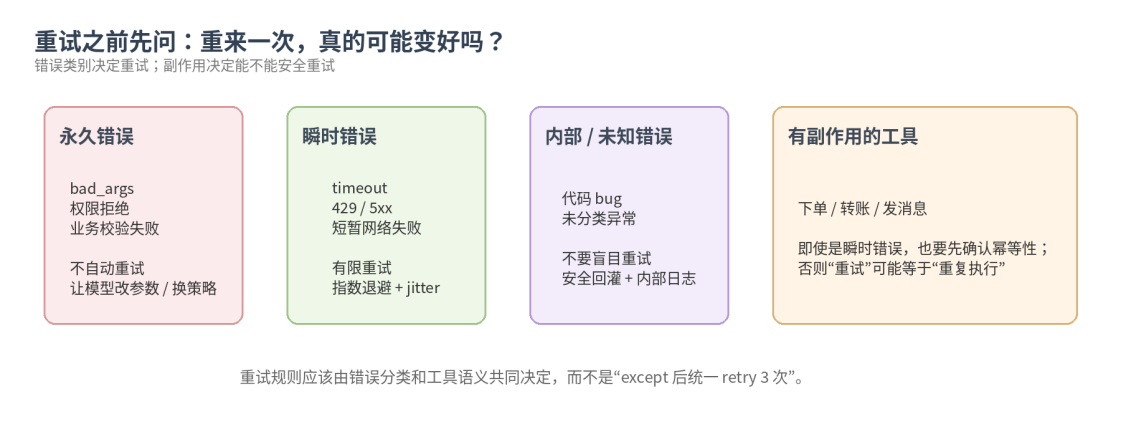
图 2 是否重试由错误类别决定;有副作用的工具还要先解决幂等问题
• 永久错误:不自动重试,把可修正信息回灌给模型。
• 瞬时错误:有限次数 + 指数退避 + jitter;重试本身也要消耗 A17 的预算。
• 下单、转账、发消息等副作用工具:没有幂等键或去重机制之前,不要因为"超时"就机械重试。
六、超时:停止等待,不等于杀掉正在运行的线程
工具最麻烦的失败往往不是"抛异常",而是一直不返回。第一层防线应该尽量下沉:HTTP 客户端设置 connect/read timeout,数据库驱动设置 statement timeout,让依赖自己先结束。ToolExecutor 的 timeout 只做最后一道看门人。
需要特别纠正一个常见误解:future.result(timeout=5) 只能让调用方停止等待,不能强行终止已经开始执行的 Python 线程。
因此线程超时后可以把本次调用标记为 timeout 并继续 Agent,但后台任务可能仍在运行。需要"可强杀"的工具,应放到进程、容器或独立作业系统里做隔离,而不是指望线程超时替你终止任意代码。
七、错误消息要脱敏,而且要短
模型不是你的日志系统。traceback、绝对路径、数据库连接串、URL 查询参数、API Key 都不应该原样进入上下文。给模型的内容只保留"做决策所需的信息";完整堆栈写内部日志,并用 trace_id 把两边关联起来。
• 模型可见:kind、简短 message、retryable、必要的合法参数提示。
• 仅内部日志:traceback、原始请求、连接信息、调试上下文。
• 错误文本设硬上限,例如 200~500 字符,避免一次异常把上下文撑大。
八、并行 tool_calls:失败也必须按 tool_call_id 归位
A16 之后,一轮里可能同时出现多个 Tool Call。此时"有一条失败"还不够,模型必须知道到底是哪一条失败。成功结果和错误结果都要携带原来的 tool_call_id,并按调用关系回填。
|--------------|------------------|--------------------------|
| 并发现场 | 错误做法 | 正确做法 |
| 3 个工具里 1 个失败 | 把异常汇总成一句"工具执行失败" | 每条结果独立返回自己的 tool_call_id |
| 一个工具超时 | 取消整批任务 | 其余调用照常收集;超时只影响自己 |
| 返回顺序变化 | 按完成顺序猜对应关系 | 按 id 关联,不依赖完成先后 |
九、一个够用的 ToolExecutor
执行器骨架:参数预校验 + 超时等待 + 有限重试 + 统一 Observation
from concurrent.futures import ThreadPoolExecutor, TimeoutError as FutureTimeout
import inspect, time, random

class ToolTemporaryError(RuntimeError):
    pass

class ToolExecutor:
    def __init__(self, timeout=5.0, max_retries=2, workers=8):
        self.timeout = timeout
        self.max_retries = max_retries
        self.pool = ThreadPoolExecutor(max_workers=workers)

    def call(self, fn, args, *, tool, call_id):
        try:
            inspect.signature(fn).bind(**args)
        except TypeError as e:
            return self.err(tool, call_id, "bad_args", str(e), False)

        for attempt in range(self.max_retries + 1):
            fut = self.pool.submit(fn, **args)
            try:
                value = fut.result(timeout=self.timeout)
                if value is None:
                    return self.err(tool, call_id, "empty", "没有可用结果", False)
                return {"ok": True, "tool": tool,
                        "tool_call_id": call_id, "value": value}
            except FutureTimeout:
                err = ("timeout", "执行超过 %.1fs" % self.timeout, True)
            except ToolTemporaryError as e:
                err = ("api_error", str(e), True)
            except Exception as e:
                err = ("internal", type(e).__name__, False)

            kind, msg, retryable = err
            if not retryable or attempt == self.max_retries:
                return self.err(tool, call_id, kind, msg, retryable)
            time.sleep(0.3 * (2 ** attempt) + random.random() * 0.2)

    @staticmethod
    def err(tool, call_id, kind, msg, retryable):
        return {"ok": False, "tool": tool, "tool_call_id": call_id,
                "kind": kind, "message": msg[:300],
                "retryable": retryable}
这里故意只把"明确标记为临时错误"的异常纳入自动重试。真实项目可以让每个 Tool 自己抛出更具体的业务异常,再由统一分类器映射成 kind;不要把所有 Exception 都塞进 retry。
十、把 A18 接回 A16 Dispatcher 和 A17 StepGuard
三层职责拼回 Agent Loop
for call in output.tool_calls:
    tool = registry.get(call.name)                 # A16
    obs = executor.call(                           # A18
        tool.func, call.arguments,
        tool=call.name, call_id=call.id,
    )
    messages.append(to_tool_message(call.id, obs))

reason = guard.after_step(usage, output.tool_calls) # A17
if reason:
    return finish(reason, messages)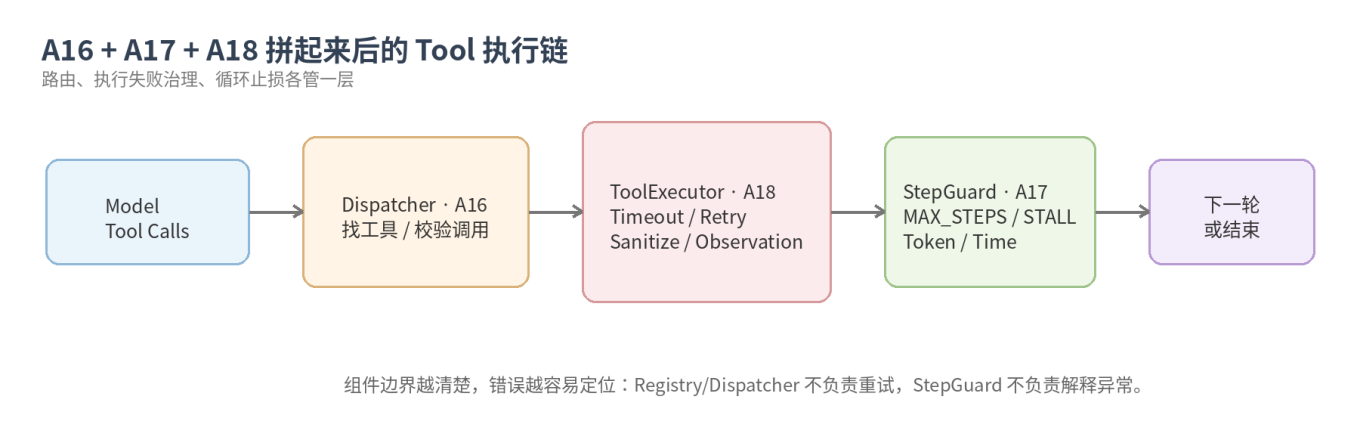
图 3 Dispatcher 管路由,ToolExecutor 管执行失败,StepGuard 管循环是否继续
十一、几个最容易写错的地方
• 误区 1:except Exception 后直接 retry。错误没有分类,重试只是在放大成本。
• 误区 2:把所有 TypeError 都当成模型参数错。先 bind;执行期 TypeError 很可能是内部 bug。
• 误区 3:线程 timeout 就认为任务被杀掉。它只代表"调用方不再等"。
• 误区 4:把 traceback 原样交给模型。调试信息和模型可见信息必须分层。
• 误区 5:错误结果丢掉 tool_call_id。并行工具一多,模型就无法把错误归位。
• 误区 6:None 当成功。空结果也是一种需要模型重新决策的 Observation。
十二、下一篇
下一篇 19《Agent 如何处理重复 Tool Call》会继续处理失败恢复之后的新问题:同一个调用因为模型复读、网络抖动或重试被执行两次怎么办?我们会把 tool_call 指纹、幂等键与重复检测接进 Runtime,让"可以重试"不再等于"可以重复执行"。