【前言】
在上一篇博客里,我们从冯诺依曼体系结构讲到了操作系统的定位,从进程的本质 task_struct 讲到了 fork 创建进程,从七种进程状态讲到了僵尸进程和孤儿进程。如果你还没看上篇,建议先去看一下,因为这篇是承接上篇的。
这篇作为下篇,我们要讲的内容更深入一些:进程优先级是怎么回事,PRI 和 NI 是什么关系,竞争性、独立性、并行、并发这四个概念怎么区分,进程切换的时候 CPU 到底做了什么,Linux 2.6 内核经典的 O (1) 调度算法是怎么实现的,环境变量的底层原理是什么,以及最重要的 ------ 虚拟地址空间,为什么我们 C 语言里看到的地址都不是物理地址。
一、进程优先级 ------ 谁先谁后的学问
1.1 基本概念
CPU 资源分配的先后顺序,就是指进程的优先权(priority)。
优先权高的进程有优先执行的权利。配置进程优先权对多任务环境的 Linux 很有用,可以改善系统性能。比如你希望自己的编译任务跑得快一点,就可以给它设高一点的优先级。
还可以把进程运行到指定的 CPU 上,这样一来,把不重要的进程安排到某个 CPU,可以大大改善系统整体性能。这在多核 CPU 上叫 CPU 亲和性。
1.2 查看系统进程
在 Linux 或者 Unix 系统中,用 ps -l 命令可以看到进程的优先级信息。输出中我们重点关注这几列:
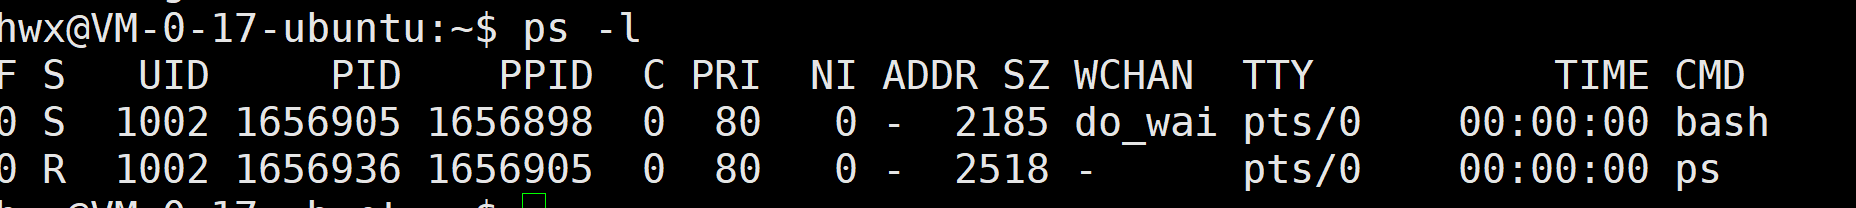
UID:代表执行者的身份。
PID:代表这个进程的代号。
PPID:代表这个进程是由哪个进程发展衍生而来的,也就是父进程的代号。
PRI:代表这个进程可被执行的优先级,其值越小越早被执行。
NI:代表这个进程的 nice 值。
1.3 PRI 和 NI 的关系
PRI 比较好理解,就是进程的优先级,通俗点说就是程序被 CPU 执行的先后顺序,此值越小进程的优先级别越高。
那 NI 呢?nice 值表示进程可被执行的优先级的修正数值。
PRI 值越小越快被执行,加入 nice 值后,PRI 的计算公式是:PRI (new) = PRI (old) + nice
这样,当 nice 值为负值的时候,该程序的优先级值将变小,即其优先级会变高,越快被执行。当 nice 值为正值的时候,优先级值变大,优先级变低。
所以,调整进程优先级,在 Linux 下,本质上就是调整进程的 nice 值。
nice 的取值范围是 - 20 至 19,一共 40 个级别。-20 是最高优先级(最 "不 nice",抢 CPU 最凶),19 是最低优先级(最 "nice",很谦让)。
1.4 PRI vs NI------ 重要提醒
需要强调一点:进程的 nice 值不是进程的优先级,它们不是一个概念,但是进程的 nice 值会影响到进程的优先级变化。
可以理解 nice 值是进程优先级的修正数据。PRI 是最终的优先级,NI 是用来调整 PRI 的一个偏移量。
在实际的 Linux 内核中,普通进程的优先级是 100 到 139,对应的 nice 值是 - 20 到 19。优先级 100 对应 nice -20(最高),优先级 139 对应 nice 19(最低)。这个对应关系我们后面讲 O (1) 调度的时候还会提到。
1.5 查看和修改进程优先级的命令
用 top 命令可以更改已存在进程的 nice 值:
- 输入 top 回车。
- 进入 top 后按 "r" 键。
- 输入进程 PID。
- 输入 nice 值(可以是负数,需要 root 权限才能设负值)。
其他调整优先级的命令还有 nice 和 renice: nice 命令:在启动程序的时候指定 nice 值,比如 nice -n 10 ./a.out,就是以 nice 值 10 启动程序。 renice 命令:修改已经运行的进程的 nice 值,比如 renice -5 -p 1234,把 PID 为 1234 的进程的 nice 值改为 - 5。
对应的系统函数是 getpriority 和 setpriority:
#include <sys/time.h>
#include <sys/resource.h>

int getpriority(int which, int who);
int setpriority(int which, int who, int prio);
getpriority 用来获取进程、进程组或用户的优先级,setpriority 用来设置。
二、四个重要概念 ------ 竞争、独立、并行、并发
这四个概念经常被放在一起考,也很容易搞混,我们一个个来说。
2.1 竞争性
系统进程数目众多,而 CPU 资源只有少量,甚至 1 个,所以进程之间是具有竞争属性的。
为了高效完成任务,更合理地竞争相关资源,便有了优先级。优先级高的进程先获得 CPU,优先级低的后获得。这就是竞争性的体现。
2.2 独立性
多进程运行,需要独享各种资源,多进程运行期间互不干扰。
一个进程崩溃了,不应该影响其他进程。一个进程修改了自己的数据,不应该影响其他进程的数据。这就是独立性。
独立性是通过虚拟地址空间来实现的,每个进程有自己独立的地址空间,互相看不到对方的内存。这个我们后面讲虚拟地址空间的时候会详细说。
2.3 并行
多个进程在多个 CPU 下分别、同时进行运行,这称之为并行。
比如你的电脑是 4 核 CPU,那么同一时刻可以有 4 个进程分别在 4 个核心上同时执行,这就是并行。并行强调的是 "同时",需要多个 CPU 核心。
2.4 并发
多个进程在一个 CPU 下采用进程切换的方式,在一段时间之内,让多个进程都得以推进,称之为并发。
比如单核 CPU,同一时刻只能运行一个进程。但是操作系统可以让进程 A 运行 10 毫秒,切换到进程 B 运行 10 毫秒,再切换到进程 C 运行 10 毫秒。因为切换速度很快,用户感觉起来就像多个进程同时在运行一样。这就是并发。
并发强调的是 "一段时间内都在推进",不要求同一时刻同时运行,单个 CPU 也能实现并发。
总结一下:并行是真的同时跑(需要多核),并发是快速切换看起来像同时跑(单核也能做到)。现在的多核系统中,并行和并发是同时存在的。
三、进程切换 ------CPU 的 "换台" 艺术
3.1 什么是进程切换
CPU 上下文切换,其实际含义是任务切换,或者 CPU 寄存器切换。
当多任务内核决定运行另外的任务时,它保存正在运行任务的当前状态,也就是 CPU 寄存器中的全部内容。这些内容被保存在任务自己的堆栈中。入栈工作完成后,就把下一个将要运行的任务的当前状况从该任务的栈中重新装入 CPU 寄存器,并开始下一个任务的运行。这一过程就是 context switch(上下文切换)。
我们来打个比方。CPU 就像一个学生,他同时要学好几门课。学数学的时候,他在草稿纸上写了一堆数学公式,书翻到了第 30 页。这时候闹钟响了,该学英语了。他需要把数学书的页码、草稿纸上的内容都记下来(保存上下文),然后拿出英语书,翻到上次学到的页码,恢复之前的学习状态(恢复上下文),然后开始学英语。
进程切换也是一样的道理。CPU 里的寄存器数量有限,当前进程运行的时候,寄存器里存的是当前进程的数据。切换到下一个进程之前,要把这些寄存器的值保存到当前进程的 task_struct 或者内核栈里(保存上下文)。然后把下一个进程之前保存的寄存器值恢复到 CPU 寄存器里(恢复上下文),这样下一个进程就能从上次中断的地方继续执行了。
3.2 时间片
当代计算机都是分时操作系统,每个进程都有它合适的时间片(其实就是一个计数器)。时间片到达,进程就被操作系统从 CPU 中剥离下来,放到运行队列里,然后调度另一个进程上 CPU 运行。
时间片的设计很有讲究。时间片太短,进程切换太频繁,切换本身的开销就很大,效率低。时间片太长,并发的体验就差,用户感觉卡顿。Linux 的默认时间片大概是几毫秒到几十毫秒的量级,根据进程的优先级和类型动态调整。
3.3 进程切换的代价
进程切换是有代价的。保存和恢复寄存器需要时间,切换页表(如果是不同进程的话)会导致 TLB 失效,缓存命中率下降。所以进程切换不是越多越好,操作系统会尽量平衡响应性和吞吐量。
四、Linux 2.6 内核 O (1) 调度算法 ------ 经典的调度设计
Linux 2.6 内核引入了 O (1) 调度器,这是一个非常经典的调度算法设计。它的核心思想是:不管系统里有多少个进程,选择下一个要运行的进程的时间都是常数 O (1),不随进程数量增加而变慢。
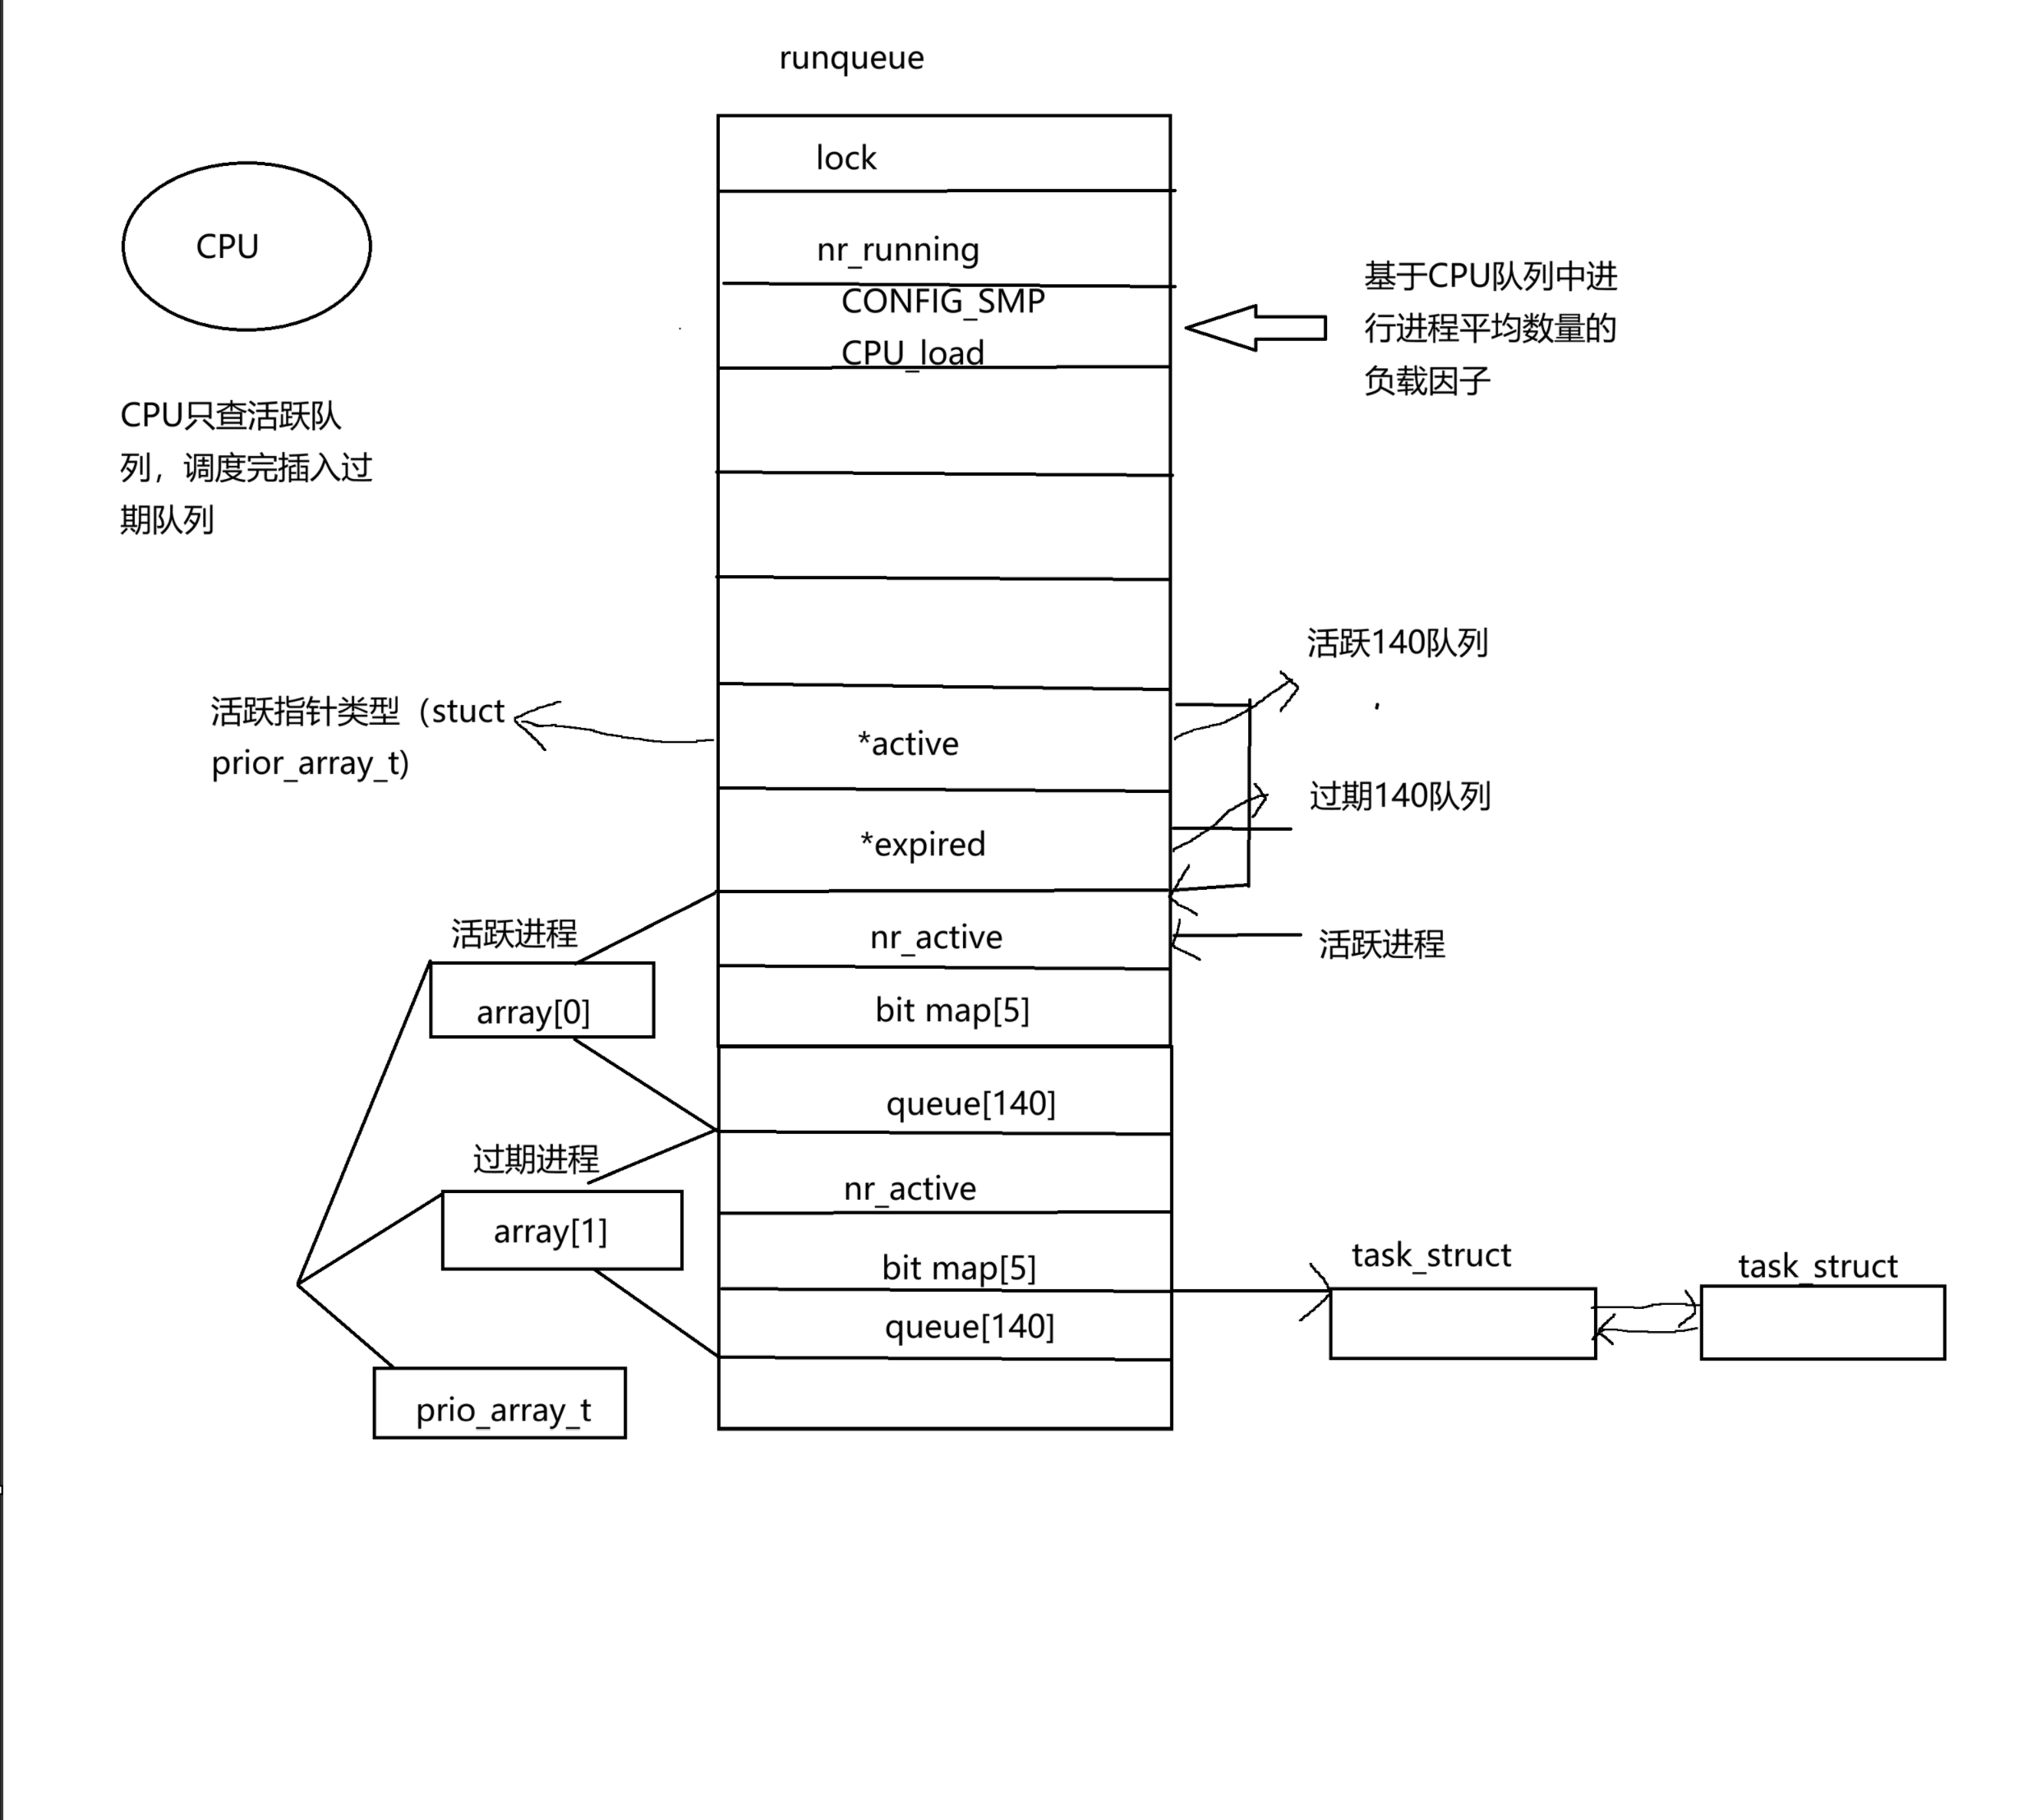
4.1 一个 CPU 拥有一个 runqueue
在 O (1) 调度器中,每个 CPU 拥有一个运行队列(runqueue)。如果有多个 CPU,就要考虑进程个数的负载均衡问题,把进程尽量均匀地分配到各个 CPU 上。
4.2 优先级分类
Linux 的进程优先级分为两类:
普通优先级:100~139。我们平时写的普通用户进程都是这个优先级范围,对应 nice 值 - 20 到 19。
实时优先级:0~99。给实时进程用的,优先级比普通进程高,我们一般不关心。
总共 140 个优先级级别。
4.3 活动队列(active array)
时间片还没有结束的所有进程,都按照优先级放在活动队列里。
活动队列的结构是 prio_array,里面有三个关键字段:
nr_active:总共有多少个运行状态的进程。
queue 140:一个元素就是一个进程队列,相同优先级的进程按照 FIFO 规则进行排队调度。所以,数组下标就是优先级!比如 queue 100 就是优先级 100 的进程队列,queue 139 就是优先级 139 的进程队列。
bitmap 5:一共 140 个优先级,一共 140 个进程队列。为了提高查找非空队列的效率,用 5 个 32 位整数(共 160 个比特位,够用)表示队列是否为空。哪个优先级有进程,对应的比特位就置 1。
从活动队列中选择一个最合适的进程,过程是这样的:
- 从 bitmap 中找到第一个为 1 的比特位,对应的就是优先级最高的非空队列。(用硬件指令可以一步找到,非常快)
- 从该队列中取出第一个进程(FIFO),开始运行。
- 调度完成!
因为 bitmap 的大小是固定的(5 个整数),查找第一个置 1 位的时间是常数,所以整个调度过程是 O (1) 的。
如果没有 bitmap,就要从 queue 0 到 queue 139 遍历找第一个非空队列,虽然 140 次循环也不算多,但 bitmap 的方式更高效。
4.4 过期队列(expired array)
过期队列和活动队列结构一模一样,也是 prio_array。
过期队列上放置的进程,都是时间片耗尽的进程。当一个进程的时间片用完了,它就从活动队列移到过期队列,并且重新计算它的时间片。
当活动队列上的进程都被处理完毕之后(活动队列为空了),对过期队列的进程进行时间片重新计算(其实在移入过期队列的时候就已经算好了),然后把过期队列变成新的活动队列。
4.5 active 指针和 expired 指针
runqueue 里有两个指针:active 指针和 expired 指针。
active 指针永远指向活动队列。 expired 指针永远指向过期队列。
可是活动队列上的进程会越来越少,过期队列上的进程会越来越多,因为进程时间片到期时会从活动队列移到过期队列。
没关系,在合适的时候(活动队列为空时),只要交换 active 指针和 expired 指针的内容,就相当于有了一批新的活动进程!这个交换只是两个指针的交换,O (1) 时间,非常巧妙。
4.6 O (1) 调度算法总结
在系统当中查找一个最合适调度的进程的时间复杂度是一个常数,不随着进程增多而导致时间成本增加,我们称之为进程调度 O (1) 算法。
我们来看一下内核中 runqueue 和 prio_array 的结构体定义(简化版):
struct rq {
    spinlock_t lock;
    unsigned long nr_running;  // 运行队列中的进程数
    struct task_struct *curr, *idle;  // 当前运行的进程和idle进程
    struct prio_array *active, *expired, arrays[2];  // 活动队列、过期队列、两个实际的数组
    // ... 其他字段
};

struct prio_array {
    unsigned int nr_active;  // 该队列中的进程数
    DECLARE_BITMAP(bitmap, MAX_PRIO+1);  // 优先级位图,140个优先级
    struct list_head queue[MAX_PRIO];  // 每个优先级一个进程链表
};
可以看到,arrays 2 是两个实际的 prio_array 数组,active 和 expired 是指向这两个数组的指针。交换的时候只需要交换指针,不需要移动数据,非常高效。
O (1) 调度器在 Linux 2.6 到 2.6.22 版本中使用,后来被 CFS(完全公平调度器)取代。但 O (1) 的设计思想非常经典,理解它对学习调度算法很有帮助。
五、环境变量 ------ 进程的 "全局配置"
5.1 基本概念
环境变量(environment variables)一般是指在操作系统中用来指定操作系统运行环境的一些参数。
比如我们在编写 C/C++ 代码的时候,在链接的时候,从来不知道我们所链接的动态静态库在哪里,但是照样可以链接成功,生成可执行程序。原因就是有相关环境变量帮助编译器进行查找。
环境变量通常具有某些特殊用途,在系统当中通常具有全局特性。
5.2 常见环境变量
PATH:指定命令的搜索路径。当你在 shell 里输入一个命令比如 ls,shell 会去 PATH 环境变量里记录的所有目录下找 ls 这个可执行文件,找到了就执行。
HOME:指定用户的主工作目录。用户登录到 Linux 系统中时的默认目录。
SHELL:当前 Shell,它的值通常是 /bin/bash。
5.3 查看环境变量的方法
用 echo NAME 命令查看,NAME 是你的环境变量名称。比如 echo PATH 查看 PATH 的值,echo $HOME 查看 HOME 的值。
我们来做一个关于 PATH 的实验:
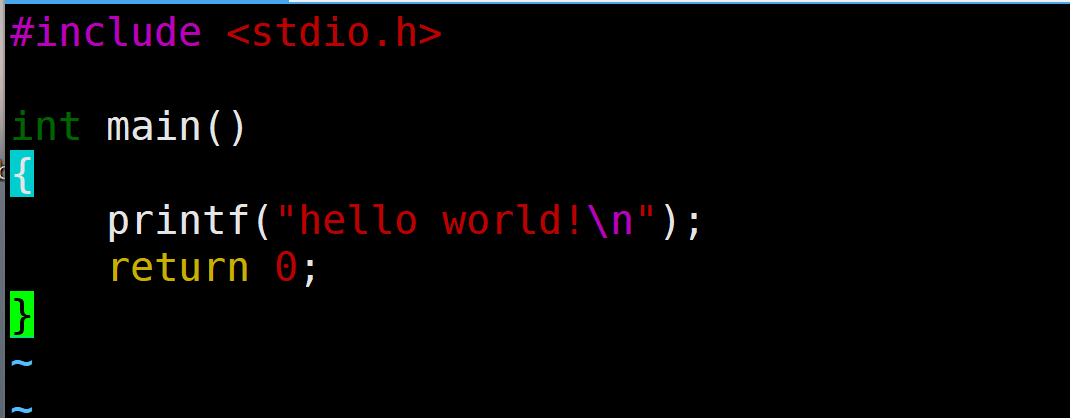
第一步,创建一个 hello.c 文件:
第二步,编译生成hello。你会发现,直接输入hello运行不了,必须输入./hello才能运行。但是系统命令比如 ls、pwd 不需要带路径,直接输入就能运行。
第三步,为什么?因为 ls 这些命令所在的目录(比如 /bin、/usr/bin)在 PATH 环境变量里,shell 会自动去这些目录找。而我们的hello所在的当前目录不在 PATH 里,所以必须带路径./hello。
第四步,将我们的程序所在路径加入环境变量 PATH 当中:PATH=$PATH:pwd后的路径。。
第五步,再输入hello,就能直接运行了,不需要带路径。
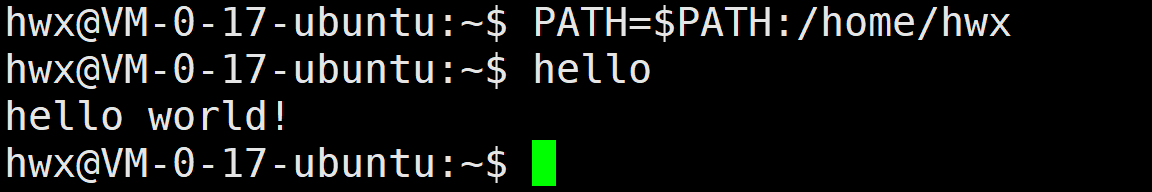
还有什么方法可以不用带路径直接运行呢?把hello放到 PATH 已经包含的目录里,比如 /usr/local/bin(需要 root 权限)。
关于 HOME 的实验:用 root 和普通用户分别执行 echo $HOME,对比差异。root 的 HOME 通常是 /root,普通用户的 HOME 通常是 /home/ 用户名。执行 cd ~; pwd,你会发现~就代表 HOME 目录,cd ~ 就是切换到 HOME 目录。
5.4 和环境变量相关的命令
echo:显示某个环境变量值。
export:设置一个新的环境变量。
env:显示所有环境变量。
unset:清除环境变量。
set:显示本地定义的 shell 变量和环境变量。
5.5 环境变量的组织方式
每个程序都会收到一张环境表,环境表是一个字符指针数组,每个指针指向一个以 '\0' 结尾的环境字符串。最后一个指针是 NULL,表示环境表结束。
环境表的结构大概是这样的:
env 0 -> "PATH=/bin:/usr/bin"
env 1 -> "HOME=/home/user"
env 2 -> "SHELL=/bin/bash"
...
env n -> NULL
5.6 通过代码获取环境变量
有三种方式可以在代码中获取环境变量:
第一种,通过 main 函数的第三个参数 env:
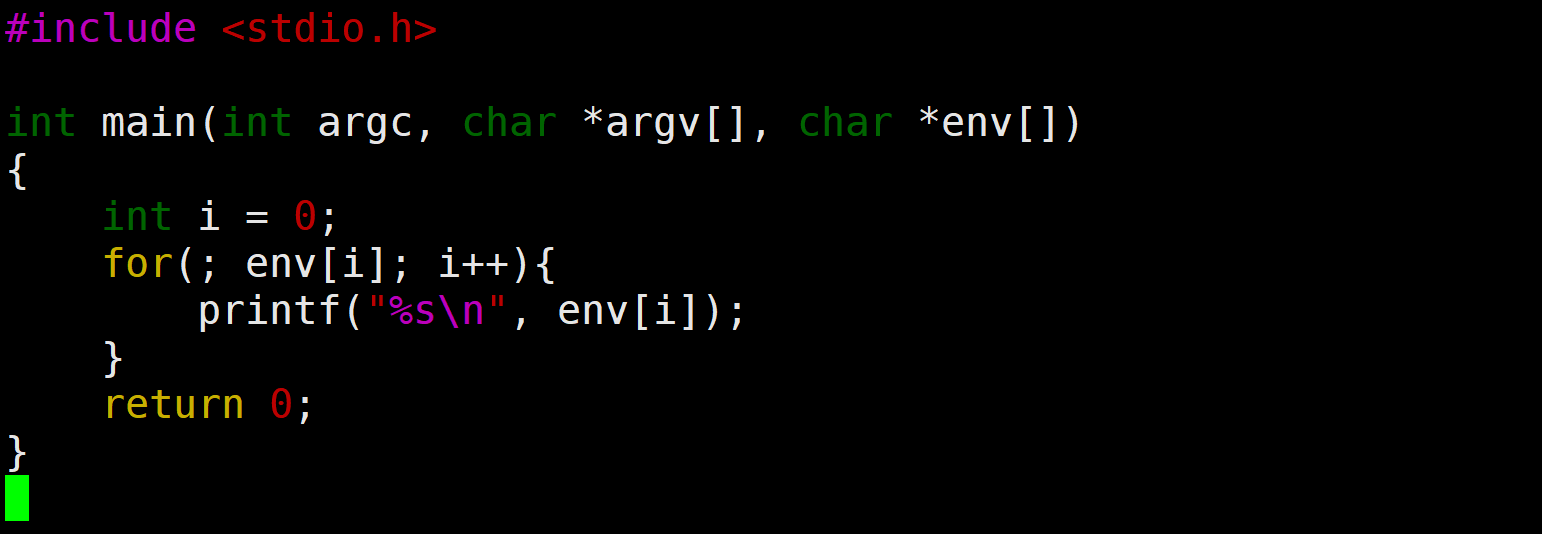
main 函数的第三个参数就是环境表,是一个字符指针数组。遍历它就能打印所有环境变量。
第二种,通过第三方变量 environ 获取:
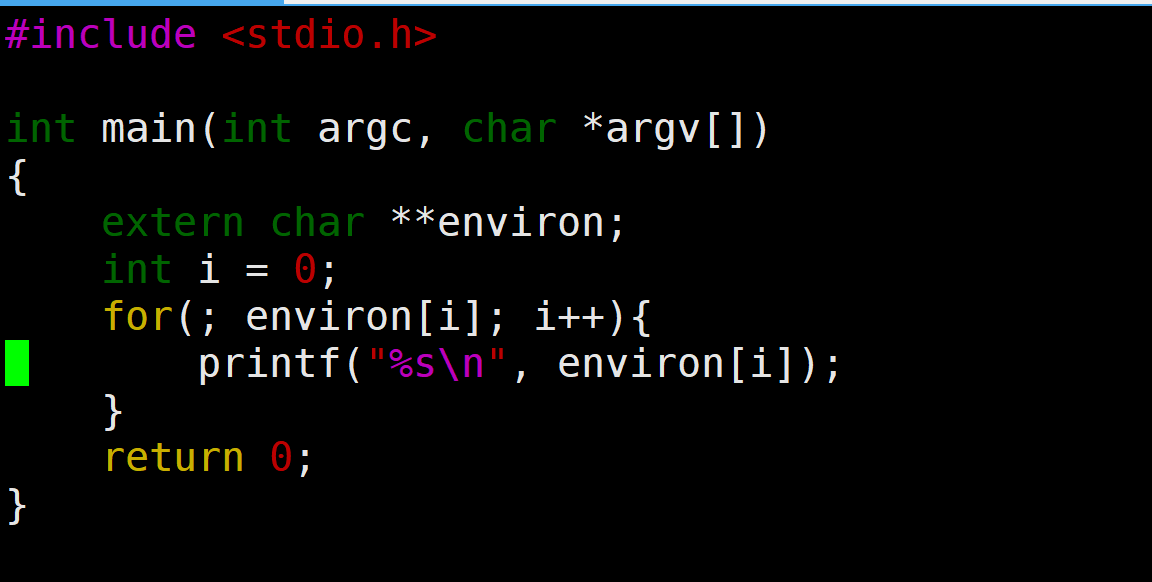
libc 中定义的全局变量 environ 指向环境变量表。environ 没有包含在任何头文件中,所以在使用时要用 extern 声明。
第三种,通过系统调用 getenv 获取特定的环境变量:
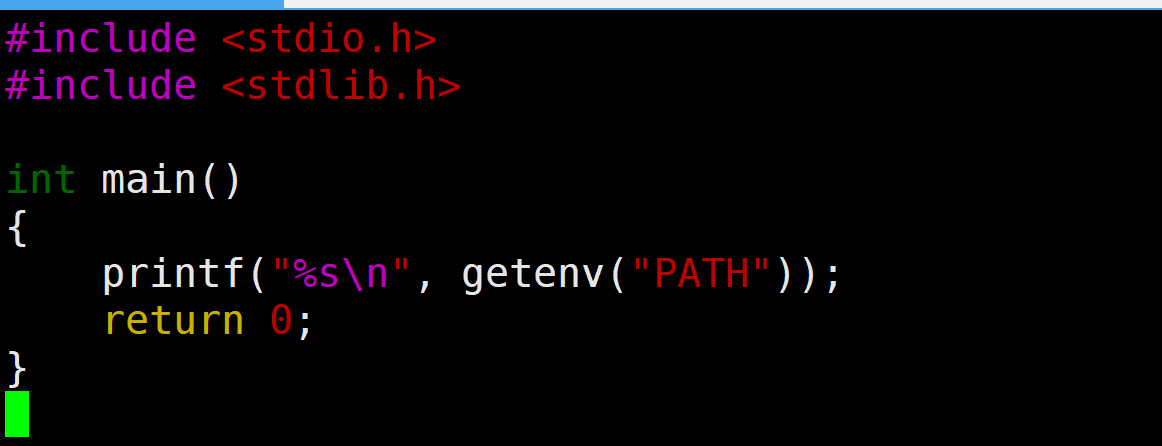
getenv 函数接收一个环境变量名,返回对应的值。如果不存在则返回 NULL。常用 getenv 和 putenv 函数来访问特定的环境变量。
5.7 环境变量的全局属性
环境变量通常具有全局属性,可以被子进程继承下去。
我们来做一个实验:
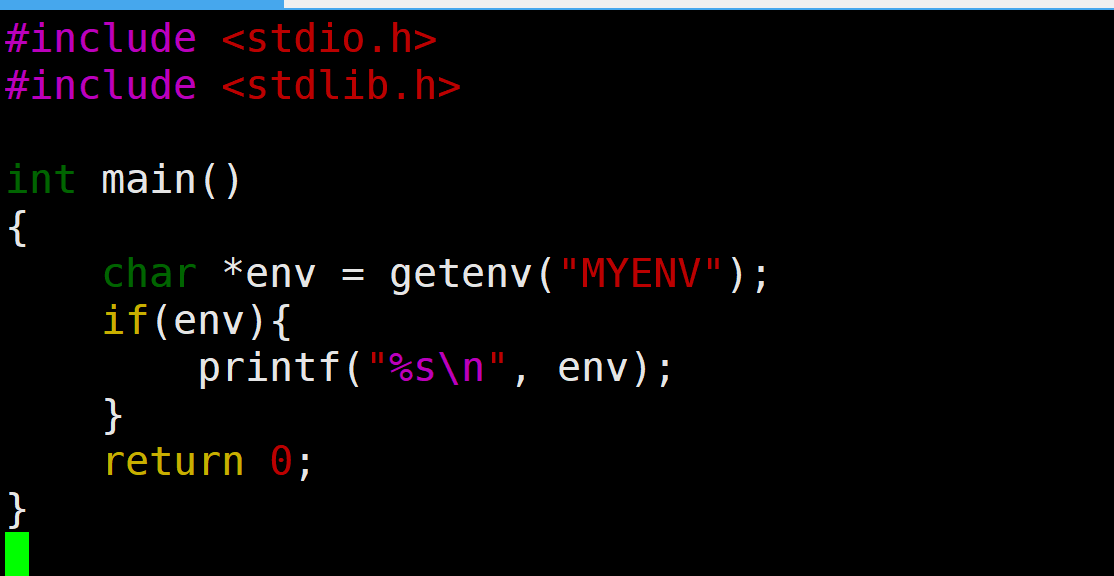
直接运行这个程序,发现没有结果,说明 MYENV 这个环境变量根本不存在。
然后在 shell 里执行 export MYENV="hello world",再次运行程序,发现结果有了!输出 hello world。
这说明:环境变量是可以被子进程继承下去的。因为我们的程序是 shell 的子进程,shell 里 export 的环境变量会被继承到子进程中。
想想为什么?因为 fork 创建子进程的时候,子进程会复制父进程的环境变量表。exec 加载新程序的时候,环境变量表会被保留传递给新程序。所以环境变量具有全局属性,能从父进程传递到子进程。
如果只写 MYENV="helloworld",不调用 export 导出,再用程序查看,会有什么结果?结果是看不到。因为没有 export 的变量只是 shell 的本地变量,不会被子进程继承。
如果想让环境变量永久生效,可以修改~/.bash_profile 或者~/.bashrc 文件,在里面写 export 语句。这样每次登录 shell 的时候都会自动加载。
六、程序地址空间 ------ 你看到的地址都是假的
这部分是整个进程概念中最抽象、也最重要的内容。我们来一步步揭开虚拟地址空间的面纱。
6.1 研究平台说明
我们讨论的平台是 kernel 2.6.32,32 位平台。32 位平台的虚拟地址空间大小是 4GB(2 的 32 次方)。其中 0-3GB 是用户空间,3-4GB 是内核空间。
6.2 程序地址空间回顾
我们在学 C 语言的时候,老师都画过这样的空间布局图:从低地址到高地址依次是代码段、已初始化数据段、未初始化数据段(BSS)、堆(向上增长)、共享库、栈(向下增长)、命令行参数和环境变量。
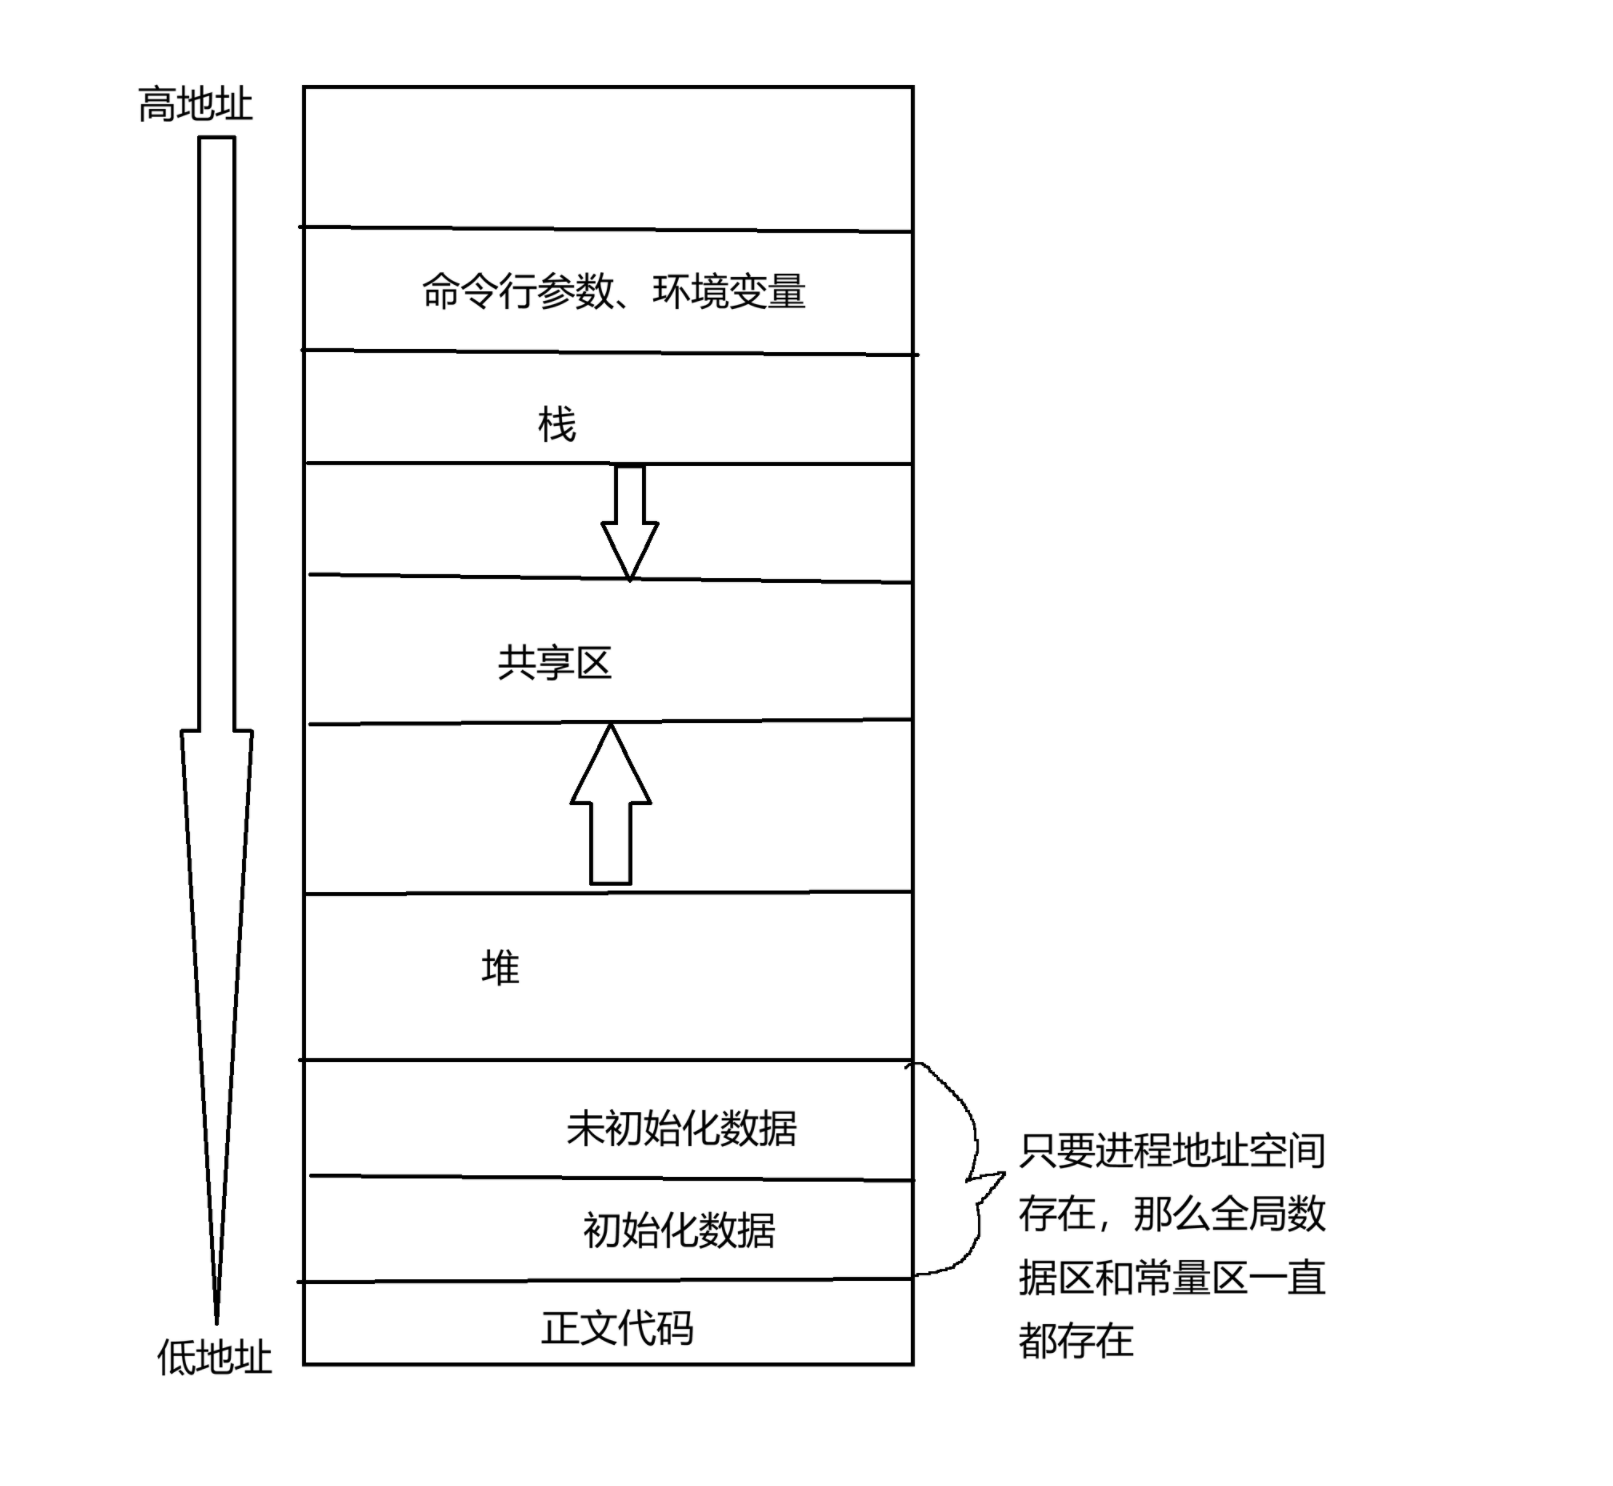
但是很多人只是背了这个图,并不理解为什么要这样布局,也不理解这些地址到底是什么。我们来写一段代码验证一下各区域的地址分布:
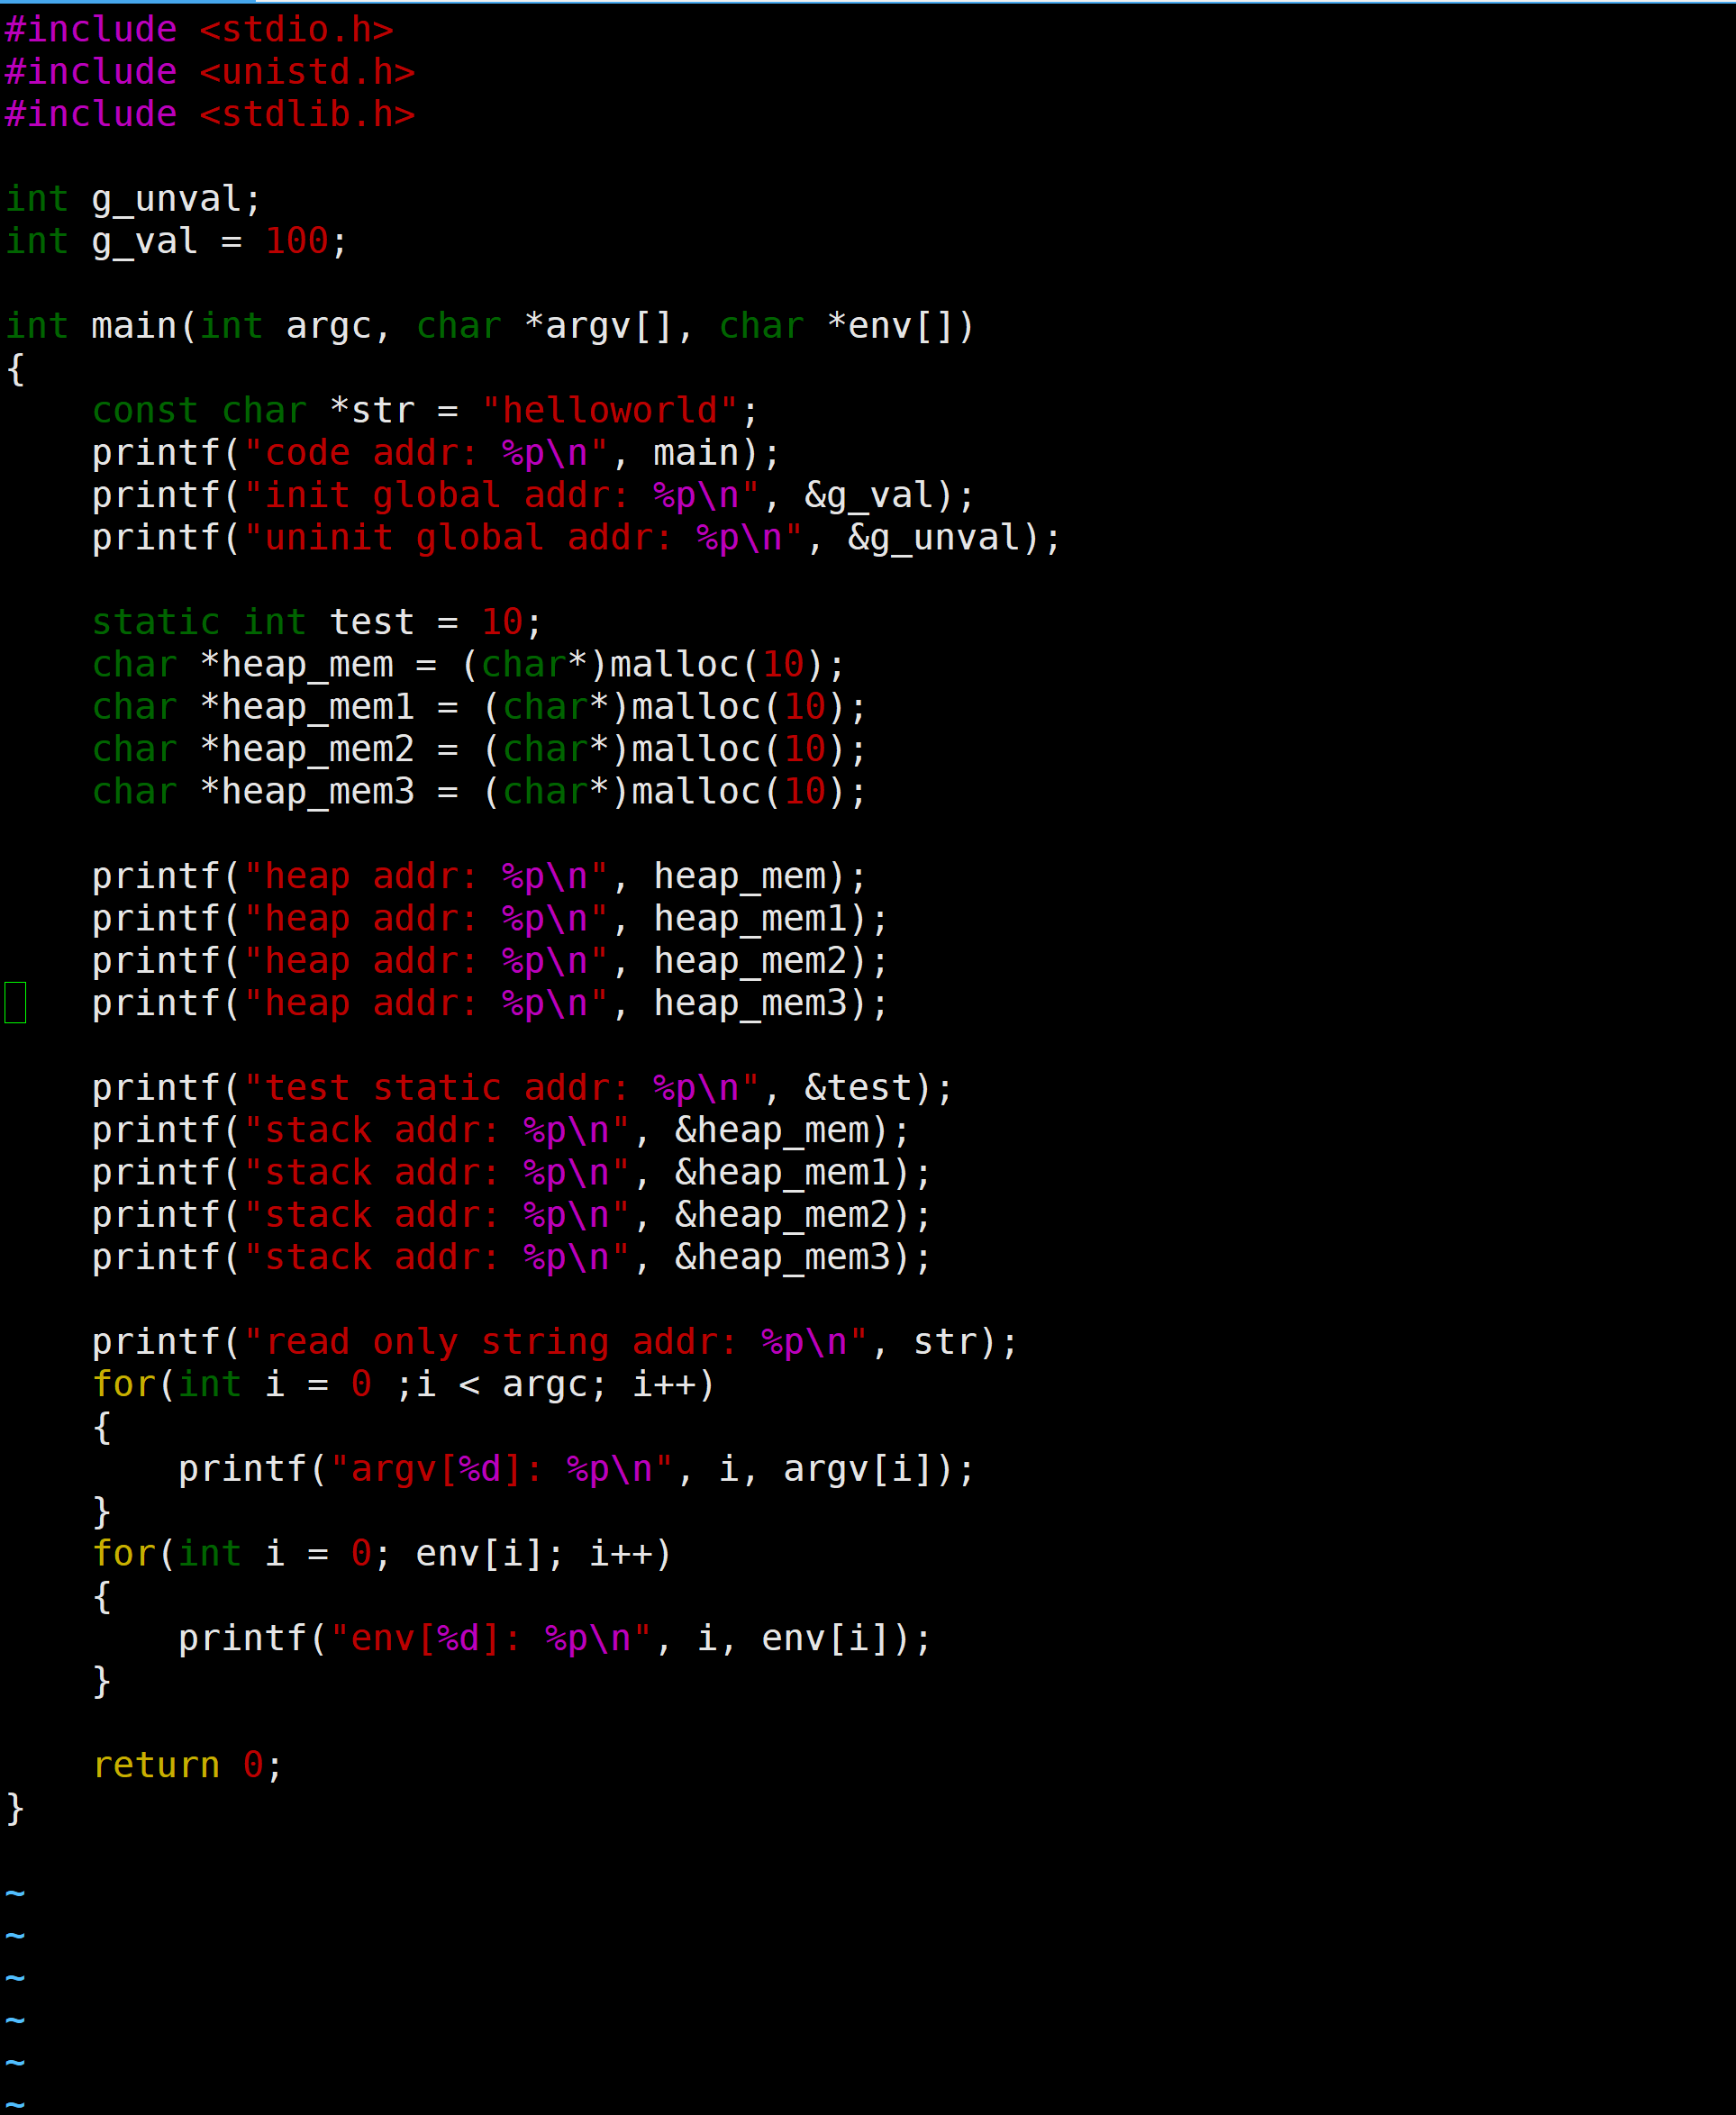
运行结果大概是这样的(具体地址和环境相关):
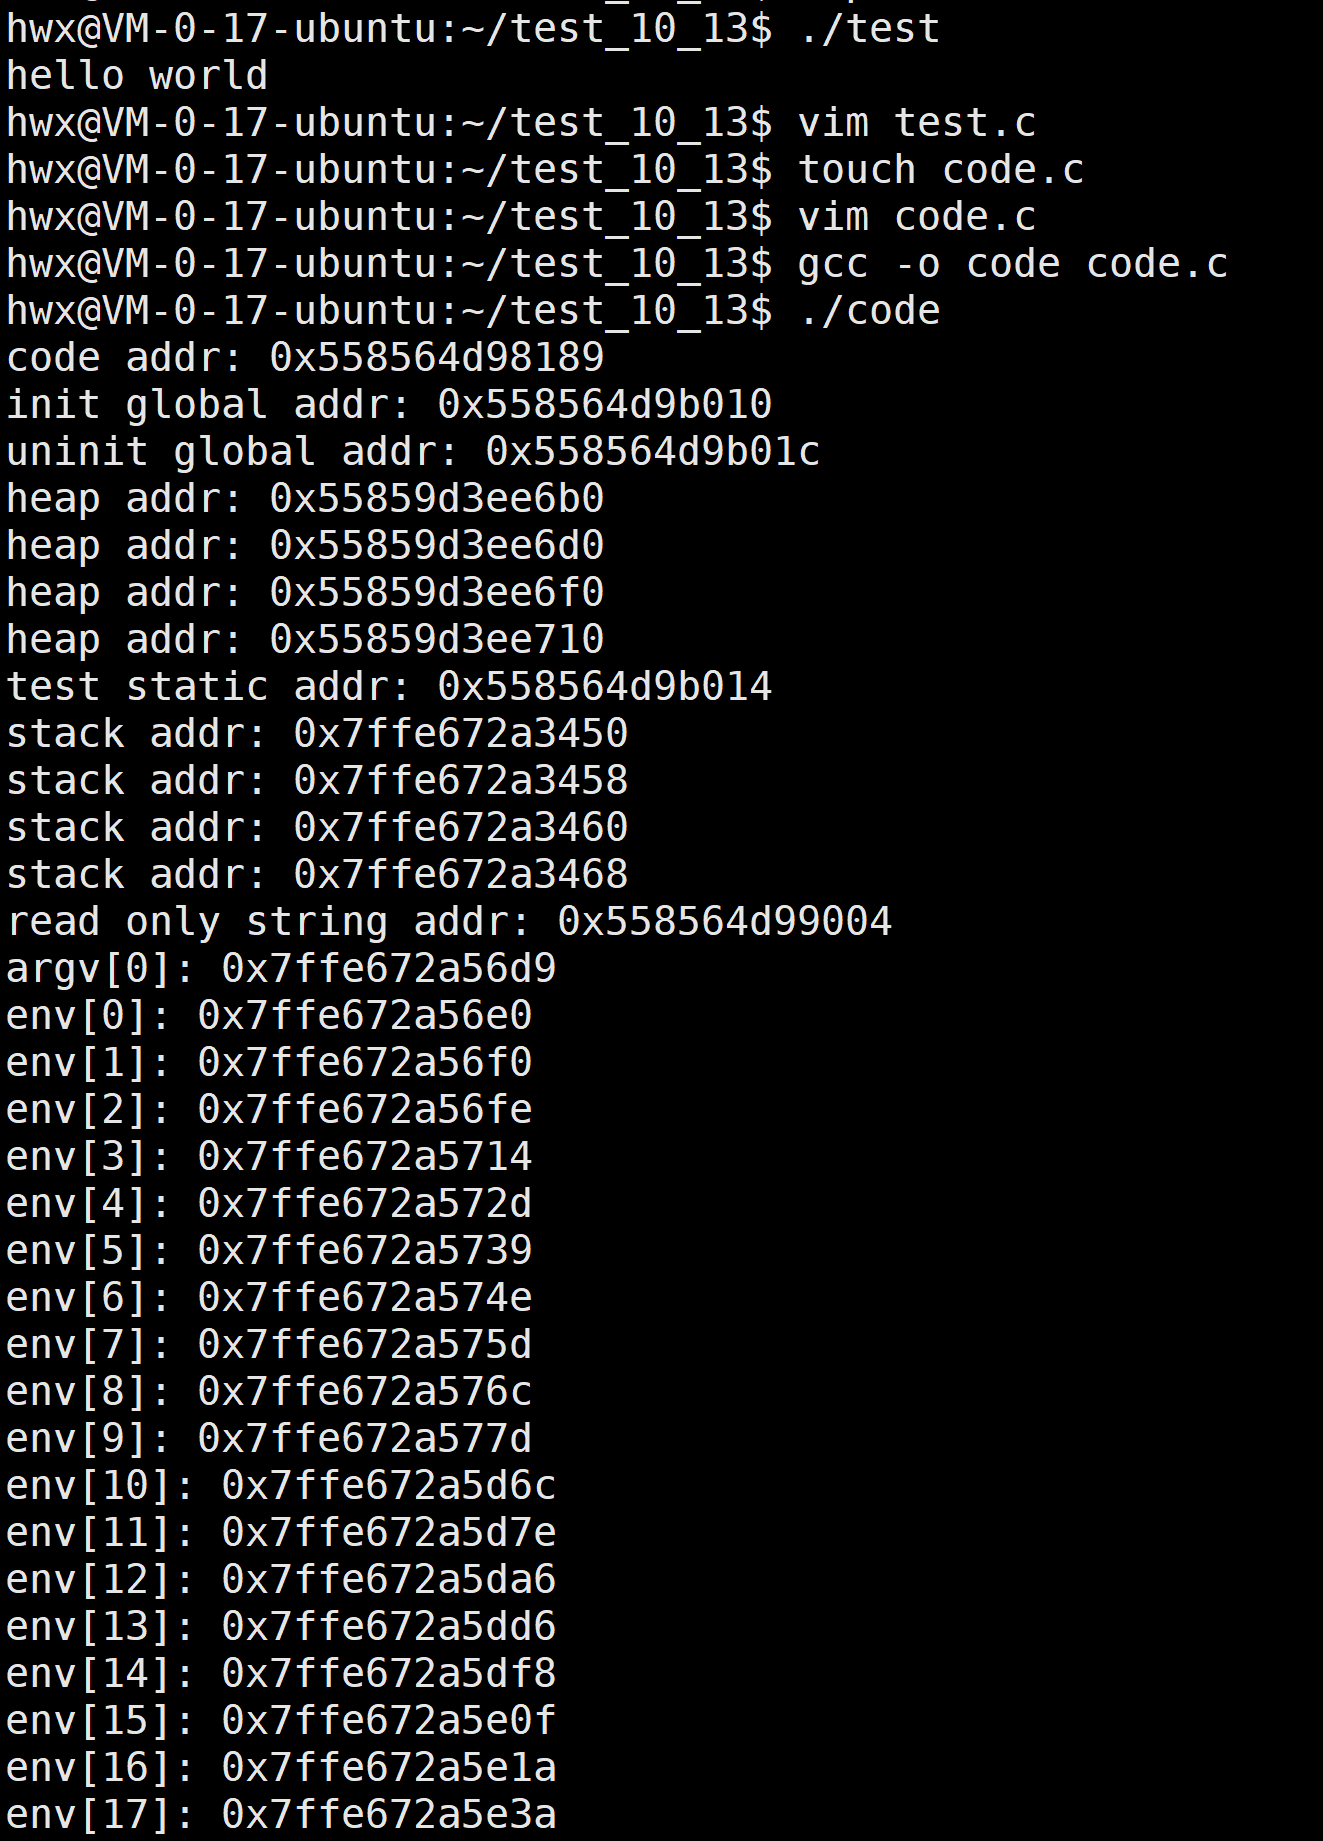
从输出我们可以观察到:
代码段地址最低。
只读字符串在代码段附近。
已初始化全局变量和静态变量在数据段。
未初始化全局变量在 BSS 段。
堆的地址在中间,而且每次 malloc 地址递增,说明堆向上增长。
栈的地址最高,而且变量地址递减,说明栈向下增长。
命令行参数和环境变量在栈的上方,地址最高。
这验证了我们背的那张空间布局图。
6.3 虚拟地址 ------ 一个颠覆认知的实验
接下来我们做一个实验,这个实验会颠覆你对地址的认知。
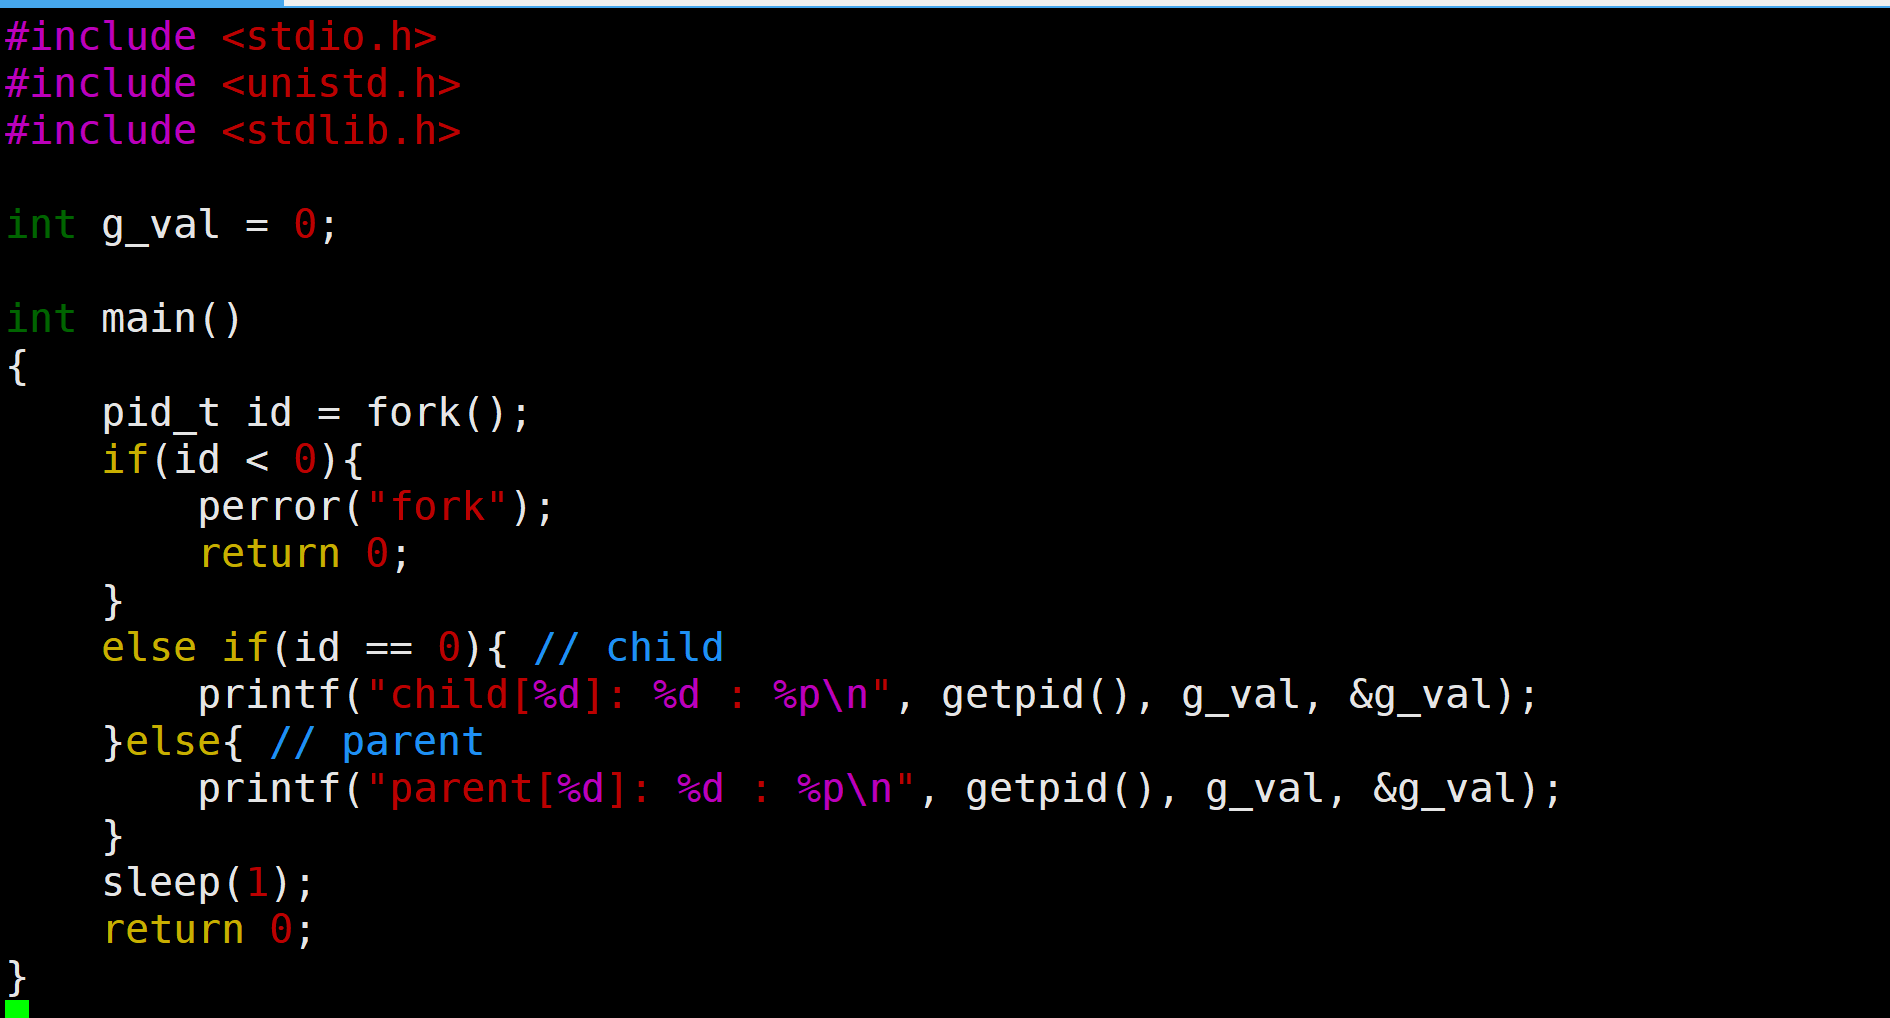
输出:
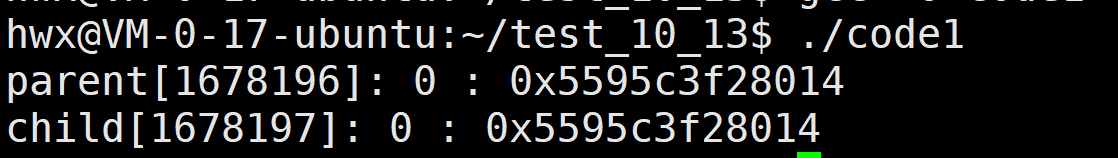
我们发现,父子进程输出的变量值和地址是一模一样的。这很好理解,因为子进程以父进程为模板,父子都没有修改变量。
可是我们把代码稍加改动:
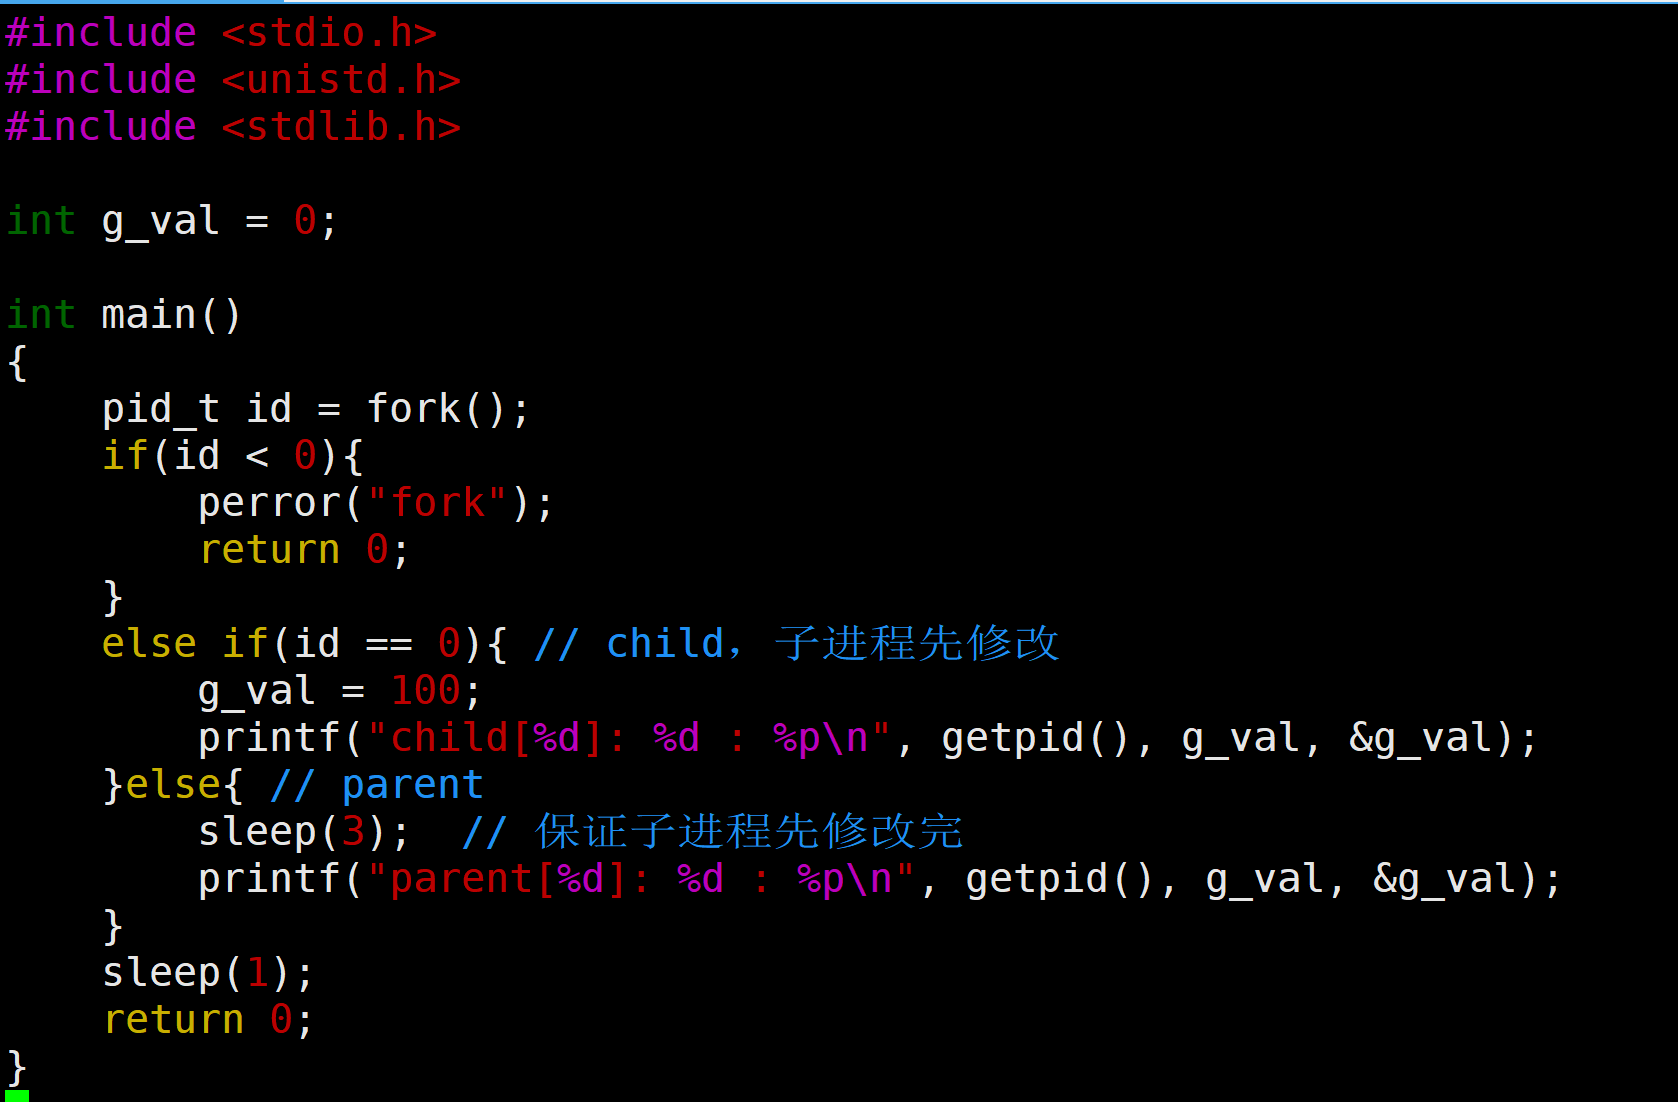
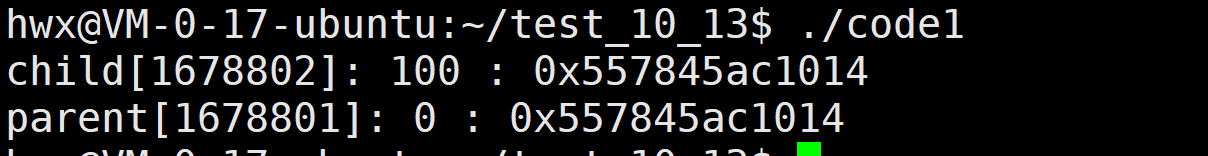
仔细看这个结果!父子进程输出的地址是一样的(都是 0x80497e8),但是变量内容不一样!子进程的 g_val 是 100,父进程的 g_val 是 0。
这怎么可能?如果地址是物理地址,同一个物理地址不可能同时存两个不同的值。
所以我们能得出如下结论:
第一,变量内容不一样,所以父子进程输出的变量绝对不是同一个变量。 第二,但地址值是一样的,说明该地址绝对不是物理地址! 第三,在 Linux 下,这种地址叫做虚拟地址。 第四,我们在用 C/C++ 语言所看到的地址,全部都是虚拟地址!物理地址用户一概看不到,由操作系统统一管理。
操作系统必须负责将虚拟地址转换成物理地址。
这就是虚拟地址空间的核心概念。你在程序里看到的所有地址,包括指针的值、& 取地址的结果,全都是虚拟地址,不是真实的物理内存地址。
6.4 进程地址空间 ------ 每个进程都有自己的 "小世界"
所以之前说 "程序的地址空间" 是不准确的,准确的应该说成 "进程地址空间"。
每个进程都有自己独立的虚拟地址空间。在 32 位系统下,每个进程都认为自己拥有 4GB 的内存空间。但这 4GB 是虚拟的,不是真实的物理内存。
虚拟地址通过页表(page table)映射到物理地址。每个进程有自己独立的页表。所以同一个虚拟地址,在不同进程中,通过不同的页表,可以映射到不同的物理地址。
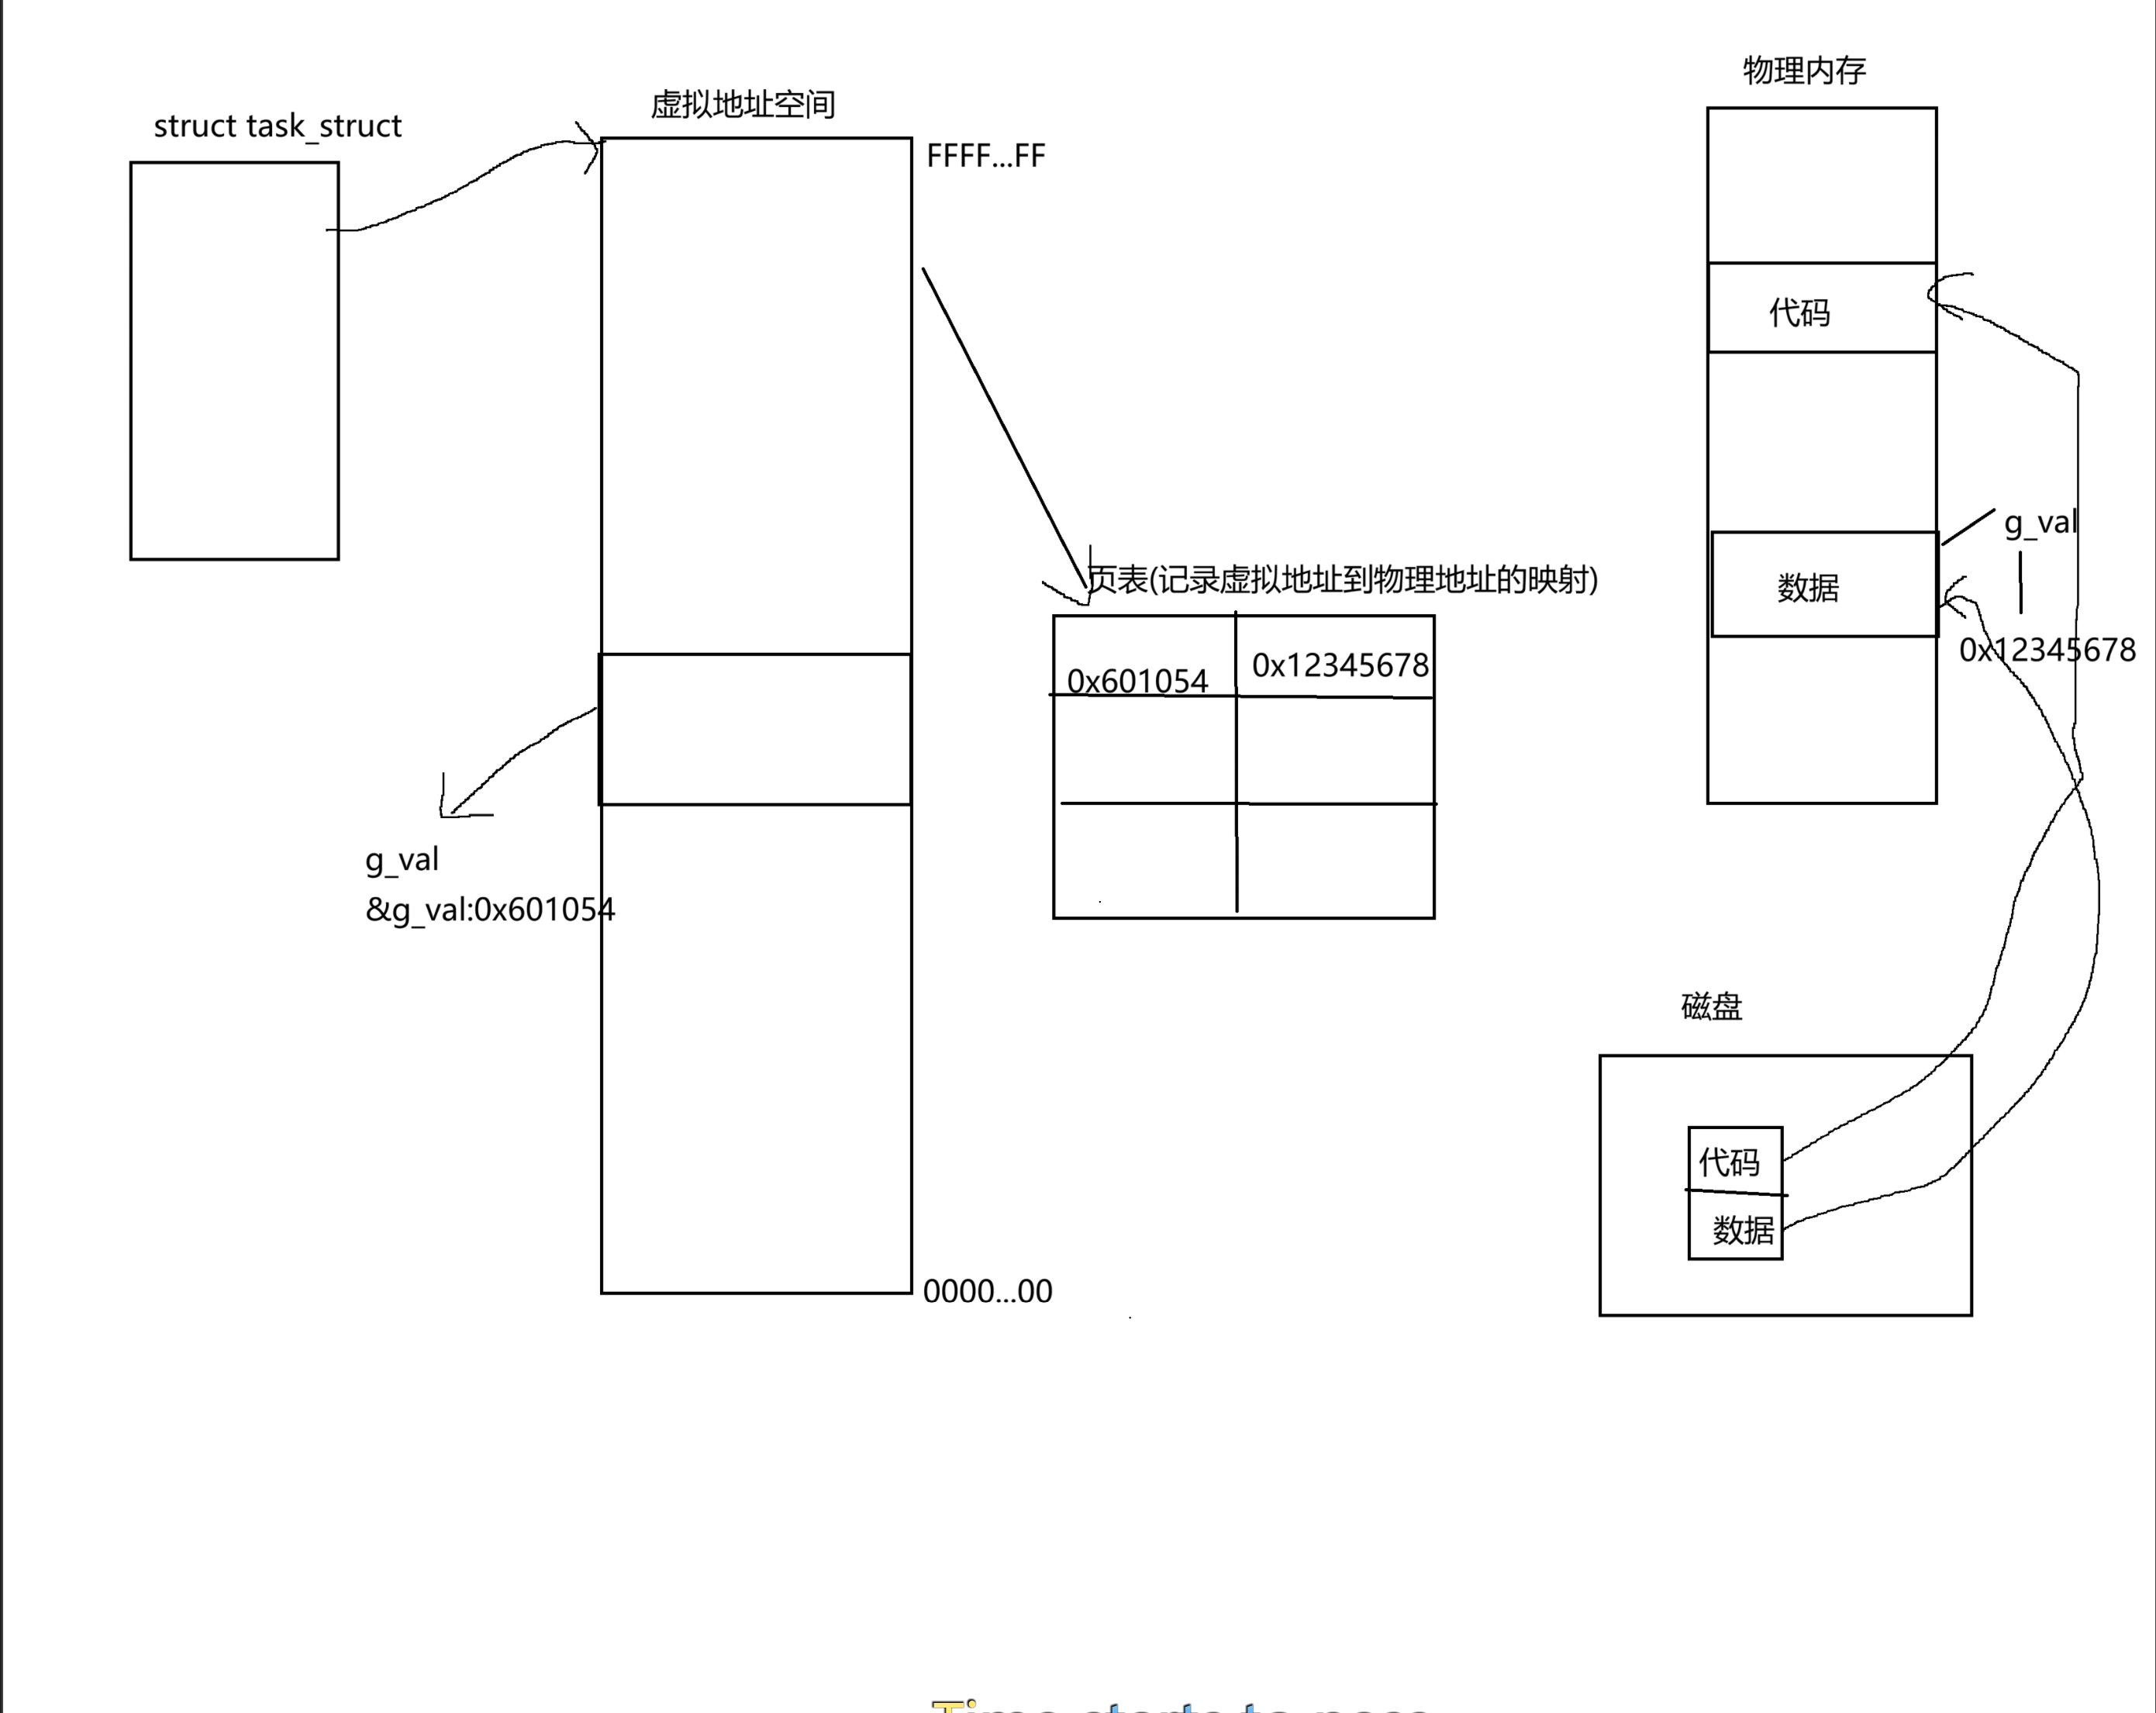
这就解释了上面的实验:父子进程的 g_val 虚拟地址相同,但是它们的页表把这个虚拟地址映射到了不同的物理页。子进程修改的是自己物理页里的值,父进程的物理页里的值没变。所以虚拟地址相同,但内容不同。
这就是写时拷贝的底层实现:fork 的时候,子进程的页表项指向和父进程相同的物理页,并且标记为只读。当子进程尝试写入时,触发缺页异常,内核分配一个新的物理页,把数据拷贝过去,更新子进程的页表项指向新物理页,然后恢复写入权限。这样父子进程就有了各自独立的物理页。
6.5 虚拟内存管理 ------ 内核中的数据结构
描述 Linux 下进程地址空间所有信息的结构体是 mm_struct(内存描述符)。每个进程只有一个 mm_struct 结构,在每个进程的 task_struct 结构中,有一个指向该进程 mm_struct 结构体的指针。
struct task_struct
{
    /*...*/
    struct mm_struct *mm;  // 指向进程的虚拟地址空间
    struct mm_struct *active_mm;  // 内核线程使用
    /*...*/
};
对于普通的用户进程,mm 字段指向它的虚拟地址空间的用户空间部分。对于内核线程,mm 字段为 NULL,因为内核线程没有用户空间。
mm_struct 结构是对整个用户空间的描述。每一个进程都会有自己独立的 mm_struct,这样每一个进程都会有自己独立的地址空间,才能互不干扰。
我们来看 mm_struct 的关键字段:
struct mm_struct
{
    /*...*/
    struct vm_area_struct *mmap;      /* 指向虚拟区间(VMA)链表 */
    struct rb_root mm_rb;             /* 红黑树 */
    unsigned long task_size;          /* 进程虚拟地址空间的大小 */
    // 代码段、数据段、堆栈段、参数段及环境段的起始和结束地址
    unsigned long start_code, end_code, start_data, end_data;
    unsigned long start_brk, brk, start_stack;
    unsigned long arg_start, arg_end, env_start, env_end;
    /*...*/
};
可以看到,mm_struct 里记录了代码段、数据段、堆、栈、参数、环境变量各个区域的起始和结束地址。这就是我们那张空间布局图在内核中的数据结构体现。
那这么多虚拟区域,操作系统是怎么组织的呢?有两种组织方式:
- 当虚拟区较少时,采取单链表,由 mmap 指针指向这个链表。
- 当虚拟区间较多时,采取红黑树进行管理,由 mm_rb 指向这棵树。
Linux 内核使用 vm_area_struct 结构来表示一个独立的虚拟内存区域(VMA,Virtual Memory Area)。由于每个不同性质的虚拟内存区域功能和内部机制都不同,因此一个进程使用多个 vm_area_struct 结构来分别表示不同类型的虚拟内存区域。比如代码段是一个 VMA,数据段是一个 VMA,堆是一个 VMA,每个共享库的映射也是一个 VMA。
struct vm_area_struct {
    unsigned long vm_start;  // 虚存区起始地址
    unsigned long vm_end;    // 虚存区结束地址
    struct vm_area_struct *vm_next, *vm_prev;  // 链表前后指针
    struct rb_node vm_rb;    // 红黑树中的位置
    struct mm_struct *vm_mm; // 所属的mm_struct
    unsigned long vm_flags;  // 标志位(读写权限等)
    const struct vm_operations_struct *vm_ops; // VMA对应的操作
    struct file *vm_file;    // 映射的文件(如果是文件映射)
    // ... 其他字段
};
每个 VMA 描述了一段连续的虚拟地址空间,以及这段空间的属性(可读、可写、可执行、是否文件映射等)。
6.6 为什么要有虚拟地址空间?
这个问题可以转化为:如果程序直接操作物理内存,会造成什么问题?
在早期的计算机中,要运行一个程序,会把程序全都装入内存,程序直接运行在物理内存上。也就是说程序中访问的内存地址都是实际的物理内存地址。当计算机同时运行多个程序时,必须保证这些程序用到的内存总量小于计算机实际物理内存的大小。
比如某台计算机总内存 128M,同时运行程序 A(需 10M)和程序 B(需 110M)。分配方式是:前 10M 给 A,接着 110M 给 B。
这种简单的内存分配策略问题很多:
问题一:安全风险。
每个进程都可以访问任意的内存空间,这意味着任意一个进程都能去读写系统相关内存区域。如果是一个木马病毒,它就能随意修改其他进程甚至操作系统的内存空间,让设备直接瘫痪。没有隔离性,系统毫无安全可言。
问题二:地址不确定。
编译完成后的程序存放在硬盘上,运行的时候需要搬到内存中。如果直接使用物理地址,我们无法确定内存现在使用到哪里了。也就是说程序每次运行被加载到的实际物理地址都是不确定的。第一次运行 a.out 时内存是空的,加载到 0x00000000;第二次运行时内存已经有 10 个进程了,加载地址就完全不同了。这会导致程序中的绝对地址引用全部失效,重定位非常麻烦。
问题三:效率低下。
如果直接使用物理内存,一个进程作为一个整体(内存块)操作。如果物理内存不够用了,一般的办法是将不常用的进程拷贝到磁盘的交换分区中,腾出内存。但如果是物理地址的话,就需要将整个进程一起拷走,在内存和磁盘之间拷贝时间太长,效率较低。而且进程的地址空间必须是连续的,容易产生内存碎片。
有了虚拟地址空间和分页机制,这些问题就都解决了:
第一,安全性。地址空间和页表是 OS 创建并维护的。凡是想使用地址空间和页表进行映射,一定要在 OS 的监管之下进行访问。每个进程只能访问自己的虚拟地址空间映射到的物理内存,无法访问其他进程的内存,也无法随意访问内核内存。这就保护了物理内存中的所有合法数据,包括各个进程以及内核的相关有效数据。
第二,地址确定性。因为有地址空间的存在和页表的映射,物理内存中可以对数据进行任意位置的加载。进程看到的虚拟地址空间是统一的、确定的(比如代码段总是从 0x08048000 开始),不管实际物理内存怎么分配。物理内存的分配和进程的管理就可以做到没有关系,进程管理模块和内存管理模块完成了解耦合。
第三,效率提升(延迟分配)。因为有地址空间的存在,我们在 C、C++ 语言上 new、malloc 空间的时候,其实是在地址空间上申请的,物理内存可以甚至一个字节都不给你。而当你真正对物理地址空间进行访问的时候,才执行内存的相关管理算法,帮你申请内存,构建页表映射关系。这叫延迟分配,由操作系统自动完成,用户和进程完全 0 感知。这样可以提高内存的利用率,不会因为进程申请了但没用的内存而浪费。
第四,内存碎片问题解决。因为页表的映射存在,程序在物理内存中理论上可以任意位置加载,不需要连续的物理内存。虚拟地址是连续的,但映射到的物理页可以是离散的。这就解决了外部碎片问题。