大语言模型非常适合查找证据、串联上下文、解释工程结果。但它不应替代物理模型、经过验证的计算,以及钻井决策所依赖的实测数据。
确定性计算和语言模型推理,解决的是工程问题中不同部分的问题。
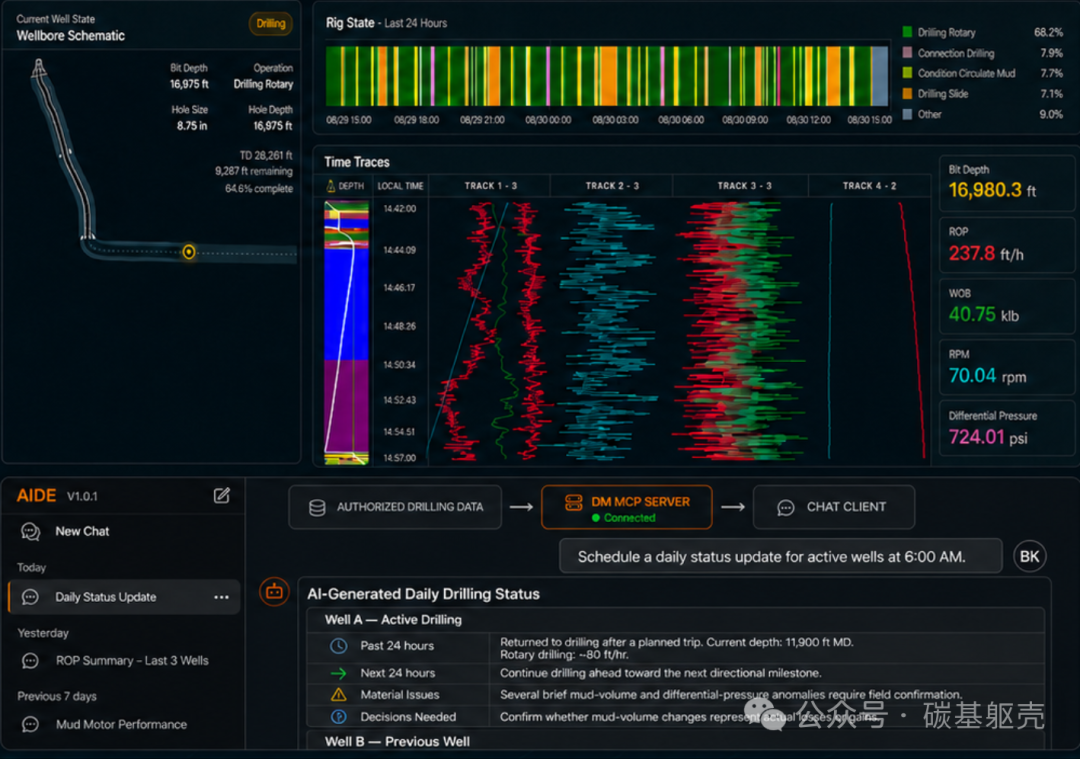
代码应当负责:获取测量值、强制校验单位和限值、执行可复现的计算。LLM 的价值出现在这些工作之后------当它需要路由工具、比较证据、解释不确定性,并综合出一个有前提条件的答案时。
不要把"计算"变成"语言任务"
常见的钻井问题,会路由到不同方法:
问题
主要方法
两个测斜点之间的狗腿度?
确定性轨迹计算
18,000 ft 处的建模提拉重量?
扭矩---阻力计算
套管鞋处的预期 ECD?
水力计算
哪些邻井在该深度附近遇到高拖曳?
检索与对比
当前扭矩为何超过这些邻井?
工程解释
我们应该先调查什么?
决策支持
自然语言是接口,但不一定是求解器。给定相同输入和实现,确定性函数应返回相同结果:
y=f(x1,x2,...,xn)
如果一个最小曲率函数收到:
测深 MD,
井斜角 inclination,
方位角 azimuth,
它会计算出一条明确定义的轨迹。
如果一个水力模型收到明确定义的:
几何参数,
流体模型,
流变学参数,
排量,
它会根据该模型返回计算出的压力响应。
计算可能包含假设。输入可能包含不确定性。模型可能有局限。但计算路径是显式的。这让它可以:
测试,
版本化管理,
复现,
审计。
LLM 有不同的优势。它的输出是根据上下文概率生成的。这对语言和推理很有用,但这不是我们通常希望安全相关工程方程具备的性质。
把 LLM 用作"编排器"
如果工程师问:
如果我们把排量从 600 gpm 提高到 675 gpm,18,500 ft 处的 ECD 是多少?
一种架构是把问题、井描述、泥浆数据都丢给 LLM,让它"算"。
更强的架构是让 LLM 先识别:
哪口井,
当前 BHA,
井段,
泥浆性质,
提议排量,
然后调用经过验证的水力计算。计算返回:
建模 ECD,
相关假设,
可能还有当前值与新方案值的对比。
LLM 再解释结果。它协调工程师意图和证据;水力引擎解决水力问题。
AIDE 会把请求拆开,调用确定性数据工具,并解释对比结果;计算本身留在语言模型之外。
一个有价值的工程 LLM,可以充当编排器。比如工程师问:
把我们当前水平段性能和三口最好邻井比一比,告诉我 ROP 偏低看起来是机械原因还是地质原因。
这个请求要求系统:
解析井、井筒、水平段和当前深度;
检索当前 ROP、WOB、RPM、扭矩、压差和钻机状态;
按地层、深度、井段和操作状态选择邻井;
运行所需的 MSE、DOC、水力或扭矩---阻力计算;
检索相关邻井性能、报告、BHA 细节和历史问题;
让 LLM 在组装好的证据上做推理。
重点是:LLM 没有生成证据,它只是组装并解释证据。
保留"认知类型"
一个好的信息层级,会让证据类型保持可见:
类型
含义
示例
Measured 实测
传感器或操作源报告
地面 RPM = 120 rpm
Deterministically calculated 确定性计算
由明确定义的工程函数产生
最小曲率 TVD = 12,740 ft
Modeled 建模
带假设的物理模型产生
建模 ECD = 12.3 ppg
Statistically inferred 统计推断
由不确定证据估计
刺漏证据在增强
Retrieved 检索
在已有记录中找到
邻井 DDR 记录泥浆 11.8 ppg
LLM interpretation 大模型解释
对前述证据的综括
有前提条件的工程解释
例如:
当前压力损失低于建模预期,而邻井水力情况相似。在把原因归到地层之前,这个模式值得先检查循环系统是否发生变化。
这些类别不应被呈现得好像它们具有同等的认知地位。
所需输入缺失时,要停下来
如果扭矩---阻力请求缺少泥浆密度,差系统可能会假设:
12.0 ppg,因为这个数值看起来合理。
答案看起来完整,但工程链已经断了。
更强的系统应该:
从授权源检索当前泥浆密度,
向工程师询问,
或明确说明:该计算无法可靠完成。
这正是工程 AI 与普通对话助手的不同之处。缺失输入往往不是"语言上的小麻烦",而是计算约束。
"确定性"不等于"精确"
有一个重要提醒:调用确定性工具,并不等于它的输出就是真理。
水力模型可能因为以下原因存在误差:
流变学不确定,
刺漏,
温度假设,
几何参数,
偏心。
该模型具有:
明确定义的目的,
验证,
已知局限。
LLM 在解释结果时,应当保留这些局限。
算例与护栏
假设问题是:
我们在水平段 18,600 ft,排量 625 gpm。井眼清洁一直勉强。能不能提到 675?
稳健工作流会把检索、计算、解释分开:
阶段
必需工作
解析状态
检索井、井筒、当前深度、钻机状态
检查限值
识别 BHA、马达、泵限和地面压力约束
加载泥浆上下文
解析 MW、流变、温度上下文(如适用)
运行水力
计算当前和提议的 SPP、ECD、环空流速及其他相关输出
检索历史
找井眼尺寸、水平段深度、泥浆、排量可比的邻井
对比当前响应
检查实测 vs 建模 SPP、返出和井眼清洁证据
综合
让 LLM 用已披露结果和限值解释权衡
例如:
提高到 675 gpm 会使建模 ECD 增加 0.3 ppg,建模 SPP 增加约 420 psi。这些值仍在当前给出的操作限值内。可比邻井在该井段用过 650--675 gpm。考虑到当前井眼清洁问题,更高排量在机械上是可行的;但改动后要核实实际 SPP 响应,因为最近实测压力一直高于模型。
数字是工具给的。解释是推理给的。这种分工才是重点。
一个排量变更问题,只有在当前数据、设备限值、泥浆上下文、水力和邻井证据都组装完成后,才经得起推敲。
提示词可以告诉 LLM:
永远不要编造泥浆密度。
这有帮助。但更强的系统还会:
要求工程工具必须有该字段,
校验单位,
检查数据新鲜度,
确认井身份,
限制工具权限。
提示词引导行为,软件约束强制执行行为。高价值工程系统应当两者都用。
AI agent 或许能检索:
实时井数据,
历史井,
报告,
工程计算。
这种能力需要边界。工具层应控制:
用户能访问哪些井,
哪些函数是只读的,
哪些数据源是授权的。
LLM 不应仅仅因为用户能把请求说出来,就决定访问权限。安全应位于推理层之下。