中文提问,能检到英文文档吗?------一次跨语言 RAG 检索五语种实测
一句话结论:能,而且比此前的担忧乐观得多------但乐观有边界,边界之外是一种静默失败。 本文是一次个人知识库(heart-net)上的实证记录:五语种、七组 query、双闸链路下的完整数据与归因。
0. 起因:一个从未实测的担忧
我的知识库是混装的:官方文档与英文教程(Spring AI、jenkov 这类)+ 大量中文个人笔记(JVM、并发专题)。日常用中文提问是主流,于是有个问题悬了很久------
中文提问「内存可见性怎么保证」,能检索到 jenkov 的英文教程吗?
更早之前(检索还是单阶段纯向量时),我给这个问题写下过一条风险预估:
中文 query 与英文 chunk 的向量距离天然偏远,而分数闸的阈值是用中文语料调出来的------正确的英文块可能被闸拦掉。
这条预估一直停在纸面。后来检索链路升级成了两阶段(向量粗排 + rerank 精排),这个问题反而更值得测了:两层对语言的敏感性不一样,升级可能已经悄悄改变了答案。于是有了这次实测。
1. 实验环境:现成的对照素材
先把记分牌讲清楚:两个分数是怎么来的
后文所有表格都绕不开两个数字,先弄明白它们怎么来的------整条检索链只有两次打分:
① distance(向量距离)------第一阶段的几何打分
入库时,每篇文档先切成小块(chunk),每块文本过一遍 embedding 模型(text-embedding-v3),变成一个 1024 维向量;查询时你的问题也变成一个向量。两个向量之间算余弦距离:
- 取值 0~2,越小越近。可以换算成更直观的余弦相似度 = 1 − distance:distance 0.178 ≈ 相似度 0.82,distance 0.261 ≈ 0.74;
- 它只懂几何、不懂语言------衡量的是两段文本在模型学到的语义空间里「方向」是否一致。
② relevanceScore(rerank 分)------第二阶段的语义打分
第一阶段按距离排出的前 30 个候选,还要再过一道 qwen3-rerank:它把「你的问题原文 + 候选块原文」拼在一起读一遍,直接输出一个 0~1 的相关性分------这段内容到底能不能回答这个问题。与 embedding 的「各自变向量再比对」不同,它看得见词与词的对应关系;纯读文本,不算几何。
名次是谁定的:rerank 分降序。 两道闸各管一段:粗排闸(distance ≤ 0.8)决定谁有资格进精排,分数闸(rerank 分 ≥ 0.5)决定谁能出现在最终结果里。第一阶段只发「入场券」,座次由第二阶段定------所以后文会反复出现「distance 近的不一定排前面」的反直觉现象,§3 还有一场它的翻盘现场。
一句话总结记分牌:表格里的「名次」= rerank 分从高到低的名次;「distance」= 第一阶段几何距离(越小越好);「rerank 分」= 第二阶段语义相关性(越大越好)。
两阶段检索链路全景(闸值为当前生产配置):
- 模型:embedding 用 text-embedding-v3(1024 维,官方口径支持 100+ 语种),精排用 qwen3-rerank,生成用 qwen 系;
- 语料:88 篇文档,中英文同主题天然并存------英文侧有《Java Memory Model》(jenkov.com 教程,24 块),中文侧有多篇 JVM/并发笔记,内容高度重叠(JMM、volatile、happens-before);
- 测试入口 :检索调试端点
GET /api/knowledge/search?q=...&topK=5,返回的每条结果都带上文记分牌里的两个字段:distance与relevanceScore。
零导入、零写库------库里的中英对照素材恰好够用,这是做实证最舒服的起点。
2. 第一轮:中英四形态
同一个知识域(Java 内存模型),四种问法:
| # | query 语言 | 问法 | 英文块表现(名次 / distance / rerank 分) |
|---|---|---|---|
| 1 | 中文 | 「Java 内存模型是什么」 | 第 2 名 / 0.261 / 0.860 |
| 2 | 英文 | 「What is the Java Memory Model」 | 第 1 名 / 0.178 / 0.864 |
| 3 | 中英混合 | 「JMM 的 happens-before 原则是什么」 | 未进前 5(第 1 名是中文笔记的 happens-before 专章,rerank 0.97) |
| 4 | 纯中文零锚点 | 「内存可见性是怎么保证的」 | 第 3 名 / 0.367 / 0.638 |
担忧被数据推翻:中文 query 下英文块稳定在前列(第 2、第 3 名),rerank 分 0.638~0.860,距离 0.5 分数闸的余量很大。当年「正确英文块被闸拦掉」的预估,在两阶段架构下不成立。
更细的数字在 #1 与 #2 的对照里------同一个英文块,中文问 vs 英文问:
| 维度 | 英文 query | 中文 query | 差异 |
|---|---|---|---|
| 向量距离 distance | 0.178(余弦相似度 ≈ 0.822) | 0.261(≈ 0.739) | +0.08,温和偏移 |
| rerank 分 | 0.864 | 0.860 | 几乎零衰减 |
这组对照直接回答了另一个问题:「同一句话,中文和英文的向量余弦相近吗?」------相近(0.82 vs 0.74),但不对齐到同语言水准。多语言 embedding 的对齐训练会把同义异语的向量拉到邻近区域,但表面形式不同的子空间并不重合。换句话说:跨语言检索天然要付一笔「距离税」,但这笔税没有想象中重。
发现一:术语锚点效应
为什么技术语料的「距离税」这么便宜?因为 Java、volatile、happens-before、JMM 这些词在中英文里同形------技术文档里这类术语密度极高,它们构成了跨语言的天然向量锚点,把两种语言的语义表示强行拉近。
这同时也划定了结论的边界:技术文档是跨语言检索的最好场景,不可外推到通用散文。问「今天天气怎么样」的中英文,距离税不会这么便宜。
发现二:两阶段架构的意外红利
对照表里最扎眼的是 rerank 分的零衰减(0.864 → 0.860)。机理不复杂:
- 向量层(粗排)看的是几何距离------语言鸿沟的损耗几乎全部落在这里(+0.08);
- rerank 层(精排)读的是文本语义------它判断「这段英文是否回答这个中文问题」,不吃向量距离的亏。
单阶段时代的风险预估「分数分布整体下移」其实只对了半句:下移确实发生在向量层,但被精排兜住了。这是架构升级送的一笔意料之外的跨语言保险。
3. 第二轮:往语种谱系的尽头追问
下一个自然的问题:「那用模型不支持的语言呢?是不是就完全偏离了?」
「支持」不是开关,是谱系:中英最深 → 日韩法德西俄主流层 → 小语种逐层衰减。于是我拿同一个问题(「内存可见性怎么保证」)的五种语言问法,测了一条梯度:
| query 语言 | 第 1 名(语言) | 英文块:distance / rerank 分 / 名次 | 返回条数 |
|---|---|---|---|
| 英文(同语言基线*) | 英文 | 0.178 / 0.864 / 第 1 | 5 |
| 中文 | 中文 | 0.367 / 0.638 / 第 3 | 5 |
| 日语 | 中文 | 0.380 / 0.670 / 第 2 | 5 |
| 法语 | 中文 | 0.372 / 0.621 / 第 2 | 4(第 5 候选被闸拦) |
| 韩语 | 英文 | 0.406 / 0.610 / 第 1 | 5 |
*英文基线取自「What is the Java Memory Model」问英文块的同语言参照。
五语种全部可用------检回的都是可见性主题的正确内容。但衰减梯度清晰可见:距离从 0.18(同语言)一路走到 0.41(韩语),rerank 分数带从 0.86 掉到 0.55~0.61。
发现三:衰减的结构性原因不止「训练深度」,还有「文字系统亲缘度」
梯度里有三个耐人寻味的细节:
- 日→中(0.325)比日→英(0.380)近------因为「可視性」「保証」是汉字词,与中文的「可见性」「保证」半同形。表意文字是天然锚点;
- 法→英居中(0.372)------visibilité/visibility、garantie/guarantee 是同源词,字母系统共享;
- 韩语垫底(0.406)------谚文是表音文字,与中英文零字面共享,全靠语义对齐硬撑。
所以跨语言距离 ≈ 对齐训练深度 × 文字系统亲缘度,两个变量叠加。这也解释了为什么「术语锚点」能帮中英:同形术语本质上就是文字系统亲缘度的局部最大化。
发现四:rerank 的跨语言翻盘
韩语那轮出现了一次教科书级的翻盘:向量层中文块更近(0.369 < 0.406),但 rerank 把内容更对症的英文块抬到了第 1(rerank 分 0.610 vs 0.567)。
第二道闸的语义判断再次优于几何距离------与发现二互相印证:只要候选能活着进精排(粗排闸 0.8 挡不住它们),语言鸿沟造成的排序损失就有机会被拉回来。
法语那轮只返回 4 条:一次「静默拦截」的现场
法语 query 下第 5 个候选的 rerank 分跌破了 0.5 分数闸,被直接丢弃------调用方完全无感。这张截图就是当时的现场: 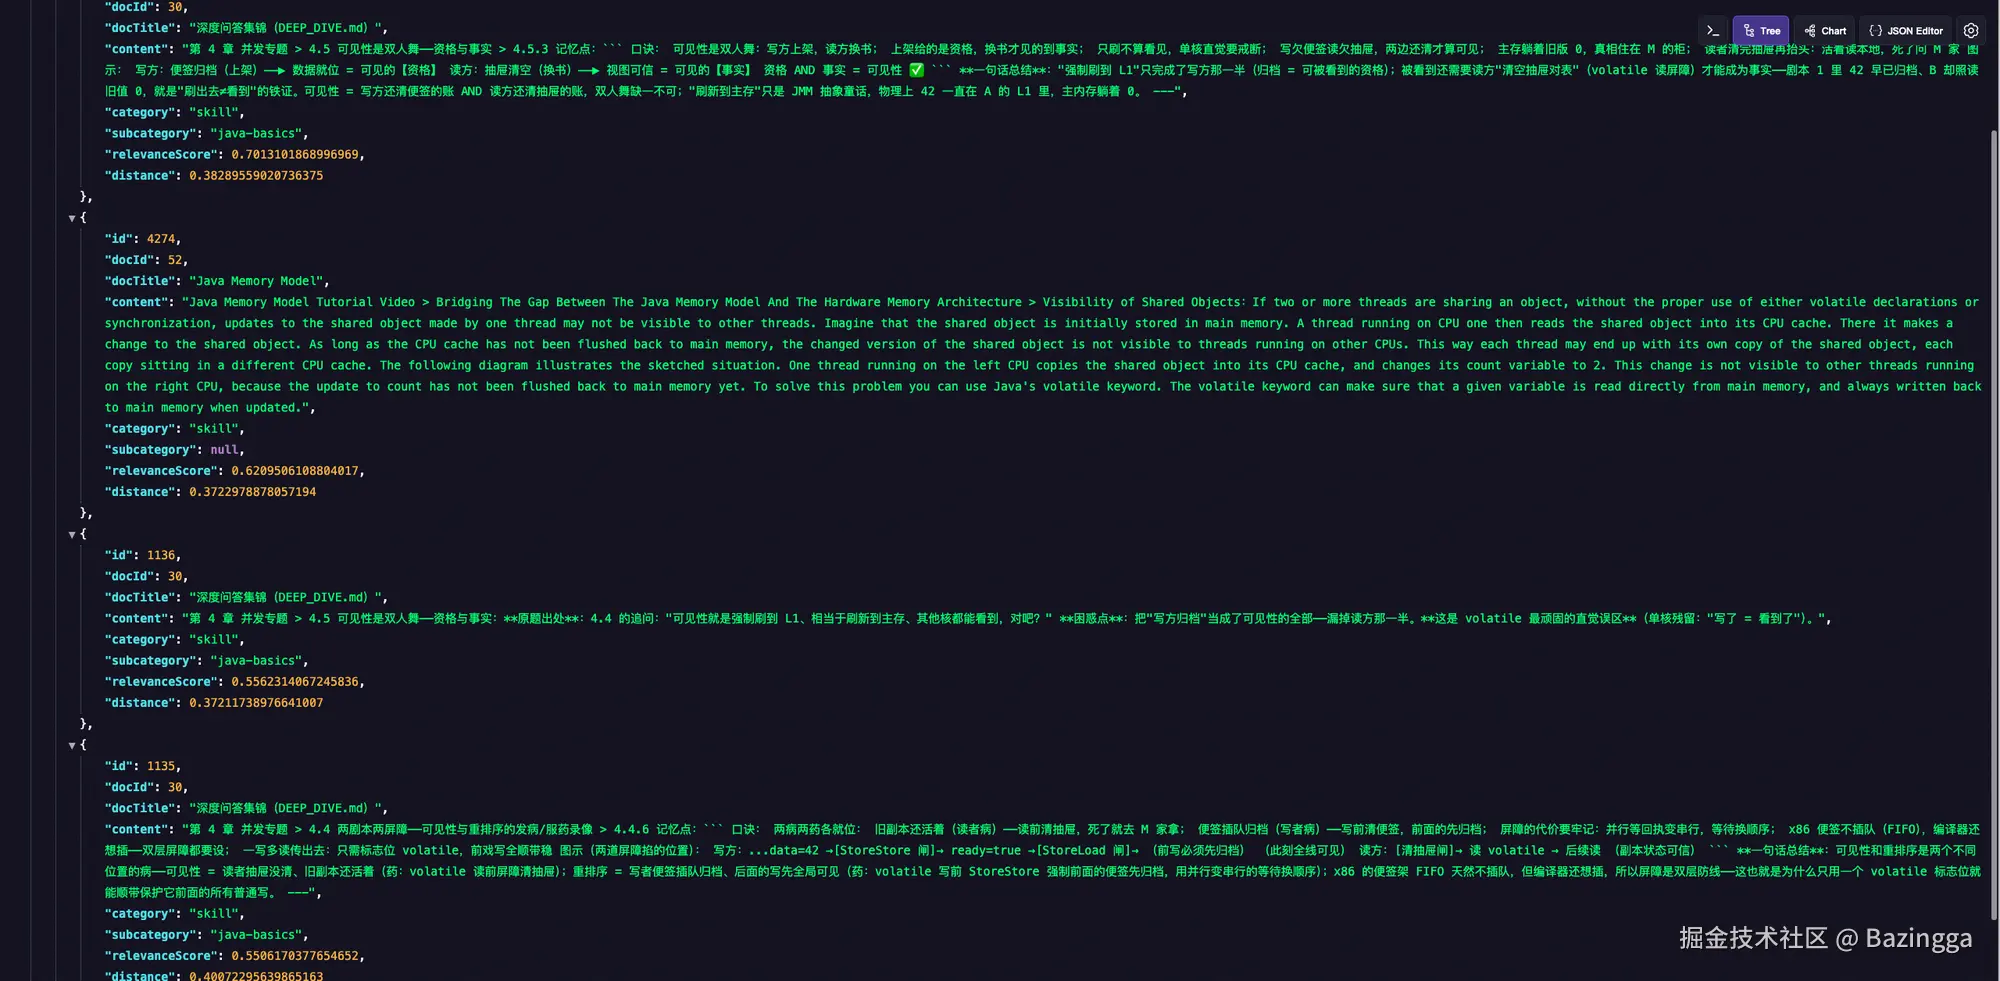
现场证据:法语 query(visibilité de la mémoire)返回 4 条------第 5 候选 rerank 分跌破 0.5 被分数闸静默拦截;英文块 distance=0.3722978878057194,与首次实测 16 位小数逐位一致。
它预演了下一个问题------真正不支持的语言会发生什么。
4. 失败形态:不是「偏离」,是「塌缩」
「用不支持的语言会完全偏离吗?」------方向对,形态要修正。两种失败模式有本质区别:
| 失败模式 | 向量行为 | 检索表现 |
|---|---|---|
| 语义偏离(支持语言里问跑题的话) | 落在语义空间的错误邻域 | 检回别的东西------有结果,但答非所问 |
| 语义塌缩(不支持的语言) | tokenizer 见不到的脚本碎成字面碎片,语义权重趋零 | 字面巧合的假命中,或干脆空结果 |
落到语种谱系上:
- 主流圈(中英日韩法德西俄):逐档衰减,全部可用,韩语已贴闸门(余量约 0.1);
- 边缘圈 (训练里见过一点的小语种):距离逼近 0.8 粗排闸、或分数带整体跌破 0.5 → 静默空结果;
- 不支持 :向量塌缩成字面信号 → 粗排拦空;偶尔字面巧合假命中。
其中最阴的坑是静默空结果的归因歧义:用户看到「知识库没覆盖」,真实原因却是「语言不通」。这两种归因需要的补救动作完全不同------前者该补语料,后者该换链路(比如先让 LLM 把小语种材料翻成中文摘要再入库)。分数闸本身不会告诉你它是为哪种原因空的。
而假命中比空结果更误导:它有分数、有内容、看起来像那么回事,只是语义已经不可信。
5. 复现性插曲:十六位小数
实测收尾时做了一次复现验证:隔了一轮对话后重开同一 URL(等于重新走一遍 embedding + rerank),结果------
distance十六位小数逐位复现 (0.3722978878057194)------embedding 对同一文本返回同一向量,这组数字是可复算的,不是一次性的运气;relevanceScore存在小数位级波动(第 9 位小数一个字符的出入)------rerank 是实时模型调用,输出本就带非确定性,但名次与量级稳定。
「数字能复现,结论才叫实证」------这一步让前面所有表格从「一次实验的观察」升级成「可复算的证据」。
6. 实操结论
沉淀成几条可以指导后续入库决策的规则:
- 语种安全区 = 模型能力圈。qwen 系 + text-embedding-v3 覆盖的主流语种(中英日韩法德西俄)随便进;技术文档场景连「英文原文 + 中文提问」这种最常见混装都不需要任何补救;
- 小语种入库前先试一发。拿该语种的典型问题打检索调试端点,看分数带落在哪------离 0.5 闸余量充足就裸入,贴闸就走「LLM 中文摘要入库」的预处理路线;
- 不要为跨语言做过度工程。曾经预案过的三条对策(跑英文 gold 命中率 / 给英文块附中文摘要 / 提示用户 query 带英文关键词),实测后分别降级为:已执行且通过 / 技术文档场景无必要 / 锦上添花;
- 警惕空结果的归因歧义。检索为空时先想想是「没覆盖」还是「语言不通」,再决定补语料还是换链路;
- 结论的边界:术语锚点效应是技术语料的红利,通用散文类语料的跨语言损耗大概率更接近韩语那档甚至更差------换语料域前重测,别外推。
7. 附录:账本
调用账本:7 组 query = 7 次 embedding + 7 次 rerank 精排,合计约 7.7 万 tokens------个人 key 之下可忽略的成本,换来一组可复算的数据。