知识注入的两条路:RAG知识库与Skills蒸馏
实证案例:heart-net 个人知识库(pgvector + rerank 两阶段检索 / 100 题评测集 / run #1~#5 真实跑分) 与同仓库的《RAG 评测体系生产实践指南》构成姊妹篇------那边讲"怎么测",这篇讲"两种知识形态为什么测法天生不同"。
本文所有数字均为真实跑分数据;所有对比均来自同一项目里两种形态并存的实际使用,不是思想实验。
0. 这篇博客讲什么、给谁看
一句话定位:AI 应用里有两种把知识塞给模型的方式------知识库(RAG)和 Skills。大多数人两种都在用,但很少想清楚它们的本质区别,结果是把"必须每次都在"的知识赌在概率检索上,或者把"海量长尾"的语料硬蒸馏成卡、把最贵的注意力烧在低价值内容上。
先用人话说清楚各自干什么(后文所有抽象都从这两个场景里长出来):
- 知识库(RAG)用来回答"我读过的东西怎么说" 。你把文档原文一篇篇存进向量库;每次提问,系统现场按语义相似度从库里捞回最相关的几小片原文,喂给模型作答。它是你的第二大脑书架------"我的知识库里 JUC 是怎么讲的""那份手册里这个参数配多少",都是它在干活。
- Skills 用来告诉模型"动手前必须知道什么" 。每张卡是一份事先写好的规程------项目架构导览、开发红线、工作流程------任务对得上就整卡加载进上下文。它是 AI 的上岗手册------不负责"知识是什么",只约束"这件事该怎么做、什么绝不能碰"。
给谁看:
| 读者 | 读法 |
|---|---|
| 同时维护知识库和 skill 卡的人 | 通读,重点 §2 四层区别 + §4 漏斗结构 |
| 搭 RAG 的工程师 | 重点 §3------失败模式为什么必须靠仪器量化,仪器本身怎么工作 |
| 写 skill 卡 / 维护 agent 规则的人 | 重点 §2.4 + §3.6------skill 的"失败可见"是资产,"没仪器"是代价 |
| 纠结"这段经验到底放哪"的人 | 直接看 §4 的判断标准 + §5 的价值排序 |
贯穿全文的实证对象:heart-net 是一个个人知识库项目------RAG 侧是 41 篇文档、约 4000 chunks 的向量库加两阶段检索;Skills 侧是十几张 SKILL.md 卡(项目架构卡、开发红线卡、各专题素材卡)。同一个仓库里两种形态并存且互相喂数据,这让"对比"有了实打的现场,而不是纸上谈兵。
写作约定:每个抽象概念配一个"通俗例子"框;每个论断尽量配实测数据;关键结构配图。
1. 同一道题的两种解法
1.1 问题从哪来:权重冻结,知识却活着
先立住问题的根。大模型的权重是冻结 的------训练完那一刻,它知道什么就固定了。而你自己的知识是活的、私有的:今天踩了个坑、明天读了一篇文档、后天公司改了一条规矩。模型永远不可能通过"再训练"来实时跟上你------且不说成本,你的私有知识本来就不该进任何权重。
所以必须有一套机制,把"对的知识"在"这一刻"塞进模型有限的上下文窗口。这类问题统称上下文工程(Context Engineering):窗口就这么大(几万到几十万 token),知识无限,选什么进来、怎么放进来,决定了这个 AI 是"懂你的"还是"泛泛的"。
通俗例子:开卷考试。书带不进考场(权重冻结),但可以带小抄(上下文)。小抄只有一张 A4 纸(窗口有限)------抄什么、怎么排版、按什么顺序找,就是全部学问。
RAG 和 Skills 是这张小抄的两种做法。它们不是互相竞争的技术路线,而是同一道题的两个解------分歧只出现在两个决策点上。
1.2 先拆词:Skills 是容器,蒸馏是装法
"Skills 蒸馏"是个合成词,很容易被读成"Skills 本身就是一门蒸馏技术"。不是------它压着两个层次的东西,拆开才立得住。
Skills 的本体是一种加载机制 。物理形态上一个 skill 就是"一个文件夹 + SKILL.md":文件头写名字和描述,正文写内容。运行时规则只有一条------模型读描述判断当前任务用不用得上,用得上就把整张卡加载进上下文。它是一个按需加载的上下文模块,本身不生产任何知识。
蒸馏是一种内容加工工艺 :把几万字原文消化成几百字结论------读原文、提炼、核对、定稿。它跟 skill 机制没有绑定关系:SKILL.md 只规定格式,没规定内容必须是蒸馏产物------把整篇原文贴进一张卡,机制照样触发、照样加载,合法,只是蠢。
两个维度交叉,看得最清楚:
| 内容 \ 载体 | RAG 库(相似度检索) | skill 卡(触发整卡加载) |
|---|---|---|
| 原文 chunk | 经典 RAG------本文左列 | 可行但蠢:整卡原文轰进窗口,有用的就两句 |
| 蒸馏产物 | 中间层飞轮------LLM 详解文档回流知识库(§4.2 展开) | 经典 skill------本文右列的最佳实践 |
所以本文对比表的两列,严格说是两个"机制 × 内容"的组合:左列 = RAG 机制 + 原文内容,右列 = skill 机制 + 蒸馏内容。"Skills 蒸馏"指的就是右边这对搭档------后文沿用这个简称,但概念上记住它是两个东西。
为什么这对搭档绑得这么紧?机制塑造内容的最优解。skill 的机制约束是"整卡加载"------卡内每个 token 都是直接成本,没有"卡内再检索"这回事,卡必须字字有用,高信噪比是硬要求;而把内容压到字字有用的主流工艺就是蒸馏。再加上 skill 的典型使命是装红线、纪律、流程------这类知识天然就是结论形态("数据库写操作必须先确认"本来就是一句话,没人把六百字事故报告原文塞进卡)。反过来,RAG 按需取片、给出处------原文的冗余在它那里不是成本(反正只取几片),出处属性反而是资产,原文于是成了它的合理内容。
顺带校准一个常见说法:把 skills 叫"工具包"只对了一部分------它装的不全是能力。heart-net 的卡里有学习路线(能力)、项目架构(导览)、开发红线(纪律)、博客素材(事实存档),共同点只有机制。一句话定义:skill 是按需加载的上下文模块;"工具包"只覆盖装能力的那部分,"蒸馏"则根本不是 skill 的一部分,只是跟它最搭的装法。
1.3 分歧的两个决策点
决策点一:什么时候压缩?
知识从原始形态(几千字的文档)到进窗口(几百 token 的有效内容),必然经历一次压缩。分歧在于压缩发生在什么时刻:
- RAG:用时压。原文整篇躺在库里不动,检索那一刻才决定取哪几片------压缩发生在"回答这个问题的瞬间",压缩结果由相似度现场裁决。
- Skills:入库时压。写卡的那一刻就完成了蒸馏------原文被消化成结论和纪律,卡片定稿后每次加载的都是同一份压缩结果。
决策点二:怎么找到该给的那份知识?
- RAG:相似度检索 。把问题变成向量,在库里找"语义最近的几片"------这是概率匹配,这次问法和上次差一个词,捞回来的东西就可能不一样。
- Skills:触发词整卡加载 。靠卡片描述、关键词触发,一旦命中就整卡进来------不取半句,不挑段落。
1.4 一句话定调
两个决策点组合起来,可以把两种形态的性格压缩成一句话:
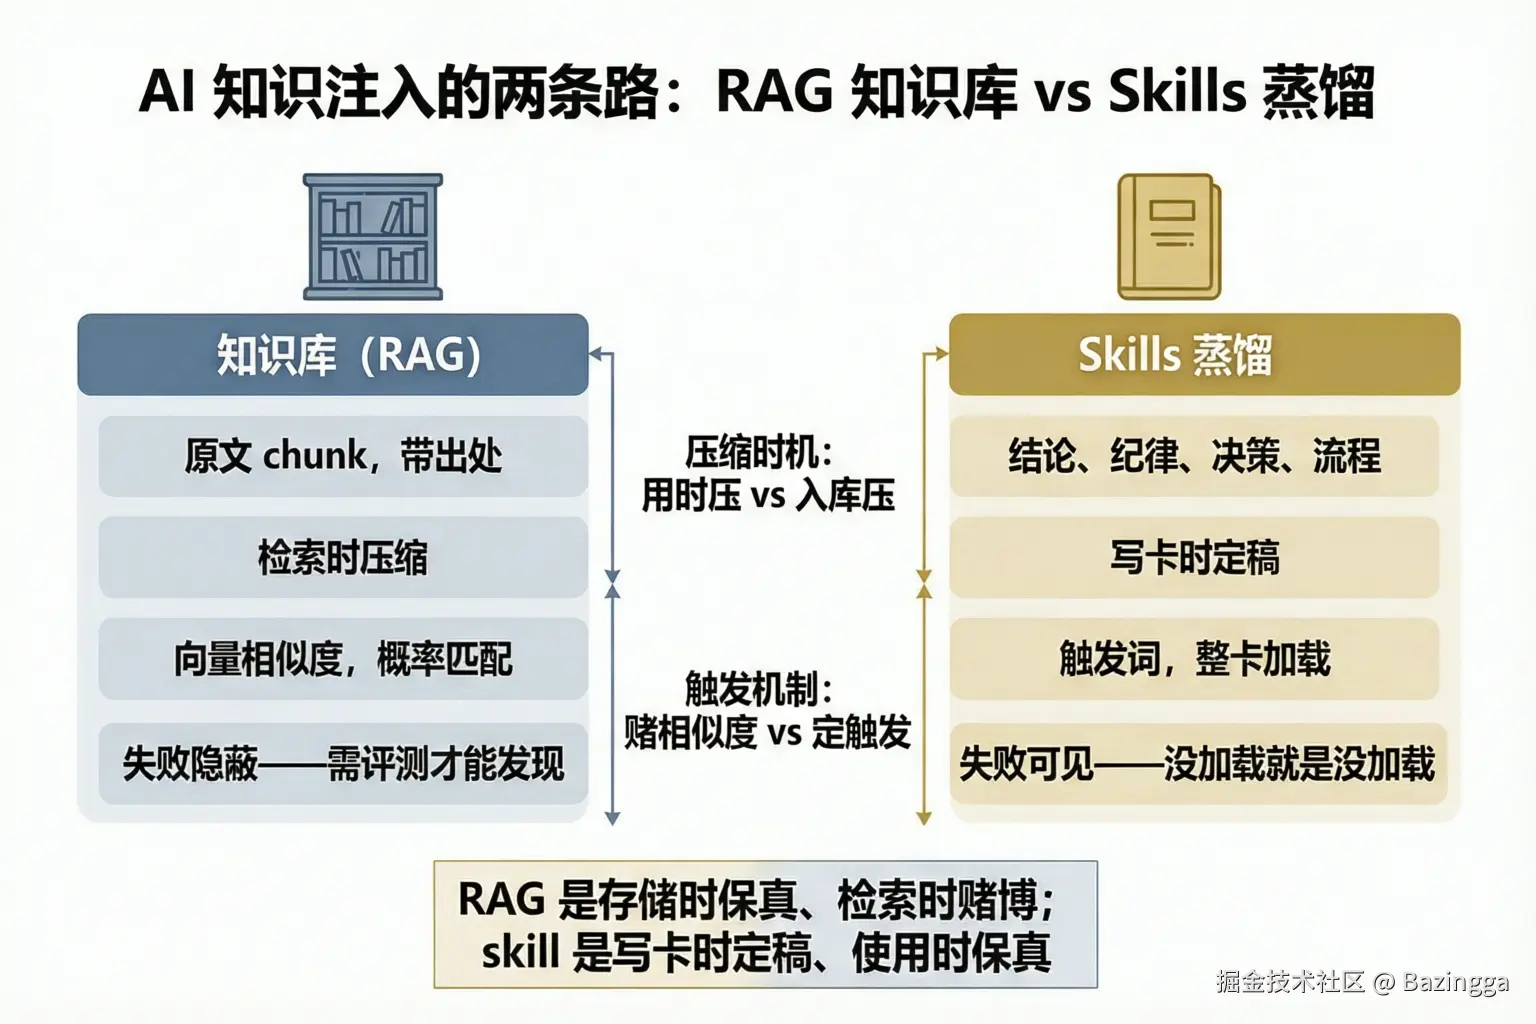
RAG 是存储时保真、检索时赌博;skill 是写卡时定稿、使用时保真。
这句话值得逐词拆开------尤其当心:前后两个"保真"不是同一个意思。
- RAG「存储时保真」 :入库那一刻什么都没发生------原文原样进库,没人改写、没人提炼,引用有据、细节无损。保的是内容真实:存的东西是真的。
- RAG「检索时赌博」:所有决定被推迟到"回答这个问题的瞬间"------取哪几片、gold 排第几,全部由相似度现场裁决。同一个问题今天捞回 A、B、C,明天措辞变一点就捞成 B、D、E。赌的是"这一枪打得中",赔率实测过:Hit@1 = 55%;更糟的是赌输了不一定知道------模型拿着不完整的材料照样一本正经作答。
- skill「写卡时定稿」:压缩被提前到入库那一刻,一次性做完、永久固定。写得好,以后每次用都好;写得偏,以后每次用都偏(直到有人修卡)。所有判断在写卡那一瞬间锁死。
- skill「使用时保真」 :这个"保真"保的不是内容真实,是传输一致------卡触发后整卡进来、一字不差,今天加载和明年加载是同一份,零损耗、零现场裁决。使用时没有赌局。
通俗例子 :图书馆每来一位读者都现场翻一次目录------同一个问题今天和明天复印给你的那几页可能不一样,每局都赌 ;工作手册付印那天就定版,谁翻开都是同一页------一次押注,赌注全压在写手册那一次:写得偏了,往后每件事都按偏的方式错,好在错得一致、看得见、能修。
所以这句定调真正说的是风险的位置 :RAG 把不确定性摊到每一次使用,skill 把不确定性集中在一次写卡。风险的位置决定质量守护的手段------RAG 必须配仪器 (评测体系,否则等于每局都赌还从不看战绩),skill 只需能修卡(事故回溯)。§3 那组"仪器 vs 肉眼"的对称,根子就在这里。这是下一节的主题。
2. 四层本质区别
2.1 全景对比表
先上全表。这张表是本文的骨架,后面每一小节展开一层:
| 维度 | 知识库(RAG) | Skills 蒸馏 |
|---|---|---|
| 知识形态 | 原文 chunk,带出处 | 结论、纪律、决策、流程 |
| 压缩时机 | 检索时(相似度决定) | 写卡时(人/AI 协作定稿) |
| 触发方式 | 向量相似度,概率匹配 | 描述/触发词,整卡加载 |
| 失败模式 | 隐蔽(漏召回/误召回不专门评测就不知道) | 可见(没触发就是没加载) |
| 信噪比 | chunk 几百 token 可能只有一两个结论 | 卡内字字是必须执行的约束 |
| 运行成本 | 每问一次跑一遍召回+rerank | 一次注入 N 次生效,边际成本零 |
| 更新成本 | 加料便宜,质量靠入库闸 | 蒸馏贵(消耗注意力),但条条高信噪比 |
| 量级 | 大而全、覆盖长尾 | 少而精 |
| 服务的对象 | 分身智能体------回答"我读过的东西怎么说" | 开发搭档 AI------决定"动手前必须知道什么" |
| 对应人的什么 | 见闻、经历 | 原则、方法论 |
2.2 知识形态:原文与结论
RAG 库里存的是原文切片(chunk)------带标题路径前缀、带出处、可能有代码和上下文的原始段落。它不替你判断轻重,原文怎么说它就怎么存。好处是保真:引用有据、细节无损、不掺二次理解。代价是冗余:一个几百 token 的 chunk 里,真正是"结论"的可能就一两句,剩下的都是铺垫。
Skill 卡里存的是蒸馏产物------结论("rerank 分数是请求内相对值,不是绝对置信度")、纪律("数据库写操作必须先经用户确认")、决策("个人项目引 Python 技术栈不值,评测内嵌 Java")、流程("先查字典→带分类检索→标注来源")。没有原文,全是"怎么做、别踩什么坑"。
通俗例子:RAG 是图书馆------原文在架上,用时翻几页;skill 是老员工的工作手册------没有原文,全是门道。
2.3 压缩与触发:两种"运气"的分布
把压缩时机和触发方式合起来看,会发现两者的不确定性分布完全不同:
- RAG 的不确定在每次使用:同一类问题,这次捞中了、下次措辞变了就没捞中;捞中的三片里 gold 排第一还是第三,也是现场才定的。
- Skill 的不确定只在触发那一刻:触发词设计得好不好决定卡会不会被加载,但一旦触发,内容是定稿的、完整的、每次一致的。
运行成本跟着这个分布走:RAG 每问一次就要跑一遍"召回 + 精排",模型调用一次不少;skill 注入一次,之后的 N 轮对话都在生效,边际成本归零。
2.4 失败模式:隐蔽与可见
这是最容易被忽视、却最致命的一层区别。两种形态都会失败,但失败被发现的难度天差地别:
RAG 的失败是隐蔽的 。漏召回(库里明明有 gold,这一枪没打中)、误召回(捞回来一堆擦边但不该命中的),都发生在一瞬间,表面上什么都看不出来------模型会拿着不完整的材料"一本正经地回答",你只觉得答案质量一般,不知道病根在检索。不专门建评测体系,这些失败永远不可见。
Skill 的失败是可见的。卡没触发就是没加载,行为上立刻能看出来------该守的红线没守住、该走的流程没走。失败模式和行为后果直接绑定,肉眼可查。
一句话:**RAG 是"有仪器才知道失败",skill 是"失败了自然露馅"。**这个不对称引出了一个更深的对称------两种形态的可评测性恰好互补。这是下一节的主题,也是这两种形态对比里最值得展开的一层。
3. 失败模式的量化:55% 是怎么测出来的
上一节说 RAG 的失败隐蔽、需要仪器。这一节就讲这台仪器------它怎么工作、为什么便宜、以及一个反直觉的事实:给它打分的不是任何模型,是几十行 Java 代码。
3.1 先看仪器测出了什么
heart-net 的评测集里有 11 道跨文档题(比如"对比 MVCC 与 redo log 在并发控制上的分工"------答案横跨两篇文档)。对这批题反复跑分,实测结果:
- Hit@1 = 55% :11 道题里只有 6 道,正确文档(gold)排在检索结果第 1 位------近一半的问题,第一枪打不中 gold。
- Hit@3 = 100%:但 11 道题的 gold 全部进了前 3------材料是捞到了的,输在排序。
- MRR = 0.73:平均排位倒数------第 2 名贡献 0.5,第 3 名贡献 0.33。
更有说服力的是后面三轮调参:依次扩召回宽度(30→40)、收粗排闸(0.8→0.5)、放分数闸(0.3→0.2),Hit@1 纹丝不动地停在 55%。参数确实生效了(快照如实记录,候选池确有微变),但变化没强到翻转任何一题的排位。这不是仪器失灵------这是"当前结论对这几个参数稳健"的证据,三次实验免费验证了稳健区间。
还有失败模式的另一面:给评测集加进负例(库里没有答案的问题)后,8 道负例有 3 道被误召回,且三条全命中同一篇 1085 chunks 的《面试题大全》大杂烩------任何"......的基本原理是什么"式的问法都能在那篇里蹭出浅相似。误召回和漏召回一样,不专门测就永远看不见。
3.2 反直觉的事实:L1 评分没有裁判模型
讲仪器的原理前,先纠正一个常见误解。很多人(包括一周前的我)会假设:既然是"AI 的考试",那总得有个 AI 裁判来打分吧?
没有。L1 检索评测的裁判是纯 Java 代码,全程没有一个模型参与评分。
这里要把两个角色分清楚,因为 L1 的链路里确实有模型,但它们的身份是考生,不是裁判:
| 角色 | 谁 | 判定依据 |
|---|---|---|
| 考生 | embedding 模型 + rerank 模型(就是生产检索链路本身) | 它们的输出在被比对------top3 列表 |
| 裁判 | Java 代码(集合比对 + 排位计数 + 除法) | 它在做比对------gold 在不在 top3、排第几 |
容易混淆的点:rerank 确实在"打分"(relevanceScore),但那是考生草稿纸上的数字------它是被测系统的内部排序机制,不是评测的分数。评测的分,是拿考生的最终答案(top3 列表)对标准答案(gold 文档集合)机械比出来的。
3.3 机器阅卷的四个步骤
整个评分流程四步,每一步都简单到可以手算复验:
第一步:人标标准答案。出题的时候人工标注 goldTitles------"这道题的答案物理上在哪篇文档"。这是唯一的"主观"环节,且主观性被压缩到"指认出处"这个最小动作上(不用写参考答案,只需指出答案在哪)。
第二步:考生作答 。用真实的生产检索链路跑这道题------embedding 向量化、向量粗排、rerank 精排、topK 截断,一步不 mock。评的就是当前线上这套配置,不是理想化的替身。
第三步:代码阅卷 。遍历考生交回的 top3:第 1 名的 docId 在 gold 集合里吗?在,hitRank = 1。不在,看第 2 名、第 3 名。负例更简单:召回列表是空的 → 拒答成功(hits.isEmpty() → rejected,一行代码)。
第四步:除法聚合。
ini
Hit@1 = hit1 ÷ 正例总数          (排第 1 的题占比)
Hit@3 = hit3 ÷ 正例总数          (进前 3 的题占比)
MRR   = Σ(1 ÷ hitRank) ÷ 正例总数(排位倒数的平均)
验证一下手感能不能复算:11 题中 6 题排第 1、2 题排第 2、3 题排第 3 →
ini
MRR = (6×1.0 + 2×0.5 + 3×0.33) ÷ 11 ≈ 0.727和报告里的 0.73 对上了。报告数字可以拿笔算出来,因为评分过程没有任何模型主观判断------这就是"机器阅卷"四个字的完整含义。
通俗例子 :L1 是选择题 ------答案唯一、答题卡机器阅卷,快、准、零争议;L2(生成质量评测)是作文题------质量是连续光谱,没有标准答案可比,才需要请一位"老师"(裁判模型)通读全文打 1~5 分。选择题能用答题卡判的,绝不请老师人工批------这不是省钱技巧,是方法论。
3.4 机器阅卷的三笔红利
"能用代码判的绝不请模型"带来三笔实打实的红利,每一笔都在 heart-net 的实践里兑现过:
红利一:确定性 。评分环节没有模型 = 没有采样噪声。实测证据:两轮等效条件下的跑分,rerank 分数小数点后 16 位逐位一致。这直接决定了两种评测的阈值策略可以不同------L1 的阈值可以贴着基线钉死(逐位复现,差一位都是回归);L2 的阈值必须留容差(生成和裁判都带采样抖动,贴太紧一半红灯是噪声不是回归)。
红利二:便宜 。L1 每题 2 次模型调用(embedding + rerank,约 3 秒);L2 每题再加 2 次(生成 + 裁判,15~23 秒)。L1-only 扫参便宜两个数量级------大规模网格扫参数时先跑 L1 筛出头部参数组,少数决赛组再上 L2 验证,这个分层控制成本的生产惯例,物理依据就是"评分零模型调用"。
红利三:可解释。每个分数都能翻明细落到具体某题排第几、distance 多少、rerank 分多少------55% 的损失具体丢在 5 道题的排序上,一览无余。L2 才需要裁判额外产出"幻觉句清单"来把主观扣分落到句子上;L1 的扣分天生就长在题上。
3.5 对称的另一半:skill 没有这台仪器
现在把镜头转回 skill,就能看到一组漂亮的对称:
| RAG | Skills | |
|---|---|---|
| 失败的可见性 | 隐蔽------不测就不知道 | 可见------没触发就是没加载 |
| 可评测性 | 极好------gold 命中是选择题,机器阅卷、零噪声、便宜 | 差------行为质量没有 gold 排位可比 |
| 质量守护方式 | 靠仪器:离线评测体系、指标门禁 | 靠肉眼:使用中盯行为、事故回溯修卡 |
为什么 skill 建不成这种仪器?因为评分的第一步"人标标准答案"在 skill 的世界里没有对应物------你可以给一道检索题标注"答案在这篇文档",但没法给一次开发协作标注"此刻模型必须想起卡上第 3 条纪律"并把它变成集合比对。skill 的"考卷"是行为层面的:红线守没守住、流程走没走对,只能在真实使用中观察,靠事故回溯来修卡。
heart-net 的开发红线卡就是这么来的------"数据库写操作必须先经用户确认"这条纪律,背后是一次 schema.sql 整文件重放把 doc 表清空的事故。RAG 的卡片靠出题标金,skill 的卡片靠事故回溯------两种知识形态的质量守护方法论,也随形态本身分化了。
而这组对称恰恰是补偿设计:
- RAG 失败隐蔽,所以必须建仪器------不建等于裸奔;
- skill 失败可见,所以敢整卡加载------错了会露馅,露馅就能修。
3.6 推论:必须每次都在的知识,不能赌检索
把 §2.4 和本节合起来,可以立一条工程上的铁律:
"必须每次都在"的知识不能交给概率检索。
红线、纪律、关键流程,属于"错一次就出事故"的知识------55% 的 Hit@1 意味着赌检索有近一半概率第一枪落空,这个赌注对红线类知识完全不可接受。这类知识的正确归宿是 skill(触发词整卡加载,零漏项),再配一层自动召回的 memory 做双保险------heart-net 的架构里,开发红线卡(skill 形态)+ 关键约束自动注入(memory 形态)双轨并行,依据就是这条推论。
反过来,"错了能重问一句"的查询类知识、海量长尾的原始语料,才适合放 RAG------失败成本低,换取的是覆盖广度和存储便宜。
4. 漏斗结构:正确答案不是二选一
4.1 为什么全蒸馏不行,全 RAG 也不行
前面对比了这么多"差异",容易读成"选边站"。但实践中的正确答案是两者分层共存------因为各自的"不行"恰好卡死在对方的"行"上:
全蒸馏为什么不行:蒸馏消耗的是人的注意力------读原文、提炼、核对、定稿,一条卡的诞生要以小时计。几百篇文档不可能都成卡;而且长尾语料(可能一年就查一次的技术细节)根本不值得这个成本。蒸馏的单位成本,决定了它只配给"反复被用到"的知识。
全 RAG 为什么不行:上一节的推论已经回答------必须每次都在的知识(红线/纪律/核心流程)赌不起 55% 的命中率。
4.2 知识金字塔:三层各就各位
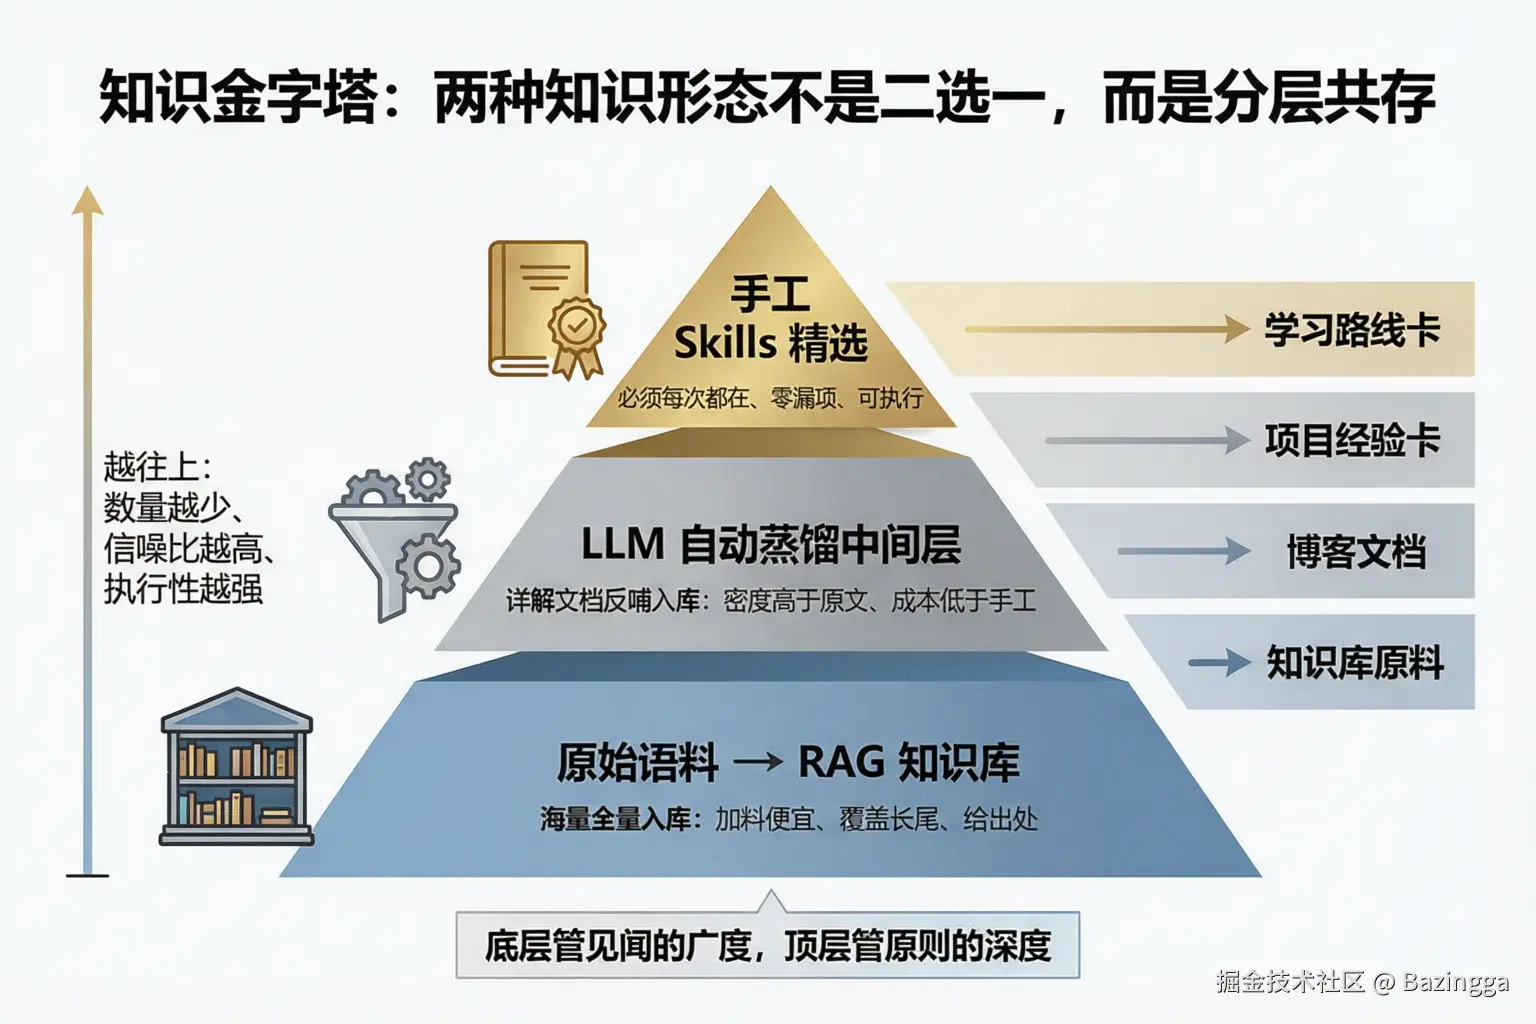
正确的结构是一座金字塔,越往上数量越少、信噪比越高、执行性越强:
| 层 | 住什么 | 形态 | 成本特性 |
|---|---|---|---|
| 底层(最宽) | 海量原始语料,全量入库 | RAG | 加料便宜、容量无限、给出处、覆盖长尾 |
| 中间层 | 机器生成的详解文档、摘要 | LLM 自动蒸馏 | 密度高于原文、成本远低于手工 |
| 顶层(最窄) | 反复被用到的结论与纪律 | 手工 Skills | 蒸馏贵,但条条是必须执行的约束 |
中间层值得单独说一句:它是用 LLM 自动做漏斗中间层的蒸馏------把一篇 80 万字符的原始文档自动生成一份几万字符的详解文档再反哺入库。这层的价值在于它站在两种形态的甜点交叉处:比原文密度高(信噪比向 skill 靠),比手工蒸馏便宜两个数量级(成本向 RAG 靠)。heart-net 的"详解文档反哺入库"飞轮(详解管道生成的文档自动打分、高分回流知识库)就是这层的落地------LLM 生成的详解文档经过裁判打分闸门,回流后又成为下一轮检索的弹药。
4.3 四条蒸馏产线的实例
heart-net 仓库里,这座金字塔的实际运转长这样------四条产线各有产出,且知识库(RAG)是所有产线的原料来源:
markdown
                    ┌─→ learn-* 五张学习路线卡     (方法论蒸馏,个人目录)
原始语料(知识库)──┼─→ heart-net 五张项目经验卡   (工程纪律,项目内)
                    ├─→ docs/ 博客与指南           (面向人的系统化整理)
└─→ 知识库自身 (原始语料,全量保真)一个耐人寻味的细节:这几条产线的产出互相喂数------项目经验卡(skill)记录"评测体系怎么建",博客(docs)把卡展开成面向陌生读者的完整叙事,而写博客的过程又会逼出新的认知、回头修订卡。蒸馏不是单向漏斗,是循环。
5. 蒸馏自己的价值:单位 token 信息增量最高
前四节讲的都是"怎么选"。这一节讲"什么最值得蒸馏"------因为金字塔顶层的位置稀缺,放什么进去是个价值判断。
判断标准:这段知识在模型权重里存在吗?
外部公开文档(官方文档、经典书籍、技术博客):预训练大概率见过。RAG 它们的收益只是"精确化、私有化"------让模型引用你指定的那本书、你锁定的那个版本,而不是它记忆里可能过时、可能张冠李戴的模糊印象。这个收益是真实的(尤其对抗幻觉和版本漂移),但不是"新知识"。
个人决策史、教训、约束 :这些是权重里绝对不存在的知识------"数据库写操作必须先确认"是炸过一次库换来的;"评测内嵌 Java 不引 Python"是个人项目约束拍板的;"gold 标注要独立于检索预览"是差点考卷污染的教训。模型读一万遍互联网也学不到你的事故史。
所以蒸馏的价值排序很清晰:
蒸馏自己,注入的是模型永远学不到的信息------单位 token 信息增量最高的知识。
一条红线卡防住一次炸库事故------这种价值的知识,交给概率检索"hopefully 命中"是不行的;而它恰好又是"必须每次都在"的知识,于是又回到 §3.6 的铁律:进 skill,配 memory 双保险。
这也解释了为什么"个人知识引擎"类产品里,最有护城河的资产从来不是接入了多少公开文档------那人人都能接------而是用户自己的蒸馏产线:踩过的坑、拍过的板、付过学费的结论。公开知识拼接入,私有知识拼蒸馏。
6. 收尾:记忆与人格
最后把三种机制放进一张完整的图景。除了 RAG 和 skill,实践里还有第三种存在------memory(自动召回的长期记忆)。它是杂交体:内容形态像 skill(蒸馏过的要点,不是原文),召回机制像 RAG(按上下文自动带入,不靠触发词)。它填的是两种纯形态之间的空隙------"值得每次都在、但不想手工维护成卡"的中间地带。
于是有了这个终极比喻:
RAG 库是分身的记忆海马体------读过什么、见过什么; skills 和 memory 是分身的人格与前额叶------怎么想事、什么绝不能碰。 只有记忆没有人格是复读机,只有人格没有记忆是空想家。
回到开头的问题:"这段经验放知识库还是写成 skill?"现在可以给出完整的判断流程:
- 错一次会出事故吗? 会 → skill + memory 双保险(§3.6 铁律)
- 是海量长尾、偶尔查用的原文吗? 是 → RAG(底层全量保真)
- 高频使用、值得压缩、但手工蒸馏太贵? → 中间层自动蒸馏(LLM 生成 + 质量闸)
- 是你自己的教训、决策、约束吗? 优先级无条件调到最高(权重里不存在的知识,§5)
知识库管见闻的广度,蒸馏管原则的深度。两条路都要走,但每一段知识,只有一条属于它的路。