最近我一直在用 Agent 做 Vibe Coding。
一个任务交给它,它可以一次性改很多文件、加不少功能,最后告诉我:已经完成。
但我很快发现,真正花时间的事变了。以前是等代码写完,现在代码很快就能生成;更头疼的是------它到底有没有做对?
我可以让开发 Agent 自己跑测试,也可以再叫一个 Agent 来检查。可如果第二个 Agent 只是把第一份总结读了一遍,再给我一份看起来很专业的报告,我其实没多拿到什么证据。
这也是我最近在做 AI 交付验收台时一直在想的问题。做着做着我发现,它不只是一个工具怎么设计的事,而是 AI Coding 时代一个更普遍的工程问题:当实现越来越容易,谁来定义完成?又凭什么证明完成?
一、AI 写代码的比例在涨,瓶颈正在换位置
2026 年 2 月,Cursor 创始人 Michael Truell 写了篇文章《The Third Era of AI Software Development》,讲 AI 软件开发的第三个阶段。
里面有个数字:Cursor 内部合并的 PR,已经有 35% 是由云端虚拟机里自主运行的 Agent 创建的。
这个数字我得先把口径说清楚:它说的是 Cursor 自己公司内部、合并 PR 的情况,不是全行业 35% 的生产代码,更不能拿来直接推断你我的项目。
但它至少说明了一种变化:在某些团队,Agent 已经不只是补全几行代码,而是能自己扛下更完整的开发任务。
当实现成本不断往下掉,瓶颈也会跟着换。
过去我们常问:代码写得够不够快?功能能不能按时交付?测试覆盖率够不够高?
等 Agent 能一次改一堆东西之后,新的问题开始冒出来:它有没有真正理解原始需求?测试通过,是不是就等于功能正确?测试覆盖了代码,有没有覆盖用户真正在意的结果?它说自己完成了,我凭什么相信?
代码能快速生成,测试也能快速生成,连测试报告都能快速生成。但这些东西,不会自动变成可信的交付结论。
一句话:实现变便宜了,判断没有跟着变便宜。
二、测试全绿,为什么交付还可能有问题?
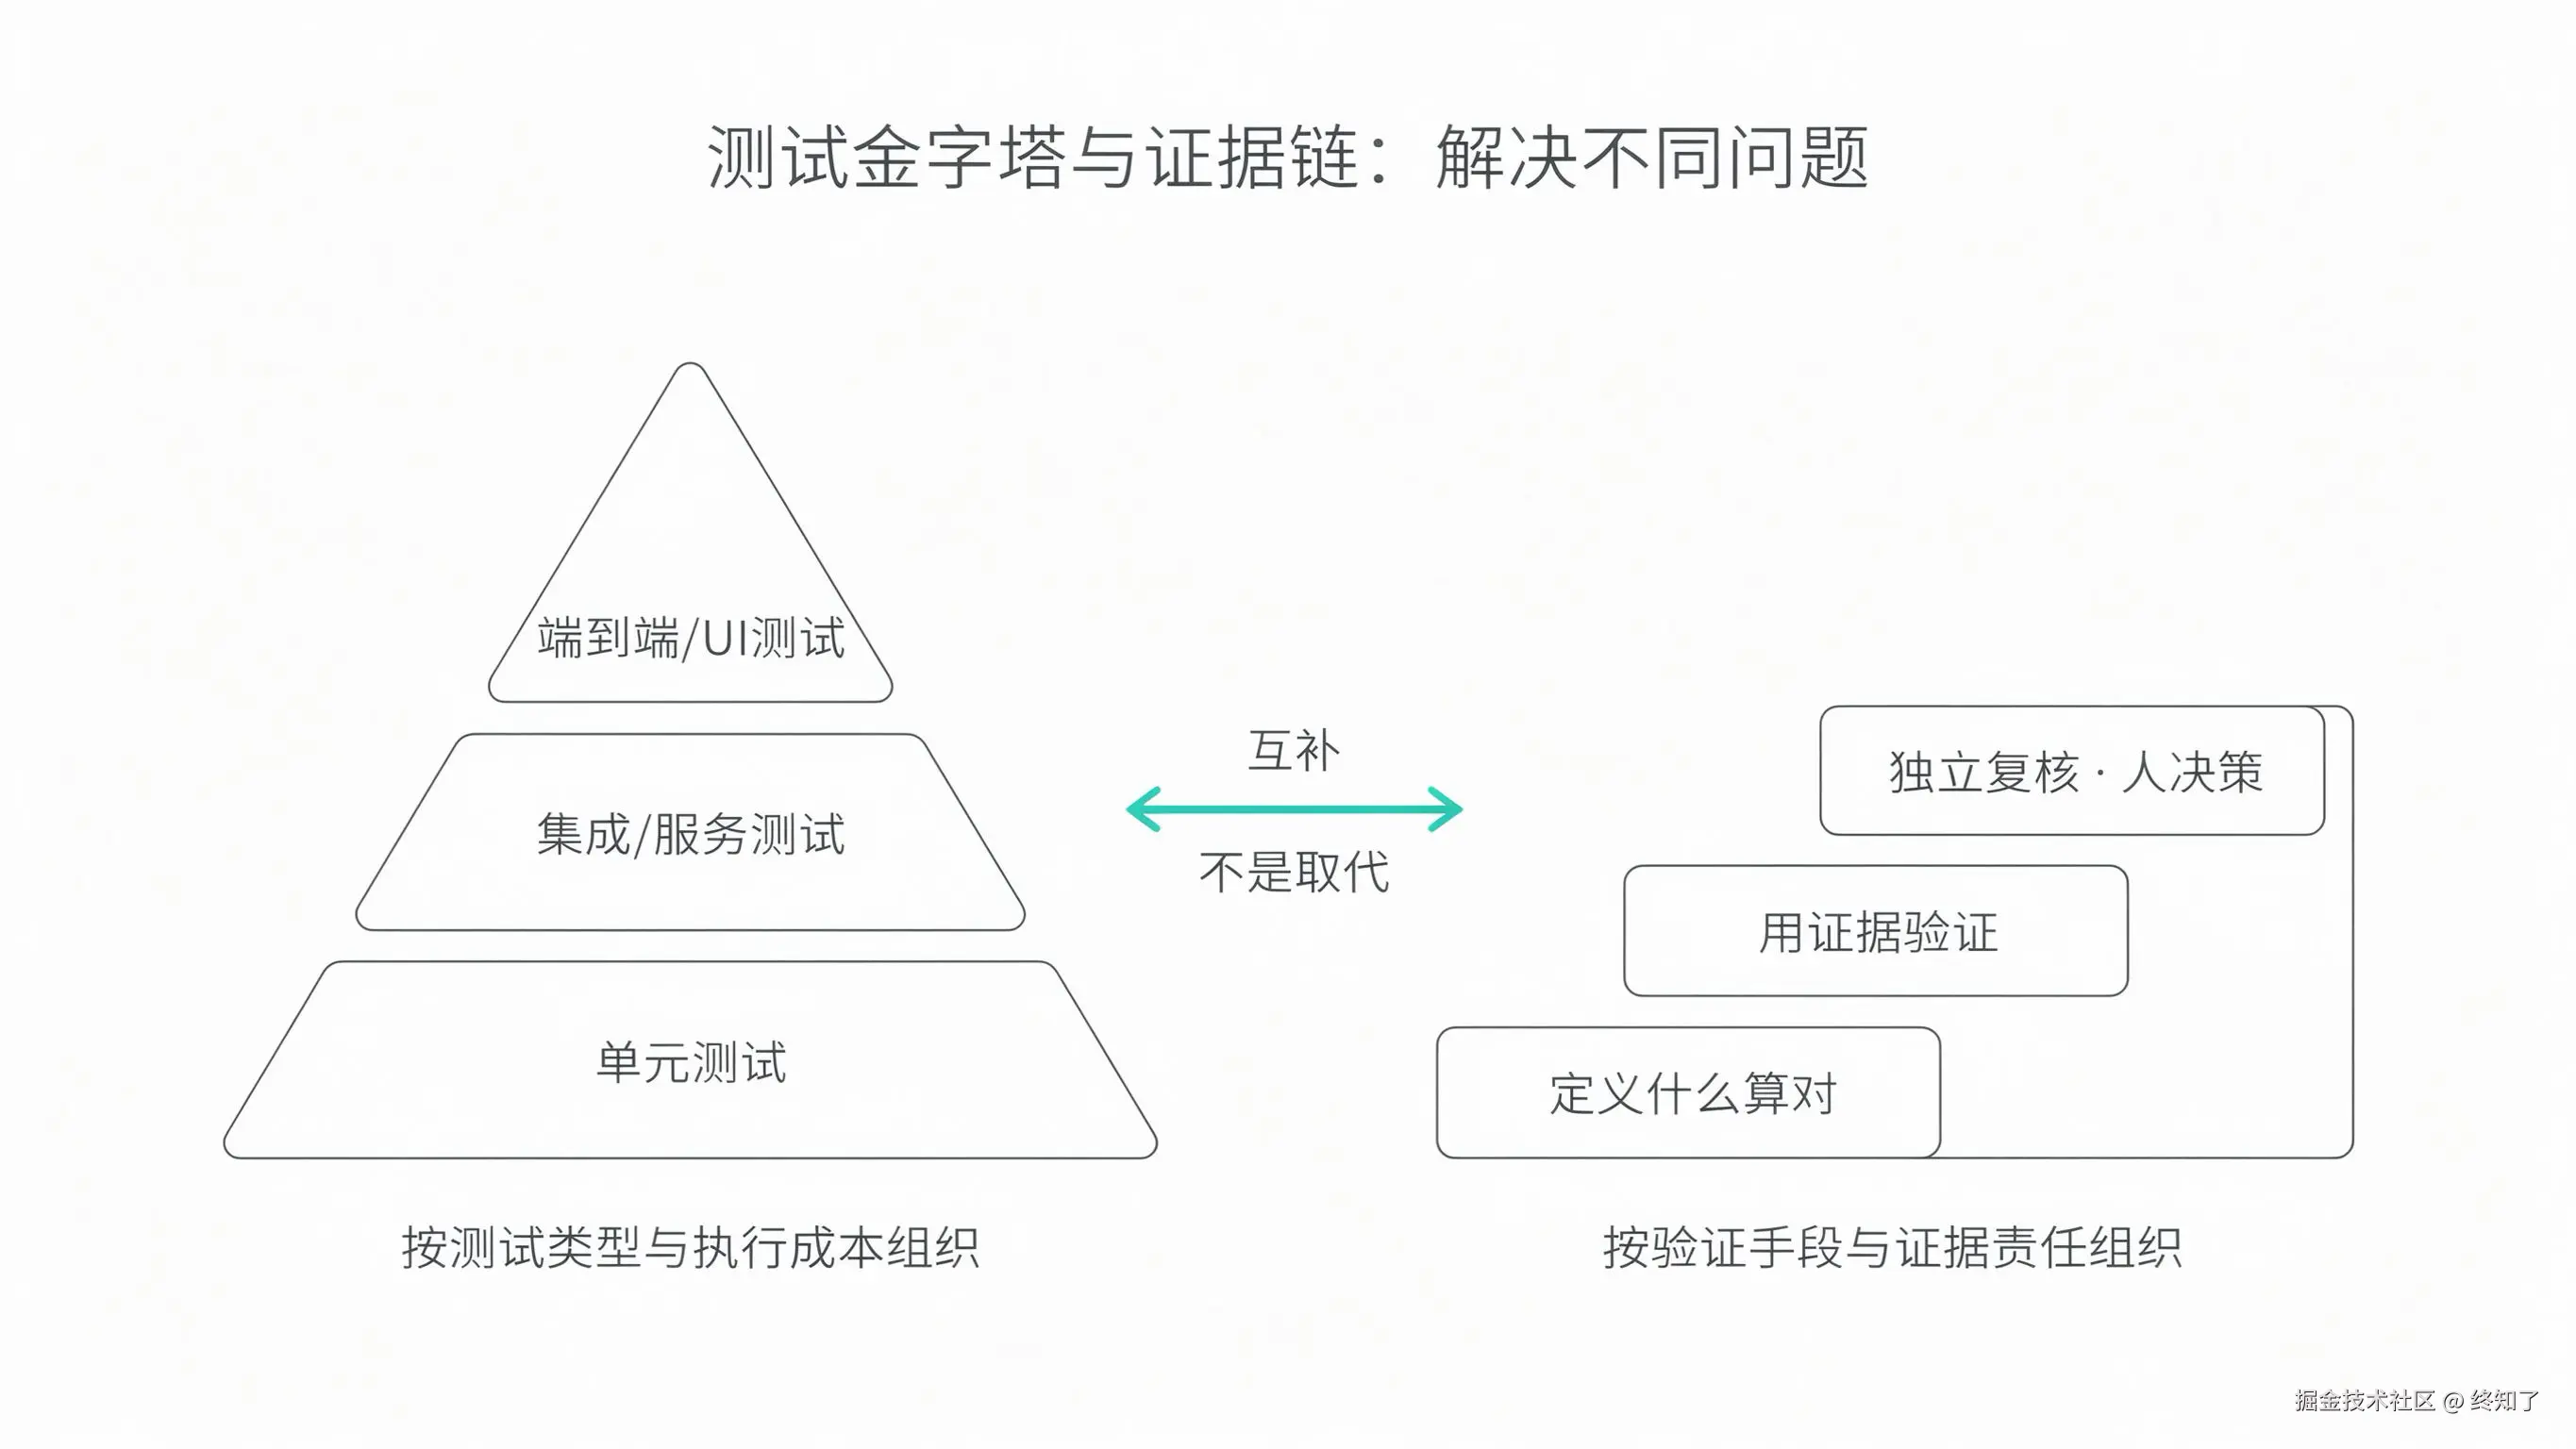
传统测试体系当然还是重要的。单元、集成、端到端,各管一层。测试金字塔讲的是不同测试类型之间成本、速度和维护的权衡,这套东西并没有因为 AI Coding 就失效。
真正值得重新想的是另一件事:我们是不是把"测试通过",过度等同于"任务完成"了?
我现在会特别警惕三个失效模式。
1. 测试验证了实现,却没验证需求
比如让 Agent 做一个搜索功能。它把搜索框、查询接口、结果列表都做了,还补了测试,全绿。
但用户真正想要的,可能是:输入关键词,能找到正确的文档,而且结果跟当前任务相关。
如果测试只验证了接口返回一个数组、组件能渲染、某个函数返回了预期数据结构,那它可能完全没碰到用户真正关心的结果。
覆盖率能告诉你测到了多少代码,却回答不了:我们有没有验证用户要求的行为?
2. 测试很多,不等于测试有判断力
AI 能生成测试、Mock、断言。但生成得多,不等于验证能力强。
有一项研究分析了 2025 年超过 120 万次提交、2,168 个仓库,专门看 Agent 生成的测试。结果发现,Agent 提交里有 36% 会给测试加 mock,非 Agent 是 26%;23% 会改测试文件,非 Agent 是 13%。
这不是说 mock 是坏东西。Mock 本来就是隔离依赖、构造边界的重要工具,关键在于它有没有把"真正需要验证的行为"也一起隔离掉。
如果一个测试把外部服务、数据层、甚至关键业务逻辑全 mock 掉,最后只验证调用顺序,那它绿着,却没验证真实依赖组合起来到底能不能用。
另一篇研究还发现,Agent 写测试时,大量是揭示结果的 print 语句,真正的断言要少得多;而且无论用 prompt 让它多写还是少写测试,最终任务结果并没有明显变化。
这些研究不能证明"AI 写的测试都没用",它提醒我们的是:测试数量、通过率、和真实验证能力,是三件不同的事。
3. 测试一直绿,不等于没有风险
还有一种更隐蔽的:业务逻辑被意外改坏了,但断言没覆盖到那块;或者测试和实现用了同一个错误假设,结果俩一起绿。
变异测试(Mutation Testing)给了个补充办法:故意对代码做一点小的错误修改,看测试能不能发现。
如果代码被改坏了,测试还全绿,那它大概率有盲区。
Thoughtworks 在技术雷达里把变异测试列为 Trial,看重的就是它能评估测试"到底能不能发现故障"。当然它也有成本,更像检查测试有效性的工具,不是能自动证明系统正确的万能答案。
这三个失效模式,指向同一句话:我们不仅要问"有没有测试",更要问"这个测试到底证明了什么"。
三、我现在怎么做:三步证据法
测试金字塔帮我组织"测什么"。但当任务交给 Agent,我还得回答另一个问题:这次交付,凭什么可以被接受?
我更愿意把它理解成一条证据链,而不是再造一个新金字塔去取代它。这两件事解决的问题不一样------金字塔管测试类型和反馈,证据链管"需求、验收标准、验证结果和最终决定怎么连起来"。
我把它收敛成三步。
第一步:先定义什么算对
很多验收问题,其实在开发开始前就埋下了。如果需求只有一句"优化一下搜索体验",开发 Agent 按自己的理解做完,验证 Agent 也按自己的理解检查,最后两边都觉得没问题。
所以在动手前,我会尽量把原始需求转成明确的验收条件。
比如"搜索文档",验收条件就是:输入关键词后,返回匹配的文档;要"支持筛选",就是:选择筛选条件后,结果跟着变化;要"修复保存问题",就是:保存后重新打开,修改的内容还在。
这些是简化示意,真实项目还要补异常、边界和质量要求。
不是所有需求都能变成确定性断言。体验、可用性这类难形式化的,我会定义观察维度和判断标准,而不是假装已经量化了。
核心是:验收标准要来自原始需求,而不是 Agent 干完活之后,再自己解释什么叫完成。
第二步:用证据验证,而不是只看总结
"功能已完成"是一句陈述,不是验证结果。
能确定性检查的,优先用自动化测试、构建结果、接口断言。没法完全用断言描述的,就保留观察材料:实际做了什么操作、操作后看到什么、哪些条件验过了、哪些还没验、有没有环境限制。
页面能打开,不等于功能都能用;截图看着正常,不等于数据保存和异常处理都对。
不同证据只能支持不同范围的结论:一张截图支持某个界面状态,证明不了后台逻辑;一次测试通过,支持被它覆盖的行为,证明不了整个需求。
所以我看重的不是证据有多少,而是证据和验收条件能不能一一对应。
第三步:独立复核,最终由人决策
如果 Agent 自己写代码、自己写测试、自己跑、自己宣布通过,整个过程会有共同盲区。
再加一个验证 Agent,确实能换个视角,但前提是它得真的独立检查,而不是复述第一份总结。
它应该对照原始需求和验收标准,看真实代码、测试结果或运行表现,明确指出:哪些有证据支持、哪些失败、哪些还没验、哪些被环境卡住。
但独立复核不等于第二个 Agent 天然正确,它的结论同样要证据。最终的交付决定,也不该被一个绿色状态自动替代。
没有证据,不等于失败;但没有证据,也不能算通过。
顺带说一个我看到、但只在特定场景有用的做法。
GitHub 团队讲过怎么验证非确定性的 Agent:把多次运行的轨迹合并,用支配分析(dominator analysis)找出"每一次成功运行都必须经过的状态",自动过滤掉加载动画这种可变路径。它不用人工写规则,逻辑也可解释。
但它针对的是 GitHub 自己的 Agent 场景,并不意味着普通代码验收都得套支配分析。我把它当案例参考,不当主线。
四、所以我开始做 AI 交付验收台
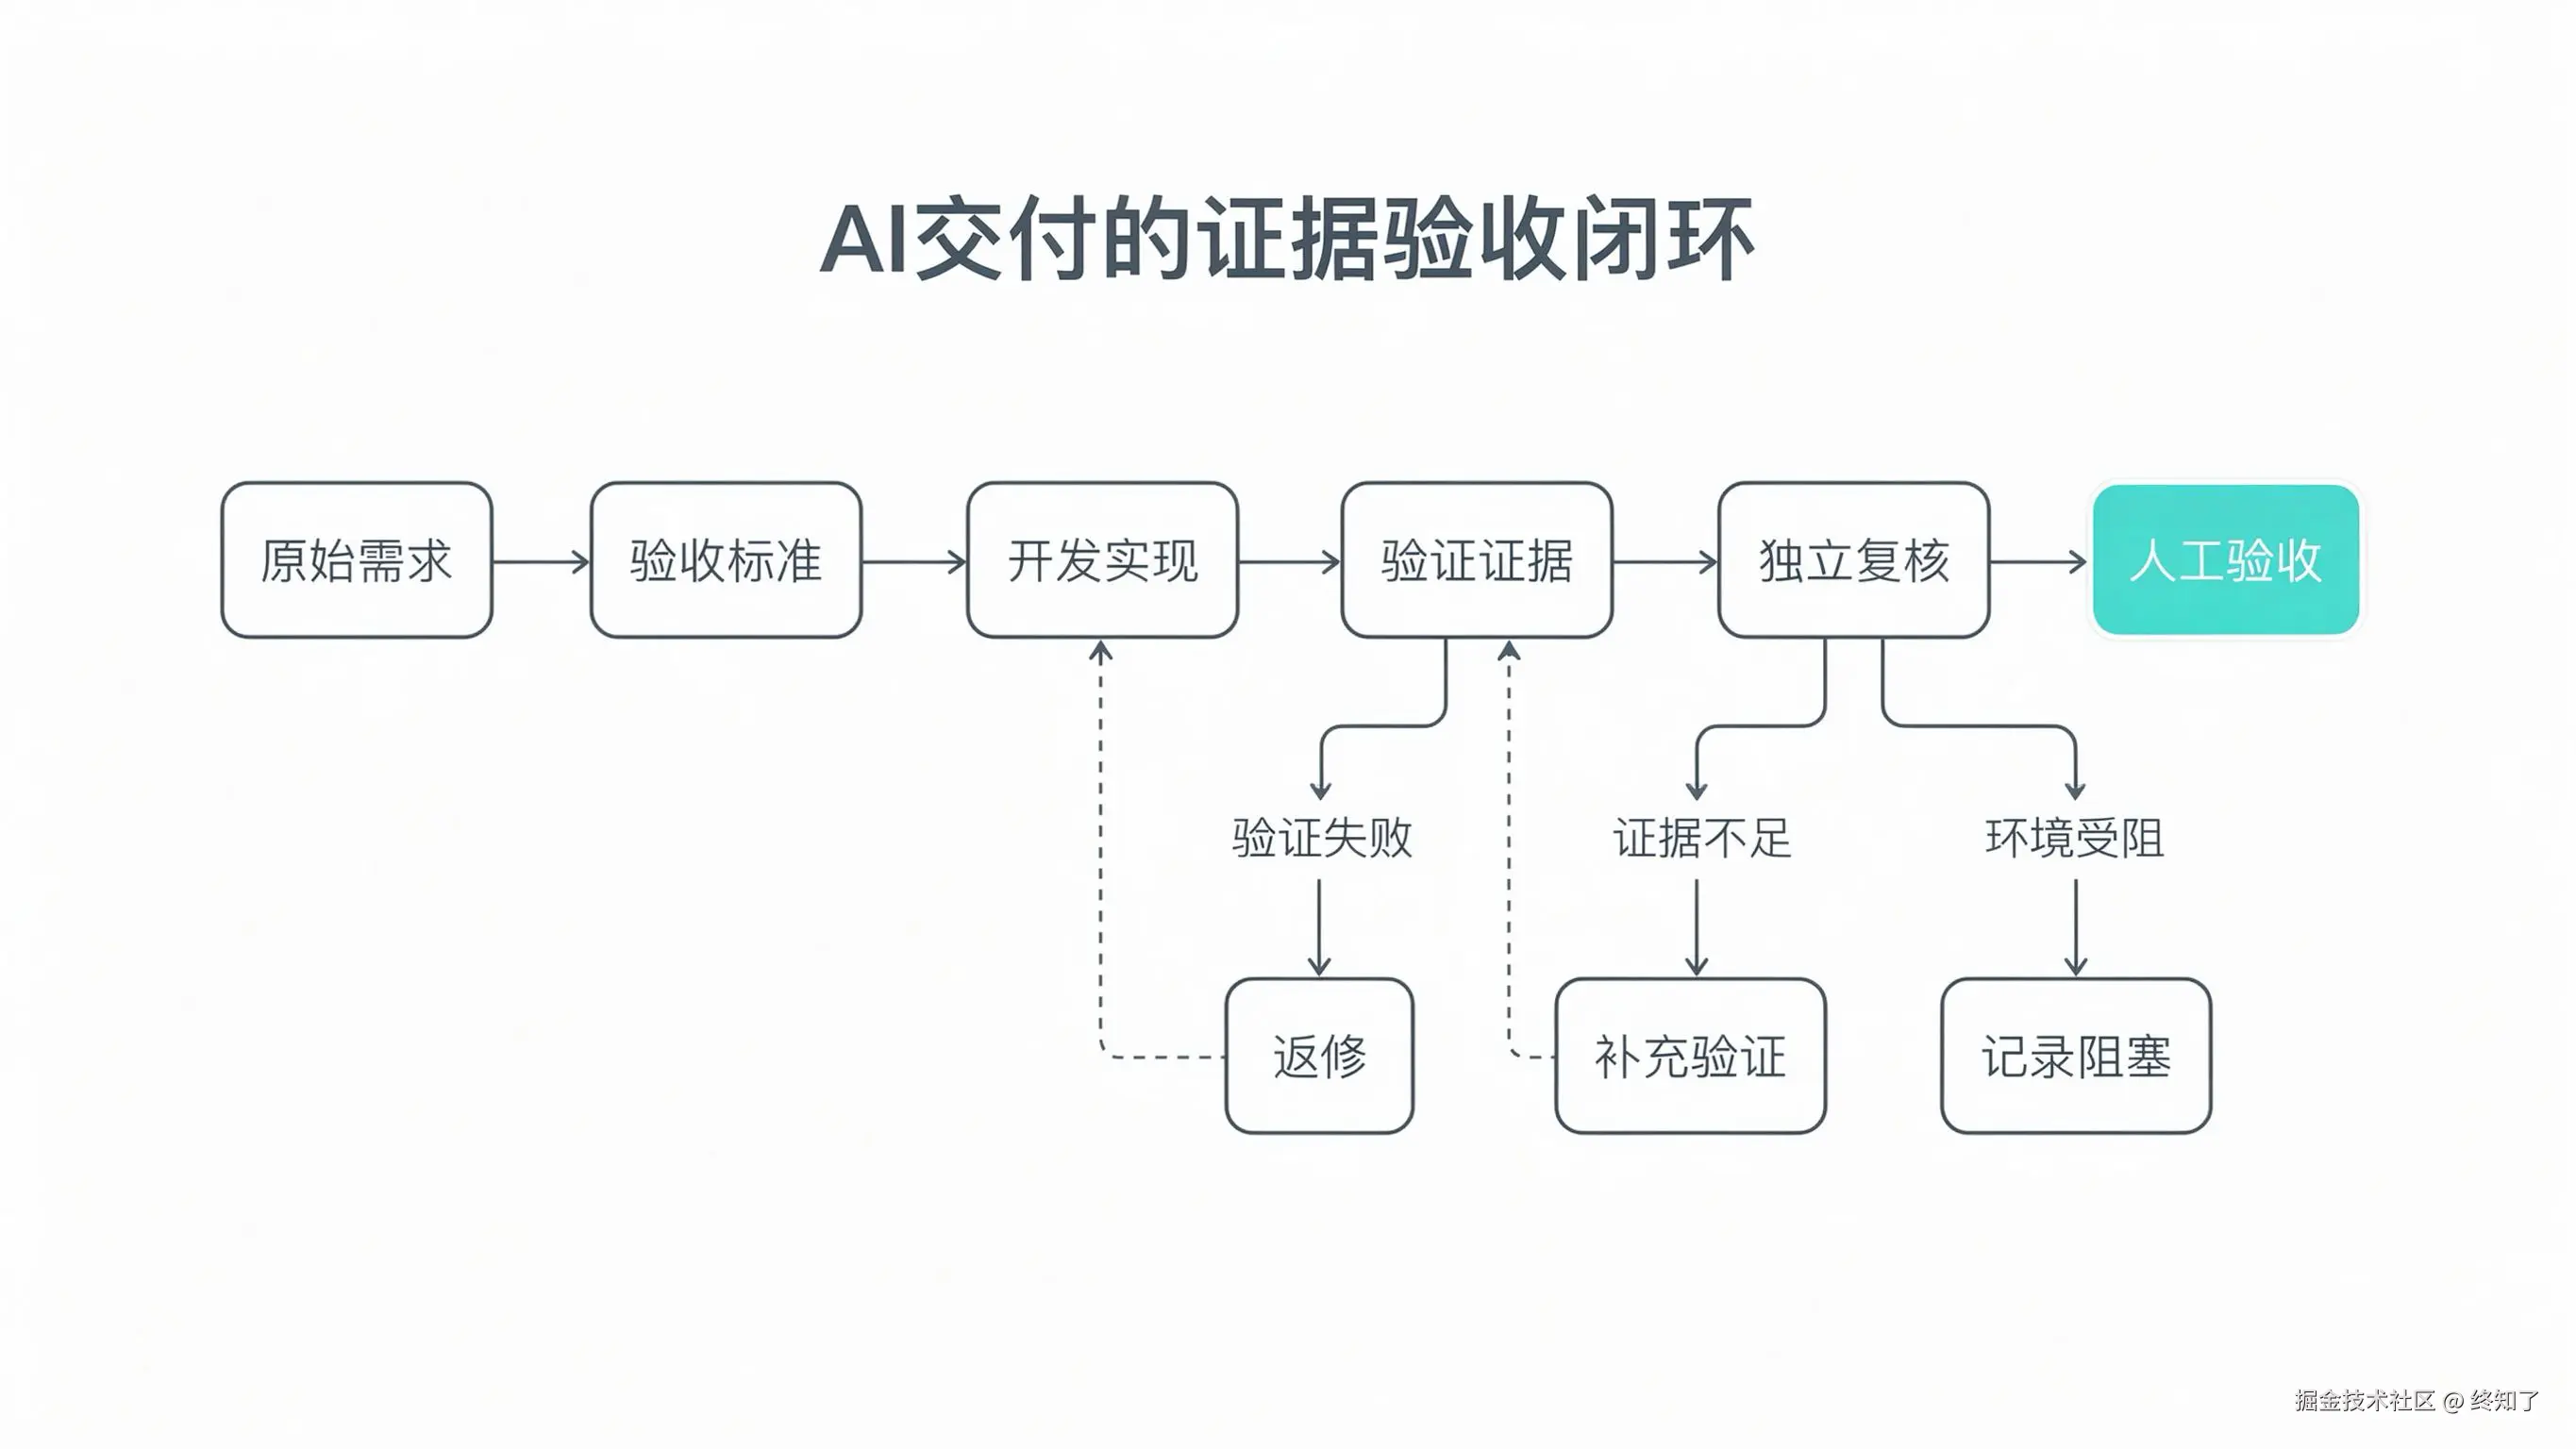
这也是我做 AI 交付验收台的直接原因。
我不是测试工程师,也没打算重造一套测试框架。我更多是站在 AI 产品经理和重度 Agent 使用者的角度,想怎么更可靠地验收 Agent 的交付。
当一个任务牵扯多个文件、多个功能点,我很难只靠读代码、看一份总结,就判断它真完成了。
我想把任务拆成若干验收条件,再逐项记录验证依据、结果和后续处理。
所以我现在在意的,不是让系统自动喊"全部通过",而是让它清楚地呈现:原始需求是什么、每条验收条件是什么、现在有哪些证据、哪些要返修、哪些还没验、最终由谁决定。
我会把每条验收项区分成五种状态:待验收、通过、未通过、无法判断、环境阻塞。
这五个是并列的分类,不是五个等级,更不会被压成一个通过率。
工具现在还在迭代,自动交接、返修、重新验证的完整闭环还没全部打通。但我越来越确定一件事:我们需要的不是一份更漂亮的报告,而是让交付结论能追溯到实际依据的机制。
结尾
我现在会用三个问题检查一次 Agent 交付:
- 什么算完成? ------ 有没有明确的验收标准
- 凭什么说完成? ------ 有没有跟标准对应的证据
- 谁来决定完成? ------ 有没有独立复核,并由责任人拍板
这套方法不保证系统绝对正确,也消不掉所有不确定性。但它至少能让我分清:哪些结论已经被验证,哪些只是看起来合理,哪些还不知道。
AI 让实现变便宜了,但没有让判断变便宜。真正要建立的,不是更多绿色对勾,而是一套能说明"交付为什么可以被接受"的证据机制。
最后也想问问你:你在用 AI Coding 时,还会因为测试全绿就放心交付吗?有没有遇到过"全绿、但其实是坏的"?你是怎么确认 AI 没糊弄的?
参考资料
- Michael Truell,《The Third Era of AI Software Development》,Cursor,2026-02-26
- Hora & Robbes,《Are Coding Agents Generating Over-Mocked Tests?》,arXiv:2602.00409(MSR 2026)
- Chen et al.,《Rethinking the Value of Agent-Generated Tests》,arXiv:2602.07900
- Thoughtworks Technology Radar,Mutation Testing(Trial)
- GitHub Blog,《Validating agentic behavior when "correct" isn't deterministic》
注:文中研究和案例用于说明特定观察,不代表所有 Agent、代码库、测试场景表现相同。