让Agent的挣扎可见:执行轨迹面板与生成统计行
实证案例:heart-net 个人智能体对话链路(AgentScope 2.0 + DashScope + Vue 3 SSE 流式前端)
本文所有代码片段均取自真实实现(
AgentChatServiceImpl.java/ChatView.vue/api/chat.ts), 所有数字均为真实跑流实测(8093 临时实例 + 真实模型流),可复算、可回放。 与《RAG 评测体系生产实践指南》构成姊妹篇------评测管结果质量,trace 管过程质量, 两者合起来才是 Agent 工程师的完整武器。
0. 这章讲什么、给谁看
一句话定位 :把对话页的 SSE 流从"只透出最终文字"升级为两个可观测消费场景------执行轨迹面板(过程时间线:模型为什么这么干)+ 生成统计行(结果账单:这次花了多少)。两者共享同一条帧协议,一次协议建设、两个消费场景先后兑现。
给谁看:
| 读者 | 读法 |
|---|---|
| 用 Agent 框架(AgentScope/LangChain 等)想加观测的开发者 | 通读------§2 取证方法 + §3 帧协议直接抄作业 |
| 前端做流式 UI(SSE/WebSocket)的工程师 | 重点 §4~§5------增量帧聚合、防御性回退、错位采样计时 |
| 想知道"可观测到底观测什么"的概念型读者 | 重点 §1------可观测 ≠ 可视化,三层拆解 |
| 排查过"Agent 越答越慢"的人 | 直接看 §6.4------64K 上下文雪球,面板上线当晚抓到的实锤 |
贯穿全文的实证对象 :heart-net 是一个单 agent 对话应用------AgentScope HarnessAgent 托管 ReAct 循环(思考→调工具→再思考→作答),DashScope qwen3.8-omni-flash 做模型,五个只读工具(检索/台账查询),前端 Vue 3 走 SSE 流式渲染。改造前,这条链路对用户的全部输出只有两类:打字的正文 + 一个工具名标签条;改造后,用户能看见模型每一轮在想什么、调了什么、传了什么参数、拿到什么结果、烧了多少 token。
1. 引子:模型的挣扎,你看不见
1.1 一个真实样本
先看一个改造后才"现形"的真实行为(现场截图): 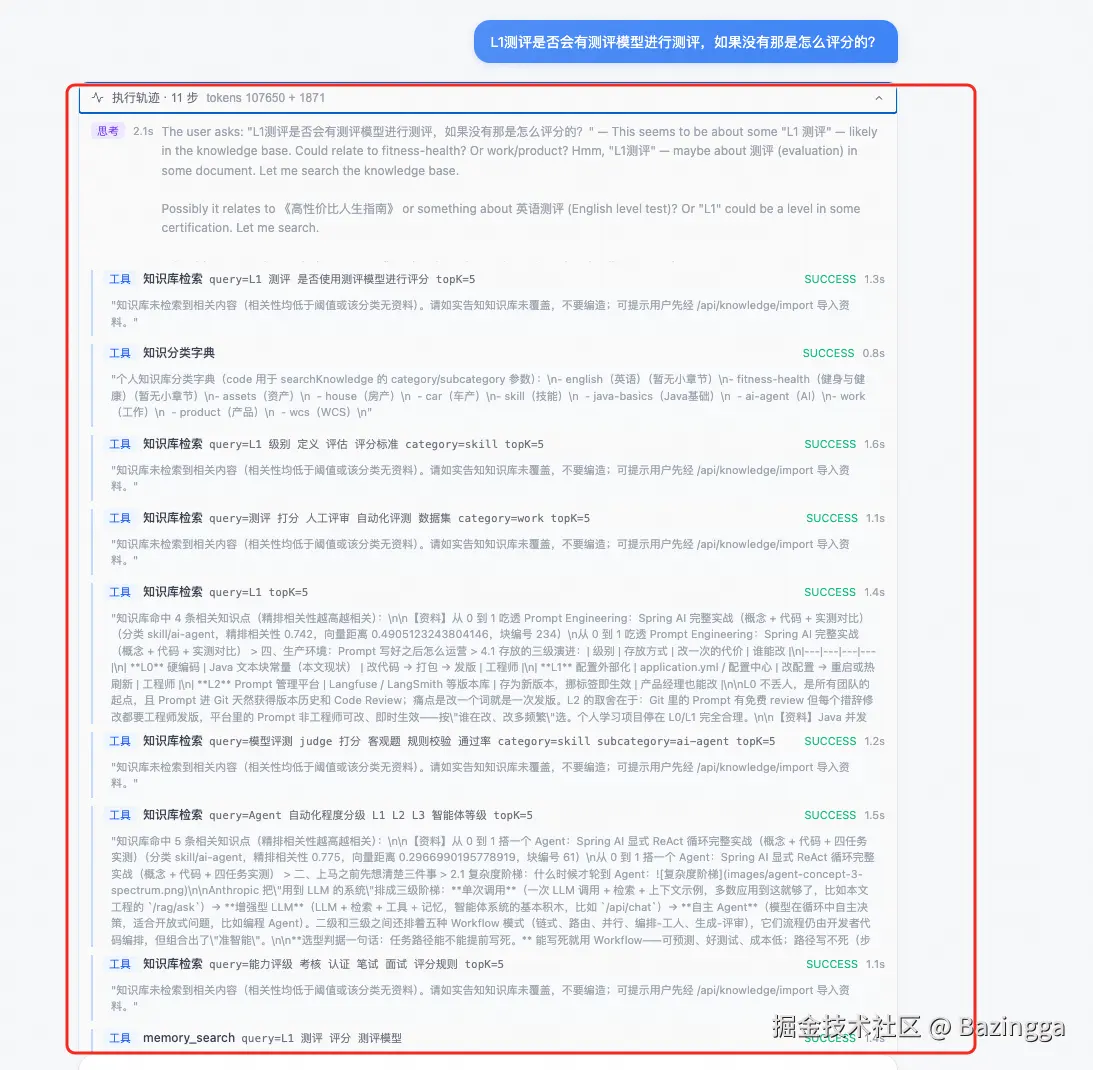
用户问了一个知识库里其实没有对症语料的问题,模型连续发起了 7 次检索工具调用 ------L1 测评、Agent、skill、memory_search......每个 query 都完整可见,每次 1~2 秒,全部执行成功。最后模型基于捞到的边角料组织了一个回答。
这件事在改造前完全不可见。你只会看到:问题发出去 → 光标闪了十几秒 → 答案出来了。答案质量一般,但你说不出为什么------是模型笨?是检索烂?还是库里根本没货?
改造后,7 枪扫射摆在眼前,你一眼就能看出两件事:模型在换着关键词碰运气 (说明库里大概率没有对症语料);每次调用都成功但可能没捞到货(SUCCESS 只表示工具没抛异常,不代表有可用材料)。
通俗例子 :这就好比医生看诊。只有最终处方(最终回答),你永远不知道医生做了哪些检查、排除了哪些可能;有了完整病历(执行轨迹),"为什么开这个药"才有答案可查。结果没错 ≠ 过程没浪费------7 枪扫射和后面要讲的 9 次空转,答案都对,过程都在烧钱。
1.2 可观测 ≠ 可视化
做面板之前必须先立住一个概念:可观测(observability)和可视化(visualization)不是一回事。
- 可视化是把已经存在的数据画出来;
- 可观测 是先回答"数据存在吗?够用吗? "------工程定义是:不打断系统运行,就能回答"它刚才为什么这么干"。
所以"做个面板"之前,先过三道数据关: 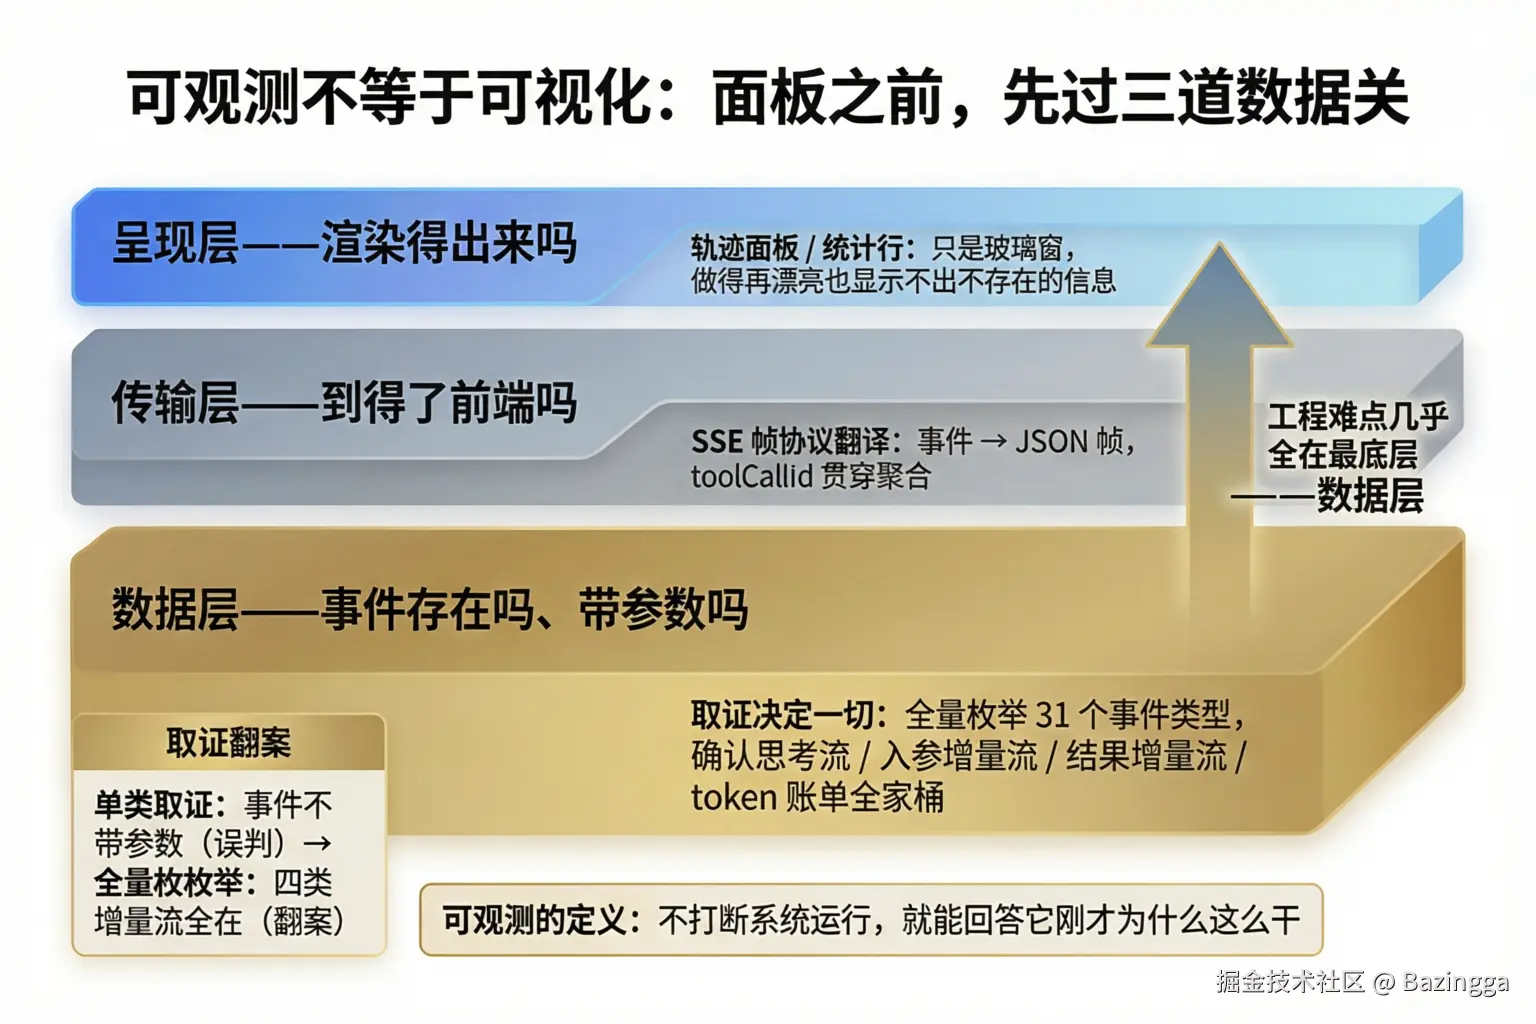
| 层 | 要回答的问题 | 本案例的答案 |
|---|---|---|
| 数据层 | 事件存在吗?带参数吗? | 框架事件流里到底有没有思考流、入参流、token 账单?(§2 取证) |
| 传输层 | 到得了前端吗? | SSE 帧协议翻译:事件 → JSON 帧(§3) |
| 呈现层 | 渲染得出来吗? | 面板 + 统计行(§4~§5) |
面板只是呈现层。面板做得再漂亮,也显示不出不存在的信息------玻璃窗后面得先有东西。这就是为什么本文一半篇幅在讲数据层取证和传输层协议,真正的"画界面"反而是最薄的一层。
1.3 为什么这是编排阶梯的第 1 级
heart-net 的编排学习路线里有一个六级实战阶梯(基线 → 轨迹可观测 → 撞墙取证 → 显式 workflow → HITL 断点 → 子 agent 扇出),观测排在所有编排改造之前------理由只有一句话:
改编排之前必须能观测编排,否则改了不知道好在哪。
没有轨迹面板,"把检索从一锤子改成多跳""把串行改并行"这类改造的收益只能靠体感;有了面板,每一步决策可见,A/B 对比才有据可依。观测是所有后续编排实验的地基。
2. 数据层:一个错误结论的诞生与推翻
2.1 错误结论怎么诞生的
时间回到几天前。当时在做多跳检索改造,想知道一个问题:ReAct 循环里每一跳工具调用的入参,能不能从 SSE 事件流透出到前端?(如果能,前端就能显示每跳的 query------观测多跳的关键。)
取证姿势:javap 反编译 ToolCallStartEvent,看它有哪些 getter。结果:
objectivec
ToolCallStartEvent 的全部 getter:replyId / toolCallId / toolCallName没有 arguments。于是当时的结论是:"事件不带工具入参,每跳 query 只能走服务端日志,前端帧透不出。"这个结论写进了素材卡和记忆库,还成了当时观测层设计的一个边界约束。
这个结论是错的。但错不在证据,在取证方法。
2.2 翻案:全量枚举
这次做面板,动工侦察时换了一个取证姿势------不查想到的那个类,先枚举全部类:
bash
# 1. 解压 jar,枚举 event 包内全部类文件:35 个
unzip agentscope-core-2.0.3.jar -d target/asj
ls target/asj/io/agentscope/core/event/    # 35 个类文件

# 2. 反编译枚举类,拿全部事件类型:31 个枚举值
javap io.agentscope.core.event.AgentEventType

# 3. 逐类 javap,看每个事件带什么字段
javap io.agentscope.core.event.ToolCallDeltaEvent
javap io.agentscope.core.event.ThinkingBlockDeltaEvent
...全量枚举后发现一个全家桶------之前只盯着 Start 类看,漏掉了它周围的兄弟:
| 事件类型 | 携带字段 | 含义 |
|---|---|---|
TOOL_CALL_DELTA |
getDelta() |
工具入参增量流------模型流式吐 JSON 参数片段 |
TOOL_RESULT_TEXT_DELTA |
getDelta() |
工具结果增量流------结果文本一片片到达 |
THINKING_BLOCK_DELTA |
getBlockId() + getDelta() |
思考流------模型思考过程逐字输出 |
MODEL_CALL_END |
getUsage()(ChatUsage:input/output/cached/total 四字段) |
单轮 token 账单 |
也就是说:入参、结果、思考、账单,观测需要的四类数据在事件 API 里全都有,之前那个"事件不带参数"的结论错得离谱------错的根源是只查了一个类就下了包级结论。
2.3 教训:取证方法决定结论质量
这个翻案比面板本身更有博客价值,因为它暴露的是一类系统性风险:
查 API 存在性,先枚举包内全部类,再逐类看 getter。只查你想到的那个类,结论天然带着盲区------你不知道自己不知道什么。
技术结论是有保质期的:结论依附于取证方法,方法有盲区,结论就有盲区。
有个细节让这个教训更真实:错误结论当时被写进了两张素材卡和一条记忆库,翻案时三处都要追加修正(保留原文 + 附修正段)------错误结论的传播成本远高于产生成本,这也是"下结论前多花十分钟取证"的性价比所在。
3. 传输层:帧协议设计
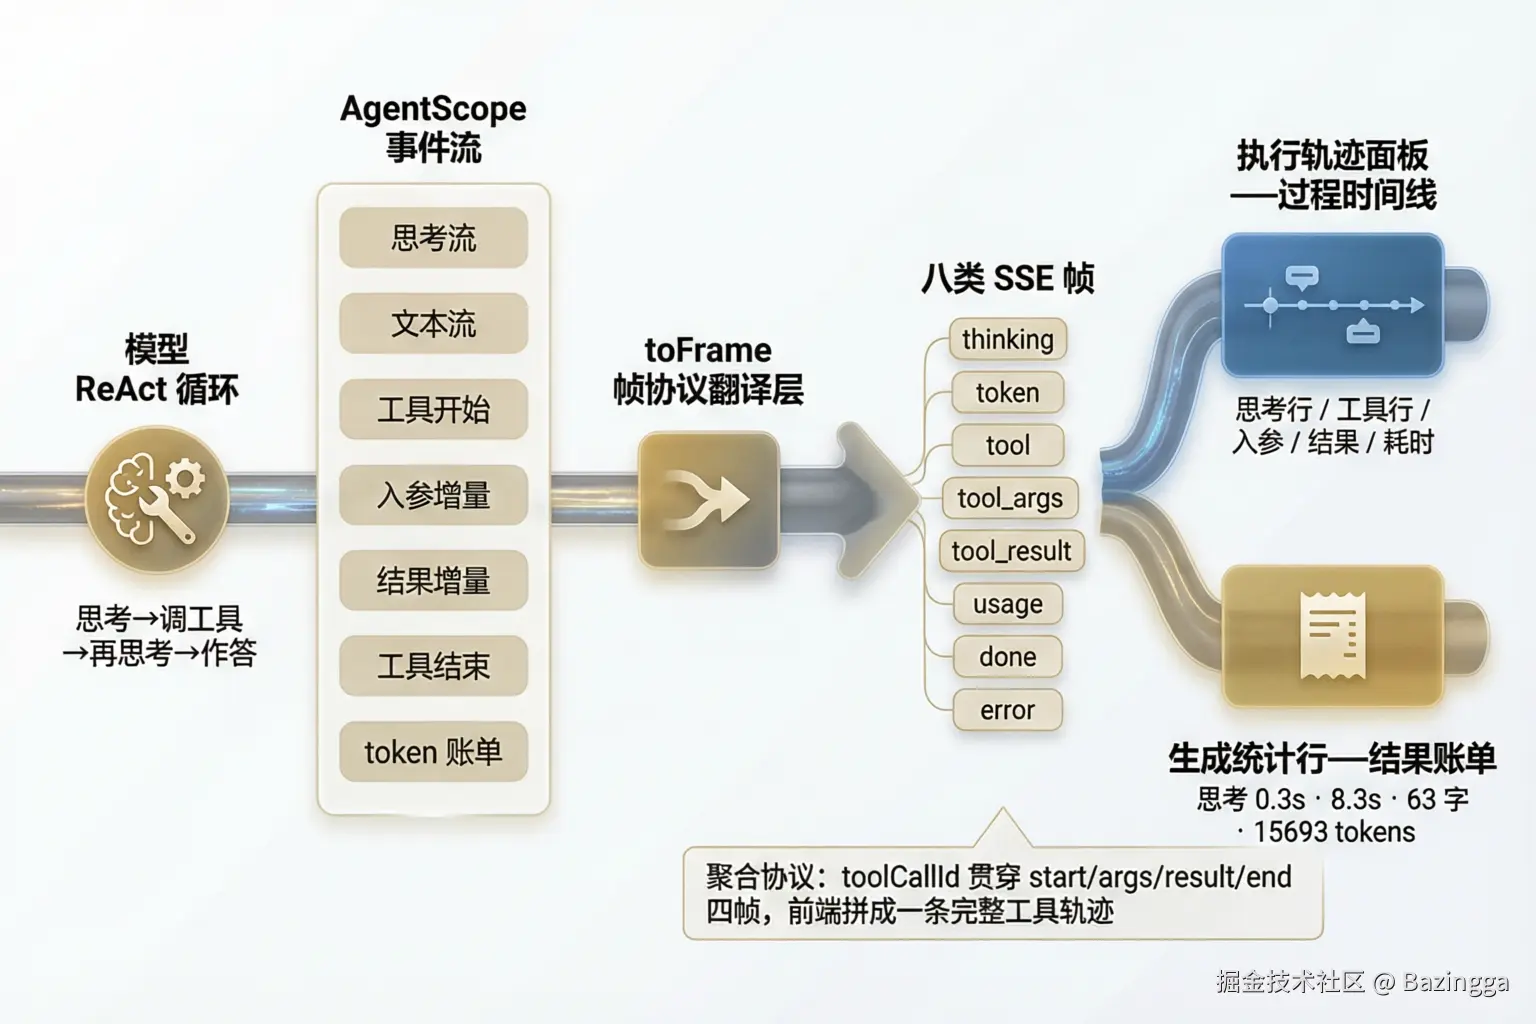
数据层确认"全家桶都在"之后,下一步是把它送到前端。总体管道:
3.1 从三类帧到八类帧
改造前,SSE 通道里只有 4 类帧:token(正文增量)、tool(工具开始/结束标签)、done、error。改造后扩到 8 类:
| 帧 | 内容 | 设计要点 |
|---|---|---|
thinking |
思考流增量(blockId + text) |
blockId 区分多个思考块;模型不支持思考流时自然缺省,前端不渲染该行 |
token |
正文增量 | 不变 |
tool |
工具 start/end(新增 id) |
原来只按工具名匹配,同名并发会错配;改 toolCallId 精确聚合 |
tool_args |
工具入参增量流(id + delta) |
模型流式吐 JSON 参数片段,前端按 id 拼出完整入参 |
tool_result |
工具结果增量流(id + delta) |
结果文本片段,前端聚合为结果摘要 |
usage |
单轮 token 账单 | ReAct 多轮会发多帧,前端累加------观测成本的第一现场 |
done / error |
结束 / 错误 | 不变 |
3.2 翻译层代码:toFrame
整个协议就是 AgentChatServiceImpl 里一个纯函数------事件进、帧出,未观测到的事件类型静默丢弃(Flux.empty())。核心分支节选:
java
// AgentChatServiceImpl.java ------ 事件 → SSE 帧的唯一翻译层(节选)
private Flux<String> toFrame(AgentEvent event) {
    if (event.getType() == AgentEventType.THINKING_BLOCK_DELTA) {
        ThinkingBlockDeltaEvent e = (ThinkingBlockDeltaEvent) event;
        if (e.getDelta() == null || e.getDelta().isEmpty()) return Flux.empty();
        Map<String, Object> payload = new LinkedHashMap<>();
        payload.put("type", "thinking");
        payload.put("blockId", Objects.toString(e.getBlockId(), "-")); // 多思考块区分键
        payload.put("text", e.getDelta());
        return Flux.just(frame(payload));
    }
    if (event.getType() == AgentEventType.TOOL_CALL_DELTA) {
        // 工具入参增量流:模型流式吐 JSON 参数片段,前端按 id 聚合出完整入参
        ToolCallDeltaEvent e = (ToolCallDeltaEvent) event;
        Map<String, Object> payload = new LinkedHashMap<>();
        payload.put("type", "tool_args");
        payload.put("id", Objects.toString(e.getToolCallId(), "-"));   // 贯穿聚合键
        payload.put("name", Objects.toString(e.getToolCallName(), "-"));
        payload.put("delta", Objects.toString(e.getDelta(), ""));
        return Flux.just(frame(payload));
    }
    if (event.getType() == AgentEventType.MODEL_CALL_END) {
        // 单轮模型调用 token 账单(ReAct 多轮会发多帧,前端累加)
        ModelCallEndEvent e = (ModelCallEndEvent) event;
        if (e.getUsage() == null) return Flux.empty();
        Map<String, Object> payload = new LinkedHashMap<>();
        payload.put("type", "usage");
        payload.put("inputTokens", e.getUsage().getInputTokens());
        payload.put("outputTokens", e.getUsage().getOutputTokens());
        payload.put("totalTokens", e.getUsage().getTotalTokens());
        return Flux.just(frame(payload));
    }
    // ... TOOL_RESULT_TEXT_DELTA / TOOL_CALL_START / TOOL_RESULT_END 同构
    return Flux.empty();   // 未观测到的事件静默丢弃
}
三个实现细节值得点名:
Objects.toString(x, "-")兜 null------适配器没透出的字段降级为占位符而不是 NPE 或丢帧;- 空 delta 直接
Flux.empty()------思考流经常发空片,翻译层过滤掉,不让垃圾帧进通道; MODEL_CALL_END是"每轮一张账单"------ReAct 一轮对话可能调七八次模型,每次调用结束都有一帧 usage,所以 7 帧 usage = 7 轮模型调用,这个数字本身就是行为证据(后面测试案例会用到)。
3.3 聚合协议:toolCallId 贯穿四帧
一次工具调用在前端要拼成一条 完整轨迹,靠的是 toolCallId 贯穿四类帧:
ini
tool(phase=start, id=T1) ──┐
tool_args(id=T1, delta..) ──┼── 前端按 id=T1 聚合成一条:名称+入参+结果+状态+耗时
tool_result(id=T1, delta..)┤
tool(phase=end, id=T1) ────┘
为什么必须靠 id 而不是工具名?实测抓到一个铁证:DashScope 在参数流阶段,tool_args 帧的 name 字段是 "__fragment__" ------工具名还没定,参数先流出来了。如果按 name 聚合,这些增量帧全部对不上号;按 toolCallId 聚合则稳如泰山。协议键的选型要以实测为准,不能想当然------"同名匹配"在纸面上很合理,在流式现实里一枪就碎。
3.4 前端类型层
帧协议在前端的第一落点是类型定义------联合类型把 8 类帧钉死,让后续聚合代码全程有类型护栏:
typescript
// frontend/src/api/chat.ts ------ SSE 流事件帧(与后端 toFrame 一一对应)
export type StreamEvent =
  | { type: 'token'; text: string }
  | { type: 'thinking'; blockId?: string; text: string }
  | { type: 'tool'; phase: 'start' | 'end'; id?: string; name: string; state?: string }
  | { type: 'tool_args'; id?: string; name: string; delta: string }
  | { type: 'tool_result'; id?: string; name: string; delta: string }
  | { type: 'usage'; inputTokens: number; outputTokens: number; totalTokens: number }
  | { type: 'done' }
  | { type: 'error'; message: string }

// 面板条目:thinking 按 blockId 聚合;tool 按 toolCallId 聚合成一条完整轨迹
export type TraceEntry =
  | { kind: 'thinking'; blockId: string; text: string; startTs?: number; endTs?: number }
  | { kind: 'tool'; id: string; name: string; phase: 'start' | 'end'; state?: string;
      args?: string; result?: string; startTs?: number; endTs?: number }
注意 TraceEntry 上的 startTs/endTs------这是前端本地采样的时间戳(§5.2 会讲为什么不用后端时间),是统计行"思考时长/工具耗时"的数据来源。
4. 呈现层 A:执行轨迹面板
4.1 聚合逻辑:帧 → 条目
面板的主体是 onStreamEvent------每帧到达时判断类型、找聚合目标、增量追加。核心分支节选:
typescript
// ChatView.vue ------ SSE 帧分发与聚合(节选)
function onStreamEvent(event: StreamEvent, reply: ChatMessage) {
  if (event.type !== 'thinking') {
    closeActiveThinking(reply)        // 非思考帧到达 = 思考结束(错位采样,见 §5.2)
  }
  if (event.type === 'token') {
    reply.content += event.text       // 正文:直接拼接
  } else if (event.type === 'thinking') {
    if (!reply.trace) reply.trace = []
    const key = event.blockId || '-'
    // 按 blockId 找已有思考块;没有就开新块(startTs = 计时起点)
    let entry = reply.trace.find(
      (t): t is ThinkingTraceEntry => t.kind === 'thinking' && t.blockId === key)
    if (!entry) {
      entry = { kind: 'thinking', blockId: key, text: '', startTs: Date.now() }
      reply.trace.push(entry)
    }
    entry.text = (entry.text + event.text).slice(0, TRACE_TEXT_CAP)  // 2000 字上限
  } else if (event.type === 'tool_args' || event.type === 'tool_result') {
    const target = findToolEntry(reply.trace, event.id, event.name)  // id 优先
    if (target) {
      const field = event.type === 'tool_args' ? 'args' : 'result'
      target[field] = ((target[field] || '') + event.delta).slice(0, TRACE_TEXT_CAP)
    }
  } else if (event.type === 'usage') {
    const u = reply.usage ?? { inputTokens: 0, outputTokens: 0, totalTokens: 0 }
    u.inputTokens += event.inputTokens    // ReAct 多轮:账单逐帧累加
    u.outputTokens += event.outputTokens
    u.totalTokens += event.totalTokens
    reply.usage = u
  }
  // ... tool start/end 分支:start 建条目,end 定位改状态(见下文防御)
}聚合目标定位带防御性回退------id 精确匹配优先,缺 id 时退回"同名且运行中"最后一条;end 帧找不到对应 start 时直接补一条终态条目,宁可多一条也不丢数据:
typescript
// 优先 toolCallId 精确匹配;缺 id(适配器未透出)时退回「同名且运行中」最后一条
function findToolEntry(trace: TraceEntry[], id?: string, name?: string) {
  if (id && id !== '-') {
    const byId = trace.find((t): t is ToolTraceEntry => t.kind === 'tool' && t.id === id)
    if (byId) return byId
  }
  for (let i = trace.length - 1; i >= 0; i--) {
    const t = trace[i]
    if (t.kind === 'tool' && t.phase === 'start' && (!name || t.name === name)) return t
  }
  return undefined
}
4.2 面板模板:折叠条 + 两种行
面板 UI 很克制------一个折叠头 + 两类行(思考行 / 工具行),模板节选:
html
<!-- ChatView.vue ------ 轨迹面板模板(节选) -->
<div v-if="msg.trace?.length" class="trace-panel" :class="{ open: traceOpen(idx, msg) }">
  <button class="trace-head" @click="toggleTrace(idx, msg)">
    <span>执行轨迹 · {{ msg.trace.length }} 步</span>
    <span v-if="msg.usage" class="trace-usage">
      tokens {{ msg.usage.inputTokens }} + {{ msg.usage.outputTokens }}</span>
  </button>
  <div v-show="traceOpen(idx, msg)" class="trace-body">
    <!-- 思考行:紫色标签 + 块级耗时 + 暗色滚动区 -->
    <div v-if="t.kind === 'thinking'" class="trace-thinking">
      <span class="trace-tag">思考</span>
      <span class="think-elapsed">{{ thinkElapsed(t) }}</span>
      <div class="thinking-text">{{ t.text }}<span class="cursor">▌</span></div>
    </div>
    <!-- 工具行:名称 + 入参 k=v + 状态/耗时 + 结果区 -->
    <div v-else class="trace-tool"
         :class="{ running: t.phase === 'start', failed: t.state === 'ERROR' }">
      <span class="trace-tag tool">工具</span>
      <span class="trace-tool-name">{{ toolName(t.name) }}</span>
      <span class="trace-args">{{ argsPreview(t.args) }}</span>
      <span class="meta-state">{{ t.state }}</span>
      <span class="meta-elapsed">{{ toolElapsed(t) }}</span>
      <div v-if="t.result" class="trace-result">{{ t.result }}</div>
    </div>
  </div>
</div>
4.3 交互与工程细节
几个不显眼但都在防真实事故的细节:
- 展开策略 :流式期间默认展开(实时看着轨迹长出来),答完自动收起,用户手动点过之后手动优先------
traceExpanded[idx] ?? !!msg.streaming,一行实现三种态; - 入参预览 (
argsPreview):完整 JSON 解析成k=v串、长值截 48 字;流式中半截 JSON 解析失败则原样截断 120 字------流式与终态共用一个函数,两种形态都好看; TRACE_TEXT_CAP = 2000:思考流/入参/结果的聚合文本一律截 2000 字符。这不是为了好看------localStorage 持久化是面板的硬需求(刷新页面轨迹不丢),而 945 帧思考流不截断能把配额撑爆。展示上 2000 字也够了,长思考本来就是滚动区;- 旧消息兼容 :localStorage 里改造前的历史消息没有
trace字段,模板用v-else-if走旧标签条渲染------升级面板不破相历史消息,这是"渲染模型演进"最容易被忘的一步。
5. 呈现层 B:生成统计行------第二个消费场景
面板上线几天后,来了一个新需求(用户原话):"我想知道每次对话生成多少字,烧了多少 token......模型思考也需要体现出来" ------四个要素:思考时长、总耗时、字数、token ,一行小灰字挂在回复下方(Qoder 风格):思考 0.3s · 8.3s · 63 字 · 15693 tokens。
5.1 零后端改动:协议先行铺好,UI 后到
这次需求的实现成本是一次纯粹的复利兑现 :四要素的数据,thinking 帧、usage 帧在做面板时就已经在通道里流了------统计行只是把已到达前端却被丢弃的数据接上展示,后端一行未动:
| 要素 | 数据来源 | 实现动作 |
|---|---|---|
| 总耗时 | send() 起点到 finally 定格 |
前端记时 |
| 字数 | content.length 现算 |
一行 |
| token | usage 帧累加(§3 协议原样复用) | 一行 |
| 思考时长 | thinking 块 startTs/endTs 采样 |
见 5.2,唯一有讲究的 |
协议建设的复利在第二个消费者身上兑现。 面板落地时把八类帧一次铺完,看似"超前建设"(当时 thinking/usage 帧没有消费者),统计行需求到来时边际成本只剩排版。反过来,如果当时只透出最小集,这个需求就得重新动后端、重启、重新联调------通道建设的正确姿势是按数据全貌建,不是按当下需求建。
5.2 思考时长的「错位采样」
四要素里唯一有讲究的是思考时长。难题:ThinkingBlockDeltaEvent 只有增量文本,没有"思考结束"信号 ------帧协议里不存在 thinking_end。
解法是错位采样:用"下一个非 thinking 帧到达"作为思考结束的证据------模型开始说话或调工具了,思考必然已结束:
typescript
// ChatView.vue ------ 「错位采样」:思考没有结束帧,用下一个非 thinking 帧兜
function closeActiveThinking(reply: ChatMessage) {
  for (const t of reply.trace ?? []) {
    if (t.kind === 'thinking' && t.startTs && !t.endTs) {
      t.endTs = Date.now()   // 所有未闭合思考块,此刻定格
    }
  }
}

// 思考总时长 = 全部思考块计时之和(ReAct 每轮一个块,blockId 区分)
function thinkMsOf(msg: ChatMessage): number {
  let sum = 0
  for (const t of msg.trace ?? []) {
    if (t.kind === 'thinking' && t.startTs) {
      sum += (t.endTs ?? Date.now()) - t.startTs
    }
  }
  return sum
}「错位」的含义要说透:endTs 记录的不是模型内部思考结束的精确时刻,而是"前端收到思考结束证据的时刻"------两者之间隔着网络抖动和帧调度,毫秒级误差。对展示用途完全够(人对 0.3s 和 0.31s 无感),对计费用途不够(要跟模型方对账就得后端权威时间)。所以这里有个明确的取舍记录:
计时精度要与用途对齐,不为用不到的精度付协议改造成本。
顺带一个白送的效果:流式中耗时随帧到达实时跳动(每帧触发 Vue 重渲染,thinkElapsed 里 endTs ?? Date.now() 让未闭合块一直"活"着)------统计行在生成过程中是个活的秒表,答完在 finally 定格。这个动效一行代码没写,是响应式渲染的自然结果。
5.3 顺带修掉一个盲区
统计行上线时顺带修复了一个真实盲区:纯对话场景(零工具调用)token 完全不可见。
原设计里 token 账单只挂在轨迹面板折叠条头部------但纯对话没有轨迹,面板整个不渲染,token 就消失了。问题出在:面板的出现条件是"有 trace",而 usage 数据不依赖 trace 存在 ------同一批帧的两个消费者,不该共享同一个出现条件。统计行独立渲染(v-if="msg.stats || msg.usage"),盲区顺手修掉。
6. 测试案例
6.1 案例一:帧协议全命中实测
方法 :8093 起临时实例(--server.port=8093,连同一 PG,对 8092 零打扰),发一条真实对话:"我的技术栈里 Java 掌握到什么程度",curl 收完整 SSE 流逐帧统计(共 3316 行):
| 帧类型 | 实测帧数 | 读数含义 |
|---|---|---|
thinking |
945 | 思考流密度远超预期------qwen3.8-omni-flash 思考块逐字流式 |
token |
599 | 正文 |
tool_args |
79 | 入参增量片段(9 次调用的参数流总和) |
tool_result |
9 | 每次工具一条结果流 |
tool |
18 | 9 次 start + 9 次 end,精确配对 |
usage |
7 | 7 轮模型调用 = 7 张账单 |
done / error |
1 / 0 | 正常收尾,全程无 error 帧 |
结论 :四类新帧全部真实命中(DashScope 链路确实发射全家桶,§2 的翻案不是纸面推断);旧协议消费者不受新帧干扰;tool 18 = 9×2 精确配对说明 toolCallId 聚合协议成立。
6.2 案例二:9 次空转------首个可观测发现
这条实测顺带抓到了面板上线的第一笔可观测红利。
翻看轨迹:模型连调 9 次 queryTechStack ,全部落空(技术栈台账还没有数据);7 帧 usage 显示每轮 input tokens 从 15.6K 一路涨到 15.9K------每轮模型调用都背着之前所有工具结果;最后模型诚实告知台账为空,并提议走管理端点补录。
三层数字互相印证出一个完整故事:结果正确(诚实告知)+ 过程低效(9 次空转、7 轮模型调用) 。这件事以前埋在服务端日志里,现在面板上一眼可见------正是 §1 说的:结果没错 ≠ 过程没浪费。9 次空转后来成了"该不该在工具 description 里写明'台账可能为空'"的讨论起点,也是编排阶梯 2(撞墙取证)的第一份候选素材。
6.3 案例三:两个消费者互证 + localStorage 注入测试法
统计行上线后的验证分两层:
第一层,口径互证 :面板折叠条显示 tokens 15630 + 63,统计行显示 15693 tokens------同一批 usage 帧喂出的两个数字,加法吻合(15630 + 63 = 15693)。两个消费者互为对方的测试用例,这是"一套协议多个消费者"架构送的免费测试。
第二层,离线 UI 验证 :后端不可起时用 localStorage 注入 + 真实渲染代码路径 ------把带 trace/stats/usage 的消息 JSON 直接写进 heartnet.chatMessages 键再刷新页面,统计行和面板照常渲染。注入的是数据不是伪造图像,走的是完全真实的渲染代码路径------比截图靠谱,比等后端快。
6.4 案例四:上线当晚的第三个实锤------64K 上下文雪球
面板 + 统计行上线当晚,日常使用中就抓到了第三个实锤(现场截图):
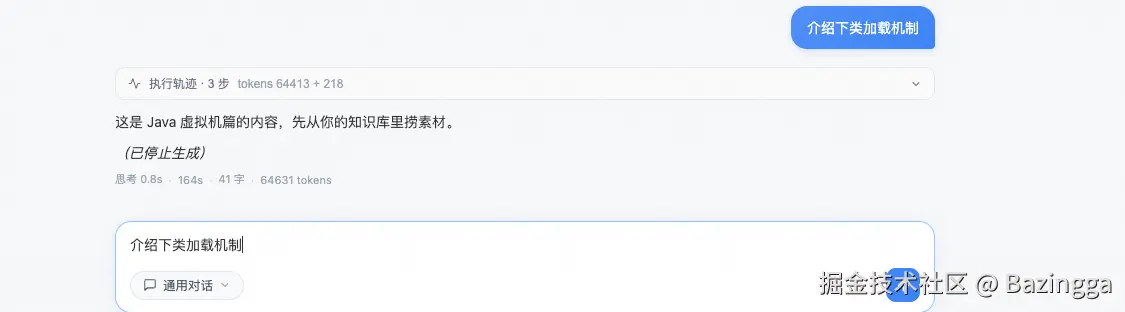
用户在多轮旧会话里问"介绍下类加载机制",统计行定格出这组数字:
| 观测项 | 数值 | 读法 |
|---|---|---|
| tokens | 64413 + 218 | input 累计 64K / output 仅 218------钱花在"读"不在"写" |
| 总耗时 | 164s | 远超正常(新会话 7 轮 90s 内完成) |
| 思考 | 0.8s | 第一轮思考很快------模型没死,是 input 太重 |
| 字数 | 41 字 | 开场白秒出,随后长等待 |
| 执行轨迹 | 3 步 | 工具正常推进------不是卡在工具 |
| 终态 | 用户点停 | AbortSignal 正常工作,非系统挂死 |
六个数字合起来完成了一次纯观测层的归因排除法 :不是模型死(思考 0.8s)、不是工具慢(3 步正常推进)、不是生成慢(output 只有 218)------嫌疑高度集中在 64K input 的 prefill 耗时 。对照新会话底座(系统提示词 + 工具 schema + MEMORY.md ≈ 15.6K),本会话 input 是底座的 4 倍+:会话历史 + 每轮工具结果全量驻留,input 逐轮滚动成雪球。
这个案例的完整归因(会话记忆回带机制、检索结果驻留形态)是另一篇文档的课题,这里只强调一点:没有统计行和面板,这个现象的形态只是"好像有点慢" ------用户抱怨一句,开发者茫然排查;有了它们,现象直接定格成六个可复算的数字,归因还没开始,排除法已经做完了大半。这就是可观测的价值兑现方式:不是让问题消失,是让问题在第一时间以可分析的姿态出现。
7. 踩坑实录
当天落地过程中踩了三个坑,都有普适性:
坑一:mvn spring-boot:run 报 UnsupportedClassVersionException 。报错说 RunMojo 类文件版本 61.0(Java 17+),而 shell 的 mvn 跑在 Java 8 上。迷惑性在于 mvn compile 一直是过的 ------因为 IDEA 已经编译过,compile goal 走缓存显示 "Nothing to compile";run goal 才真正加载 mojo 类。教训:compile 绿不代表 run 能起,两个 goal 的类加载路径不同 。解法:命令前缀 JAVA_HOME=$(/usr/libexec/java_home -v 24)(本机无 JDK 21,24 向后兼容 21 字节码)。
坑二:幽灵构建撞车 。同步静态资源到 target/classes/static 后,页面引用了一个新 hash 的入口 bundle,但配套的 ChatView chunk 没在目录里 ------404 主模块。取证发现:用户终端 11:30 起挂着的 npm run dev 在 16:16 触发过一次完整 build,和手动 cp -R 撞车,拷进去的 index.html 是 dev 系构建的、chunk 却是旧的。教训:同步产物前 ps 确认无并发构建;同步后做一致性校验(index.html 引用的每个 hash 文件都存在且能被服务)。
坑三:bundle 验证 grep 错地方 。验证面板代码进没进 bundle 时,grep 入口 index-*.js 找不到 trace-panel------差点误判"没构建进去"。真相是 Vue Router 懒加载把视图代码拆进了 ChatView-*.js chunk,入口里根本没有。教训:验证功能进 bundle,要 grep 对应视图的 chunk 文件,不是入口文件。
8. 结语:一条协议,三个消费场景
回看这次改造的产出结构,最有价值的不是面板也不是统计行,而是中间那条帧协议:
| 消费场景 | 看什么 | 抓到的实锤 |
|---|---|---|
| §4 执行轨迹面板 | 过程时间线 | 9 次空转------看得见浪费 |
| §5 生成统计行 | 结果账单 | 纯对话 token 盲区------看得见成本 |
| §6.4(下一个消费者) | 上下文体量 | 64K 雪球------看得见膨胀 |
三个消费场景、三个实锤,全部来自同一条协议、同一批帧。而第三个消费者(会话上下文的量化归因)现在才刚开场------它需要的 usage 逐轮数据、轨迹的步骤数据,协议里早就有了。
可观测建设不是"加个监控页面",是修一条数据公路------路修通了,消费者会一个一个自己长出来。
而修路的第一块砖,永远是数据层那句朴素的问话:这个数据,存在吗?------问之前,先把包里的类全枚举一遍。