上一篇 (04) TP-Link 路由器我们接上了第二路数据源------路由器告诉我所有联网设备。但 04 篇结尾留了一个问题:
路由器能看到"在网"的设备,但 DHCP 过期后没续约的、从来没连过路由器的、挂在 DMZ 自己跑公网 IP 的------这些设备路由器也看不见。
这些正是攻击者最爱藏的地方。"影子资产 + 公网暴露面"------这是任何一个"基本安全"都没做的中小公司最真实的盲区。
这一篇收掉"零 agent 接入"主题的最后一环。看完三篇你就有完整的视野:
- Wazuh(03)------ 装了 agent 的主机上发生什么;
- TP-Link(04)------ DHCP 在线设备在干什么;
- Nmap (本篇)------ **其他都看不见的,**包括影子设备和公网暴露面。
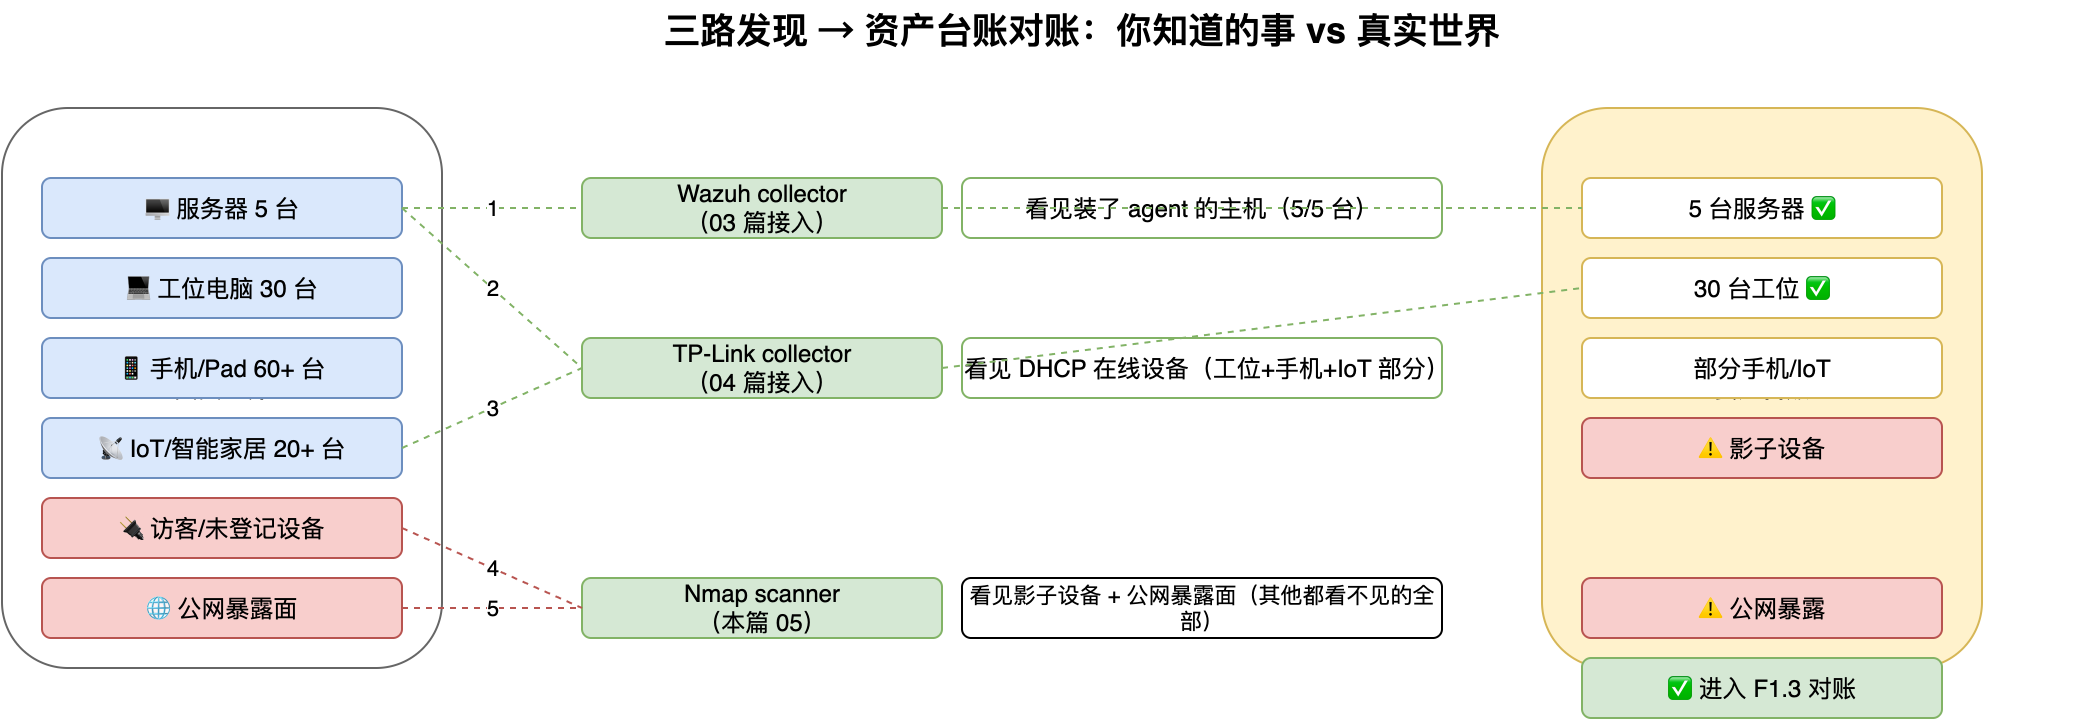
💡 关键洞察 :三路数据几乎零重叠、缺一不可 。前两路是"被动数据流"(等数据上门),本篇是"主动探测"(自己去发现)------结构上完全不一样。所以本篇讲的也是一套新范式,不是 Wazuh 那套的简单复制。
为什么要做"控制面 + 数据面"分离?
直接说原因------不绕弯子。Wazuh 那种"装个 agent 推到 server"的模式在攻击面扫描场景下行不通:
| 问题 | Wazuh 模式 | Nmap 模式 |
|---|---|---|
| 任务谁来定 | Agent 自顾自推 | 你要"现在扫一下 192.168.0.55",谁发起? |
| 多台扫描器怎么协调 | 各自为政 | 三台扫描器在三个子网,谁扫哪? |
| 扫描器宕机谁通知 | 没有 | 192.168.0.45 这台 Kali 死了一周你都不知道 |
| 取消正在跑的扫描 | 杀进程 | 控制台点"取消"要能传到执行端 |
结论 :所有任务的"创建/调度/审计"都得上提到 AI-miniSOC 这个控制面;扫描器(数据面)只做"心跳+拉任务+跑 nmap+推结果"四件套。
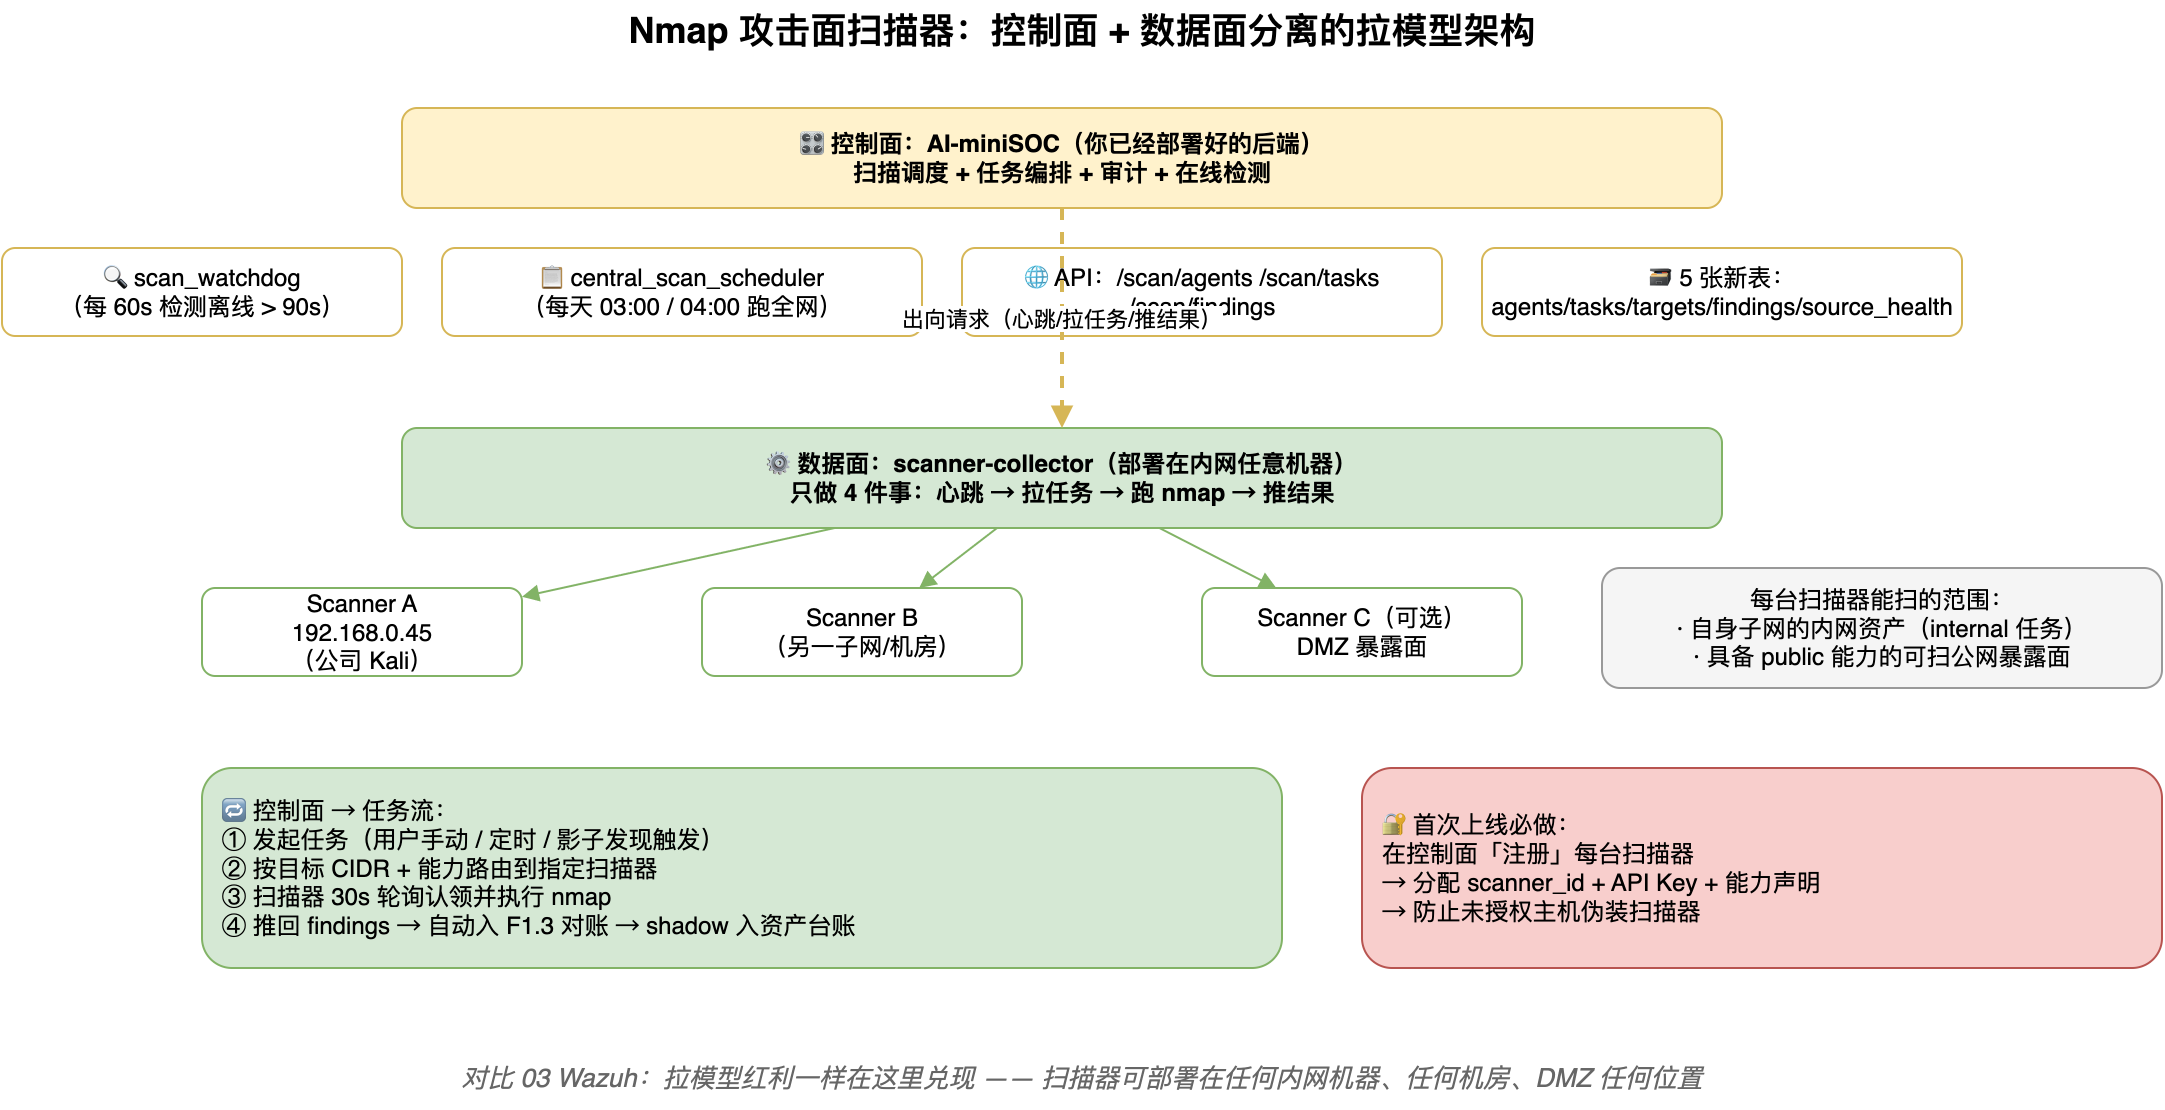
这套架构沿用了 01 篇的"拉模型"红利------扫描器可部署在任何内网机器、任何机房、DMZ 任何位置,只用出向连接,零端口映射、零新增攻击面。
第 0 步:扫描器放哪?
先决定一个关键问题:你的第一台扫描器放哪里?三种典型选择:
| 选项 | 适用场景 | 优势 |
|---|---|---|
| 公司内网 Kali/运维机 | 中小公司本地 | 网络可达性能好,可扫所有内网段 |
| DMZ 区 | 有公网资产 | 出口方向直接探测公网暴露面 |
| 云上 VPC 内 | 资产主要在云上 | 与目标网络低延迟 |
老李的选择:把扫描器直接装在他的 2019 年旧服务器(Kali 系统)上------反正 8G 内存闲着也是闲着。生产部署文档里默认是 192.168.0.45(Kali Linux),可以照搬。
💡 起步建议:先一台就够。后期多子网再扩------控制面会自动按 CIDR 路由到合适的扫描器。
第 1 步:装扫描器本体(5 分钟)
回到 02 篇部署的根目录,采集器层已经设计好 scanner-collector 容器,只是没启用。把它拉起来:
bash
cd src/collectors
cat docker-compose.yaml | grep -A 3 scanner-collector   # 确认 service 定义存在
把扫描器凭据写到采集器专属 .env(不是后端那个 .env):
bash
# src/collectors/.env
SCANNER_ID=<待会在控制台生成>
SCANNER_API_KEY=<控制面给的一长串>
MINISOC_API_URL=http://<ai-minisoc-server>:8000
关键:这里的 SCANNER_ID 和 SCANNER_API_KEY 现在还不知道------它们要先去控制面"注册"才能拿到。继续看第 2 步。
第 2 步:去控制面"注册"扫描器(5 分钟)
Wazuh 的 agent 不需要"注册"------装上自动注册成功。但扫描器必须显式注册 ------因为它做的事(端口扫描)比日志收集敏感得多 。如果未授权主机能伪装成扫描器向你的 SOC 推"扫描结果",等于在攻击面上主动告诉你内部网络布局。
"资产扫描" → 选"扫描器":
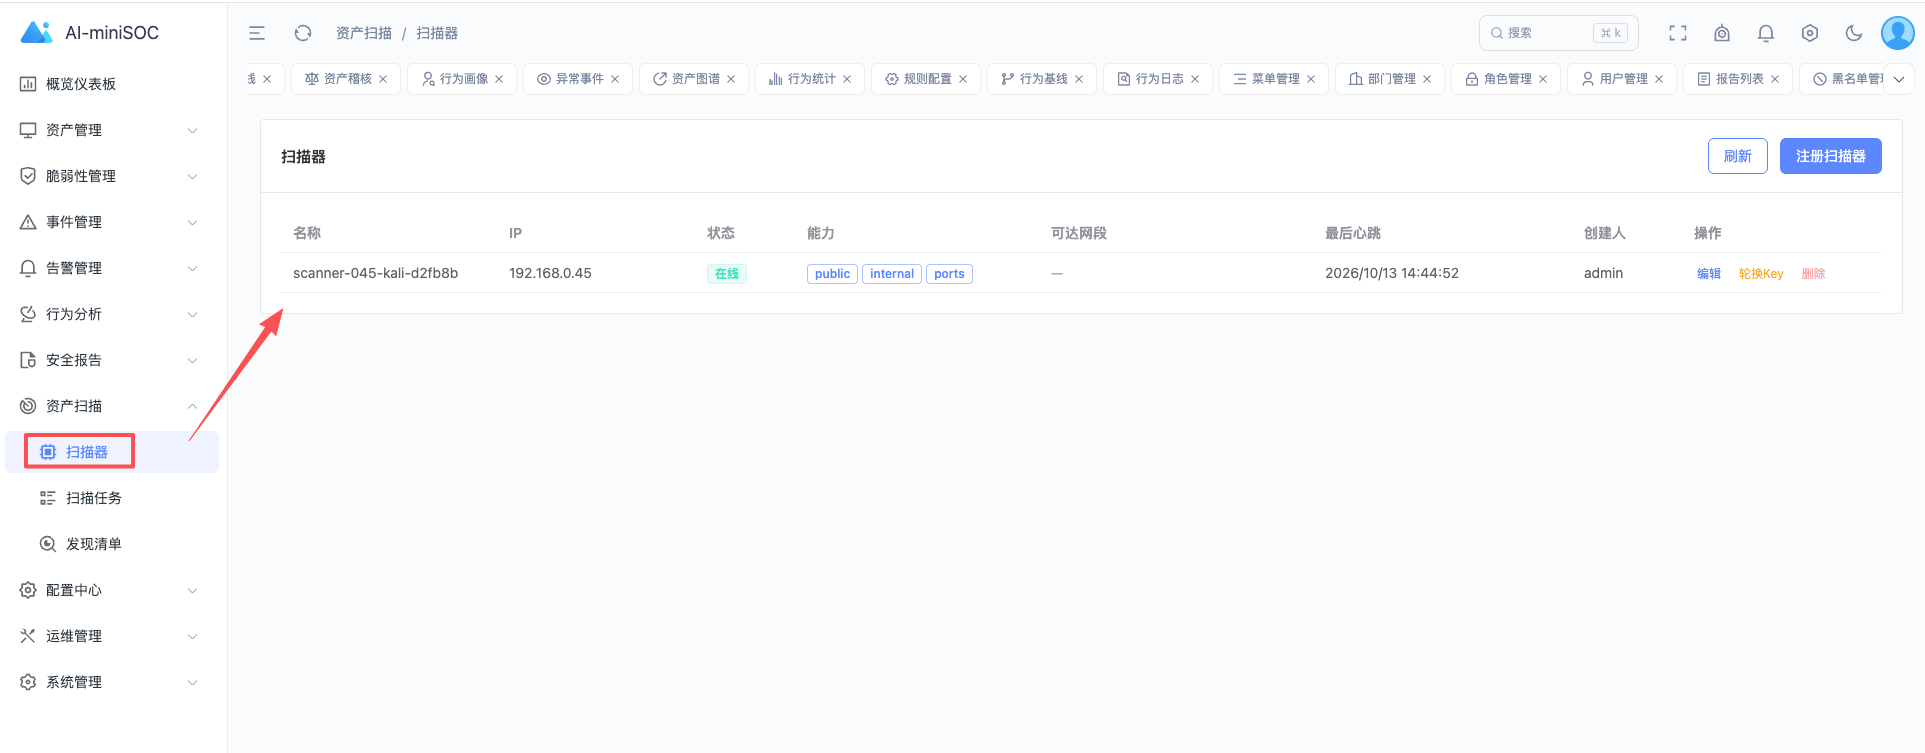
注册时三件事要填:
- scanner_id (自取)------给这台机器起个唯一名字,比如
kali-office; - 能力声明 ------勾选它能做什么(
internal内网扫描?public公网扫描?); - 可达子网 ------
reachable_subnets=192.168.0.0/24,10.0.0.0/8,控制面会按这个自动派发任务。
注册成功后,控制面会给你一个 API Key ------这就是 SCANNER_API_KEY。把它写回第 1 步的 .env,然后启动:
bash
docker compose up -d scanner-collector
docker compose logs -f scanner-collector
过关标准 :日志里出现 registered to control plane as scanner_id=kali-office,且控制面"扫描器列表"里这一行从 offline 变 online。
🕳️ 坑 #1 :Nmap 在 Docker 容器里默认是没有原始套接字 的------SYN 扫描会退化成 connect 扫描(慢 10 倍以上)。解法 :容器以
NET_RAWcapability 启动,且--cap-add=NET_RAW。docker-compose.yaml里已经预设好,但如果你是手动起的容器,记得加上。
第 3 步:发起第一次扫描(2 分钟)
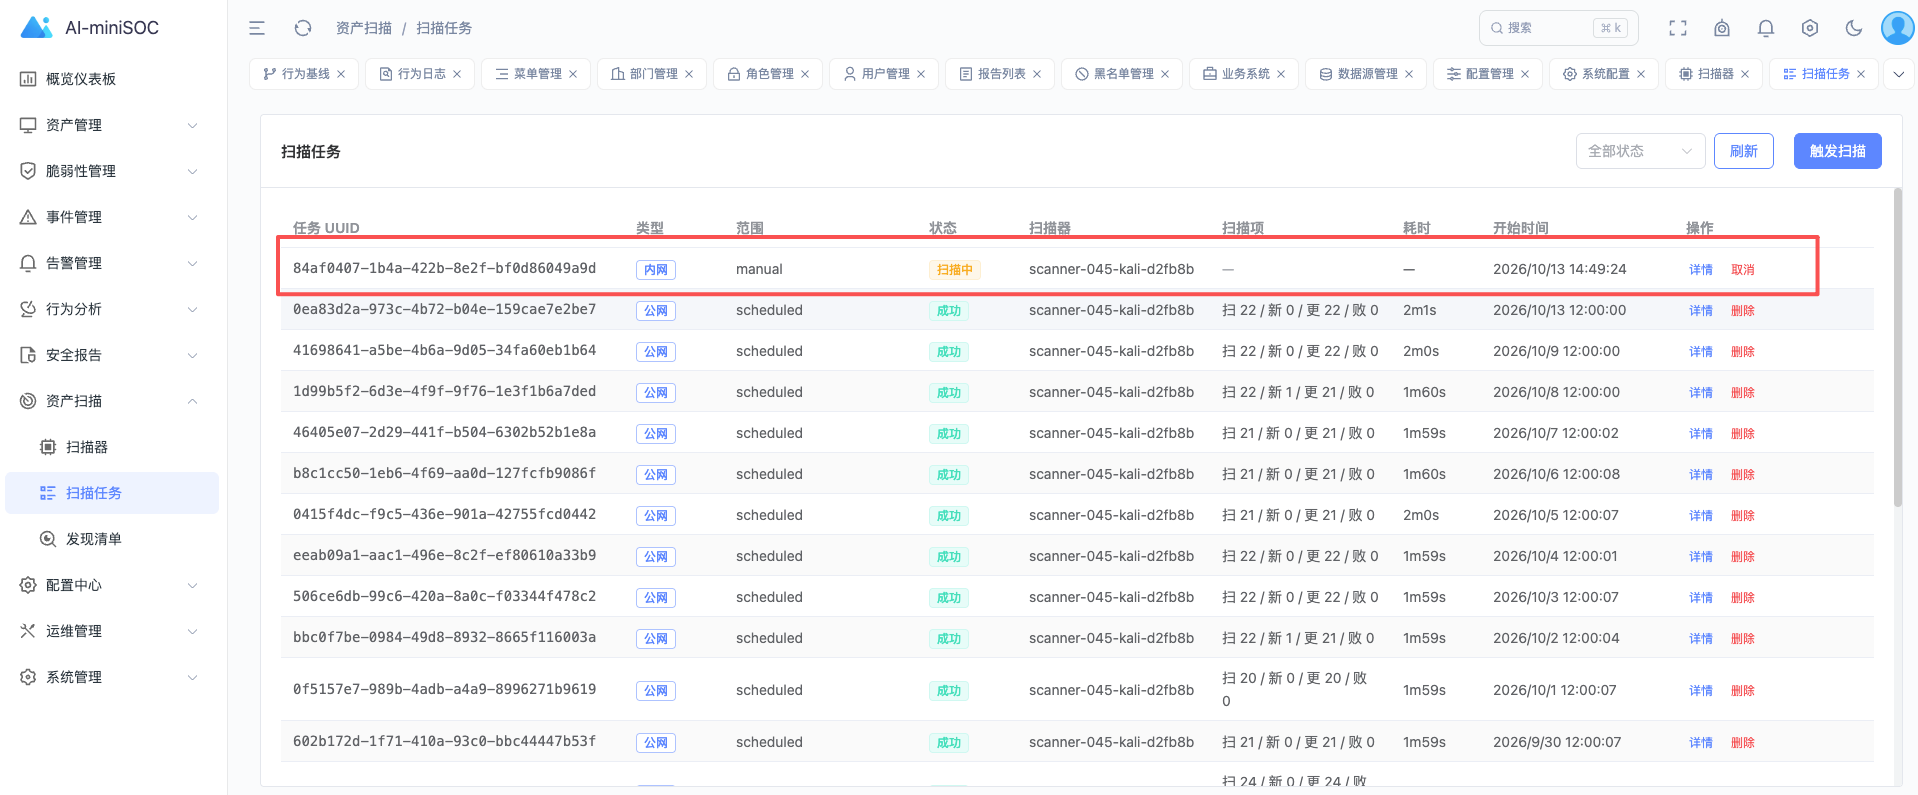
控制面在线检测到你的扫描器后,UI 上就会出现"扫描器已上线"的提示。点进"扫描任务"页:
新建扫描任务
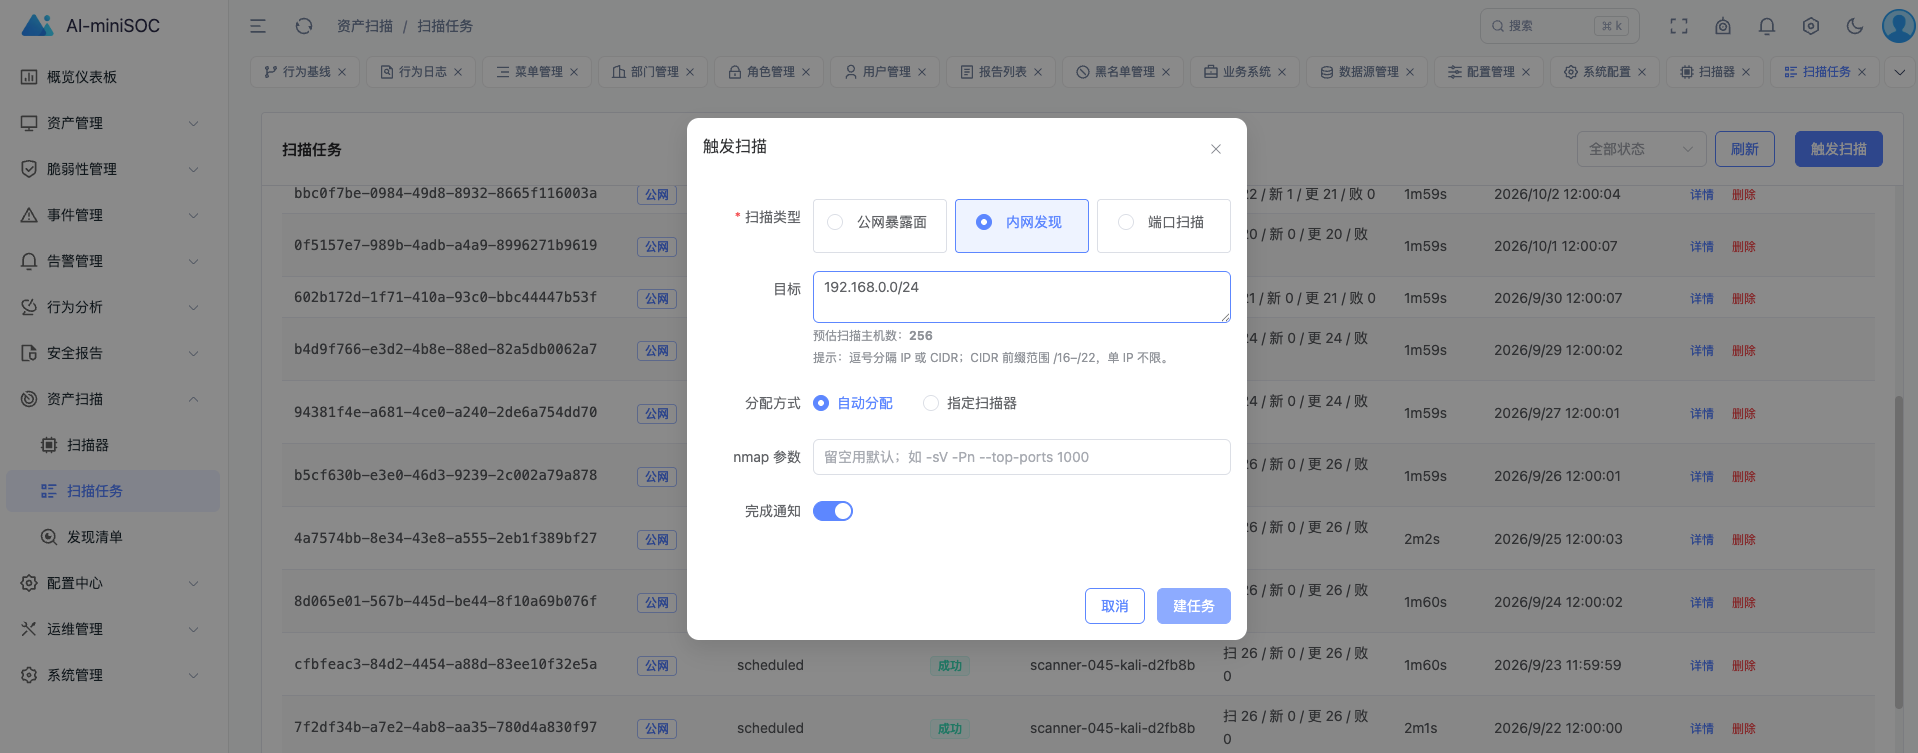
自动分配扫描器开始扫描
扫描完成后返回扫描结果
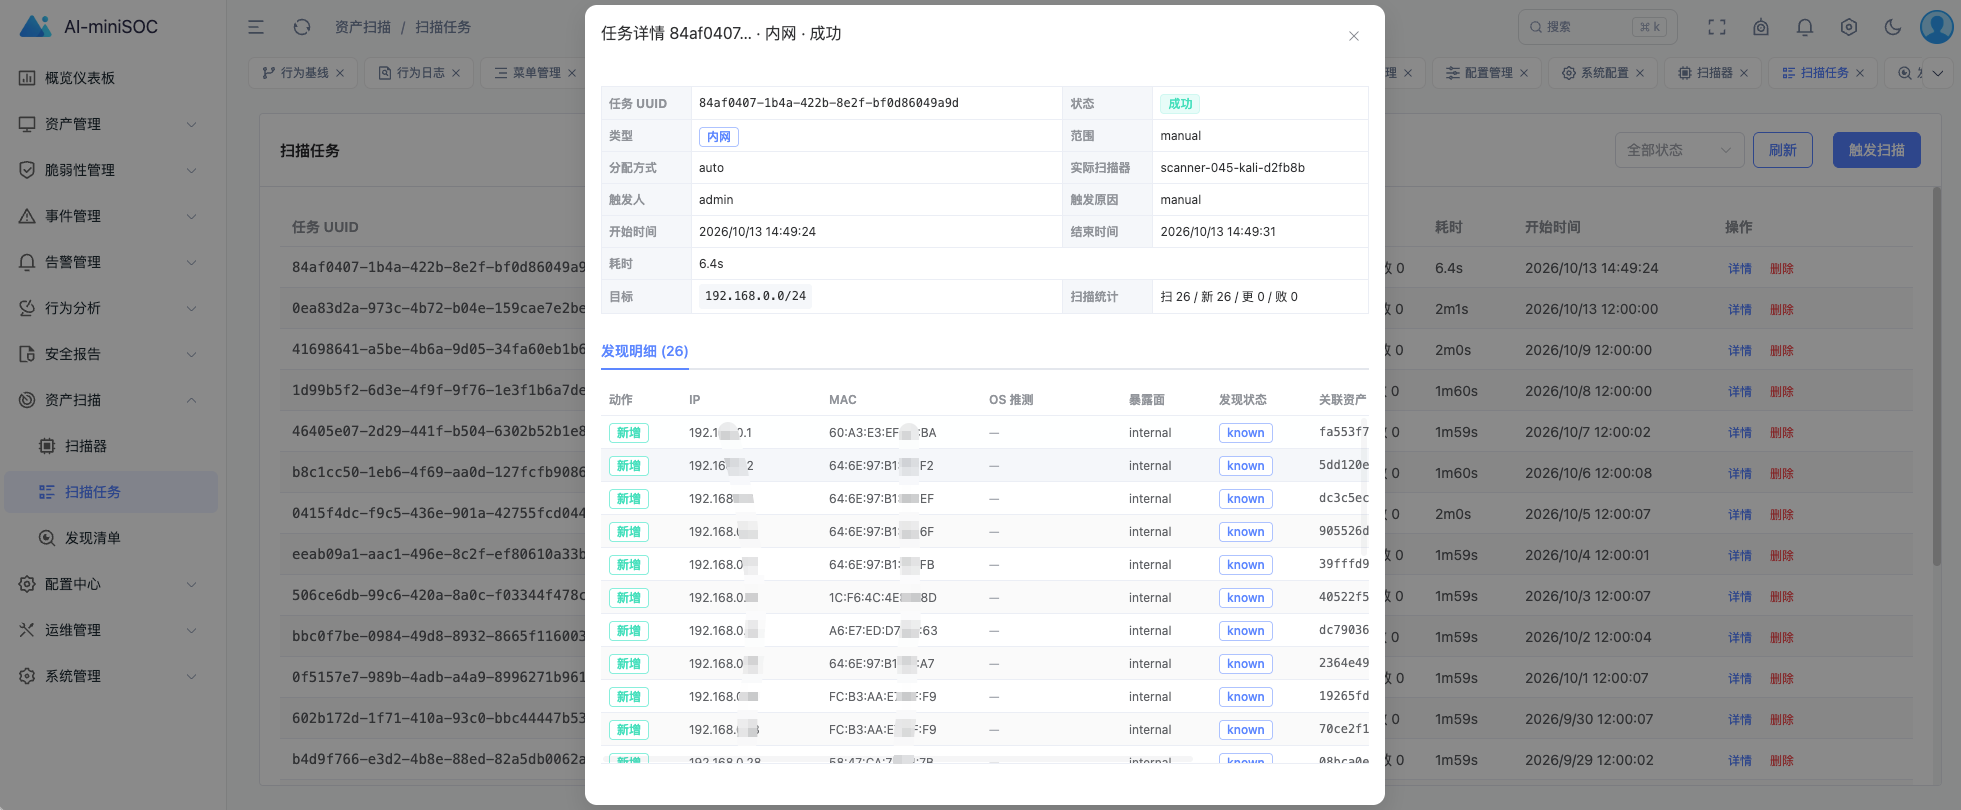
第一次建议这样填:
- 目标 :填你办公室子网,比如
192.168.0.0/24(先拿自己的小网络练手); - 模式 :选
standard(端口 + 服务识别,平衡速度与精度); - 指定扫描器 :自动(控制面按 CIDR 匹配
reachable_subnets派单); - 备注 :
首次启动 摸底------ 这个备注会写进soc_audit_logs,未来回看知道为什么扫。
提交后任务进入 pending 状态。大约 30 秒后 (下次扫描器轮询),任务状态变成 running,扫描器开始跑 nmap。
过关标准 :30 秒后控制面"任务列表"里这条变成 running 或 success。
第 4 步:看回推的发现(10 分钟后看)
nmap 跑完(按你选的目标规模几分钟到十几分钟),扫描器会主动推回 soc_scan_findings 表。
"资产扫描" → "发现列表":
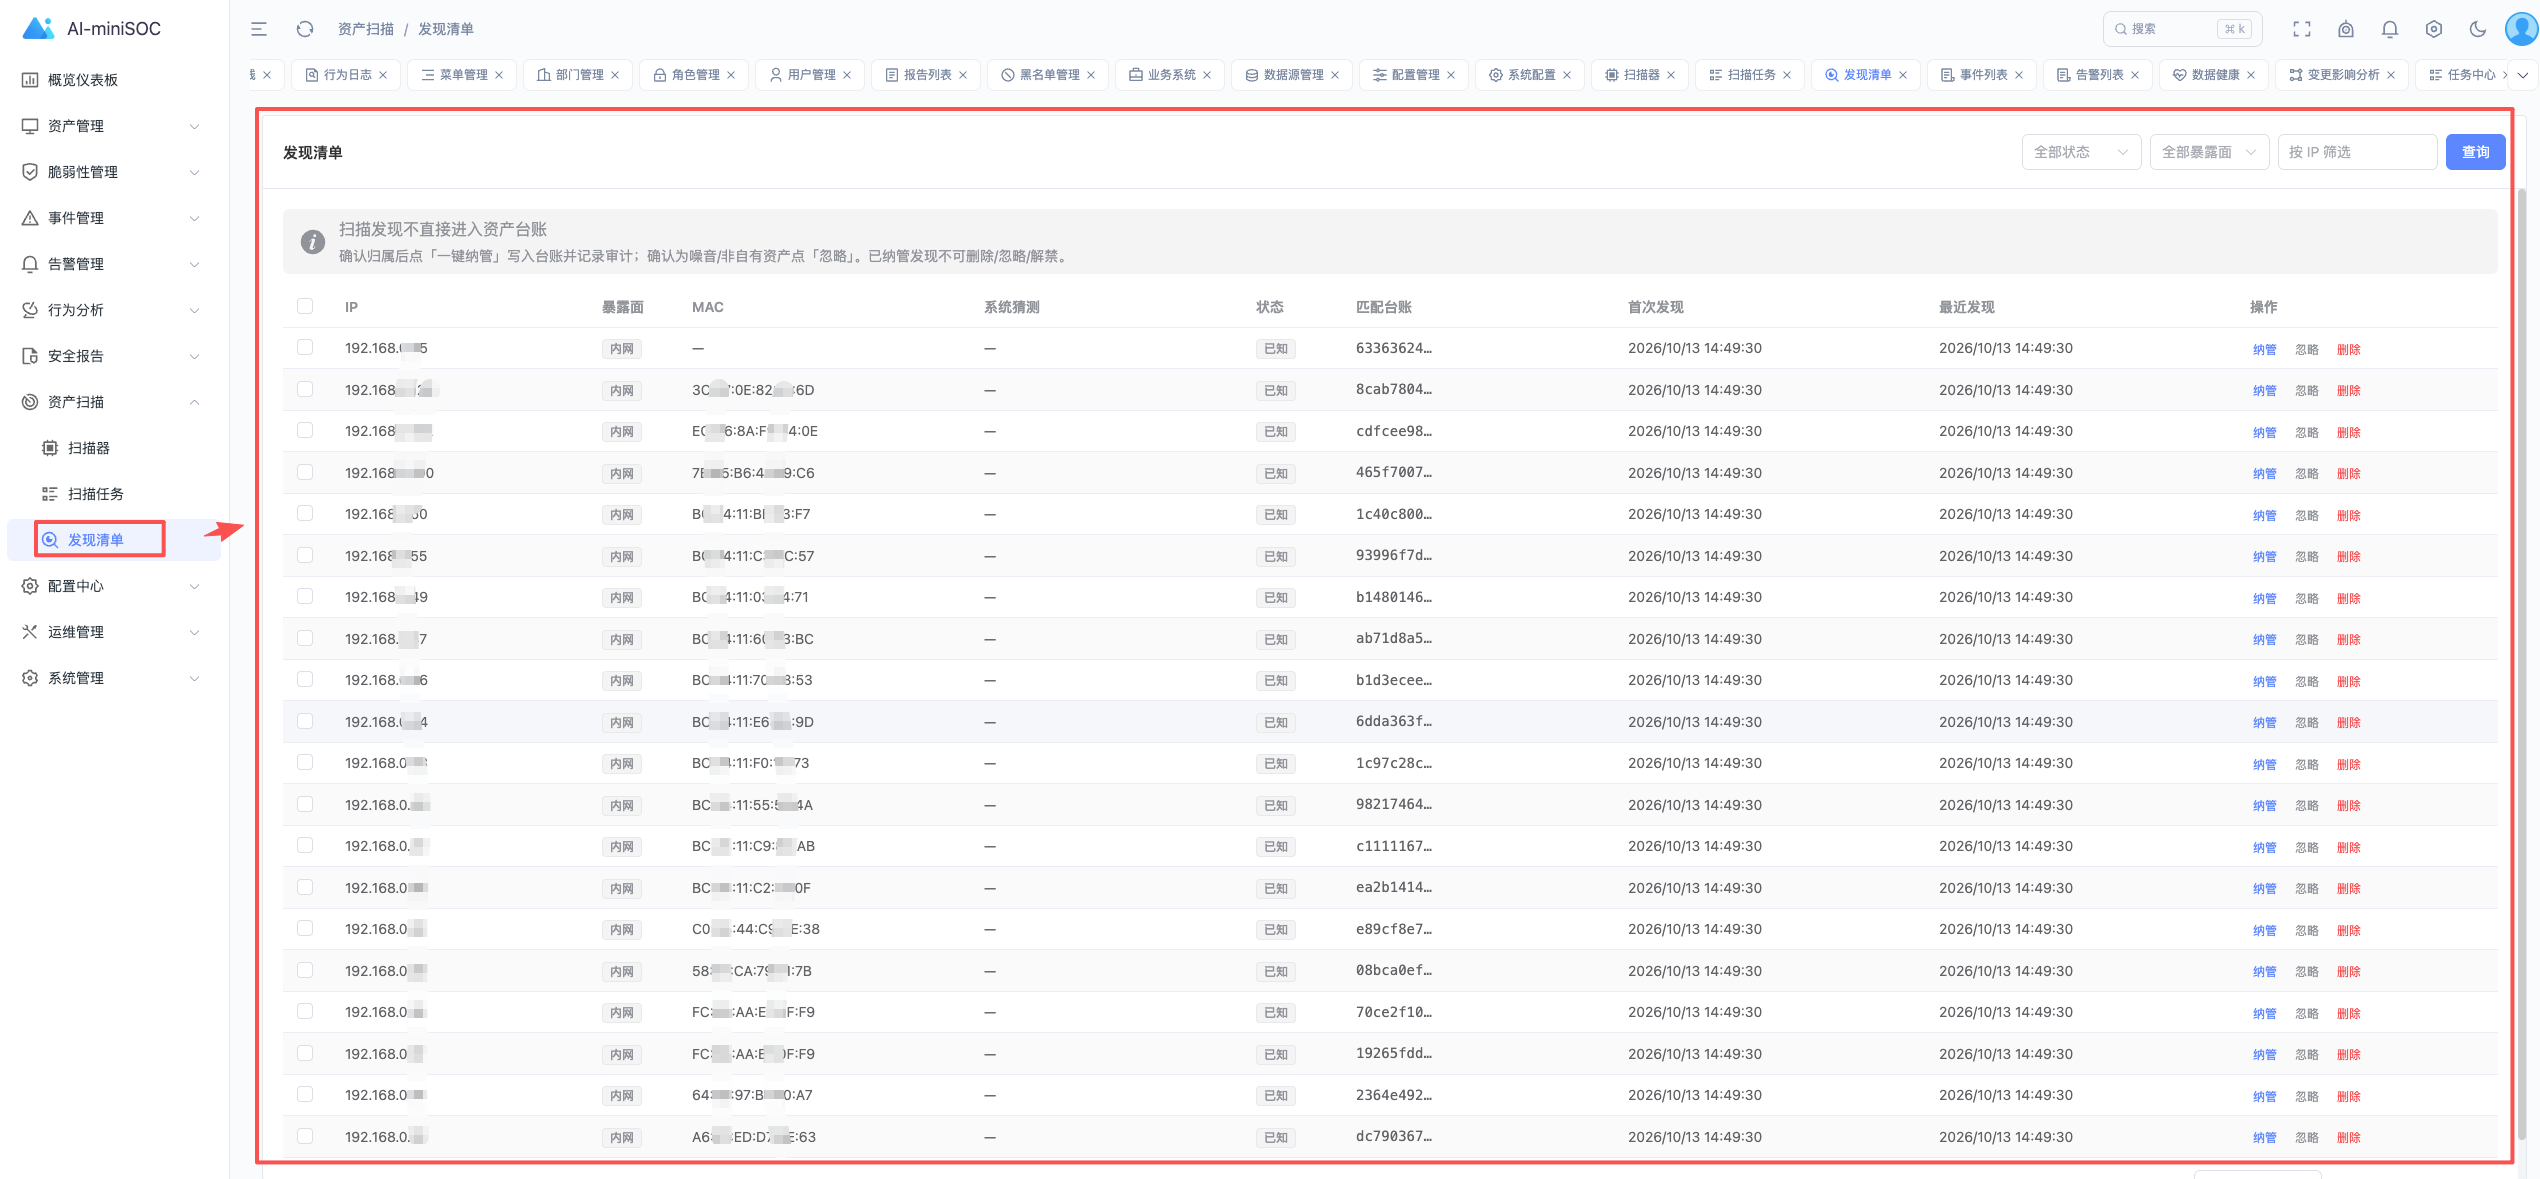
你会看到三类东西第一次出现在你的 SOC 里:
- 影子设备------Wazuh 不知道、TP-Link 也漏了,但 nmap 主动 ping 到了的设备;
- 公网暴露面 ------标记
exposure_level=public的资产,nmap 会扫它的公网端口; - 服务版本 ------Nmap
-sV输出,比如OpenSSH 9.6p1 Ubuntu 3ubuntu13.5------为下一步的脆弱性管理提供输入。
🕳️ 坑 #2(血的教训) :Nmap 的
-sV会主动向目标服务发特征探测包 ,有些老设备(打印机、摄像头)会假死或重启 。解法 :默认走version-intensity 5(中等强度),第一次扫描全网时避开 22:00-08:00 ------尤其是生产环境第一次跑全网扫描前,先发个全员公告。
第 5 步:把影子设备纳管进资产台账
nmap 发现的设备还不在 soc_assets 里------这是有意识的设计 。原因:扫描器只负责"发现",要不要纳入管理是人的决定(可能是一次性测试设备、可能是邻居蹭网的)。
控制面"发现列表"里每行右侧有"一键纳管"按钮:
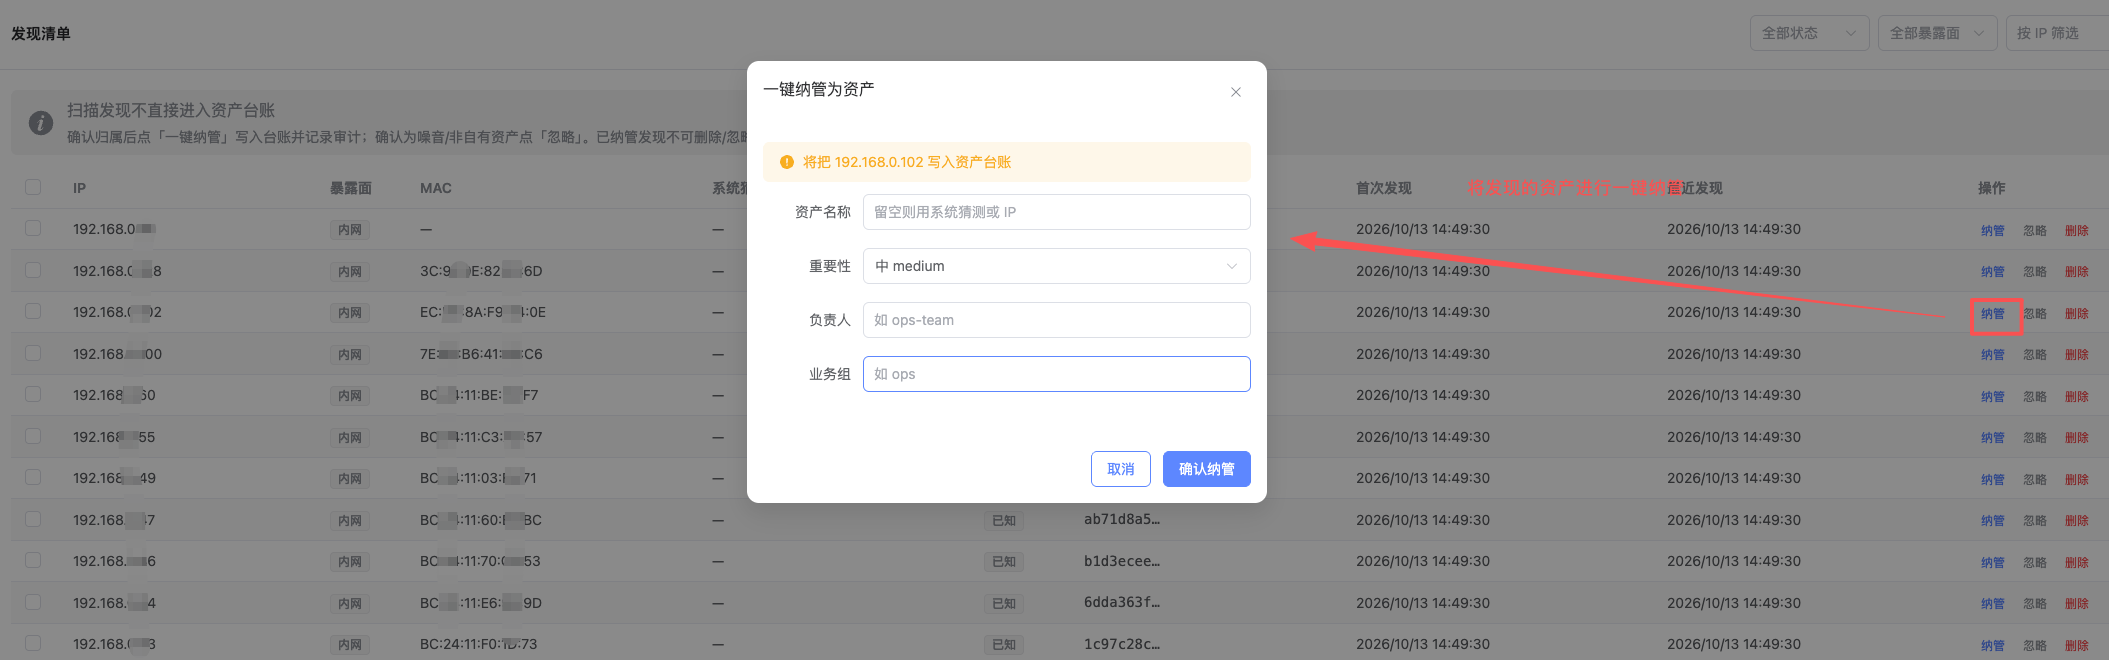
点击后,系统会:
- 写入
soc_assets(来源标scanner,不再被 F1.3 误判为影子); - 自动跑 F1.3 资产对账(下一篇 (06) 展开)------已纳管设备就此闭合;
- 还没纳管的 保持
pending状态------F4.2 会发"影子资产发现"通知给你。
这个"先发现再决定是否纳管"的设计是关键。直接扫到就入台账,迟早会因为"误纳管"或"网络抖动"产生一堆噪声。
怎么把它用成"自动化的"?
前三步是手动模式(每次创建任务)。两个自动化场景是常态:
场景 A:每天凌晨全网扫描 ------已经默认开 central_scan_scheduler:
# 服务启动时自动注册的定时任务
每天 03:00 → 全网 internal 任务派给所有 scanner
每天 04:00 → 公网 exposure_level=public 资产扫描跑一周下来你就有全网资产基线------这一周发现的影子设备逐一过一遍"要不要纳管",后面告警就安静了。
场景 B:单 IP 影子发现后自动重扫 ------F1.3 资产对账发现某 IP 是 shadow 状态时,自动派一个针对该 IP 的 quick 扫描到可达子网的 scanner,确认它到底跑什么服务。一键开过这个规则后,整个过程无人值守。
收尾:常见问题
Q:扫描器要 root/管理员权限吗?
A:是的 。Nmap 的 SYN 扫描需要原始套接字。容器需要 NET_RAW capability(已在 compose 文件里写好),或直接用 --network=host 模式(更简单但牺牲隔离性)。
Q:扫多久?扫一次能看什么?
A:取决于你选什么模式:
quick(默认):nmap -T4 -F------ 100 端口/主机,约 5-10 秒/台;standard:nmap -T4 -sV --top-ports 1000------ 1000 端口+服务识别,约 30-60 秒/台;full:nmap -T4 -p- -sV------ 65535 全端口,单台几分钟 ,别对全网段开 full。
Q:能扫到 NAT 后面的设备吗?
A:直接扫不行 (NAT 会阻断主动探测)。但你可以把 scanner 部署到 NAT 内侧(每个 NAT 网段一台),或对 NAT 网关做端口映射(不推荐,新增攻击面)。
Q:和 Wazuh agent 撞了怎么办?
A:不撞 。Wazuh 推到后端的是 agent 的实时日志;Nmap 推到后端的是"主机是否在线/开什么端口"这种周期性状态 。两者数据维度完全不同。影子设备入资产表后可以同时被两者覆盖------IP 一致就是同一台。
Q:发现了公网暴露的 22 端口(SSH)怎么办?
A:这是最有价值的发现。处理流程:
- 是不是有意开放?业务系统可能合法开放;
- 不是→ 改端口或加 IP 白名单;
- 监控变更------F1.1 风险评分会给它高风险分(公网暴露 + 服务版本已知 = 攻击面大),F4.2 会主动推送。
写在最后
00→05 五篇,你现在的 SOC 已经具备了一个商业 SOC 80% 的能力:
| 能力 | 来源 | 篇目 |
|---|---|---|
| 看得见装了 agent 的主机 | Wazuh | 03 |
| 看得见所有联网设备 | TP-Link | 04 |
| 看得见所有设备的公网暴露面 + 影子设备 | Nmap | 05(本篇) |
剩下的 20% 是告警治理 + 报告输出 + 合规审计 ------这些是 14-18 篇的尾段。而 06-13 篇会回到"软件系统内部":怎么对账、怎么评分、怎么让 AI 真正帮你分析告警。
这一篇与 04、03 两篇一起,把"零 agent 接入"的三路数据源(Wazuh + TP-Link + Nmap)拼齐了------
从此你的 SOC 既能看见装了 agent 的服务器、也能看见没装 agent 的设备、还能主动找出"根本没人知道存在"的影子资产。
从下一篇 (06) 开始,进入"资产/审计"主题的内部精细化阶段。
你的 SOC 现在看得见整个世界。剩下的,是把看见的变成可治理的。
老李的 Kali 已经替他的网络跑了一周的基线扫描。你呢?
【系列导航】《一个人的SOC》总目录(持续更新)
【上一篇】 (04) TP-Link 路由器------用一台路由器做内网资产发现与上网行为审计
【系列开篇】 (00) 中小企业为什么需要自己的安全运营中心
【项目地址】 AI-miniSOC - GitHub · MIT 开源,欢迎 Star ⭐
https://github.com/xiejava1018/AI-miniSOC
同步gitee
https://gitee.com/xiejava/AI-miniSOC
【交流】 扫描器注册卡住了?把 docker compose logs scanner-collector 输出发 Issue,我会逐个回复。
下一篇(预告):(06) 资产对账------F1.3 影子/离线/不匹配三类差异稽核(连载中,敬请关注)