1 KV Cache 友好的上下文设计
1.1 KV Cache 基础直觉
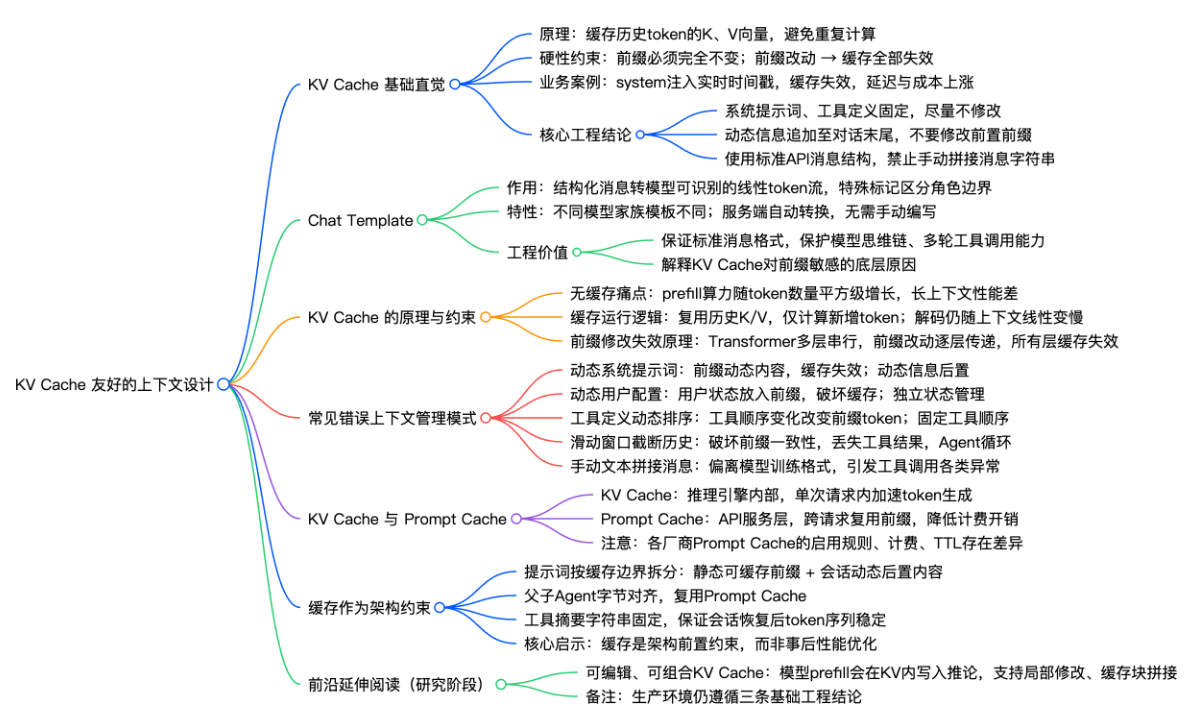
模型生成每个token时,需要读取前文所有token的中间计算结果;若无缓存,每轮生成都要从头重算,计算开销随上下文长度爆炸式上涨。 KV Cache的思路:缓存前文Key、Value向量,新增token仅计算自身部分。
硬性前提:上下文前缀必须完全不变。只要前缀任意字符发生修改,全部缓存失效,模型需要从头重新计算。 概念区分:Prompt Cache是API服务商侧、跨请求层级的缓存,底层依托推理引擎的KV Cache。
1.1.1 业务案例
客服Agent案例:开发者在system提示词内嵌入实时时间戳,每次请求前缀都发生变化,KV Cache完全失效。首token延迟大幅上涨,推理成本翻倍。
本质:看似无害的动态内容注入,会带来巨大的隐形推理成本,这类陷阱在Agent项目中十分常见。
1.1.2 三条核心工程结论
- 系统提示词、工具定义一旦确定,尽量不要改动;微小改动(增加空格)都会造成缓存失效,延迟、成本上升。
- 动态信息(时间戳、用户状态)追加到对话末尾,禁止修改前置的系统提示词。
- 使用标准API消息结构,不要手动拼接字符串消息;
- 手动拼接会偏离模型训练时的标准格式,削弱模型多步推理、工具调用能力;
- 缓存仅识别token字节序列,若拼接内容不稳定,同样会破坏缓存。
通俗类比:前缀如同做菜前置步骤,前置步骤不变,就可以复用半成品;前置任意一步改动,全部工序需要重做。
1.2 Chat Template
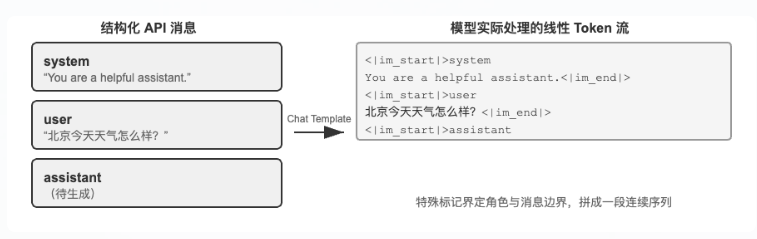
Chat Template是Agent开发的基础底层机制,同时影响KV Cache、工具调用、思维链保留。
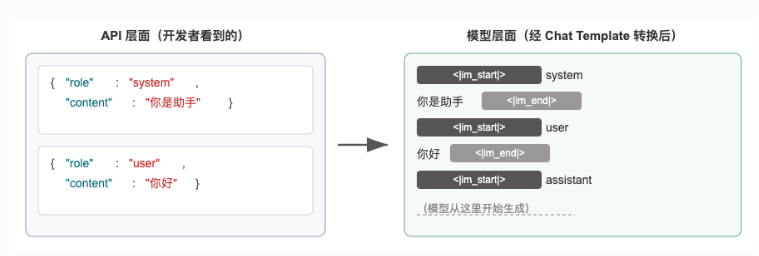
- 作用:API传入结构化JSON消息,Chat Template将角色消息转换为模型能够识别的线性token流,依靠特殊标记区分不同角色消息的边界。不同模型家族(Qwen、Llama、Gemma)拥有各自独立模板规则。
- 开发者不需要手动编写修改Chat Template,vLLM/Ollama等推理服务会自动转换。
- 两大工程价值:
- 解释必须使用标准API消息格式:如果错误把tool结果标记为普通user消息,模板会误判为新用户提问,清理模型历史思维链,打断多轮工具调用的推理连贯性;不同模型对于历史思维链保留策略存在差异,开发前需要查阅模型文档。
- 解释KV Cache对前缀敏感的根源:system消息、工具定义会被模板转换成固定前置token序列,这部分token的KV向量可以缓存复用;任意token改动,缓存失效。
1.3 KV Cache 的原理与约束
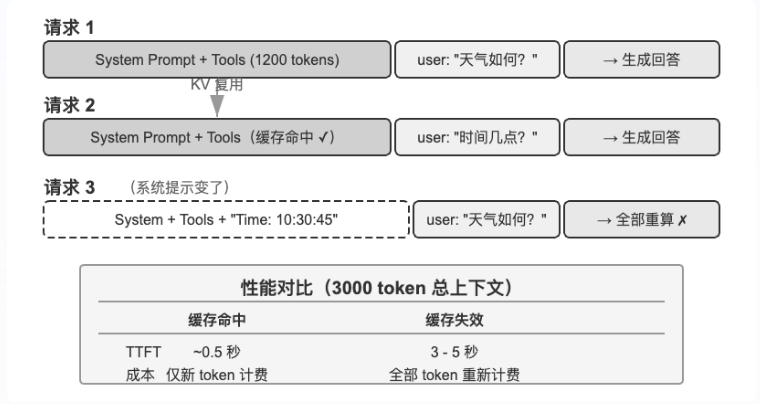
- 无缓存的缺陷:prefill阶段计算量随上下文token数量平方级增长,对话越长,延迟越高。对于需要多轮工具调用的Agent,性能无法接受。
- KV Cache运行逻辑:
- 提前计算并缓存历史所有token的K、V向量;
- 生成新token时,只计算新token的K/V,复用缓存内历史K/V向量,避免重复投影计算;
- 局限:新token仍然需要遍历全部缓存K/V做注意力计算,解码速度随上下文长度线性变慢,显存与带宽会成为长上下文推理瓶颈。
- 修改前缀导致缓存全部失效的底层原理: Transformer多层堆叠,层与层串行传递中间结果。修改前缀任意token,第一层输出发生变化,逐层传导,每一层的KV缓存全部失效,必须全部重算,带来高额延迟与算力开销。
1.4 常见错误上下文管理模式(破坏KV Cache / Agent能力)
- 动态系统提示词:在system中嵌入时间、动态状态,每次请求前缀变化,缓存失效。✅方案:动态信息追加至消息末尾,或者按需调用工具获取。
- 动态用户配置:把账户余额、调用次数等状态放入前缀,破坏缓存。✅方案:独立状态管理模块,按需读取。
- 工具定义动态排序:频繁调整tools数组内工具顺序,改变前置token序列,缓存失效;工具顺序对模型工具选择能力几乎无影响,工程上固定顺序即可。
- 滑动窗口截断历史:丢弃最早消息,破坏前缀一致性,缓存失效;还会丢失关键工具返回结果,造成Agent遗忘历史信息,反复循环调用工具。
- 手动文本拼接格式化 :把role消息拼接成
USER:xxx ASSISTANT:xxx纯文本;- 缓存层面:只要拼接字节稳定,缓存可以命中;
- 核心危害:偏离模型训练的标准消息格式,模型解析角色边界困难,容易出现工具调用失败、重复执行操作等问题。
小结:所有错误模式的规避方案,都回归前面三条核心工程原则;优先使用模型原生标准API接口,减少自定义消息处理逻辑。
1.5 KV Cache 与 Prompt Cache:两层缓存区分
-
KV Cache:推理引擎内部,单次请求内,复用已计算token的K/V向量,加速单轮token生成。
-
Prompt Cache:API服务平台层,跨多次API请求,复用相同前缀的KV计算结果,直接降低prefill的算力消耗与计费。
两者都依赖前缀不变;Prompt Cache直接影响账单成本,在生产环境中经济影响更大。 补充:不同厂商Prompt Cache启用策略、计费、缓存TTL、最小长度限制各不相同,开发前需要查阅服务商文档。
1.6 缓存作为架构约束
当Prompt Cache带来的成本收益足够大时,缓存一致性会前置约束Agent整体架构设计:
- 提示词结构由缓存边界划分:内容分为全局可缓存前缀、会话动态内容两部分;动态变量全部放到缓存边界之后,避免产生大量不同缓存键。
- 父子Agent字节对齐:子Agent请求的提示词、工具、前缀token序列,需要和父Agent保持字节一致,从而命中Prompt Cache。
- 工具结果摘要字符串固定:工具返回内容做摘要替换时,替换字符串永久固定,会话恢复后保持token序列不变,保护缓存。
核心启示:缓存不是上线后的性能优化手段,而是架构设计前置约束,越早纳入设计,工程成本越低。
1.7 前沿延伸阅读(研究阶段,生产环境不适用)
传统KV Cache"修改前缀则缓存全失效"是当前推理引擎的现状,但前沿研究提出可编辑、可组合KV Cache: 模型prefill阶段会在多层KV状态中写入事实推论(类似读书笔记)。
-
编辑:修改事实字段,借助思维链更新下游推论,不需要全部重算;
-
组合:利用RoPE位置编码,把预计算的缓存块直接拼接组装长上下文,大幅降低算力。
现状:属于学术前沿,前面三条核心工程原则仍是当前生产系统的默认准则。