GPT Researcher 源码拆解:研究型 Agent 如何检索、筛选证据与生成报告
摘要:从 GPT Researcher 真实源码出发,拆解研究规划、检索抓取、BM25 与模型筛选、深度研究及报告生成。结合 SDK 示例、Linux 部署与二次开发,说明研究型 Agent 如何组织证据,以及为什么有引用仍需审核。
一篇带着十几个链接的 AI 报告,不一定比没有链接的回答可靠。真正需要理解的是:链接从哪里来,原文是否被读过,哪些段落进入了模型,证据为空时系统会做什么。
GPT Researcher 值得学习的,不是"给模型加一个搜索工具",而是把研究任务拆成可替换的工程环节。本文沿着真实源码分析这条流水线,再给出安装、Linux 部署和二次开发的路径。
文章目录
- [GPT Researcher 源码拆解:研究型 Agent 如何检索、筛选证据与生成报告](#GPT Researcher 源码拆解:研究型 Agent 如何检索、筛选证据与生成报告)
-
- [一、项目定位:它是研究应用,不是万能 Agent 框架](#一、项目定位:它是研究应用,不是万能 Agent 框架)
- 二、先看目录:应该从哪些文件读起
- 三、一条研究请求,实际经历了什么
-
- [3.1 入口对象负责组装,而不是完成所有工作](#3.1 入口对象负责组装,而不是完成所有工作)
- [3.2 规划不是凭空拆问题:先做初始搜索](#3.2 规划不是凭空拆问题:先做初始搜索)
- [3.3 来源选择决定了后面的可信边界](#3.3 来源选择决定了后面的可信边界)
- [3.4 子查询并行,但并行不意味着成本免费](#3.4 子查询并行,但并行不意味着成本免费)
- 四、真正的关键:筛选什么内容让模型读
-
- [4.1 搜索摘要、网页原文、模型上下文是三层对象](#4.1 搜索摘要、网页原文、模型上下文是三层对象)
- [4.2 最新源码提供五种筛选模式](#4.2 最新源码提供五种筛选模式)
- [4.3 BM25 为什么能作为有效回退](#4.3 BM25 为什么能作为有效回退)
- [4.4 筛选的评估应该固定检索结果](#4.4 筛选的评估应该固定检索结果)
- 五、深度研究与多角色研究:别混成一个概念
- 六、写作阶段的保护:没证据,就不该装作有证据
- [七、最小可运行示例:先 SDK,再考虑完整应用](#七、最小可运行示例:先 SDK,再考虑完整应用)
-
- [7.1 创建环境与安装](#7.1 创建环境与安装)
- [7.2 新建 research_demo.py](#7.2 新建 research_demo.py)
- [7.3 用指定 URL 做更可控的研究](#7.3 用指定 URL 做更可控的研究)
- [八、Linux 服务器部署:端口与文件比启动命令更重要](#八、Linux 服务器部署:端口与文件比启动命令更重要)
-
- [8.1 先固定源码](#8.1 先固定源码)
- [8.2 公网访问应该走 HTTPS 入口](#8.2 公网访问应该走 HTTPS 入口)
- 九、二次开发:从研究工具变成你的业务服务
-
- [9.1 第一层:业务包装,不急着改底层](#9.1 第一层:业务包装,不急着改底层)
- [9.2 第二层:替换资料入口](#9.2 第二层:替换资料入口)
- [9.3 第三层:增加证据审查,而不是只换 Prompt](#9.3 第三层:增加证据审查,而不是只换 Prompt)
- 十、技术选型与常见问题
- 十一、总结与阅读资料
一、项目定位:它是研究应用,不是万能 Agent 框架
GPT Researcher 是 Apache-2.0 许可的开源研究型 Agent 项目。它围绕一个具体目标组织能力:从问题出发,检索外部信息或本地资料,整理相关上下文,再生成报告。
例如,你要调查"团队应该使用 pgvector 还是 Milvus"。普通聊天可能直接给出比较表;研究型应用还需要查最新文档、弄清规模和运维约束、记录来源,并把证据组织成回答。这些步骤的输入、错误和成本并不相同,不能全部藏进一个长 Prompt。
它与三类系统的边界如下:
| 系统 | 主要职责 | GPT Researcher 的关系 |
|---|---|---|
| 搜索引擎/API | 返回候选网页或摘要 | 为研究提供入口,不代替研究 |
| RAG 应用 | 在给定知识集合中检索并回答 | 可作为资料来源;研究还需要规划和报告组织 |
| LangGraph 等编排库 | 提供状态和执行控制机制 | 可用于构建复杂研究工作流,不等于现成研究产品 |
"自主研究"也不是事实准确性的承诺。网页可能过时、抓取可能失败,模型仍可能曲解原文。本文把工程机制和质量边界分开讨论。
二、先看目录:应该从哪些文件读起
不要按目录字母顺序通读。更有效的顺序是"入口 → 主流程 → 上下文 → 写作 → 外围服务"。
text
gpt_researcher/
  agent.py                  对外 GPTResearcher 类与组件组装
  skills/researcher.py       研究规划、来源分流、子查询调度
  skills/browser.py          抓取管理
  skills/context_manager.py 上下文管理
  skills/writer.py           报告生成与空证据保护
  skills/deep_research.py    递归深入研究
  context/select.py         选择上下文筛选策略
  context/lexical.py        BM25 本地筛选
  retrievers/               搜索服务适配
  scraper/                  页面抓取实现
  config/                   默认值与配置加载
backend/                    Web 应用后端
frontend/                   Web 界面
multi_agents/ 更复杂的多角色研究流程这里有一个易混淆的名字:gpt_researcher/skills/ 是项目内部 Python 功能模块,不应直接理解为所有文件都是可安装的 SKILL.md 包。阅读项目时,要看实际加载机制,而不是只看目录名。
前后端是应用包装层;GPTResearcher 才是适合嵌入自己后端的核心接口。这意味着你可以不部署完整 UI,只将它作为知识调研服务的一部分。
三、一条研究请求,实际经历了什么
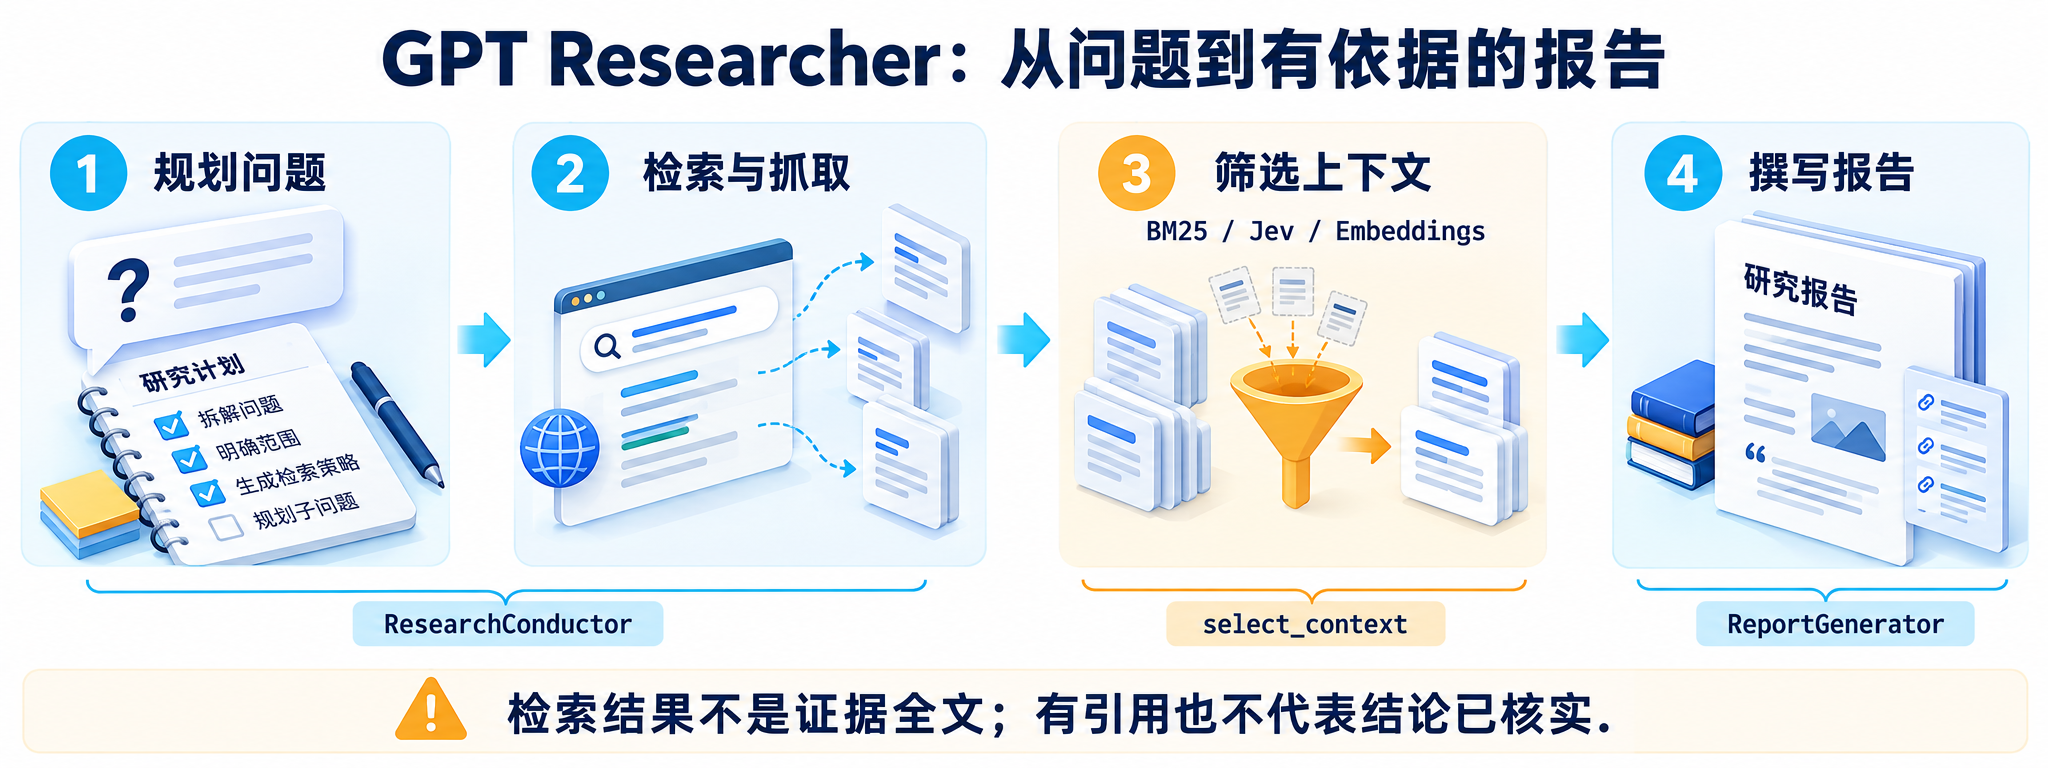
3.1 入口对象负责组装,而不是完成所有工作
agent.py 在初始化时创建研究执行器、写作器、上下文管理器、抓取管理器和来源整理器。它保存问题、来源 URL、已访问 URL、上下文以及成本信息。
下面是依据源码整理的调用关系示意,不是可替代原类的完整实现:
python
# 调用关系示意:省略日志、模型选择、图片等分支
async def conduct_research(self):
    self.context = await self.research_conductor.conduct_research()
    return self.context

async def write_report(self, custom_prompt=""):
    return await self.report_generator.write_report(
        ext_context=self.context,
        custom_prompt=custom_prompt,
    )
这个分离很实用:研究完成后,你可以先检查来源,再决定是否生成报告;也可以保存研究上下文,使用不同写作模板生成技术综述、采购说明或内部评估。一次检索与一次写作不是同一个生命周期。
3.2 规划不是凭空拆问题:先做初始搜索
ResearchConductor.plan_research() 可以接收已经取得的初始搜索结果,再调用规划函数生成子查询。在网页研究路径中,初始搜索结果还会进入上下文处理,避免"规划看过的资料,写作时反而丢失"。
这与纯 Prompt 拆题不同。对于陌生问题,先搜索可以提供真实术语和议题范围。例如调查数据库,不应先假设所有产品都有同一种索引;应让官方材料帮助规划比较维度。
规划输出也需要约束。子问题太多会导致重复检索,太少会遗漏核心事实。建议先把输入写清楚:对象、时间范围、预期读者、比较维度、允许来源,而不是输入"全面分析一下"。
3.3 来源选择决定了后面的可信边界
源码根据 source_urls、report_source 等设置走不同分支:指定 URL、网页研究、本地资料、混合资料等。指定 URL 可以减少无关搜索,但无法保证网页可访问或内容充足。
complement_source_urls=True 表示允许在指定来源之外补充搜索。对严格的内部审计,这可能不合适;对公开技术调研,则可以提高覆盖面。
visited_urls 是运行内的去重信息,不是一个自动持久化、跨用户共享的缓存数据库。源码刻意保留调用者传入的空集合对象,便于父子研究共享去重状态。把它当成永久缓存,会误判资料是否已经更新。
3.4 子查询并行,但并行不意味着成本免费
网页研究路径使用 asyncio.gather() 汇总子查询上下文。异步的收益主要是等待搜索和网络响应时重叠工作;并不是把 CPU 计算变成多核,也不是降低服务商计费。
要区分四种限制:
- 子查询数量决定工作量;
- 抓取 Worker 数量影响网页访问并发;
- 深度研究的 Semaphore 约束其查询执行;
- 模型/API 的 RPM、TPM 和账户配额来自服务商。
只改一个"并发数"不会同时控制所有环节。网页研究汇总路径会捕获异常并返回空结果;因此上层业务不能仅凭"函数没有抛异常"认定研究成功。
四、真正的关键:筛选什么内容让模型读
4.1 搜索摘要、网页原文、模型上下文是三层对象
搜索服务返回候选结果;抓取器读取页面正文;上下文筛选器进一步挑选相关段落。搜索成功不等于抓取成功,抓取成功也不等于写作模型读到了整个网页。
因此,"给报告加来源列表"只能证明来源被记录过,不能证明每个结论都由对应段落支持。
4.2 最新源码提供五种筛选模式
context/select.py 的 resolve_context_filter() 决定使用哪种策略:
| 模式 | 如何选择内容 | 工程取舍 |
|---|---|---|
auto |
有 TypeSafe Key 使用 Jev,否则 keyword | 默认便于启动 |
keyword |
本地 BM25 排序 | 无额外筛选 API,但依赖词项匹配 |
jev |
为段落评估回答问题的有用性 | 需要服务凭据、考虑外发资料与费用 |
embeddings |
向量相似度筛选 | 需要嵌入模型,相似不等于能回答 |
none |
不做筛选 | 更易超上下文和增加噪声 |
小资料集有直接传递的快速路径。Jev 或 embeddings 路径失败时会回退到 keyword。这不是"总能找到正确证据",只是避免筛选服务失败就完全失去已有资料。
这里的 Memory/嵌入模型是懒加载:只有相关路径使用时才创建,不是初始化每个研究对象都强制调用 Embedding API。
4.3 BM25 为什么能作为有效回退
BM25 不是"大模型理解"。它根据词项在段落中的频率、在资料集合中的稀有程度和段落长度计算相关性:
text
score(q,d) = Σ IDF(t) × tf(t,d)×(k1+1)
                         / [tf(t,d)+k1×(1-b+b×|d|/avgdl)]
高频但到处都出现的词贡献较小;与查询重叠、但比较稀有的技术词贡献较大;长度归一化避免长文仅因词多就占优势。
项目 lexical.py 将文本切块后排序,还采用相对阈值:只有达到最高分一定比例的块才保留,并设置最大数量。它不是强行填满 Top-K;在没有任何词项命中时,则回退到开头的块。
这带来两个边界:相对高分不代表事实真实;零匹配的回退也不代表与问题相关。中文资料尤其要用实际语料检查词项切分效果,不能把 Unicode 支持等同于专业中文分词效果。
4.4 筛选的评估应该固定检索结果
如果今天用 A 策略,明天用 B 策略,同时搜索结果和模型都变了,就无法知道差异来自哪里。仓库的 evals/context_filter/ 使用录制与重放思路比较过滤策略,这是值得复用的实验设计。
自己的评估至少应固定问题集、原始页面、模型版本和报告模板,再比较相关段落覆盖、引用正确性、输入 Token、失败率和端到端耗时。官方样本集的表现不能直接迁移成你的中文业务效果,本文不引用它作为独立验证的性能承诺。
五、深度研究与多角色研究:别混成一个概念
skills/deep_research.py 的重点是递归探索:生成查询、执行查询、整理发现,再在剩余深度内继续研究。源码中有广度、深度和并发限制,并在没有成功查询结果时停止向下递归。
工程上可以把它理解为受预算约束的搜索树。若每层产生多个分支,深度提高一层可能显著增加搜索和模型调用。并且不同层的并发限制不能简单理解为"整个系统只有这么多个请求"。
multi_agents/ 则提供更复杂的多角色工作流组织。本文最小示例使用核心 SDK 普通报告路径,不应把它的行为说成已经包含编辑、审稿、人类批准等完整流程。
选择普通研究还是深度研究,取决于证据是否已有明确边界:官方文档比较通常先用普通模式;需要持续追踪新线索的问题再考虑深度模式。深入探索不是质量无限提升按钮。
六、写作阶段的保护:没证据,就不该装作有证据
skills/writer.py 在调用报告模型前会检查上下文是否为空;为空时返回明确的无法收集来源说明,而不是继续生成看起来有依据的报告。这是重要的失败显式化设计。
但要注意:这是字符串返回,不是统一业务异常或强类型状态。接入自己的后端时,应该在研究阶段先检查上下文,并将"无来源""研究失败""写作失败"分成明确状态,不依赖匹配英文提示句来判断结果。
历史 Issue #1572 曾报告空上下文下出现虚构来源。本文核对的当前 writer 已有空上下文保护;不能仅凭旧 Issue 就说最新源码没有保护,也不能反过来说所有引用幻觉已经解决。
业务上还应增加两道检查:输出链接是否属于已收集来源;关键判断是否能定位到具体原文段落。前者是集合约束,后者是证据支持性,难度不同。
七、最小可运行示例:先 SDK,再考虑完整应用
7.1 创建环境与安装
以下命令面向 Linux,先确保 python3.12 已安装:
bash
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install 'gpt-researcher==0.16.0' python-dotenv
新建 .env,只在本地填写自己的凭据,不提交到 Git:
dotenv
OPENAI_API_KEY=替换为你自己的密钥
TAVILY_API_KEY=替换为你自己的搜索密钥
LANGUAGE=chinese
CONTEXT_FILTER=keyword
MAX_SEARCH_RESULTS_PER_QUERY=3
MAX_ITERATIONS=2
LANGUAGE 控制报告语言,不保证检索资料全部是中文。关键词筛选无需额外筛选模型,但研究规划与写报告仍然使用语言模型。
如果换成兼容接口,需要同时核对模型名、接口地址、输出参数以及工具/结构化输出支持。不要把任意服务都当成完全兼容的替代品。模型配置可使用 FAST_LLM、SMART_LLM、STRATEGIC_LLM,它们采用项目支持的 provider:model 形式;具体供应商和模型选择以当前官方配置文档为准。
7.2 新建 research_demo.py
python
import asyncio
from pathlib import Path

from dotenv import load_dotenv
from gpt_researcher import GPTResearcher

load_dotenv()

async def main() -> None:
    researcher = GPTResearcher(
        query=(
            "为已有 PostgreSQL 的小型团队比较 pgvector 与 Milvus。"
            "围绕数据规模、过滤检索、备份和部署复杂度进行研究。"
            "区分官方事实与工程建议,不编造性能数字。"
        ),
        report_type="research_report",
        query_domains=["github.com", "milvus.io"],
        verbose=True,
    )
    context = await researcher.conduct_research()
    if not context or not str(context).strip():
        raise RuntimeError("没有取得研究上下文,请检查检索与抓取日志")

    report = await researcher.write_report(
        custom_prompt="使用中文;列明资料来源;证据不足处明确说明。"
    )
    if not report.strip():
        raise RuntimeError("报告内容为空,请检查写作模型日志")

    output = Path("outputs")
    output.mkdir(exist_ok=True)
    (output / "report.md").write_text(report, encoding="utf-8")

if __name__ == "__main__":
    asyncio.run(main())
bash
python research_demo.py这里的域名列表是搜索约束而不是安全防火墙;搜索服务支持方式也要检查。report.md 是输出文件,不代表结果已经审核。读者运行后应先打开来源链接检查,再将报告用于决策。
7.3 用指定 URL 做更可控的研究
python
researcher = GPTResearcher(
    query="总结 pgvector 的索引选择与查询注意事项,用中文说明。",
    report_type="research_report",
    source_urls=["https://github.com/pgvector/pgvector"],
    complement_source_urls=False,
)
这适合教学复现和限定文档的比较。但 GitHub 页面抓取是否完整要看日志;严谨做法是保存文档快照、抓取时间和内容摘要,而不是只保存一个会变化的 URL。
八、Linux 服务器部署:端口与文件比启动命令更重要
8.1 先固定源码
bash
git clone https://github.com/assafelovic/gpt-researcher.git
cd gpt-researcher
git checkout 3582a6841fe7dc801e2a34e34ee408641aea9bce
mkdir -p my-docs outputs logs
官方根目录 Compose 的后端端口是 8000,Next.js 前端端口是 3000。它的前端使用 Dockerfile.dev 并挂载源码,后端使用 root 用户,不能原样称为生产加固方案。
为了先验证后端,可以只启动官方的后端 service。将 Compose 文件中的后端端口映射改为以下内容,避免直接暴露到公网:
yaml
ports:
  - "127.0.0.1:8000:8000"
上面是编辑官方 service 的片段,不是可独立启动的完整 Compose 文件。采用片段时不要用简单 override 追加一个端口并保留原来的公网映射,应检查最终合并配置。
官方 Compose 显式传递一部分环境变量。你新增的 LANGUAGE、CONTEXT_FILTER 等 SDK 环境设置,必须也传入容器,不能以为宿主 .env 的所有键都会自动成为容器环境变量:
yaml
environment:
  LANGUAGE: ${LANGUAGE:-chinese}
  CONTEXT_FILTER: ${CONTEXT_FILTER:-keyword}
  MAX_SEARCH_RESULTS_PER_QUERY: ${MAX_SEARCH_RESULTS_PER_QUERY:-3}
bash
docker compose config --quiet
docker compose up -d --build gpt-researcher
docker compose ps
docker compose logs --tail=100 gpt-researcher
curl -I http://127.0.0.1:8000/
curl -I 只检查 HTTP 可达性;即使某路由返回 405,也应继续按应用接口验证,而不是立即认定模型可用。网页能打开不代表搜索密钥、模型调用和文件导出都正常。
8.2 公网访问应该走 HTTPS 入口
优先通过 SSH 隧道做个人访问:
bash
ssh -N -L 8000:127.0.0.1:8000 your-user@your-server需要团队访问时,再设计域名、TLS、身份验证和配额。云安全组与主机防火墙是两层;容器发布端口是第三层。不要为了排障将 8000、3000 和所有内部端口全部开放。
若使用应用 WebSocket,反向代理还需要处理 Upgrade/Connection 头和长连接超时。前端 NEXT_PUBLIC_GPTR_API_URL 必须是浏览器能访问到的后端地址,不能填只在 Docker 网络内有效的 service 名。
outputs、my-docs、logs 的持久化与权限要分别验证:容器重建后报告是否还在,敏感文档是否可被无关用户访问,日志是否泄漏完整研究内容。
九、二次开发:从研究工具变成你的业务服务
9.1 第一层:业务包装,不急着改底层
把提交研究请求与研究执行分开:API 返回任务 ID,后台 Worker 执行,数据库记录状态,完成后保存报告和来源。至少区分 queued、running、succeeded、failed、cancelled。
每次任务创建一个研究对象,不要跨用户共享上下文或修改进程级环境变量来切换请求配置。添加超时、预算和用户配额;重复提交用幂等键约束;重试前确认上次是否已经生成报告,以免重复消费费用。
9.2 第二层:替换资料入口
如果场景是企业内部调研,优先接入经过权限过滤的内部知识检索,而不是把数据库凭据直接交给模型。检索器应返回稳定结构,保留来源、标题和内容,明确内容是否还需要抓取。
当前 Release 记录了通过 gpt_researcher.retrievers entry point 加载第三方检索器的能力。真正编写插件前,应阅读适配器的构造和返回值契约;本文不提供未经完整验证的插件骨架,避免"能 import 但不能被调用"的假示例。
9.3 第三层:增加证据审查,而不是只换 Prompt
建议保存以下业务证据结构,它是二次开发建议,不是上游已实现的全部字段:
json
{
  "task_id": "research-001",
  "source_url": "https://example.org/official-doc",
  "fetched_at": "2026-10-13T00:00:00Z",
  "content_hash": "由抓取内容计算",
  "passage": "与结论直接相关的原文片段",
  "claim": "报告中的待验证判断",
  "review_status": "unverified"
}
这样可回答两个不同问题:系统当时读到了什么,以及这些资料能否支持结论。不要用"模型再次说正确"替代证据审核。
十、技术选型与常见问题
| 需求 | 建议 |
|---|---|
| 有限来源的技术调研、报告助手 | GPT Researcher 很适合先做验证 |
| 复杂文件交付、代码执行、长期协作 | 需要更完整的 harness 与执行环境,可参考 DeerFlow |
| 高吞吐的固定业务 API | 先判断是否真的需要研究 Agent;确定性检索/规则可能更简单 |
| 法律、医疗、投资等高风险决策 | 必须有专业审核,不应依赖自动报告直接决策 |
为什么有链接,仍然可能答错? 链接记录、段落筛选、判断生成是不同环节。真实来源可能被误读,也可能不支持输出的结论。
为什么只搜到结果却写不出报告? 继续检查正文抓取、筛选后的上下文、模型输出与超时,而不是只检查搜索 API 是否返回 200。
是否必须装向量数据库? 普通网页研究在本文版本中不要求。选择 embeddings 或外部知识库接入时,才按具体路径准备依赖。
为什么中文报告仍引用英文资料? 输出语言和检索语言不是同一个设置;需要明确资料范围和搜索策略。
能否把开源项目作为自己的项目? 可以在遵守 Apache-2.0 许可和依赖许可的前提下二次开发;项目经历应该描述你增加的权限、任务管理、评估和部署能力,不能把上游代码归为自己的原创。
十一、总结与阅读资料
GPT Researcher 最值得借鉴的,是研究阶段的组件边界,以及"已有网页如何变成模型上下文"这一中间层。把检索、抓取、筛选、写作和审核分别观察,才能知道质量问题发生在哪里。
要做自己的产品,先用 SDK 完成一个来源可检查的小任务,再补任务状态、持久化、权限、成本约束和评估。不要以"容器启动了"代替"研究服务可以可靠交付"。
资料采集日期:2026-10-12~2026-10-13。示例需要读者自备模型与搜索凭据;本文未虚构模型执行结果或云服务器截图。