目录
https://legacy.cplusplus.com/reference/set/
一.序列式容器和关联式容器
之前我们了解的容器以及容器适配器比如说vector,string,list,deque,array,forward_list等,他们都是序列式容器,他们逻辑上都是线性的关系,两个位置存储的值之间一般没有紧密的关联关系,除了这个地方的vector这些底层是数组的容器,他们都是序列式的容器,他们有什么特点呢?就是他们交换一下,依旧是序列式容器,顺序容器中的元素是按他们在容器中存储位置的顺序保存和访问的
关联式容器也是用来存储数据的,与序列式容器不同的是,关联式容器逻辑结构通常都是非线性的?两个位置有紧密的联系,交换一下,他的存储结构就被破坏了。顺序容器中的元素是按照关键字来保存和访问的。关联式容器有map/set系列和unordered_map和unordered_set系列
map和set的底层又是由红黑树来实现的unordered_map和unordered_set的底层是哈希表
map是key/value的结构set是key结构的
二.set系列的使用
https://legacy.cplusplus.com/reference/set/
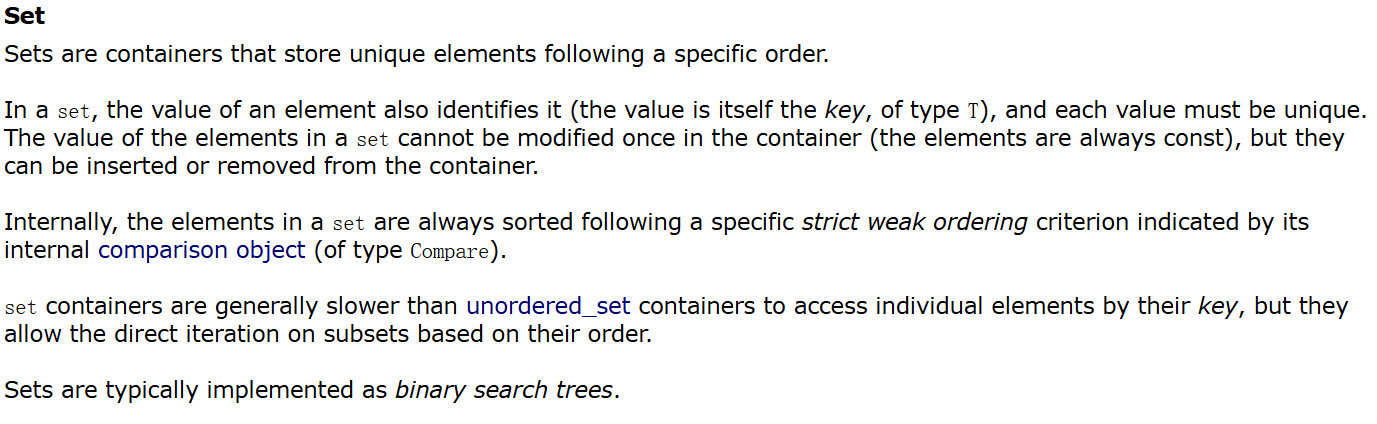
介绍一下set,set是一个按照特殊顺序存储唯一的元素的容器--也就是set是不能存储key值相等的
set的声明下,T就是set底层关键字的类型 --每个元素都必须独一无二,元素的值不能被修改(总是有常性),可以插入或者删除这些元素
在set内部,每个元素都是用它内部的Compare这个仿函数的对象的标准排过序的(默认的排序是严格的弱标准--可能会移动前后的顺序) -- 默认的是支持比较小于的,你用迭代器遍历的时候是升序,如果有别的需求自己写一个仿函数,传给第二个模板参数
set底层是用红黑树来实现的,增删的效率是(logN),迭代器走的也是中序遍历
cpp
template < class T, // set::key_type/value_type
            class Compare = less<T>, // set::key_compare/value_compare
            class Alloc = allocator<T> // set::allocator_type
                >class set;
1.set的成员函数
set的构造函数
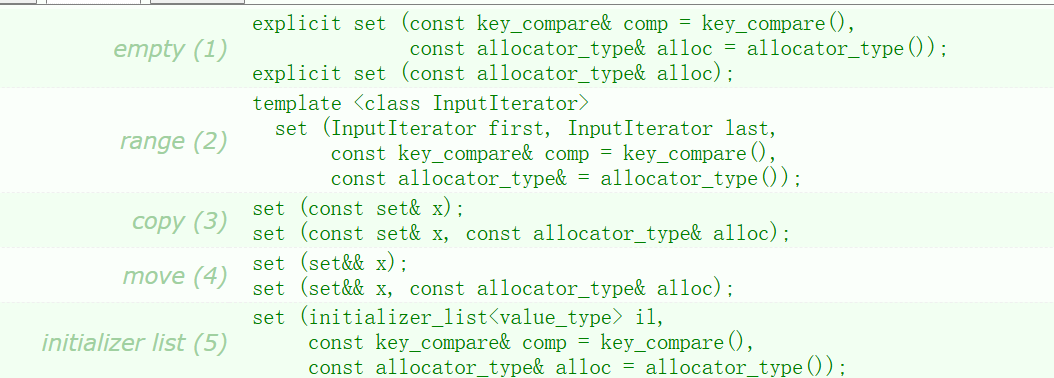
(1)无参的构造(2)利用迭代器区间的构造(3)拷贝构造(4)移动构造(5)利用列表初始化的构造
特别的讲一下(4)移动构造和(5)列表初始化的构造,这个方法是c++11之后支持的方法,这些方法旨在提高效率和方便后续也会讲
大概讲一下就是如果参数是右值的化走移动构造效率比走隐式类型转换(构造)和拷贝构造---(即使编译器优化成构造)效率高,移动构造只要求交换资源即可完成
列表初始化他的就是你用{}它会走这个地方initializer_list的构造然后用他的迭代器去构造map反正看着就比较方便
set的迭代器

set的迭代器是一个双向的迭代器即支持++也支持--
set的增
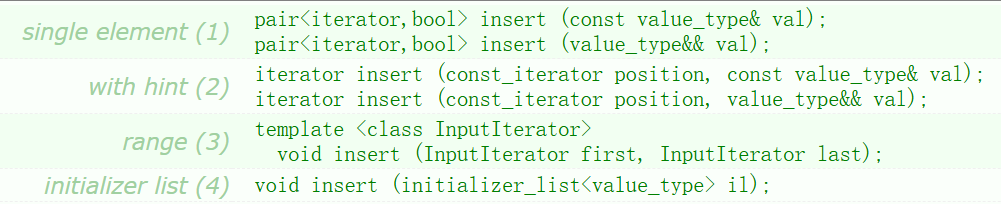
这里的插入(1)返回的是一个pair类型这个类型是库里面一个含有两个类型元素的类型这里支持值插入还支持一段迭代器区间和链表初始化的插入,需要注意的是因为set容器不支持有相同的值所以不会插入容器已经存在的值
set的查找
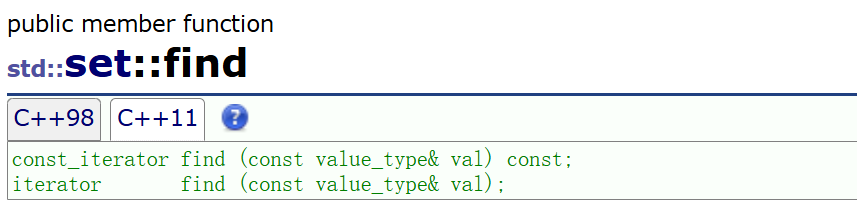
查找的化返回的是一个迭代器,如果没有这个元素会返回set::end()
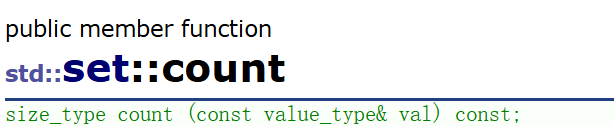
其他的也可以使用count来查找,因为set容器的特性这个函数是找val在容器的数量--如果val的值set中存在就会返回1,没有的话返回0,这个查找也很好用不需要比较迭代器是否是end()
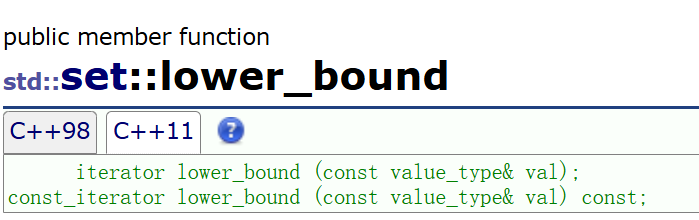
这个成员函数是返回 >=val的迭代器,他跟upper_bound结合起来可以一起使用,
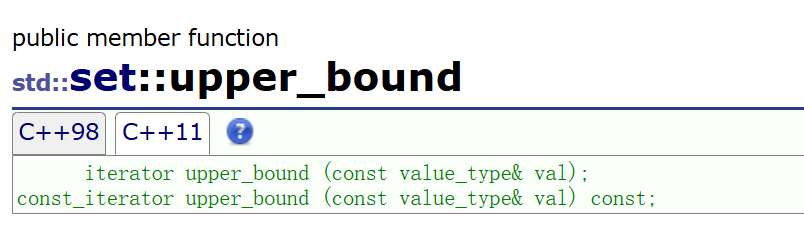
这个是返回>val的迭代器,这样我们能通过者两个成员函数找到一个左开右闭的迭代器区间,做一些迭代器层面的操作比较的方便
set的删除
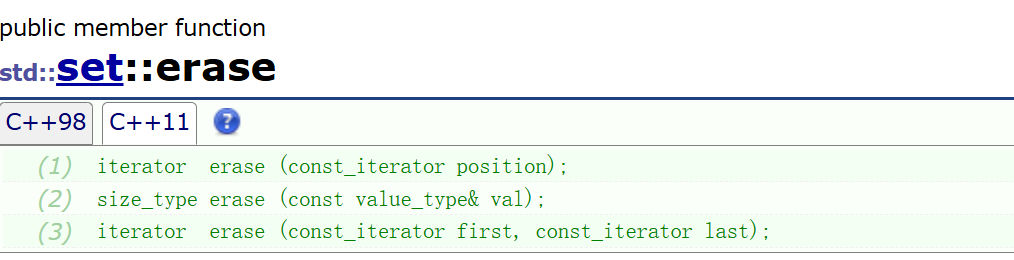 erase如果是传值的化返回值如果val不存在返回0,存在并且删除了返回1,其他的就是返回已经删除的元素的迭代器,这个一般返回值不接收
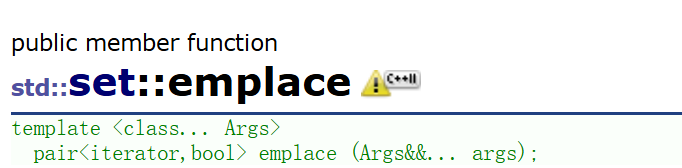
将一个c++11特殊的这个参数是可变模板参数--我们使用模板创建模板函数只解决了类型不同的函数间可以通过编译器创建不同的函数,----这个地方的可变模板参数不但解决了这一问题而且还解决了参数的个数问题,不管传几个参数编译器都会自己实例化对应的函数非常的方便,而且使用&&万能引用的可变模板参数还会触发引用折叠,如果这个地方传的是右值--可变参数还会走移动构造,如果不是右值就走拷贝。
cpp
#include<iostream>
#include<set>
using namespace std;
int main()
{
    // 去重+升序排序
    set<int> s;
    // 去重+降序排序(给⼀个⼤于的仿函数)
    //set<int, greater<int>> s;
    s.insert(5);
    s.insert(2);
    s.insert(7);
    s.insert(5);
    //set<int>::iterator it = s.begin();
    auto it = s.begin();
    while (it != s.end())
        {// error C3892: "it": 不能给常量赋值
            // *it = 1;
            cout << *it << " ";
            ++it;
        }
    cout << endl;
    // 插⼊⼀段initializer_list列表值,已经存在的值插⼊失败
    s.insert({ 2,8,3,9 });
    for (auto e : s)
    {
        cout << e << " ";
    }
    cout << endl;
    set<string> strset = { "sort", "insert", "add" };
    // 遍历string⽐较ascll码⼤⼩顺序遍历的
    for (auto& e : strset)
    {
        cout << e << " ";
    }
    cout << endl;
}
cpp
int main()
{
	set<int> s = { 4,2,7,2,8,5,9 };
	for (auto e : s)
	{
		cout << e << " ";
	}
	cout << endl;
	// 删除最⼩值
	s.erase(s.begin());
	for (auto e : s)
	{
		cout << e << " ";
	}
	cout << endl;
	// 直接删除x
	int x;
	cin >> x;
	int num = s.erase(x);
	if (num == 0)
	{
		cout << x << "不存在!" << endl;
	}
	for (auto e : s)
	{
		cout << e << " ";
	}
	cout << endl;
	// 直接查找在利⽤迭代器删除x
	cin >> x;
	auto pos = s.find(x);
	if (pos != s.end())
	{
		s.erase(pos);
	}
	else
	{
		cout << x << "不存在!" << endl;
	}
	for (auto e : s)
	{
		cout << e << " ";
	}
	cout << endl;
	// 算法库的查找 O(N)
	auto pos1 = find(s.begin(), s.end(), x);
	// set⾃⾝实现的查找 O(logN)
	auto pos2 = s.find(x);
	// 利⽤count间接实现快速查找
	cin >> x;
	if (s.count(x))
	{
		cout << x << "在!" << endl;
	}
	else
	{
	cout << x << "不存在!" << endl;
	}
	return 0;
}
2.multiset和set的区别
multiset和set在使用上基本完全类似,主要区别在于multiset支持值冗余,那么insert/find/count/erase都围绕支持冗余有所差异
使用set和multiset很多情况下leetcode上面的题目很多都有很好的解决-比较方便的解决方法
三.map系列的使用
1.map类的介绍
map的主要是以K-V的存储与set的不同,支持K值的排序和去重,他的要求也是类型要支持比较小于,如果不支持或者需要的化可以自行实现一个比较的虚函数传过去,map底层存储数据的内存是从空间配置器申请的,一般情况下,我们都不需要传后面两个参数,map的底层是红黑树支持K-V的结构。增删查改的效率是O(logN),迭代器遍历走的是中序,所以是按照key有序顺序遍历的
cpp
template < class Key, // map::key_type
        class T, // map::mapped_type
        class Compare = less<Key>, // map::key_compare
        class Alloc = allocator<pair<const Key,T> > //
        map::allocator_type
        > class map;
2.pair类型的介绍
因为在底层map里面定义的value_type是一个pair的类型传过去key-和T,这里底层又把key映射类的叫做T封装成mapped_type,所以就是他的底层是pair<key,T>这样的映射,我们需要了解一下pair这个类
cpp
typedef pair<const Key, T> value_type;
template <class T1, class T2>
struct pair
{
	typedef T1 first_type;
	typedef T2 second_type;
	T1 first;
	T2 second;
	pair() : first(T1()), second(T2())
	{
	}
	pair(const T1& a, const T2& b) : first(a), second(b)
	{
	}
	template<class U, class V>
	pair(const pair<U, V>& pr) : first(pr.first), second(pr.second)
	{
	}
};
template <class T1, class T2>
inline pair<T1, T2> make_pair(T1 x, T2 y)
{
	return (pair<T1, T2>(x, y));
}
这个类也是比较的简单就是两个模板参数构成的类,需要关注map中first就是key的值,second就是value的值
3.map的构造
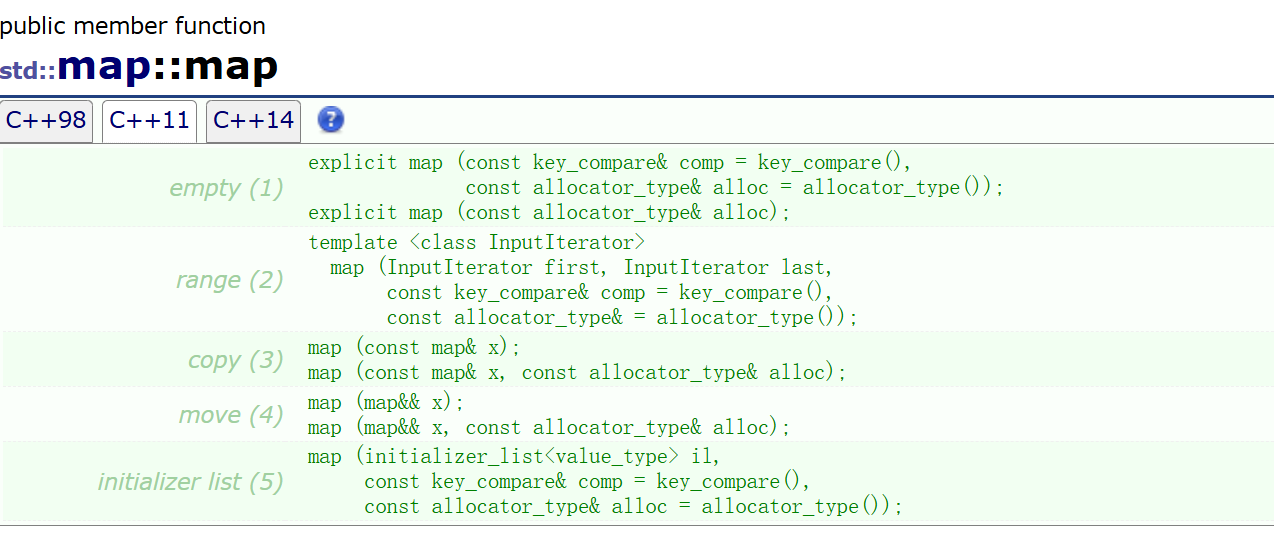
自己看吧,懒得讲了就跟map是一样的
map的迭代器也是一个双向的迭代器。
4.map的增删改
map这里有一个比较有意思的改就是map是支持\[\]的方式改数据的他的逻辑跟insert有一些的关联
我们讲一下insert,\[\]稍后再说
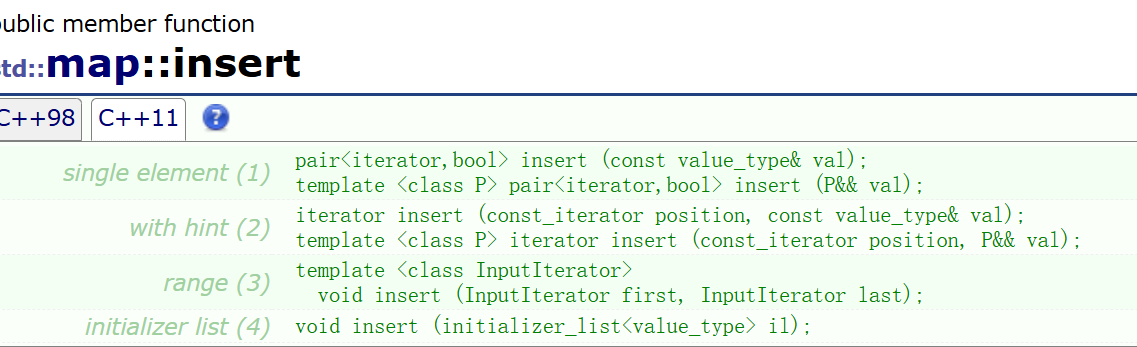
这个insert我们重点关注(1)这里是返回一个pair的对象,insert会有这个查找的,因为map不支持key值的冗余,所以如果这个val的first的key在容器内已经存在了,返回pair的第二个参数是false,并且返回key想的元素的迭代器。
我们来说一下这个地方的\[\]
他这里的\[\]是根据insert来访问的输入一个key的值他的逻辑走的是会去找看一看里面有没有这个值如果有就返回*iterator中的second。他的迭代器也是一个。
(*(this->insert(make_pair<key,mapped_type()>).first)).second
大概就是这样的一个逻辑反正就是\[\]之后就是mapped_value可以直接进行修改
cpp
// operator的内部实现
mapped_type& operator[] (const key_type& k)
{
    // 1、如果k不在map中,insert会插⼊k和mapped_type默认值,同时[]返回结点中存储
mapped_type值的引⽤,那么我们可以通过引⽤修改返映射值。所以[]具备了插⼊+修改功能
    // 2、如果k在map中,insert会插⼊失败,但是insert返回pair对象的first是指向key结点的
迭代器,返回值同时[]返回结点中存储mapped_type值的引⽤,所以[]具备了查找+修改的功能
    pair<iterator, bool> ret = insert({ k, mapped_type() });
    iterator it = ret.first;
    return it->second;
}
其他都和set差不多
cpp
// 单个数据插⼊,如果已经key存在则插⼊失败,key存在相等value不相等也会插⼊失败
pair<iterator, bool> insert(const value_type& val);
// 列表插⼊,已经在容器中存在的值不会插⼊
void insert(initializer_list<value_type> il);
// 迭代器区间插⼊,已经在容器中存在的值不会插⼊
template <class InputIterator>
void insert(InputIterator first, InputIterator last);
// 查找k,返回k所在的迭代器,没有找到返回end()
iterator find(const key_type& k);
// 查找k,返回k的个数
size_type count(const key_type& k) const;
// 删除⼀个迭代器位置的值
iterator erase(const_iterator position);
// 删除k,k存在返回0,存在返回1
size_type erase(const key_type& k);
// 删除⼀段迭代器区间的值
iterator erase(const_iterator first, const_iterator last);
// 返回⼤于等k位置的迭代器
iterator lower_bound (const key_type& k);
// 返回⼤于k位置的迭代器
const_iterator lower_bound (const key_type& k) const;
cpp
int main()
{
	// 利⽤find和iterator修改功能,统计⽔果出现的次数
	string arr[] = { "苹果", "西⽠", "苹果", "西⽠", "苹果", "苹果", "西⽠",
	"苹果", "⾹蕉", "苹果", "⾹蕉" };
	map<string, int> countMap;
	for (const auto& str : arr)
	{
		// 先查找⽔果在不在map中
		// 1、不在,说明⽔果第⼀次出现,则插⼊{⽔果, 1}
		// 2、在,则查找到的节点中⽔果对应的次数++
		auto ret = countMap.find(str);
		if (ret == countMap.end())
		{
			countMap.insert({ str, 1 });
		}
		else
		{
			ret->second++;
		}
	}
	for (const auto& e : countMap)
	{
		cout << e.first << ":" << e.second << endl;
	}
	cout << endl;
	return 0;
}
5.multimap和map的差异
multimap和map的使用基本完全相同,同样的multimap支持key值冗余,insert/find/count/erase都围绕支持key冗余有所差异,这里set和multiset完全一样,比如find时,有多个插入,返回中序第一个,其次是multimap不支持\[\],因为key冗余,\[\]就只能支持插入不能进行修改了