目录
[01 研究动机](#01 研究动机)
[02 方法:Freeze-and-Stream](#02 方法:Freeze-and-Stream)
[① 逐组联合感知](#① 逐组联合感知)
[② 压缩:Rig-Resampler](#② 压缩:Rig-Resampler)
[③ 时序:CausalBridge](#③ 时序:CausalBridge)
[④ 锚快照:因果前提下的双向交互](#④ 锚快照:因果前提下的双向交互)
[⑤ 分块重锚](#⑤ 分块重锚)
[03 实验:四种 rig 上的评测](#03 实验:四种 rig 上的评测)
[有无时序状态:与 G2G 串接的对照](#有无时序状态:与 G2G 串接的对照)
[04 适用场景与边界](#04 适用场景与边界)
[05 消融与分析](#05 消融与分析)
[06 结论与展望](#06 结论与展望)
多相机组已是移动机器人、无人车与人形机器人的标准感知配置,各相机同步采集,相互位姿经过标定。相比之下,近年兴起的三维基础模型流式定位方法(如 CUT3R、STream3R)仍以单目视频为输入:逐帧处理,相机参数由网络自行推断,现成的标定信息被搁置。
针对这一差距,浙江大学的研究团队提出 StreamRig:流式里程计每一步读入的不再是一帧图像,而是一整组同步视图。同一时刻的视图连同标定由冻结的多视图三维基础模型统一编码,跨时间传递的则只有每台相机 16 个压缩特征。据作者所知,这是首个将冻结多视图三维基础模型迁移到一般多相机 rig 上的流式里程计。
主要结果:
- 精度:NCLT 约 6 公里的校园路线上,ATE 为 25.8 米,单目 CUT3R 为 164.7 米;
- 覆盖面:在四类平台上与八种方法对比,平移与旋转漂移均为最低;
- 效率:分辨率相同时,五视图单步 26.2 毫秒,快于 CUT3R 的单视图 31.3 毫秒。
论文 :StreamRig: Exploiting Intra-Rig Geometry for Streaming Multi-Camera Odometry
作者 :Yufei Wei(一作:魏雨飞,浙江大学博士研究生), Shuhao Ye, Qi Wang, Xin Zheng, Qing Huang, Rong Xiong, Yue Wang(通讯作者)
单位 :浙江大学、华南理工大学
论文链接 :arxiv.org/abs/2609.40244
代码:github.com/WeiYuFei0217/StreamRig
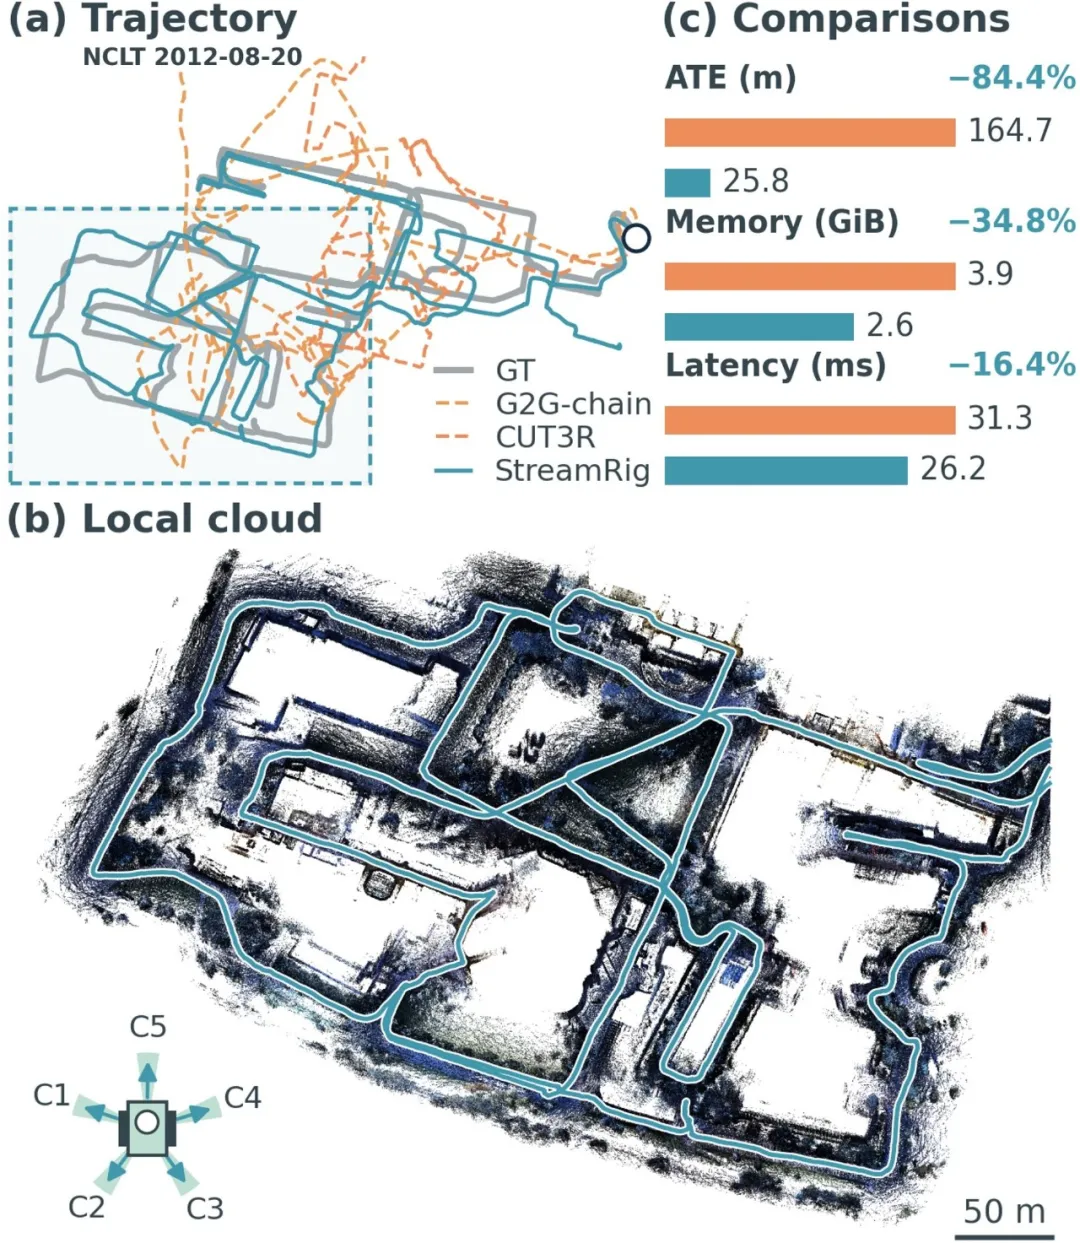
▲ 图 1|环视里程计的精度与效率。(a) NCLT 2012-08-20:StreamRig(青)比 G2G 串接与 CUT3R(橙色虚线)更贴近真值(灰)。(b) 以预测位姿拼接的着色 LiDAR 点云,范围对应 (a) 中方框,仅用于可视化,不作为里程计输入;左下为五相机朝向。(c) 五目 StreamRig 与单目 CUT3R 在 ATE、显存和延迟上的比较;精度一项用九帧窗口微调版 CUT3R,开销一项用其循环版本,分别测得。
01 研究动机
任务与问题设定
视觉里程计的目标,是仅凭图像序列在线恢复平台的六自由度运动。其误差随路程增长,因此论文沿用 KITTI 的评测惯例,以相对漂移刻画精度:平移以每百米位置偏差的百分比计,旋转以每百米的角度偏差计。
多相机为该任务带来两类额外信息。其一是冗余视场:某一视角被遮挡或纹理退化时,其他视角仍能约束运动。其二是已知几何:相机刚性固连,彼此的相对位姿在标定中已经确定。下文沿用论文的术语,称这组相机为 rig,称其内部的已知相对位姿为 rig 内几何(intra-rig geometry)。
传统多相机里程计将 rig 建模为广义相机,在优化框架中求解运动,但依赖手工特征与针对平台的工程调校,在动态、重复纹理和弱纹理场景中仍存在困难。三维基础模型从大规模数据中习得几何先验,为这一问题提供了新的路径。
现有方法的局限
第一类是单目流式模型:有记忆,无 rig 几何。 CUT3R、STream3R 等以状态或键值缓存保存历史,但输入接口只容纳单张图像。把各视图当作独立帧逐一送入,会让相机维度与时间维度纠缠在一起:同一时刻的已知几何没有得到显式编码,每步 token 量与持久缓存也按相机数成倍放大。
第二类是面向 rig 的多视图模型:有 rig 几何,无记忆。 以团队前作 G2G 为代表,这类方法联合感知一组相机,求解两组观测间的刚体变换,但每次调用互不关联。连续定位只能依靠逐对串接,误差随跳数叠加。即便为 MapAnything 提供两组的真值外参(oracle 设置),逐对串接后 NCLT 上的平移漂移仍约为 46%:单次估计中的微小系统偏差,经数千次复合后被显著放大。
需要解决的三个问题
- 状态规模:五目的 token 量是单目的五倍,原样进入时序缓存会使长序列推理的计算与显存迅速膨胀;
- 因果性与双向交互的冲突:参考帧与当前帧相互注意时位姿最易解算,但流式推理禁止参考帧读取未来观测;
- 数据稀缺:真实 rig 数据集多数只附带稀疏 LiDAR 深度,单个数据集内相机布局几乎不变,从头训练一个同时承担感知与时序推理的模型并不现实。
02 方法:Freeze-and-Stream
整体上,StreamRig 以冻结的 MapAnything 为感知前端,只在其后训练三个轻量模块。可训练参数为 74.6M,约占 638M 全系统的 11.7%。下面沿一组观测从输入到位姿输出的路径展开。
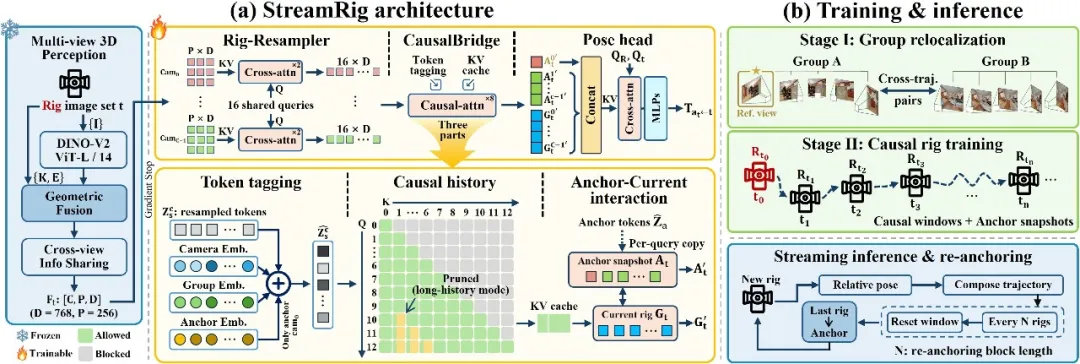
▲ 图 2|StreamRig 总览。(a) 冻结前端逐组感知,Rig-Resampler 压缩,CausalBridge 在压缩状态上因果注意,位姿头回归相对锚点的位姿。(b) 两阶段训练(组间重定位 → 因果 rig 训练)与每 N 组重锚一次的流式循环。
① 逐组联合感知
前端的输入包括三部分:C 张同步图像、由内参计算的逐像素射线,以及以参考相机为原点的外参。MapAnything 内部的 DINOv2 编码器与交替注意力在视图间交换信息,输出已锚定于相机几何的图块特征。
这是标定唯一的入口。 下游模块看不到外参,也不预设任何相机排布,因此任何能接收图像、内参和相对位姿的多视图前端都可以接入。
② 压缩:Rig-Resampler
估计运动与尺度只需要少量几何线索,无须保留稠密重建所需的全部细节。据此,Rig-Resampler 用 16 个可学习查询、两层交叉注意力把每台相机的 256 个图块 token 汇聚为 16 个潜变量。以五目为例,每组观测只剩 80 个 token,甚至少于一张 224×224 图像的 256 个;由于查询跨相机共享,多接一台相机只增加 16 个 token,参数量不变。
③ 时序:CausalBridge
压缩特征附加相机、分组和锚点三类嵌入后,进入 8 层自注意力的 CausalBridge。组内注意力不受限制,组间注意力为因果形式;历史各组的键值在各层缓存,新观测到达时只需计算当前组。
位姿的参照对象是较早的某一组观测,即锚点:网络直接输出当前组相对锚点的变换,而非相邻两组间的增量。锚点之后缓存的各组观测提供中间约束,锚点与当前组视野不再重叠时,由它们完成几何上的传递。
④ 锚快照:因果前提下的双向交互
此处存在一个结构性矛盾:相对位姿最好在两组相互注意时读出,因果掩码却不允许锚点看到更晚的观测;若让全局共享的锚点表示去读后续观测,缓存会被未来信息污染,并需不断重算。
StreamRig 的处理是锚快照(anchor snapshot):针对每一个当前组,单独拷贝一份锚点 token,使其仅与该组双向注意,得到位姿后即丢弃,不进入缓存。锚点原始表示与历史缓存始终只读。第 t 步的输出因而只依赖锚点至第 t 组的观测,整窗并行训练与逐组增量推理严格等价。
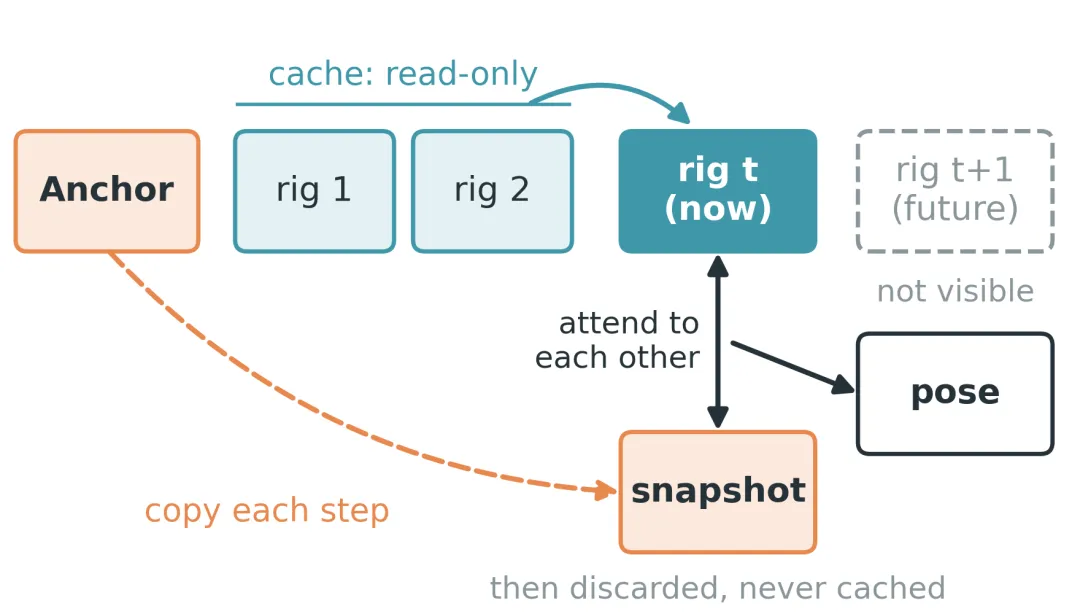
▲ 图 3|锚快照机制示意:每个当前组获得一份独立的锚点拷贝,二者双向注意后拷贝即被丢弃;中间组缓存只读,后续观测不可见。
消融中改用静态锚点------当前组可以读取锚点,但锚点表示在整个网络中与当前组无关------三个平台的平移漂移随之上升 9%--38%。
位姿头为每台相机设置旋转、平移两个查询,读取快照中参考相机与该相机的桥接特征,解码为 6D 旋转与三维平移。里程计输出取参考相机位姿;其他相机的目标由它与标定直接导出,无需额外标注即可作为辅助监督。
⑤ 分块重锚
锚点固定不动时,状态会随序列无限增长。为此 StreamRig 按块推进:每 N 组为一块,块尾一组成为新锚点,窗口从该处重启,轨迹由逐块的锚点间位姿复合而成。无论序列多长,活动状态至多为 N 组、即 N·C·L 个 token。
桥接模块不含时间位置编码,顺序信息完全来自因果掩码与 token 内容,所以块长 N 是部署参数,与训练窗口无须一致。这一设计有其依据:单目模型须借助帧序跨时间重建几何,StreamRig 则在组内完成几何解算,参照组又由锚快照显式给出。加入 RoPE 的对照实验没有收益,平移漂移最多反而高出 8%。
两阶段训练
冻结前端免去了重新学习三维表征的需要,却不能自动教会一个新的位姿后端如何使用这些表征:随机初始化后直接做因果训练,NCLT 漂移高达 41.37%,三个平台为完整方案的 4.6--14.9 倍。StreamRig 因此采用两阶段方案,全程只以相对位姿为监督:
- 阶段一,组间重定位。 在单相机轨迹上取短窗口作为"视图组",有共视的两组即可成对,且允许跨采集时段、跨轨迹组合,后端由此见到远超单一 rig 的布局与位移分布。该阶段对输入外参施加 1.5° / 0.1 m 的 SE(3) 噪声,目标保持干净,以学习从带噪标定中恢复真实几何。
- 阶段二,因果 rig 训练。 模块结构与权重原样继承,变化只在输入与监督:成对输入换成带锚快照的 rig 窗口,双向注意力换成因果掩码,窗口内每一组都成为目标。
为兼顾远近目标,窗口长度在 6, 48 内按长度加权采样,平移误差按真值位移归一化;若固定 48 组窗口,远端目标主导损失,漂移上升 15%--30%。
要点回顾:感知交给冻结前端,每组一次;每台相机 16 个 token 进入时序状态;CausalBridge 因果地读取历史并输出相对锚点的位姿;锚快照兼顾双向交互与因果性;分块重锚限定状态上界。
03 实验:四种 rig 上的评测
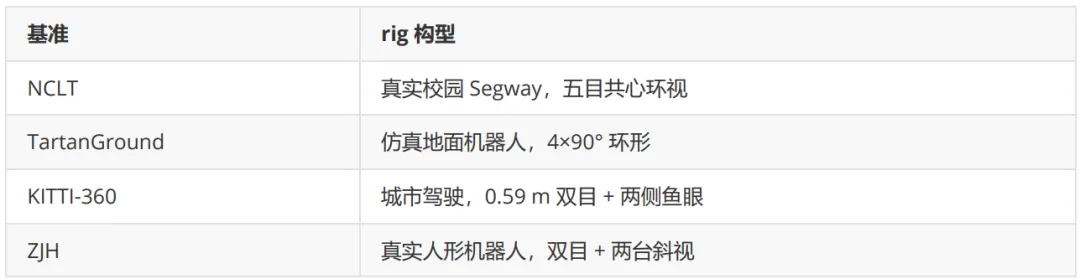
测试规模:NCLT 两条完整路线 12.29 km,TartanGround 10 个未见场景 12.60 km,KITTI-360 两段路线 13.63 km,ZJH 三条真机序列约 0.36 km。
基线分两组:单目流式的 CUT3R、STream3R(二者按原配方在目标数据上微调)、LingBot-Map 与 HorizonStream;非流式、面向 rig 的 Reloc3R、Rig3R、MapAnything 与 G2G 逐对串接。评测时每种方法都从首帧出发、因果地跑完整条序列,并仅用自身预测复合轨迹;真值只参与打分(oracle 参照除外)。
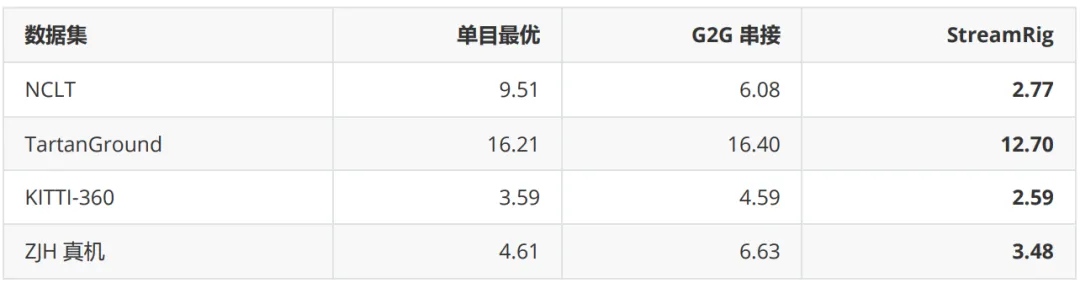
表中为平移漂移(%)。"单目最优"在 TartanGround 取 STream3R,其余取 CUT3R;无公制尺度输出的方法按序列施加一次全局尺度,ZJH 则对全部方法如此处理;oracle 参照不计入排名。
就漂移而言,StreamRig 的平移与旋转两项在全部四个数据集上领先。ATE 方面,它在三个数据集上同样最低,例外是 KITTI-360:经 Sim(3) 对齐的 STream3R 为 53.6 米,StreamRig 为 63.7 米。
相机数量对照:深度与视场
KITTI-360 以前向行驶为主,运动最为平稳,单目方法在此表现较好,适合作为隔离相机数量影响的对照。实验沿用主表配置,只更换送入前端的相机:
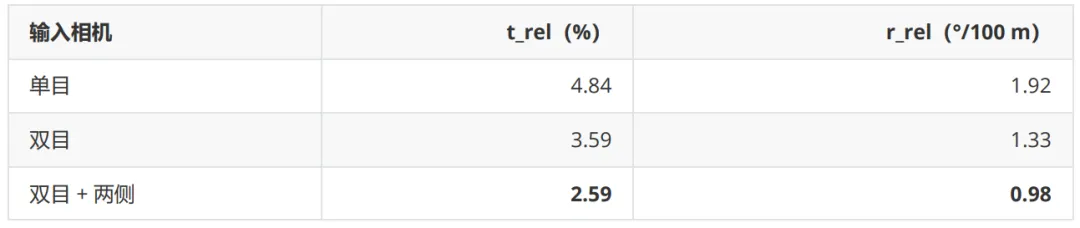
单目输入下,StreamRig 落后于 CUT3R(3.59%);换成双目后二者持平。第二个视角对视场几乎没有扩展,其价值在于:两个已标定视图的联合感知直接给出深度,而单目只能依赖推断。再补入两侧相机后,视场扩大,全部指标(含整段 ATE)进一步改善。由此可以区分两种收益:双目贡献深度,侧视相机贡献视场。
视场的作用在五目环视的 NCLT 上可以直接看到。下图取自项目主页,两幅点云使用同一套五目 StreamRig 位姿,只改变参与建图的相机:单个前视相机留下的观测稀疏而断续,五台相机则把道路两侧的树列与建筑连成完整的条带。
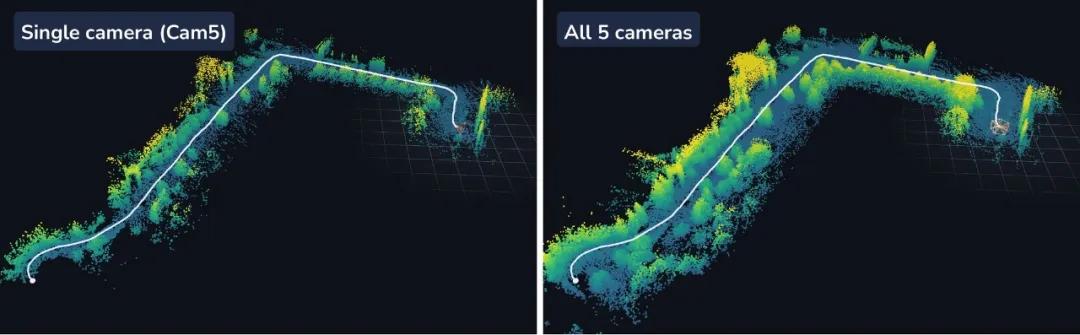
▲ 图 4|NCLT 上的建图覆盖对比(项目主页截图,按离地高度着色)。左:仅前向 Cam5;右:五台相机。两图位姿相同,差别只来自参与建图的相机,反映的是观测覆盖而非里程计精度;深度取自 LiDAR,仅用于可视化。
有无时序状态:与 G2G 串接的对照
四个数据集中,NCLT 最具挑战:两条约 6 公里的真实路线交织着室内外转换、光照剧变、运动模糊和往来行人。最能说明时序状态作用的是与 G2G 串接的对比------两者的输入图像、标定与冻结特征完全一致,唯一差别是有无跨步状态:
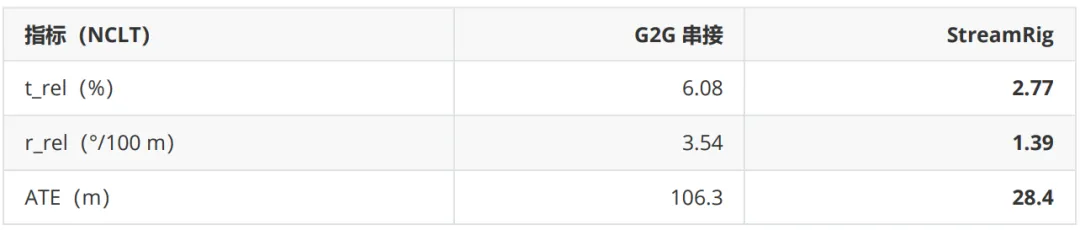
值得注意的是,无时序状态的 G2G 串接已优于所有单目流式方法,说明环视感知首先保证了跟踪稳定;时序状态进一步减少串接次数,将稳定跟踪转化为低漂移。若串接时缓存上一组特征,其每步计算量与 N=2 的 StreamRig 相同,因此这一提升是同等开销下的精度收益。
TartanGround 上,G2G 串接的漂移远低于在目标数据上重新训练的 Reloc3R 和 Rig3R,表明冻结预训练前端将多相机感知能力迁移到了未见场景。
人形机器人:仿真训练,真机零样本
相比轮式平台,步行人形机器人对里程计更为苛刻:每一步都会带来相机抖动,每米行程的转角也居四个平台之首。ZJH 的 rig 由 7 cm 基线的前向双目和两台斜视相机组成,水平覆盖约 180°。训练完全在仿真中进行------基于 3D Gaussian Splatting 重建的 25 个真实扫描室内环境、131 条行走轨迹;测试则是 3 个未见环境的真机序列。真值来自 COLMAP 的 rig 重建,仿真与真机之间的尺度事先未知,故所有方法均按序列施加一次全局尺度。
零样本条件下,StreamRig 的三项指标均列第一:平移漂移 3.48%(次优 CUT3R 为 4.61%),ATE 0.88 米,旋转漂移 14.88°/100 m,较 CUT3R 的 39.85°/100 m 低约 63%。该平台上时序状态的作用尤为明显:CUT3R 优于 G2G 串接,零样本运行的 LingBot-Map 与 HorizonStream 也优于除 G2G 串接外的全部非流式方法。论文认为,跨越多组观测的历史能够吸收步态带来的逐步扰动。
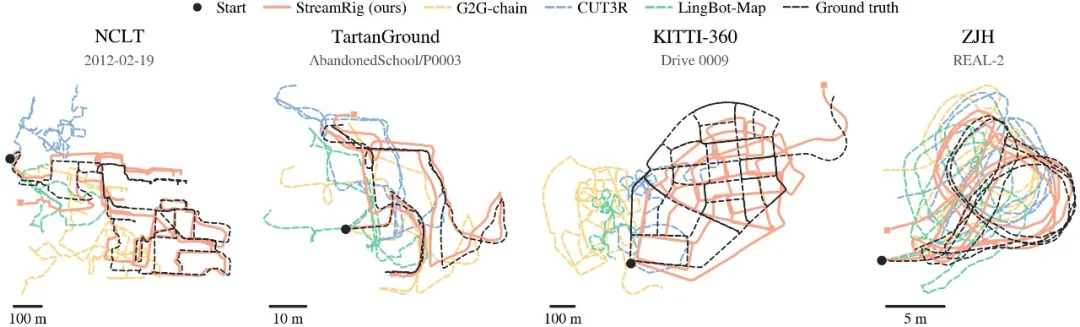
▲ 图 5|主表模型在四个平台上的轨迹示例(整段 Sim(3) 对齐后平移至共同起点)。
轨迹曲线之外,另一种直观的检验是用估计位姿把逐帧观测拼成地图:位姿一旦漂移,墙面与树列就会出现重影或错层。项目主页为四个平台各提供了一段可交互的点云回放,下图为其建图过程。
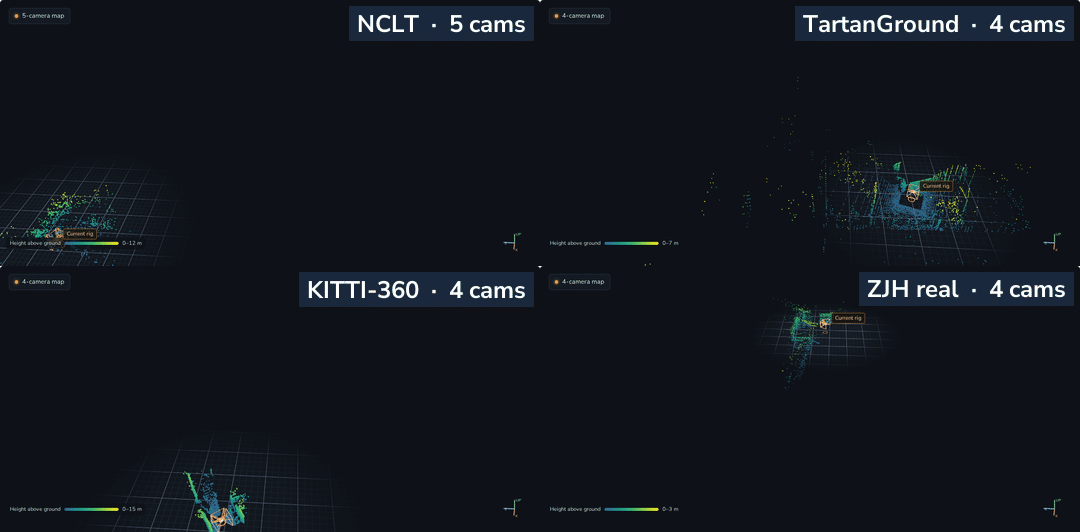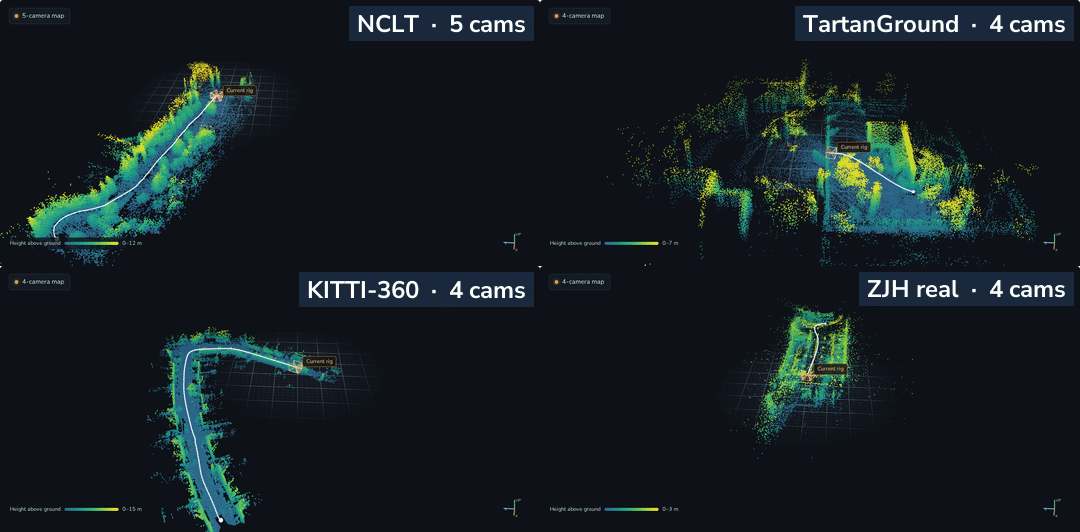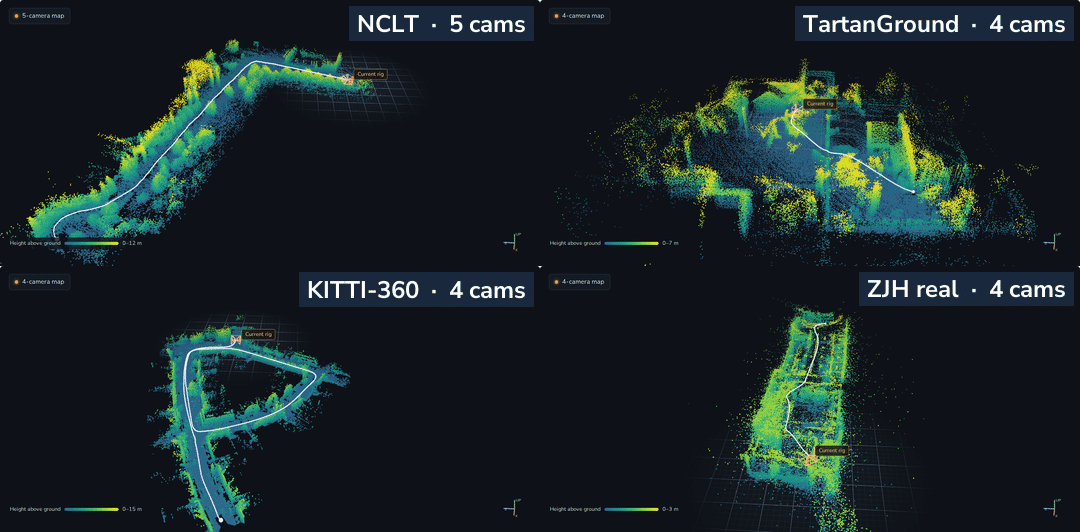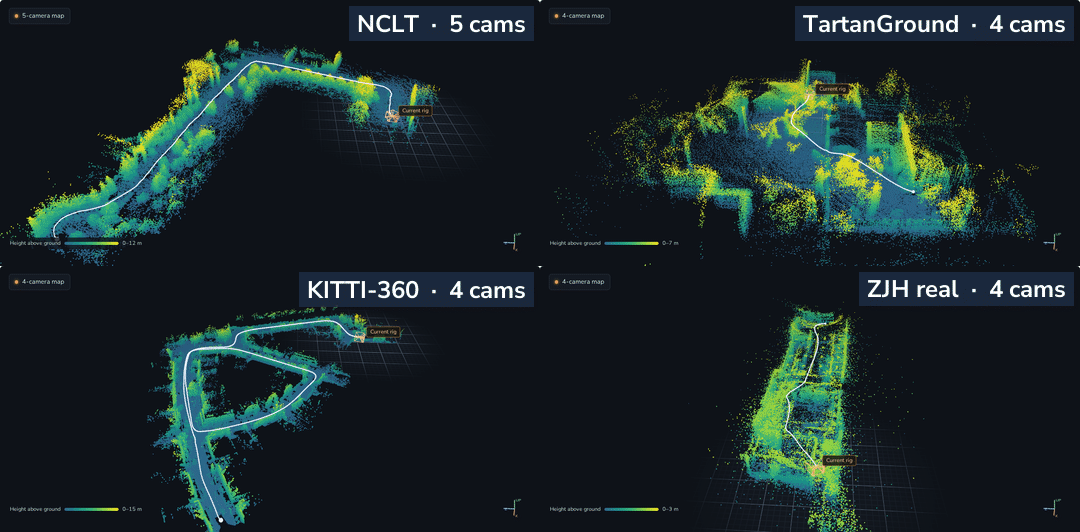
▲ 图 6|用 StreamRig 位姿逐帧拼接的点云(项目主页录屏),白线为估计轨迹,颜色表示离地高度。深度来自各数据集的参考数据(NCLT 为 LiDAR,TartanGround 为仿真深度,KITTI-360 为官方 LiDAR 融合地图,ZJH 为 COLMAP 稀疏重建),并非模型预测;各段为主页选取的连续片段,定量结论以前文表格为准。
计算与显存开销
效率测试统一在单张 RTX 4090 上进行,计时覆盖从 RGB 输入到位姿输出的全过程:
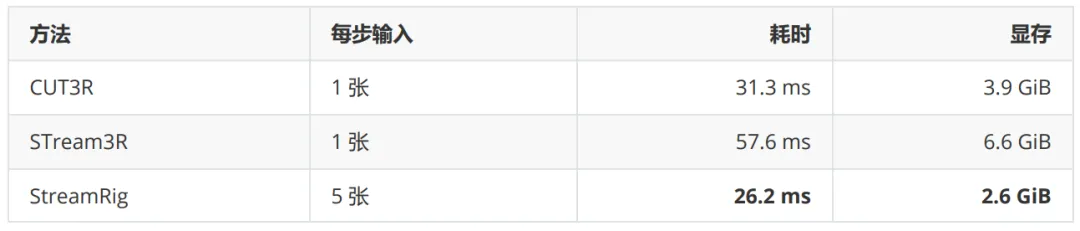
输入均为 224×224,STream3R 取窗口 5,显存为峰值;BF16,batch size 为 1,连续 512 步。测速时 StreamRig 取 N=2,前文 NCLT 精度结果对应 N=24。
换言之,处理一整组五目观测,比单目方法处理一帧还快。 耗时分解显示,感知占绝对主导:冻结骨干与 Rig-Resampler 共 24.9 毫秒,CausalBridge 与位姿头仅约 1.3 毫秒。时序模块几乎不增加成本,新增一台相机的边际开销即为感知该相机的开销。
另需指出,显存有界并非压缩本身所致,而是由重锚保证。论文给出的长历史模式固定锚点并对远端观测进一步剪枝,单步耗时仍为 26.4 毫秒,但状态随序列增长,512 组后显存达 3.0 GiB。
04 适用场景与边界
StreamRig 部署时只需同步 RGB 与标定参数,不依赖 IMU 或 LiDAR,输出带公制尺度的连续位姿。环视巡检和配送机器人、"前向双目 + 侧视"的车辆都属于其适用构型;对真机数据昂贵的人形机器人,"仿真训练、真机直接部署"的路线已在 ZJH 上得到初步验证,但真机的公制尺度仍需额外标定。
迁移到新的 rig 时,前端和网络结构保持不变,仅需用目标 rig 数据重训后端;在缓存前端特征的前提下,NCLT 模型约需 48 个 RTX 4090(24 GB)GPU 小时。
需要说明的边界:当前每种 rig 需分别训练,且依赖事先标定;真机实验总长约 360 米,规模有限;效率数据来自桌面 GPU,机载算力上的表现尚待验证。
05 消融与分析
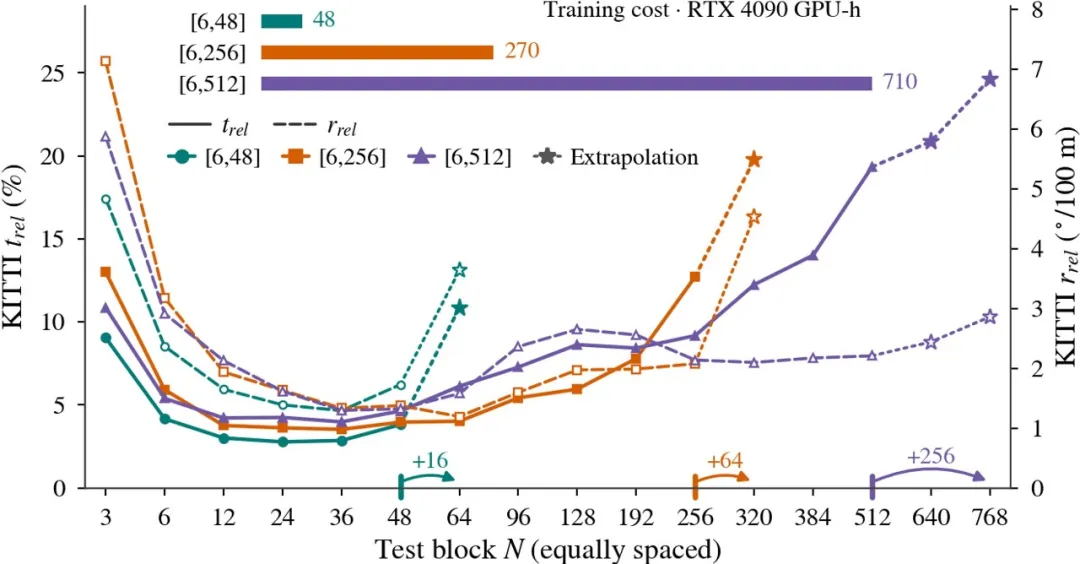
▲ 图 7|NCLT 两条完整路线上的重锚间隔扫描。实心点为平移漂移(左轴),空心点为旋转漂移(右轴);不同颜色对应不同训练窗口,星号表示外推至训练范围之外,顶部条形为估算的 RTX 4090 训练成本。
重锚间隔存在折中。 平移漂移随 N 呈 U 形变化。锚点过近,轨迹被切成许多短跳,每一跳都叠加单次估计的噪声底;锚点过远,两组可能失去共视,只能靠中间组接力,且位移逐渐超出训练分布------诊断显示输出位移会在训练最大位移附近饱和。以 6, 48 训练的标准模型在 N≈24 处最优,N=48 时小幅上升,N=64 时急剧变差。
更长的训练窗口换来的是射程,不是精度。 训练窗口放宽到 6, 256 与 6, 512 后,U 形右支明显右移,可用锚距随之扩大;但最低漂移并未下降,训练成本却从约 48 GPU 小时升至 270 与 710 GPU 小时。
公制监督的收益超出尺度本身。 由于 MapAnything 输出公制几何,StreamRig 可直接以公制位姿训练。换成 STream3R 式的无尺度损失并在评测时补做尺度对齐,NCLT、TartanGround 的平移漂移仍分别升至 6.87% 和 27.51%(原为 2.77% 与 12.70%)。
潜变量数与前端的可替换性。 每相机潜变量减半至 8 个,平移漂移最多增加约 18%;加倍至 32 个,旋转漂移下降约四分之一,但训练计算约为三倍,故默认取 16。前端换成 Depth Anything 3 或 π³X 同样可以训练和流式推理,重锚曲线也呈 U 形,MapAnything 最优;论文认为差异来自前端暴露 rig 内几何的直接程度(逐像素射线条件化最为直接),而非参数规模。
06 结论与展望
综合全文实验,StreamRig 给出了三点结论:
- 联合 rig 感知与时序历史是两种互补的精度来源。 前者由冻结基础模型在每组内一次完成,提供深度与视场;后者以压缩状态跨步传递,抑制串接误差。二者结合的代价很低,时序部分每步约 1 毫秒。
- 基础模型迁移需要合适的初始化。 冻结前端提供几何先验,组间重定位预训练则提供有限 rig 数据无法单独给出的对齐能力;两者结合,才使仅训练 11.7% 参数、仅用位姿监督的方案成立。
- 流式推理的关键超参数是重锚间隔。 锚距过短累积跳变误差,过长失去共视并越出训练分布;加长训练窗口能扩大可用锚距,但需付出数倍训练成本。
展望方面,NCLT 上的探索性试验提示,压缩后的 rig token 或可用于同一采集序列内的重访检索,但论文未对此做定量评估,判定阈值也仍需逐序列调整。后续工作将研究可迁移的回环触发并把重访纳入流式状态,同时对位姿与稠密几何进行联合优化,让已累积的地图约束之后的估计。
项目主页
项目主页*(weiyufei0217.github.io/StreamRig)*汇总了完整结果表、方法视频和上述四段可交互点云:读者可以在浏览器中切换单相机与全部相机、StreamRig 与参考位姿、RGB 与高度着色,并拖动时间轴回放建图过程。
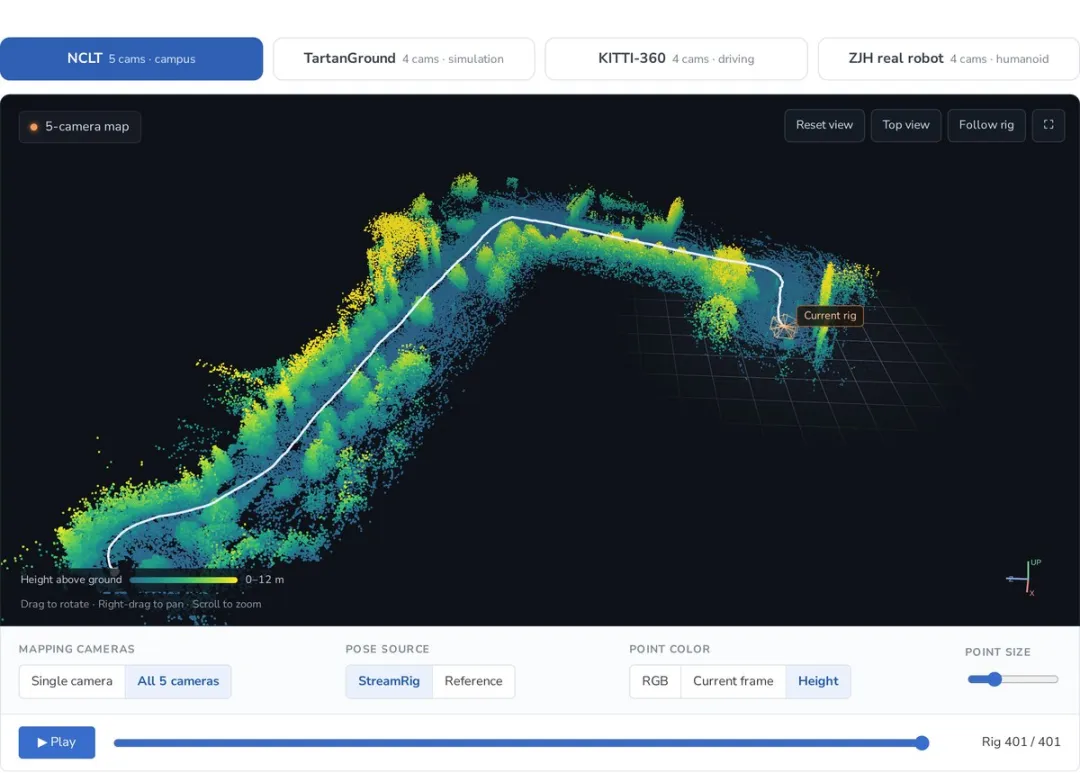
▲ 图 8|项目主页的交互式 3D 建图界面(NCLT)。