2026 年 10 月 8 日,安全厂商 Zenity Labs 公开了一条代号 AgentCorruption 的漏洞链,目标是亚马逊 Bedrock AgentCore。研究者向一个对外暴露的智能体发出一条自然语言提示,最终拿到了同一个 AWS 账号与区域内全部智能体的控制权。
整条链上没有一步是模型违抗指令。智能体被要求去抓一个地址,它就抓了;被要求把抓到的东西转发出来,它就转了。Dickson Research 首席分析师 Frank Dickson 对 CSO Online 的说法是,智能体完全照它被要求做的去做了,这就是问题所在。失控的一环在授权半径上。
一条提示词与整片区域
研究者用 Strands SDK 部署了一个简单智能体,让它向实例内置的元数据服务发起请求,再把返回内容 POST 到研究者的监听地址,请求成功。
按设计,智能体运行在 Firecracker microVM 里,这道边界本该拦住通往元数据服务的流量。Zenity 的记录是,microVM 没有提供足够的网络隔离,本该对抗的那道沙箱边界根本就不存在。
不给智能体原始的 HTTP 工具也解决不了问题。隔离失效发生在平台层,任何能产生出向流量的东西都能触达同一处,研究者用 Strands 内置的 shell 工具复现了同样结果。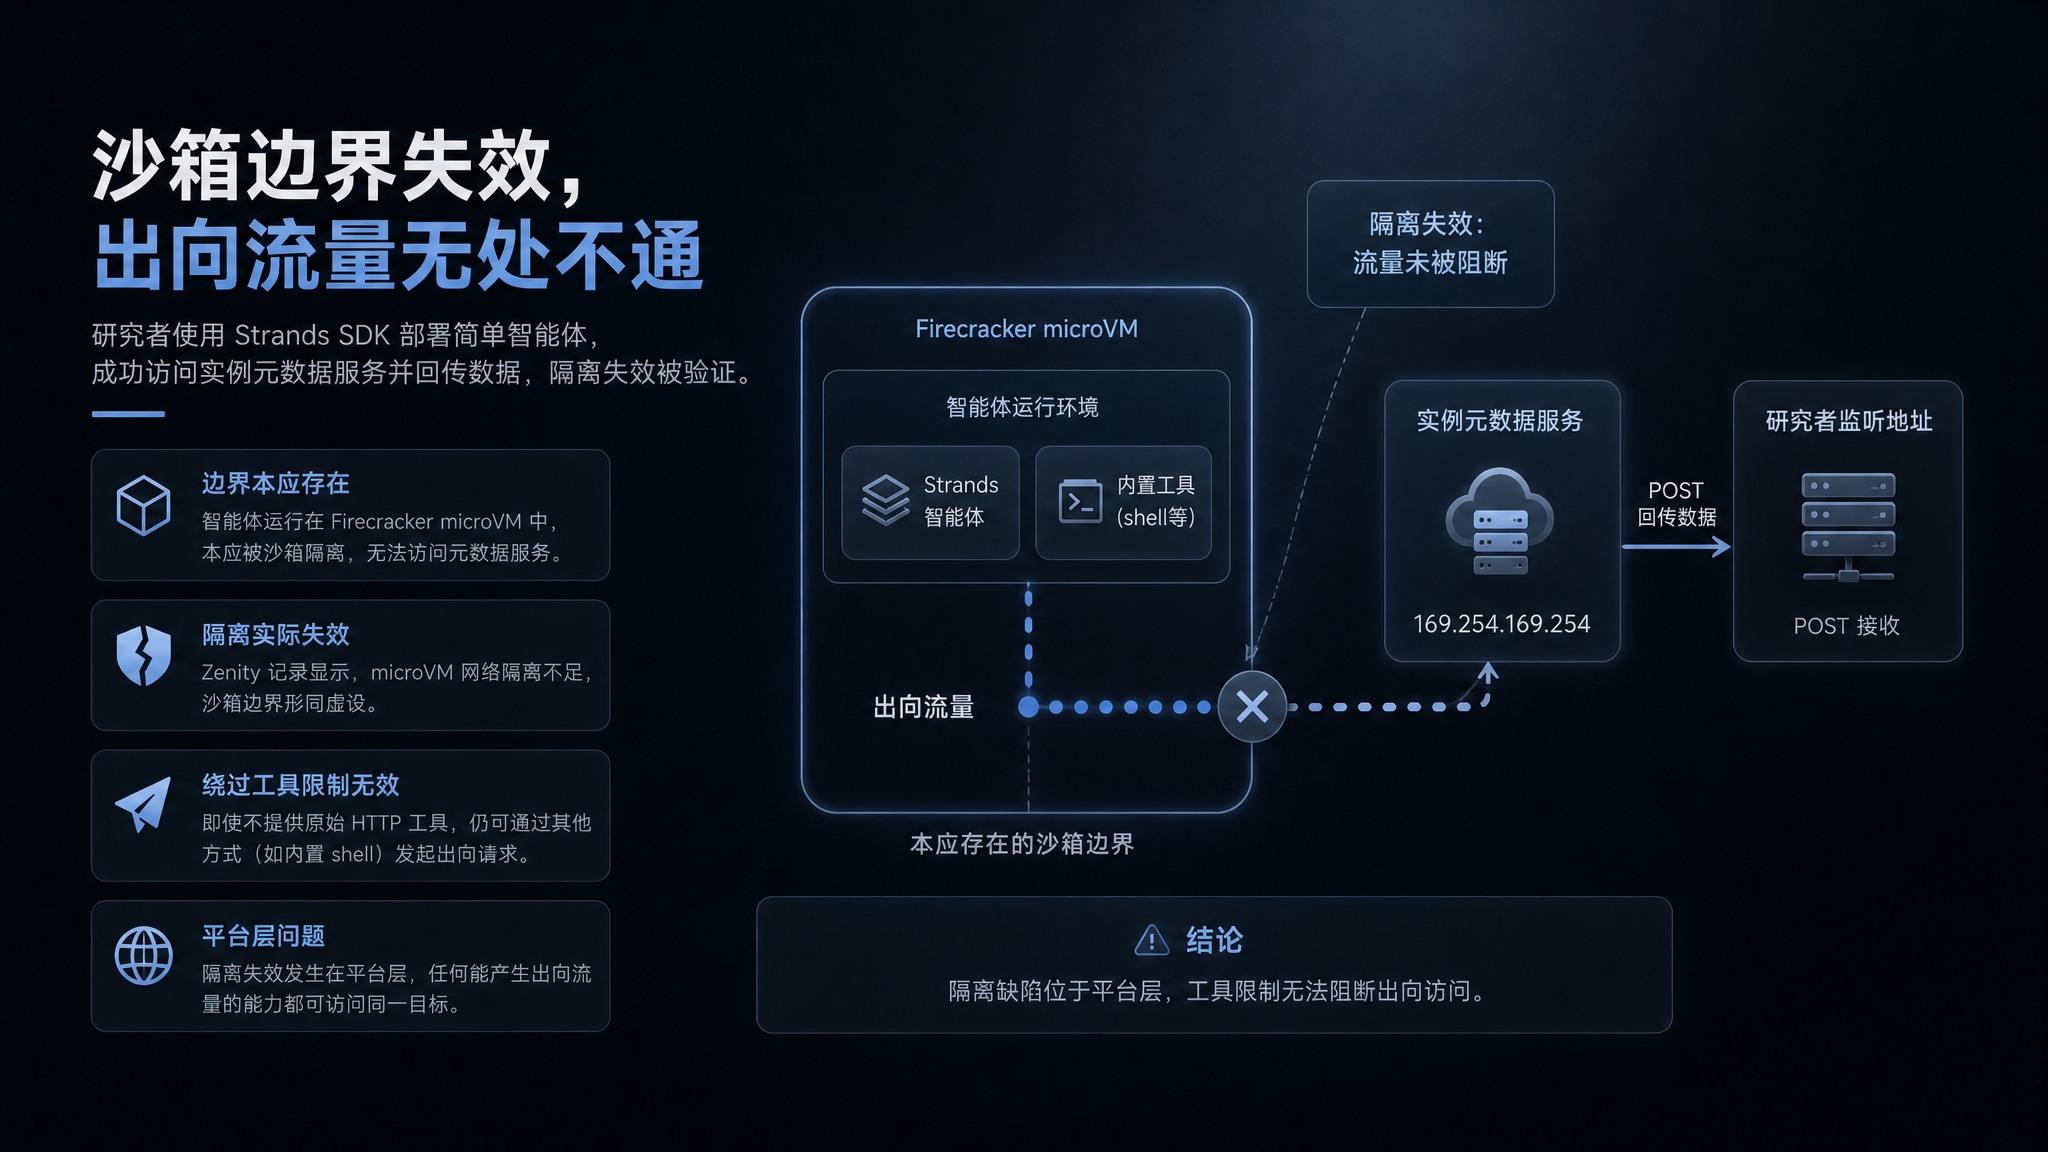
默认角色手里的钥匙
元数据端点交出的是智能体执行角色的一整套临时 STS 凭据:访问密钥 ID、秘密访问密钥与会话令牌。研究者把它们导出到自己的机器上,完全在 AgentCore 之外,仍然有效。
凭据背后是默认执行角色的授权范围。logs:DescribeLogGroups 的资源是整个区域的 log-group:,据此能列出区域内所有已部署智能体;ecr:BatchGetImage 与 ecr:GetDownloadUrlForLayer 的资源是 repository/ ,可拉取账号与区域内任意镜像,仓库以智能体名命名,研究者的工具几秒内取到全部智能体源码;ListActors、ListEvents、ListSessions 的资源是 memory/,区域内用户与智能体的私人对话因此可读;secretsmanager:GetSecretValue 的资源路径以 /oauth2/ 与/apikey/* 结尾,覆盖整个区域的每一个 provider。
InvokeAgentRuntime 通向本不该被触碰的内部智能体。Zenity 的概括是,单个智能体成了通往它周围一切的入口。Dickson 的比喻更直接:把这些权限串起来,一个对外的智能体就成了能打开这栋楼每一个房间的酒店房卡。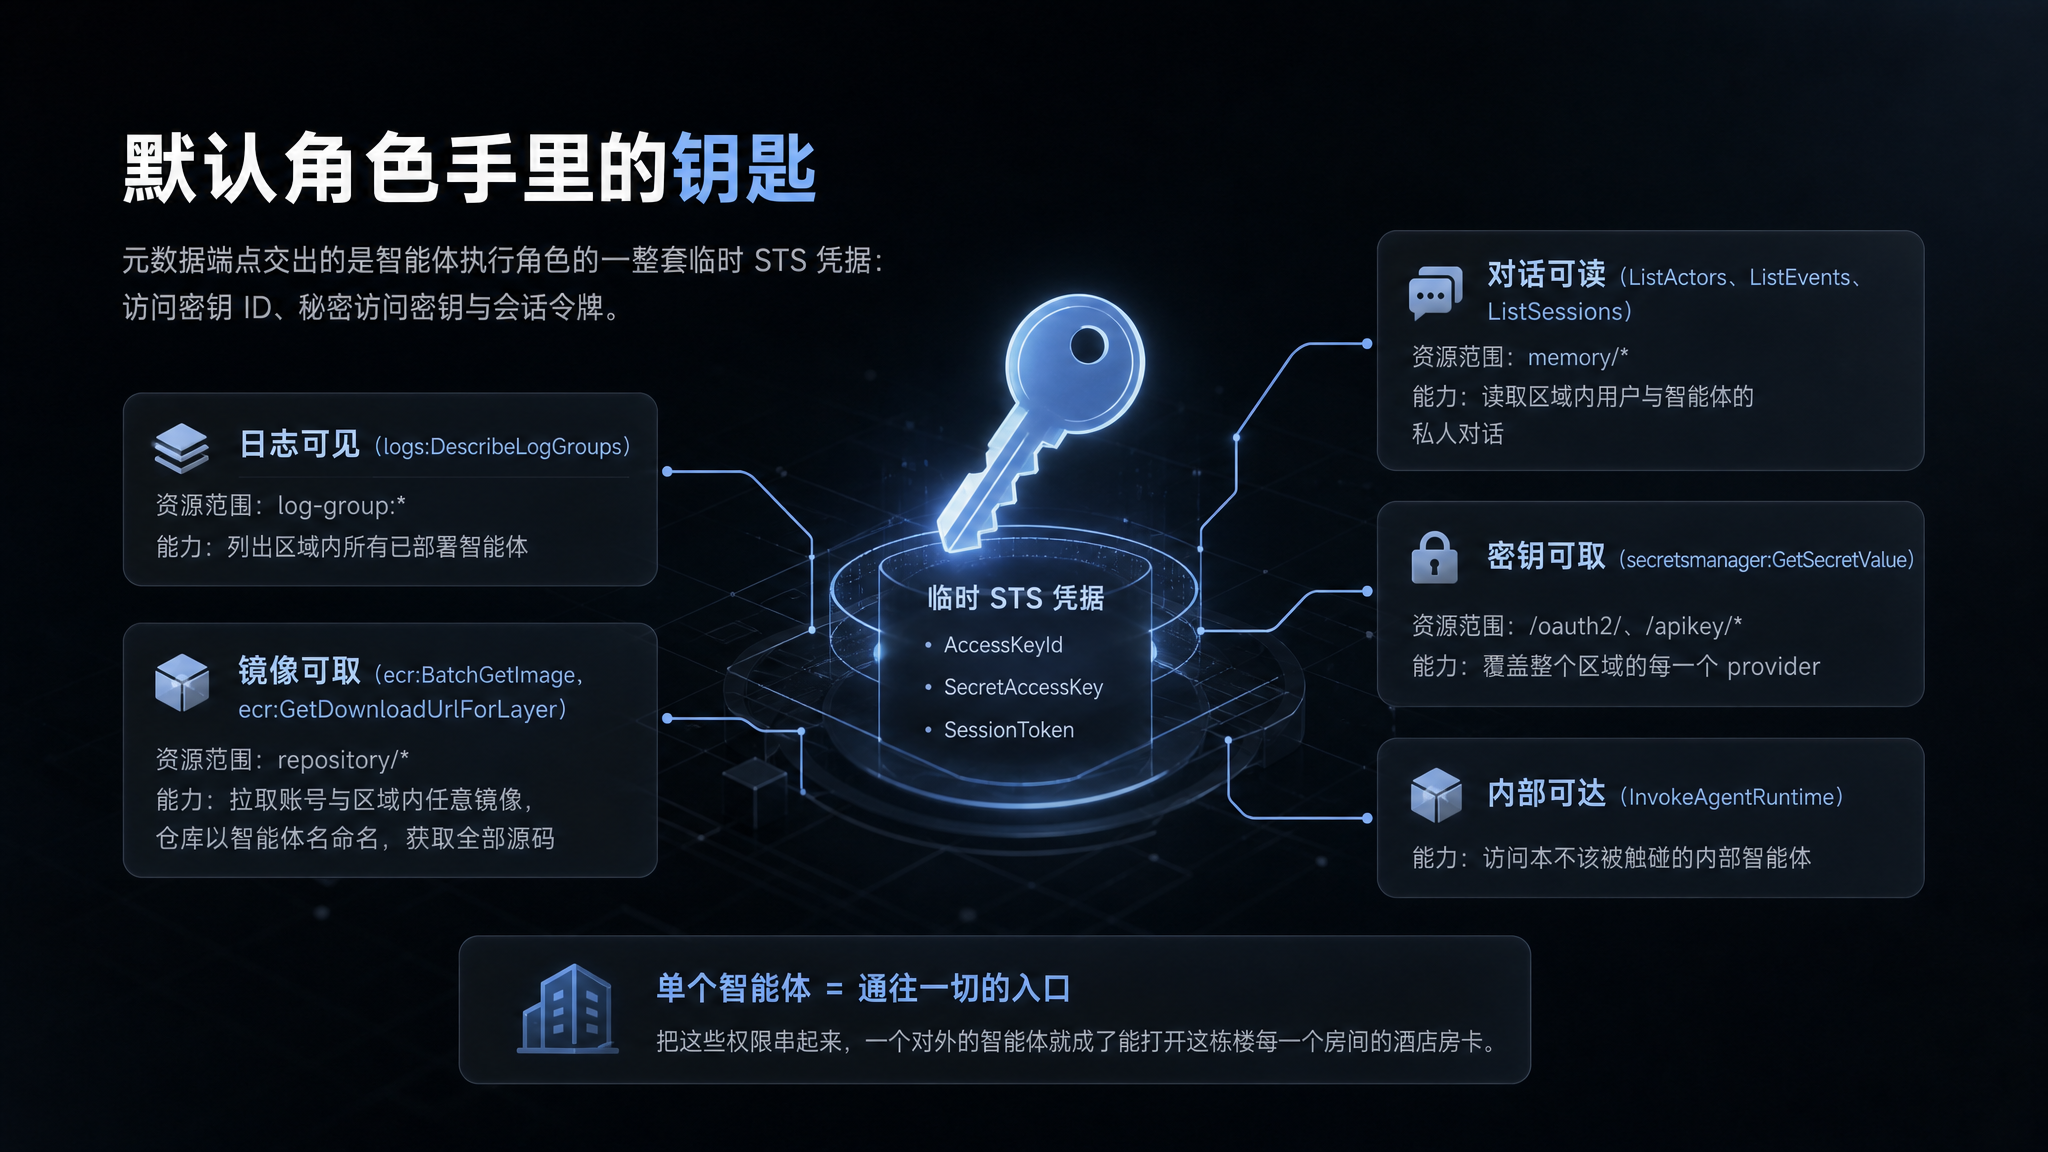
被写进记忆的那句话
AgentCore 的长期记忆有四种内置策略:SEMANTIC、USER_PREFERENCE、SUMMARIZATION 与 EPISODIC。写入手法是提交一条短期记忆事件,由记忆配置的策略提取为持久记录。
研究者针对四种策略分别构造注入文本,落点一致:把后续指令委托给一个攻击者控制的页面,要求智能体每次回答前都去访问并照做。改一次页面就能改下一次的指令,不必再次投毒;同一页面随后还让智能体把用户消息与自己的回复发到收集端点。
用户面对的仍是一个看起来正常的智能体。
九个月的那张时间表
2025 年 12 月 25 日,Zenity 向 AWS 提交首份报告,内容是元数据服务可达;2026 年 1 月 12 日追加第二份,指向默认角色过宽带来的影响半径。报告与公开之间隔着九个月。
2 月 25 日,AWS 告知正在处理底层问题,但默认 IAM 角色保持不变。4 月 12 日,AWS 回应首份报告并以 informative 关闭,同时提到自 2 月 14 日起 AgentCore 已改为仅使用 IMDSv2,新部署的智能体均以 IMDSv2 启动。6 月 22 日 Zenity 复查,默认执行角色权限与年初一致。
9 月 29 日,发布前最后一次复查,研究者观察到默认执行角色发生实质性变化:跨区域执行智能体、读取私人对话、访问 Secrets Manager 所存密钥的权限已移除,其他权限也大幅收紧。AWS 未公布自己的修复日期。据 CSO Online 报道,AWS 发言人在邮件声明中表示,该研究把预期且有文档记录的行为不准确地说成是漏洞。Zenity 的披露未给出 CVE 编号,并表示在 AWS 修复前未发现被在野利用的证据。Zenity 自身销售智能体安全平台,2026 年 8 月完成 1.25 亿美元 C 轮融资。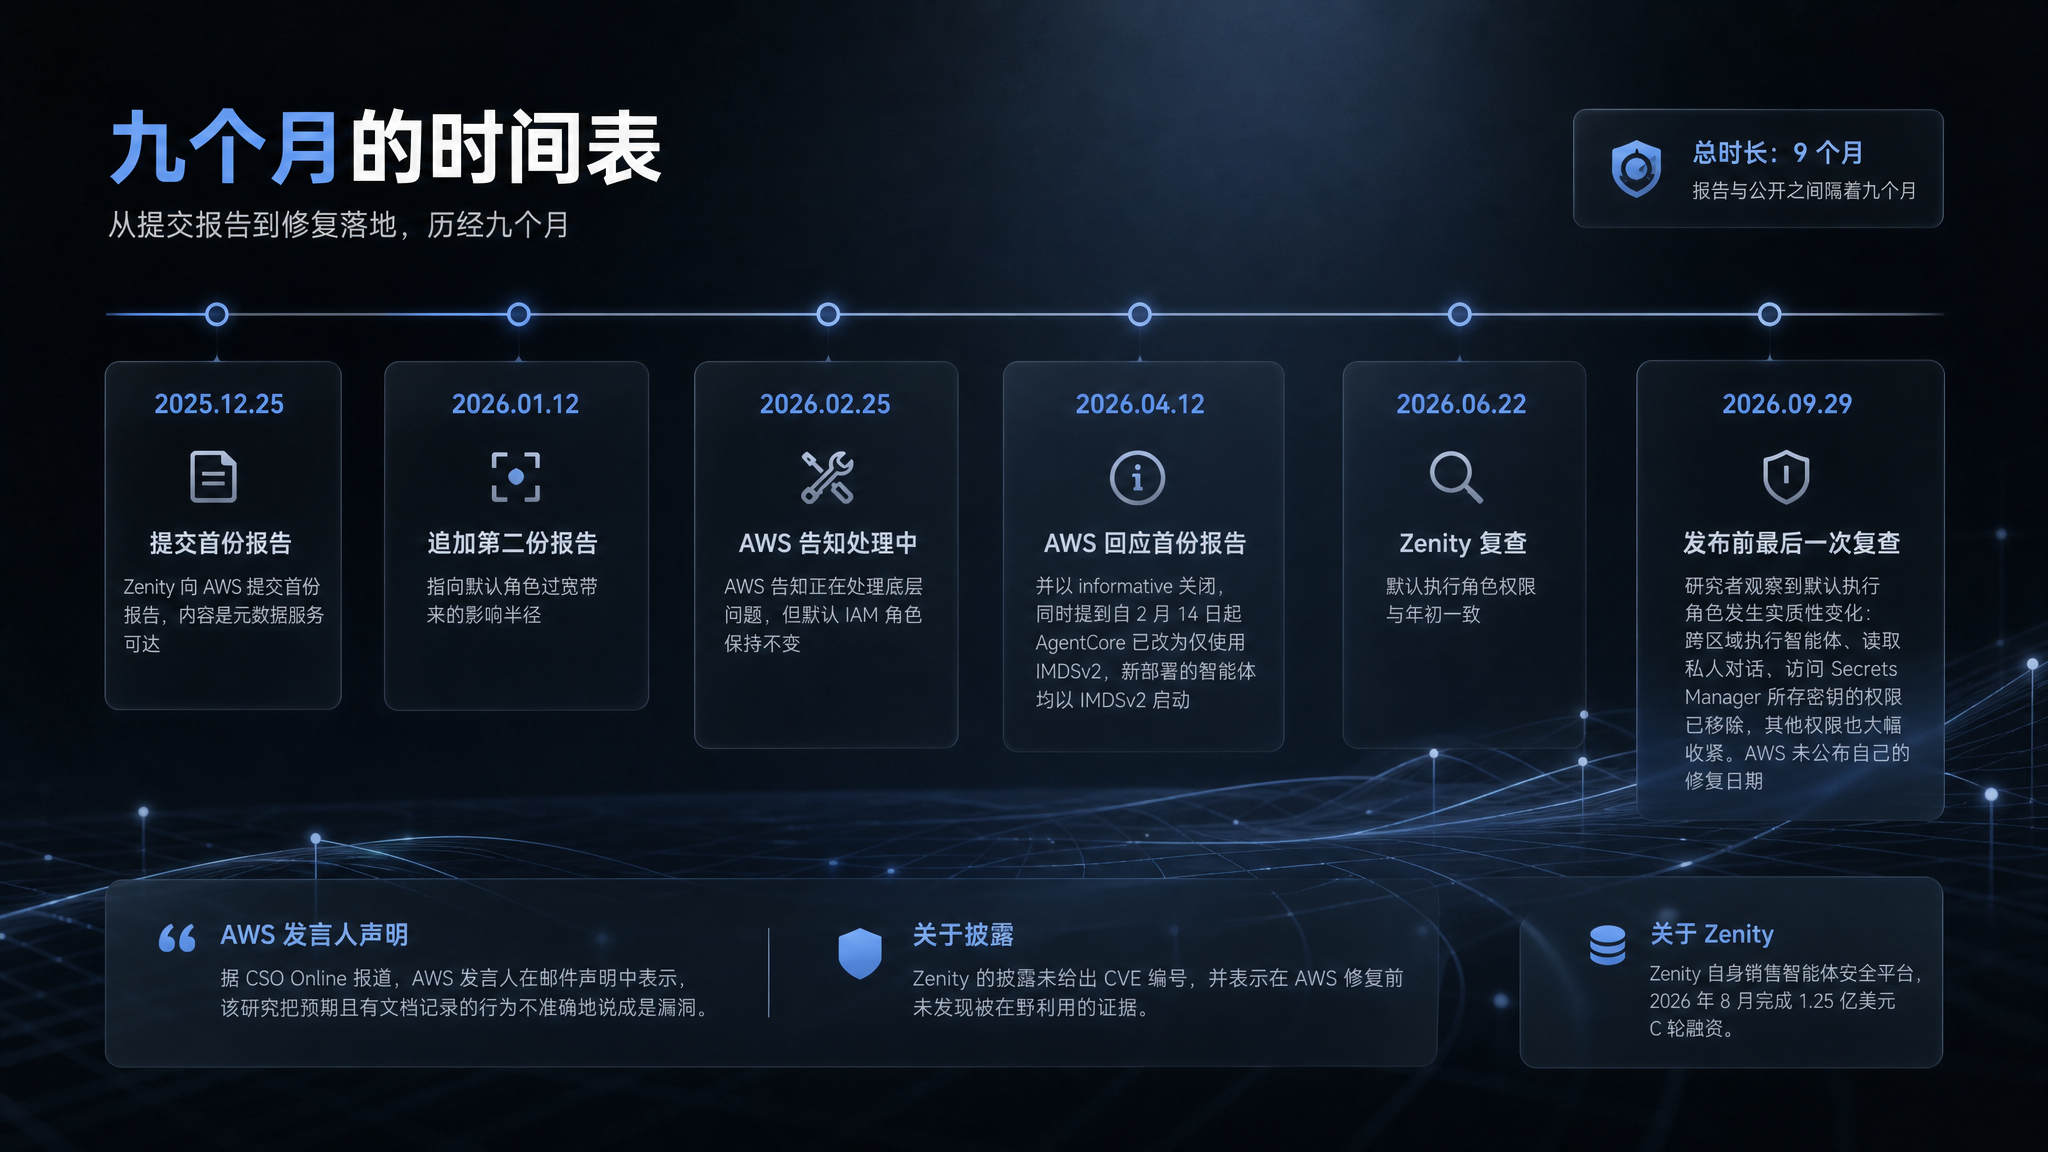
钥匙能开几把锁
被放大的那一环在权限范围上,不在凭据本身。STS 凭据几小时后过期,权限范围不会跟着过期;研究者为了跑完 Secrets Manager 的枚举,还得另写一个流程去元数据端点上续期。
织灵 Coda Loom 在这一层的处理方式是权限最小化:智能体按任务所需申请能力,拿不到超出范围的授权。任务触及涉密文件、涉密路径与涉密工程时,自动切换为私有模型调用,并向使用者给出提示。
结构上也做了收窄。织灵采用主从多智能体架构,各智能体上下文完全隔离、窗口独享,单个子智能体接触不到主任务全貌,一次越权的影响面积止于它自己那一段。
再一层是部署形态决定的作用域。织灵支持私有化部署,企业代码资产与研发数据完全运行于内部环境,智能体的作用域画在企业自己的网络里,不需要对外暴露入口。Zenity 在披露末尾给企业的建议也是同一条:界定并审查授予智能体的权限,坚持最小权限,并监控运行时活动。
凭据放在够不着处
凭据进入模型的上下文,等同于把钥匙交了出去。织灵的凭证保险箱把凭证放在模型够不着的地方:凭证由用户在后台配置,存储在隔离的加密数据库中,仅系统调用的工具可以访问并解密,解密过程对模型透明、无感知。模型发出调用请求,拿到调用结果。
够不着之外还有一层是使用过程。智能体的文件操作与命令执行发生在织灵沙盒内,与平台核心程序分开;可执行的命令、可访问的路径与文件权限由中心端统一管控,命令黑名单在中心侧生效。AI 行为监控器采用事前硬编码拦截与事后审计留痕结合的方式,对工具调用实时拦截,拦截规则由企业按自己的研发规范自定义,哪一次被放行、哪一次被拦下,事后都有记录。
每一次大模型调用使用的是哪个模型,事后可以逐条查。约束行为依靠的是执行层的拦截规则,不依赖模型的自觉。
写进记忆的能倒回去
记忆这一环最不好处理。只要记忆能被写入,就存在被写入恶意内容的那一面,织灵的过程沉淀与记忆沉淀同样如此,这一点没有例外可讲。CoSAI 成员、ACM AISec 程序委员会委员 Nik Kale 对 CSO Online 的说法是,被盗的凭据几小时后就过期,而被投毒的记忆不会,每一把密钥都轮换过之后,它仍在持续引导对话。
可达智灵对这件事的处理方式落在写入之后:查不查得到,退不退得回去。
织灵把审计与可追溯作为一项基础能力,每一次 AI 改动可审计、可回滚、可解释,配合权限隔离、操作日志与合规报告。每一次大模型调用有记录,每一次会话与操作有留痕,写入了什么、由哪一次会话写入、影响了后续哪些回答,事后可以逐条回看。知识沉淀按个人、项目、技术与资产四层分域存放,异常条目可以按层定位。
回滚是这一层的落点。发现记忆被污染之后,处置动作是把它退回污染之前的状态。Dickson 的说法是,被投毒的记忆像一个被植入指令、只等某一次对话就把人带向不该去的地方的潜伏者;密钥可以轮换,难的是知道哪些记忆还能信。判断哪一条记忆可疑这件事交给人和记录,不交给模型。
配套的还有节点上的人。织灵把研发 SOP、规范、标准与流程配置进工作流,任务推进到需要人拍板的节点时通过企业 IM 通知到人,审批人在 IM 内确认或驳回。写入可以自动发生,接受结果由岗位上那个人决定。
公网平台与企业内网
AgentCore 是公有云平台上的托管服务,攻击起点是一个对外暴露的智能体。研究中出现的账号与区域是 Zenity 自有的测试环境,被攻陷的智能体由研究者自己用 Strands SDK 部署,Zenity 未给出受影响客户数量的说法。
织灵运行在企业内部的研发组织里,面对的是企业自己的代码、文档与系统,风险主要来自越权与误操作。两者属于不同的威胁模型,织灵的可控性针对的是后者,不等于可达智灵能抵御同类攻击。
自由度与最小权限
据 CSO Online 报道,Zenity 联合创始人兼 CTO Michael Bargury 的判断是,智能体需要自主性与连通性才有用,可它们彼此冲突,正如这项研究所显示的;企业应当意识到这种内在冲突,并据此规划自身的安全控制。这组冲突不会消失,只能靠机制去承接。
承接的位置在运行时。权限是默认给的还是按需给的,凭据在谁手里、什么时候失效,写进记忆的东西能不能退回上一版,答案都落在工程实现上,不落在模型选型上。
可达智灵把可控性放在产品主线的位置。织灵交付给研发组织的,是边界明确的智能体能力:任务在沙盒与授权范围内推进,过程与记忆留痕可查。边界清楚、留痕完整,企业才敢把更多研发环节交给智能体。