第一章 用大白话理解 RAG
1.1 先讲个故事
想象你雇了一位特别聪明、但刚来公司第一天的员工。他上知天文下知地理,可就是不了解你们公司的业务。你问他「我们产品的退款政策是什么」,他只能凭感觉瞎编一个答案------这就是大模型(比如 ChatGPT)的现状。
现在,你给他配了一本《公司业务手册》,告诉他:「回答之前,先翻手册,照着手册说。」他立刻就能准确回答了------这就是 RAG。
RAG = Retrieval(检索)+ Augmented(增强)+ Generation(生成)
翻译成人话:先检索资料,再让AI基于资料生成回答。
1.2 为什么 RAG 这么重要?
大模型有三个天生的毛病,RAG 正好能治:
- 爱瞎编(幻觉):不知道的事也敢编,RAG 让它「有据可查」
- 不懂你的私事:训练数据里没有你公司的资料,RAG 现场喂给它
- 知识过期:模型知识停留在训练时点,RAG 随时更新资料库
一句话总结:RAG 让大模型从「闭卷考试」变成「开卷考试」。
1.3 RAG 的工作流程(五步走)
第一步 · 加载:把你的文档(PDF/Word/TXT)读进系统
第二步 · 切分:把长文档切成一段段小知识块(就像把书拆成一页页卡片)
第三步 · 建索引:给每块内容建立「特征指纹」,方便快速查找
第四步 · 检索:用户提问时,找出最相关的几块资料
第五步 · 生成:把找到的资料 + 用户问题一起交给大模型,让它照着资料回答
第二章 深入一点:RAG 的技术原理
2.1 为什么要「切分」?
大模型的「记忆窗口」(上下文长度)是有限的,不能一次塞进去一整本书。而且资料越杂,模型越容易抓不住重点。所以要把文档切成小块,每次只把最相关的几块喂给模型。
切分策略很关键:切得太碎,语义不完整;切得太粗,检索不精准。本工具采用「按段落/标题切分 + 超长段落二次切分」的智能策略。
2.2 怎么找到「最相关」的资料?
这一步叫「向量检索」。核心思路是:把每块资料和用户问题都转换成一串数字(叫「向量」),然后计算它们之间的「相似度」,越相似越相关。
专业方案用「嵌入模型」(Embedding)把文本转成向量。本工具为了让老板您零门槛使用(不用下载几个G的模型),采用了轻量级的 TF-IDF 方案,效果同样可靠,且完全离线。
2.3 为什么能防止瞎编?
关键在于「提示词约束」。我们明确告诉大模型:「只准用参考资料回答,资料里没有就说不知道。」这就把模型的发挥空间限制住了,从源头掐掉幻觉。
2.4 RAG 的进阶方向
- 混合检索:向量检索 + 关键词检索,取长补短
- 重排序(Rerank):对初步检索结果再精排一遍
- 多轮对话:记住上下文,支持追问
- 多模态:支持图片、表格、扫描件的理解
第三章 动手:做出你的小工具
3.1 工具介绍:智答宝
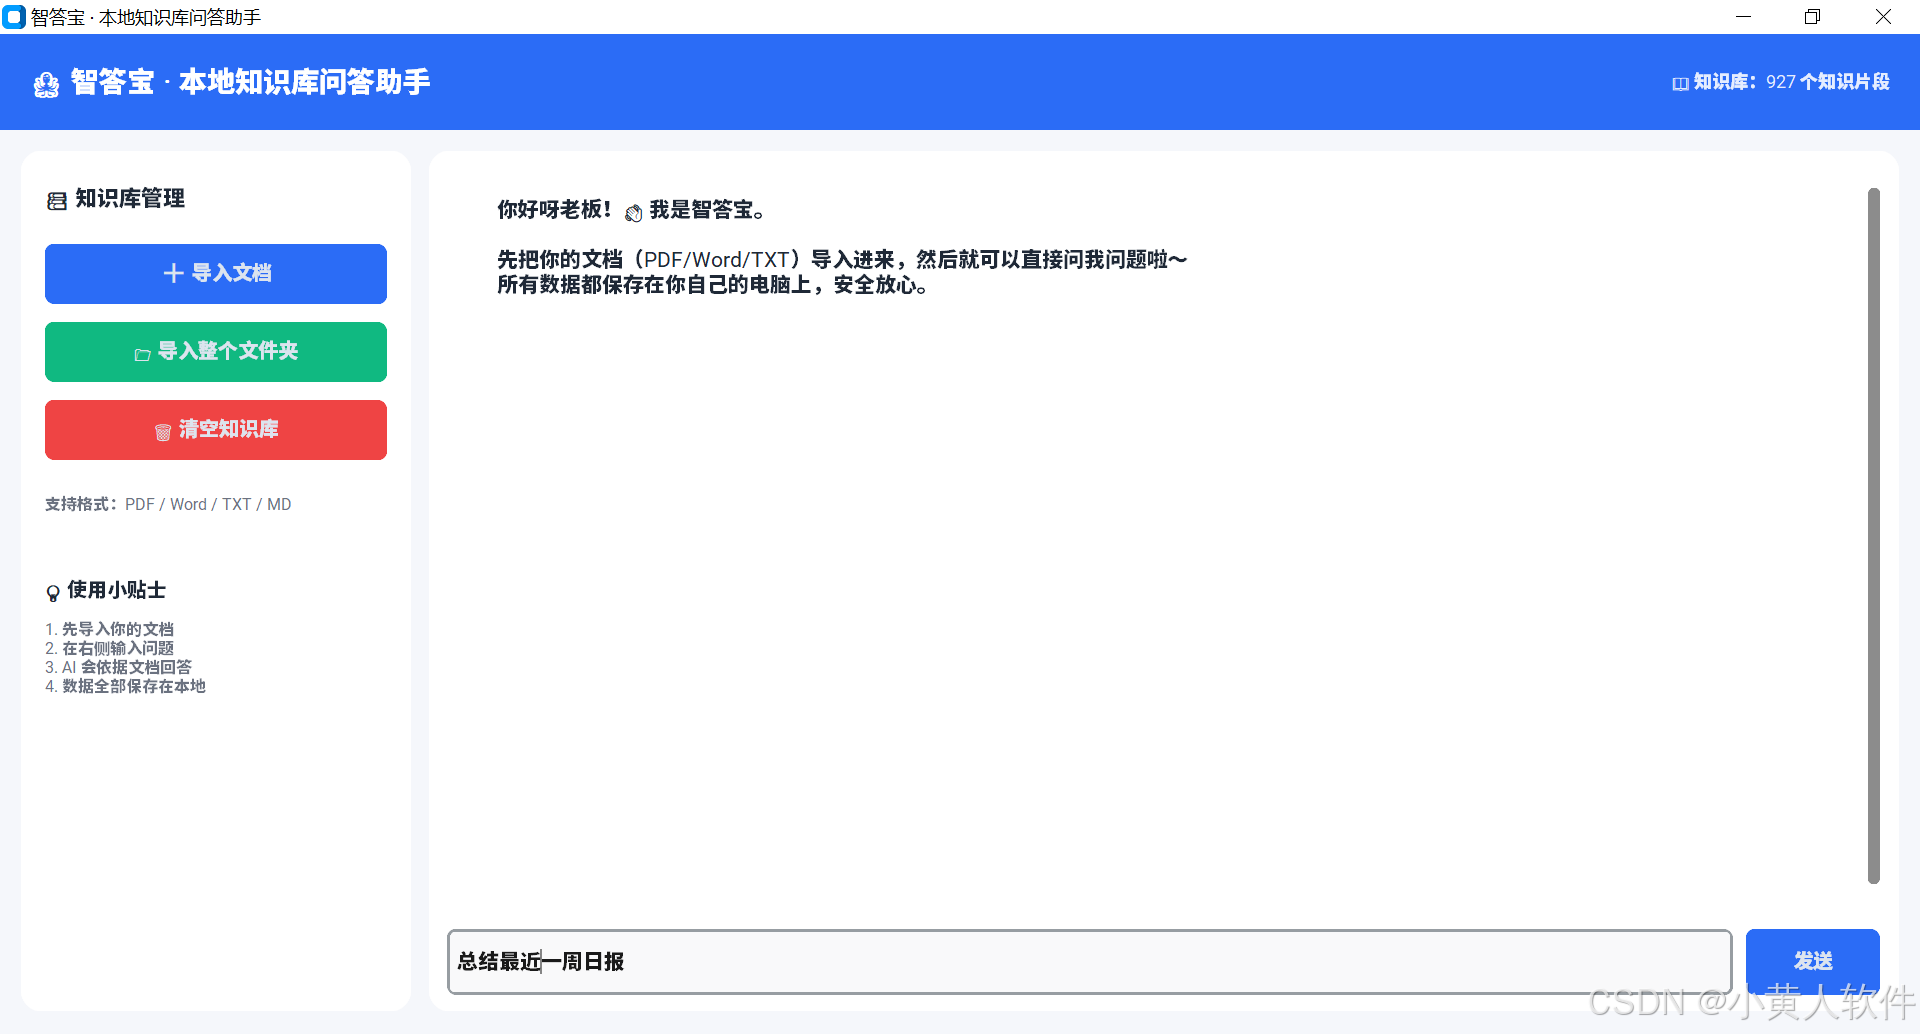
「智答宝」是一款本地知识库问答助手,具备以下特点:
- 支持导入 PDF / Word / TXT / MD 文档
- 自动切分、建库,一键完成
- 基于你的文档回答问题,并标注出处
- 纯本地运行,数据不出电脑,隐私安全
- 界面友好,双击即用,无需编程基础
3.2 怎么用?
第一步:双击运行 app.py(或打包后的 exe)
第二步:点击「导入文档」或「导入整个文件夹」
第三步:在右侧输入框提问,比如「这份合同的付款周期是多久?」
第四步:AI 依据你的文档给出答案,并列出参考来源
3.3 技术架构
整个工具由五个模块组成:
- loader.py:文档加载与解析(PDF/Word/TXT)
- splitter.py:智能文本分块
- vectorstore.py:本地向量库(TF-IDF 检索)
- llm.py:大模型调用与提示词约束
- rag.py:RAG 主流程串联
界面采用 CustomTkinter,现代美观,跨平台可用。
第四章 谁需要RAG工具?
4.1 为什么 需要RAG 工具?
因为它解决的是企业的「真痛点」------每个公司都有一堆文档,员工找不到、客户问不停、新人上手慢。而市面上的方案要么贵,要么要上云,很多企业(尤其是中小企业)对数据安全很敏感。
本地部署 + 私有数据 + 低成本 = 强需求 + 高溢价