SEED-V数据集下载:https://gitee.com/CodeStoreHub/cbra-mod-seedv
算法源码下载:https://gitee.com/CodeStoreHub/cbra-mod-seedv
通过时频联合编码和空间、时间并行注意力学习脑电表示,加载预训练权重,在原始 EEG 上完成五类情绪识别。本文覆盖模型原理、数据处理、环境安装、训练流程及本次五种子实验的完整结果。
全参数微调FP321 秒 EEG 片段GPU0 顺序训练
62EEG 输入通道
200 Hz模型输入采样率
117,744处理后的样本总数
5 类情绪识别任务
01
算法原理
保留通道与时间结构,融合波形和频谱信息。
CBraMod 是一个 EEG 表示学习模型。首先在大量无标签脑电上通过掩码重建学习基础表示,再用有标签数据微调分类模型。核心由时频 patch 编码、非对称条件位置编码(ACPE)和 Criss-Cross Transformer组成。
输入 EEGB, C, N, 200
时频编码200 维 / patch
ACPE通道 × 时间邻域
Transformer12 层 / 双分支
情绪分类5 类 logits
1.1 以 1 秒为单位分块
设 EEG 有 C 个通道,每个通道分成 N 个不重叠时间片段。输入形状为 [B, C, N, 200],每个 patch 是一个通道的 1 秒波形。通道和时间片段组成二维网格,为不同方向的依赖建模提供明确结构。
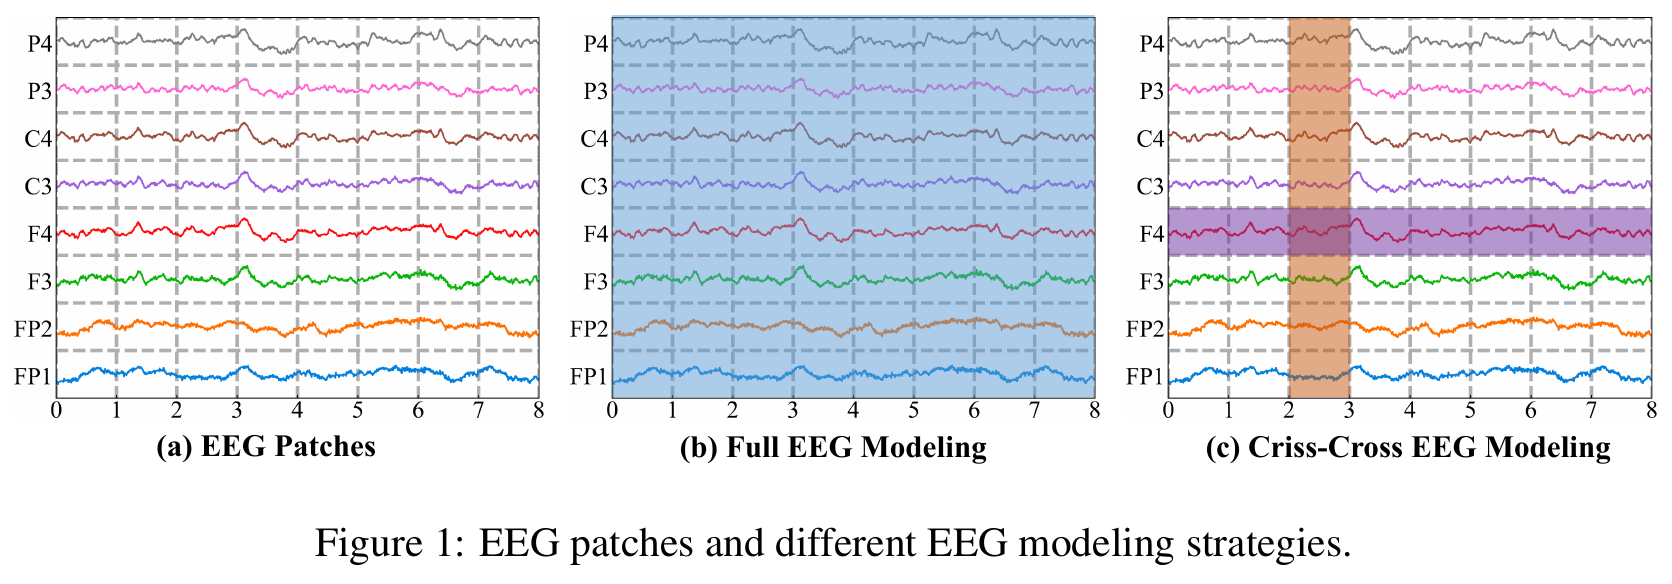
EEG 分块与建模策略。 同一时间沿通道方向形成空间条带,同一通道沿时间方向形成时间条带。
1.2 时域与频域联合编码
时域分支:学习波形变化
三层卷积配合 GroupNorm 和 GELU。沿采样点方向进行卷积,提取一个 patch 内部的局部变化,输出 200 维表示。
实现采用 Conv2d 的 (1, k) 核;这一步不跨不同 EEG 通道卷积。
频域分支:学习频谱结构
对 200 点波形进行实数 FFT,取 101 维幅值谱,经线性投影和 Dropout 得到 200 维表示,与时域表示相加。
计算:abs(rfft(x, norm='forward'))。输入是幅值谱,并非预先提取的 DE 特征。
E = Etime + Efrequency ; E ∈ ℝB×C×N×200
1.3 ACPE:从当前输入生成位置编码
ACPE 将特征调整为 [B, 200, C, N],使用深度可分组二维卷积生成位置编码,再加回原特征。卷积核 (19, 7)、padding (9, 3)、groups 200,在通道方向取较长邻域,在时间方向取较短邻域。
条件位置编码随输入特征生成,能够适应不同通道数和时间片段数。其通道轴对应输入的排列顺序;没有直接引入电极在头皮上的二维几何坐标。
Epositioned = E + DWConv19×7(E)
1.4 空间与时间注意力并行计算
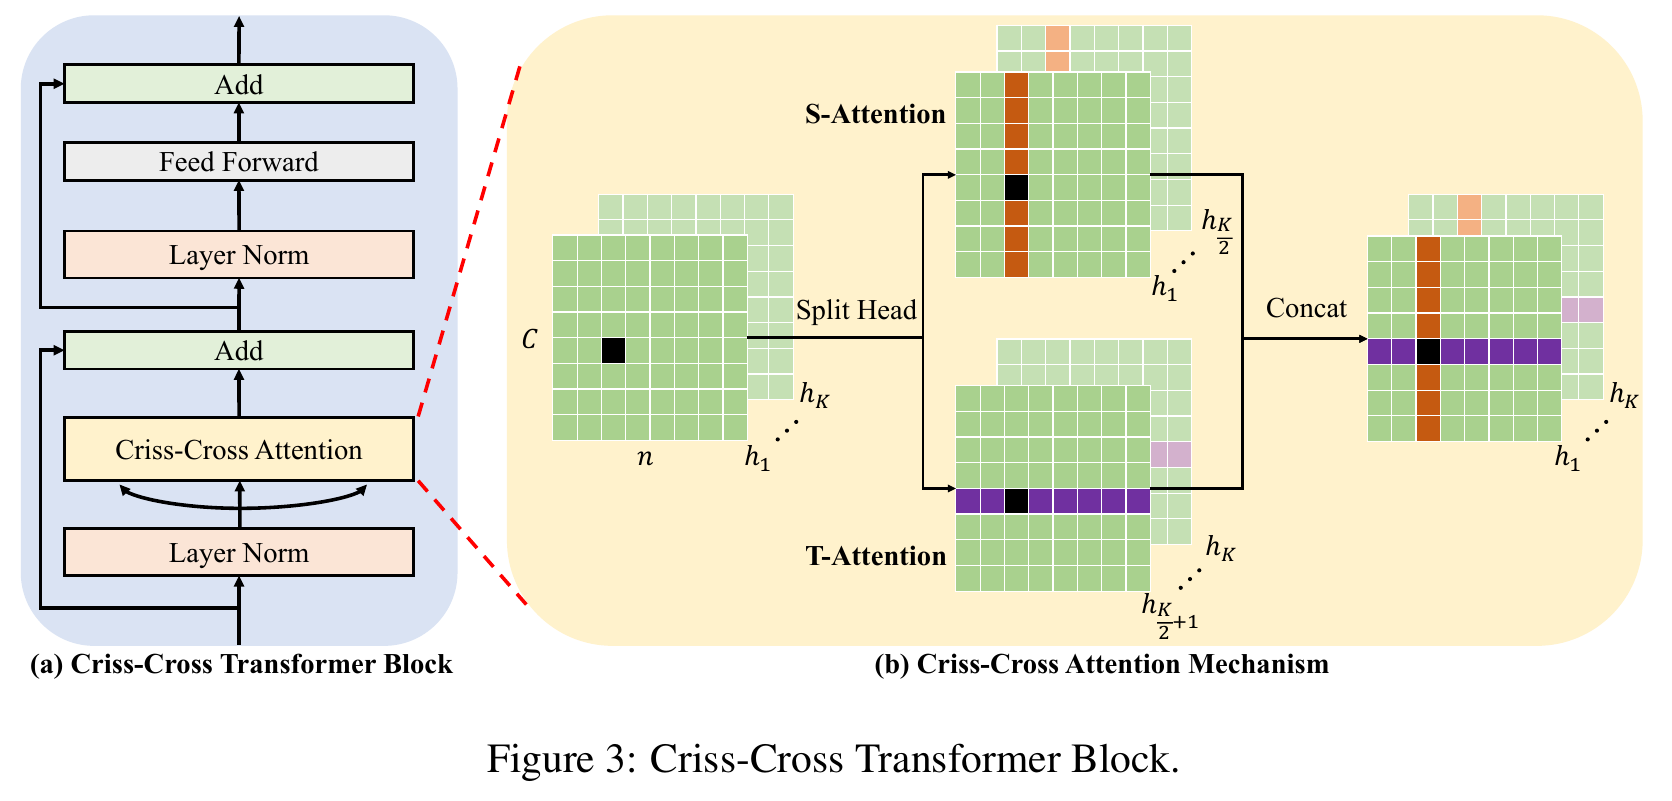
Criss-Cross Transformer。 空间分支关注同一时间的不同通道,时间分支关注同一通道的不同时间片段,拼接输出后进入残差和前馈网络。
- **空间注意力:**固定时间片段,在各通道间计算注意力,学习不同脑电通道之间的依赖。
- **时间注意力:**固定通道,在各时间片段间计算注意力,学习该通道的时间变化。
- **分支融合:**200 维特征分为两个 100 维分支,每个分支有 4 个注意力头;两路输出拼接回 200 维。
- **块内更新:**采用 pre-norm、残差连接和前馈网络,堆叠 12 层,使不同方向的信息通过特征更新融合。
| 模型配置 | 实际值 |
| 隐藏维度 / 前馈中间维度 | 200 / 800 |
| Transformer 层数 | 12 |
| 空间 / 时间注意力头 | 4 / 4,每头 25 维 |
| ACPE 卷积核 / padding | (19, 7) / (9, 3) |
| SEED-V 分类头 | 12400 → 800 → 200 → 5;隐藏层使用 ELU 和 Dropout |
| 完整模型参数数 | 14,965,805;backbone 4,883,800,分类头 10,082,005 |
|---|
1.5 掩码重建预训练与分类微调
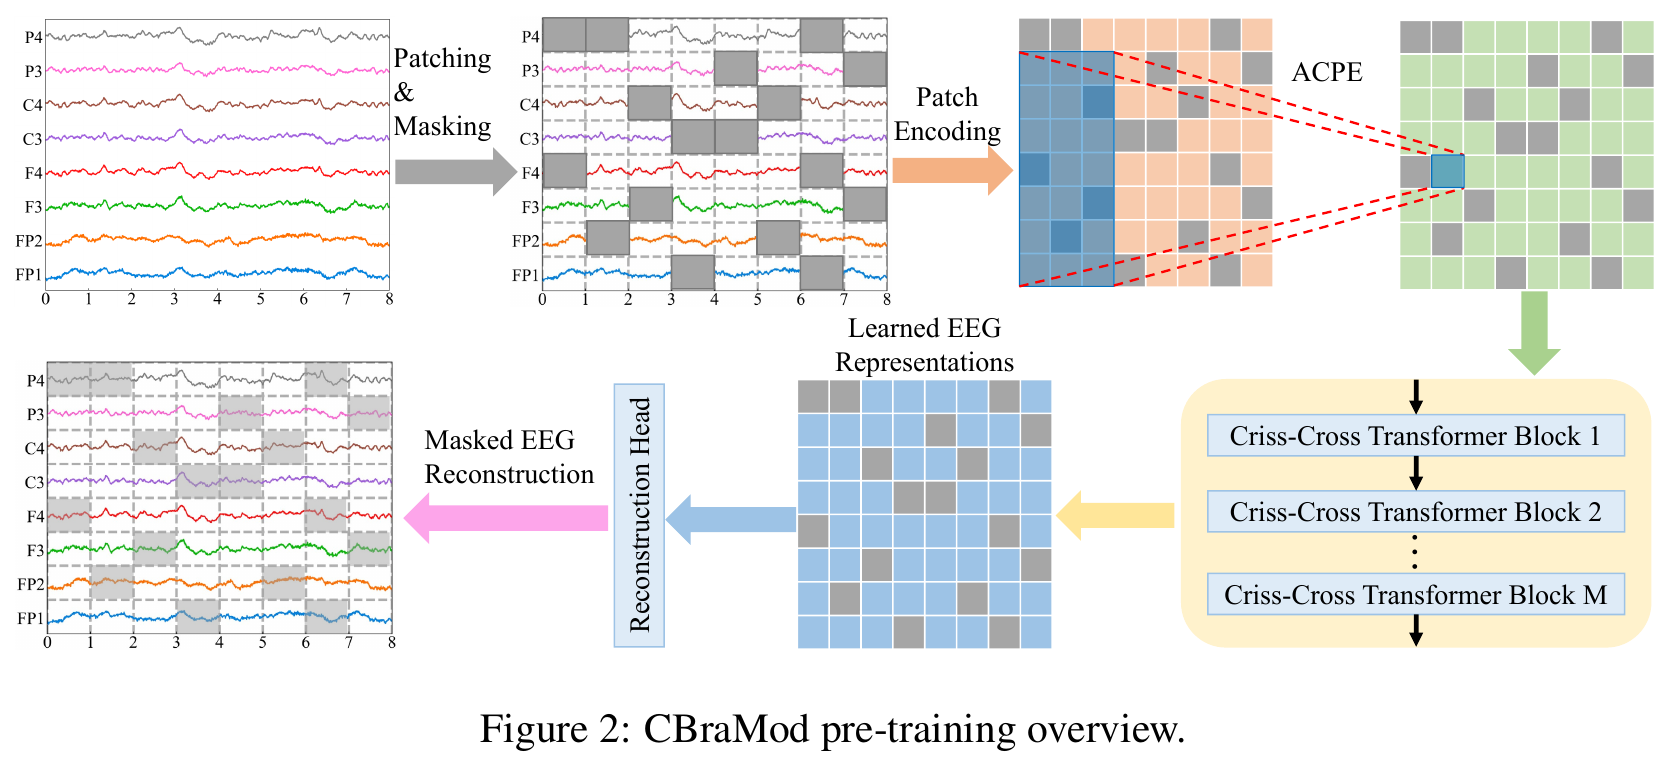
掩码表示学习流程。 先学习恢复缺失脑电片段的能力,再将表示用于监督分类。
基础预训练使用 TUEG 脑电,输入为 [B, 19, 30, 200],即 19 个通道、30 秒信号。随机遮蔽约 50% 的 patch,以重建头恢复被遮蔽波形,仅对被遮蔽部分计算均方误差(MSE)。
本次实验加载已有预训练权重,将重建头替换为分类头,并微调整个模型。训练使用带标签平滑的交叉熵,输出为五个情绪类别的 logits。
本次 SEED-V 输入的时间轴只有一个 patch。
实际输入为 [B, 62, 1, 200],经过 backbone 后展平为 [B, 12400]。时间注意力序列长度为 1,不在不同训练样本之间建模;单个 1 秒波形内部的时间变化由时域编码器提取。
02
SEED-V 数据集
以视频诱发情绪,使用原始脑电完成五分类。
SEED-V 包含 16 名被试,每人参加 3 个会话,每个会话观看 15 个视频片段,对应五类情绪。原始 EEG 使用 Neuroscan 设备记录,本项目处理 48 个 CNT 文件,保留 62 个脑电通道。原始采样率为 1000 Hz,模型输入统一为 200 Hz。
0 厌恶 · Disgust1 恐惧 · Fear2 悲伤 · Sadness3 中性 · Neutral4开心 · Happiness
数据文件命名为 被试编号_会话编号_日期.cnt,例如 1_1_20180804.cnt。会话编号由刺激材料分组决定,不应直接当成按日期排列的时间序号。原始数据中的视频起止时间与情绪顺序用于切片和赋标签。
2.1 本次使用的数据形式
本次输入:原始 EEG
CNT → 去除辅助通道 → 重采样与滤波 → 按视频试次截取 → 不重叠的 1 秒片段 → LMDB。
其他数据形式
数据包还包含提取的 DE 特征和眼动相关数据。本次训练直接读取 EEG 波形,没有使用 DE 特征或眼动融合。
2.2 按试次划分训练、验证与测试
每个会话按视频试次固定划分,先划分完整试次,再生成 1 秒样本。每个种子将全部被试与会话的数据汇总,训练一个分类模型。
训练试次 1--5 · 34,432 样本
验证试次 6--10 · 42,960 样本
测试试次 11--15 · 40,352 样本
| 划分 | 厌恶 | 恐惧 | 悲伤 | 中性 | 开心 | 合计 |
| 训练 | 5,824 | 5,600 | 11,440 | 7,488 | 4,080 | 34,432 |
| 验证 | 7,440 | 10,896 | 9,792 | 5,936 | 8,896 | 42,960 |
| 测试 | 6,544 | 7,584 | 9,440 | 10,256 | 6,528 | 40,352 |
| 总计 | 19,808 | 24,080 | 30,672 | 23,680 | 19,504 | 117,744 |
|---|---|---|---|---|---|---|
| [完整数据的类别分布] |
结果适用于当前试次划分。
训练、验证、测试包含相同被试。这里的成绩不能解释为跨被试 LOSO 或跨会话泛化结果。各类样本数不同,因此评估同时报告平衡准确率、Kappa 和加权 F1。
03
环境安装
新机器使用独立环境;已有服务器可复用实际训练解释器。
| 组件 | 本次实际版本 / 配置 |
| Python / PyTorch | 3.9.25 / 2.5.1 |
| CUDA runtime / GPU | 11.8 / NVIDIA RTX 3090,24 GB,仅 GPU0 |
| NumPy / SciPy | 1.26.4 / 1.13.1 |
| MNE / LMDB | 1.8.0 / 3.0.0 |
| scikit-learn / einops | 1.5.2 / 0.8.2 |
| matplotlib / tqdm | 3.9.4 / 4.70.1 |
|---|
命令均在项目根目录执行。新机器需已有 Conda、Git、curl 和可用的 NVIDIA 驱动。原始 CNT 约 37.67 GiB,最终 LMDB 约 11.24 GiB;首次处理还有一份同等大小的中间分片,建议预留至少 65 GiB 空间。
01创建独立 Python 环境
BASH · 新机器环境复制
conda create -n cbramod-seedv python=3.9.25 pip -y
conda activate cbramod-seedv

python -m pip install torch==2.5.1 \
  --index-url https://download.pytorch.org/whl/cu118

python -m pip install -r requirements.txt
python -m pip check
先安装 CUDA 11.8 版本的 PyTorch,再安装其他依赖。该流程不编译自定义 CUDA 扩展。安装方法匹配公开包版本;原环境使用的 Conda 构建与新 pip wheel 不保证二进制完全相同。
02验证仅 GPU0 可见
BASH + PYTHON · CUDA 检查复制
CUDA_DEVICE_ORDER=PCI_BUS_ID CUDA_VISIBLE_DEVICES=0 python - <<'PY_GPU'
import torch
assert torch.cuda.is_available(), "CUDA 不可用"
assert torch.cuda.device_count() == 1, "仅允许一个可见 GPU"
print("PyTorch:", torch.__version__)
print("CUDA runtime:", torch.version.cuda)
print("GPU:", torch.cuda.get_device_name(0))
print("计算检查:", torch.ones(4, device="cuda:0").sum().item())
PY_GPU
本机已有 .venv/bin/python 是实际训练解释器,继承原有环境中的 PyTorch。继续使用本机代码时,可以将指南中的 python 换为 .venv/bin/python;新机器按上述步骤安装独立环境。
03准备固定版本实现与预训练权重
当前项目已经包含源码和权重。只在对应目录或文件缺失时执行以下命令:
BASH · 固定版本实现复制
mkdir -p upstream
git clone https://github.com/wjq-learning/CBraMod.git upstream/CBraMod
git -C upstream/CBraMod checkout b9e961003214326972c567eff390e75b0287e32a
BASH · 预训练权重复制
mkdir -p artifacts/pretrained
curl -fL --retry 3 \
  https://huggingface.co/weighting666/CBraMod/resolve/main/pretrained_weights.pth \
  -o artifacts/pretrained/pretrained_weights.pth

sha256sum artifacts/pretrained/pretrained_weights.pth
本次预训练权重的 SHA-256:0792cb808c14e6b7a2bb2ce1dff379bc47bc54c49a779825bdfeb33bf8157178。
04
数据预处理
固定通道、采样率、时间戳和存储精度,获得一致的模型输入。
- 读取完整 CNT,删除
M1/M2/VEO/HEO,保留原排列顺序的 62 个 EEG 通道。 - 先重采样到 200 Hz,再进行 0.3--75 Hz FIR 带通。
- 读取微伏值,根据视频起止时间截取试次,并沿用固定标签顺序。
- 切成不重叠的 1 秒样本,每个样本形状为
(62, 1, 200)。 - 保存 float64 数组至 LMDB;训练读取时执行微伏值
/100,再转为 float32。
流程没有额外的重参考、notch、z-score 或数据增强。对 7_1_20180411.cnt 的异常样本数字段,仅在内存中按已核验布局恢复 3,527,400 个 int32 样本;原始文件不改写,其余 47 个文件使用原读取器。
4.1 在新机器生成完整 LMDB
将 48 个 CNT 放入 data/SEED-V/EEG_raw/。下面的命令用于首次处理;输出目录和分片目录需为空。四个 CPU worker 处理连续排序的文件子集,最终按原顺序合并。
BASH · CPU 预处理复制
export OMP_NUM_THREADS=2
export OPENBLAS_NUM_THREADS=2
export MKL_NUM_THREADS=2

python -u scripts/preprocess_cbramod_parallel.py \
  --raw-dir data/SEED-V/EEG_raw \
  --shards data/SEED-V/CBraMod/.shards \
  --output data/SEED-V/CBraMod/processed_parallel \
  --artifacts results/cbramod/preprocessing_parallel \
  --workers 4
本机已有完整数据,可跳过预处理。
直接使用 data/SEED-V/CBraMod/processed_parallel。若重做数据,请为 output、shards 和 artifacts 指定新目录;内存不足可以将 workers 改为 1,仍保留同样的 CNT 兼容读取流程。
4.2 完成后的数据检查
本次对 117,744 个样本验证了形状、float64 类型、有限值、类别计数及分片合并后的保存字节,差异数为 0。完整划分为 34,432 / 42,960 / 40,352。训练只读取合并后的 LMDB;已清理的中间分片不影响训练,但不能再用于单独合并。
05
训练指南
固定五个种子、完整训练 50 轮,按验证 Kappa 选择权重。
5.1 启动一次新的五种子实验
使用新的结果目录 results/cbramod_new,保留已经完成的 results/cbramod。以下命令逐个运行种子 3407--3411:
BASH · GPU0 / 五种子 / 顺序执行复制
export CUDA_DEVICE_ORDER=PCI_BUS_ID
export CUDA_VISIBLE_DEVICES=0

python -u scripts/run_cbramod_seedv.py \
  --data-dir data/SEED-V/CBraMod/processed_parallel \
  --checkpoint artifacts/pretrained/pretrained_weights.pth \
  --results results/cbramod_new \
  --seeds 3407 3408 3409 3410 3411 \
  --jobs 1 --epochs 50 --batch-size 64 \
  --lr 1e-4 --weight-decay 0.05 \
  --optimizer AdamW --clip-value 1.0 \
  --dropout 0.1 --label-smoothing 0.1
训练入口自身强制仅 GPU0 可见,子进程使用逻辑 cuda:0 并核对可见设备数。--jobs 1 表示五个独立训练进程顺序执行;每个种子都有独立随机状态、验证结果和权重。
请显式传入完整数据目录。
使用 --data-dir data/SEED-V/CBraMod/processed_parallel。脚本旧默认目录为 processed,而本次完整数据保存在 processed_parallel。
5.2 训练参数
| 参数 | 实际配置 |
| 训练轮数 / batch | 50 / 64 |
| 优化器 | AdamW;betas=(0.9, 0.999),eps=1e-8 |
| Backbone 初始学习率 | 1e-4 |
| 分类头初始学习率 | 5e-4;由 0.001 × sqrt(batch / 256) 生成 |
| Weight decay / dropout | 0.05 / 0.1 |
| Label smoothing / 梯度 norm 上限 | 0.1 / 1.0 |
| 学习率调度 | CosineAnnealingLR,逐 batch 更新;eta_min=1e-6 |
| 更新范围 / 精度 | Backbone 与分类头全部微调 / FP32 |
| 选模与测试 | 50 次验证;验证 Kappa 最高的权重;最终测试一次 |
|---|
验证 Kappa 相同则保留最早的 epoch;选中的 Kappa 必须高于实现的初始值 0。训练结束后恢复选中模型,测试集不参与模型选择。--lr 控制 backbone 学习率,分类头使用 multi_lr 规则。
5.3 汇总与指标校验
五个种子完成后,训练入口自动生成 JSON 和 CSV 汇总。需要再次汇总新实验时,执行:
BASH · 结果汇总及校验复制
python scripts/summarize_cbramod.py --results results/cbramod_new
python scripts/audit_cbramod_results.py --results results/cbramod_new
校验工具从整数混淆矩阵独立复算三项指标,核对验证选模、最终测试、权重和日志哈希、均值及标准差。当前校验面向五种子、每种子 50 次验证的标准协议;不要使用 python -O,它会禁用断言检查。
5.4 复核本机已完成的结果
BASH · CPU 校验,不重新训练复制
.venv/bin/python scripts/audit_cbramod_results.py \
  --results results/cbramod

.venv/bin/python results/cbramod/analysis/plot_results.py \
  --validate-only
关于重复运行、恢复和数据保护
06
本次实验结果
汇总全部五次独立运行,报告均值与样本标准差。
平衡准确率 · Balanced Accuracy40.00%样本标准差 ± 0.94 个百分点
Cohen's Kappa0.2548样本标准差 ± 0.0136
加权 F1 · Weighted F140.65%样本标准差 ± 1.32 个百分点
6.1 五个种子的最终测试成绩
| 种子 | 选中 epoch | 平衡准确率(%) | Kappa | 加权 F1(%) |
| 3407 | 29 | 40.97564 | 0.26874278 | 41.88868 |
| 3408 | 22 | 40.15886 | 0.25883325 | 41.07484 |
| 3409 | 29 | 40.67357 | 0.26328254 | 41.49188 |
| 3410 | 18 | 39.61104 | 0.24929597 | 40.23669 |
| 3411 | 10 | 38.60043 | 0.23402655 | 38.54670 |
| 均值 ± 样本标准差 | --- | 40.00391 ± 0.94086 | 0.25483622 ± 0.01364227 | 40.64776 ± 1.32460 |
|---|---|---|---|---|
| [验证选模后的测试结果] |
标准差采用 ddof=1,描述五次运行之间的波动;它不是置信区间。全部五次均纳入均值,没有用最优单次成绩代替整体结果。
6.2 指标如何解释
| 指标 | 含义 | 日志字段 |
| 平衡准确率 | 五类 recall 的算术平均,各类贡献相同,适合类别数量不均衡的情况。 | acc |
| Cohen's Kappa | 根据真实和预测类别分布校正偶然一致性的指标,0 对应其机会一致水平。 | kappa |
| 加权 F1 | 各类 F1 按真实类别样本数加权,综合反映 precision 与 recall。 | f1 |
|---|
6.3 完整训练与验证曲线
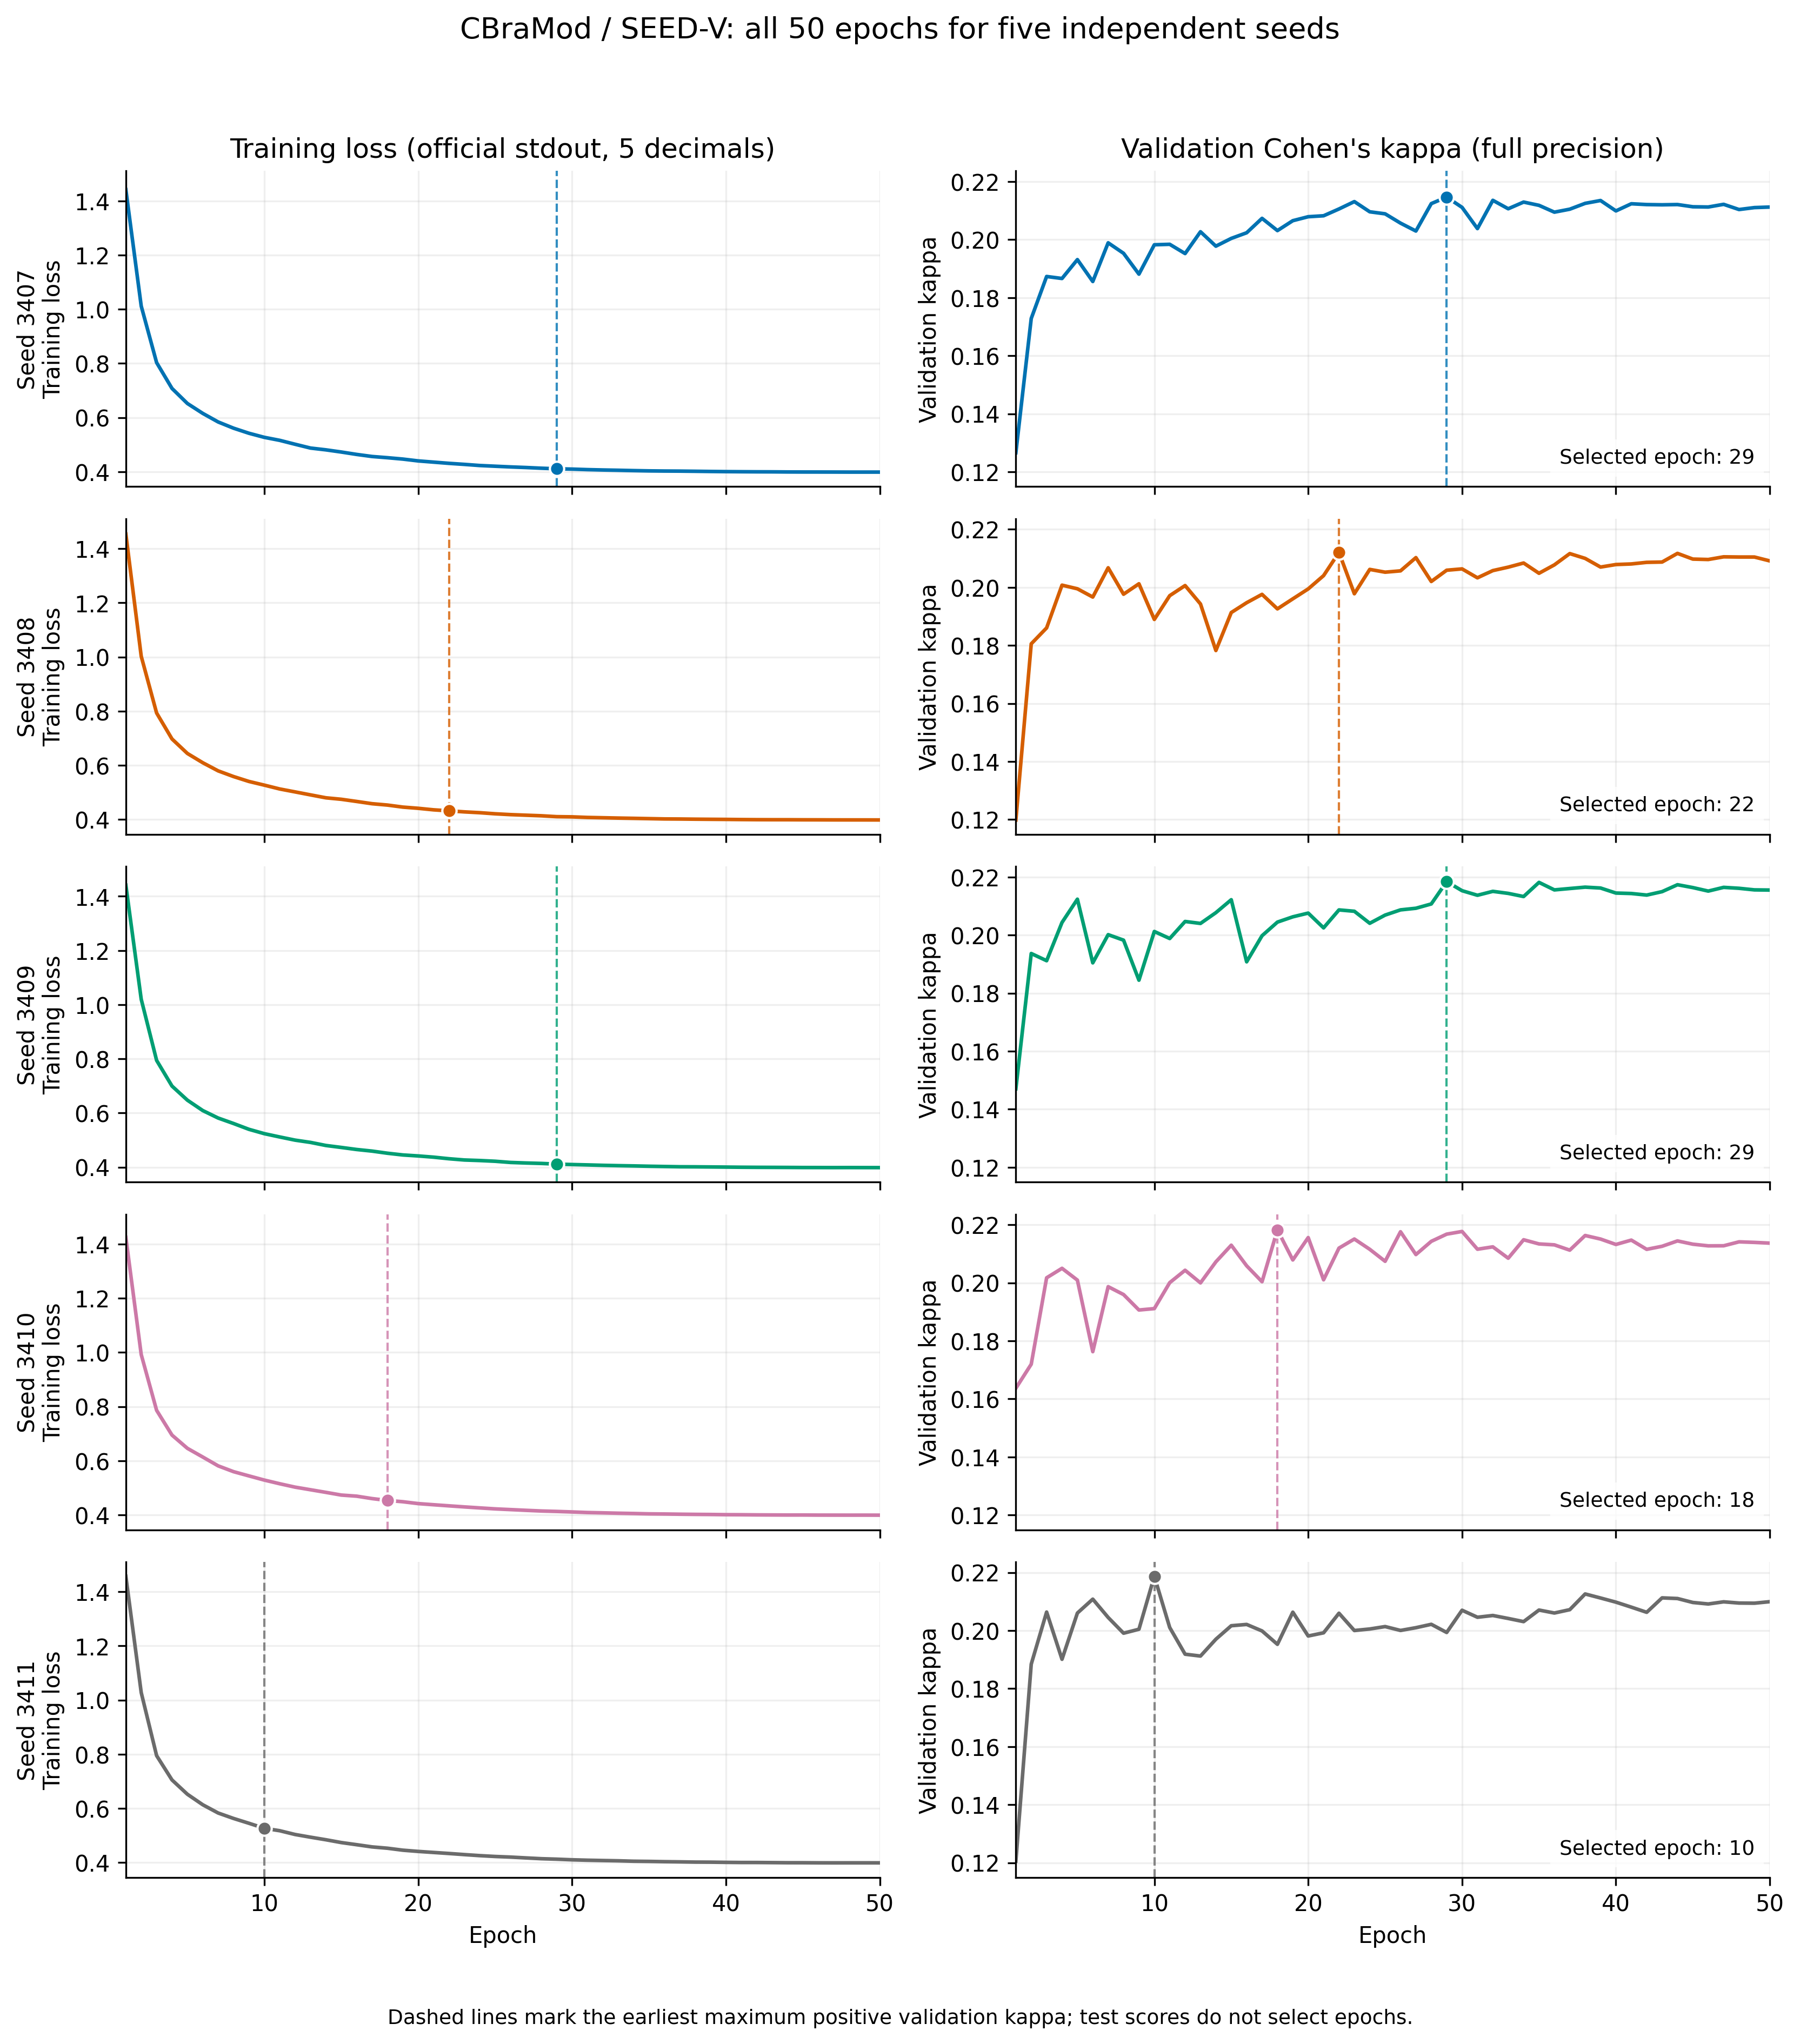
每个种子都训练满 50 轮。 所选 epoch 为 29、22、29、18、10;标记由验证 Kappa 决定,测试成绩不参与选模。训练 loss 来自日志,保留五位小数。
6.4 平均测试混淆行为
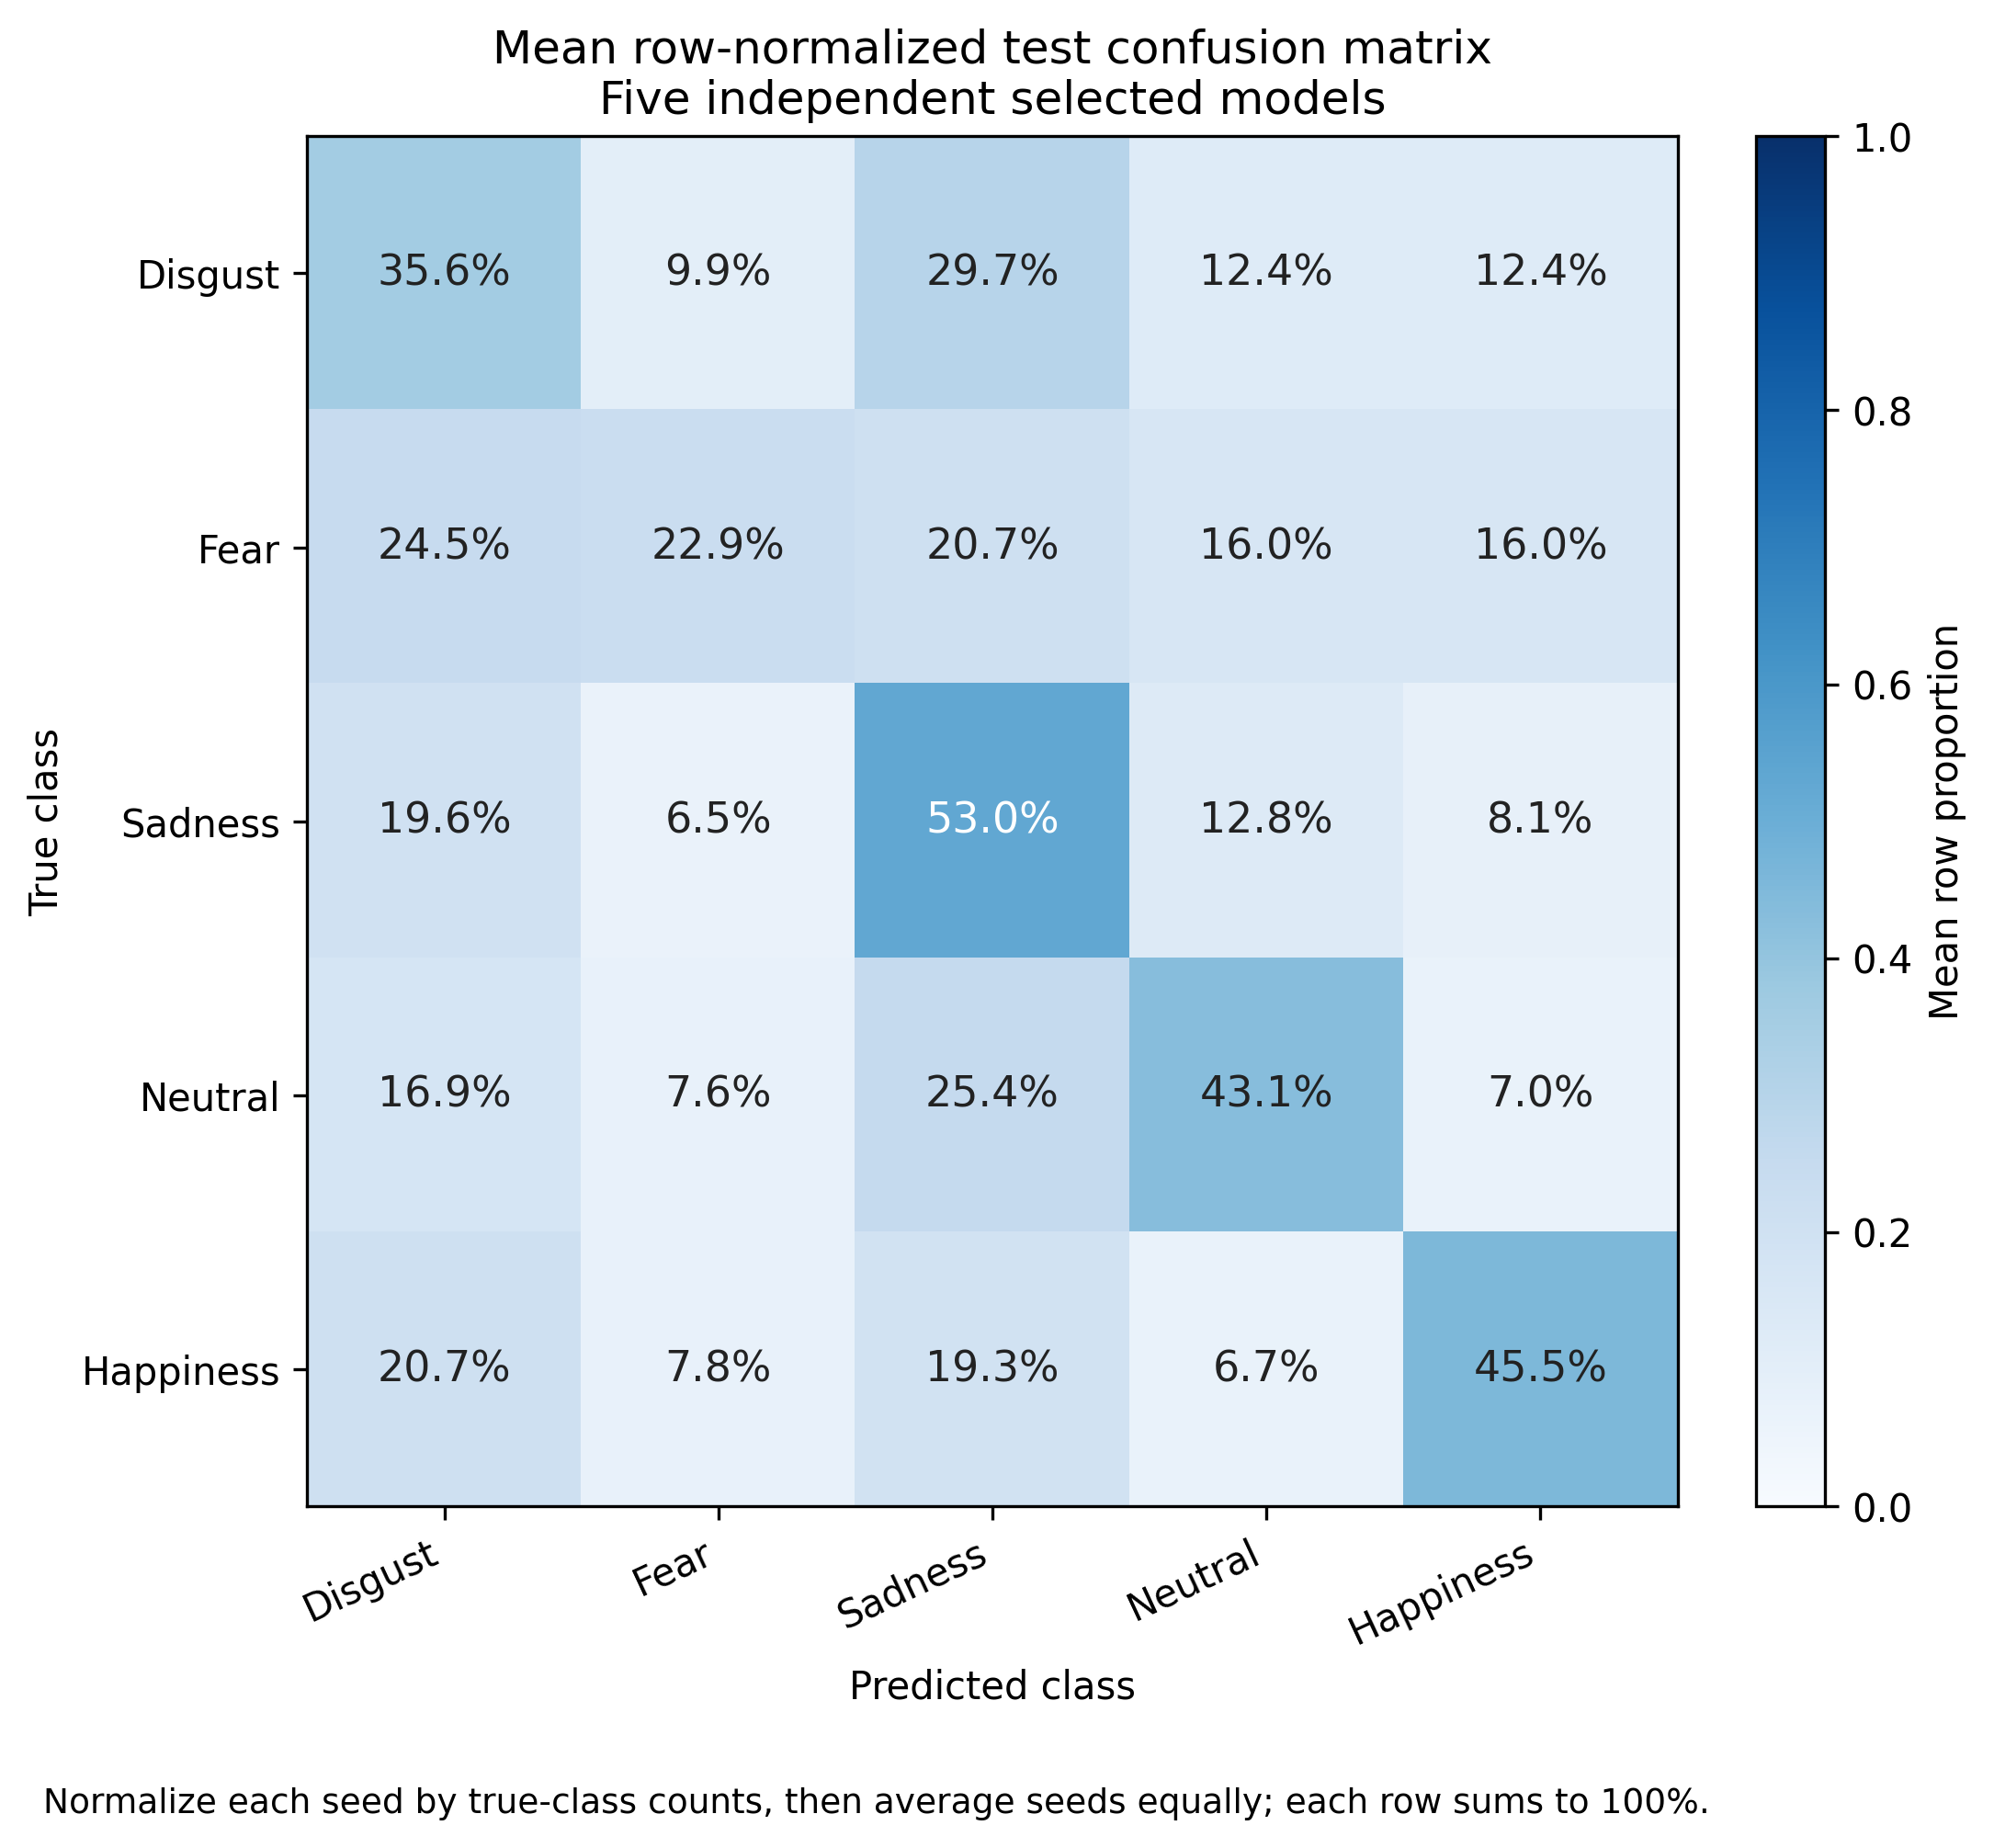
行是真实类别,列是预测类别。 先按每个模型的真实类别数量逐行归一化,再对五个模型等权平均。它描述五次模型的平均表现,不是额外集成模型的预测结果。
从类别平均 recall 看,恐惧类别约为 22.87% ,悲伤类别约为 53.01%,说明不同情绪类别的识别难度存在明显差异。评估时应同时查看总体指标和类别混淆行为。
结果的适用范围
这些数值对应当前固定试次划分、公开预训练权重、软件版本和训练参数。它们不代表跨被试成绩,也不能直接替代其他数据划分或训练配置的测量。
07
代码与结果文件
训练入口、数据路径、结果记录及必要的实现适配。
| 位置 | 用途 |
| scripts/preprocess_cbramod_parallel.py | 推荐的 CNT 预处理入口,支持 CPU 分片和兼容读取。 |
| scripts/run_cbramod_seedv.py | 固定配置,生成外部适配,顺序执行训练,最后汇总。 |
| scripts/train_cbramod_seed.py | 调用训练器和评估器,记录完整精度的指标与混淆矩阵。 |
| scripts/summarize_cbramod.py | 汇总五次成绩、均值、样本及总体标准差。 |
| scripts/audit_cbramod_results.py | 独立复算指标,校验选模和产物哈希。 |
| data/SEED-V/EEG_raw | 48 个原始 CNT。 |
| data/SEED-V/CBraMod/processed_parallel | 本次实际使用的完整 LMDB。 |
| results/cbramod/summary.json results/cbramod/summary.csv | 五种子结果与汇总统计,JSON 保留完整精度。 |
| results/cbramod/seed_3407 ... seed_3411 | 每次运行的权重、训练日志、评估记录和 run.json。 |
artifacts/environment |
实际软件版本和环境记录。 |
|---|
保留数值行为的外部适配
- 删除 forward 中多余的展平,让分类头的 Rearrange 接收到四维特征;分类器结构和参数不变。
- 三个数据视图共享同一个只读 LMDB 环境,避免同进程重复打开问题。
- CPU 分片、每试次事务与原字节合并改善数据处理效率。
- 对一个异常 CNT 头部采用限定的内存读取修正。
- 记录评估器返回的完整精度结果,避免仅从五位小数日志汇总指标。
CBraMod · SEED-V 脑电情绪识别中文离线指南 · 文档整理 2026-10-13