LLM记忆实战:从一次164秒慢问,到上下文治理与记忆版图
一句话结论:LLM 的上下文是昂贵、易失、越满越慢的工作内存(RAM),不是硬盘 。把 RAM 当硬盘用,就是「上下文雪球」的全部根源------本文从一次 input 64K、耗时 164 秒、只回了 41 个字的慢问出发,拆透形成机制,对照企业级 Agent 产品(Qoder work / Claude Code / Cursor 一类)的八层防线,再沿三个追问走向深处:治理落地之后是什么稳态?删旧与会摘之间该怎么选?长短期之外,记忆的完整版图长什么样?
0. 引子:一次 164 秒的慢问
我的个人智能体 heart-net(账号/技术栈/知识库的对话入口,下文简称「案例项目」)某天出现一例慢问,观测数据如下:
| 观测项 | 数值 | 含义 |
|---|---|---|
| tokens | input 64413 + output 218 | usage 帧按模型调用累计(多跳每跳都发帧):单次调用远没这么大,是多跳×多轮把累计滚上 64K------output 仅 218,说明模型没写多少字,账单几乎全是重复背的历史 |
| 总耗时 | 164s | 远超正常(当天下午实测新会话 7 轮 90s 内完成) |
| 思考耗时 | 0.8s | 第一轮思考很快------模型本身没「卡」 |
| 回复字数 | 41 字 | 几乎没干活 |
| 执行轨迹 | 3 步工具调用 | 推进正常,不是死循环 |
| 终态 | 已停止生成 | 用户主动 abort,非系统挂死 |
另一个关键对照数字:全新会话第一问的 input 底座实测 15.6K (系统提示词 + 5 个工具 schema + 长期记忆文件 + workspace 底座)------这个会话的 input 是底座的 4 倍以上。
现象很清楚:不是模型坏了,不是工具坏了,是这个会话「胖」了。41 字的回答背着 64K 的输入跑了 164 秒------input 是 output 的近 300 倍。这就是本文的主角:上下文雪球。
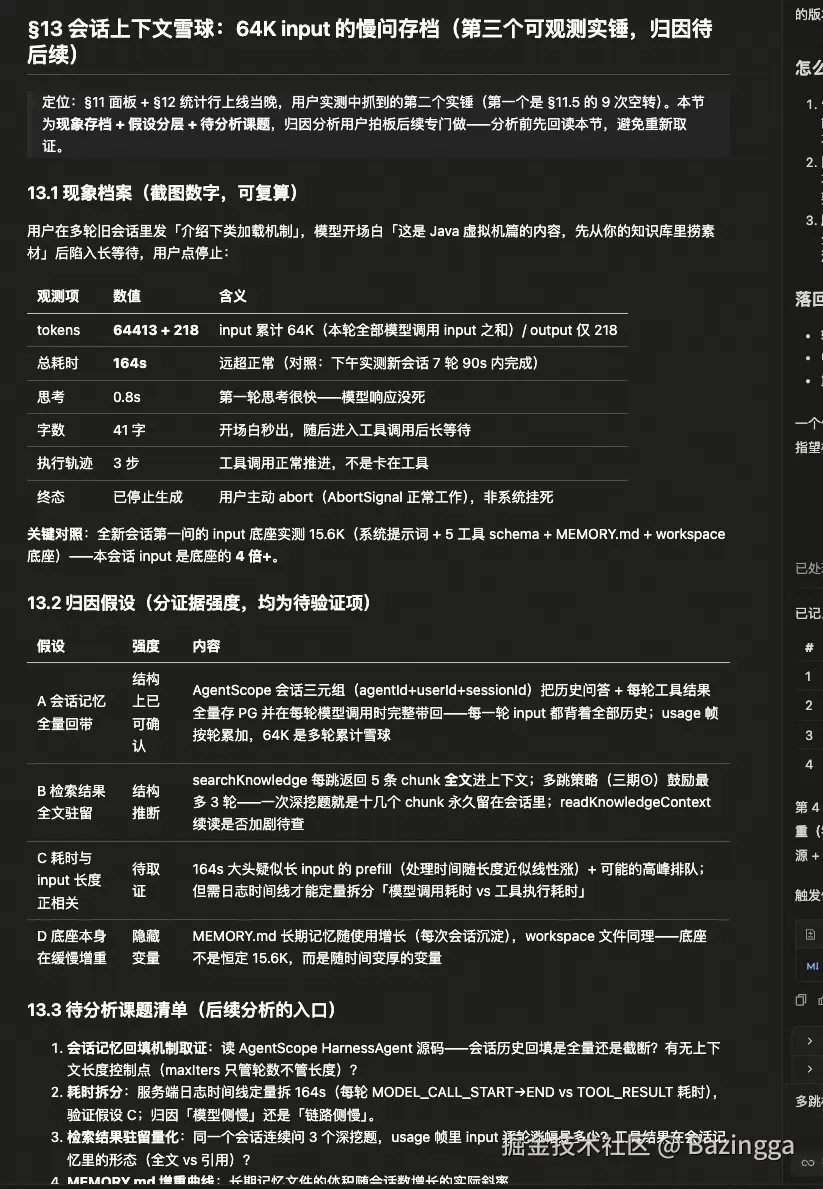
现场证据:慢问现象档案(13.1)与四条归因假设(13.2)的存档卡片------后续所有分析都能回溯到这张表。
1. 机制:雪球不是 bug,是 LLM 工作原理的必然推论
1.1 LLM 是无状态的,每轮都全量重发
先立一个最底层的事实:模型不记得任何事。每轮对话在模型眼里都是一次全新请求;所谓「记得上文」,是调用方每轮把全部历史重新拼进 input 发一遍:
text
第 1 轮 input = 底座 + 问题1
第 2 轮 input = 底座 + 问题1 + 回答1 + 工具结果1 + 问题2
第 3 轮 input = 底座 + 问题1 + 回答1 + 工具结果1 + 问题2 + 回答2 + 工具结果2 + 问题3
...
第 N 轮 input = 底座 + 前 N-1 轮的一切增量
这个协议叫「无状态服务 + 客户端全量重放」。它换来了架构的简单(服务端不用管会话),代价是历史每轮都要重新付费、重新计算。
1.2 关键数学:总成本是 O(N²),不是 O(N)
这是「雪球」的本质,值得单独算一遍。设每轮新增增量平均为 δ,底座为 B:
text
第 N 轮 input ≈ B + (N-1)δ

N 轮总消耗 = Σ(各轮 input)
           = N·B + [(N-1) + (N-2) + ... + 1]·δ
           = N·B + N(N-1)/2 · δ
轮数翻倍,总账接近翻四倍。 每一轮单看只是「多带了一点历史」,加总起来就是平方增长------这就是「雪球」和「线性变长」的区别:雪球是滚出去的每一圈都粘在身上,且下一圈滚得更远。
我的慢问案例里,input 64413 vs output 218 就是这个数学的具象:会话几轮积累下来,input 侧膨胀到 output 侧的近 300 倍。
1.3 为什么「慢」:prefill 的物理账
一次模型调用的耗时拆成两段,规律完全不同:
| 阶段 | 做什么 | 耗时规律 |
|---|---|---|
| prefill(预填充) | 把全部 input 逐 token 过一遍注意力计算 | 随 input 长度近似线性到超线性地涨 |
| decode(解码) | 逐 token 自回归生成 output | 与 output 长度成正比,218 token 只占几秒 |
所以 164s 的大头必然在 prefill(外加可能的高峰排队)。慢问档案里两个旁证恰好排除了其他解释:思考 0.8s ------短序列时模型响应没死;新会话 7 轮 90s------同样的交互轮数,input 小就快。变量只剩一个:input 长度。
更狠的一层:对话式 API 每轮是独立请求。上一轮 prefill 过的 64K,这一轮不会白送------没有缓存机制时,每次调用都把 64K 完整重算一遍。雪球不只是「越来越贵」,还是「同样的东西反复算」。
1.4 ReAct 是放大器:轮内多跳 × 跨轮累积
Agent(ReAct 模式)比纯聊天惨烈得多,因为膨胀发生在两个维度上:
text
跨轮累积:会话记忆把历史带回(第 N 轮 input 含全部前轮)
   ×
轮内多跳:每次工具调用后再次调用模型,工具结果追加后又全量重发
我的慢问案例「执行轨迹 3 步」意味着至少 4 次模型调用(初始 1 次 + 每步工具后各 1 次),每次都背着滚到当前的整个 input。多轮 agent 会话的 input 膨胀是这两个维度的乘积------这就是为什么雪球问题在 agent 应用里集中爆发,而纯聊天应用里相对温和。
2. 逐层归因:64K 是怎么滚出来的
把慢问解剖开,四条成因按贡献权重排:
假设 A(主因):会话记忆全量带回
AgentScope 的会话三元组(agentId + userId + sessionId)把历史问答 + 每轮工具结果全量存 PostgreSQL,每次模型调用前全量回填。这是框架的默认行为:它假设你要连贯,就给你全部连贯------代价藏在 usage 里,直到雪球大成这样才被看见。
假设 B(最肥增量源):检索结果全文驻留
看我的检索工具返回给模型的内容(真实代码):
java
StringJoiner joiner = new StringJoiner("\n\n");
joiner.add(String.format("知识库命中 %d 条相关知识点(精排相关性越高越相关):", hits.size()));
for (Map<String, Object> hit : hits) {
    // 精排路径带 relevanceScore;降级路径只有向量距离,动态拼接相关性段
    Object score = hit.get("relevanceScore");
    String relevance = score == null
            ? "" : String.format("精排相关性 %.3f,", (Double) score);
    joiner.add(String.format("""
            【资料】%s(分类 %s%s,%s向量距离 %s,块编号 %s)
            %s""",
            hit.getOrDefault("docTitle", "-"),
            hit.getOrDefault("category", "-"),
            hit.get("subcategory") == null ? "" : "/" + hit.get("subcategory"),
            relevance,
            hit.getOrDefault("distance", "-"),
            hit.getOrDefault("id", "-"),
            hit.getOrDefault("content", "-")));      // ← 块全文直接进上下文
}
// 多跳续读提示:块是切片不是全文,截断/指代前后文时模型知道下一步抓手
joiner.add("如上内容被截断或指代前后文(如「如前所述」),可调 readKnowledgeContext 传块编号续读相邻内容。");
每条命中带 content 全文 (一块 300~800 字符)。topK 默认 3、上限 5;而系统提示词鼓励多跳检索「最多 3 轮」------一次深挖题可能往会话里塞十几个 chunk 的全文 ,几千 token,而且永久驻留:话题早就换走了,它们还在每一轮 input 里被重发。
值得注意的是 MAX_TOP_K = 5 的常量注释写着「避免模型一次拉太多资料撑爆上下文」------说明单次调用的量控是有意识的,缺的是跨轮的驻留治理:单看每一跳都合规,加总起来失控。
假设 C(下游结果):耗时随 input 线性涨
164s 是 A + B 的账单。prefill 规律(1.3 节)把 input 膨胀兑换成延迟------C 不是独立原因,是前两条的兑换汇率。
假设 D(慢性变量):底座在缓慢增重
底座不是常量。AgentScope Harness 会自动沉淀 MEMORY.md 长期记忆、维护 workspace 文件,每次会话注入------用得越多底座越厚。15.6K 的底座今天没制造事故(4 倍膨胀主要来自历史),但它决定 input 的「下限水位」,是逐年抬高的慢变量。
一句话归因:无状态模型 + 全量重发协议 + 工具结果全文驻留 + 无缓存,四个条件同时成立,雪球必然滚起来。
3. 企业级应用怎么做:八层防线
概念图先看全貌:
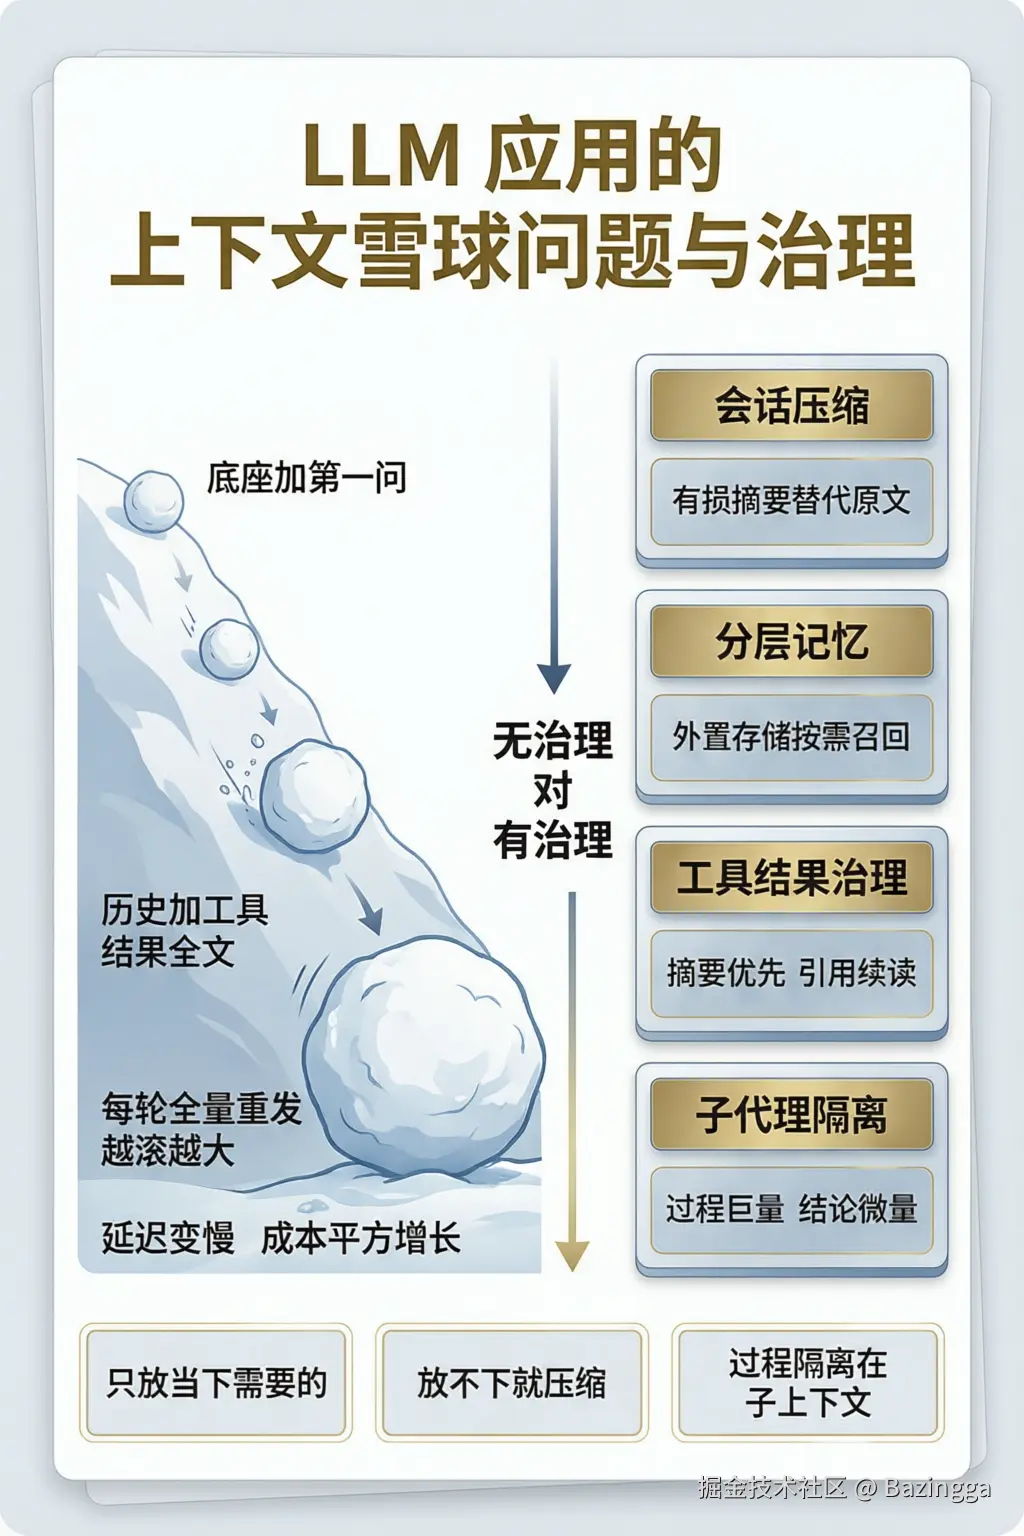
左边是无治理时雪球怎么滚(每级标注膨胀内容,坡底是延迟与成本的兑换结果);右边是企业级的核心防线分层;底部是贯穿全部方案的三条铁律。
下面逐层展开,前五层管「少装」,第六层管「重发也能便宜」,后两层管「装了什么要看得见」。
防线 1:把上下文当「预算」管理,不当「仓库」使用
所有成熟产品的第一共识:200K/1M 的窗口不是让你装满的,是预算上限 ------系统提示词、工具 schema、文件上下文、历史、工作记忆各占份额,接近阈值就触发治理动作。Qoder work 的可观察行为:上下文快满时自动压缩(auto-compact) ,会话被摘要重写后继续工作;Claude Code 同款设计,默认约 92% 触发自动压缩,也可手动 /compact。
防线 2:有损压缩(compaction)------会话摘要替代会话原文
压缩不是截断,是提炼任务状态:目标、已做决策、未完成事项、关键文件路径、下一步------丢掉寒暄、试错过程、冗长的中间输出。压缩后 input 从 60K+ 掉回几千 token,prefill 立刻变快。
代价是有损,所以成熟产品的压缩是闭环而非单点:压缩管日常,检索管补救------原始对话记录外置保存,丢了细节可以按关键词/行号找回。Qoder work 的会话压缩续接就是这个形态:压缩摘要 + 可检索的完整 transcript,两者配合把「有损」控制在可接受范围。
防线 3:分层记忆------外置存储 + 按需召回,替代全量注入
Qoder 的记忆系统是教科书案例:长期记忆不进上下文,进上下文的只有一张「标题目录树」;真要用某条记忆,按标题取全文,一次只取几条。同样的信息量,注入策略从「全量」变「目录 + 检索」,底座从变量变常量。
对照案例项目的现状:MEMORY.md 每轮全量注入,正是假设 D 的病灶。同一个病,成熟产品的药方是把记忆从上下文里搬出去,换成目录 + 按需取用。
防线 4:工具结果治理------最大的膨胀源要单独设闸
工具结果是 agent 上下文里最肥的东西,通行三板斧:
| 手段 | 做法 | 例子 |
|---|---|---|
| 截断/限额 | 返回设上限 | Claude Code 的 Read 默认带行数范围、大文件分片读;案例项目的 MAX_TOP_K=5、台账查询 LIMIT 是同思想微缩版 |
| 摘要优先 | 大结果先压缩再入上下文,原文留外部 | 长报告只回摘要 + 「全文见某处」 |
| 引用代替全文 | 上下文里只放指针,需要时续读 | 业界叫 agentic retrieval:「目录搬进来,要哪页翻哪页」 |
第三招案例项目其实已经搭了骨架------searchKnowledge 返回带块编号,续读工具按编号取相邻块:
java
public String readKnowledgeContext(/* chunkId */) {
    // ...
    KnowledgeChunk anchor = knowledgeChunkMapper.selectChunkById(chunkId);
    // ...
    List<KnowledgeChunk> neighbors = knowledgeChunkMapper.selectNeighbors(
            anchor.getDocId(), index - EXPAND, index + EXPAND);   // 锚块前后各一块
    // ...
    if (prev == null) {
        joiner.add("(锚块已是文档第一块,无前文)");
    } else {
        joiner.add(String.format("【前文·块序号 %d】\n%s",
                prev.getChunkIndex(), sensitiveContentFilter.sanitize(prev.getContent())));
    }
    // ...(后文同理)
}从「一次搬全文」改成「给编号、要哪块续哪块」的通道已经存在------差的只是把 searchKnowledge 的默认行为从「全文」改成「摘要 + 编号」,让续读从补充手段升级为默认形态。这就是假设 B 的对症药。
防线 5:子 agent 上下文隔离------过程巨量、结论微量
把脏活(全库搜索、大文件通读、浏览器操作)派给子 agent:它开独立上下文窗口,百万 token 的中间过程烧在自己窗口里,干完只把结论带回主线。Qoder 派 Browser/CodeReview/Debug 子代理、Claude Code 的内置 subagent 都是这个架构。
主线上下文始终干净:只留决策,不留过程。这也是我上一篇文章(《一个叫「子 agent 扇出」的需求,最后用线程池解决了》)里四触发信号的第 2 条------上下文隔离从奢侈品变必需品的时刻,就是该上子 agent 的时刻。
防线 6:Prompt Caching------重发税的官方解药
Anthropic prompt caching / OpenAI 前缀缓存 / DashScope 上下文缓存,原理相同:input 的不变前缀,服务端缓存其 KV 计算结果;命中部分按缓存价计费(通常原价的 10%~25%)、首 token 延迟大幅下降。
它有一个塑造架构的副作用:前缀必须稳定。所以企业级产品都把系统提示词、工具 schema 放最前面,历史严格 append-only------中段改一个字,后面全部缓存作废。案例项目走 DashScope 链路,这条是现成可查的优化路径;模型侧的解药和 1.3 节「每轮重算」的病灶正好对上。
防线 7:显式注入------用户控制什么进上下文
Cursor 的 @file/@folder/@web 是代表:上下文不是系统偷偷塞满,而是用户显式引用;配合代码库索引(先语义检索命中、再注入相关文件),把「隐式全量」改成「显式按需」。
防线 8:可观测性------让雪球在滚大之前被看见
最后一块拼图:看不见就治理不了。Claude Code 底部常驻上下文剩余量指示;案例项目靠 usage 帧抓到了这次 64K(真实代码,模型调用的 token 账单透传给前端):
java
if (event.getType() == AgentEventType.MODEL_CALL_END) {
    // 单轮模型调用 token 账单(ReAct 多轮会发多帧,前端累加)
    ModelCallEndEvent e = (ModelCallEndEvent) event;
    if (e.getUsage() == null) {
        return Flux.empty();
    }
    Map<String, Object> payload = new LinkedHashMap<>();
    payload.put("type", "usage");
    payload.put("inputTokens", e.getUsage().getInputTokens());
    payload.put("outputTokens", e.getUsage().getOutputTokens());
    payload.put("totalTokens", e.getUsage().getTotalTokens());
    return Flux.just(frame(payload));
}
没有这几行,64K 雪球永远不会被发现------用户只会觉得「今天怎么这么慢」。每轮 usage 透出 + input 逐轮涨幅曲线,就是上下文的油表;我的慢问档案(§0 那张表)能成立,全靠这块仪表先在场。
4. 防线落地之后:治理的稳态、账单与三个陷阱
八层防线听起来是终点,其实只是起点。把防线 2(压缩)+ 防线 4(工具结果驱逐)真的装进一个 Agent 框架后,会连续撞上三个问题:稳态长什么样?压缩本身多贵?阈值该怎么定?------这三个问题都没有出现在产品宣传页上,但每一个都决定治理方案的成败。
4.1 锯齿稳态:200 轮之后的推演
先看全景:
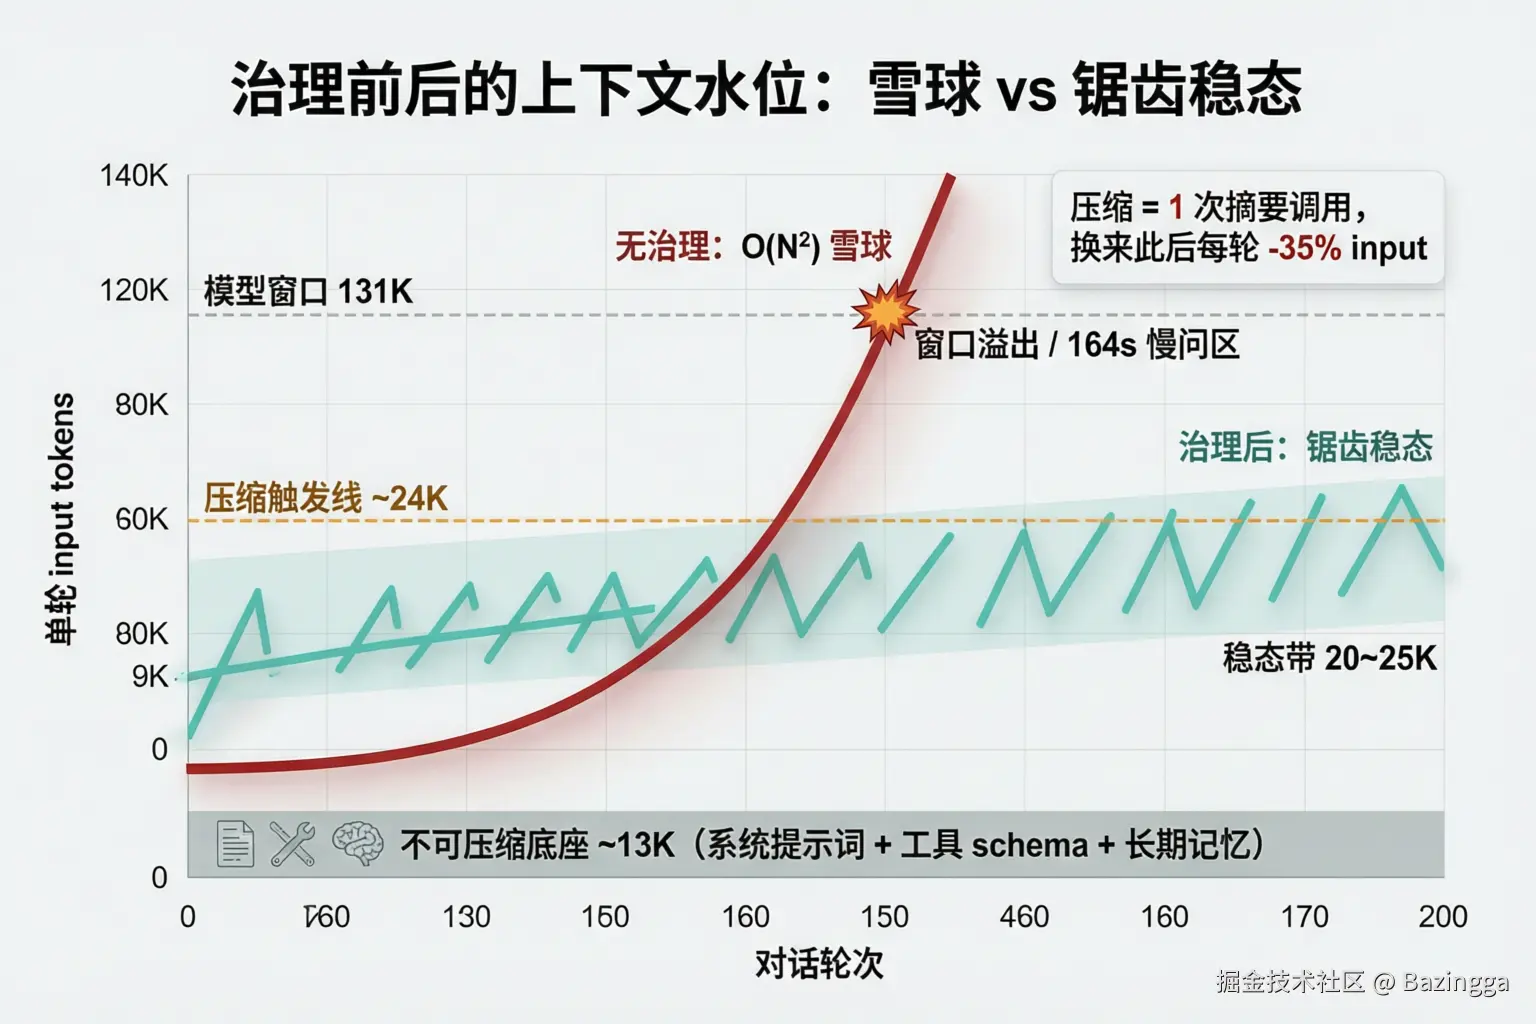
无治理时 input 随轮次平方增长,撞上模型窗口即出局;治理后进入「爬升 → 触发压缩 → 跌回低位 → 再爬升」的锯齿循环,永远生活在稳态带里。
无治理的曲线就是 §1.2 的 O(N²) 数学,无需重复。有意思的是治理后的形状------它不是一条平滑下降的曲线,而是锯齿。设触发线为 T、压缩后水位为 K,则稳态行为是:
text
压缩后:input ≈ 底座 + 1 条摘要 + 最近 1 轮原文        (水位 K)
之后每轮:+ 本轮增量(对话 + 工具结果,驱逐后约 1~2K)    (爬升)
爬到触发线 T:再次压缩,跌回 K                          (锯齿一齿)
用一个真实治理案例的数字代入:触发线 T ≈ 24K(真实 tokens)、压缩后水位 K ≈ 9K、不可压缩底座 ≈ 13K(系统提示词 + 工具 schema + 长期记忆)。那么 200 轮之后的状态是:
| 维度 | 无治理 | 治理后稳态 |
|---|---|---|
| 单轮 input | 滚到 64K+,直到撞窗 | 20~25K 封顶(底座 13K + 锯齿上沿 10K) |
| 200 轮总 token | O(N²) 增长,约 7M+ | 约 3.5~4M,省约 45% |
| 最慢一轮 | 164s 级 | 压缩轮约多 20s~2min,其余正常 |
| 64K 雪球复发 | 必然 | 结构上不可能(触发线在窗口的 1/5 处就动手) |
两个容易被忽视的推论:
- 底座决定下限,锯齿决定上限。稳态带的高度 = 底座 + (T − K)。底座(尤其长期记忆)是慢变量,它每涨 1K,200 轮的每一轮都跟着涨 1K------这就是假设 D 在治理后依然成立的原因,也是「下一个要治理的层」;
- 「窗口用量 90%」的红线在稳态里永远看不到。治理成功的标志恰恰是用量条不再变色------仪表安静不是没在工作,是防线在工作。
4.2 一次真实压缩的账单
压缩不是免费的。案例项目一次被日志完整记录的压缩过程:
text
[Compaction] 触发判定:26 msgs / 21281 估算 tokens > 触发线 9600(估算口径)
[Compaction] 切点计算:cutoff=22,保留尾部 4 msgs
[Compaction] 摘要调用:输入 = 前段 22 msgs 全文(约 33K 真实 tokens) → 输出 1 条 summary
[Compaction] 完成:26 msgs → 1 summary + 4 tail = 5 msgs

治理效果:input 33078 → 21315(-35%);上下文字符 62716 → 23196(-63%)
三个数字值得细读:
- 压缩本身是一次 33K input 的模型调用 ------首跳耗时实测约 2.5 分钟。这是「一次性成本换之后每轮 -35%」的买卖:若会话再活 10 轮,回本约 3 倍;若会话下一轮就关了,纯亏。所以触发线不宜设太低------不是越勤压缩越好,压缩是延迟换长期的交换,触发线是交换汇率;
- 摘要的模板决定记忆的骨架 。AgentScope 的默认摘要提示词要求输出四段:SESSION INTENT(会话意图)/ SUMMARY(内容摘要)/ ARTIFACTS(产出物)/ NEXT STEPS(待办)。这不是随便分的------压缩丢掉的是过程,必须保住的是任务状态四要素;
- 「摘要的摘要」衰减链。多次压缩后,第一段历史的原貌经过 N 层摘要,细节持续衰减------这是有损方案的结构性代价(§5 会把它作为选型变量)。
4.3 陷阱一:token 估算口径对不上
压缩触发判定依赖「估算器」,而估算器算的 token 和模型实际计费的 token 可能是两个世界。
案例项目的实测:会话上下文 64539 个字符,模型自报 input 33078 tokens,而框架估算器只算出 21281------差了 1.55 倍。顺着字节码追下去,估算器的实现是:
java
// 通用形态:以「字符数 ÷ 2.5」近似 token 数
static int estimateTextTokens(String text) {
    return (int) Math.ceil(text.length() / 2.5);
}
这个口径是英文 tokenizer 的统计近似(英文约 4 个字符一个 token)。而中文一个汉字 ≈ 一个 token------同样的估算公式在中文语料上系统性低估约 2.5 倍。直接后果:按英文直觉配的触发线(比如 24000),中文会话永远点不着火,压缩形同虚设,雪球照滚。
通用解法是补偿配置 :期望真实 24K 触发 → 配置值写 24K ÷ 2.5 ≈ 9600。更稳的解法是展示与触发分口径------给用户看的用量条用模型自报的真实 token(usage.input_tokens),给压缩判定用的阈值按估算器口径补偿,两套口径各自正确、互不污染。
这个陷阱的普适性超出中文场景:任何「估算器 ≠ 计费器」的系统,阈值都必须先标定估算器的口径再配置------否则你设的是水位的刻度,量的是另一种液体。
4.4 陷阱二:压缩抖动
锯齿稳态有个紧平衡问题:压缩后水位 K 距离触发线 T 的「缓冲带」如果太窄,会进入抖动 ------每 12 轮就触发一次压缩,每次都是 20s2min 的摘要调用,用户感知为「这应用每问两句就卡一下」。
案例项目的缓冲带算出来只有约 300 估算 tokens------原因是工具轮的「安全切点」粒度大:压缩器不能从一轮对话中间劈开(会把工具调用与它的结果拆散,破坏消息结构不变量),只能整轮整轮地切。一轮带工具的对话天然就是 6K+ tokens,保留量配 3200 根本凑不平------要么多留一轮(顶穿触发线),要么少留一轮(砍掉完整上下文)。
两个通用解法:
- 扩缓冲带 :把触发线从 9600 提到 16000(估算口径,≈ 真实 40K),压缩频率从每 2
3 轮降到每 510 轮------代价是稳态水位整体抬高; - 让触发判定带滞后(hysteresis):升到 T 触发、跌回 K 之后要求再涨到 T' > T 才允许下次触发,两个阈值夹出死区------这是控制论里防振荡的标准手法,温控器就是双金属片双阈值。
多数框架(包括 AgentScope)不提供滞后参数,只能在 T 的选取上做文章------这也解释了为什么 Claude Code 把触发点放在 92% 而不是 70%:窗口大,锯齿齿距天然就长。
4.5 陷阱三:工具结果驱逐的「体外循环」
防线 4 的落地形态通常叫 tool result eviction:工具结果超过 N 字符(案例项目配 4000)就落盘到外部文件、上下文里只留 2K 预览 + 文件指针。
实测一例:一个会话里 5 条检索工具结果(4355~5784 字符)全部命中驱逐,落盘成 large_tool_results/{callId}-{hash} 文件。单轮视角省了约 12K 字符驻留;但有个隐性契约------模型如果想再看全文,必须有工具能按指针取回,否则驱逐就等于永久失忆。「驱逐 + 续读」必须成对出现,和防线 4 的第三板斧(引用代替全文)是同一思想的轮内/跨轮两个变体。
5. 删,还是摘要:上下文治理的三岔路
防线建到这一步,一个更根本的问题浮出来:为什么要摘要?直接删掉旧对话不行吗?或者更朴素------只带最近 5 轮上文?
这个问题的直觉版本人人都有:「旧的好像没用,删了不就完了」。值得把三岔路摆开讲清楚------因为三条路的 input 账单几乎一样,差别全在记忆构成和成本结构上。
5.1 删掉远期历史,到底丢什么
只有三类信息真正依赖远期历史:
- 指代链:第 20 轮问「再详细讲讲上面第二个要点」------第 3 轮被删后,模型不知道「第二个要点」指什么;
- 会话目标:长任务(「帮我整理全部云账号」)进行到第 30 轮,初始目标丢了,回答会偏题;
- 跨轮事实:第 5 轮用户随口说过「生产服务器在杭州」,第 40 轮的提问隐含依赖它。
判断的关键在于应用形态 :任务型 agent(连续推进一个目标)三类依赖都高频;查询型 agent(独立问答为主,轮间弱关联)三类依赖都低频。同一个「删」动作,在两种应用里是「激进」和「合理」的两种评价。
5.2 三岔路的量化对比
用治理案例的实测数字代入「保留最近 5 轮」的滑窗方案(工具结果已驱逐):
| 滑窗 5 轮 | 压缩稳态(§4 方案) | 语义筛选 | |
|---|---|---|---|
| 总 input | 底座 13K + 近 5 轮原文 ≈ 25K | 底座 13K + 1 轮原文 + 摘要 ≈ 21~25K | 可变(按召回量) |
| 记忆构成 | 5 轮内无损原文 ,之外彻底为零 | 1 轮原文 + 全史有损骨架 | 与当前问题相关的片段 |
| 额外调用 | 零(纯规则裁剪) | 每几轮一次摘要调用 | 每轮 N 次 embedding 检索 |
| 实现成本 | 自研中间件(框架通常不内置) | 框架配置即得 | 自研检索 + 重排 |
| 失效模式 | 「第 6 轮前全忘」的断崖 | 「摘要的摘要」衰减链 | 召回漏检(相关性误判) |
最反直觉的发现是第一行:input 相当时,滑窗的近因记忆质量反而更好(原文 vs 摘要)------它输掉的只是「5 轮以前的骨架」,赢下的却是零额外调用、零慢轮、零衰减链。压缩赢在「历史骨架」和零代码成本,滑窗赢在成本结构与近因精度,语义筛选赢在信息密度但输在工程复杂度与失效不确定性。
所以正确的问法不是「哪种最好」,而是「你的应用里,§5.1 的三类依赖出现频率是多少」------查询型应用滑窗是优解,任务型应用压缩是优解,两种形态混合的应用才需要语义筛选这种重武器。
5.3 滑窗中间件长什么样
主流框架把压缩做成了内置件,但纯滑窗(直接不带、无摘要调用)几乎都要自研------好消息是扩展点是标准化的。以 AgentScope 的 harness 中间件为例(其他框架同构):
java
/**
 * 滑窗中间件:发送给模型前,把消息列表裁剪为最近 N 轮。
 * 注意「轮」≠「条」:一轮 = USER 1 条 + ASSISTANT 若干 + TOOL 若干。
 */
public class SlidingWindowMiddleware implements HarnessRuntimeMiddleware {

    private final int keepRounds;

    public SlidingWindowMiddleware(int keepRounds) {
        this.keepRounds = keepRounds;
    }

    @Override
    public Flux<ReasoningOutput> onReasoning(
            Agent agent, RuntimeContext ctx,
            ReasoningInput input,
            MiddlewareNext<ReasoningOutput> next) {
        // 只改「发送视图」:按轮边界裁剪消息列表
        List<Msg> windowed = keepLastRounds(input.getMessages(), keepRounds);
        return next.apply(input.withMessages(windowed));
    }

    private List<Msg> keepLastRounds(List<Msg> messages, int rounds) {
        int cut = 0, seen = 0;
        for (int i = messages.size() - 1; i >= 0; i--) {
            if (messages.get(i) instanceof UserMsg) {   // 从尾部数 USER 消息即数「轮」
                if (++seen > rounds) {
                    cut = i;
                    break;
                }
            }
        }
        return messages.subList(cut, messages.size());
    }
}
onReasoning 是全部框架共有的一个拦截位:在消息列表被拼成模型 input 之前,允许中间件改写它。压缩、滑窗、语义筛选三种治理,在工程上都是这同一个钩子的三种实现------区别只在改写算法(摘要 / 截断 / 检索)。
一个必须说清的细节:上面这样改的是「发给模型的视图」,持久层里的会话 state 仍会全量写回(每轮末尾的持久化不经过这个钩子)。滑窗治理的是 input 侧的雪球,不是存储侧的增长------存储治理(会话归档、jsonl 轮转)是另一条独立战线,两者不冲突也不互相替代。
5.4 三岔路的统一视角
把三岔路收拢成一句话:它们都是「重写发送视图」的不同策略,区别只在重写函数------
text
压缩:   view = f(全部历史)   其中 f = LLM 摘要(有损、有成本、保骨架)
滑窗:   view = 最近 K 轮原文  (无损近因、零成本、丢骨架)
语义筛选:view = retrieve(当前问题, 全部历史)(按需、有检索成本、依赖召回质量)工程上的成熟路径是组合而非单选:近几轮保原文(滑窗层)、更早的压成摘要(压缩层)、两者之外挂一个可检索的完整 transcript(检索层)------Claude Code 的「压缩摘要 + 可检索历史」就是这个三层组合的产品化形态。
6. 记忆的完整版图:长短期只是起点
到此为止,「记忆」一直指会话历史的存取。但 §4.1 里「底座含长期记忆」、§2 假设 D 里「MEMORY.md 每轮注入」这些线索都指向一个更大的版图------会话治理只是记忆工程的三分之一。把版图补全需要两个正交维度:时间尺度和内容类型。
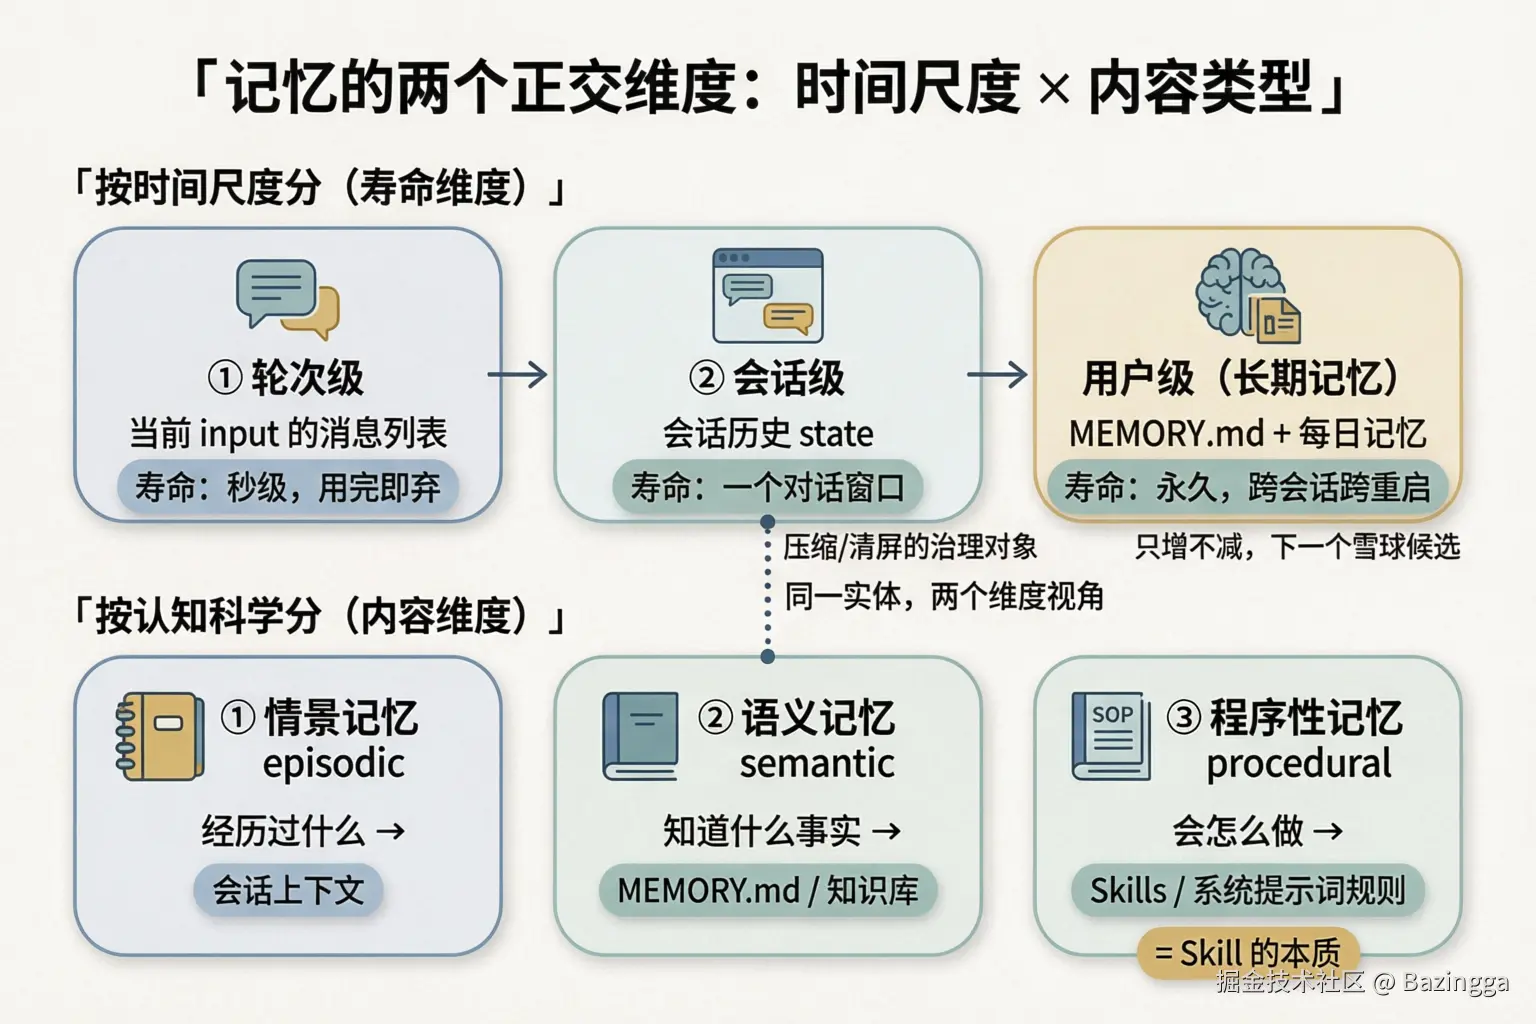
上层按时间尺度分三层(寿命维度),下层按认知科学分三类(内容维度)------同一套记忆实体,两个视角。
6.1 时间尺度维度:轮次、会话、用户
| 层 | 载体 | 寿命 | 治理对象 |
|---|---|---|---|
| 轮次级 | 当前 input 的消息列表 | 秒级,用完即弃 | 压缩 / 驱逐 / 滑窗(§4~§5 的主角) |
| 会话级 | 会话历史 state(DB 一行或一份 jsonl) | 一个对话窗口 | 压缩触发线 / 清屏 / 会话归档 |
| 用户级 | 长期记忆文件(MEMORY.md + 每日记忆) | 永久,跨会话、跨重启 | 多数系统为零治理------下一个雪球 |
三层的关系是包含与喂养:轮次级膨胀成会话级雪球(本文主题);会话级被框架的 consolidation 周期任务提炼沉淀进用户级;用户级每轮全量注入回轮次级的底座。第三层只增不减的特性使它成为慢性雪球------案例项目的每日记忆单日可沉淀 6 万字符,而这一层没有任何压缩、驱逐、滑窗机制。会话治理做完的那天,就是长期记忆治理提上日程的那天。
存储结构上有一个容易踩的隔离陷阱:会话记忆按 userId + sessionId 复合键隔离,长期记忆的路径里只有 userId、没有 sessionId------意味着「清空本会话」的任何操作都不该碰长期记忆(案例项目实测验证:清空会话后长期记忆文件逐字符完好)。两层的隔离维度不同,「清理」的语义就不同------把会话清理实现成连带清记忆,是数字分身类应用最贵的一类误删。
6.2 内容维度:认知科学的经典三分法
时间维度之外,记忆还按内容性质分三类------这套来自认知科学,已被 agent 学术界和工业界普遍采纳(LangChain 的 LangMem 就按它直接建模):
| 类型 | 存什么 | Agent 里的落地形态 |
|---|---|---|
| 情景记忆(episodic) | 「经历过什么」------事件与经历的时序记录 | 会话上下文、每日记忆 |
| 语义记忆(semantic) | 「知道什么事实」------脱离具体经历的知识 | 长期记忆事实层、RAG 知识库 |
| 程序性记忆(procedural) | 「会怎么做」------技能与流程 | Skills、系统提示词规则、few-shot 示例 |
第三行值得停一下:Skill 的认知科学本质就是程序性记忆。一个 SKILL.md 文件(流程、红线、工具用法)和一段情景记忆(上次这么干成功了)的区别,正是「程序性」与「情景性」的区别。这解释了两者在注入策略上的分野------程序性记忆是「怎么做」的规程,值得常驻或按任务类型加载;情景记忆是「发生过」的流水,适合摘要与检索。
三类之间还会互相转化:会话里反复出现的模式先沉淀为情景记忆(每日记录),频率够高后蒸馏成程序性记忆(一条 skill 规则)------个人知识管理里「经验变习惯」的机制,在 agent 记忆里同名重现。
6.3 架构维度:市面上的六大流派
时间 × 内容两个维度描述「记什么」,还剩一个维度描述「怎么记」------2026 年的市面格局可以收拢成六个流派,每个流派是三个根本问题(记什么、怎么召回、记忆长什么样)的一组押注:
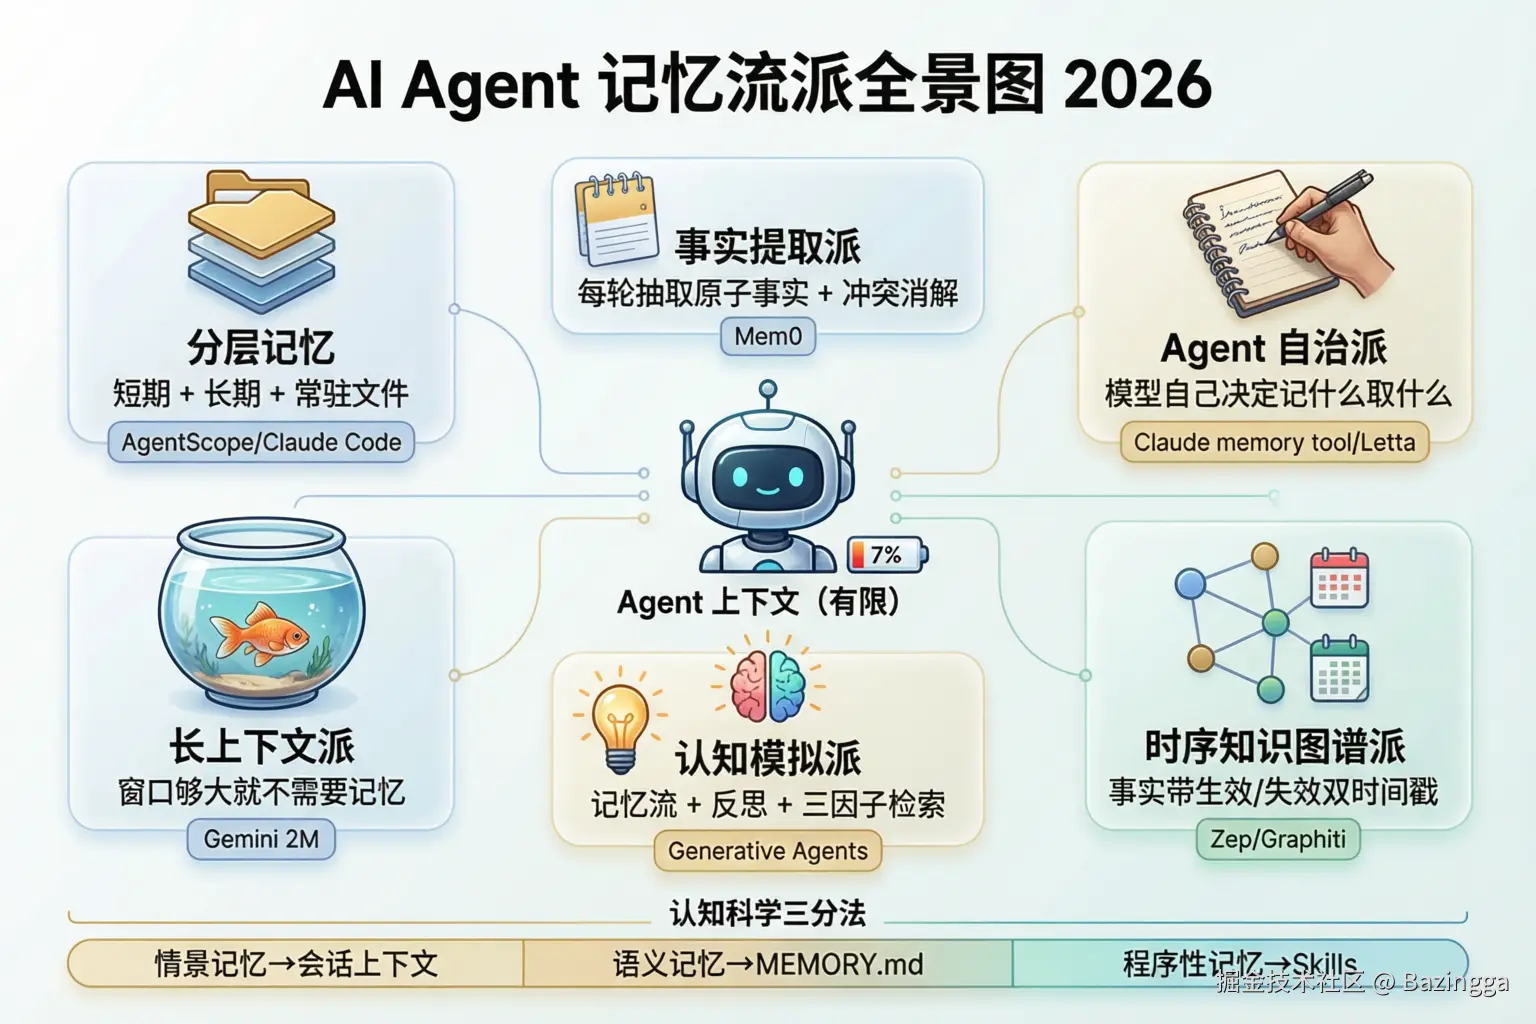
六大流派围着同一个有限上下文;底部是贯穿的认知科学三分法------三层维度(时间/内容/架构)在一张图上各占一席。
① 分层记忆------会话短期 + 文件长期 + 常驻底座,本案例与 Claude Code(CLAUDE.md/MEMORY.md 双层)走的就是这条路。优点是简单直观、无外部依赖;弱点是层间搬运靠定期 consolidation,长期层只增不减。
② 事实提取派(Mem0,约 66K stars,最火) ------每轮对话后跑一条流水线:LLM 把对话抽取成原子事实,与既有记忆比对,做 ADD/UPDATE/DELETE 决策,检索时向量 + BM25 + 实体三路融合。用官方 Python SDK 表达它的核心用法:
python
from mem0 import Memory

m = Memory()  # 或 Memory.from_config({"llm": {...}, "vector_store": {...}})

# 写入:不是存原文,而是提取事实并消解冲突
m.add("我把生产服务器从北京迁到了杭州,老的北京机器下月停用", user_id="alex")

# 事后写入新事实------流水线会判定它与旧事实的关系(更新/并存/失效)
m.add("生产服务器又从杭州迁到了上海", user_id="alex")

# 检索:按当前问题召回相关事实(融合向量、词法、实体三路信号)
m.search("我的生产服务器在哪", user_id="alex")它火的根本原因是集成姿态:drop-in API,十行代码给现有应用加记忆层,不动你的 agent 架构。弱点是原子事实抽取本身每轮要过一次 LLM(写入有成本),且开源版的冲突消解比商业版简化。
③ Agent 自治派(Claude memory tool / Letta) ------不给系统写死记忆规则,给模型一个记忆工具,让它自己决定记什么、取什么。Anthropic 的官方 memory tool 长这样(MCP/工具定义示意):
json
{
  "name": "memory",
  "description": "持久记忆的读写工具。路径以 /memories/ 开头;建议维护 index.md 作目录。",
  "input_schema": {
    "type": "object",
    "properties": {
      "command": {"type": "string", "enum": ["view", "create", "str_replace", "insert", "delete"]},
      "path":    {"type": "string", "description": "如 /memories/preferences.md"},
      "old_str": {"type": "string", "description": "str_replace 时的被替换文本"},
      "new_str": {"type": "string", "description": "替换为/插入的文本"}
    },
    "required": ["command", "path"]
  }
}
Letta(原 MemGPT)更激进:记忆是一组 git 管理的文件,agent 用文件工具自己编辑(self-editing memory),每次改动有版本历史可审计。这个流派的哲学是「记忆是 agent 的能力而非基建」------代价是把记忆质量交给模型自律,且依赖较强的指令跟随能力。
④ 时序知识图谱派(Zep / Graphiti,约 31K stars) ------事实存成图三元组,每条边带双时间戳。一条 Zep/Graphiti 风格的 fact 记录:
json
{
  "fact": "alex 的生产服务器位于杭州",
  "subject": "alex",
  "predicate": "生产服务器位于",
  "object": "杭州",
  "created_at": "2026-03-01T10:00:00Z",
  "valid_at":   "2026-03-01",
  "invalid_at": "2026-10-01",
  "expired_at": null
}
被新事实推翻时不删除、只填 invalid_at------像户口档案 :「2026-03 至 2026-10 服务器在杭州(已迁出)」而非撕了重写。这是全场唯一原生回答「过去某天什么是真的」的流派(双时态,bi-temporal:记录时间与事实生效时间分离)。凡是「会变的事实」密集的领域------账号、地址、权限、组织架构------这个结构都有天然优势;代价是图数据库的运维和查询复杂度(业界称之为 GraphRAG 税)。
⑤ 认知模拟派(学术源头:斯坦福 Generative Agents / Reflexion) ------最像人脑:记忆流(每条观察带时间戳入库)+ 三因子打分检索 + 定期「反思」生成高阶记忆。三因子公式是它最被广泛偷师的部分:
text
recall_score(mem) = α · relevance(mem, query)      // 语义相似度(向量余弦)
                  + β · recency(mem)                // 时近性:e^(-λ·Δt) 指数衰减
+ γ · importance(mem) // 重要性:入库时模型打分 1~10「用户最近在筹备搬家」这种高阶结论,不是任何单条观察里写的,而是反思机制从几十条低阶观察里合成出来的------记忆不只是存取,还会自我加工出新的层级。学术源头,商业产品多只取三因子而舍弃反思(反思的调用成本高)。
⑥ 长上下文派(反记忆派) ------「窗口够大就不需要记忆系统」:Gemini 的 1M2M tokens。物理上它把「全量历史塞进单轮」变成了可能,但两条硬约束还在:有效窗口 ≈ 宣称的 1/4~1/2(长中段检索类指令的准确率衰减,RULER 类研究反复证实------本文案例的 131K 窗口按此打折后约 30 60K 有效区);prefill 成本与延迟随窗口超线性增长。它不是记忆方案,是把记忆问题转化成了账单问题。
6.4 基准的罗生门
六流派各有自报的基准数字,但没有可横向比较的排行榜------同一套 LongMemEval/LoCoMo 基准,读法模型、judge、摄入路径不同,分数就不同。两个典型样本:某厂商宣称 93.4%,竞争对手用自家 harness 复测只跑出 73.8%(差 19.6 点);另一家自报 63.8~71.2%,换一个 judge 就到 90+。
选型时行话是「问 harness,别只问 score 」:谁跑的、用什么读法模型、什么 judge、什么摄入路径。厂商自报数字一律当参考上限------这也和 RAG 评测的老经验一致:judge 的宽严,常常比记忆系统本身的差异更能决定分数。
6.5 选型的第一刀:集成边界
六流派怎么选?先别看功能表,先回答一个边界问题------记忆系统该拥有你应用的多少:
| 你的处境 | 适配流派 | 一句话理由 |
|---|---|---|
| 已有 agent 运行时,只想加记忆 | Mem0 / Supermemory 类 drop-in API | 十行接入,不动架构 |
| 想让记忆管理成为 agent 行为的一部分 | Letta / Claude memory tool | 换 harness,换来 agent 自治 |
| 事实会变、要回答「过去某天什么是真的」 | Zep / Graphiti | 唯一原生双时态 |
| 有大量异构源材料要变成可查询知识 | Cognee 类图引擎 | 记忆引擎跑在你的数据上 |
| 个人/单机/数据不出本机 | 分层记忆 + 自研治理 | 控制权与隐私优先,成本最低 |
案例项目属于最后一行:单用户单机,多租户记忆基建整套引入是杀鸡用牛刀------但三个机制值得偷师,留作长期记忆治理立项时的设计输入:Mem0 的事实原子化 + 冲突消解 (长期记忆只增不减的解药)、Zep 的失效窗口 (账号/资产类「会变事实」的正确建模)、Letta 的 git-tracked 记忆(人格档案值得可审计可回滚)。
7. 处方映射:四个假设各配一味药
把企业级方案映射回四个归因假设:
| 假设 | 企业级对应 | 案例项目可落地动作 |
|---|---|---|
| A 会话记忆全量回填 | 滑动窗口 + 压缩(§4~§5) | 压缩管道已装配(实测 input -35%);滑窗中间件作为查询型场景的备选升级 |
| B 检索结果全文驻留 | 工具结果摘要 + 引用续读 | searchKnowledge 返回改「标题 + 摘要 + 块编号」,全文走 readKnowledgeContext 续读(通道已建好,只改输出格式) |
| C prefill 线性涨 | prompt caching | DashScope 上下文缓存------历史 append-only 前提下,64K 重发从「每轮全价全速」变「缓存价 + 秒回」 |
| D 底座缓慢增重 | 分层记忆(目录 + 按需取) | MEMORY.md 拆「活跃卡(小,全量注入)+ 归档卡(大,检索召回)」------§6.1 的长期记忆治理立项时一并设计 |
四味药对应四条防线(2/4/6/3),没有一味需要推翻现有架构------都是「把已有零件从功能升级成防线」的组装活。
8. 下一步实验:先量化,再动手
归因目前是「结构上确认 + 推断」的混合态,下一步最有信息量的动作是拿曲线代替猜测:
同一会话连续问 3 个深挖题,抓 usage 帧画 input 逐轮涨幅曲线。
预期读法:涨幅斜率的主力是 B(每跳 +5 条 chunk 全文),底座跳变来自 A 的历史累积;如果曲线显示单轮涨幅远超预期,再回头细查多跳轮数。有了曲线,A/B/D 各占多少一目了然,处方不用猜------这也是「撞墙取证再动手」的一贯纪律:先测量,再治疗。
9. 结语:一个心智模型 + 三条铁律 + 一张版图
把全文压缩成一个心智模型:
把 LLM 的上下文当 RAM,不要当硬盘。
它昂贵(每轮重发都计费)、易失(超出窗口就丢)、还越满越慢(prefill 线性涨)。雪球的根源就是把 RAM 当硬盘用------什么都往里存,存了就不再拿出来,然后每一轮都背着全部库存重新付费。
八层防线归根到底三条铁律:
- 只放当下需要的------按需检索、显式注入、目录式记忆;
- 放不下就压缩------有损摘要保任务状态,原始记录外置可回溯;
- 过程隔离在子上下文------脏活下放子 agent,主线只留结论。
而本文后半程的三层追问,把这三条铁律接到了一张更大的版图上:治理不是一次动作,是稳态 (锯齿循环 + 三个陷阱:估算口径、压缩抖动、驱逐的体外循环);治理策略没有唯一解,只有交换 (删与摘要之争的本质是近因精度换历史骨架);会话记忆只是记忆版图的三分之一(时间三层、内容三类、架构六流派------程序性记忆就是 Skill,长期记忆是下一个雪球)。
对照着看,那次 164 秒的慢问不是什么神秘故障,而是压缩/分层/续读/缓存四层防线一层都还没建时的必然现象。零件都在手里了------缺的不是零件,是把它们从「功能」升级成「防线」的那次系统性组装;而装完防线的那天,下一个战场已经在版图上标好了位置。
至于那 164 秒本身,它最大的价值是把一个抽象问题变成了具体账单:input 64413、output 218、耗时 164 秒------从此每次讨论上下文管理,我们都不是在谈玄学,是在谈这三个数字背后那颗滚大的雪球,以及锯齿、版图和三岔路上每一个可计算的交换。