**一句话看懂:**它把长文档 OCR 从"一页一页翻着抄",变成了"摊开整本匀速抄"------靠的是让模型的记忆(KV Cache)不再越攒越多,而是始终保持一个固定大小。
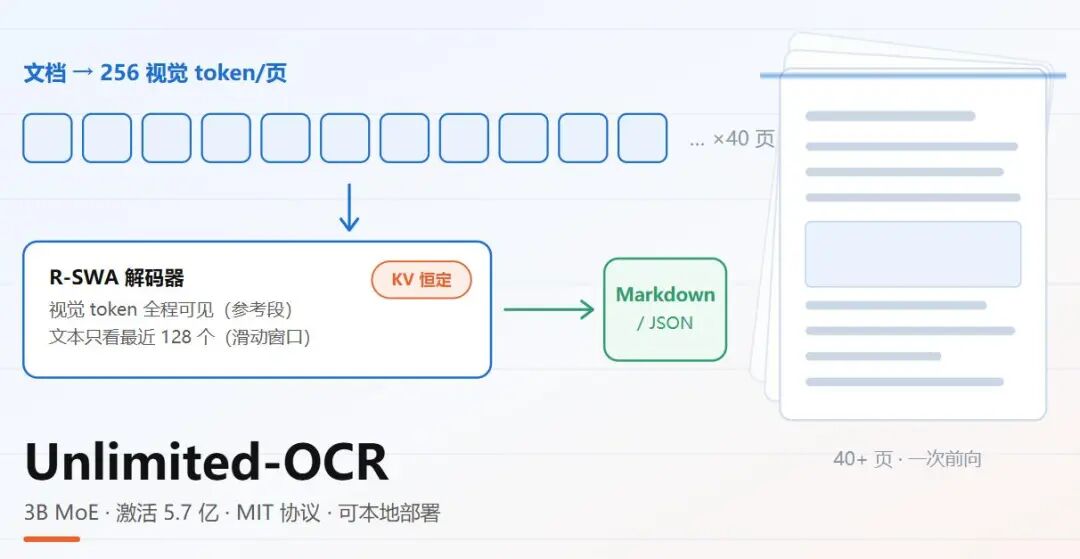
Unlimited-OCR 的整体流程------整份文档一次进,Markdown 一次出。
一、先说痛点:长文档 OCR 卡在哪儿?
用过端到端 OCR 模型的人,大概都踩过两个坑。
第一个坑叫"分页割裂"。传统流程是把 PDF 拆成一页页,逐页识别再拼回去。一旦遇到跨页表格、跨页段落、脚注和章节引用,上下文就在页面边界被硬生生切断,拼出来的东西看着像那么回事,进库一查全是错。
第二个坑更隐蔽,叫"越生成越慢"。这类模型的解码器本质上是个大语言模型,每生成一个 token,都要把前面所有 token 的 Key/Value 缓存(KV Cache)留在显存里。输出越长,这份缓存就越滚越大------显存被吃掉,注意力计算量也随长度水涨船高。于是模型在第 1 页时健步如飞,到第 40 页时已经气喘吁吁
这两件事其实是一件事:模型"记得太多",又"看不全"。Unlimited-OCR 的解法,是让它学会像人抄书那样------眼睛始终盯着原书,笔尖只看刚写下的几个字。
二、Unlimited-OCR 是什么:一个被"改了一层"的 3B 模型
它不是一个从零训练的大模型,而是一次非常克制的改造:
底座:DeepSeek-OCR。编码器 DeepEncoder 整体冻结,只训练解码器,继续训练约 4000 步,训练样本约 200 万份文档。
规模:总参数 3B,MoE 架构,推理时仅激活约 5.7 亿参数(部分报道写作"约 5 亿 / 570M",口径一致)。
改动:把解码器里所有的注意力层换成新方法 R-SWA。就这一层。
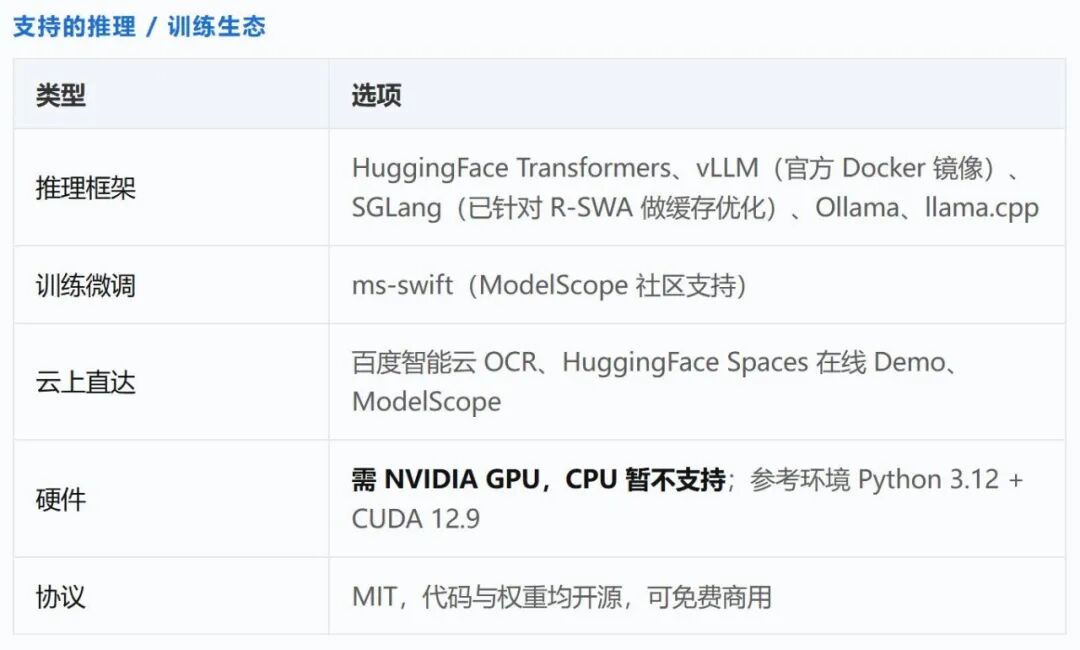
协议:MIT 开源,代码与权重公开,可免费商用。
三、核心创新 R-SWA:把 KV Cache 从"线性增长"压成"一条平线"
R-SWA,全称 Reference Sliding Window Attention(参考滑动窗口注意力)。名字有点唬人,道理很朴素。
想象你在抄一本书:眼睛始终落在书页上,手上只关心刚写完的那几个字,你不会每写一个字就回头把前面抄过的三千字重读一遍。人也正因为这样,抄一整天也不会越抄越慢。
R-SWA 做的就是这件事。它把注意力切成两段:
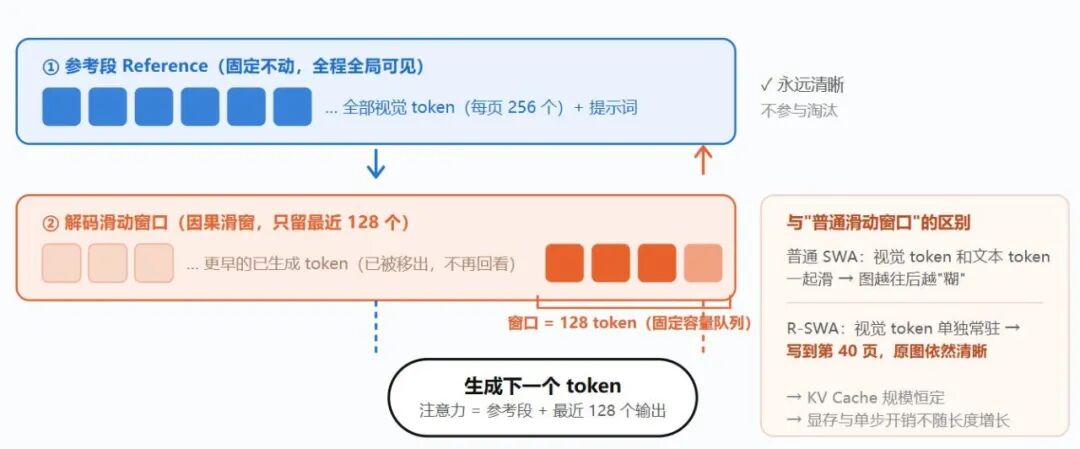
R-SWA 的两段式注意力。参考段常驻不动,滑动窗口像固定长度的队列,进一个、出一个。
1、参考段(Reference):全部视觉 token + 提示词,在整个解码过程中全局可见且状态固定,不参与淘汰。
2、滑动窗口(Sliding Window):对已生成文本仅保留最近 128 个 token,更早的自动移出。KV Cache 因此变成一个固定长度的队列------进一个,出一个。
结果就是:无论输出 1 万还是 10 万 token,显存占用和单 token 的计算开销都保持恒定。这是它和普通滑动窗口注意力(SWA)的关键差别------普通 SWA 会把视觉 token 和文本 token 一起扔进滑窗,写到后面,最初的页面图像早被挤出窗口,模型对原图越来越"糊";R-SWA 则让视觉 token 常驻,写到第 40 页,第 1 页依然清晰。
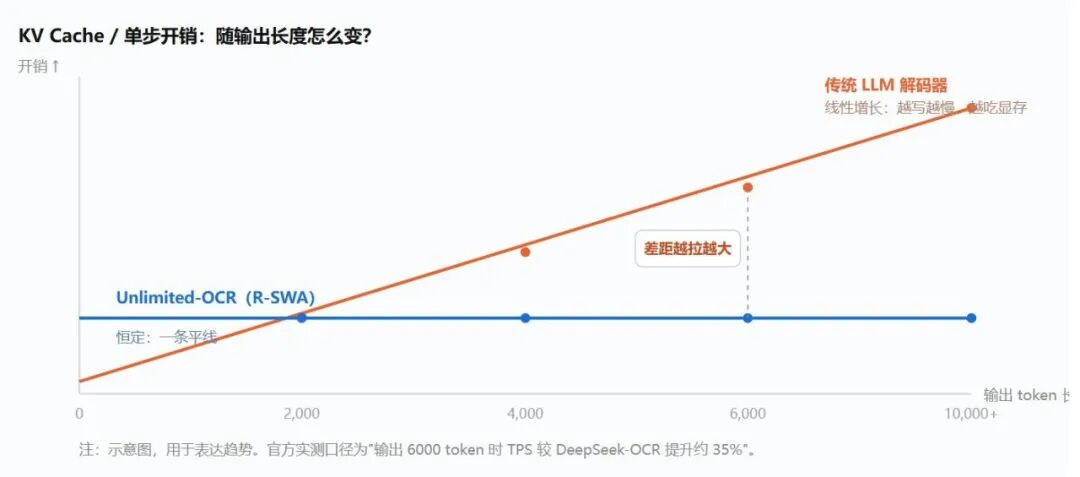
一条斜线,一条平线。长文档解析的性能衰减问题,本质就是这条斜线。
四、数字说话:它到底有多强
先看精度。在文档解析权威基准 OmniDocBench 上,Unlimited-OCR 拿下了端到端模型的第一:
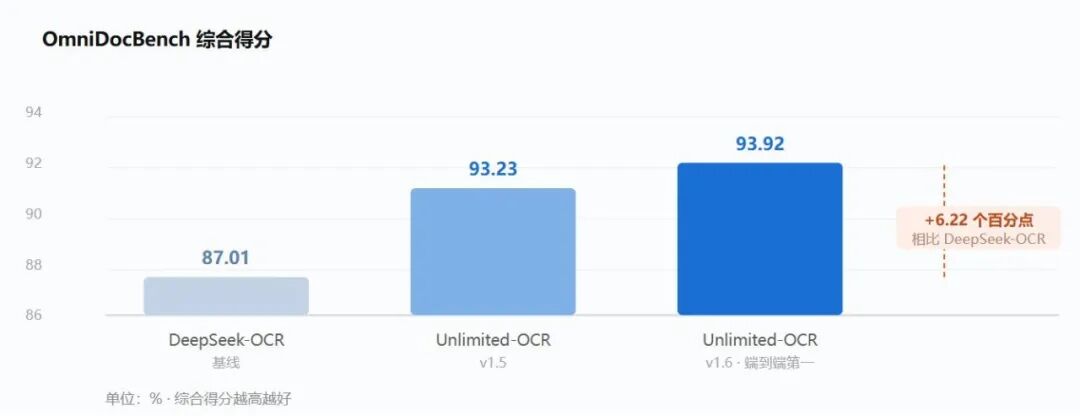
从 87.01 到 93.92,用的是同一个编码器,改的只是解码器的注意力。
再看长文档能力,这是它的主战场:
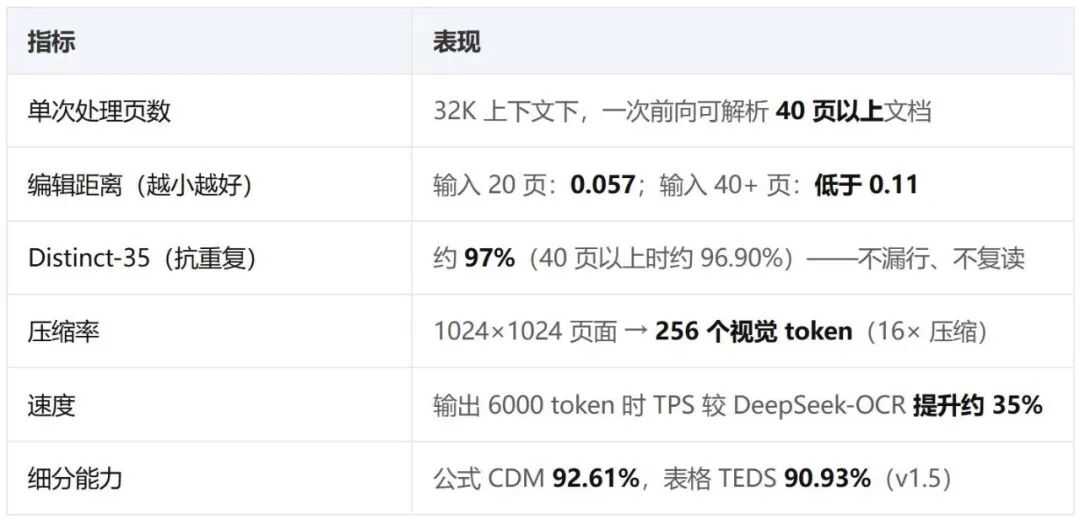
五、能拿来干什么:从"识别工具"变成"数据入口"
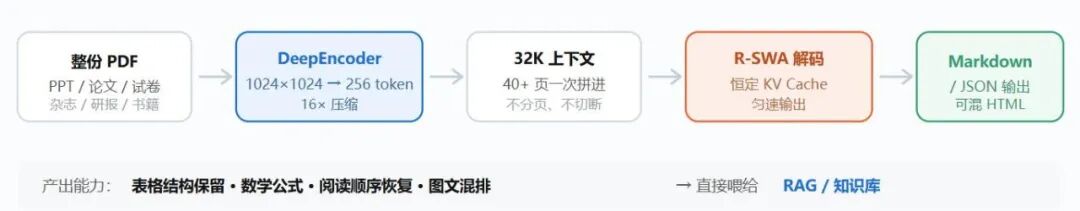
端到端流水线。输出不是"一堆文字",而是可直接入库的结构化文档。
几个很实际的点:
-
输出即可用。直接产出 Markdown(可混 HTML 保留表格结构),支持表格、数学公式和阅读顺序恢复,不用再做一遍版面还原。
-
两种编码模式。Base 模式 1024×1024,适合多页长文档;Gundam 模式动态分辨率,适合单页高精度识别。
-
版式覆盖广。PPT、学术论文、书籍、彩色教材、试卷、杂志、报纸、手写笔记、研究报告都能吃。
-
适合做 RAG 的数据入口。过去知识库建设最脏最累的一环是"文档解析",跨页表格丢一半、公式变乱码。一次成型的 Markdown,直接把这一步的成本砍下来。
六、想上手:部署与限制
用 Transformers 跑一份多页 PDF,核心代码就这么几行:
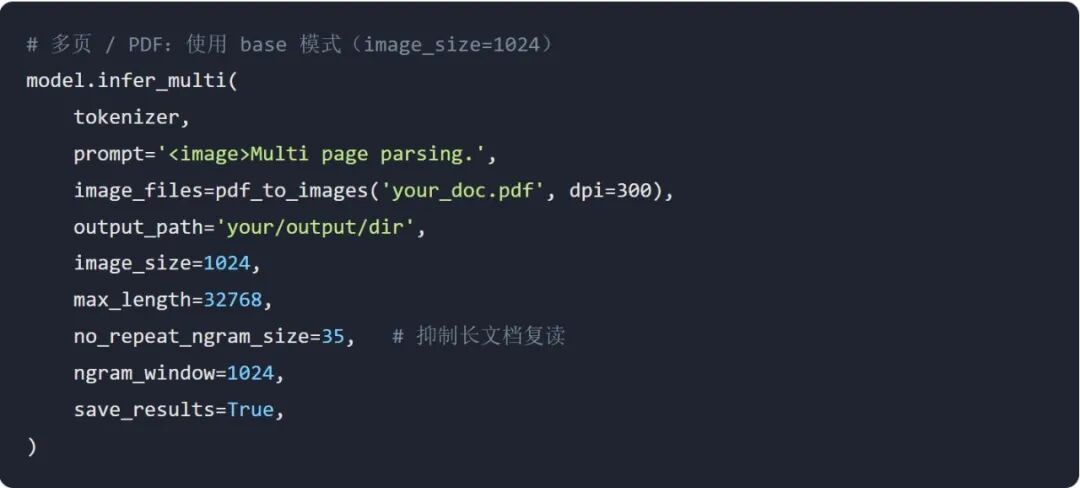
其中 no_repeat_ngram_size=35 是长文档场景的关键开关------它用来压制模型在长序列上"复读"的倾向,这也是 Distinct-35 这个指标名字的由来。
需要冷静看待的三件事
"Unlimited"是愿景,不是承诺。名字里的"无限"指架构上不再受长度衰减约束,但当前稳妥的处理范围大约在 40--60 页,训练上下文窗口为 32K。真拿一本 500 页的书硬塞,它也会崩。
必须有 GPU。目前明确不支持 CPU 推理,纯 CPU 环境只能走云端 API。
细节仍需校验。编辑距离 0.11 意味着长文档仍存在少量字符级偏差,涉及合同、财务、医疗等关键场景时,人工复核这一步省不掉。
七、真正值得关注的,其实不是 OCR
R-SWA 这个机制,本质上在回答一个更普遍的问题:当生成任务有一个"固定不变的参考源"时,为什么还要为已生成的历史无限买单?
符合这个特征的任务,远不止 OCR:
-
语音识别(ASR):音频特征就是那个"参考段",转写文本只需要近期上下文。
-
机器翻译:源语言句子是参考,目标语言生成只需要局部窗口。
-
长视频理解、长音频字幕、代码仓库级生成:同理。
团队已经明确表示要把 R-SWA 推广到 ASR、翻译等"参考型任务"上,同时计划把训练上下文窗口扩展到 128K,并探索 Prefill Pool(预填池)机制,按需调取历史状态。
换句话说,这是一次"注意力机制层面的降本"。它没有靠堆参数、堆算力,而是把一处明显的结构性浪费给堵上了------3B 的模型、5.7 亿的激活参数,跑出了超过一众大参数竞品的效果。这种思路,比分数本身更值钱。
八、该不该现在就用?
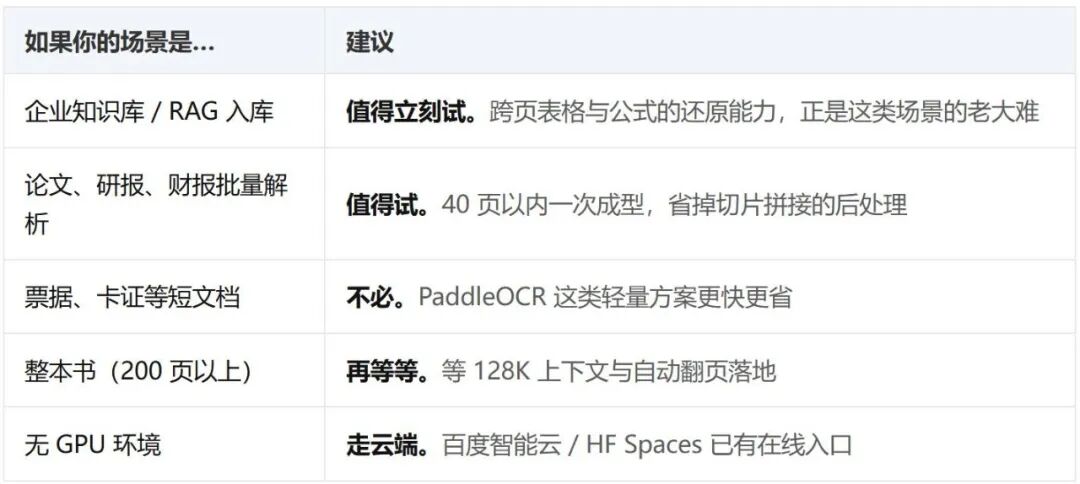
相关链接:
GitHub:https://github.com/baidu/Unlimited-OCR
HuggingFace:https://huggingface.co/baidu/Unlimited-OCR