项目简介
BitNet (bitnet.cpp) 是微软官方推出的专为 1-bit 大语言模型(如 BitNet b1.58)设计的高性能推理框架。该项目基于 llama.cpp 构建,旨在通过极致的量化技术(如 I2_S 和 TL1),在 CPU 和 GPU 上实现 1.58-bit 模型的快速且无损推理。其核心目标是降低大模型在边缘设备和本地部署的硬件门槛与能耗,同时保持接近全精度模型的 perplexity 表现。
核心功能
- 极速 CPU 推理:针对 x86 (AVX2) 和 ARM (NEON) 架构提供优化的内核,相比全精度模型实现显著加速(x86 上最高 6.17x,ARM 上最高 5.07x)。
- 极低能耗:大幅降低推理过程中的能源消耗,x86 平台节能高达 82.2%,ARM 平台节能高达 70.0%。
- 多架构支持:不仅支持 CPU,还发布了官方 GPU 推理内核,并预告将支持 NPU。
- 多样化模型支持:原生支持 BitNet-b1.58 系列(包括 2B、3B、8B 等参数规模),以及最新的 BitNet Embedding 模型(0.6B 和 270M)。
- 无损量化推理:采用 I2_S 等量化方案,在减少权重的同时保持模型质量的"无损"或接近无损。
- 嵌入式与 ASR 扩展:发布了专门的 1-bit 嵌入模型以加速向量检索,以及 VibeASR.cpp 用于实时多语言语音识别。
技术栈
- 核心语言:C++ (提供底层高性能内核)
- 构建工具:CMake (>=3.22)
- 编译器:Clang (>=18) 或 Visual Studio 2022 (Windows)
- 依赖库 :基于
llama.cpp框架,利用其 Lookup Table 方法论及 T-MAC 内核技术。 - 运行环境 :Python (>=3.10) 用于脚本管理和模型转换,支持 Conda 环境管理。
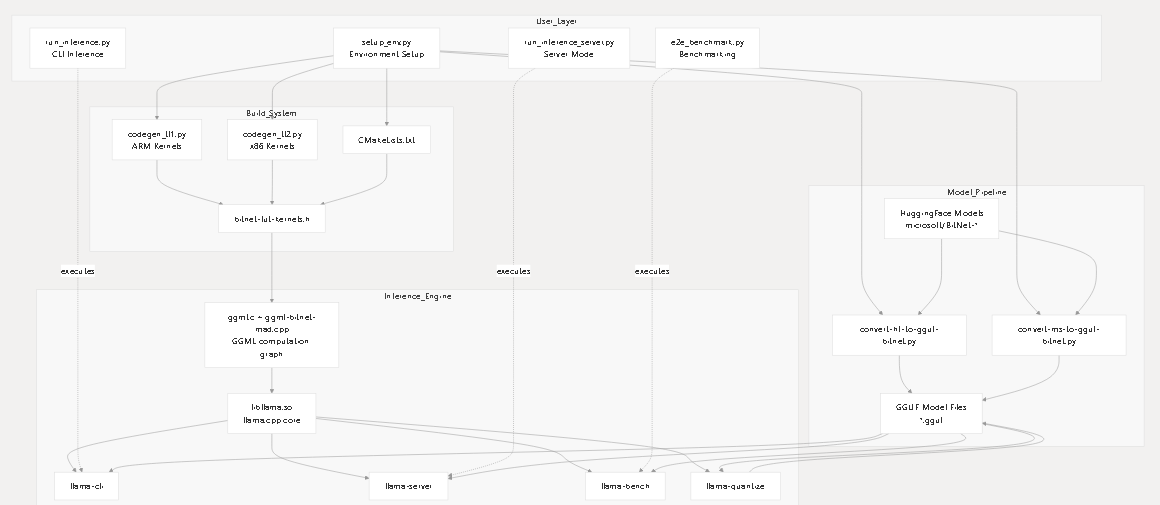
亮点与特点
- 硬件友好性极强:能够在单颗 CPU 上流畅运行 100B 参数的 BitNet b1.58 模型(达到 5-7 tokens/秒的人类阅读速度),极大拓展了本地部署 LLM 的可能性。
- 官方生态整合:微软直接发布了配套的 1-bit 预训练模型(如 BitNet-b1.58-2B-4T)及 Embedding 模型,实现了从训练到推理的完整闭环。
- 前沿量化技术:引入了 I2_S 转换和 TL1 内核优化,证明了 1.58-bit 权重在保持性能的同时能带来巨大的效率提升。
- 跨平台兼容性:详细适配了 Windows (VS/Clang)、Linux (Debian/Ubuntu) 及 macOS (Apple Silicon) 的构建流程,降低了使用门槛。
- 实时应用潜力:通过 VibeASR.cpp 等项目展示了在低线程数下实现实时语音识别的能力,证明了其在资源受限场景下的实用性。
适用场景
- 边缘设备部署:适用于内存和算力有限的设备(如手机、IoT 设备、树莓派等),利用 ARM CPU 的高效性运行大模型。
- 绿色计算/数据中心优化:适合对能耗敏感的大规模推理服务,通过降低功耗来减少运营成本。
- 本地化私有部署:个人开发者或企业可在普通 PC 或服务器上低成本部署 7B-100B 级别的大模型,无需依赖高端 GPU 集群。
- 向量检索加速:使用 BitNet Embedding 模型进行快速、低成本的文本嵌入生成,适用于 RAG 系统中的索引构建阶段。