在之前的文章《Ultra X7 358H 笔记本电脑,本地部署当红炸子鸡 Qwen3.8-27B-Q4,实测生成速度 5.6 tok/s》中,已完成 Qwen3.8-27B-Q4 模型的本地部署。
但是 Qwen3.8-27B-Q4 实际生成速度很慢,于是便想找一个模型能力差不多的,速度再快一点儿的可以本机部署的大模型,了解到 Bonsai-2-27B 模型之后,便想试一试。
Bonsai-2-27B 是 Prism ML 于 2026-09-17 发布的 27B 级多模态推理模型,基座是 Qwen3.8-27B(架构未改,只做低比特化)。Apache 2.0,27.36B 参数,262K 上下文,文本+图像。
首先看实测结果:11.6 tok/s
随便输入一个问题,最后有速度统计:
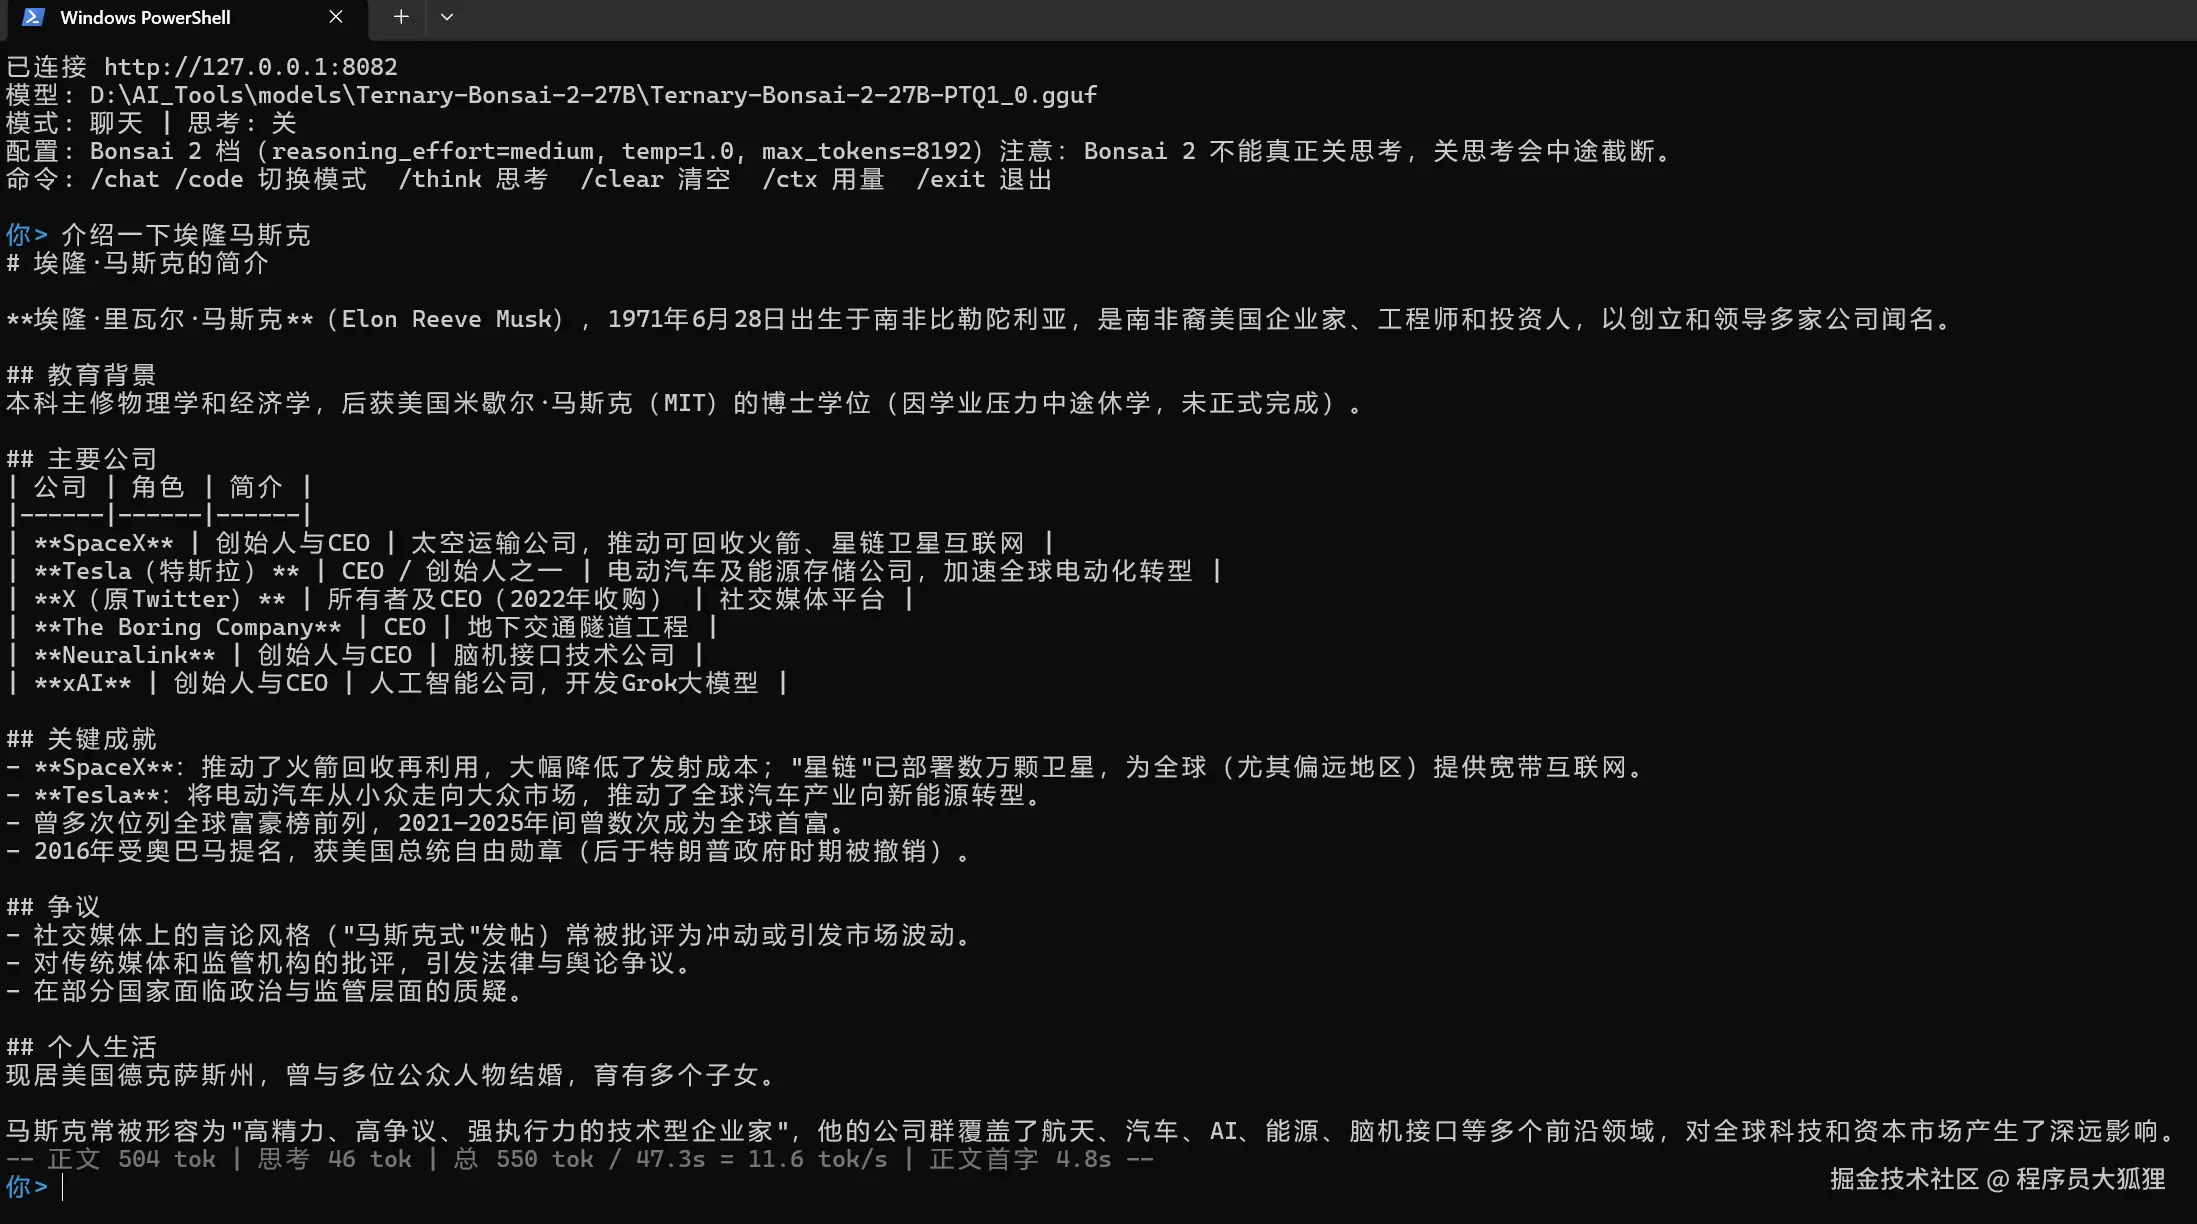
以下是部署过程的 AI 总结(Deepseek Harness Desktop + Deepseek V4.1 Flash):
本机新增部署:Bonsai 2 27B(Prism ML 三值量化模型)
结论:可行,已部署完成并实测通过。
但和现有两个模型不同:不能用现有的 llama.cpp + SYCL 引擎跑 ,必须换成 PrismML 的分支(
prismbranch),且该分支没有 Windows SYCL 预编译包,需要自己编译。实测:11.8 tok/s (Arc B390 iGPU),权重仅 5.54 GiB ,读图正常。
本文所有数字均为本机实测,来源见文末。
结论摘要
| 项目 | 结果 |
|---|---|
| 模型 | prism-ml/Ternary-Bonsai-2-27B-gguf → PTQ1_0(5,946,648,928 字节 = 5.54 GiB) |
| 基座 | Qwen3.8-27B(arch = qwen35,26.90B 参数,原生 262144 上下文) |
| 引擎 | PrismML-Eng/llama.cpp prism 分支 @ 2459f68(= 官方 prism-b10754),自行编译 SYCL 版 |
| 速度(生成) | 11.79 tok/s(GPU);CPU 对照仅 3.67 tok/s |
| 速度(提示处理) | 289.48 tok/s @512(GPU);CPU 对照 206.15 tok/s |
| 加载耗时 | 约 9~12 秒 |
| 内存占用 | 64k 上下文 14.90 GiB ;加视觉塔 15.62 GiB(系统余 5.2 GiB) |
| 上下文 | 默认 65536,原生上限 262144 |
| 视觉 | ✅ 已验证读图(mmproj Q8_0,0.59 GiB,可选加载) |
| 与现有模型的关系 | 完全独立,端口 8082,不影响 8080 的两个 Qwen 模型 |
一句话定位 :现有 dense Qwen3.8-27B(Q4,15.33 GiB,4.5-4.6 tok/s)速度翻倍、体积只剩 1/3; 但打不过 Qwen3.6-35B-A3B(MoE,23-24 tok/s)------因为 Bonsai 2 是稠密 27B,激活全部参数。
可行性判断:为什么现有引擎直接跑不了
Bonsai 2 用的是自定义量化类型
Bonsai 2 发布两种打包:
- PTQ1_0 --- 密集三值(trit),1.75 bits/weight,5.95 GB
- PQ2_0 --- 每个三值占 2-bit 槽,2.13 bits/weight,7.21 GB
这两个类型是 PrismML 新增的,上游 llama.cpp 里根本不存在。 本机实测证据:
ini
本机 llama.cpp\ggml\include\ggml.h:
    GGML_TYPE_TQ1_0   = 34
    GGML_TYPE_TQ2_0   = 35
    GGML_TYPE_Q1_0    = 41
    GGML_TYPE_Q2_0    = 42
    ← 没有 PQ2_0 / PTQ1_0
而且模型自带的 KNOWN_ISSUES.md 明确写了两点(原文):
PQ2_0andPTQ1_0are new quantization types, and support for them isn't in mainline llama.cpp yet. Stock llama.cpp, Ollama and LM Studio (GGUF) can't load thePQ2_0orPTQ1_0files.The
F16file loads in stock llama.cpp but produces garbled output, because it depends on metadata only the PrismML build applies.
还有一个更隐蔽的坑:Hadamard 旋转
Bonsai 2 的权重存在旋转基里(blockwise Hadamard 变换后才是三值),运行时必须对激活 做匹配的变换。本机 GGUF 头部实测确认了这些元数据:
ini
prism.hadamard.version            = 1
prism.hadamard.block_size         = 1024
prism.hadamard.transform          = normalized-sylvester-walsh-hadamard
prism.hadamard.axis               = input-last-dimension
prism.hadamard.sign_mode          = explicit
prism.hadamard.weight_names       = arr[str,401]
prism.hadamard.sign_widths        = [5120, 6144, 17408]
prism.hadamard.sign_values        = arr[i32,28672]
prism.hadamard.gdn_v_grouped = true这就是"能加载但输出乱码"的根因:格式解出来了,变换没做。本机日志确认分支正确套用了它:
css
load_tensors: loaded 402 Hadamard-folded weight(s) (1 inverse-lookup)
              using 1 rotation(s) and 3 sign vector(s)
结论:必须用 PrismML 分支,没有捷径。
后端选择(本机最关键的一个决策)
Bonsai 2 官方支持 CPU / CUDA / Metal / ROCm / Vulkan / SYCL。本机是 Intel Arc B390 核显, 候选只有三个:Vulkan 预编译包、SYCL 自编译、CPU。
Vulkan 预编译包在本机是个陷阱
官方有现成的 llama-prism-b10754-2459f68-bin-win-vulkan-x64.zip(已下载备用), 但恰好不适用于本机,两条独立的原因:
-
驱动版本正好落在禁用区间。
BACKEND-SUPPORT.md原文:Vulkan: FWHT kernels are disabled on Intel proprietary Windows drivers from 32.0.101.8509 up to, but not including, 32.0.101.8860 because of crashes.
本机驱动正是 32.0.101.8509 (
KNOWN_ISSUES.md里 27B 专用的 Arc B390 例子也是它)。 落在区间内 → FWHT 被禁用 → 退化成稠密矩阵乘 → 慢。而 FWHT 又正是第 2.2 节那个必需变换。 -
未修复的挂起 bug。
PTQ1_0on Vulkan can hang Intel Arc GPUs after about 1,900 tokens. Workaround: run on CPU for now. Status: open
SYCL 可行,但官方没发预编译包
KNOWN_ISSUES.md 里 SYCL 那行写的是:
The SYCL build can't run
PQ2_0orPTQ1_0yet ; it stops at load with "unsupport data type". Workaround: on Intel GPUs, use the Vulkan build for now. Status: fix in review (#235)
注意 BACKEND-SUPPORT.md 的支持矩阵(SYCL 对 PQ2_0/PTQ1_0 都是 ❌)是过期的------ 它自己声明审计基线是老版本:
Source audit:
prism-b10709-9a9394a... Pending PRs and newer branch code do not count as released support.
而 prism 分支在 b10709 之后 已合入一串 SYCL 工作(本次 clone 的 2459f68 全部包含):
| PR | 标题 | 合并时间 |
|---|---|---|
| #235 | sycl: add PTQ1_0 and PQ2_0 support with MMVQ vector dot kernel | 2026-09-24 |
| #278 | sycl: 2-3x prompt processing speedup by dequantizing PTQ1_0/PQ2_0 to FP16 | 2026-09-28 |
| #288 | sycl: pick the src1 fp16 conversion from the runtime oneDNN switch | 2026-09-28 |
| #294 | sycl: XMX path for PQ2_0 and PTQ1_0 on 16-wide DPAS devices | 2026-10-02 |
| #302 | sycl: FWHT for widths above 512 and Kronecker sizes | 2026-10-02 |
其中 #294 的 XMX/DPAS 路径正好针对本机 GPU :Arc B390 是 Xe3/Panther Lake, 报告 16-wide subgroup,属于 DPAS16 设备。 #302 也很关键 ------它补上了宽度 >512 的 FWHT,而本机 sign_widths 是 [5120, 6144, 17408], 全都在 512 以上,没有它就会退化成稠密矩阵乘。
结论:选 SYCL 自编译。 唯一代价是要编译(493 个目标)。
部署过程
环境
| 项目 | 值 |
|---|---|
| CPU | Intel Core Ultra X7 358H(16 核) |
| GPU | Intel Arc B390(核显,96 CU / 17677 MiB 可分配),驱动 32.0.101.8509 |
| 内存 | 31.55 GiB(共享给核显 80%) |
| 编译器 | oneAPI DPC++/C++ 2025.3.3(icx) |
| MSVC / SDK | VS BuildTools MSVC 14.44.35207 + Windows SDK 10.0.26100 |
引擎编译
源码:git clone --depth 1 --branch prism https://github.com/PrismML-Eng/llama.cpp → D:\AI_Tools\llama.cpp-prism,独立目录,不动现有 llama.cpp。
构建脚本:D:\AI_Tools\build-bonsai-sycl.cmd,关键参数:
ini
-DGGML_SYCL=ON
-DGGML_SYCL_TARGET=INTEL
-DGGML_SYCL_DEVICE_ARCH=ptl        ← 关键,见下
-DGGML_SYCL_DNN=ON
-DGGML_SYCL_GRAPH=ON
-DGGML_SYCL_HOST_MEM_FALLBACK=ON
-DGGML_SYCL_SUPPORT_LEVEL_ZERO_API=ON
-DLLAMA_BUILD_MTMD=ON              ← 视觉塔需要
GGML_SYCL_DEVICE_ARCH=ptl 是必须的,它同时决定了两件事:
-
AOT 编译 Panther Lake 设备镜像(否则运行时 JIT,首次启动要现场编译)
-
决定 XMX 内核编不编 ------
ggml/src/ggml-sycl/CMakeLists.txt的逻辑是:只有当所有 AOT 设备都属于^(pvc|bmg|lnl|ptl|wcl|nvl|cri|xe-hpc|xe2|xe3)时,才编译pq2_xmx.cpp。 设备名不对会打印not building the PQ2_0/PTQ1_0 XMX path并退化成慢路径。 本次配置日志确认走了正确分支:bash-- GGML_SYCL_DEVICE_ARCH=ptl (AOT via spir64_gen) -- Found oneDNN: D:/AI_Tools/Intel/oneAPI/dnnl/latest/bin/dnnl.dll(
ptl这个名字也先用ocloc compile -device ptl验证过可用。)
踩过的坑 :第一次 configure 直接失败,LNK1104: 无法打开文件"kernel32.lib"。 原因是只调了 oneAPI 的 setvars.bat,没有 MSVC 环境。修法是先调 vcvars64.bat 再调 setvars.bat,脚本里已按此顺序固化。
另一个坑(只在手敲命令时出现):
set VAR=value && cmd会把&&前的空格并进变量值, 导致ONEAPI_DEVICE_SELECTOR变成"level_zero:gpu "→ SYCL 初始化失败、静默回落到 CPU 。 脚本里统一用set "VAR=value"写法避免。这正是第 5.1 节要做 A/B 验证的原因。
模型下载
huggingface.co 本机不通,改用镜像 hf-mirror.com (curl -C - 断点续传):
| 文件 | 字节数 | 说明 |
|---|---|---|
Ternary-Bonsai-2-27B-PTQ1_0.gguf |
5,946,648,928 | 语言模型,必需 |
Ternary-Bonsai-2-27B-mmproj-Q8_0.gguf |
629,246,976 | 视觉塔,可选 |
字节数与 HF 仓库 LFS 元数据完全一致。选 PTQ1_0 而不是 PQ2_0 的理由: 体积小(5.54 vs 6.71 GiB)、官方定位"内存最紧时的选择"。在 SYCL 的 DPAS16 路径上 PTQ1_0 首次使用时会被就地展开成 PQ2_0 的 XMX 布局(代码里 ggml_sycl_ptq1_xmx_expands 会为此预留空间),所以显存占用趋同,但下载和磁盘更省。
实测数据
后端 A/B:证明核显真的在干活
同一模型、同一二进制,只改 -ngl(llama-bench,各跑 2 轮):
| 后端 | 提示处理 pp512 | 生成 tg128 |
|---|---|---|
GPU -ngl 99 |
289.48 ± 0.64 t/s | 11.79 ± 0.00 t/s |
CPU -ngl 0 |
206.15 ± 0.99 t/s | 3.67 ± 0.08 t/s |
| 倍率 | 1.40× | 3.21× |
llama-bench 表头明确报 backend = SYCL、ngl = 99、fa = 1。
这一步是必要的,不是多余的:Bonsai 2 只有 5.5 GiB,纯 CPU 也能跑出 11 t/s 量级, 光看一个"11.7 tok/s"无法排除静默回落。3.67 → 11.79 的差距才是核显生效的证据。
内存
| 配置 | 进程工作集 | 系统剩余物理内存 |
|---|---|---|
| 32768 上下文 | 13.78 GiB | 5.98 GiB |
| 65536 上下文(默认) | 14.90 GiB | 5.09 GiB |
| 65536 + 视觉塔 | 15.62 GiB | 5.23 GiB |
上下文从 32k 翻到 64k 只多约 1.1 GiB ------因为 Bonsai 2 是 Qwen3.8 的 混合注意力骨架(约 75% 线性注意力),KV 增长远比 dense 模型便宜。
对比:现有 Qwen3.6-35B-A3B 加载后系统只剩 0.72 GiB,而 Bonsai 2 留 5 GiB 余量, 日常开着浏览器也不至于换页。
正确性验证(三项独立测试)
- 算术 :
17 × 23 = ?→ 输出17 times 23 is 391.✅(思考链正确) - 写代码 :迭代斐波那契 → 函数正确、含边界处理、遵守"只给代码"的指令 ✅ (243 token / 21.4 s = 11.4 t/s,
reasoning_effort: medium生效) - 读图 :生成的测试图(白底黑字
BONSAI 7742+ 一个矩形框)→ 输出BONSAI 7742/rectangle✅
速度定位
| 模型 | 架构 | 权重 | 生成速度 |
|---|---|---|---|
| Qwen3.8-27B UD-Q4_K_M | dense 27B | 15.33 GiB | 4.5~6 tok/s |
| Bonsai 2 27B PTQ1_0 | dense 27B 三值 | 5.54 GiB | 11.8 tok/s |
| Qwen3.6-35B-A3B UD-Q3_K_M | MoE(激活 ~3B) | 15.46 GiB | 23~24 tok/s |
Bonsai 2 相对 dense-Q4 的 27B 快约 2~2.6 倍、体积只剩 36% ; 但 MoE 的 35B-A3B 依然快一倍------这是架构差异,不是量化能弥补的。
怎么用
bat
:: 网页版(自动复用已有服务,否则启动 64k 上下文后开浏览器)
D:\AI_Tools\chat-bonsai.cmd

:: 终端版(省内存,这台机器更推荐)
D:\AI_Tools\chat-bonsai.cmd cli

:: 小一点上下文
D:\AI_Tools\chat-bonsai.cmd cli 32768

:: 带视觉(多占约 0.6 GiB,可以喂图)
D:\AI_Tools\chat-bonsai.cmd cli 65536 vision
服务地址 http://127.0.0.1:8082(独立端口,不与 8080/8092/8081 的 Qwen 冲突)。 通用启动器(自定义模型 / 上下文 / 端口 / 视觉):
bat
D:\AI_Tools\llama-server-bonsai.cmd default 65536 8082 vision接入编辑器:http://127.0.0.1:8082/v1,API Key 任意。
采样参数(模型卡推荐,启动器已内置)
- 思考模式:
temperature=1.0、top_p=0.95、top_k=20、min_p=0.05 min_p=0.05是 llama.cpp 自己的默认值,GGUF 里没存,所以不写也生效
必须知道的四个坑
输出额度给小了会"思考到没答案"
这是官方 KNOWN_ISSUES.md 列的头号问题。模型默认 xhigh 思考强度,思考也算输出 token 。 -n 256 之类的小额度会在思考中途截断,正文一个字都没有。
- 建议:输出额度 16384 以上 ,上下文 65536
- 想短一点:请求体加
reasoning_effort: "medium" reasoning_effort没有high,传了会 HTTP 500;只有low / medium / xhighlow实测并不比xhigh短多少
绝对不能用 enable_thinking=false 关思考------会中途截断(已实测并修好)
本机现成的 chat.html / chat_cli.py 用的是 enable_thinking=false(Qwen3.6 那套开关)。 对 Bonsai 2 这个推理模型 把它关掉,模型会说到一半就吐出结束符。
同一提示词(带两轮历史)实测对照:
| 客户端参数 | finish_reason | 输出 | 结果 |
|---|---|---|---|
enable_thinking=false, temp 0.3, max_tokens 2048 |
stop |
173 tok,思考 0 字符 | 截断 在 ...**高效训练**:通过创新 |
reasoning_effort=medium, temp 1.0, top_p .95, top_k 20, min_p .05 |
stop |
915 tok,思考 859 字符 | 完整收尾 |
关键 :finish_reason 是 stop 而不是 length ------ 不是额度用完,是模型自己提前结束 。 所以"加大 max_tokens"治不了这个病,必须改走 reasoning_effort。
另外 chat_cli.py 原本的默认 temperature=0.3 也偏离模型卡(要求 1.0), 且不发送 top_p / top_k / min_p。
正确开关:
- 推荐 :
reasoning_effort: "medium" - 要最强:
"xhigh"(模型默认),代价是思考更长、首字更慢(实测首字 73.6 s) - 没有
high,传了会 HTTP 500 "none"能真正关掉思考,但会复现上面的截断,不建议
已做的修复(纯新增,不影响两个 Qwen 模型的原默认值) : 给 chat_cli.py 增加了 --bonsai 档,发送 reasoning_effort (关思考 → medium,/think → xhigh)+ 模型卡采样参数, 并把 max_tokens 默认提到 8192、温度提到 1.0。 chat-bonsai.cmd cli 已自动带上该开关。
less
D:\AI_Tools\unsloth\scripts\chat_cli.py --port 8082 --bonsaichat.html 同样发 enable_thinking=false,因此 Bonsai 2 的网页入口用的是引擎自带的 WebUI (http://127.0.0.1:8082,已实测返回 HTML),而不是 chat.html。
工具调用有已知缺陷
官方标注:工具调用偶尔格式错误或死循环,arguments 为空会 400/500(要发 "{}"), 系统消息必须只有一条且在开头。做 agent 要留意。
不要试图用主line llama.cpp 或 Ollama/LM Studio
见第二节。尤其 Q2_0 版本 :主line 会成功加载并静默输出乱码,不报错------ 这是最危险的一种失败,容易被误判成"模型不行"。
它会自称"通义千问(Qwen)"------这是正常的,不是部署错了
实测(思考开启、参数正确)问"你是谁",回答:
我是通义千问(Qwen),由阿里巴巴集团通义实验室研发的通用大型语言模型。
原因:Bonsai 2 的模型卡写明 base_model: Qwen/Qwen3.8-27B,且 "architecture unchanged"。 它是在 Qwen3.8-27B 上做三值化得到的,基座的身份认知没有被覆盖。
判断部署是否正确的依据 应该是:ftype: PTQ1_0、prism.hadamard.* 元数据、 以及生成质量------不是它的自我认知。
附带一提:早期那次"DeepSeek 由何浩创立"的回答是幻觉。 换成模型卡参数后,同一问题的回答变成了带不确定性的版本 (结尾:"公司具体管理团队的公开信息有限......建议查看官方渠道")。 这正是思考被打开后的差别。
文件清单
| 文件 | 作用 |
|---|---|
D:\AI_Tools\chat-bonsai.cmd |
一键启动 Bonsai 2(网页 / 终端 / 视觉) |
D:\AI_Tools\llama-server-bonsai.cmd |
通用服务启动器(PrismML 分支专用) |
D:\AI_Tools\build-bonsai-sycl.cmd |
从源码编译 SYCL 版(含 ptl AOT + XMX 开关) |
D:\AI_Tools\llama.cpp-prism\ |
PrismML 分支源码 + build\bin\(新增,与旧引擎隔离) |
D:\AI_Tools\models\Ternary-Bonsai-2-27B\ |
模型本体 + 视觉塔 |
D:\AI_Tools\test-bonsai-smoke.cmd |
冒烟测试(加载 + 出词 + 读数速度) |
D:\AI_Tools\test-bonsai-backend-ab.cmd |
后端 A/B(GPU vs CPU,复现 5.1 节) |
D:\AI_Tools\test-bonsai-ctx.ps1 |
指定上下文的内存探针 |
D:\AI_Tools\test-bonsai-truncation.ps1 |
截断复现 A/B(7.② 的证据,ASCII 脚本 + 下方 JSON) |
D:\AI_Tools\bonsai-truncation-payload.json |
上面脚本的中文请求体(UTF-8,避免控制台编码问题) |
D:\AI_Tools\test_chat_cli_profile.py |
chat_cli.py 回归测试:证明两个 Qwen 档请求体未变 |
D:\AI_Tools\downloads\bonsai-fallback\ |
官方 win-vulkan / win-cpu 预编译包(备用) |
D:\AI_Tools\bonsai-*.log |
各次实测日志 |
改动的现有文件(仅一处,纯新增) :unsloth\scripts\chat_cli.py 增加 --bonsai 档。 原有默认值(max_tokens=2048、temperature=0.3)与 enable_thinking=false 的行为 完全未变,两个 Qwen 流程不受影响。
未改动 :llama.cpp\(现有主line 引擎)、models\Qwen*、chat-27b.cmd、 chat-q36.cmd、llama-server.cmd、chat.html。
附:数据来源
- 模型体积 / 参数量 / 量化类型 / Hadamard 元数据:本机 GGUF 头部 + HF 仓库 API
- 量化支持矩阵、驱动禁用区间、挂起 bug、上游缺失说明:模型仓库
KNOWN_ISSUES.md与PrismML-Eng/Bonsai-demo的BACKEND-SUPPORT.md - SYCL 支持状态与合并时间:
PrismML-Eng/llama.cppGitHub API(PR #235/#278/#288/#294/#302) - 速度、内存、加载耗时:本机
llama-bench与llama-server日志实测 - 正确性:本机 API 实测(算术 / 代码 / 读图)
除明确标注为官方的数据外,本文数字均为本机实测值。