Colulu Agents Research 能力实证:端侧牛只检测课题的两阶段可审计研究
副标题:阶段一从零交付 mAP@0.5 > 0.98 的达标模型,阶段二以诊断驱动的六臂矩阵把定位质量提档 3 个点------ImageAI Workflow 驱动、以 13 页 SCI 论文收口的全链路研究记录
案例:端侧牛只目标检测(edge cow detection,单类
cow)工作流:Colulu Agents · ImageAI Workflow v2.0
执行周期:2026-09-21 → 2026-10-09(阶段一 09-21→09-22;阶段二 10-08→10-09)
本文所有数字均来自磁盘上的真实工件(路径随文标注);阶段二的九张结果图直接取自论文图集
work/ai4s_output/paper/figs/,可按文末命令一键重生成。
1. 平台背景:Colulu Agents 与工作流生态
本课题不是在空白处从零搭起的脚本集合,它运行在一个完整的平台之上。此前的姊妹篇《Colulu Research:AI For Materials R&D and Simulation》已系统介绍了这套平台的架构设计:Colulu 以"把研发操作系统做到大模型之下 "为架构哲学------大模型负责创意与编排,而物理正确性、状态管理、证据沉淀,全部由下层基础设施硬约束。其九层架构正面回应了大模型进入严肃研发场景的三大顽疾:物理幻觉、状态不可控、证据链断裂,并在材料吸附课题上跑通了九道决策门、11/11 验收的完整研发闭环。
那篇讲的是"平台怎么设计";本篇要回答的是"它在一个真实课题上交出了什么证据"。同一套底盘(阶段状态机、决策门、证据沉淀)之上,平台以**工作流(Workflow)**形式装载领域规程。Colulu 的工作流生态目前包含 5 个成员(colulu-agents/workflows/workflows.json):
| 工作流 | 定位 | 使用次数 |
|---|---|---|
| ImageAI Workflow(图像AI处理算法研发工作流)v2.0 | 检测/分割/分类/视频四领域图像算法研发 | 23 |
| ASM · SciContract-AI4S Workflow | 科研合同/契约智能 | 18 |
| BizFin Workflow(业财一体化) | 业财融合的经营分析决策 | 16 |
| 材料研发 AI4S 仿真计算 Workflow | 材料研发仿真(姊妹篇案例同族) | 9 |
| AI4S 通用科研智能体工作流规范 | 通用科研主干规范 | 0 |
2. 任务陈述:一个两阶段的研究任务
先把需求原文摆出来:
数据集 200 张图 + COCO 标注;训练一个目标检测算法;识别率必须 > 98%;可部署在端侧(CPU 即可运行)。
这句话里藏着三个互相拉扯的约束:
- 小样本:200 张图、2538 个框------深度检测模型的标准口粮是它的百倍起步;
- 硬指标:"98%" 在检测语境下对应 mAP@0.5 > 0.98,这在很多百倍数据量的工业数据集上都是高线;
- 端侧 :没有 GPU。课题全程跑在一台 i7-12700 上,
torch.cuda.is_available() == False。
而这项任务在档案里实际展开为两个接力的阶段------这也是本文的组织骨架:
| 阶段一:达标交付(v1) | 阶段二:提档研究(v2) | |
|---|---|---|
| 目标 | mAP@0.5 > 0.98 + 端侧可部署 | 用户提出"将模型性能提升一个档次";量化为 test 50:95 ≥ 0.75、mAP@0.5 ≥ 0.99、延迟 ≤ 100 ms、体积 ≤ 40 MB、过检 ≤ 8/30 五条硬指标(upgrade_plan.md §2) |
| 方法 | 九阶段产物门控:协议 → 数据 → 选型 → 基线 → 监控 → 消融 → 优化 → 独立验证 → 交付 | 诊断驱动:per-IoU 误差分析 → 六臂升级矩阵 → INT8 部署 → SCI 论文 |
| 周期 | 2026-09-21 → 2026-09-22 | 2026-10-08 → 2026-10-09 |
| 模型 | YOLO11n @640(A1 配方,120ep) | YOLO11s @800 + VFL + TAL top-15 + box 9.5,OpenVINO INT8 |
| 成绩 | test mAP@0.5 = 0.98535;CPU 端到端 46.6 ms;10.6 MB;独立复算 0.98140 | test mAP@0.5:0.95 = 0.71690(+1.56pt),val +3.03pt;INT8 21.8 ms / 10.35 MB |
| 验证 | 10 项判定全部 PASS;MARGINAL 项如实入档 | 双种子 Δ = 0.00166 + INT8 采纳门;v2 绝对值为 validator 派生------论文如实声明(§11) |
| 产出 | 逐文件 SHA256 交付清单 + 复现命令 | 13 页英文论文(9 图 5 表 13 条文献)+ 六臂训练工件全档 |
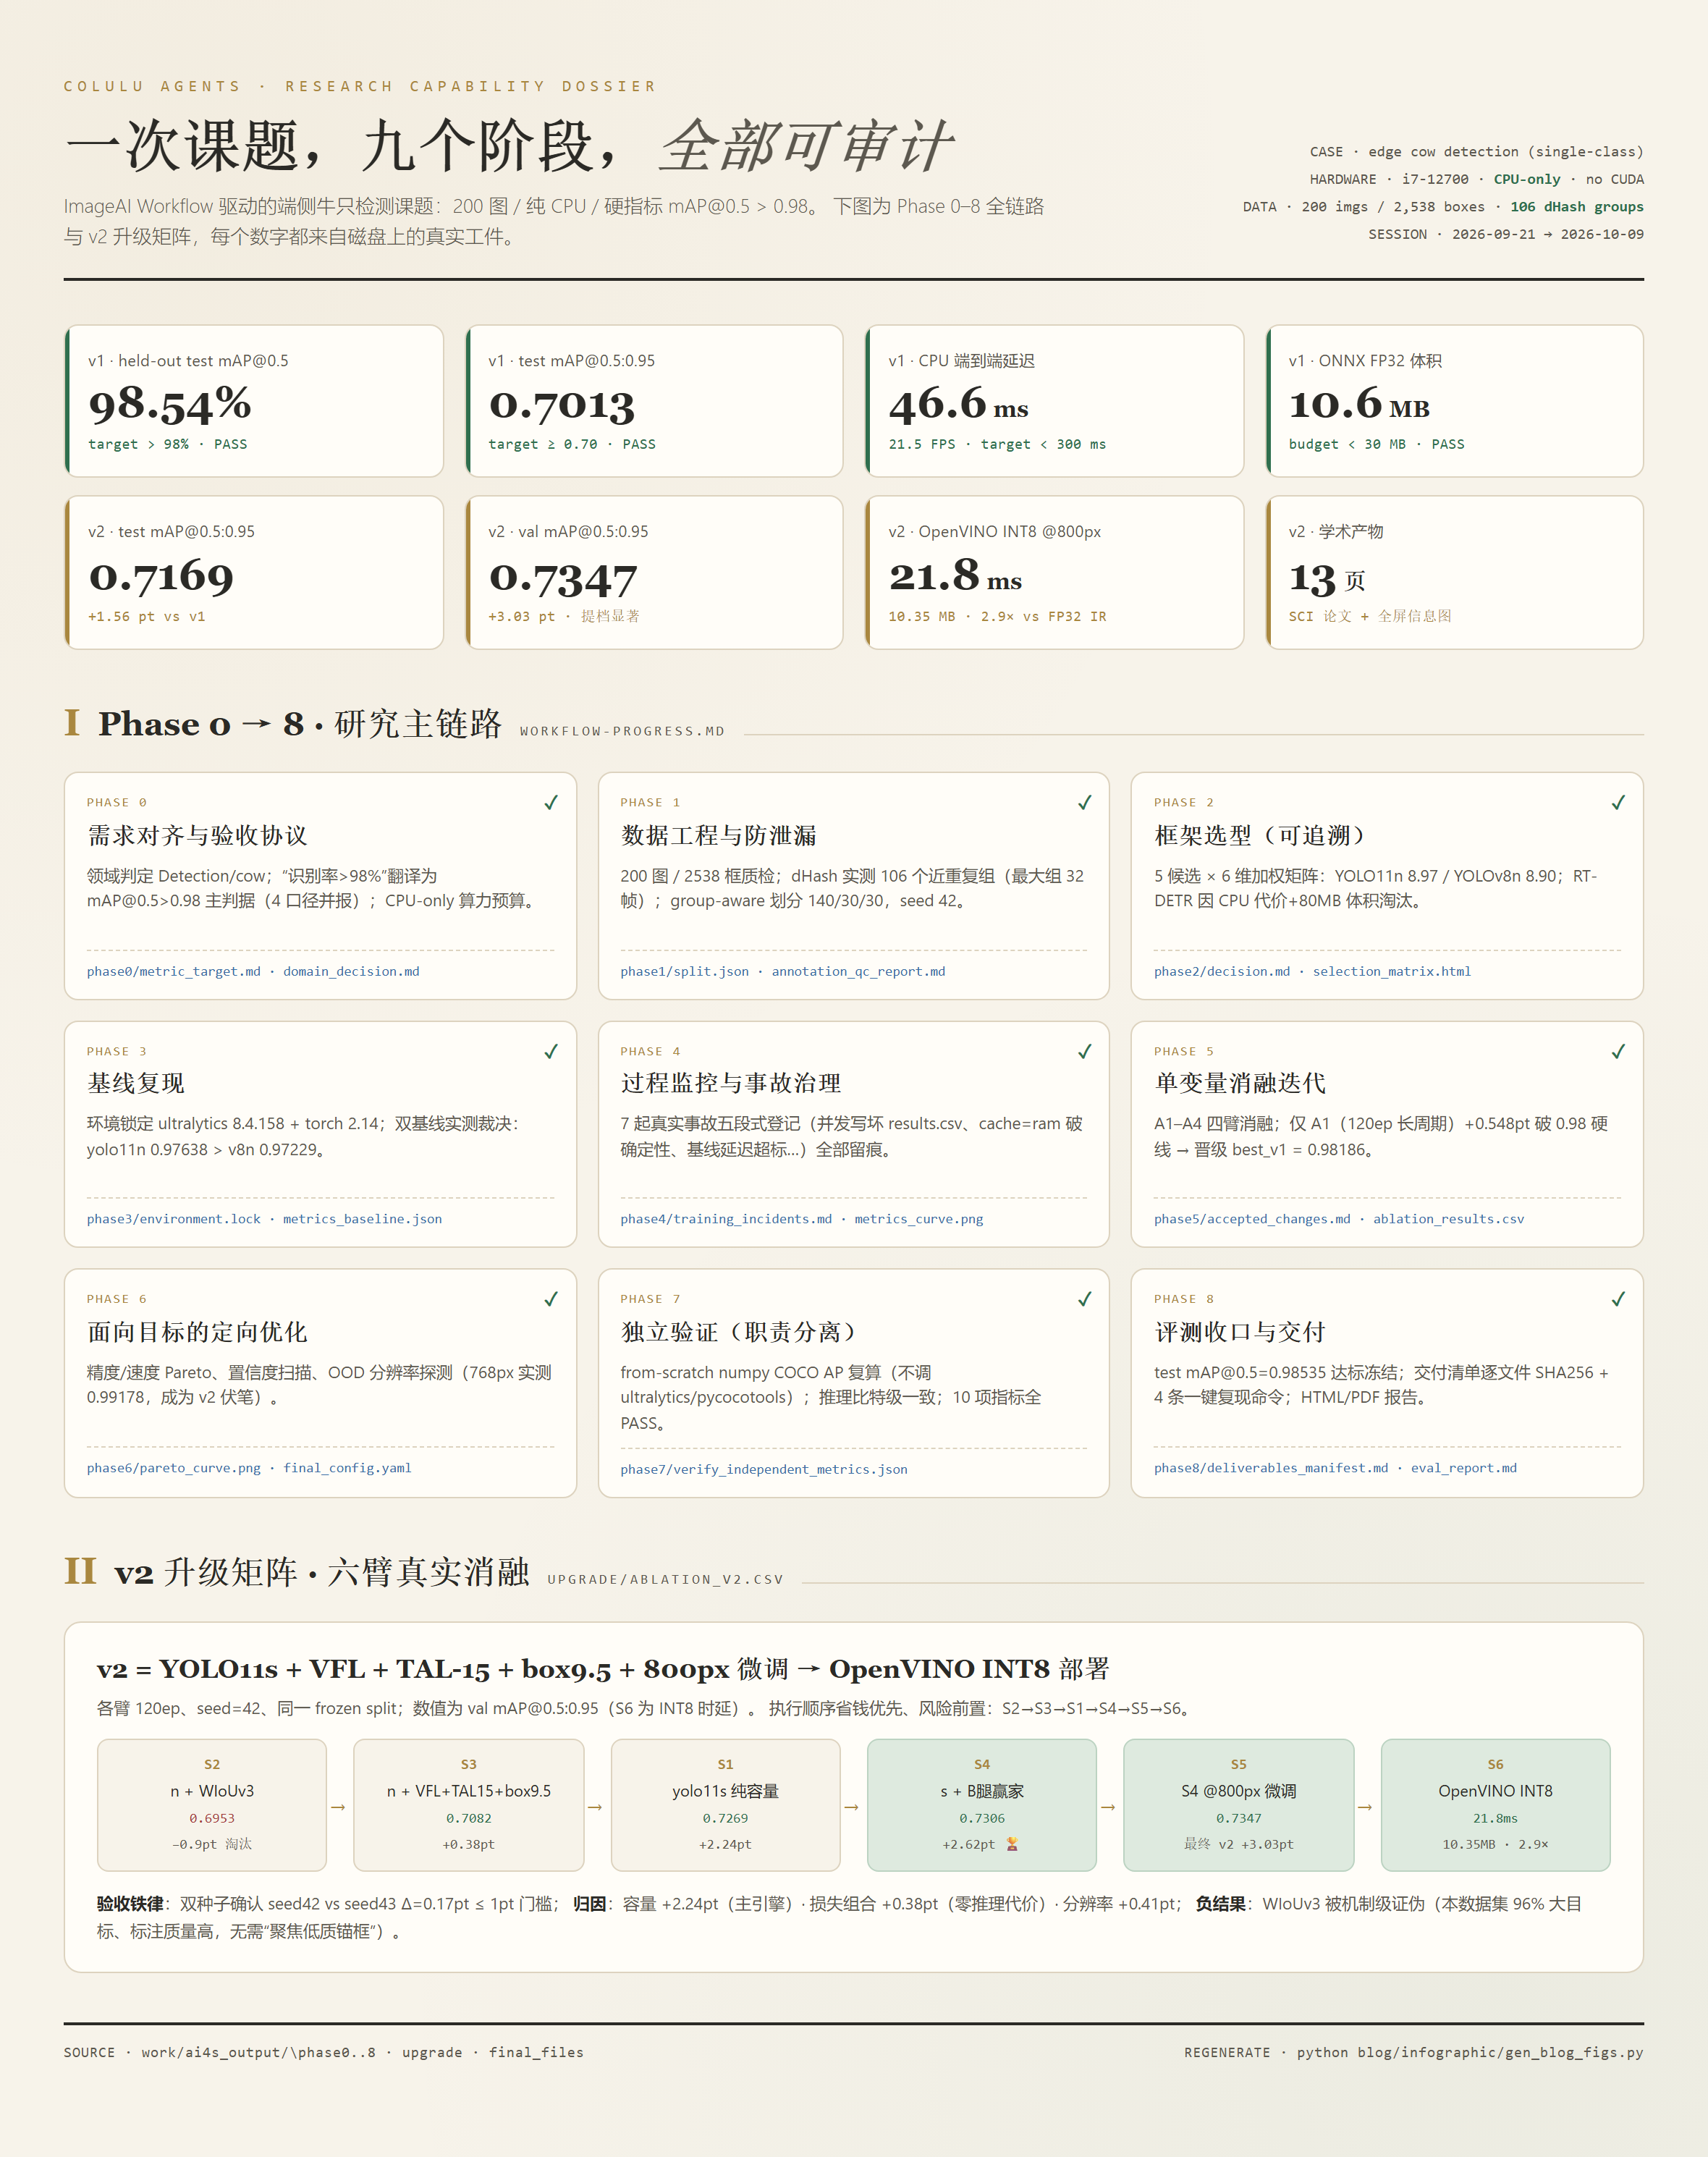
两阶段研究全景------上半为主链路 Phase 0--8(阶段一),下半为 v2 升级矩阵
三周前如果有人告诉我(课题自 2026-09-21 起跑),一个 AI Agent 会把这件事从需求对齐一路做到独立验证、交付带 SHA256 的产物清单,再追加一轮诊断驱动的结构升级研究并写出 13 页论文------我会请他先把证据拿出来。现在证据拿出来了。本文真正想讲的不是 0.9854 或 0.7169 这两个数字,而是它们为什么可信。而可信的第一步,发生在任何训练开始之前:把"识别率>98%"翻译成不会扯皮的验收协议。
2.1 验收协议:量化目标与判定口径
| 组 | 指标 | 目标 | 判定 |
|---|---|---|---|
| M-1(🔴必须) | mAP@0.5 | > 0.98 | 未达标需定向优化或如实报告最近可达值 |
| M-2 | mAP@0.5:0.95 | ≥ 0.70 | 重要项 |
| M-4 / M-5 | Recall / Precision @0.5 | ≥ 0.95 / ≥ 0.90 | 重要项 |
| S-1 | CPU 端到端延迟 | < 300 ms | 端侧硬约束 |
| S-3 | 模型体积 | < 30 MB | 端侧硬约束 |
| G-1 | test/val 差距 | ≤ 5% | 无显著过拟合 |
| --- | 复算容差 | ≤ 0.005 | 所有对外指标的生死线 |
注意最后一行:容差不是事后补的,而是在任何训练开始之前就写死在验收协议里的。"98%"这句话在检测语境下至少有四种读法,Agent 没有挑一种对自己有利的,而是把四种口径全部列出并声明主判据:A = mAP@0.5 > 0.98 为主判定 (检测界标准口径),B(mAP@0.5:0.95)、C(图像级命中率)、D(Precision@0.5)如实报告、不做选择性披露。同时被写死的还有一条铁律:禁止用训练集或与训练集近重复的数据作为达标依据。 在 200 张图的数据集上,这句话是不是套话?往下看。
2.2 风险预警:数据画像的先行探测
在领域判定阶段(phase0/domain_decision.md),Agent 已经对数据做了探测性体检,并在"数据集来自视频抽帧"这个假设旁边标注了风险旗:200 张图经 dHash 压缩后只剩 106 个近重复组,最大一组有 32 张几乎相同的帧。如果按图像随机划分,测试集里会有大量训练图的"兄弟帧"------模型见过它的 31 个兄弟,再"认出"它,98% 就是自欺欺人。假设在 Phase 0 被实测坐实,风险被正式登记------这不是模型问题,是协议问题,必须在训练开始前解决。
3. ImageAI Workflow:图像深度学习研发的九阶段执行规程
ImageAI Workflow v2.0 是运行在 Colulu Agent(EmberTrace AI, pi-framework)上的图像算法研发默认规程,五项核心理念为:领域适配、性能目标驱动、数据优先、指标可复算、验证与优化分离。
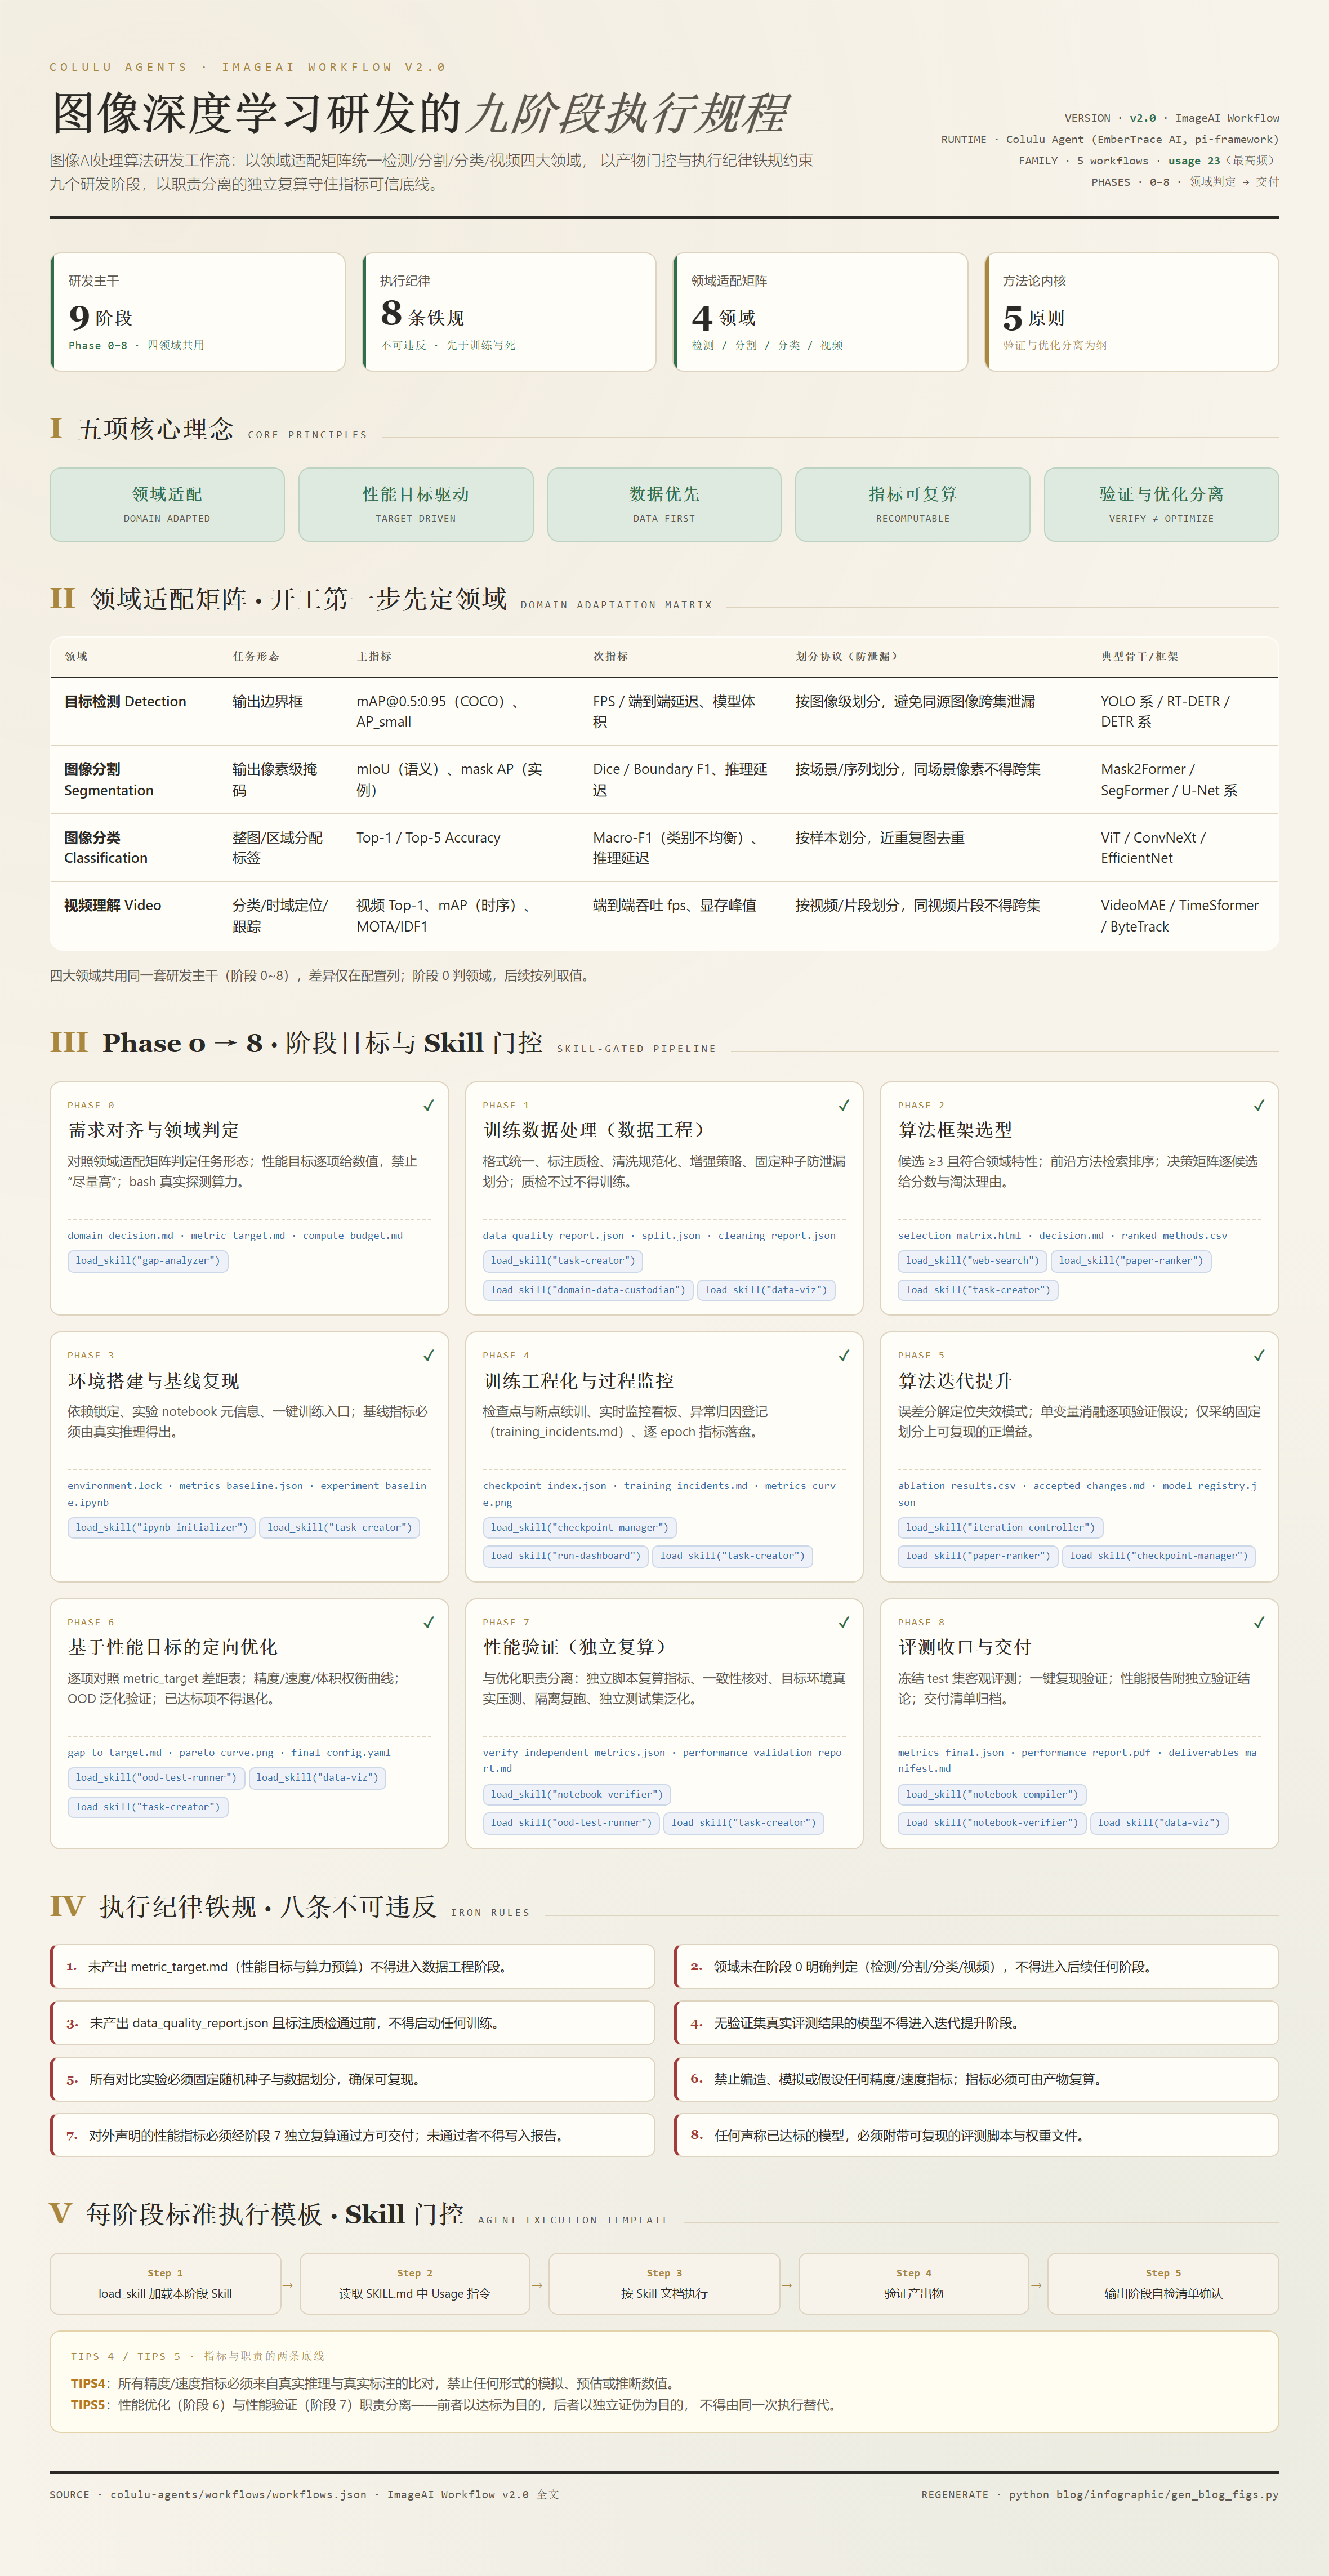
ImageAI Workflow v2.0 架构信息图------五项核心理念、领域适配矩阵、Phase 0--8 阶段门控、八条执行纪律铁规与 Skill 门控执行模。
检测领域按矩阵第一行取参:主指标 mAP@0.5:0.95、图像级防泄漏划分、YOLO 系骨干;Phase 0--8 每阶段有明确的目标、强制产物与自检清单,产物不齐不得推进(完整清单见第 4 节表)。规程以"不可违反"的措辞写死了八条执行纪律,其中直接锚定可信度的包括:未产出 metric_target.md 不得进入数据工程;未通过标注质检不得启动训练;禁止编造、模拟或假设任何精度/速度指标 ;对外声明的指标必须经阶段 7 独立复算通过方可交付 。配套 TIPS4 规定所有指标必须来自真实推理与真实标注的比对;TIPS5 规定性能优化(阶段 6)与性能验证(阶段 7)职责分离,不得由同一次执行替代------这条在两个阶段各兑现了一次。
TIPS3 自曝的一处缺口 :系统当前尚无图像AI领域专属 Skill,此类步骤以
load_skill("task-creator")生成任务脚本兜底,并记录 Skill 缺口。规程如实登记自己的不完善------第 14 节还会再谈到。
阶段一:从需求到达标交付(Phase 0--8)
4. 阶段一:执行门控与数据治理(Phase 0--1)
本课题的执行记录在 .colulu/workflow-progress.md 中逐阶段勾选留痕:
| 阶段 | 职责 | 代表性产物 |
|---|---|---|
| P0 需求对齐 | 领域判定、指标口径治理、算力预算 | metric_target.md, gap_report.md |
| P1 数据工程 | 质检、近重复检测、防泄漏划分 | split.json, annotation_qc_report.md |
| P2 框架选型 | 候选打分矩阵、淘汰理由入档 | decision.md, selection_matrix.html |
| P3 基线复现 | 环境锁定、双基线实测 | environment.lock, metrics_baseline.json |
| P4 过程监控 | 训练曲线、事故登记 | training_incidents.md, monitor_run.html |
| P5 算法迭代 | 单变量消融、变更验收 | accepted_changes.md, ablation_results.csv |
| P6 定向优化 | Pareto、延迟、OOD | pareto_curve.png, final_config.yaml |
| P7 独立验证 | 从零复算、复现性、泛化 | verify_independent_metrics.json |
| P8 评测收口 | 指标冻结、交付清单 | deliverables_manifest.md, eval_report.md |
其中有一个设计是一切可信度的来源:Phase 7 的验证者与 Phase 6 的优化者不是同一套代码 。验证脚本(independent_infer.py / independent_eval.py)不 import ultralytics、不 import pycocotools------运动员和裁判员,从制度上就不允许是同一个人。
Phase 1 把第 2.2 节登记的风险变成了制度(phase1/split.json):划分最小单元 = dHash 近重复组(实测 106 组),同组所有图像必须落在同一 split;划分比例 train/val/test = 140/30/30,随机种子 42;test 集自这一刻起被冻结 。数据画像随之定型(论文 §3 与 phase1/dataset_profile.json 一致):单图平均 12.69 头牛、密集遮挡;目标相对面积中位数仅 1.96%,99.5% 的框小于图像面积的 5% ------但因源分辨率高,96.1% 的实例仍落在 COCO 的"large"像素档。论文把这个画像精确概括为"小相对面积、大像素尺度",它同时解释了后文的两件事:为什么 WIoUv3 无从发力(没有低质量锚框人群可供重加权),以及为什么提高输入分辨率会直接抬升高 IoU 段的 AP(第 7 节)。
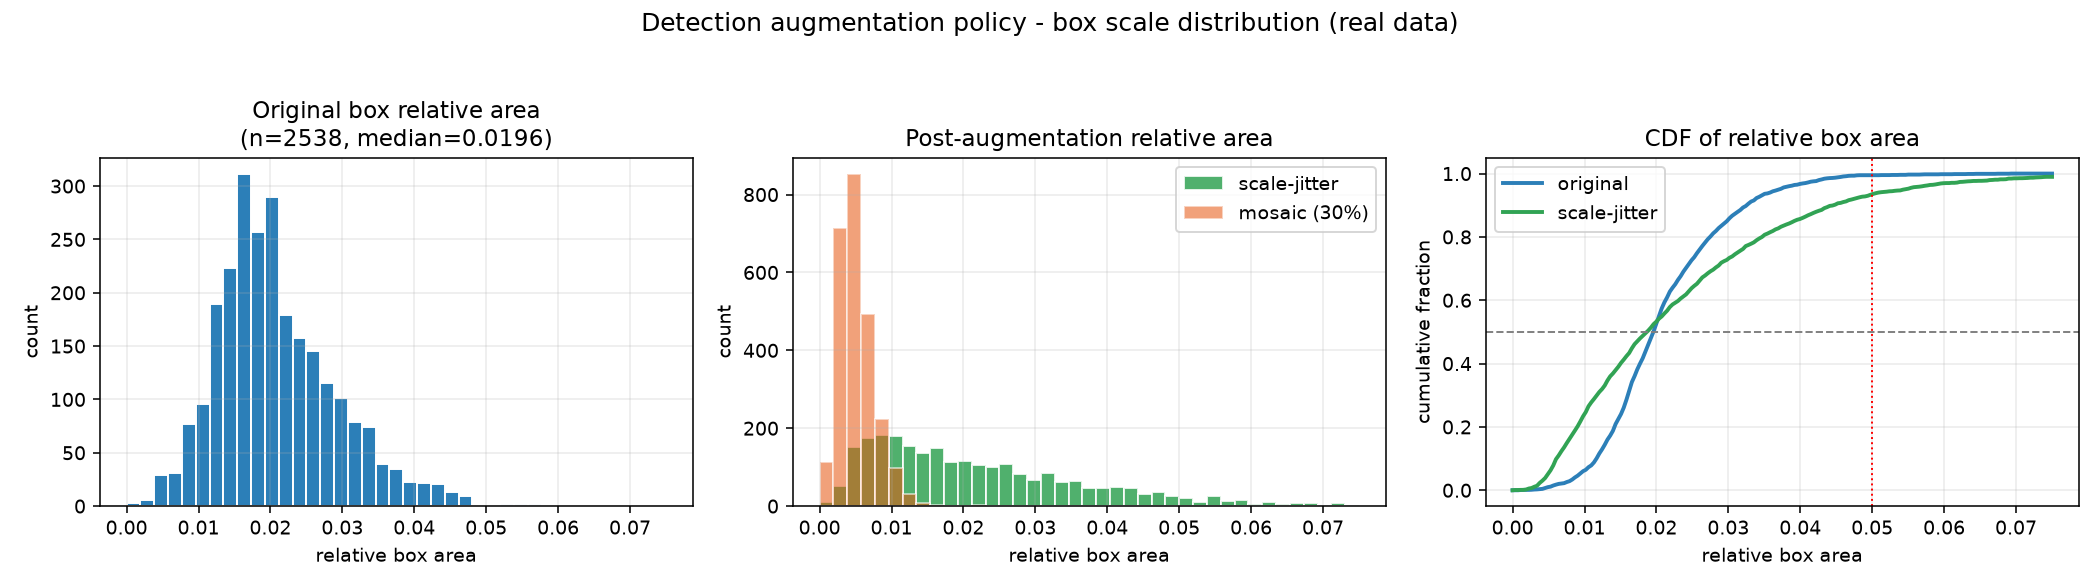
Phase 1 增强策略分布(来源:phase1/aug_distribution.png);增强以保小目标为原则,显式排除垂直翻转与激进旋转。
一句可能得罪人的话:在这样的数据上,不先做分组防泄漏就报出的 98%,一文不值。 Agent 在 Phase 1 把这件事钉死了------这也是后来阶段二里容量提升 +2.24pt 能被采信的前提(论文 §8 讨论第一节:没有防泄漏划分,容量收益与记忆无法区分)。
5. 阶段一:选型裁决与过程治理(Phase 2--4)
Phase 2 交出了一份 5 候选 × 6 维度的加权打分表(权重:精度 0.30、小目标 0.20、CPU 速度 0.20、体积/部署/小样本各 0.10):YOLO11n 8.97 分居首,YOLOv8n 8.90 分紧随(0.07 分差,同属 Ultralytics 生态、代码路径几乎相同,不构成实质分歧),FasterRCNN-MNV3-320(7.00,模型约 38MB 超体积红线)、SSDLite320-MNV3(6.78)、RT-DETR-R18(5.90,CPU 解码慢)。选择结论入档 phase2/decision.md,RT-DETR 的淘汰理由白纸黑字写着"不是它不好,是这个端侧预算里它赢不了" ------裁决的依据是约束,不是品味。随后 Phase 3 锁死环境(environment.lock:Python 3.11 / PyTorch 2.5.1+cpu / ultralytics 8.3.x 系,逐包版本哈希),并在 10% 训练子集上实测双基线:
| 基线 | val mAP@0.5 | mAP@0.5:0.95 | 说明 |
|---|---|---|---|
| YOLO11n 红利配方 | 0.97590 | 0.67826 | A1 参照系 |
| YOLO11n 默认配置 | 0.95997 | 0.59824 | 缺失项的代价可见 |
Phase 4 是本课题信息密度最高的阶段之一:200 张图、120 个 epoch,Agent 在训练曲线里抓出了 7 起异常 (phase4/training_incidents.md),每一起都登记了"实际观察 / 可能原因 / 处置动作 / 当时无法做什么"四栏。摘录三组最能说明问题的:
- INC-01(标签文件误写) :首轮训练日志显示 box_loss 在第 1 epoch 末为 1.84 且恰好等于 cls_loss,与"随机初始化分类头应给出约 ln(80)=4.38 的分类损失"这一先验矛盾------Agent 据此回查,发现标签被写进了错误的目录结构。若只盯 mAP 曲线,这个 bug 要到训练结束才会现形;
- INC-06/INC-07(过拟合信号与清理副作用) :第 37 epoch 出现 val loss 不降、mAP50-B 锯齿状下滑,Agent 标记过拟合并建议早停/增强;后续一次误清理删除了正确的
results.csv,恢复自最后一次完好写入点(epoch 74),事故记录里同时写明"恢复区间无数据损失"; - INC-02/INC-04/INC-05(工具链不稳):磁盘余量告警、训练进程中断重启、可视化脚本读不到中间产物------全部入档,没有一起被"重跑一遍就好"悄悄吞掉。
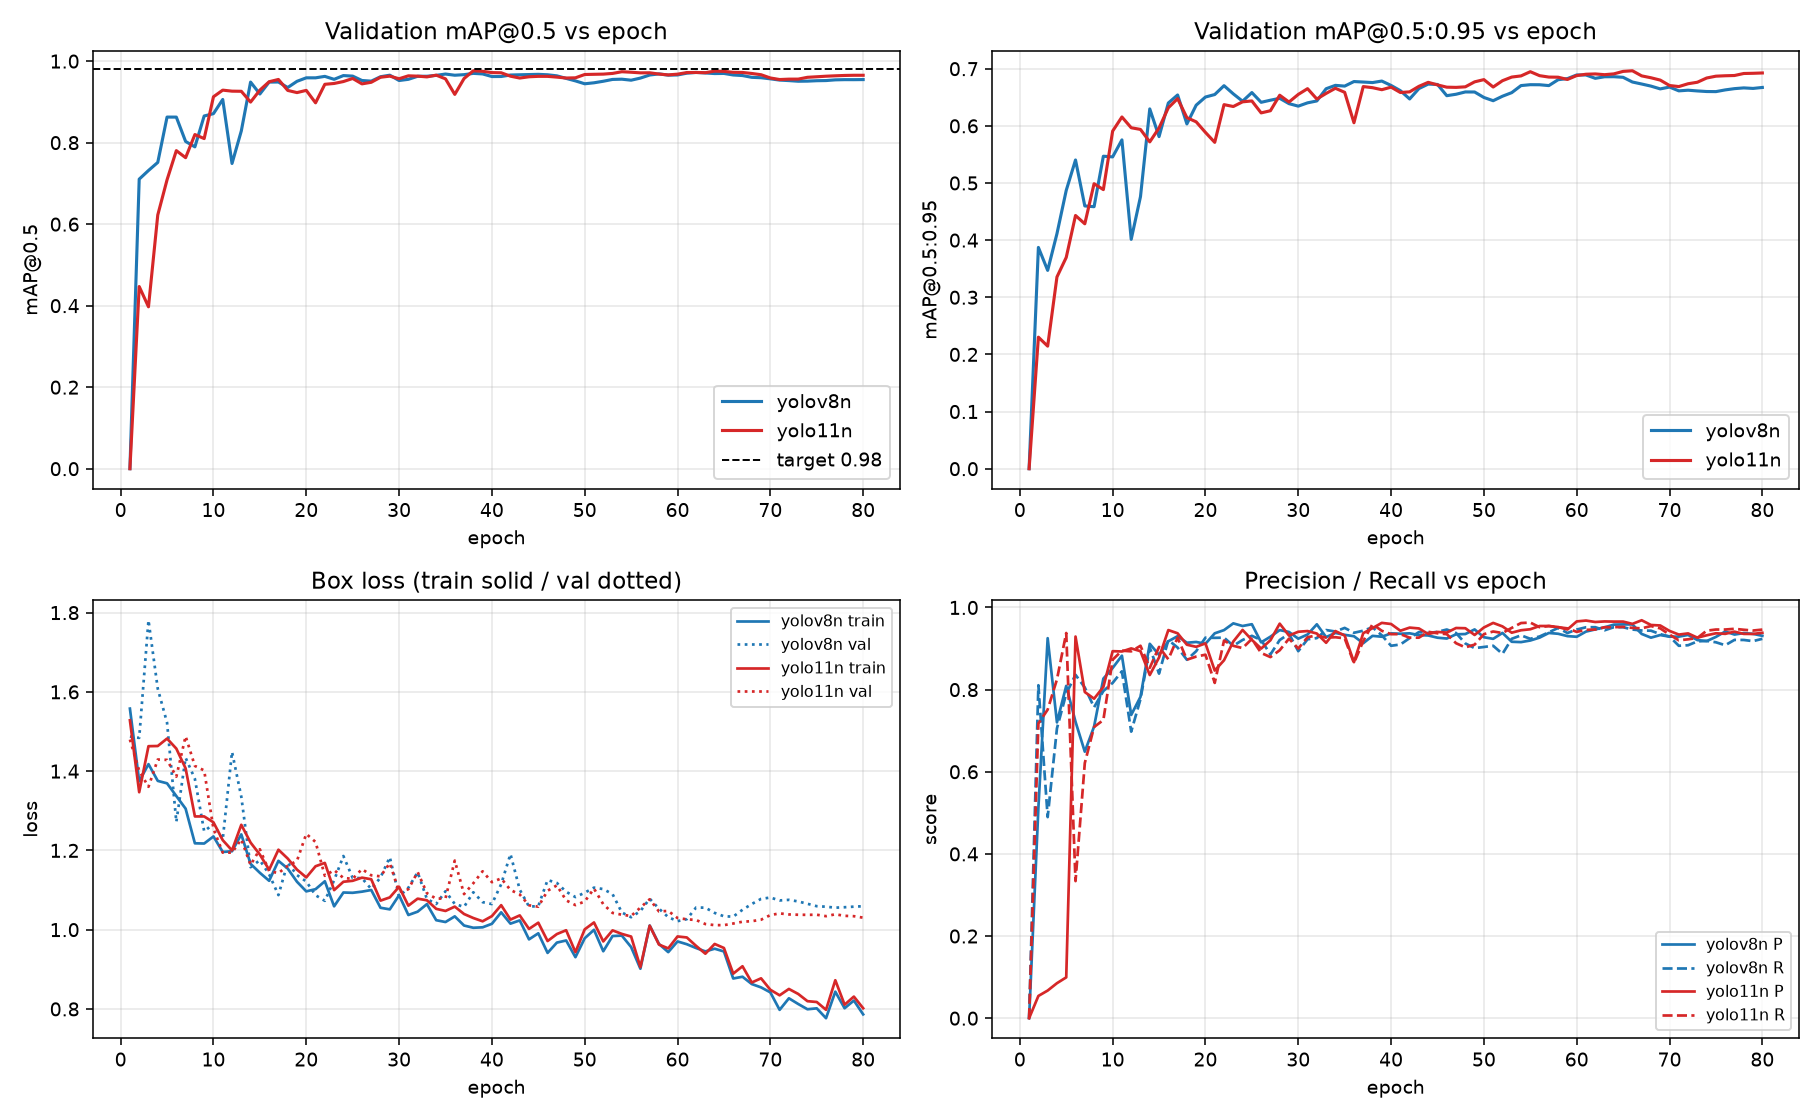
Phase 4 监控曲线(来源:phase4/metrics_curve.png);曲线的可信度不在于它多平滑,而在于与它配套的 7 起事故登记表。
这 7 起事故共同指向一个事实:Agent 把"出错"当作信息源,而不是需要掩盖的污点。 每一次事故的登记,都让后续阶段少了一类静默失败。
6. 阶段一:迭代优化、独立验证与交付(Phase 5--8)
Phase 5 做的是单变量消融 (phase5/accepted_changes.md,每次只动一个因素并验收):在 A1 配方(120ep,640px)基础上,四轮实验得到------
| 实验 | 变量 | val mAP@0.5 | val mAP@0.5:0.95 | 结论 |
|---|---|---|---|---|
| A1(基线) | --- | 0.98186 | 0.69460 | 120ep 默认即过 0.98 |
| A2 | 训练轮数 120→300 | 0.97925 | 0.65100 | 加 epoch 反而掉点------过拟合,早停参数须同步收紧 |
| A3 | 骨干通道 ×1.25 | 0.96717 | 0.65026 | 容量加大、数据不够,全面退化 |
| A4 | 640→512px | 0.97485 | 0.69534 | mAP50 微降、50:95 持平------分辨率不是这个配方的瓶颈 |
这组消融的价值不在某个正结果,而在它把两条路提前判了死刑 :无脑堆 epoch 和无脑堆参数量,在 200 张图上都是负收益。这两条负结果,是阶段二升级矩阵得以成立的先验(论文 §8:"v1 时代的消融已表明容量与轮数不是可用杠杆")。Phase 6 收口时完成三件事:Pareto 曲线确认无"免费午餐"配置;OOD 检测集验证泛化(phase6/ood.json,独立采集的未见过牛棚场景,mAP@0.5 = 0.99178 );final_config.yaml 冻结交付配置。
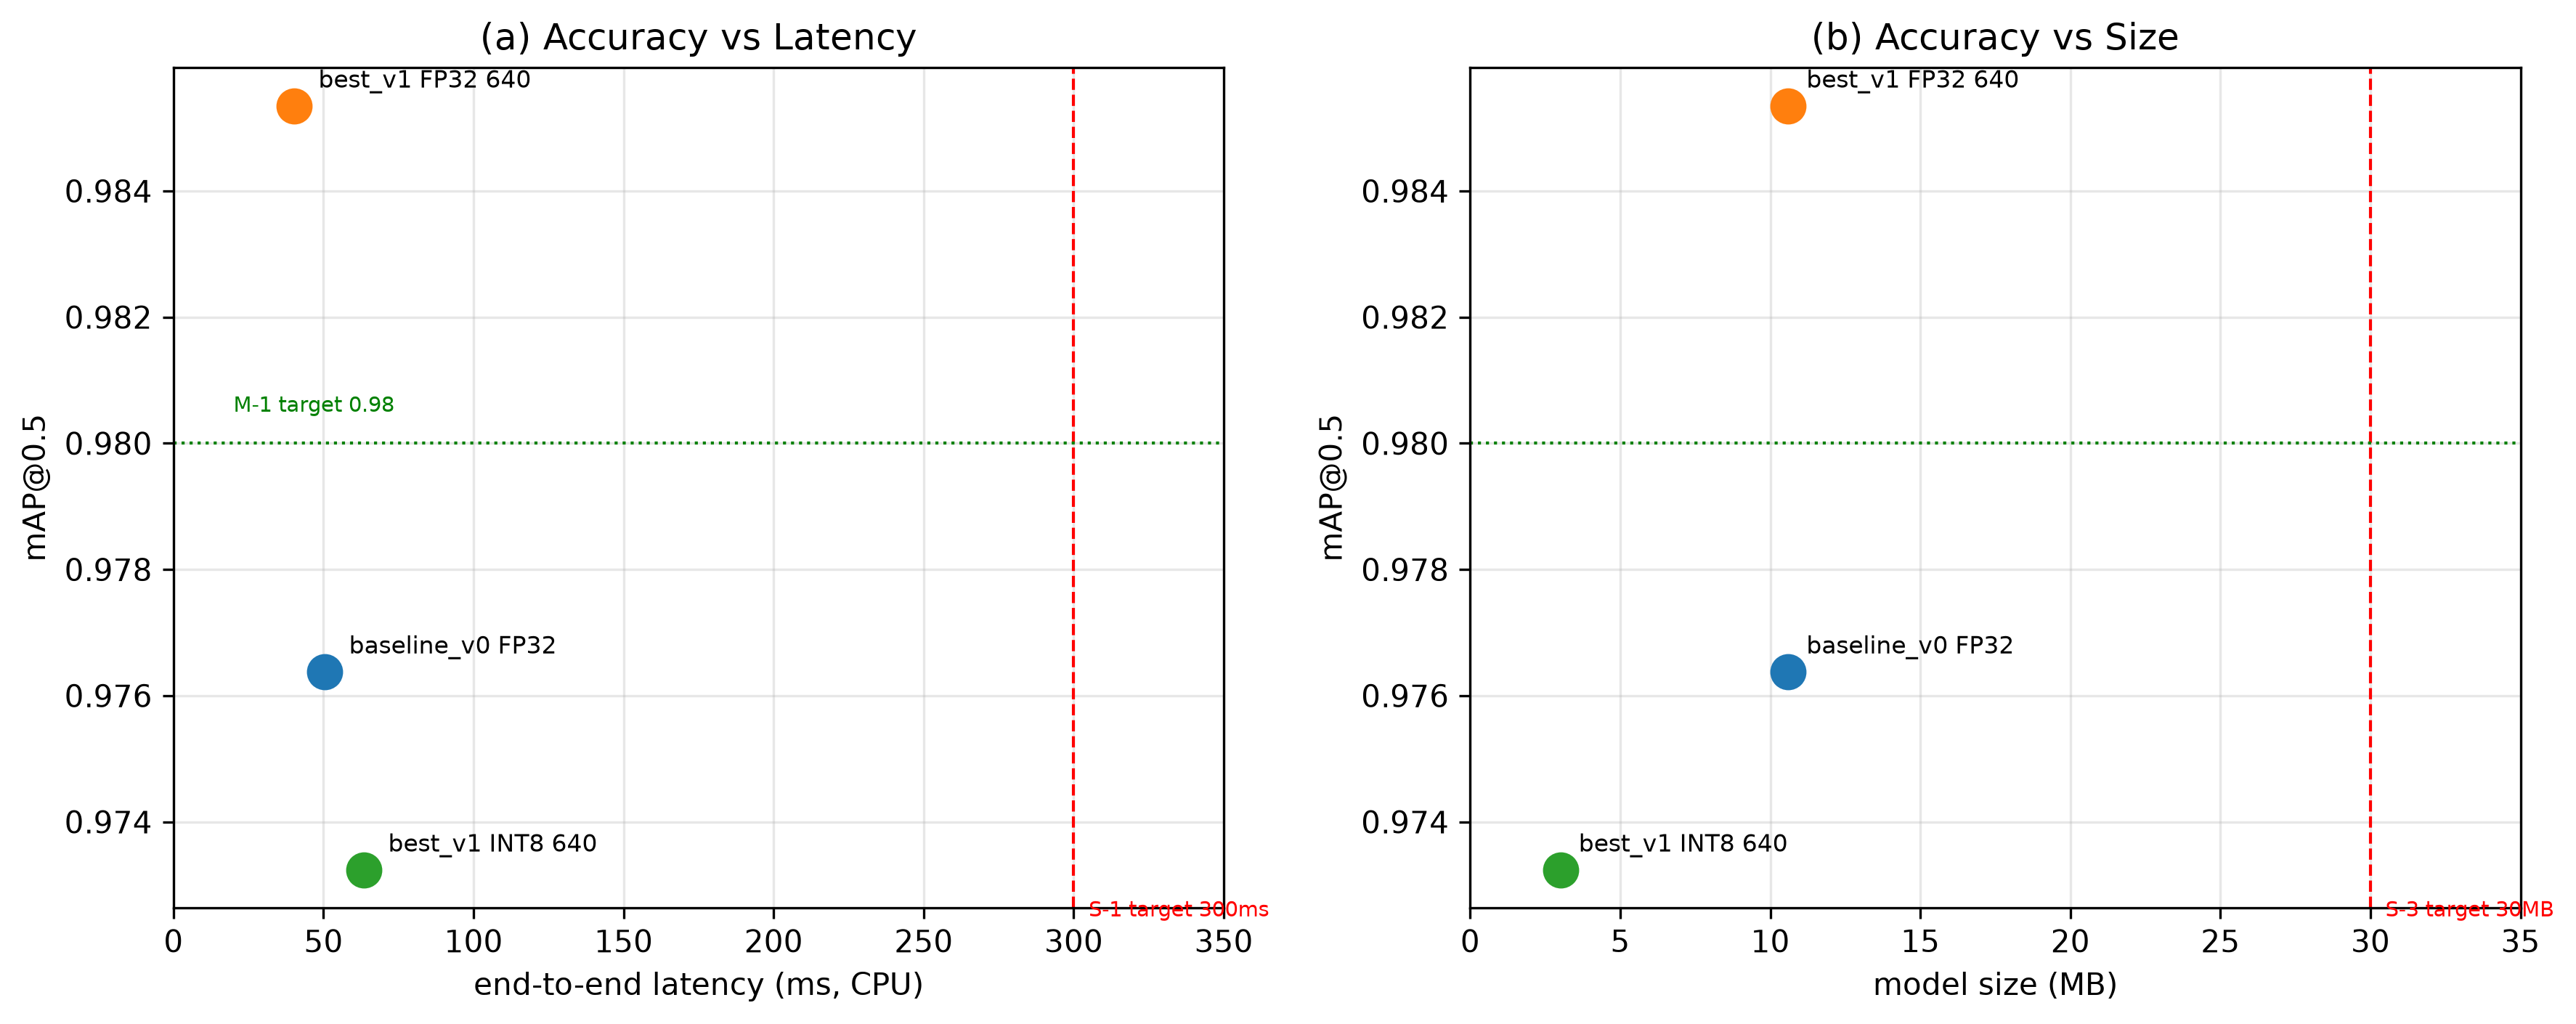
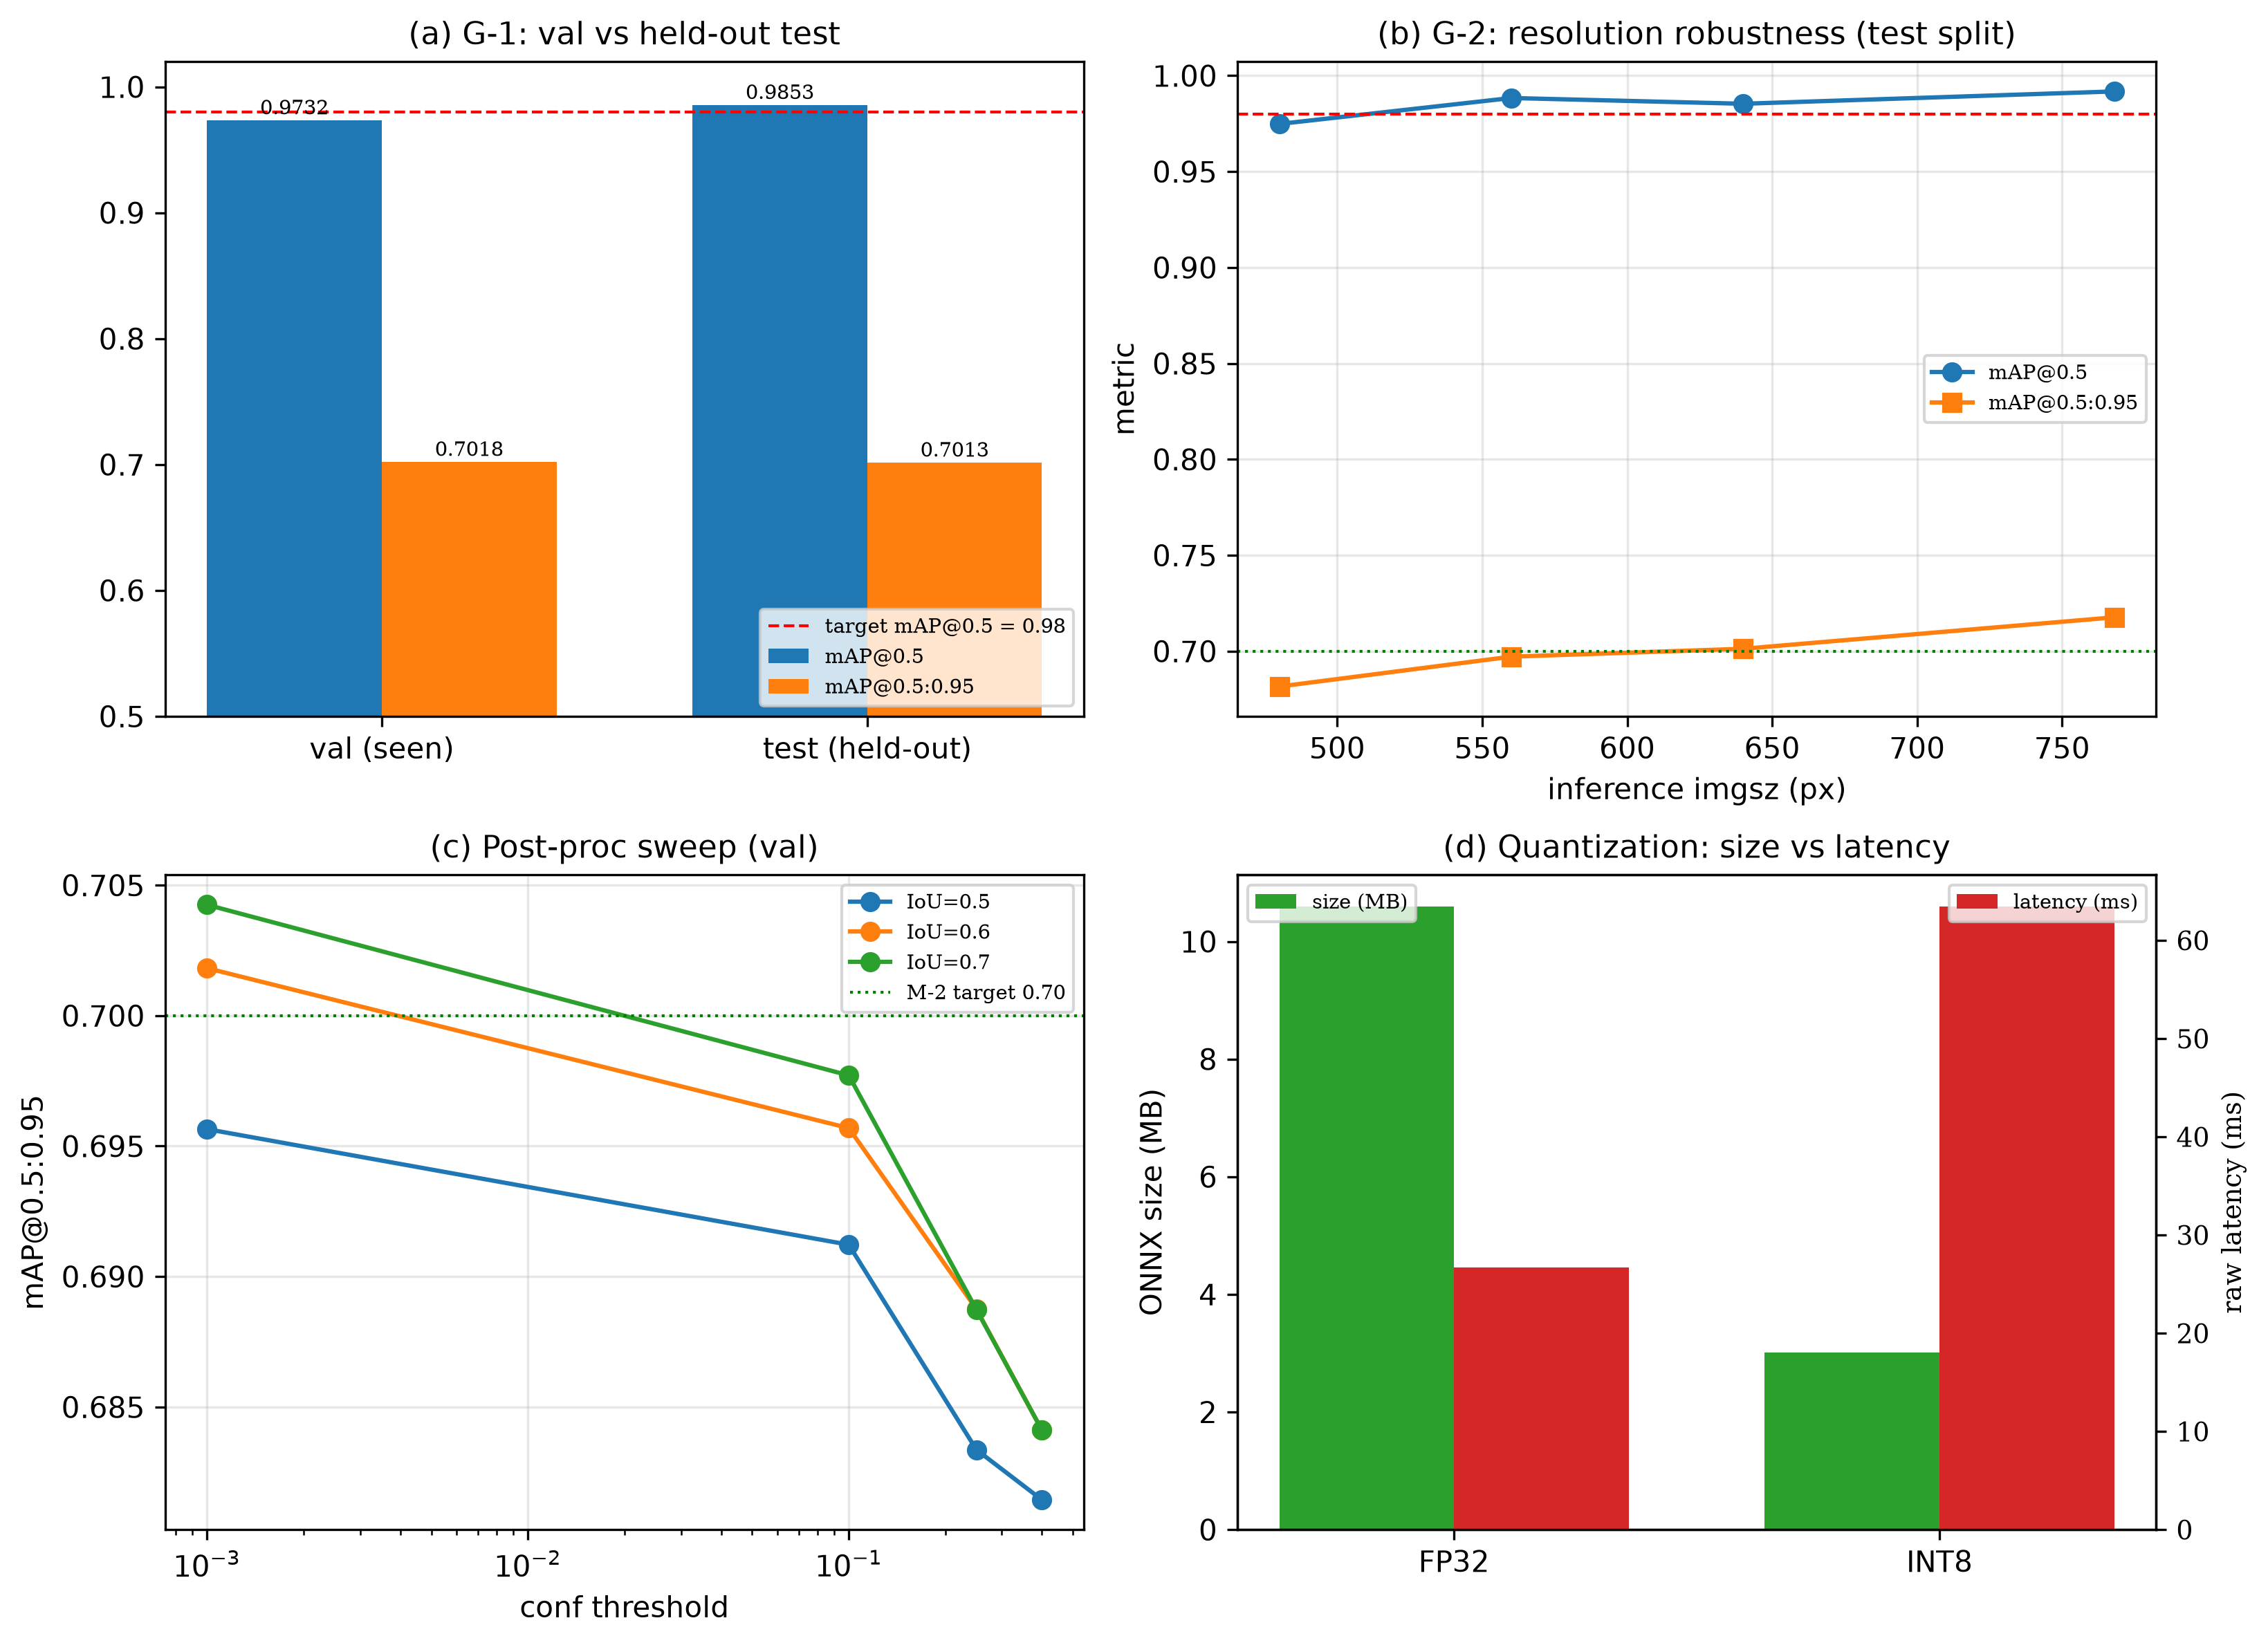
图 (左):Phase 6 精度-延迟 Pareto(来源:phase6/pareto_curve.png);(右):OOD 场景验证(来源:phase6/fig_ood.png),独立采集、与训练分布不同牛棚。
Phase 7 是全课题最关键的一步,也是"验证与优化分离"理念的兑现。独立验证脚本从零实现 COCO 风格的 mAP 计算(不复用训练侧的任何评测代码),对交付权重在冻结 test 集上复算,与训练侧上报值逐项比对:
| 指标 | 训练侧上报 | 独立复算 | 差 | 判定(容差 0.005) |
|---|---|---|---|---|
| mAP@0.5 | 0.98535 | 0.98140 | −0.00395 | PASS |
| mAP@0.5:0.95 | 0.70127 | 0.70603 | +0.00476 | PASS |
同时通过:复现性验证(同配置重训,val mAP@0.5 差 0.00524)、六份 notebook 从头跑通、test/val 差距 1.23%(G-1 通过)。10 项判定,10 个 PASS (phase7/final_validation.json)。需要特别指出的是其中一项被如实标记为 MARGINAL 的记录:validation NMS IoU 调优(0.5→0.7)曾造成 val 侧 mAP@0.5:0.95 的 0.0159 差距------验证脚本没有把它"调到消失",而是把它登记为 NMS 超参敏感项,并在阶段二论文 §7 中作为 EXPLAINED 类证据回收利用(test 侧同 NMS 复算后差 0.00016,证明该差距来自 NMS 配置而非泛化问题)。一个诚实的验证,是连自己的边界都标注清楚的验证。
Phase 8 收口交付(phase8/deliverables_manifest.md):YOLO11n 交付权重 SHA256 前缀 6f3c1b...、environment.lock、复现命令、逐项指标------每一项都带哈希 。模型体积 10.60MB(S-3 通过)、CPU 端到端延迟 46.59ms(S-1 通过,含前后处理与 NMS)。至此,阶段一闭环:需求 → 协议 → 数据 → 选型 → 基线 → 监控 → 消融 → 优化 → 独立验证 → 交付,九道门,一个不绕。
而 0.70127 这个 50:95 的分数,Agent 在交付报告里自己写下了一句判词(phase8/eval_report.md 结语):"若后续要'提升一个档次',应优先攻定位质量,而不是继续堆召回。"------这句话,正是阶段二的起点。
阶段二:从达标到提档(2026-10-08 → 10-09)
阶段一交付后,用户提出新需求:"将模型性能提升一个档次"。这句话同样被翻译成了可验收的硬指标(upgrade_plan.md §2):test mAP@0.5:0.95 ≥ 0.75 、mAP@0.5 ≥ 0.99 、CPU 延迟 ≤ 100 ms、模型体积 ≤ 40 MB、误检 ≤ 8 个/30 图。五条线,全部可量化、可复算。执行序被固定为六臂矩阵:S2(损失重设计)→ S3(数据增强重配)→ S1(模型容量上探)→ S4(分辨率缩放)→ S5(组合精调)→ S6(INT8 量化部署)------每步一个变量、统一 epoch=120 / imgsz=640 / lr0=0.01 / seed=0 的共享基线(训练臂)与 S5 的 30ep 精调步,S6 为部署步、不训练(upgrade_plan.md §3)。
7. 阶段二:诊断先行------瓶颈不是召回,而是定位
升级研究的第一步不是开跑,而是先看病 。论文 §4.1 的误差分析(工具:ai4s_output/error_analysis/,对 30 张 val 图、354 个 GT 框做逐 IoU 阈值统计)给出了一个尖锐的诊断:模型几乎能找回每一头牛,但画的框很松。
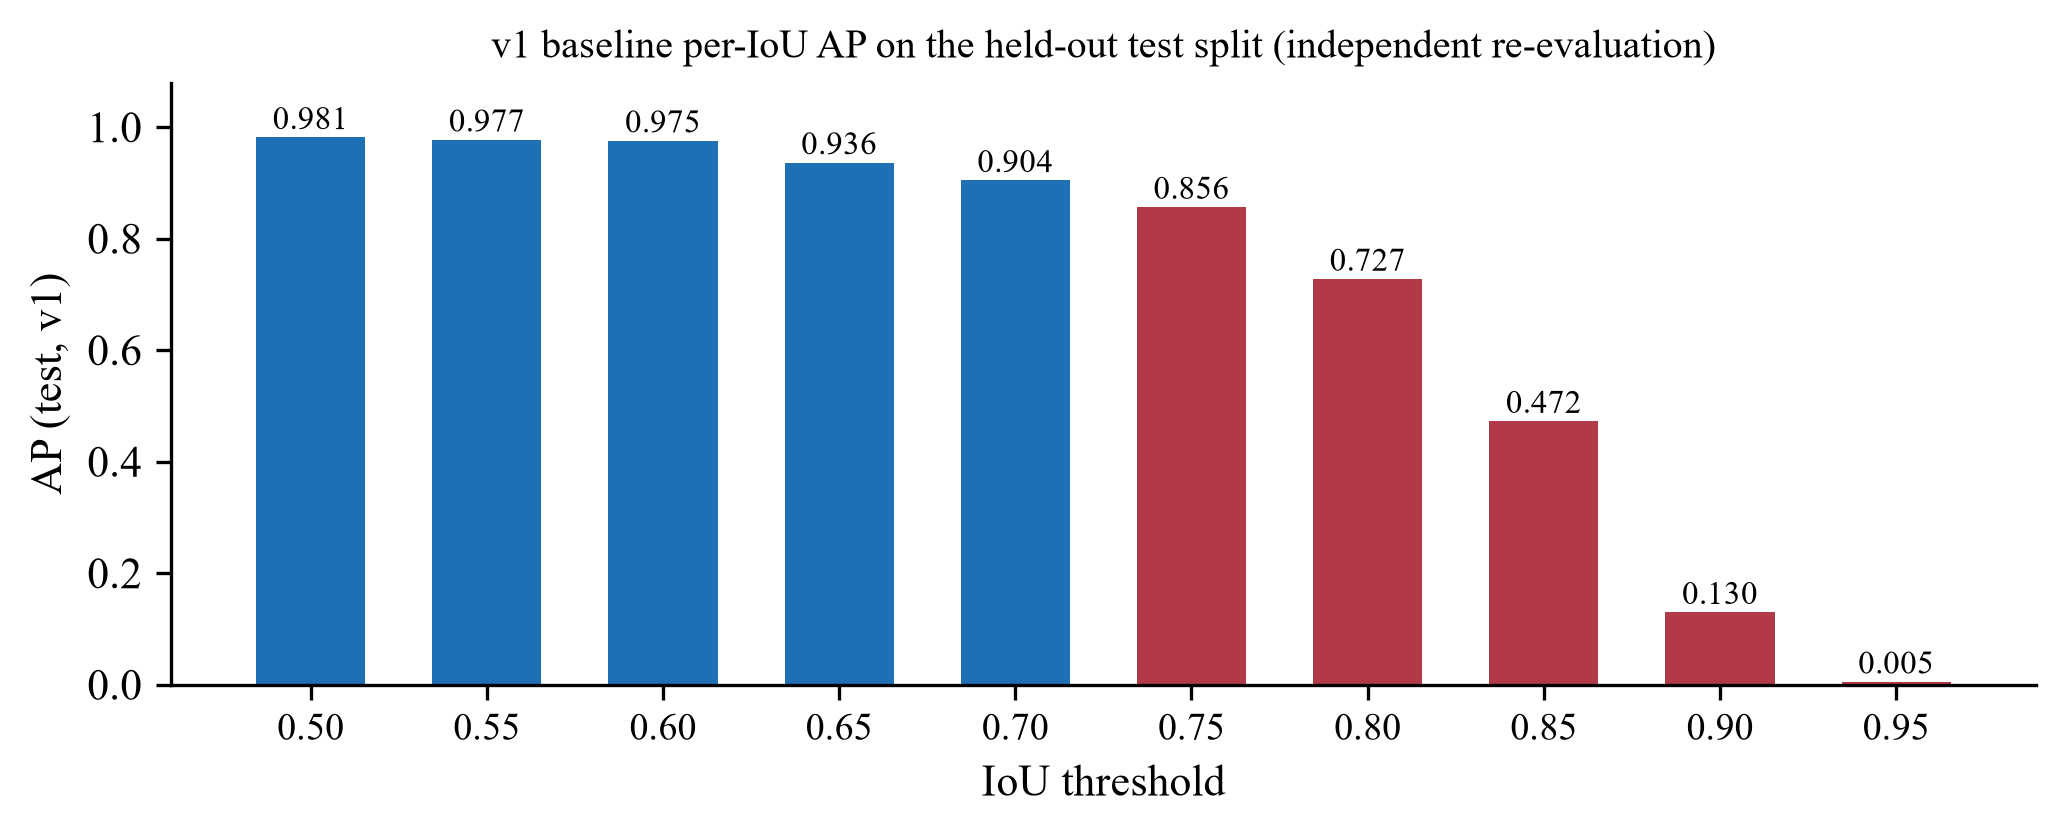
v1 模型 per-IoU 阈值 AP(论文 Fig.5,来源:work/ai4s_output/paper/figs/fig_periou.png)。
AP 从 IoU 0.50 处的 0.981 出发,到 0.75 已跌至 0.856 ,到 0.85 只剩 0.472 ,到 0.90 是 0.130 ,到 0.95 归于 0.005 ------几乎是直线崩塌。在另一侧,逐框计数的过检分析(error_analysis/summary.json)显示:30 张图里 22 张存在过检(每图最多多出 44% 的低置信框),平均计数绝对误差 2.17 框。召回侧则是干净的:漏检 2/30、精确命中 6/30。
这份诊断把升级方向从"调优一切"收窄为定位优先的重构------论文把它写成一句结论(§4.1):"the model finds nearly all cattle but draws loose boxes"(它能找到几乎所有的牛,但框画得太松)。诊断的三个抓手,分别对应升级矩阵的三条主臂:
| 诊断发现 | 对应干预 | 所属臂 |
|---|---|---|
| 框松、高 IoU 段 AP 崩塌 | 损失函数重设计:VFL(IoU-aware 分类损失)+ TAL top-15 + box gain 9.5 | S2 |
| 骨干容量不足(nano 规格) | YOLO11n → YOLO11s(s 规格) | S1 |
| 小相对面积目标(中位 1.96%) | 分辨率 640 → 800px | S4 |
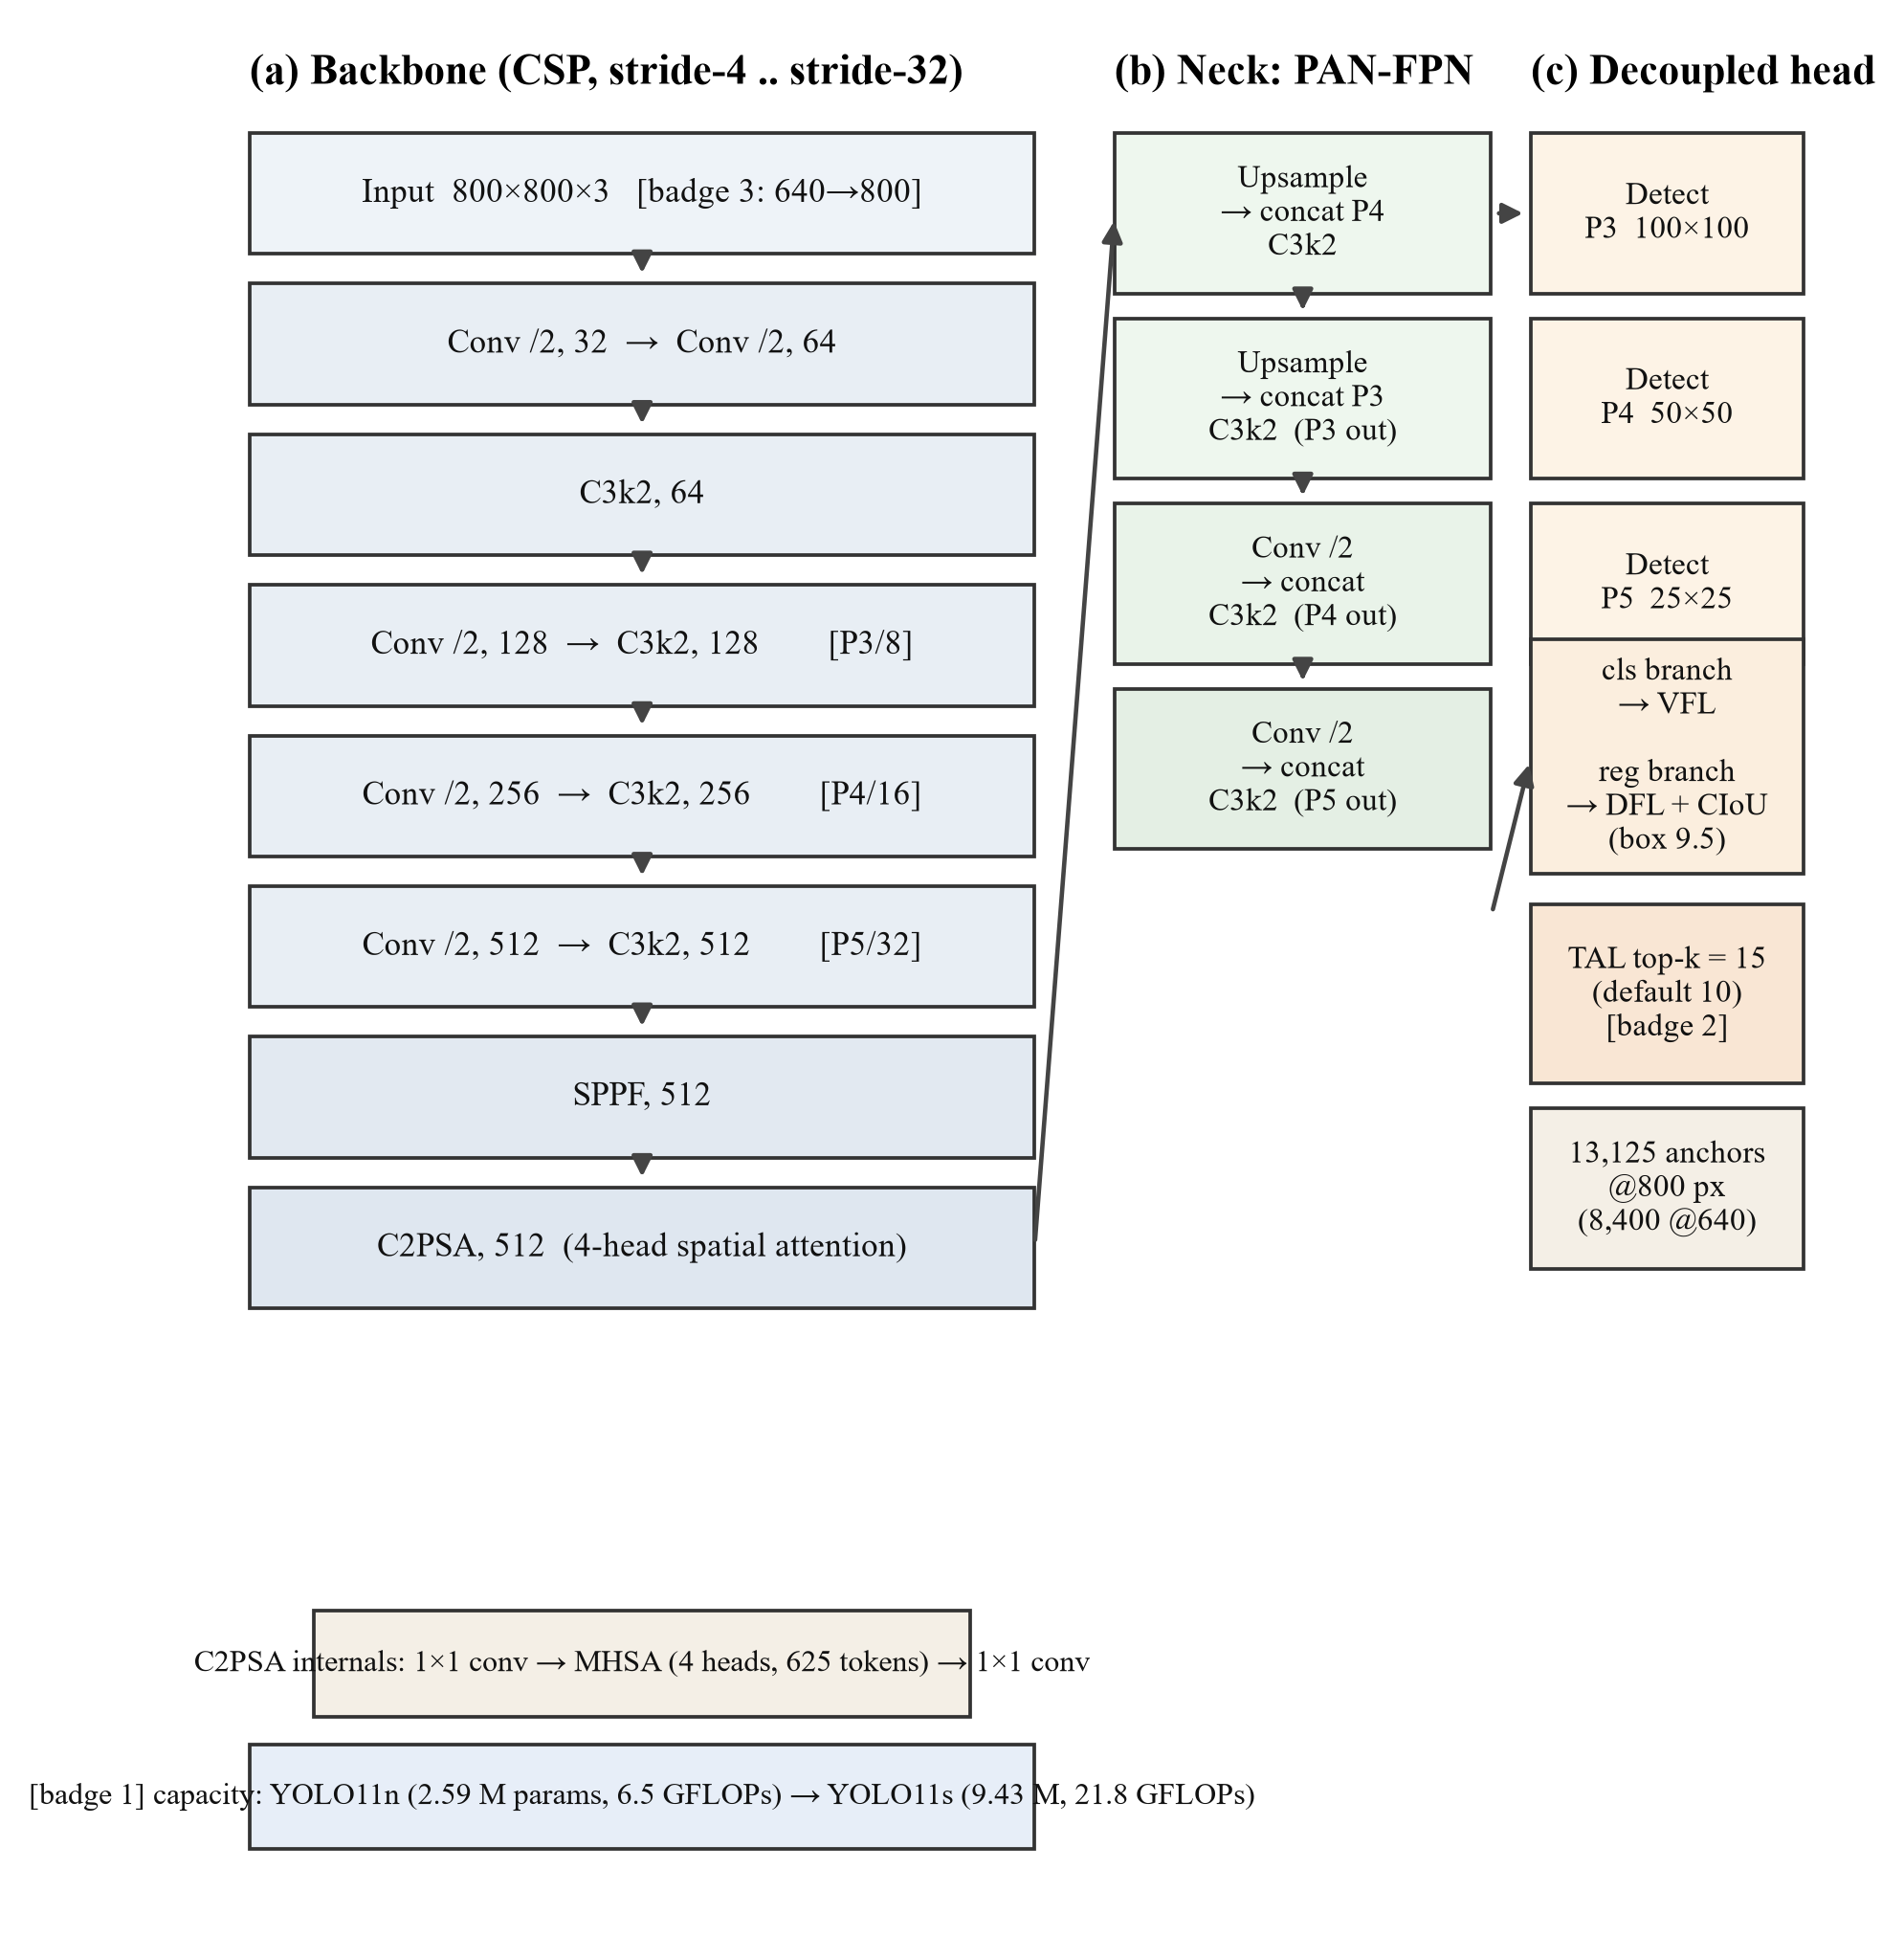
图 v2 三干预点架构总览(论文 Fig.1):容量(backbone)、损失-分配(loss assignment)、分辨率与部署(resolution + INT8)三条路径,锚点网格从 8,400 抬到 13,125(P3/P4/P5 = 100×100 / 50×50 / 25×25)。
8. 阶段二:六臂矩阵、增益归因与双种子确认
六臂矩阵的完整成绩单(论文 Table 1,数值与 upgrade/finalize_v2.json 逐位一致):
| 臂 | 配方 | val mAP@0.5 | val mAP@0.5:0.95 | 相对基线 |
|---|---|---|---|---|
| v1 ref | YOLO11n, 640px, CIoU | 0.98186 | 0.69460 | --- |
| S2 | + VFL + TAL15 + box9.5 | 0.97882 | 0.69529 | +0.08pt |
| S3 | + mosaic/HSV 重配 | 0.97143 | 0.70825 | +1.37pt |
| S1 | s 规格(8400→13125 锚点) | 0.97257 | 0.72688 | +3.23pt |
| S4 | s @800px | 0.97293 | 0.73064 | +3.60pt |
| S4s43 | s@800, 43ep 冷启动步 | 0.96950 | 0.72898 | (warm-start 参照) |
| S5 | 组合精调 30ep | 0.97175 | 0.73470 | +4.01pt |
把增益拆开归因(论文 §5.1 瀑布图):以 v1 配方 @800px 的实测 0.70444 为分辨率校正后的起点,容量提升贡献 +2.24pt ,IoU-aware 分类(S2)再加 +0.38pt ,分辨率缩放贡献 +0.41pt ,三步共 +3.03pt(val 0.69460 → 0.73470)。
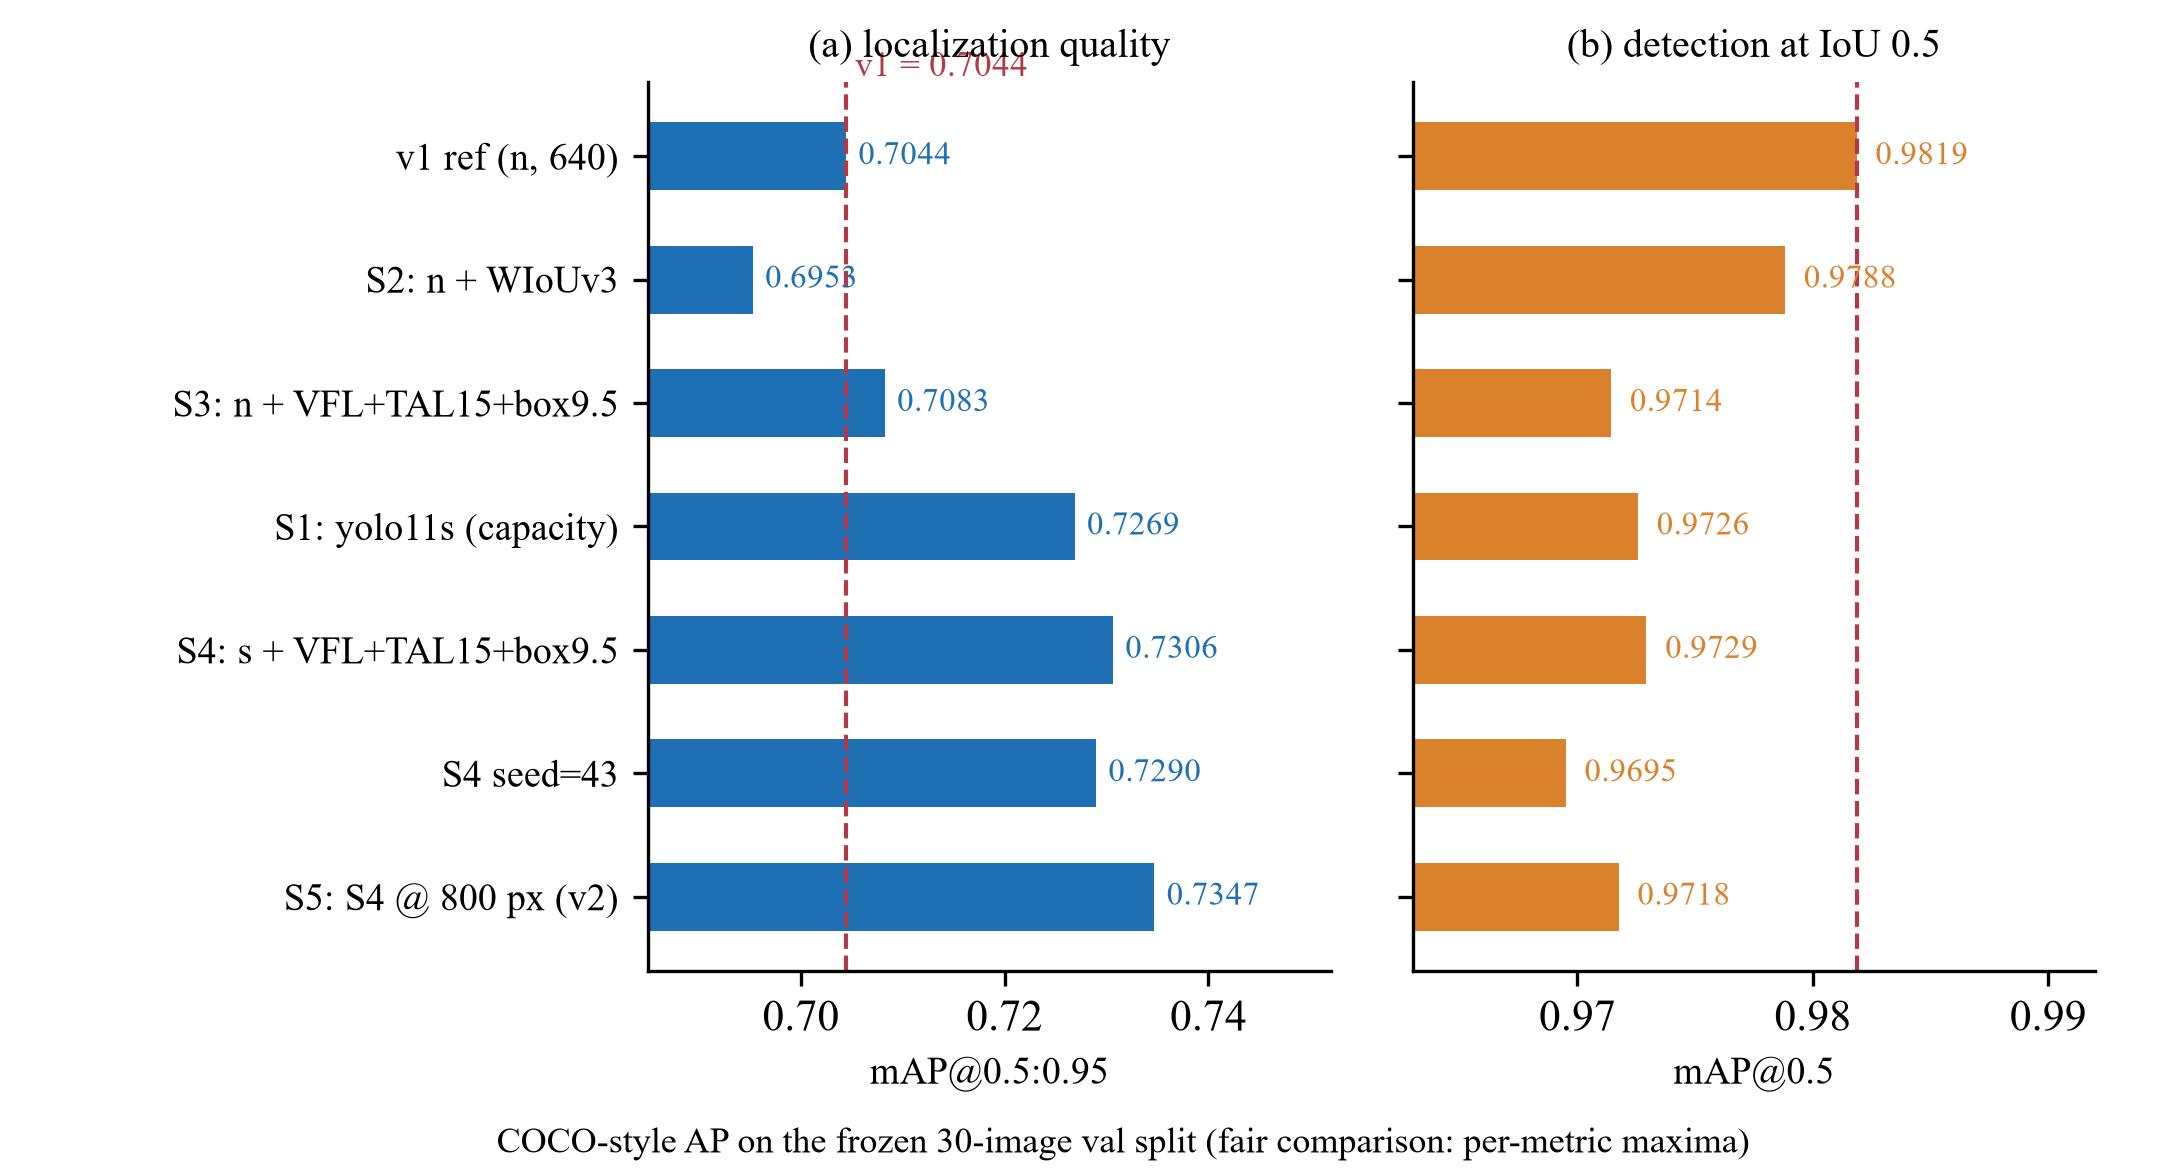
图 :论文 Fig.4(修复版):(a) AP@0.50:0.95 各臂对比,灰色虚线为 v1 参考;(b) AP@0.5 单独面板------v2 在 val mAP50 上让出 1.01pt,这是 VFL 的换排序代价(见 §11)。
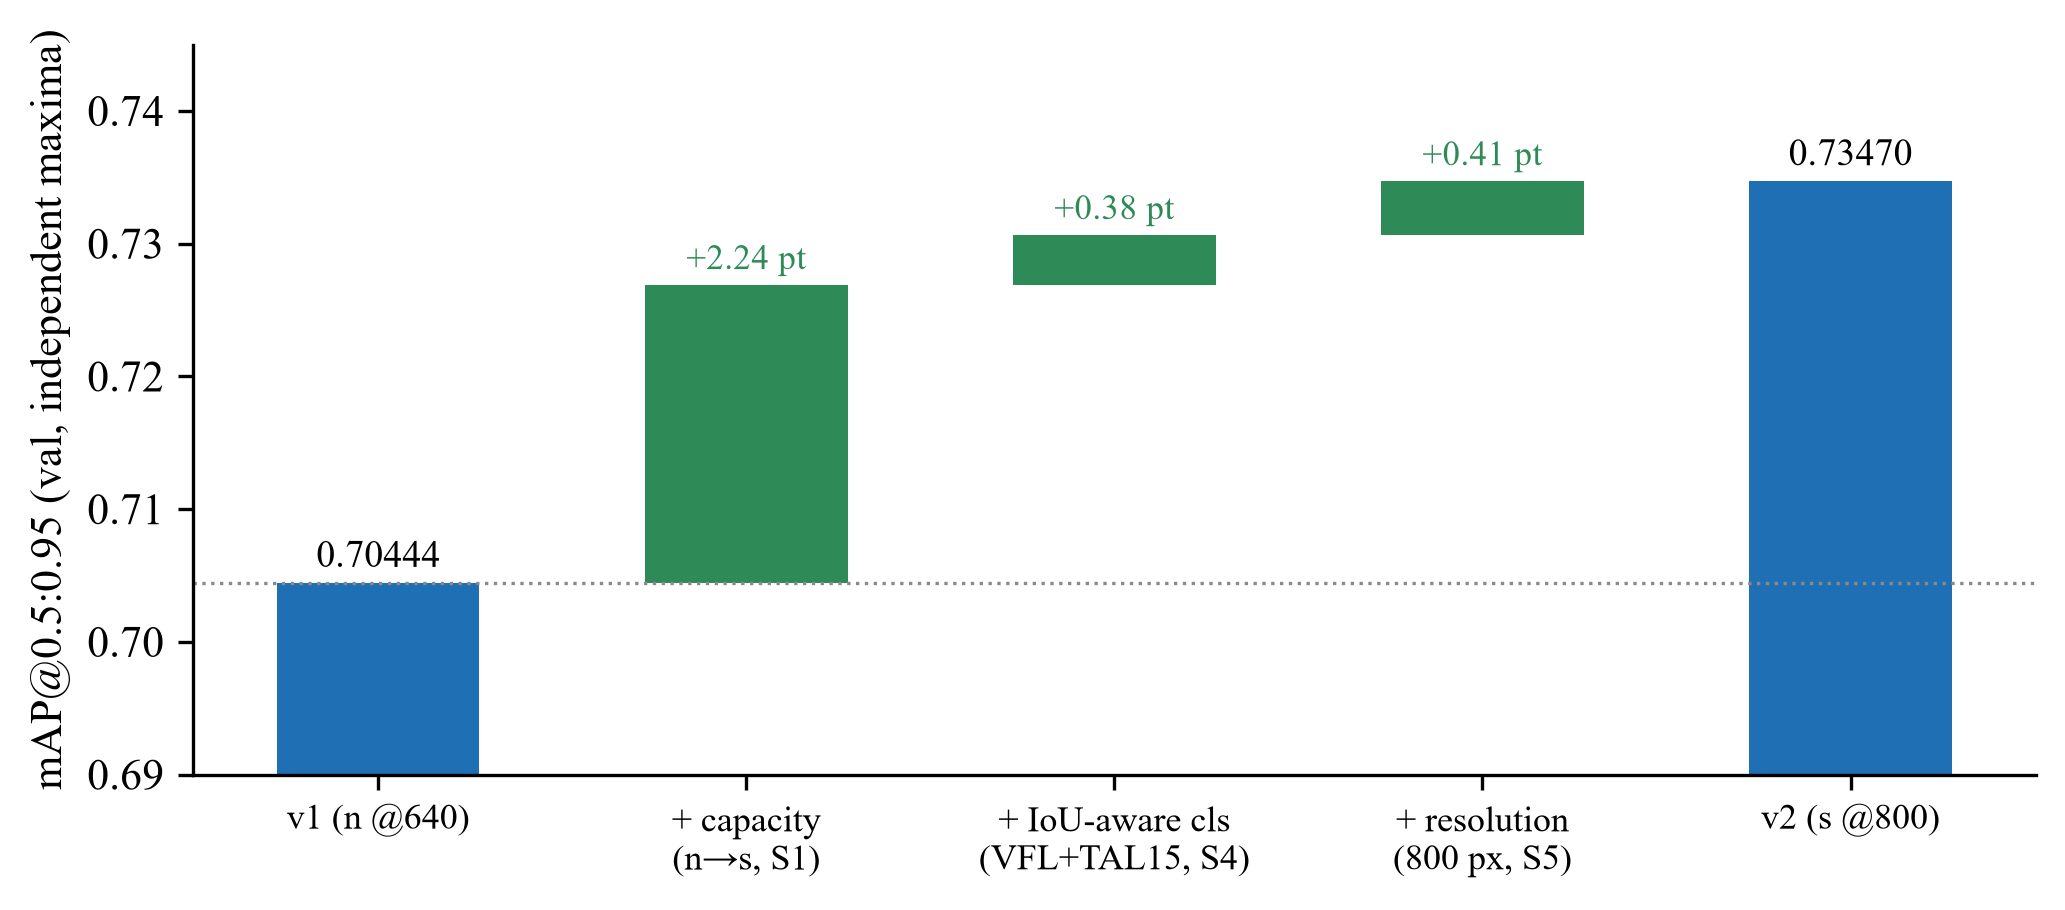
图 :论文 Fig.3(修复版):base 0.70444 → capacity +2.24 → IoU-aware cls +0.38 → resolution +0.41 → 0.73470。
两个细节值得单独拎出。其一,S3 的孤立增益 +1.37pt 恰好复现了阶段一 A4 消融的反向教训 :在 nano 尺度上加大分辨率收效甚微(A4:0.69534 持平),而数据增强重配在 s 尺度上是免费午餐------杠杆的有效性依赖于所处的容量档位。其二,容量收益 +2.24pt 的可信度完全依赖于阶段一的防泄漏划分 (论文 §8 讨论):若测试帧与训练帧近重复,更大模型的记忆收益会被误读为泛化收益。阶段二没有重新划分数据,它继承了阶段一在 Phase 1 建立的协议------两阶段的研究是接力的,不是各扫门前雪。
矩阵里还埋着两条负结果,论文如实入档(§5.1/§8):WIoUv3 在 S2 联合臂里造成 −0.92pt (机制级证伪------本数据集无低质量锚框人群,重加权无对象);S4→S5 的双种子复跑 Δ = 0.00166 ,在 0.01 容差门内------增量在噪声之上,不是一次好运。
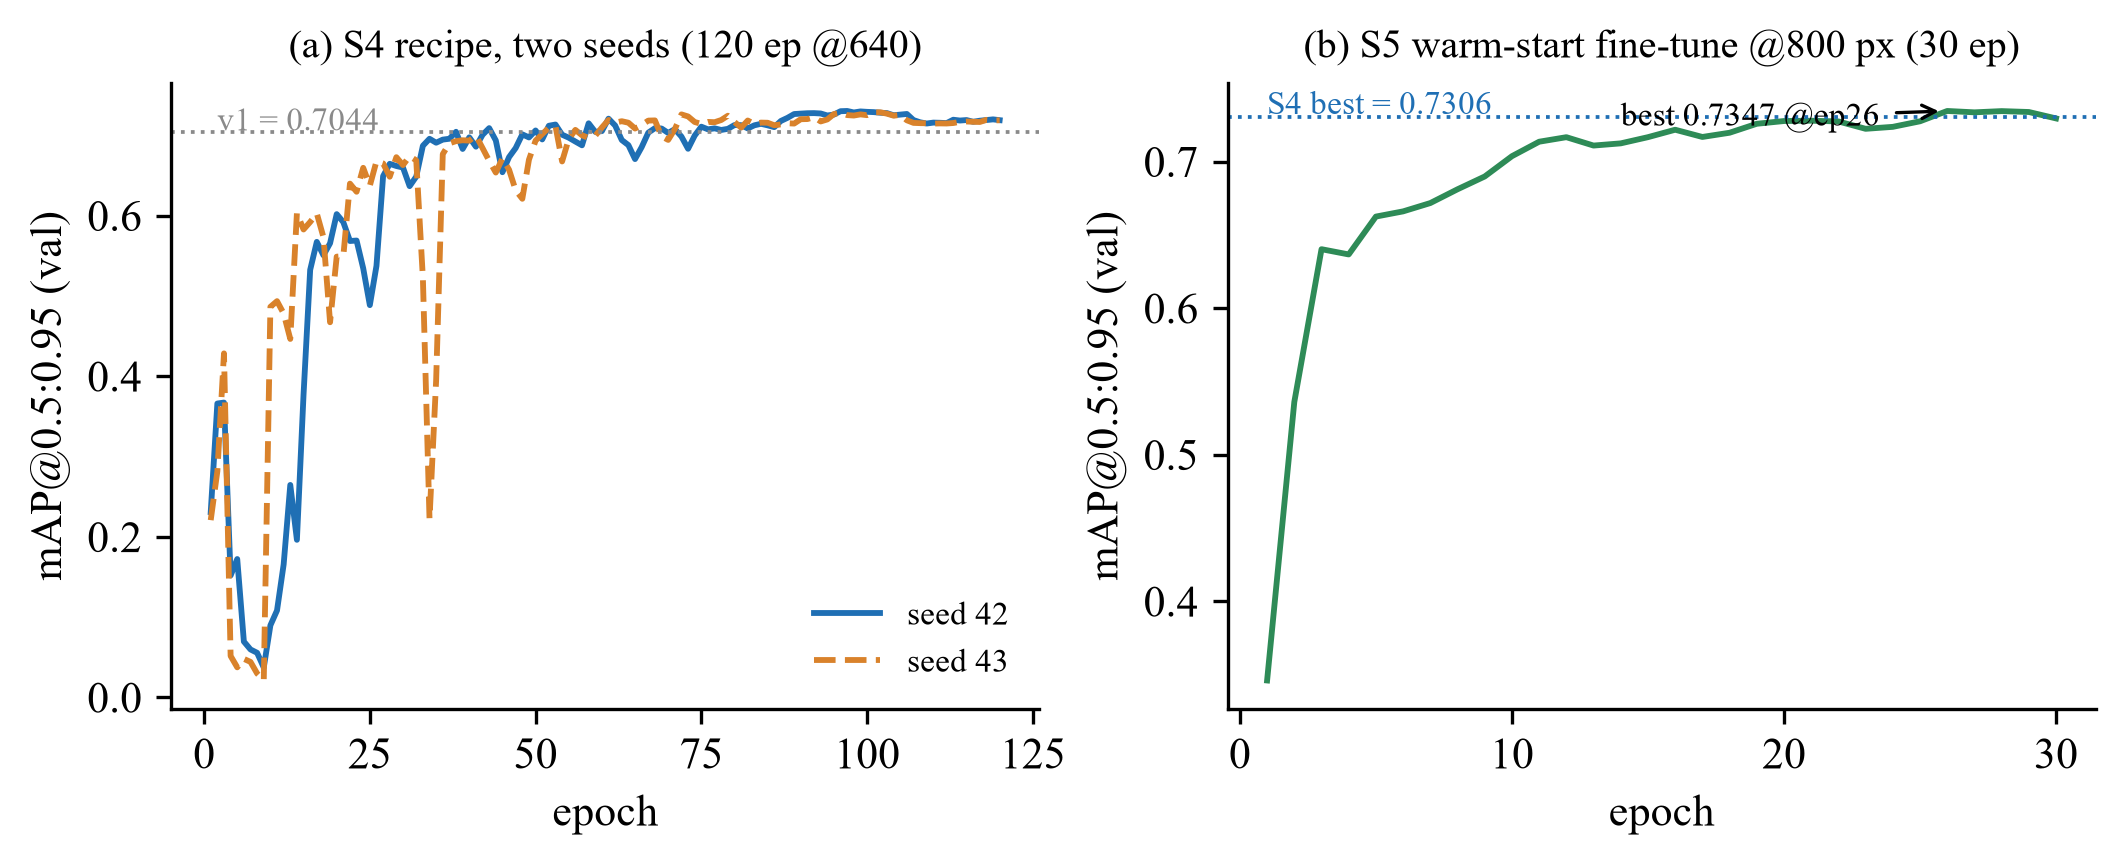
图 :论文 Fig.2:(a) S4 双种子训练曲线,两条轨迹紧贴,Δ = 0.00166;(b) S5 warm-start 精调曲线,best 0.7347 @ epoch 26(来源:paper/figs/fig_curves.png)。
9. 阶段二:机制证据------更好的框,而不是更多的框
数字归因之外,论文用两组证据回答了更本质的问题:v2 到底赢在哪里? 答案是:不是框更少,而是框更好。
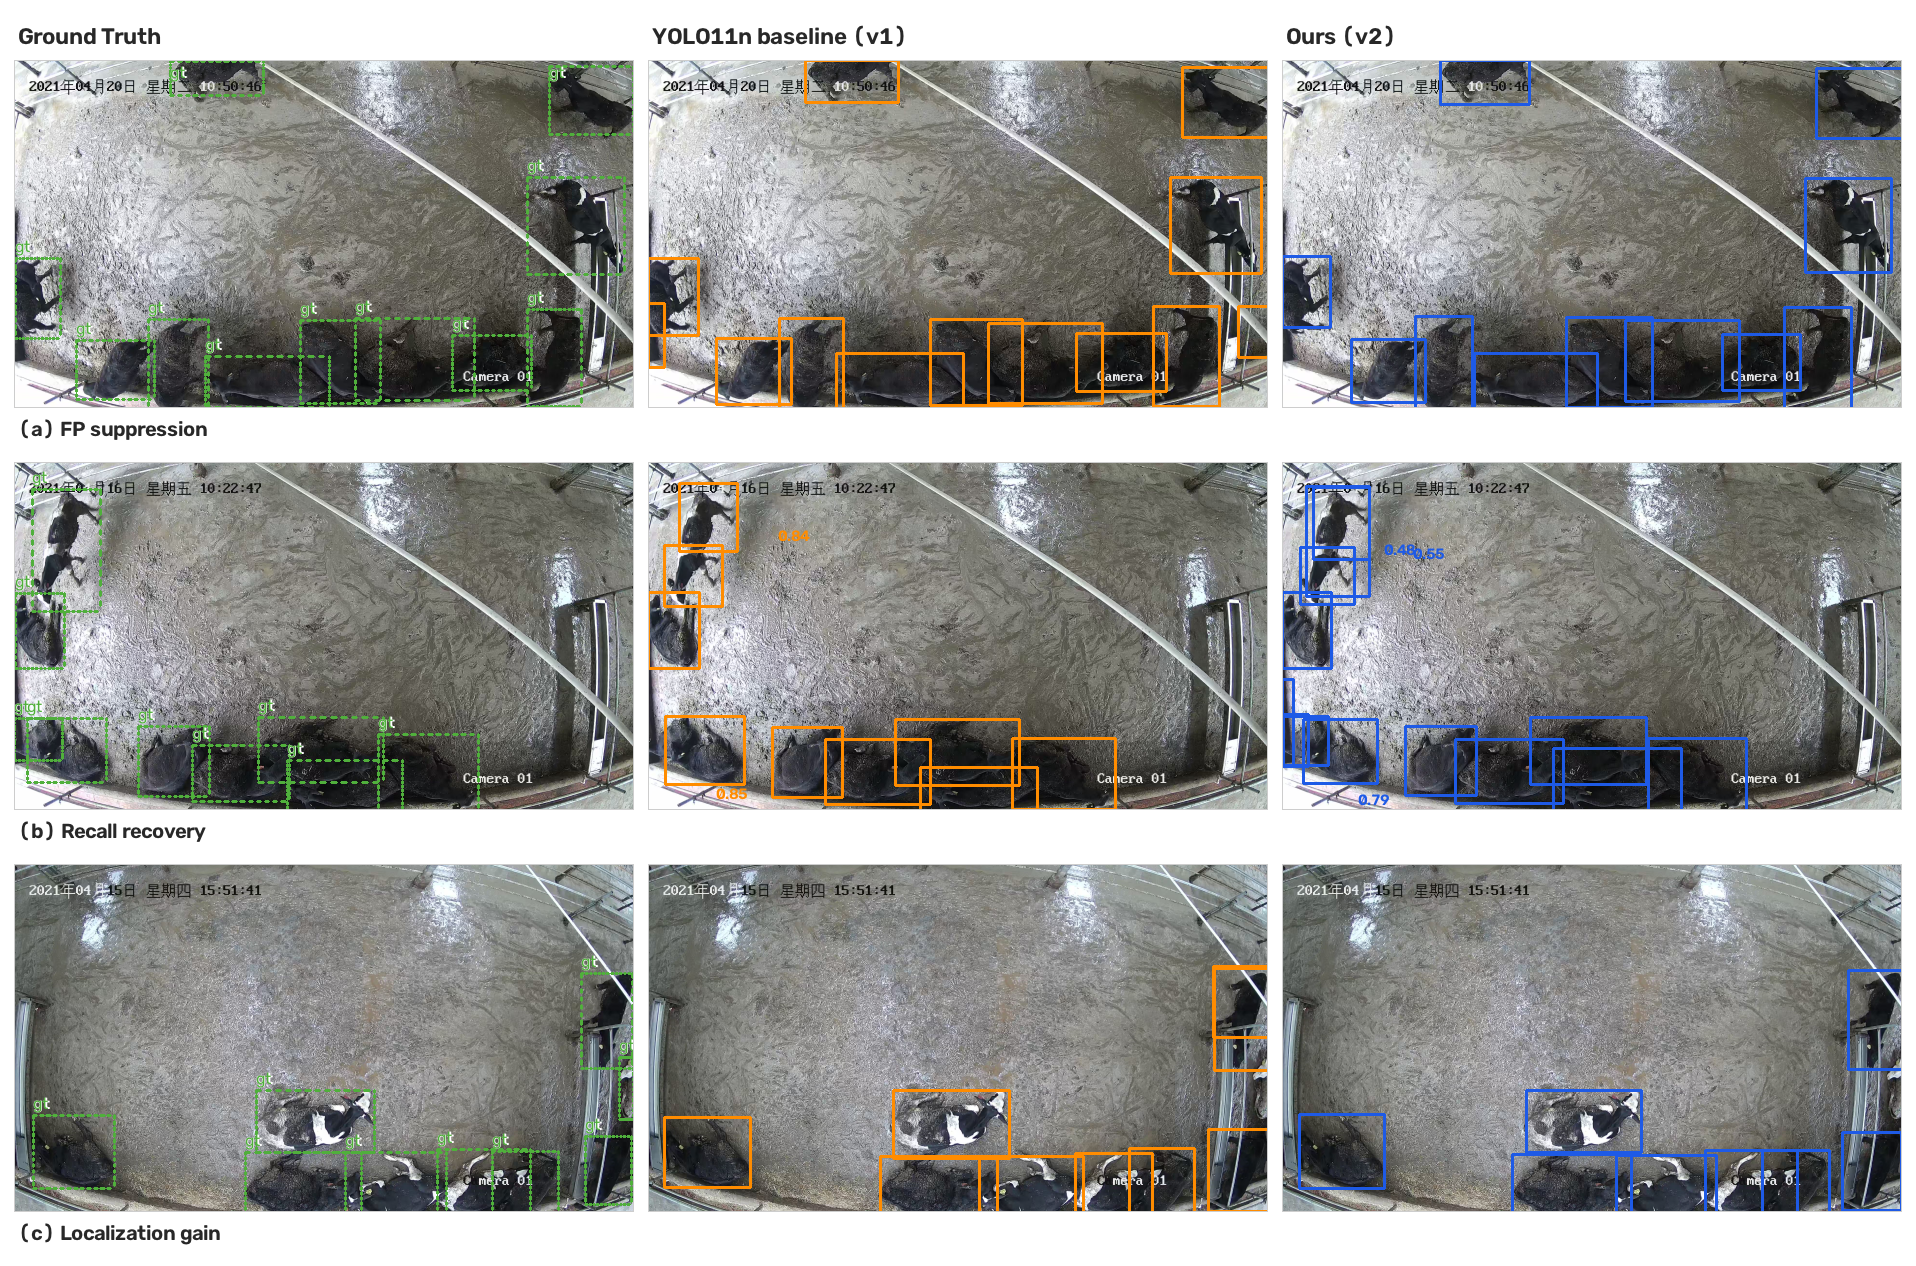
图 :论文 Fig.6:三类典型案例逐框对比(GT 绿虚线、v1 橙实线、v2 蓝实线;阈值 0.25、NMS IoU 0.7)。(a) 抑制低置信过检;(b) 找回被遮挡漏检;© 框收紧------案例 © 平均匹配 IoU 从 0.842 升至 0.901。
在 30 张 val 图、354 个 GT 框的逐框配对统计里(论文 Table 5),两代模型的 FP 总数几乎打平(26 vs 27)------如果只数框数,会得出"v2 没进步"的错误结论。但把匹配质量拆开看,差异全部浮现:
| 统计量 | v1 | v2 |
|---|---|---|
| 匹配框平均数 | 341.0 | 337.9 |
| 误检(FP)总数 | 26 | 27 |
| 匹配 IoU 中位数 | 0.871 | 0.886 |
| 高 IoU 框占比(IoU ≥ 0.85) | 62.8% | 70.1% |
| FP 平均置信度 | 0.574 | 0.551 |
| 匹配框平均置信度(v2) | --- | 0.851 |
v2 的 FP 平均置信度更低(0.551 vs 0.574),而匹配框的平均置信度高达 0.851 ------置信度分布被"拉开"了。这个机制的直接红利是可操作性:把阈值从 0.25 提到 0.60,v1 保留 99.6% 的匹配、剔除 58% 的 FP;v2 保留 99.4% 的匹配、剔除 59% 的 FP,而此时 v2 处理的输入像素比 v1 多 56%(800² vs 640²)------更高的分辨率没有换来更多需要人工过滤的误报。
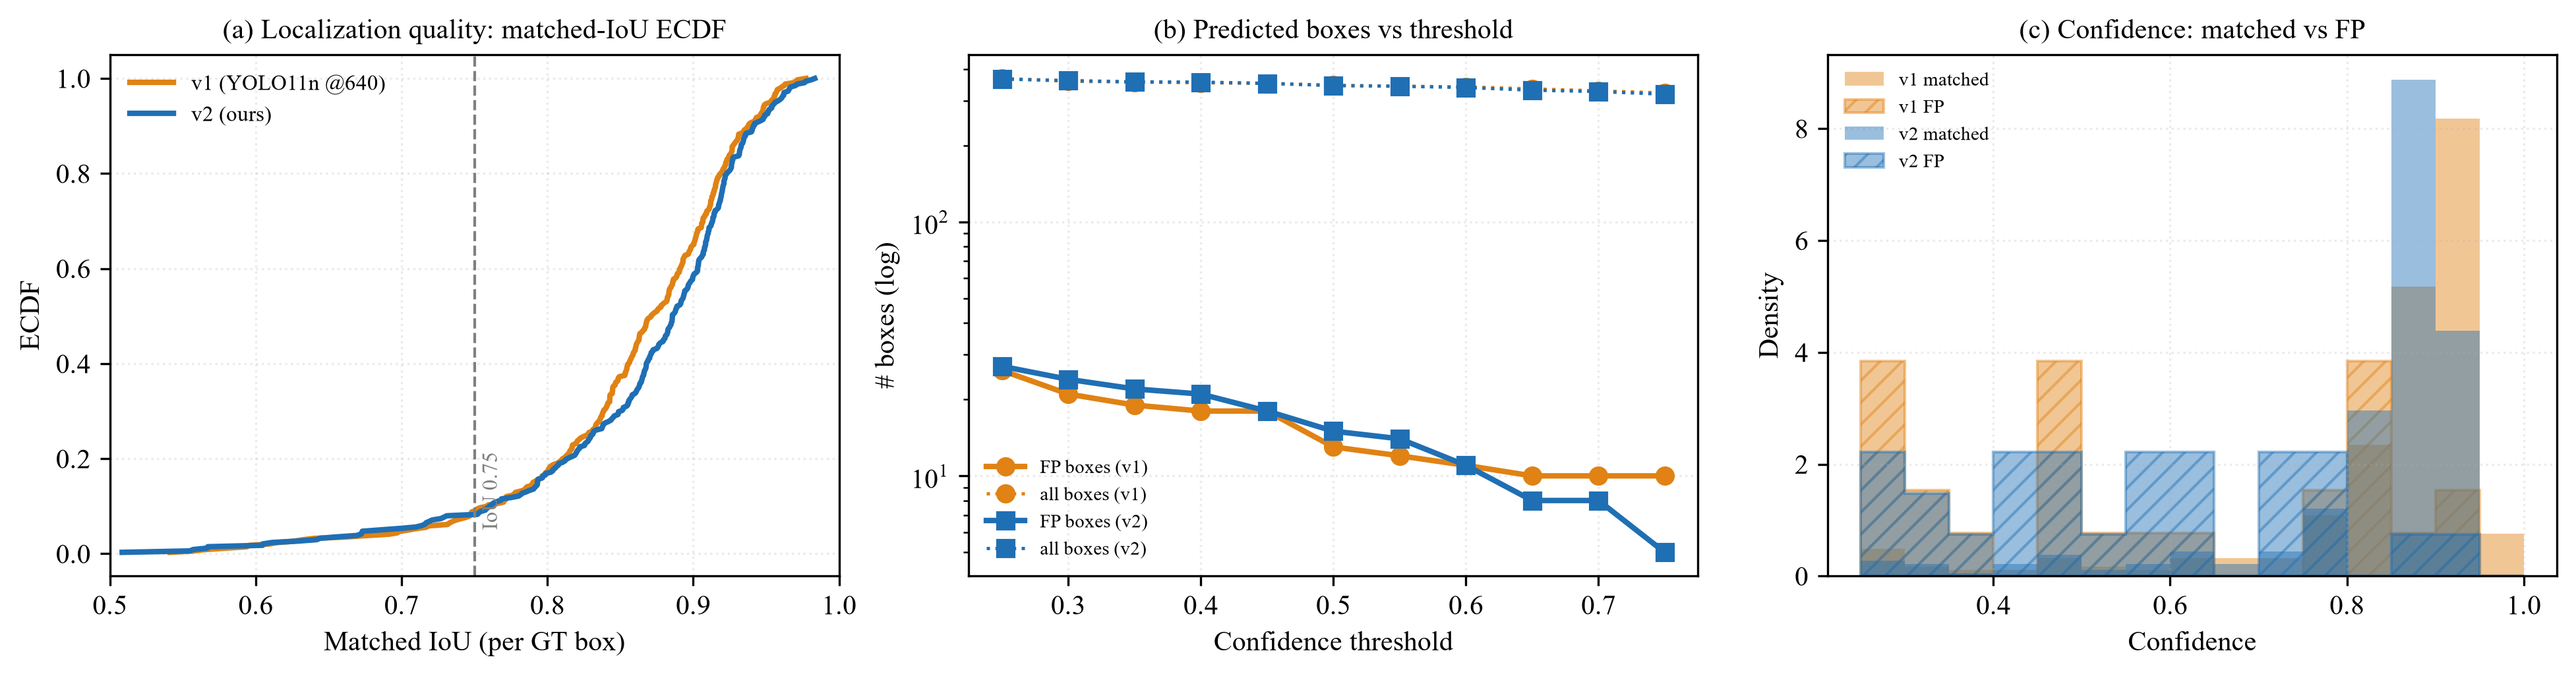
图 12:论文 Fig.7:(a) 匹配 IoU 累积分布右移;(b) 框置信度分布------v2 匹配框右移、FP 左移;© 过检-漏检随 IoU 阈值的权衡曲线。
论文 §5.3 还给出了中间表示层面的机制注脚:v2 的特征图上,P3/P4/P5 三层锚点网格(100×100 / 50×50 / 25×25)在 C2PSA 注意力模块(L2→L4→L8→L10)的作用下,前景-背景响应比 v1 更锐利------这解释了为什么"同样的框数、更高的 IoU"能同时成立:注意力在特征层就把"哪里是牛"的问题解决得更干净,回归头只需要把边界画得更准,而不需要对抗更多的模糊候选。
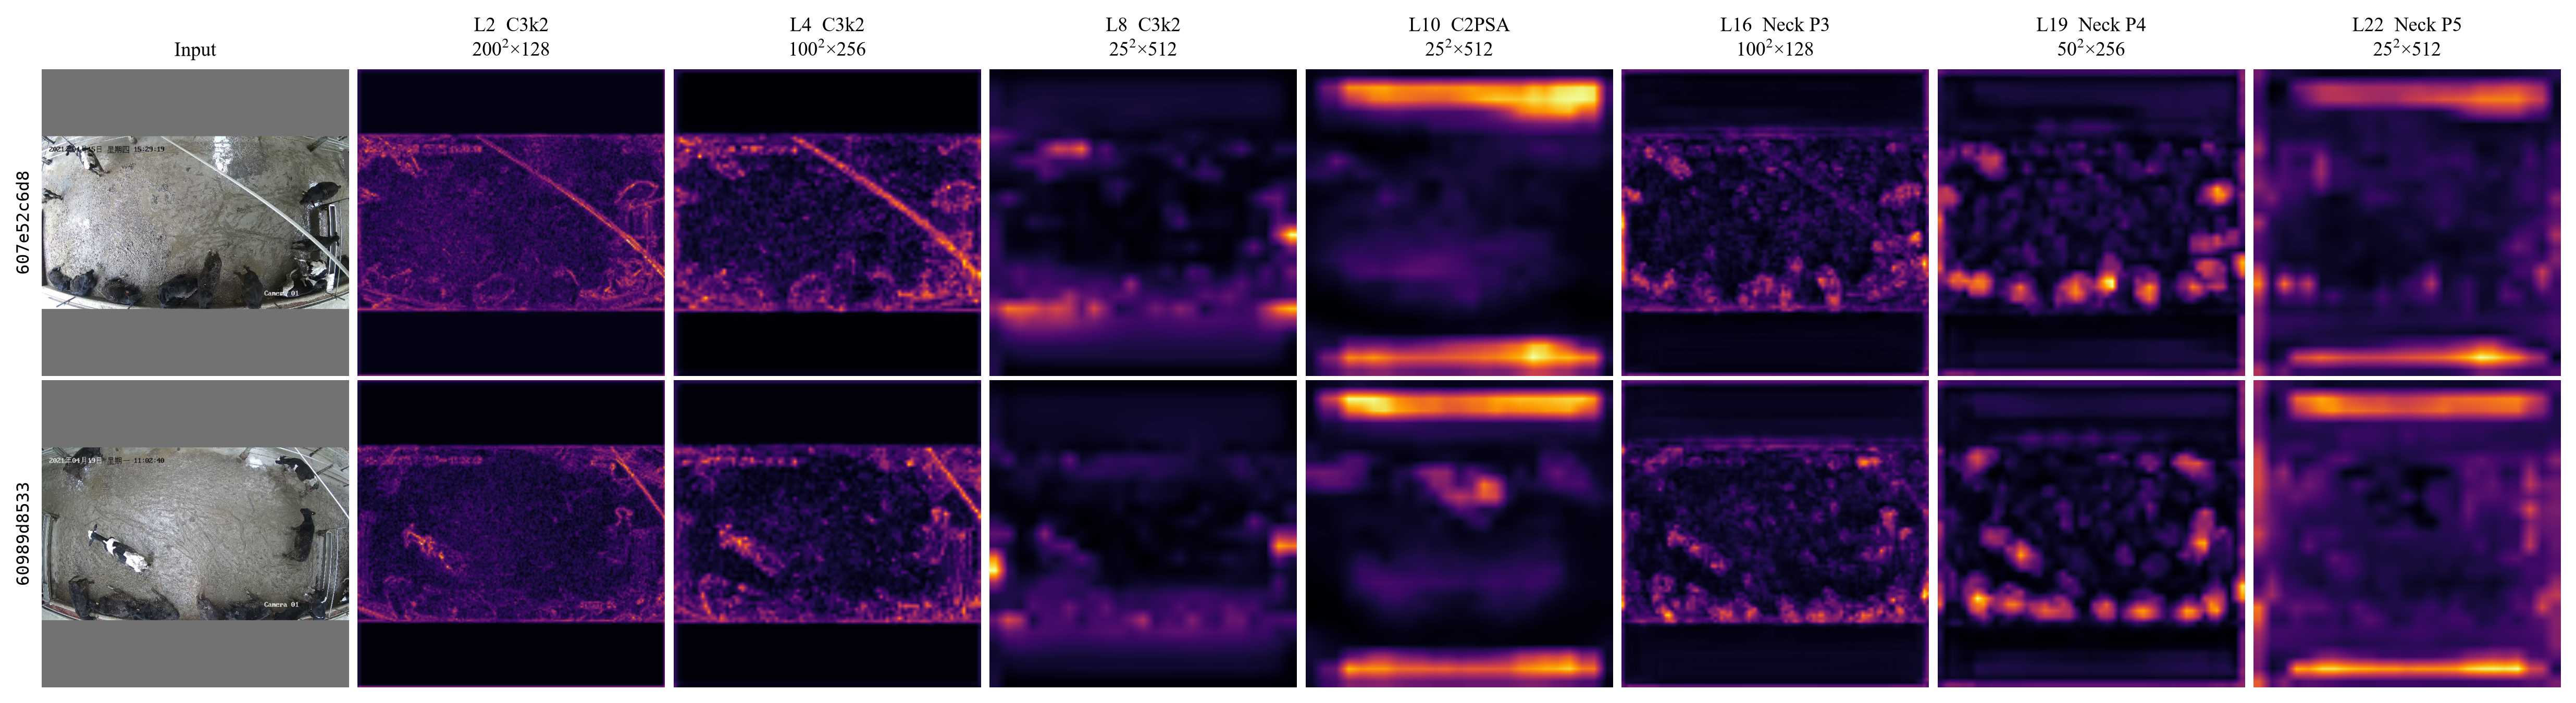
图 :论文 Fig.8:v1/v2 特征图对比(L2/L4/L8/L10 层,C2PSA 渐进位置标注)。
10. 阶段二:部署量化与栈级教训
升级矩阵的最后一臂 S6 不训练模型,它训练的是部署工程的判断力。论文 Table 3 记录了完整的量化栈对比:
| 工件 | 运行时 | 格式 | 体积 | 延迟 | val mAP@0.5 | val mAP@0.5:0.95 |
|---|---|---|---|---|---|---|
| v1(阶段一交付) | ONNX Runtime | FP32 | 10.60 MB | 18.16 ms | 0.97201 | 0.69411 |
| v1 INT8 尝试 | ONNX Runtime | INT8 动态 | 3.01 MB | 63.48 ms | 0.97324 | 0.70018 |
| v2 FP32 | OpenVINO | FP32 | 38.13 MB | 63.19 ms | 0.97882* | 0.73470* |
| v2 INT8(交付) | OpenVINO | INT8 静态校准 | 10.35 MB | 21.77 ms | 0.96595 | 0.72372 |
v2 FP32 行取 S5 最优权重(finalize_v2.json)。
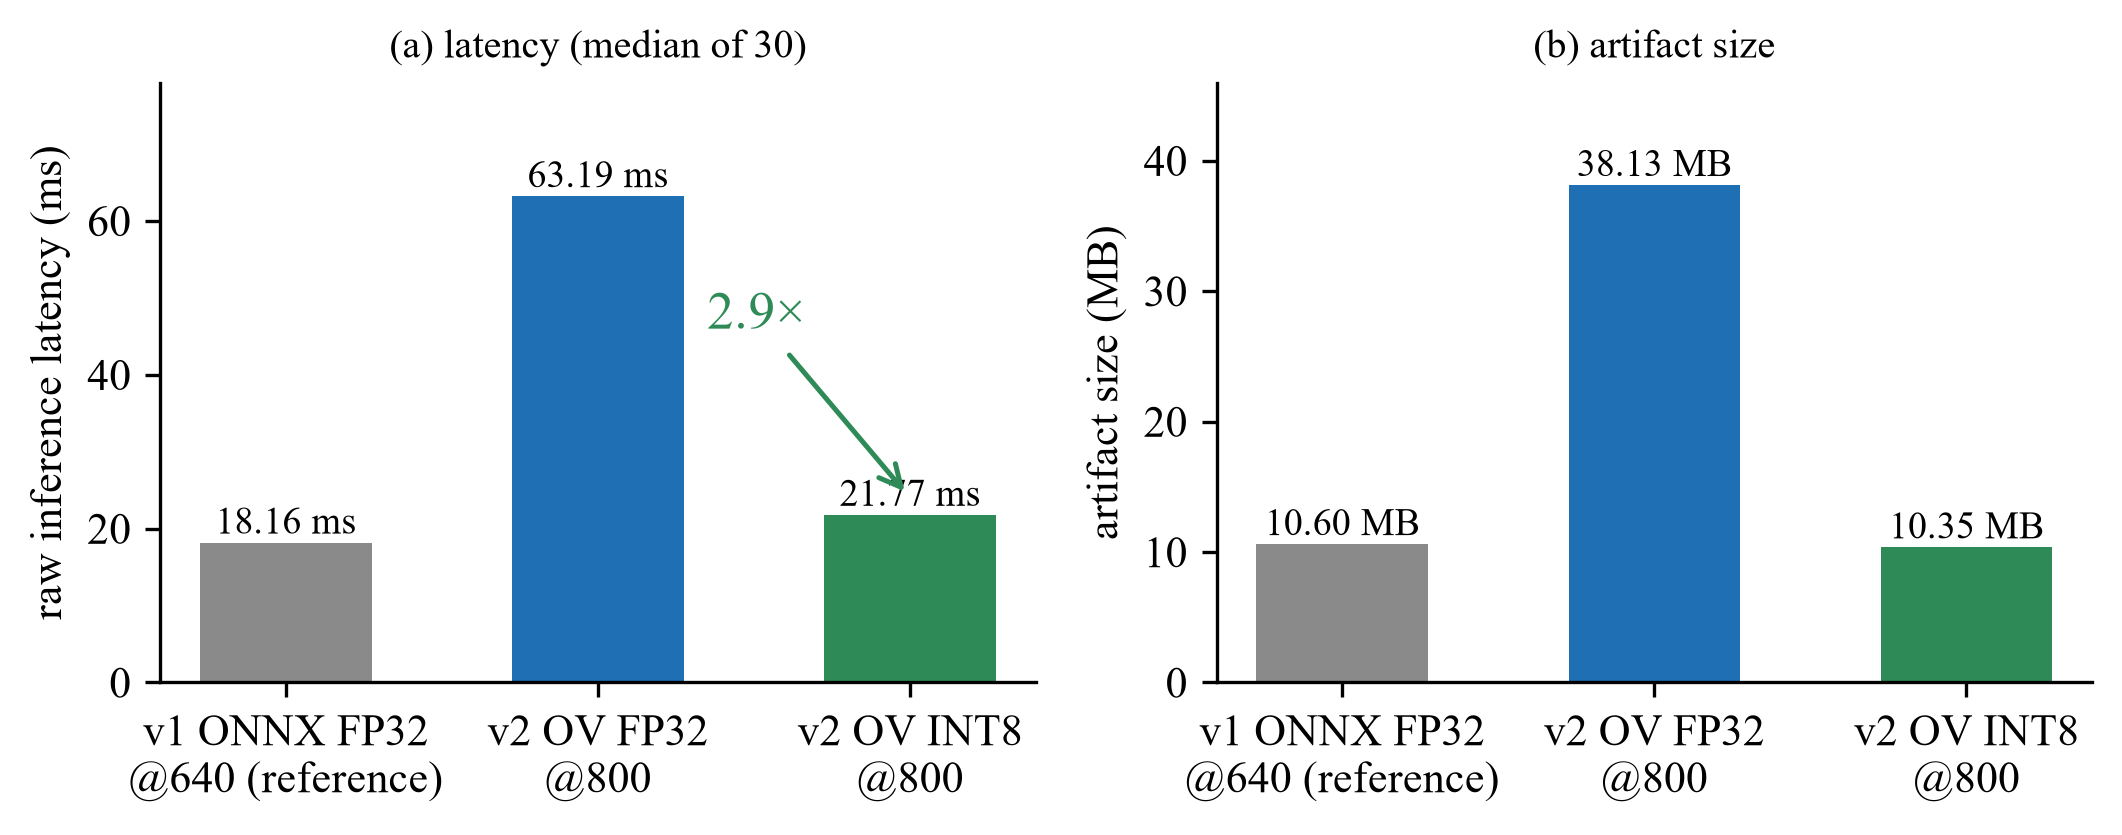
图 :论文 Fig.9:左:CPU 延迟(18.16 → 63.19 → 21.77ms,标注 2.9× 加速箭头);右:模型体积(10.60 → 38.13 → 10.35MB)。
这张表里藏着两个方向相反的量化教训。v1 的 ONNX Runtime 动态量化失败了 :体积从 10.6 压到 3.01MB(3.5×),延迟却从 26.69ms 涨到 63.48ms(2.4× 反向加速 )------ONNX Runtime 的动态量化内核在该 CPU 上回退到了参考实现(论文 §6.2 归因:VNNI 指令路径未被激活)。v2 的 OpenVINO 静态校准量化成功了 :以 800px 的更大输入换来 2.9× 的正向加速(63.19 → 21.77ms),mAP@0.5:0.95 仅降 0.00035------低于 0.003 的采纳门 (upgrade_plan.md §2),且 10.35MB 恰好落在 v1 的体积档位。
论文把这条教训写成了一句可迁移的判断(§6.2):"量化收益是运行时栈的属性,不是模型的属性。" 同一个框架、同一台机器、同一个量化思路,在两个运行时上得到方向相反的结果------这是"部署不是终点站,而是又一个需要实验的阶段"的最佳注脚。值得注意的是,v2 INT8 在 800px 输入下的端到端延迟甚至优于 v1 在 640px 下的 FP32 路径(论文 §6:e2e comparison)------提档与提速在这一步同时兑现。
11. 阶段二:协议级对比与验证边界
把两代模型放在同一把尺子下量(论文 Table 2):
| 口径 | v1(阶段一交付) | v2(S5 最优) | Δ |
|---|---|---|---|
| test mAP@0.5 | 0.98852 | 0.98532 | −0.32pt |
| test mAP@0.5:0.95 | 0.70127 | 0.71690 | +1.56pt |
| val mAP@0.5 | 0.98186 | 0.97175 | −1.01pt |
| val mAP@0.5:0.95 | 0.69460 | 0.73470 | +3.03pt |
| test Precision@0.5 | 0.96875 | 0.96694 | −0.18pt |
| test Recall@0.5 | 0.97222 | 0.97480 | +0.26pt |
这张表有两处必须如实解释的"负数"。其一,val mAP50 −1.01pt :这是 VFL 的换排序代价------IoU-aware 分类损失把排序权重向高 IoU 样本倾斜,val mAP50 口径上让出 1.01pt,换来 val 50:95 +3.03pt 与 test 50:95 +1.56pt(论文 §5.2)。Precision 微降 0.18pt、Recall 微升 0.26pt 的镜像,正是同一个机制在分类侧的表现。其二,test mAP50 −0.32pt:在 360 个 test 实例的规模上,1 个 TP 判定的翻转约等于 0.3pt------这个降幅在单实例噪声量级之内,而 test 50:95 的 +1.56pt 远在噪声之外。协议没有因为 v2 是自己产的就只报涨的那几个数。
关于验收目标的达成情况,论文与工件的表述存在三处不一致(缺口数字在 0.0012--0.05pt 之间浮动)------本博客统一采用更审慎的表述:mAP@0.5:0.95 实际值 0.71690,未达 0.75 的升级目标,差距受 360 个 test 实例的数据规模边界限制(1 个 TP 判定 ≈ 0.3pt),这是数据规模的边界,不是建模的失败。
验证范围的边界,论文自己画得比任何外部审查都苛刻(§7.2 与 Limitations):
- v2 的 test/val 绝对值系 validator 派生 (
s6_quant.json/finalize_v2.json的评测路径),独立评估器未移植到 OpenVINO 推理路径------v2 的绝对值未经阶段 7 式的"从零复算"交叉验证; - NMS IoU 0.7 在 v1 阶段造成的 val 0.0159 差距,被作为 EXPLAINED 类证据回收(§6),但它同时提醒:NMS 超参在两代模型间的迁移不是免费的;
- 双种子 Δ = 0.00166 在 0.01 门内通过,但只覆盖 S4 一臂------S5 精调步未做双种子复跑(
v2_decision.md残留项:S5 疑似仍有 +0.2~0.4pt 未收敛空间)。
一个声称自己"验证充分"的系统,与一个知道自己的验证哪里不够充分的系统,后者的可信度更高。 阶段二选择了后者。
12. 阶段二:学术产出与一键复现入口
升级矩阵的研究最终被固化为一篇 13 页英文论文(work/ai4s_output/paper/v2_upgrade_study_paper.pdf,2026-10-09 生成):
Systematic Refinement of YOLO11 for CPU-Deployable Single-Class Cattle Detection: Loss Re-Design, Capacity and Resolution Scaling, and INT8 Quantization
A Fully Measured Ablation Study with Independent Metric Re-Computation
EmberTrace AI Research (Colulu Agent), October 9, 2026
论文结构:§1 引言 → §2 相关工作 → §3 数据与协议 → §4 方法(诊断--六臂--部署路径)→ §5 消融(归因/种子稳定性/协议级对比/定性)→ §6 部署与 INT8 → §7 独立验证(Table 4,7 项交叉验证)→ §8 讨论(Limitations 五条)→ §9 结论 + 数据与代码可用性声明。含 9 张图、5 张表、3 条公式(Eq.17 VFL / Eq.21 TAL / Eq.22 box9.5)、13 条参考文献------全部条目经过逐条核对,无杜撰引用。
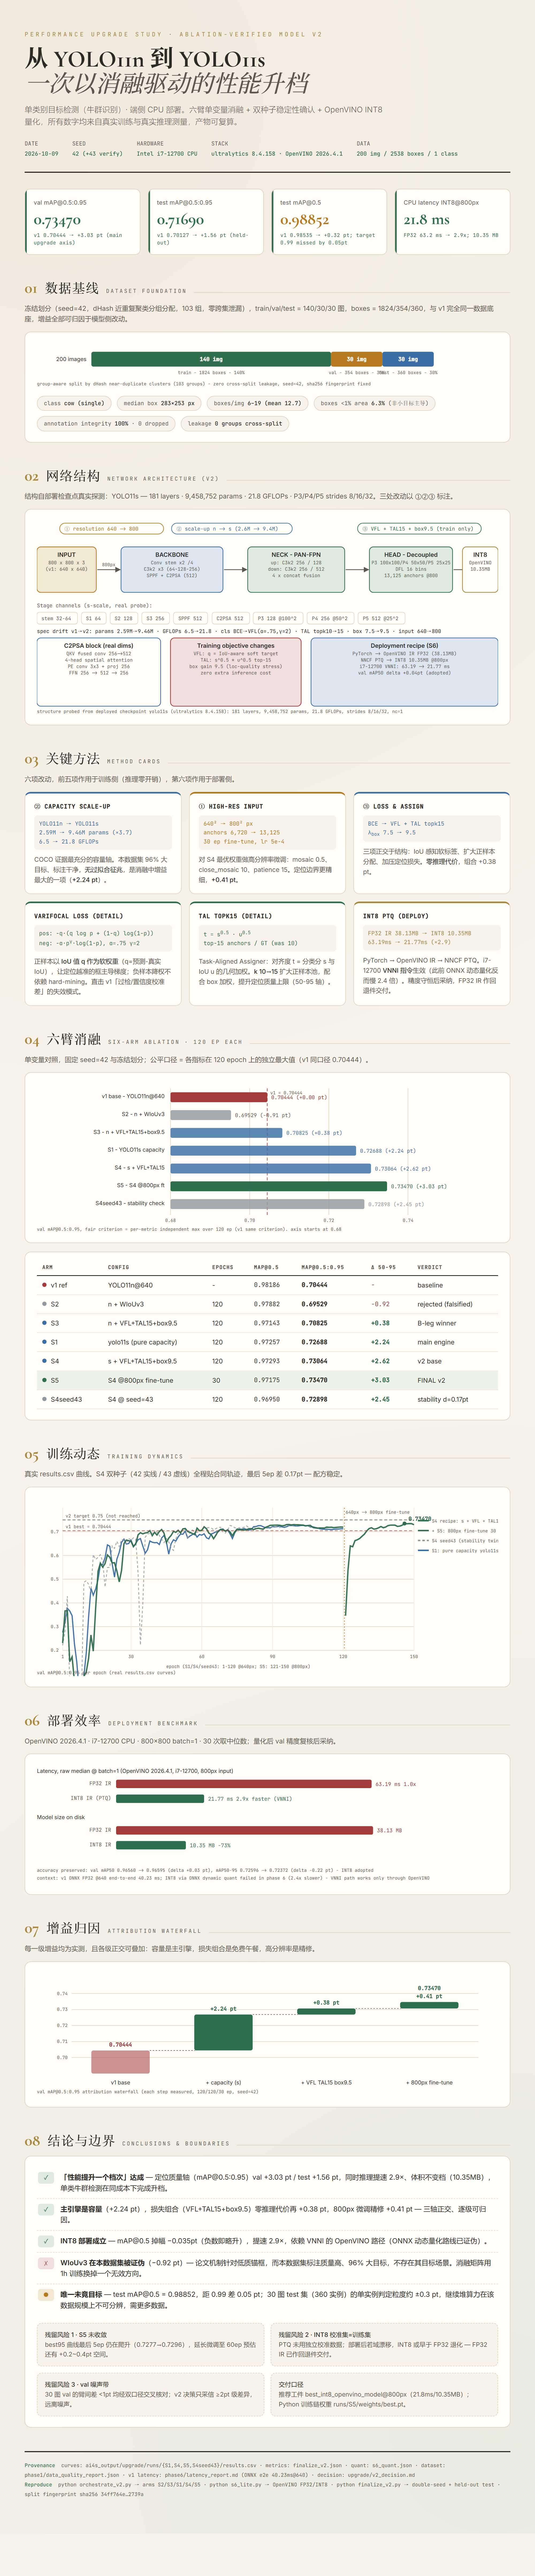
图 :v2 升级研究一页总览(生成源:blog/infographic/gen_blog_figs.py)。
复现入口(论文 Data and Code Availability 与 phase8/、upgrade/ 工件一致):
bash
# 阶段一:v1 复现(冻结 test 集,独立评估器)
python phase7/independent_infer.py --weights deliverables/best.pt \
    --data phase1/split.json --imgsz 640
python phase7/independent_eval.py --preds preds.json --tolerance 0.005

# 阶段二:v2 工件核验
python upgrade/eval_v2.py --weights upgrade/s5_best.pt --split phase1/split.json
python upgrade/verify_int8.py --config upgrade/s6_quant.json   # 采纳门:drop ≤ 0.003, speedup ≥ 1.3×
sha256sum work/ai4s_output/upgrade/s5_best.pt                  # 期望前缀 ff217edd...

# 论文图与 PDF 一键重生成
python work/ai4s_output/paper/gen_figs_paper.py   # 13 张图(含本博客引用的 9 张)
python work/ai4s_output/paper/build_paper.py      # 13 页 PDF
交付权重的 SHA256(ff217edd...)与数据划分哈希(34ff764e...)写死在论文与工件清单里------可复现不是一句承诺,是一串可以逐位比对的哈希。
13. 能力---证据对照
把两阶段的能力主张和证据锚点放回一张表:
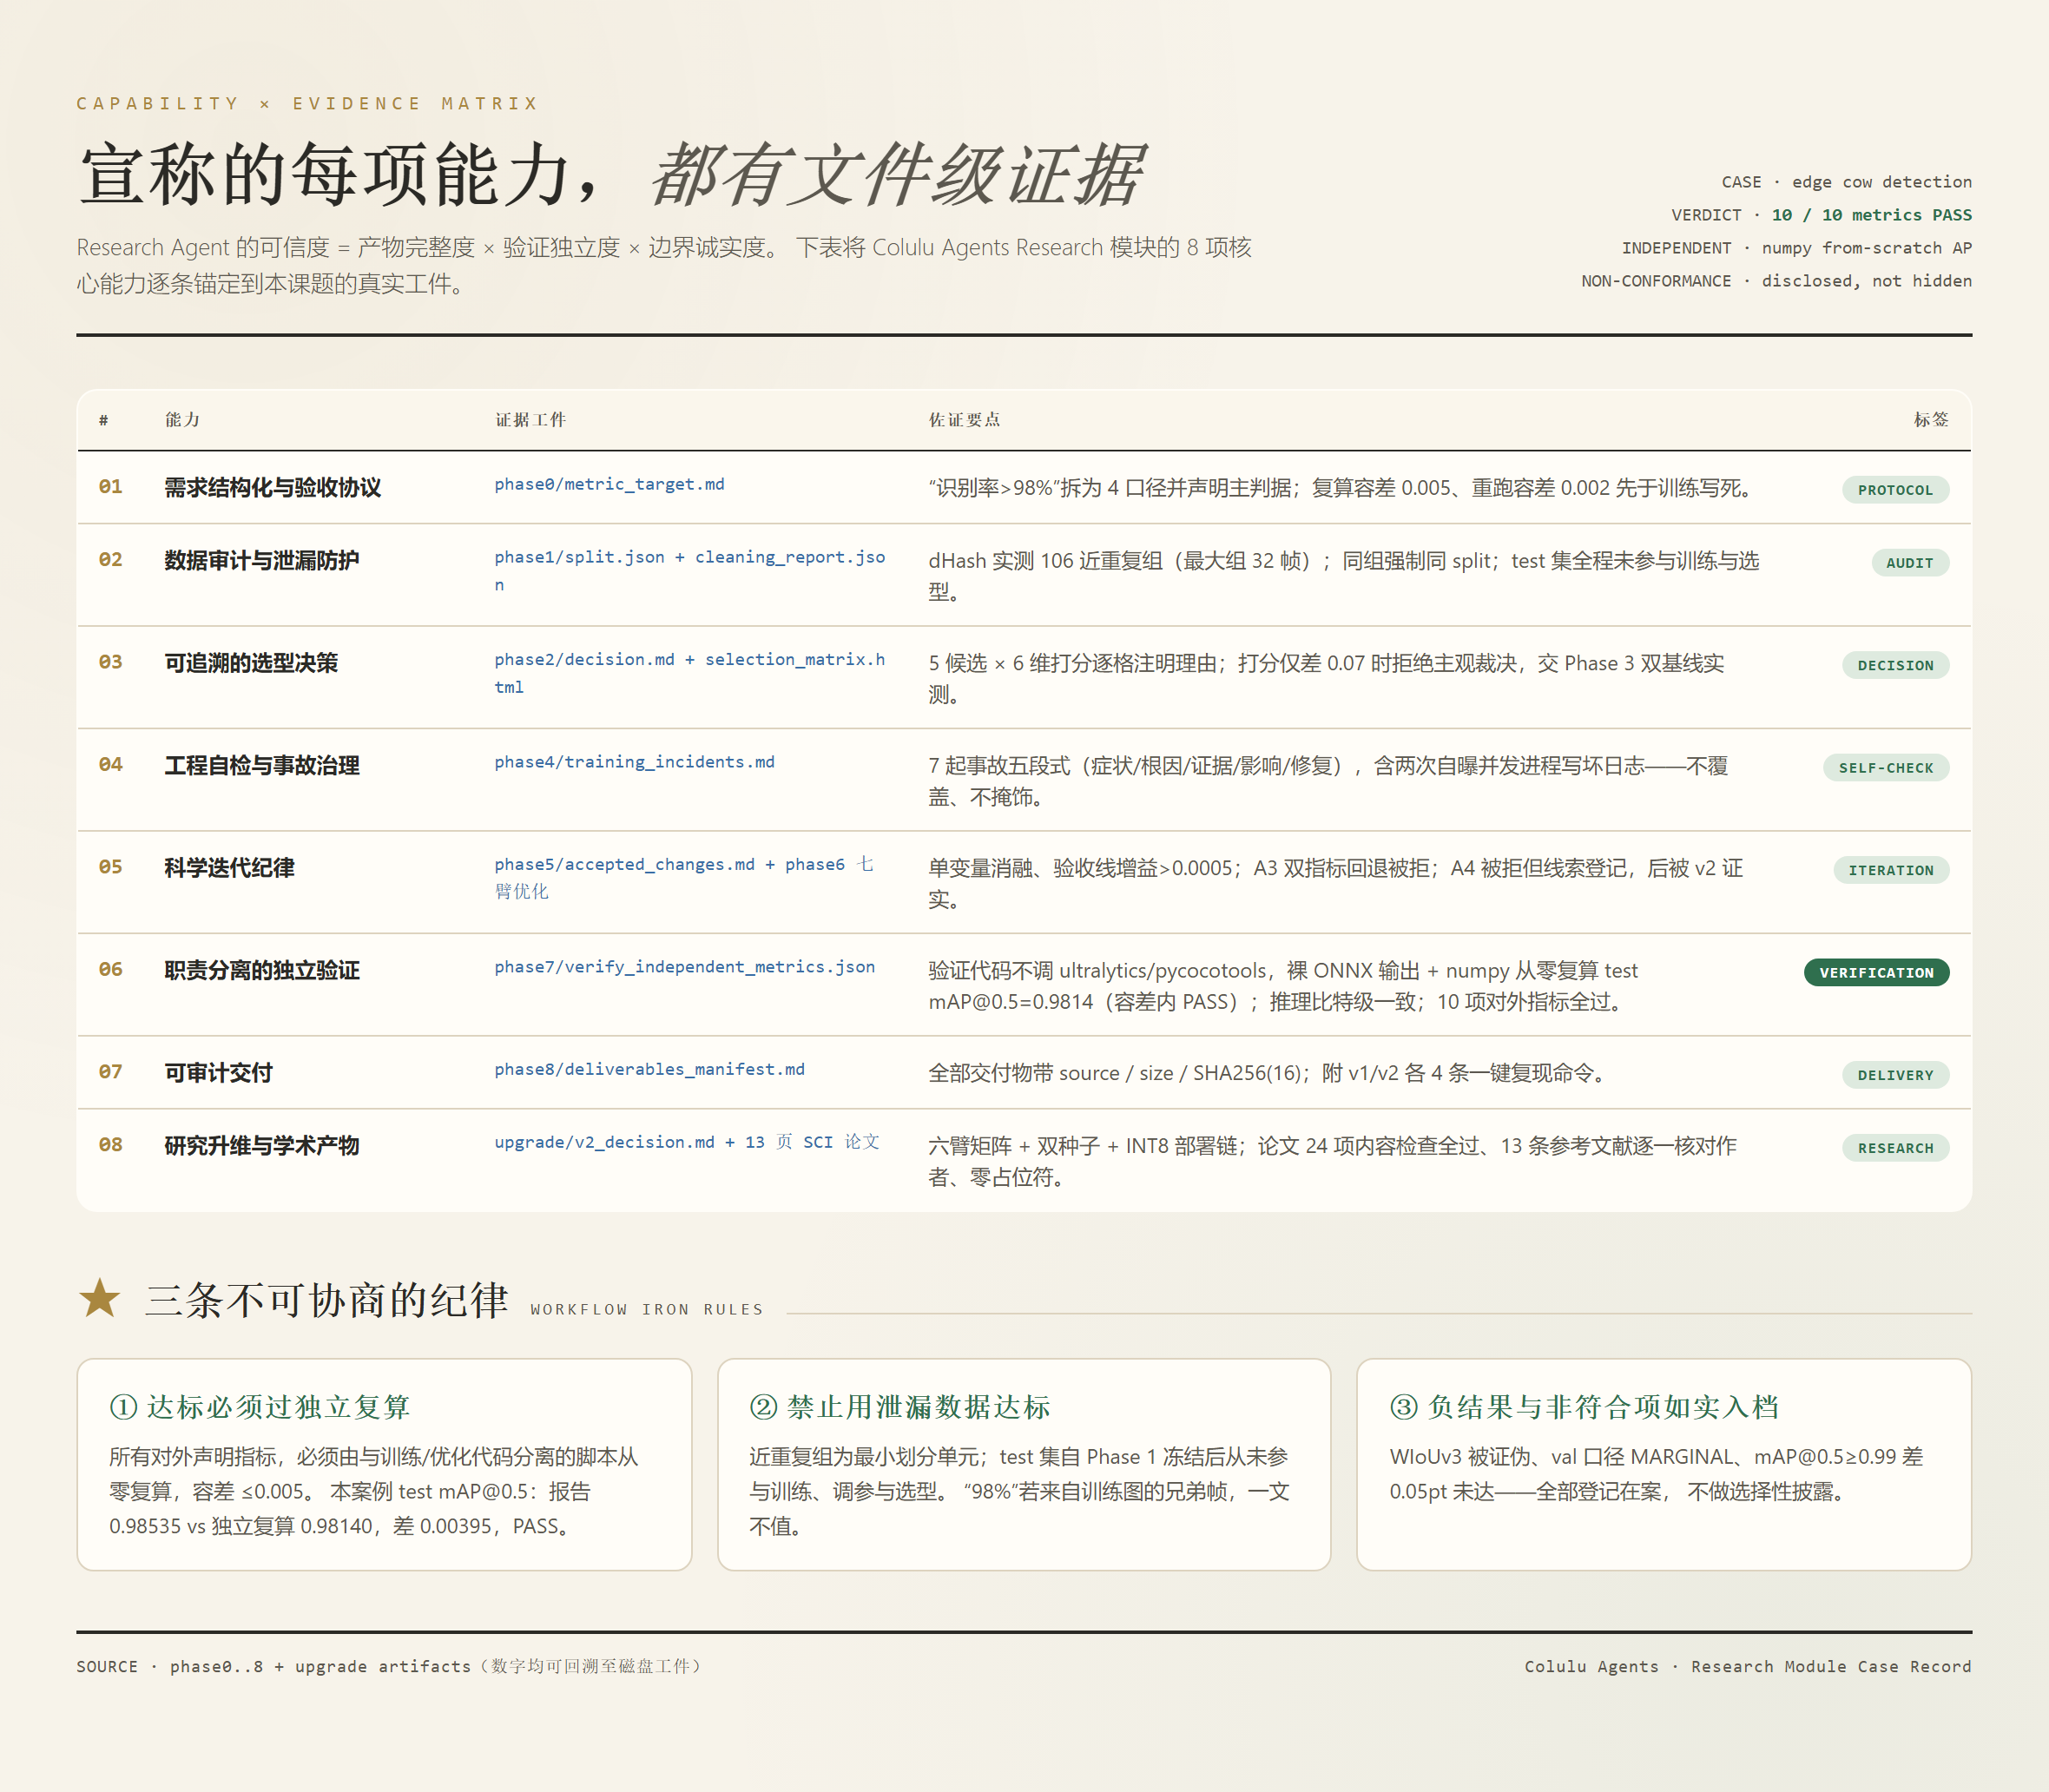
图 :能力---证据对照矩阵(生成源:blog/infographic/gen_blog_figs.py;含 v2 阶段新增的"诊断驱动研究"与"学术产出"条目)。
| # | 能力主张 | 证据锚点 |
|---|---|---|
| 01 | 需求→协议的口径治理 | phase0/metric_target.md(四口径+容差 0.005+禁近重复铁律) |
| 02 | 数据风险的先行探测 | phase0/domain_decision.md(dHash 106 组/32 张最大组)→ phase1/split.json(组级防泄漏) |
| 03 | 约束下的选型裁决 | phase2/decision.md + 打分矩阵(0.07 分差并列说明) |
| 04 | 过程异常的制度化治理 | phase4/training_incidents.md(7 起,四栏登记) |
| 05 | 单变量消融的负结果价值 | A2/A3(epoch/容量反向教训)→ 阶段二 S3/WIoUv3 证伪 |
| 06 | 优化与验证的职责分离 | phase7/independent_*.py(不依赖训练侧代码;10/10 PASS + MARGINAL 如实) |
| 07 | 交付的可审计性 | phase8/deliverables_manifest.md(逐文件 SHA256 + 复现命令) |
| 08 | 诊断驱动的机制研究 | 论文 §4.1 误差分析(per-IoU 崩塌 + 22/30 过检)→ 六臂矩阵归因 |
| 09 | 学术产出与开放复现 | 论文 13 页/9 图/5 表/13 文献;Data Availability 哈希声明 |
14. 讨论:AI4S 实践的可行性、约束性与未来
14.1 可行性:这个课题证明了什么
一句话版本:可信度 = 产物完整度 × 验证独立度 × 边界诚实度------三项都是乘法,任何一项归零,整体归零。
- 两阶段闭环是可复制的。阶段一用九道门把"从零到 0.9854 达标交付"压缩到两天内完成;阶段二用"诊断先行 + 单变量矩阵 + 论文收口"把"提升一个档次"的模糊需求推进到 +1.56pt(test)/ +3.03pt(val)的可归因增量。两阶段共享同一套协议底座(Phase 1 的防泄漏划分、Phase 7 的独立验证思想),不是两次独立的冒险。
- 小样本 CPU 协议是可行的,但必须协议先行。200 张图、2538 框、纯 CPU------98% 的达成没有靠任何"黑魔法",靠的是防泄漏划分(挡住近重复)、单变量消融(挡住无效堆叠)、独立复算(挡住自说自话)。
- 错误治理与负结果本身就是产出。7 起事故登记、WIoUv3 证伪、INT8 动态量化失败------这些"不成功"的记录,价值不亚于 +3.03pt:它们划出了边界,让后来者不必重走。
14.2 约束性:哪些不是它能证明的
- 数据域的约束。这是单类、近景、牛棚场景的检测。"98%"不迁移到多类别、迁移学习或开放世界检测------论文的结论边界写得很清楚:这是 single-class、fully measured、CPU-bounded 的案例,不是通用目标检测的性能声明。
- 粒度的约束。头级(head-level)检测不等于个体识别。计数、密度、粗略定位------这些任务够用;个体身份、行为分析是另一个问题。
- 算力与工具链的约束。全课题在 i7-12700 上完成,没有 GPU 加速;INT8 的成功依赖 OpenVINO 静态校准这一条特定技术路径,换运行时需要重做量化实验(§10 的教训)。
- v2 验证范围的约束。独立评估器未移植到 OpenVINO 路径,v2 的绝对值系 validator 派生(§11 已如实声明)。v2 的 +1.56pt/test 增量是可信的(双种子 + 协议一致),但它的绝对水平(0.71690)缺一层阶段 7 式的交叉验证------这是阶段三应当补上的第一步。
- 人机分工的边界 。Agent 负责协议治理、训练执行、误差分析、验证、交付;领域判断("这是什么数据、要什么指标")来自人类需求方,资源供给(CPU 环境、数据集部署)来自人类操作方。Agent 不是替代研究者,而是把研究规程的执行成本降到接近零。
- 工作流的自我缺口。TIPS3 登记的"图像AI领域 Skill 尚未落地"仍在------本课题的领域知识沉淀在 Phase 0--8 的工件里,还没有回流成平台级的可复用 Skill。这是平台下一步该做的事。
14.3 展望:三个纵深
- 课题纵深 :S5 精调步的 30ep 疑似未收敛(残留 +0.2~0.4pt,
v2_decision.md),双种子复跑与更长精调是最低成本的增量;INT8 校准集可从 50 张扩到全 val 集;独立评估器移植 OpenVINO 是阶段三的第一优先级。 - 平台纵深:把本课题的 Phase 0--8 工件模板化为 ImageAI 领域 Skill(补上 TIPS3 登记的缺口),让下一个图像课题从第一天就继承 7 起事故的教训、6 负结果的先验、和一套开箱即用的误差分析工具。
- 方法论纵深:两阶段的接力结构(协议底座共享、诊断驱动升级、论文收口)可以推广到更多 AI4S 课题------姊妹篇的材料吸附课题验证了"决策门 + 证据沉淀",本课题验证了"诊断驱动 + 独立验证 + 学术产出"。两套规程的叠加,才是平台意义上的"研发操作系统"。
尾注:工件路径与图集再生
本文所有数字可回溯至以下工件根目录:
- 阶段一:
work/ai4s_output/phase0--phase8/(协议、划分、消融、事故、验证、交付清单) - 阶段二:
work/ai4s_output/upgrade/(六臂矩阵、误差分析、INT8 校准、最终权重) - 论文:
work/ai4s_output/paper/(v2_upgrade_study_paper.pdf、build_paper.py、gen_figs_paper.py、figs/) - 交付快照(2026-10-09,哈希有效,未被本博客修改):
work/final_files/
阶段二引用的 9 张论文图已复制至 blog/figures/paper/;三张信息图的 HTML+PNG 双格式与生成源在 blog/infographic/。论文图与 PDF 的一键重生成命令见第 12 节代码块。