一、引言
传统数据湖常以 HDFS、S3、OSS 等文件系统或对象存储为底座,通过 Parquet、ORC、Avro 等列式文件承载数据。这类架构成本低、容量大、生态开放,但在实时更新、主键去重、CDC 入湖、增量消费、小文件治理、快照一致性等方面天然不足。
实时数仓过去常见做法是:Kafka 承载实时流,Flink 做计算,结果写入 OLAP 引擎或 KV 存储;离线侧再写入 Hive、Iceberg、Hudi、Delta Lake 等湖仓表。这样虽然能满足部分实时分析,但通常会形成两套链路:一套实时链路,一套离线链路。
Apache Paimon 试图把这两类需求收敛到统一的湖存储表中。它是一个支持流批处理的数据湖格式,可用于基于 Flink 和 Spark 的实时湖仓架构,并通过结合 Lake Format 与 LSM Tree 把实时流式更新带入数据湖。
二、Paimon 是什么
Apache Paimon 是一种湖格式或湖存储表格式。一个 Paimon 表可以描述为由 Schema、快照历史以及快照引用的文件共同组成;读表时,读取器会选择某个快照,再通过 Manifest 找到当前表状态所需的数据文件。
Paimon 的表主要可以分为两类:
| 表类型 | 逻辑行为 | 典型场景 | 说明 |
|---|---|---|---|
| Append Table | 不按主键合并,写入行会作为新记录保存 | 日志、明细事件、批量数据集 | 没有主键,插入不会进行基于主键的去重或 Upsert |
| Primary-Key Table | 相同主键记录会按 Merge Engine 合并为逻辑行 | CDC、Upsert、实体状态更新 | 维护每个 key 一条逻辑记录,物理上可保留多个版本直到读取或 Compaction 合并 |
Append Table 更像传统追加型数据湖表,而 Primary-Key Table 是 Paimon 支撑实时更新湖仓的核心。
三、Paimon 的整体架构
Paimon 位于计算引擎与底层存储之间。上层可以由 Flink、Spark、Hive、Trino、StarRocks、Doris 等引擎访问;中间通过 Catalog 管理数据库、表与元数据;底层数据文件与元数据文件存储在 HDFS、对象存储或其他文件系统中。
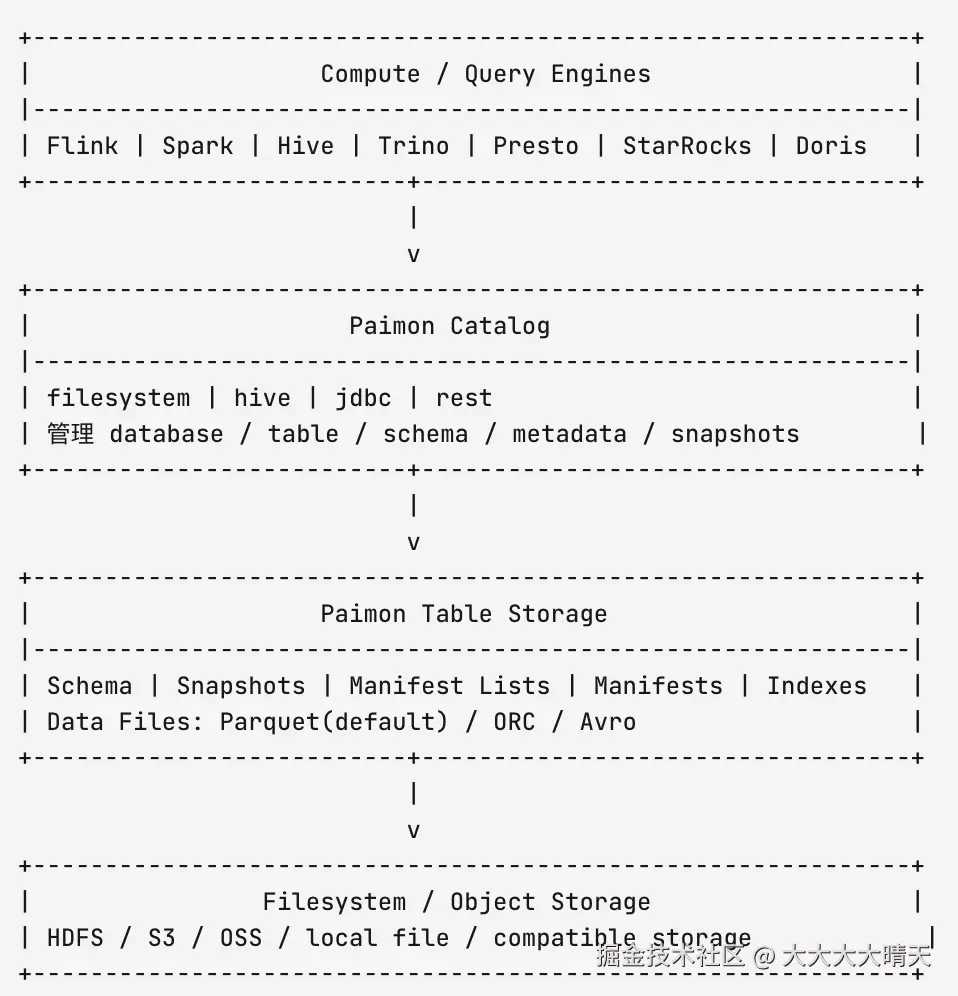
Paimon 的读写一致性依赖快照,Snapshot 捕获一次已提交的表状态;一个 Snapshot 会引用 Schema、Manifest List,以及可选的 Changelog 和 Index 元数据。
读一个 Paimon 表,大致过程如下:
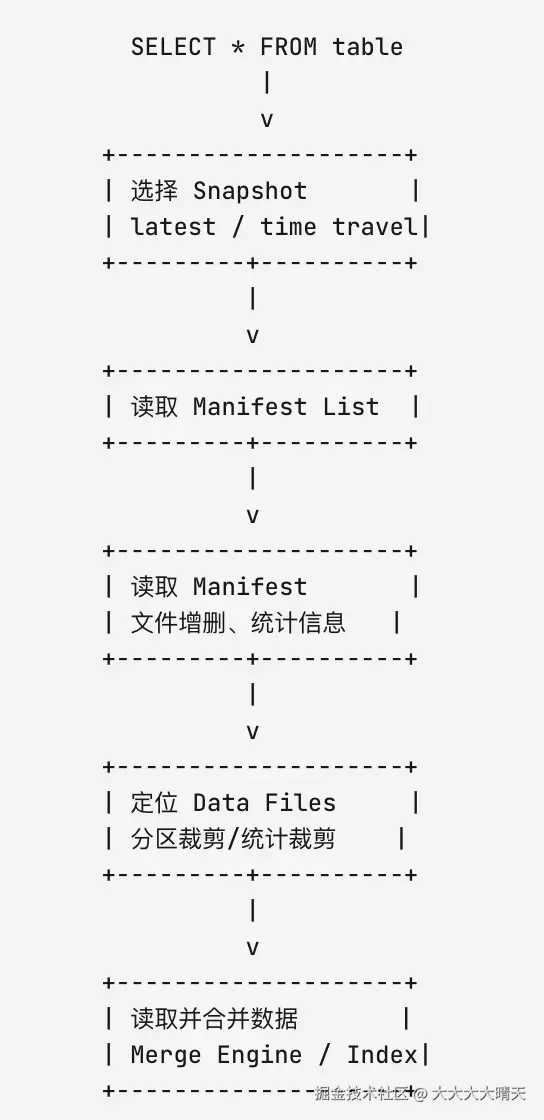
这种设计的好处是:文件是否存在于存储中,并不直接等于文件属于当前表状态。一个文件只有被已提交快照引用时,才对该快照的用户可见;用户看到的是已提交快照中的文件集合,而不是部分发布的文件。
Paimon 表通常包含以下核心元数据结构:
| 组件 | 作用 |
|---|---|
| Schema | 定义字段、类型、分区、主键、表选项 |
| Snapshot | 一次提交后的表状态 |
| Manifest List | 记录一批 Manifest 文件及其统计信息 |
| Manifest | 记录数据文件的新增、删除、行数、统计信息等 |
| Data File | 存放真实数据,默认格式为 Parquet |
| Changelog File | 在配置 Changelog Producer 时,服务增量读 |
| Index File | 存放动态桶索引、删除向量等索引信息 |
四、核心原理:LSM 与主键表
实时更新数据进入湖仓时,一个绕不开的问题是:数据湖底层文件通常不可原地更新。如果每次更新都重写大文件,写入成本太高;如果只追加新文件,查询时又必须知道哪条记录是最新状态。
Paimon 的 Primary-Key Table 使用 LSM Tree 思路(类似HBase写入模型)解决这个问题。Paimon 将主键数据存储在 LSM Tree 中,Writer 缓冲记录、排序并刷写新文件,Compaction 再合并文件以降低后续读取成本。
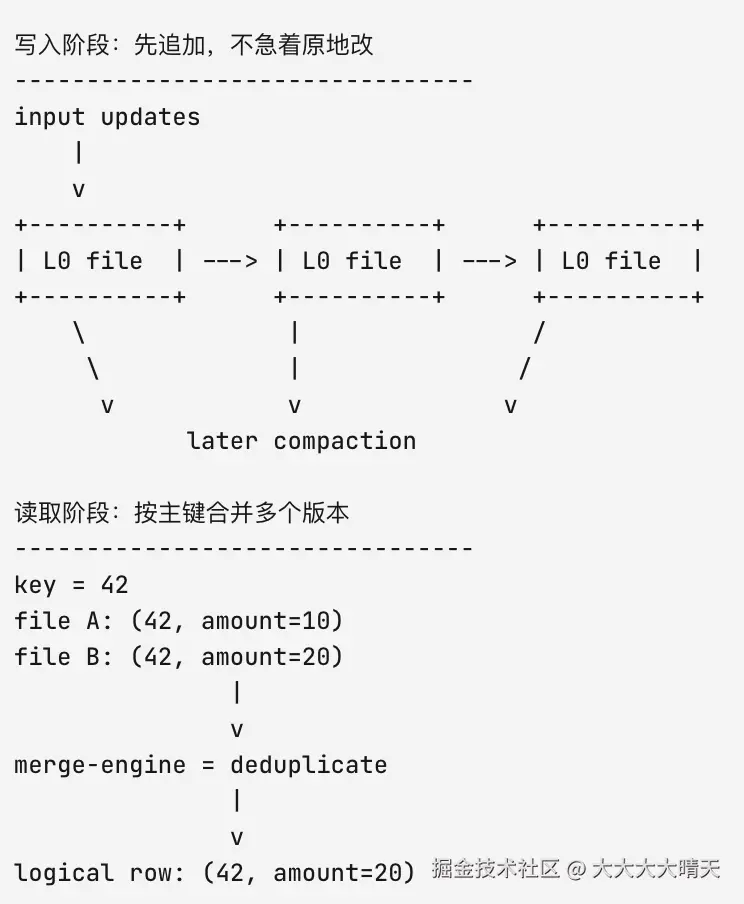
也就是说,Paimon 接受"物理上短期存在多个版本",通过读取合并与后台 Compaction 获得逻辑上的最新表状态。
在 Primary-Key Table 中,表或每个分区包含多个 Bucket,每个 Bucket 有自己的 LSM Tree。固定桶模式下,Paimon 会根据bucket-key 的 Hash 选择桶;如果没有设置bucket-key ,通常使用主键列,排除分区列。
rust
Primary-Key Table
└── partition dt=2026-09-20
    ├── bucket-0  -> LSM Tree -> data files
    ├── bucket-1  -> LSM Tree -> data files
    ├── bucket-2  -> LSM Tree -> data files
    └── bucket-3  -> LSM Tree -> data files
Bucket 会影响写入分布、读并行度、小文件数量与 Compaction 压力。它不是一个简单的"越多越好"的参数:桶太少会限制并行度,桶太多会放大小文件和元数据开销。
五、Merge Engine:Paimon 更新语义的核心
Paimon 的 Primary-Key Table 通过 Merge Engine 定义相同主键记录如何形成一条逻辑行,目前主要有四类Merge Engine。
| Merge Engine | 语义 | 典型输入 | 适用场景 |
|---|---|---|---|
| deduplicate | 保留最新记录,默认模式 | 完整更新行,如 CDC after image | 订单状态、用户资料、维表同步 |
| partial-update | 用非空字段更新已有行 | 不同流更新实体的不同字段 | 用户画像多流拼宽表 |
| aggregation | 对同主键字段做聚合 | sum、max 等贡献型数据 | 指标预聚合、实时汇总 |
| first-row | 保留第一条,忽略后续同 key 数据 | 去重事件流 | 首次访问、首单、首次曝光 |
一个容易踩坑的点是,"最新"不一定等于"业务时间最新"。如果到达顺序不代表业务顺序,应配置sequence.field ;对于 partial update 的独立流,还可以使用列级 sequence group。
ini
业务事件乱序示例
------------------------------------
event_time=10:00  amount=100   晚到
event_time=10:05  amount=120   先到

如果只按到达顺序:
    可能错误地让 10:00 覆盖 10:05

应使用:
    'sequence.field' = 'event_time'
六、Changelog:让下游理解变化
实时链路不只关心"当前表是什么样",还关心"表发生了什么变化"。Paimon 的changelog-producer 控制流式消费者可以获得哪些变化。它与 Merge Engine 不同:Merge Engine 定义表内逻辑行,Changelog Producer 定义流式消费者能收到什么变更。
| Producer | 旧值来源 | 适用场景 |
|---|---|---|
| none | 消费者自行维护状态或接受 Upsert | 下游是 Upsert Sink,或可自行 Normalize |
| input | 上游输入本身提供完整 changelog | 数据库 CDC 已有 before/after |
| lookup | Compaction 时查找旧值生成 changelog | 输入没有 before image,但下游需要完整变更 |
| full-compaction | 比较两次全量 Compaction 结果 | 可接受周期性延迟的变更输出 |
可以这样理解:
sql
                Paimon Table State
                       ^
                       |
          +------------+-------------+
          |                          |
    Merge Engine              Changelog Producer
决定"表里最终是什么" 决定"下游看到什么变化"对于需要做下游聚合的场景,是否能拿到UPDATE_BEFORE 、UPDATE_AFTER 、DELETE 非常关键。例如金额从 4 变成 5,下游 sum 需要先减 4 再加 5;如果只拿到 5,就必须由消费者自己记住旧值。
七、Paimon 的功能特性与优势
- 批流一体:Paimon 支持批处理和流处理,这使得一份数据可以同时服务实时链路和离线分析链路,减少 Kafka、OLAP、Hive 多份冗余数据之间的一致性维护成本。
lua
Flink Streaming Write
        |
        v
   Paimon Snapshot N
        |
        +------------------> Batch Query: 读取某个快照
        |
+------------------> Streaming Query: 继续跟踪后续变化- 支持主键更新与 CDC 入湖:Primary-Key Table 是 Paimon 的关键能力。它可以维护每个主键一条逻辑行,并让输入记录按 Merge Engine 插入、更新或删除该行。这对 CDC 入湖非常重要。
- 快照、时间旅行与一致性读取:Paimon 使用 Snapshot 捕获已提交的表状态;较早快照仍可能引用已被后续快照替换的数据文件,因此时间旅行依赖快照和对应文件仍被保留。
rust
snapshot-1  -> 昨天 10:00 表状态
snapshot-2  -> 昨天 11:00 表状态
snapshot-3  -> 昨天 12:00 表状态

查询 current:
    使用 snapshot-3

问题回溯:
指定 snapshot-1 或某个时间点- 多 Catalog 与多引擎生态:Paimon Catalog 负责组织数据库、表和元数据,支持
filesystem、hive、jdbc、rest等 Metastore 选择:filesystem 适合无外部元服务的简单搭建,Hive Catalog 适合和 Hive 兼容工具共享元数据,JDBC Catalog 适合用关系数据库管理元数据,REST Catalog 适合远程 Catalog 服务与认证场景。
yaml
Catalog 选择参考
------------------------------------------------
filesystem : 快速开始、测试、轻量环境
hive       : Hive 生态共享
jdbc       : MySQL/PostgreSQL 等数据库管理元数据
rest : 服务化 Catalog、统一鉴权、远程访问- 查询优化与文件治理:Paimon 支持分区裁剪、文件统计信息、索引、Compaction 等能力。Append Table 文档提到,聚合下推可在部分聚合查询中使用元数据避免读取所有数据行,排序与文件统计可缩小文件值域并改进裁剪,文件索引支持 Bloom filter、bitmap、range bitmap 等过滤能力。这些能力的目标都是减少扫描数据量、降低小文件影响、提升查询规划与执行效率。
八、适用场景
- CDC 实时入湖:业务库 CDC 入湖、实体表需要 Upsert等。
- 实时数仓分层:Paimon 可以承载 ODS、DWD、DWS 等实时分层。上游 Flink 写入 ODS,后续 Flink 继续读取 Paimon Changelog 做清洗、关联、聚合,再写回 DWD 或 DWS。适合希望统一实时与离线链路、减少中间存储复制的团队。
- 用户画像与宽表构建:用户画像常由多个来源更新不同字段:基础资料、行为偏好、会员等级、风控标签、营销标签等。此时
partial-update很有价值,因为它允许用非空字段更新已有行,而不是要求每条记录都携带完整宽表字段。 - 明细日志与大规模 Append 数据:对于日志、埋点、交易流水、监控指标原始明细等只追加、不按主键更新的数据,Append Table 更合适。
- 湖仓统一查询层:Paimon 可以被多种引擎访问,支持Flink、Spark、Hive、Trino、StarRocks、Doris 等集成方式,在多引擎共享生产表时,需要先确认所用引擎是否支持目标表特性。
九、部署使用
- 准备 Connector:下载与计算引擎版本匹配的 Paimon Connector。
- 创建 Catalog。
ini
CREATE CATALOG my_catalog WITH (
    'type' = 'paimon',
    'warehouse' = 'file:/tmp/paimon'
);

USE CATALOG my_catalog;
如果是 HDFS、S3、OSS 等环境,需要把warehouse 替换为相应路径,并配置对应文件系统访问参数。Catalog 也可以选择filesystem 、hive 、jdbc 、rest 等不同 Metastore。
- 创建主键表。
sql
CREATE TABLE orders (
    order_id BIGINT,
    customer_id BIGINT,
    amount DECIMAL(12, 2),
    status STRING,
    update_time TIMESTAMP,
    PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
    'bucket' = '4',
    'merge-engine' = 'deduplicate',
    'sequence.field' = 'update_time'
);- 写入数据。
sql
INSERT INTO orders VALUES
(1, 1001, 99.90, 'CREATED', TIMESTAMP '2026-09-20 10:00:00');

INSERT INTO orders VALUES
(1, 1001, 109.90, 'PAID', TIMESTAMP '2026-09-20 10:05:00');- 查询数据。
sql
//查询结果应保留 order_id = 1 的最新逻辑状态
SELECT * FROM orders WHERE order_id = 1 ;

+----------+-------------+--------+--------+---------------------+
| order_id | customer_id | amount | status | update_time          |
+----------+-------------+--------+--------+---------------------+
| 1        | 1001        | 109.90 | PAID   | 2026-09-20 10:05:00 |
+----------+-------------+--------+--------+---------------------+- 创建 Append Table。
sql
CREATE TABLE user_events (
    user_id BIGINT,
    event_type STRING,
    event_time TIMESTAMP,
    dt STRING
) PARTITIONED BY (dt) WITH (
    'bucket' = '-1'
);
十、与其他湖格式的关系
Paimon 与 Iceberg、Hudi、Delta Lake 都属于湖仓表格式方向,但它的特色在于更强调流式更新、主键表、LSM、Changelog 与 Flink 实时处理的结合,Paimon 通过结合 Lake Format 与 LSM Tree,把实时流式更新带入数据湖架构。
一个不严谨但便于理解的类比是:
markdown
Iceberg / Delta / Hudi:
    更常被理解为通用湖仓表格式,强调快照、事务、演进、查询优化等能力

Paimon:
    同样具备湖仓表能力,但更突出流式写入、主键更新、LSM、Changelog 和实时湖仓
十一、常见问题与建议
1.为什么查询结果不是刚写入就可见?
在 Flink 流式写入中,数据通常需要随 checkpoint 提交为 Paimon Snapshot 后才对读者可见。
2.deduplicate 与partial-update 怎么选?
如果每条更新都是完整行,使用deduplicate 更简单。如果每条更新只包含部分列,且空值表示"不更新该字段",则应考虑partial-update 。
3.是否一定要配置 Changelog Producer?
不一定。默认changelog-producer = none 不写单独完整 changelog,适合下游接受 Upsert 或自行维护状态的场景。但如果下游需要完整 before/after 语义,例如做撤回式聚合,则需要评估input 、lookup 或full-compaction。
4.多 Writer 写同一张表安全吗?
Paimon 使用乐观并发控制。Writer 会独立准备文件,再基于最新已提交 Snapshot 验证并原子发布;如果其他 Writer 先提交,则需要基于新状态重试,若文件冲突则提交会被拒绝。建议:尽量让不同 Writer 写不同分区,对 Compaction 使用独立作业,降低多个 Writer 同时重写相同文件的冲突。
5.Bucket 数怎么设置?
Bucket 数会影响写入并行度、读取并行度、小文件数量和 Compaction 负担。置得过大,导致小文件和元数据压力上升;设置太小,则可能限制吞吐和并行读取。
markdown
数据量小 / 入门测试:
    使用较小固定 bucket,例如 1、2、4

稳定大表 / 高吞吐写入:
    结合主键分布、写入并行度、文件大小、Compaction 压力压测

分区差异大 / 数据增长不可预测:
    评估动态 bucket 或 postpone bucket,但需确认版本与引擎支持
6.查询慢通常从哪里排查?
| 现象 | 可能原因 | 排查建议 |
|---|---|---|
| 查询规划慢 | Manifest 过多、小文件多 | 检查 Compaction、Manifest 合并 |
| 扫描数据多 | 分区设计不合理、统计信息不足 | 优化分区、排序、文件统计、索引 |
| 主键表读慢 | LSM 层级多、Compaction 不及时 | 调整 Compaction 参数 |
| 流式消费延迟高 | Changelog 生成方式成本高 | 评估 lookup、full-compaction 延迟与资源 |
| 多 Writer 失败 | Snapshot 或文件冲突 | 检查写入分区、锁、独立 Compaction |