一次推理的完整旅程:从12K底座到三轮ReAct的答案
本文回答一个连着的三连问:模型收到一堆 token 之后到底做了什么?为什么回答一个问题要「推理」好几轮?业界除了这种循环还有哪些打法? 三个问题分别对应三张图:单次推理的内部解剖(图 1)、ReAct 循环的三幕剧(图 2)、六大范式全景(图 3)。 所有数字来自 heart-net(个人知识引擎,AgentScope Java 框架 + DashScope qwen3.8-omni-flash)的真实实测,不是示意图上的示意值。
§0 引子:一个问题问了 46 秒
我在对话页问了一个 Java 并发容器(ConcurrentHashMap)读写并发原理的问题,从按下回车到答案完整出现,一共 46 秒 。服务端日志显示:这件事不是「一次模型调用」完成的,而是 3 轮推理、4 次知识库检索接力完成的------
| 轮次 | 耗时 | 模型在干什么 |
|---|---|---|
| 第 1 轮 | 5.1s | 读完问题,并行发出 2 路检索 |
| 第 2 轮 | 9.3s | 读完第 1 轮材料,发现还有 3 处没覆盖,再发 2 路检索 |
| 第 3 轮 | 25.2s | 判断材料够了,一口气写出 4,182 字答案 |
为什么第二轮?因为模型读了第一轮检索回来的材料后,自己发现了盲区。这是全篇最重要的一个直觉:多轮推理不是流程写死的,是模型看一步、想一步、自己决定要不要再查的。
这 46 秒里每一层都值得拆开看:单次推理内部发生了什么(§1)、循环怎么转起来的(§2)、每轮背上山的 12K token 底座里都装了什么(§3)、以及这种循环在业界范式版图上站在哪(§4)。
§1 一次推理的内部解剖
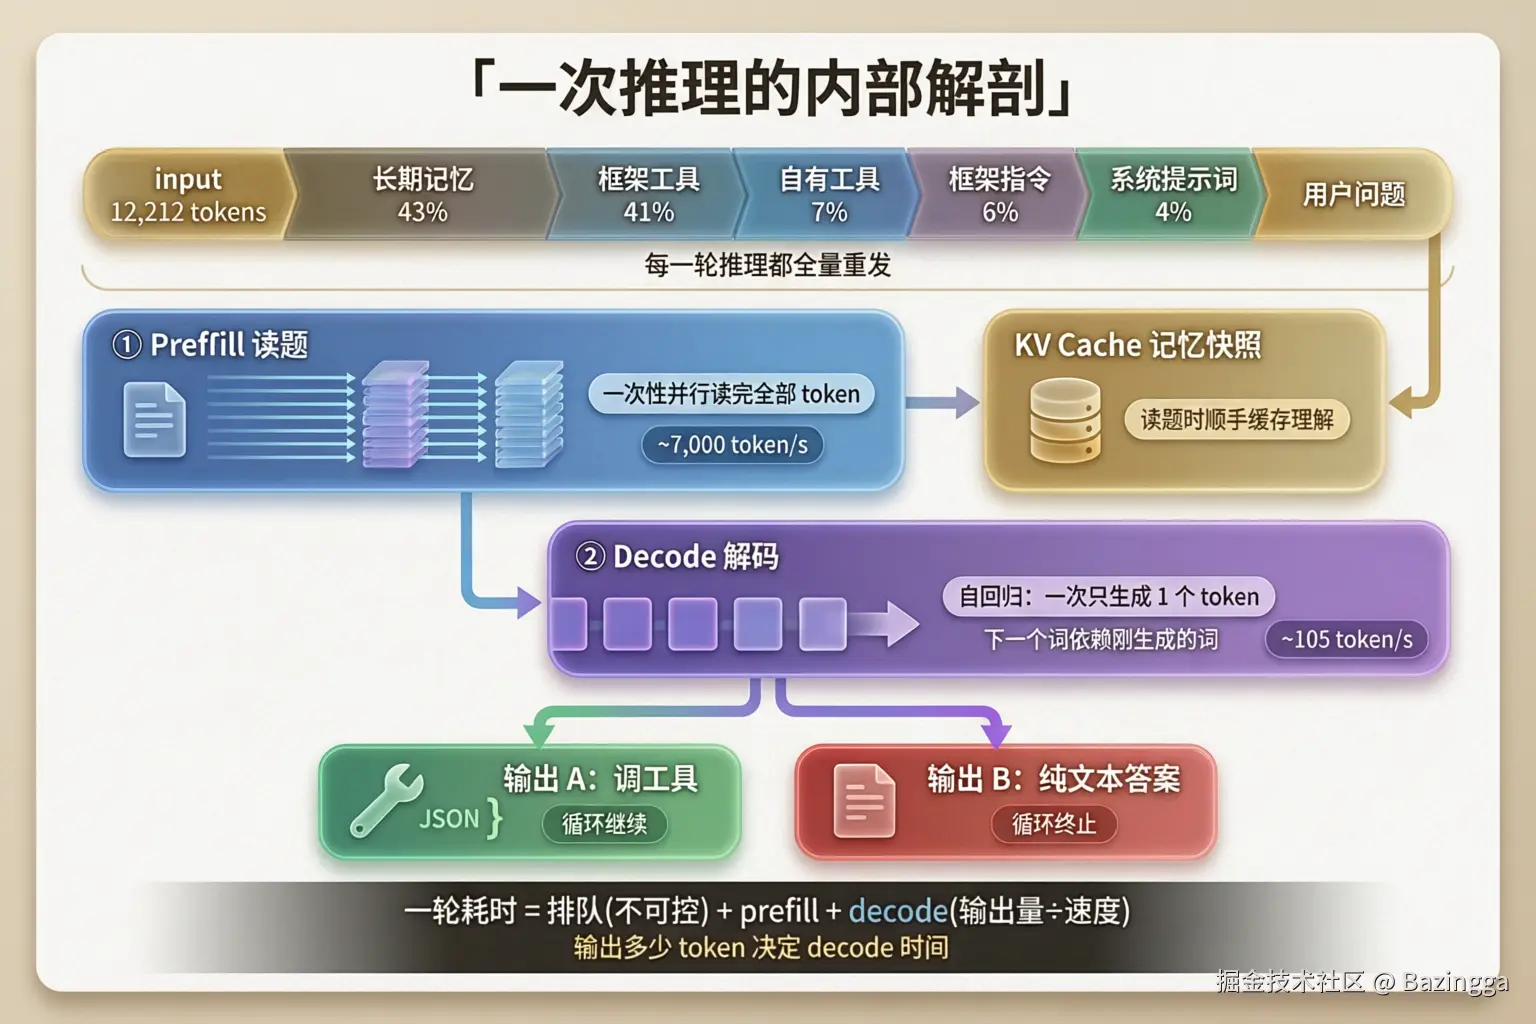
图 1:一轮推理的完整流水线------input 全量重发 → prefill 并行读题 → KV Cache 快照 → decode 自回归吐字 → 输出在「调工具」与「纯文本」之间二选一。
1.1 input:12,212 个 token 的隐形行李
实测方法很朴素:起一个全新会话,只发一句「你好」,从服务端日志抓这一轮请求的 input token 数------12,212。问题本身只有 2 个 token,剩下 12,210 个是什么?拆账如下:
| 构成 | 体量(约) | 占比 | 是什么 |
|---|---|---|---|
| 框架内置 22 个工具的 schema | 5,000 tok | 41% | AgentScope harness 自动追加的工具说明书 |
| 长期记忆(MEMORY.md 全文) | 5,200 tok | 42.6% | 15,404 字符的个人知识沉淀,每轮全量灌入 |
| 自有 9 个工具的 schema | 800 tok | 6.5% | 检索/账号/技术栈/文件等业务工具说明书 |
| harness 框架指令 | 700 tok | 6% | 框架教模型「怎么当一个 agent」的行为准则 |
| 系统提示词 | 480 tok | 4% | 1,400 字符的岗位说明书(职责边界、工具规则) |
| 用户问题「你好」 | 2 tok | ~0% | 真正的新信息 |
两个反直觉结论:
- 89% 的底座与当前问题无关------它是隐形行李,每一轮推理都全量重发一遍。
- 行李里最大两件都不是我们写的------框架工具说明书 + 框架自动加载的长期记忆,加起来 84%。这直接催生了后文的「框架税」概念(§3.3)。
一个容易忽略的物理事实:LLM 是无状态的。模型不记得上一轮说过什么,「记忆」是外部系统把历史对话重新塞进 input 实现的。所以循环每转一轮,案卷(对话历史)就厚一截,下一轮要背的 input 就更重------CHM 案例的案卷从 13.9K 涨到 20.2K token,就是这么滚起来的。
1.2 prefill 读题:一次并行读完
input 进模型后的第一阶段叫 prefill(预填充):把 12,212 个 token 一次性、并行地全部过一遍 Transformer 的几十层网络,算出每一层的 Key/Value 向量。类比:侦探到现场后不是从头到尾逐字读案卷,而是把整卷摊开、一眼扫全貌。
快是它的标签:实测这台多模态 flash 档模型约 7,000 token/s,12K 的底座 prefill 只要约 1.7 秒。
1.3 KV Cache:读题时顺手拍快照
prefill 顺手把每一层的 K/V 向量存进 KV Cache(缓存)------相当于读题时给案卷拍了快照。后面 decode 每生成一个新 token,不用回头重读整卷,直接查快照就行。
这也是「每轮全量重发」并不像听上去那么灾难的原因:轮内 KV cache 保证单次推理不重复计算;但跨轮的前缀缓存(让第 2 轮复用第 1 轮的快照)受缓存命中策略影响,实测 cachedTokens=0------每一轮都老老实实重新 prefill。这是目前挂账的优化点之一。
1.4 decode 解码:一次只吐一个字
第二阶段 decode(解码) 才是「生成答案」。它的物理约束严苛得多:自回归------一次只生成 1 个 token,而且下一个 token 依赖刚刚生成的那个,没法并行。
类比:prefill 是阅卷(可以十份卷子一起看),decode 是作文(只能一个字一个字往下写)。所以速度差两个数量级:实测约 105 token/s。
由此得到全文最重要的耗时公式:
一轮耗时 ≈ 排队(不可控)+ prefill(input 体量 ÷ 读速)+ decode(输出体量 ÷ 写速)
CHM 案例第 3 轮 25.2 秒为什么最慢?input 20.2K 只花约 3 秒 prefill,剩下的 22 秒几乎全在 decode------因为这一轮要输出 4,182 字的答案。输出量决定 decode 时间,这是慢问归因时第一个该看的地方。
1.5 输出的两种形态:分岔口
一轮推理的输出只有两种合法形态,这个分岔口就是 ReAct 循环的发动机:
| 输出形态 | 长什么样 | 框架怎么反应 | 循环走向 |
|---|---|---|---|
| 工具调用(tool_use) | 结构化指令:调哪个工具、什么参数 | 执行工具,把结果追加进案卷 | 继续------带着新材料再推理一轮 |
| 纯文本(text) | 人话答案 | 直接推给用户 | 终止 |
注意一轮推理 ≠ 一次工具调用:模型可以在同一轮里并行发出多个工具调用(CHM 第 1 轮就是两路检索同时发),框架会等全部结果回来再进入下一轮。
§2 ReAct 循环:为什么需要第二次推理
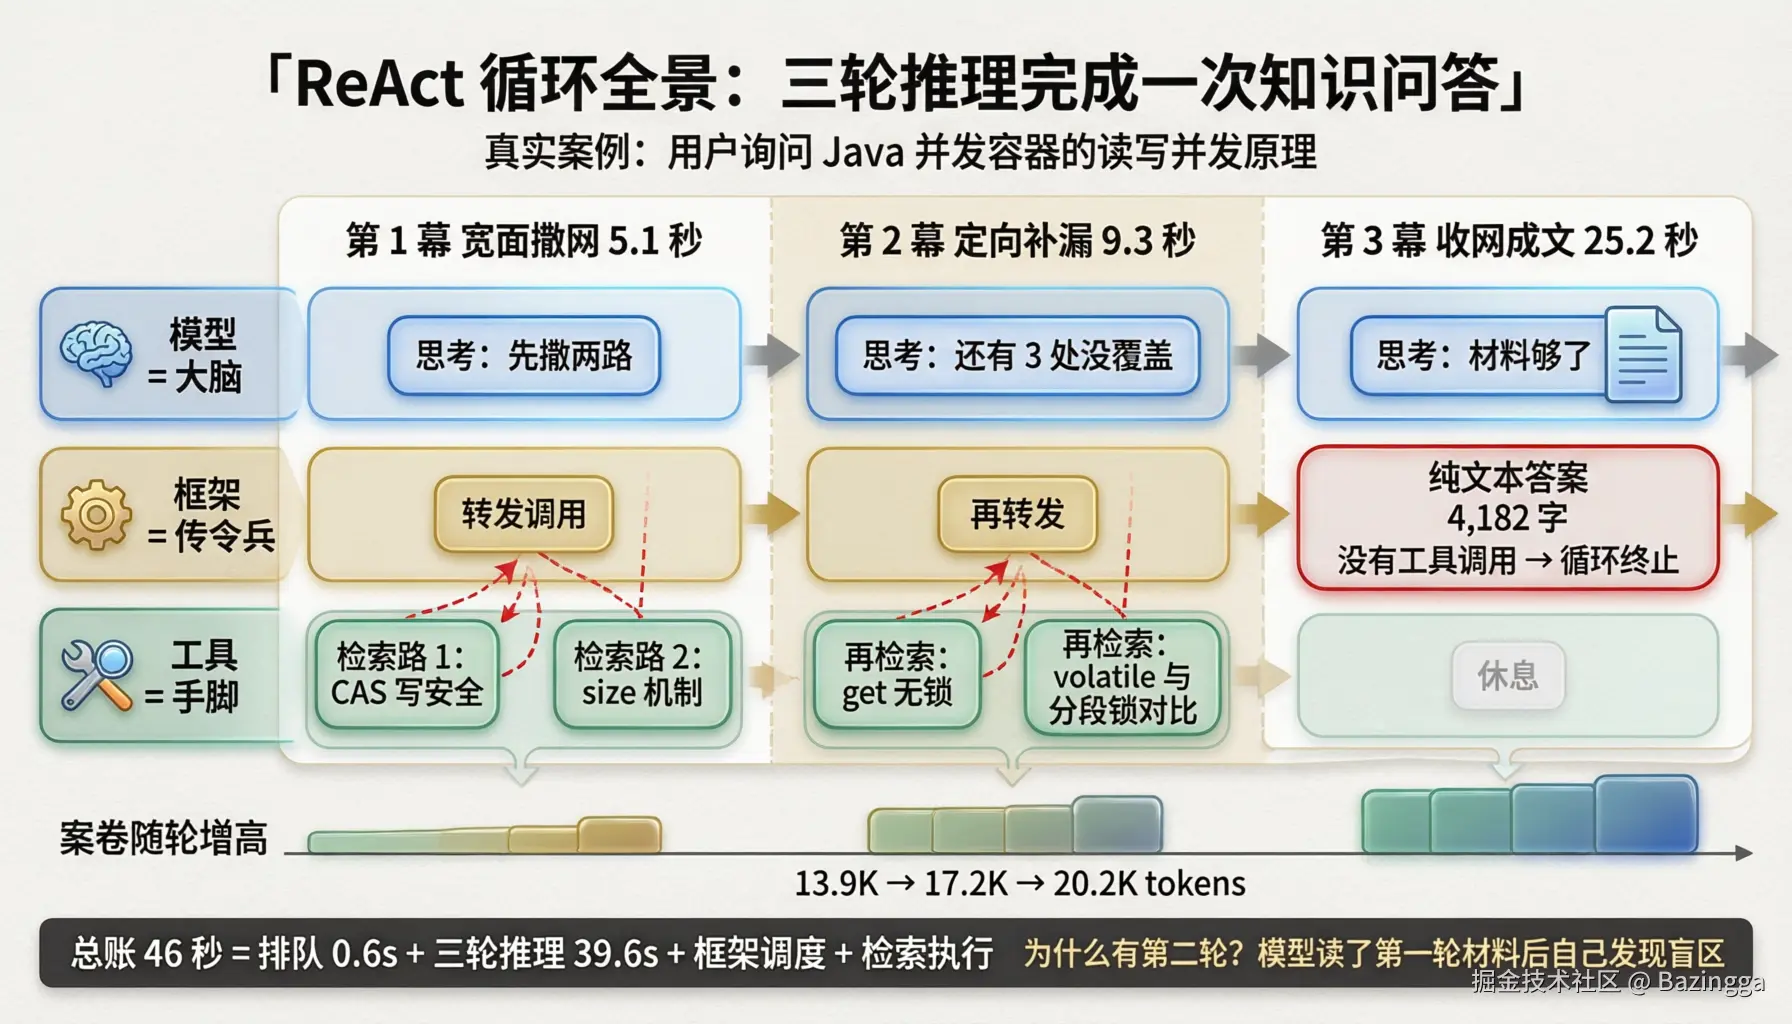
图 2:三泳道 × 三幕的真实轨迹------模型(大脑)负责想,框架(传令兵)负责转发与归档,工具(手脚)负责干活;红色虚线是检索结果回填案卷。
2.1 失忆侦探与案卷
把整套机制装进一个类比:LLM 是一位每次醒来都失忆的侦探 (无状态);外部系统给他一份案卷 (对话历史 + 系统指令 + 工具说明书,每轮全量重发);他有手脚 (工具:检索知识库、查账号、读文件);还有一个现场指挥系统(AgentScope 框架)负责传达指令、归档证据、决定何时收队。
「ReAct」= Rea son + Act:每一轮侦探先推理(thinking),再决定行动(调工具或不调);指挥系统看到纯文本结案陈词就收队。
2.2 三方分工
| 角色 | 职责 | 关键事实 |
|---|---|---|
| 模型(大脑) | 每轮决定:调什么工具、还是直接回答 | 决策完全由模型自主,框架不掺和 |
| 框架(传令兵) | 转发工具调用、执行工具、把结果归档进案卷 | 跑的就是一个 while 循环 |
| 工具(手脚) | 检索知识库、查询账号、读写文件 | heart-net 自有 9 个方法 + 框架内置 22 个 |
2.3 三幕剧走读(真实轨迹)
CHM 这一问的三幕,thinking 块是模型的第一人称侦察笔记(每轮都有,默认对用户隐藏):
第 1 幕 · 宽面撒网(5.1s)。thinking(779 字,节选):「用户要的是读写并发原理......先撒两路:CAS 写安全、size 机制。」------一次并行两路检索。
第 2 幕 · 定向补漏(9.3s)。读完第 1 轮材料,thinking(303 字)明说盲区:「get 无锁、volatile 与 JDK7 分段锁对比、弱一致性迭代器还没覆盖。」------于是再发 2 路精确制导的检索。
第 3 幕 · 收网成文(25.2s)。thinking(321 字):「材料够了,用户偏好详细解释加一页速记版。」------不再调工具,直接输出 4,182 字答案,循环终止。
第 2 幕是全案例最值得看的一眼:模型在轮与轮之间反思了自己的检索策略------这不是开发者编排的流程,是模型读了材料之后涌现出来的行为。ReAct 值钱就值钱在这里。
2.4 为什么需要第二次推理
因为第一轮的知识不完备,且模型自己知道。第 1 轮检索回来的材料只覆盖了两个侧面,模型读完发现缺口,把缺口变成新的检索词再查一轮。本质上:每一次工具结果都是新的证据,新证据让模型修正对「还缺什么」的判断。
2.5 什么时候不需要第二次推理
终止条件三种,按优先级:
- 模型判断上下文足够(CHM 第 3 轮)------输出纯文本,正常收网;
- 问题太简单不需要工具(「你好」那轮)------第 1 轮就直接纯文本;
- maxIters 兜底------配置里写着循环上限 20 轮,防止模型无限「再查一次」。
2.6 thinking 块的三个冷知识
- 计费:thinking 占 output token,按 decode 速度一个字一个字「想」出来,账单照收------第 3 轮 25 秒里有相当一部分花在 thinking 上。
- 留存:thinking 会留在案卷里跟着进下一轮,模型靠它恢复上一轮的思路(第 2 幕的「盲区清单」正是从第 1 轮 thinking 接续下来的)。
- 隐藏:thinking 默认不展示给用户,属于模型的草稿纸。执行轨迹面板(渲染 thinking/tool_args/tool_result/usage 四类帧)就是把这层黑盒打开的可观测性工程。
§3 数字侦探:12K 底座里都装了什么
图 1 的拆账表是怎么得出来的?这一节复整个盘------因为第一版估算错了两处,翻案过程比结论更有教学价值。
3.1 「6 个工具、10K schema」的疑问
初版图 1 标注了「6 个工具的 schema(~10K)」。追问随之而来:6 个工具是哪 6 个?为什么是 6?为什么值 10K?------顺着这三个问题查下去,发现「6」和「10K」都站不住。
3.2 四个视角的工具数字
同一个系统,「有几个工具」竟然有四个答案,每个都真实:
| 视角 | 数字 | 来源 |
|---|---|---|
| MCP 对外暴露 | 6 | 日志 Registered tools: 6(MCP server 端点注册数) |
| AgentScope 注册的工具对象 | 7 | Toolkit.registerTool() 调用 7 次 |
| 亲手写的工具方法 | 9 | tool 包 7 个类,其中 FileTools 类含 3 个方法 |
| 实际发给模型的 | 31 | 日志 Converted 31 tools to DashScope format |
3.3 框架税:每个回合 5,000 token
22 个内置工具的 schema 约 5,000 token,每一轮推理都随请求重发。CHM 案例跑了 3 轮,仅框架税就烧掉约 15,000 token------比问题本身、比检索回来的知识都贵得多。
「税」的另一面是「预付的升级零件」:这 22 个工具里躺着 plan-and-execute 的零件(todo_write)、orchestrator-workers 的零件(subagent 派生)。框架把范式升级的门票提前埋进了底座------你还没用上,但每轮都在交钱。AgentScope Toolkit 原生支持工具分组动态激活(ToolGroupManager,含 reset_equipped_tools 元工具),是砍掉这笔税的现成后门,已挂账待立项。
3.4 MEMORY.md:15,404 字符的长期记忆
底座里第二大件是 workspace 记忆文件 MEMORY.md------15,404 字符 ≈ 5,200 token,占底座 42.6%,由框架 MemoryFlushMiddleware 自动全量注入 system prompt 每轮重发。实测 system prompt 总长 19,512 字符 = 自写系统提示词 1,400 + MEMORY.md 15,404 + harness 框架指令约 2,708。
值得警惕的是它是底座里唯一会自己膨胀的部分:记忆蒸馏机制每天追加日记(单日 6 万字符量级),今天占 43%,明年呢?这是比框架税更长期的治理课题。
3.5 修正后的账本
初版「schema ~10K」实为约 5.8K(大头是框架 22 个工具而非自有工具);初版「MEMORY ~1.5K」实为 5.2K------总量歪打正着,构成全错。修正方法是无侵入实测:起临时实例 → 新会话发「你好」→ 从 DEBUG 日志抓 input tokens / system 长度 / tools 数量三个铁证 → 与静态字符数对账拆解。全程零代码改动完成取证。
3.6 「工具」与「技能」的三层辨析
「这跟 skills 有什么关系?」------三个同名不同物:
| 层 | 类比 | 形态 |
|---|---|---|
| Agent 工具 | 手(能做什么) | 代码注解方法,schema 随请求发给模型 |
| 知识库中 category='skill' 的内容 | 脑料(被检索的知识) | 知识库里的普通文档,只是打了个分类标签 |
| 框架 workspace 的 skills 目录 | 肌肉记忆(蒸馏出的行为模式) | Skill 文件按需加载触发,heart-net 未启用 |
§4 范式全景:ReAct 之外的世界
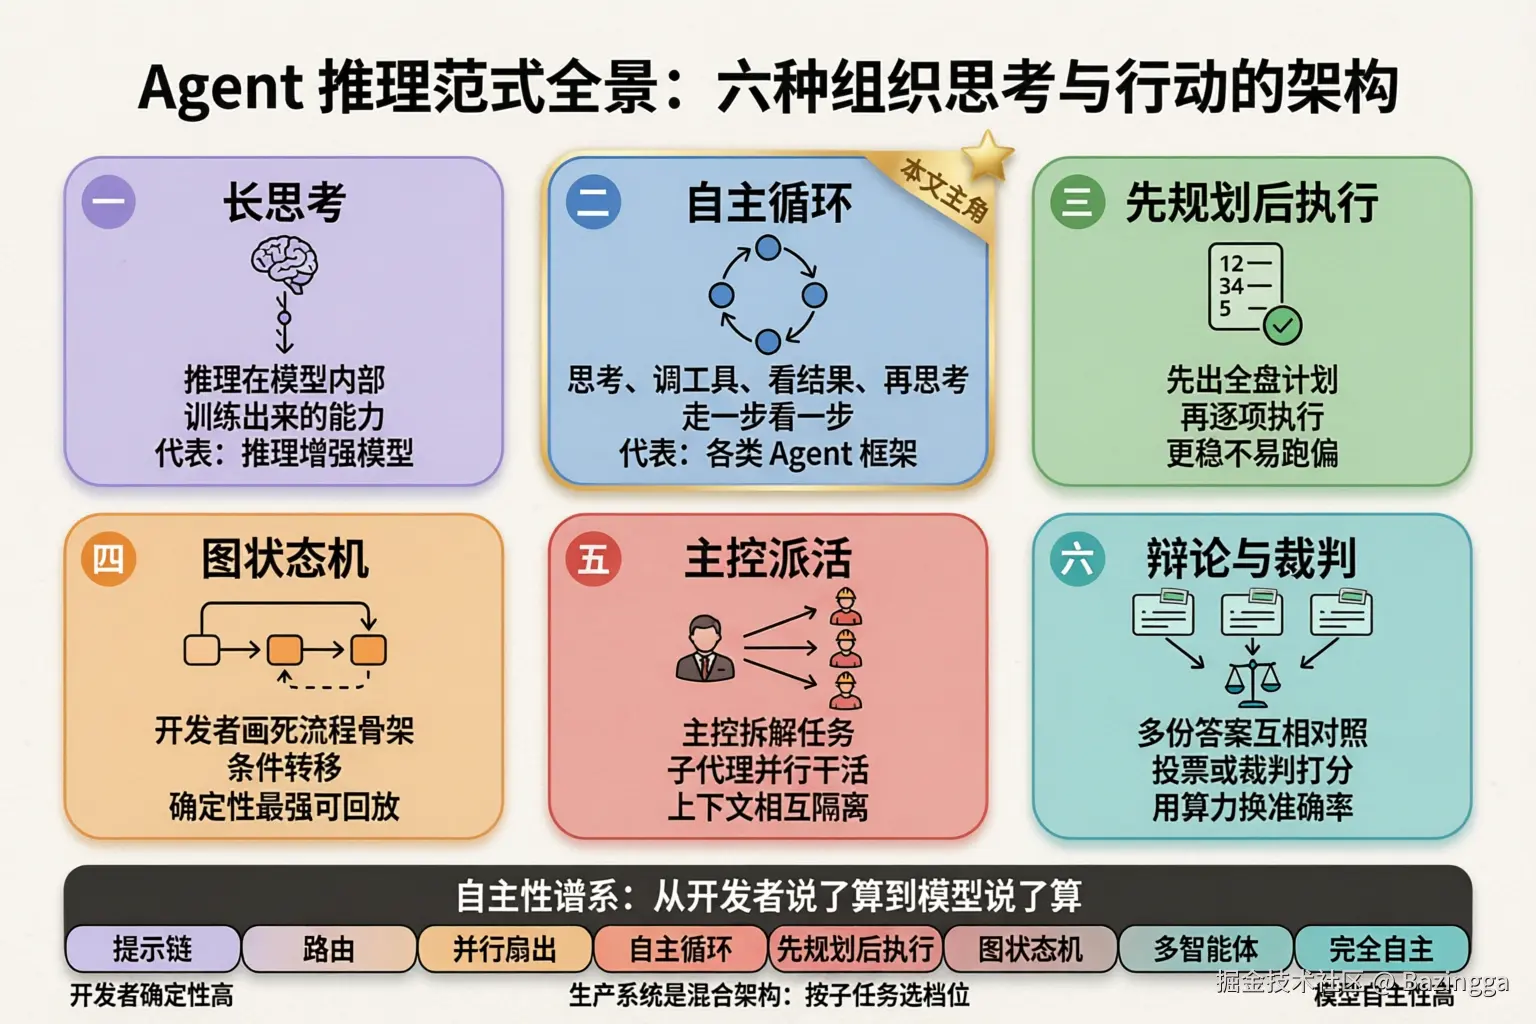
图 3:六种组织「想」与「做」的架构。右上角星标是本文主角------自主循环(ReAct);底部横幅是自主性谱系,从开发者说了算排到模型说了算。
4.1 「推理方式」的两层歧义
谈「推理方式」前必须先拆层,否则鸡同鸭讲:
| 层面 | 发生地 | 谁决定 | 类比 |
|---|---|---|---|
| 模型层 reasoning | 模型权重内部,单次调用 | 训练出来的(RL 教会它) | 侦探的大脑天生会推理 |
| 编排层 orchestration | 框架代码里,跨多次调用 | 开发者设计的 | 侦探接案子的流程制度 |
图 3 的范式一(长思考)是模型层:o1/o3、DeepSeek-R1 这类推理增强模型被训练成先写几千 token 内部推理链再作答------thinking 块就是这层能力的产品化外显。范式二到六全是编排层。两层不竞争、可叠加:thinking 块(模型层)跑在 ReAct 循环(编排层)里,大脑好用,流程也得好用。
4.2 六大范式逐个看
一 · 长思考(模型层):先打草稿再交卷。不配工具也能强推理,配上工具就是「想得深 + 走得远」。
二 · 自主循环(ReAct):走一步看一步的侦探。实现成本最低、行为最像智能,代价是不确定性------轮数不可预测、轨迹不可复现,这正是慢问归因和执行轨迹面板这些工程麻烦的根源。
三 · 先规划后执行:先列大纲再写论文。计划员出全盘清单,执行员逐项打勾,失败重规划。比 ReAct 稳(不跑偏)、比写死流程活(可重规划)。适用信号:步骤多且彼此依赖。
四 · 图状态机:地铁线路图。节点是站(步骤),边是换乘规则(条件转移),骨架开发者画死,确定性最强、可回放、可断点恢复------LangGraph 是旗手。适用信号:要合规、要回放、失败要从中间节点恢复。
五 · 主控派活:老板带实习生。主控 agent 拆任务派给多个子 agent 并行,各背独立小案卷(上下文隔离------主控的 12K 底座不传染给工人),干完收割汇总。Claude Code 的 subagent 是代表。适用信号:任务可拆、子任务独立。
六 · 辩论与裁判:答辩委员会。多模型各答一份,互相挑刺(Multi-Agent Debate)、多数投票(Self-Consistency)或裁判打分(LLM-as-judge)。用算力换准确率,数学/事实类任务增益明显。
4.3 自主性谱系:生产没有纯种范式
图 3 底部横幅把八种打法排成一条轴:越往左越像代码(可预测),越往右越像人(自主)。提示链每步写死;「完全自主」是 2023 年 AutoGPT 式的梦,真跑起来容易失控。
业界共识是生产系统 = 混合架构,按子任务选档位。用这个眼光重看 heart-net,它早已是四范式混合体:
| 子任务 | 实际用的范式 |
|---|---|
| 对话问答主链路 | 自主循环(ReAct) |
| 详解文档生成管道 | 提示链(五步写死)+ 并行扇出 |
| 详解质量把关 | 裁判(L2 三维自动打分,离线) |
| 检索不到就换 query 再查 | ReAct 内嵌的 agentic 行为 |
选档位的判断信号:要确定性 → 往左挪;要协作/可分解/上下文隔离 → 往右挪;要人进环把关(HITL)→ 图状态机最顺手(天然有「暂停在节点等人」的语义)。
4.4 三个容易混的邻概念
- MCP 不是推理方式------它是「工具插头」的协议标准(USB),任何范式的 agent 都能用它接工具。heart-net 自己就同时是 MCP server(对外供 6 个工具)和 ReAct agent(对内用 31 个)。
- A2A 也不是------agent 之间互相对话的协议,服务于多 agent 范式,本身只是通信层。
- 框架的真正分野在编排层------AgentScope/LangChain Agent 站循环阵营(图能力后补);LangGraph 站图阵营;CrewAI/AutoGen 站多 agent 对话阵营。选框架本质是选默认范式。
§5 结语:三张图一套教具
| 图 | 看什么 | 回答哪个问题 |
|---|---|---|
| 图 1 单次推理解剖 | 时间花在哪、input 装了什么 | 一次推理内部发生了什么 |
| 图 2 ReAct 三幕剧 | 循环怎么转、三方怎么分工 | 为什么需要第二轮、何时终止 |
| 图 3 范式全景 | 自主性谱系、六种架构 | 业界还有哪些打法、生产怎么选 |