用户第一句说:"帮我查订单 O-1001 为什么还没到,回答简单一点。"Agent 查完订单和物流,给出了一段分析。
第二句只有:"那我明天还要等吗?"
Agent 要回答,就得知道"那"指的是哪张订单、物流查到了什么,还得继续遵守"回答简单一点"。如果用户下周开启新会话,它可能又需要记起这个表达偏好。
这几个动作涉及不同的数据和机制:会话状态保存执行进度,上下文承载这次模型推理需要的信息,长期记忆保留跨会话有用的事实,知识库提供可检索的资料。Agent Harness 负责把它们组织起来。
上一篇把 A2A 请求从客户端一路追到了 Agent 服务。这次进入服务内部,看看对话如何延续、内容多了如何压缩,以及扩容以后状态如何恢复。AgentScope 示例固定使用 Python v2.0.10 ;记忆模式同时参考官方 2.0.9 文档,避免混用 1.x API。
1. 先分清上下文 记忆和知识库
这里的 Agent Harness 指 Agent 的运行底座,负责模型调用、工具执行、消息组织和状态管理。它是一个架构概念,不要求框架中存在名为 Harness 的类。
| 数据 | 本例里保存什么 | 什么时候使用 |
|---|---|---|
| 会话历史 | 用户问 O-1001,Agent 回答了物流状态 | 恢复对话、审计和继续处理 |
| 执行状态 | 当前订单号、已完成的工具调用、待处理步骤 | 恢复任务和推进执行 |
| 模型上下文 | 本轮规则、摘要、近期消息、相关记忆、工具定义和结果 | 这一次模型调用 |
| 长期记忆 | 用户偏好简短回答,某项目采用特定技术约束 | 跨会话按需检索 |
| 知识库 | 物流政策、退款规则、产品手册 | 查找可引用的业务资料 |
持久库可以存下很长的历史;模型上下文只能放进这次请求允许的内容。 所以"已经保存"不等于"这轮全部发送"。即便记忆和知识库都使用向量检索,两者的内容来源、更新方式和作用域也不同。
订单实时状态要从业务工具重新查询。把昨天的物流结论写成长期记忆,再当作今天的实时事实使用,容易得到错误答案。适合长期保存的是稳定偏好、项目约束和有来源的经验;时效性很强的数据需要有效期或重新核验。
2. 第二次对话是怎么接上第一次的
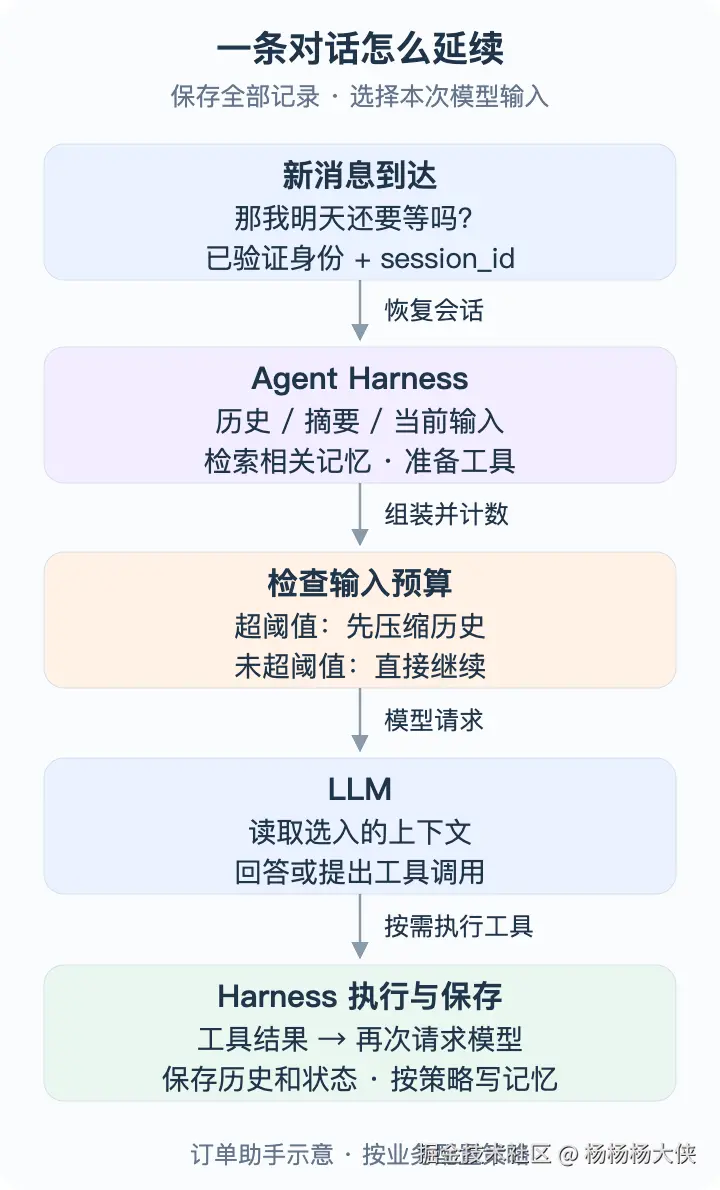
在同一个 Agent、同一个会话中,Harness 通常把用户消息、Agent 回复和工具记录保留到会话状态。第二轮到来时,恢复这些状态,再组织新的模型请求。
下面是框架内部组织消息的示意结构,不是某个模型供应商的实际 HTTP 格式。不同适配器会把它转换成各自支持的消息和工具字段。
json
{
  "session_id": "s-1001",
  "agent": "order-assistant",
  "messages": [
    {"role": "system", "content": "根据订单证据回答,说明不确定项"},
    {"role": "user", "content": "历史摘要:正在查询 O-1001,已确认发货"},
    {"role": "user", "content": "帮我查订单 O-1001,回答简单一点"},
    {"role": "assistant", "content": "最新轨迹停在中转站,暂未到配送站"},
    {"role": "user", "content": "那我明天还要等吗?"},
    {"role": "user", "content": "相关记忆:用户偏好简短说明"}
  ],
  "available_tools": ["query_logistics"],
  "output_budget_tokens": 4096
}
其中 session_id 供服务恢复状态和关联请求;是否向模型暴露,由应用决定。消息之间的顺序、角色与记忆提示格式,也由框架和模型适配器处理。
这次请求可能继续循环:模型提出查询物流的工具调用,Harness 执行工具,把返回结果加入上下文,再请求模型生成答案。工具结果需要传给模型,才会参与下一步推理。
默认保留上一轮回答有助于连续对话,但不表示回答越长越好。十页物流解释会占用窗口,也可能掩盖新的问题。可以保留关键事实和近期交互,把大段原始轨迹存到持久库或文件,需要时再取回。
3. 多大算太多 谁决定压缩
模型真正支持的窗口来自具体型号和服务部署配置。Harness 用配置和计数判断何时缩减输入,两者必须一致。
一个实用预算是:
text
本次输入 token + 计划输出 token ≤ 实际模型上下文窗口同时还要满足服务独立的输入、输出限制。思考内容、多模态内容和工具格式如何计费或计入窗口,按具体模型服务的规则处理。
AgentScope v2.0.10 的 ChatModelBase.context_size 用于本地压缩预算,基类默认值为 32768,具体适配器可以设置不同默认值。开发者应在模型配置中核对它;这个路径没有在每次请求前向服务查询窗口大小。模型基类源码
比如实际服务支持 128000 token,就按对应服务能力配置,并单独预留输出。配置成 256000 不会扩大真实窗口。 配小了会过早摘要;配大了可能来不及压缩就被接口拒绝或达到服务限制。
AgentScope 的触发条件
默认 ContextConfig.trigger_ratio 为 0.8,判断使用:
text
估算本次模型输入 token ≥ trigger_ratio × model.context_size假设配置窗口为 100000,估算输入到 80000 就触发处理。这里计入的是准备好的模型输入,包括系统提示词、摘要、消息以及工具 schema。窗口属于一次模型请求 ,不是整个应用共用的内存容量。上下文配置
三个 Agent 可以分别有自己的状态。A 的输入到 85000 时需要处理,B 只有 20000 就不需要;把 B 的结果交给 A 后,A 下次请求重新计数。
计数也有误差。该版本基类按文本 UTF-8 字节数除以 4 估算,非文本的多模态 DataBlock 使用固定估值;适配器可覆盖计数方法。0.8 是提前处理的策略,不能理解成精确 tokenizer 测量,也不能保证剩余 20% 恰好够输出。token 估算实现
每条模型调用路径都要考虑窗口。业务 Agent、路由模型、评审模型和摘要模型的输入各有自己的预算;直接调用模型适配器时,不能指望业务 Agent 的历史压缩自动覆盖它。
4. 压缩具体改了哪些内容
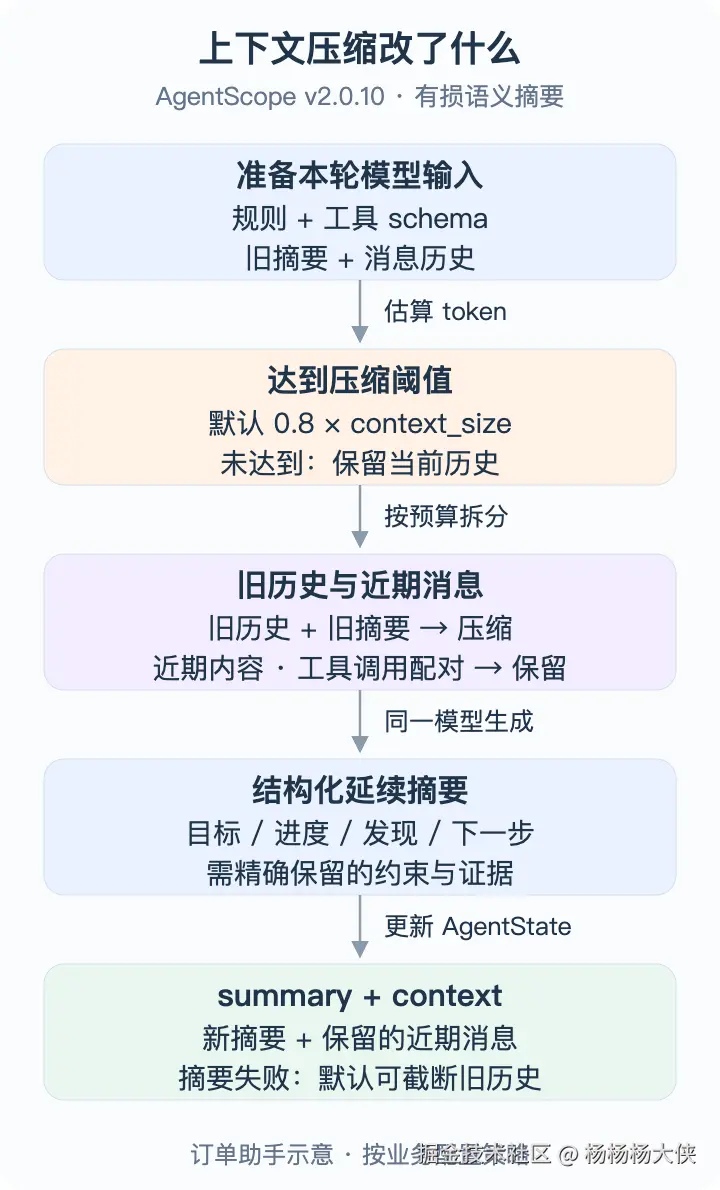
AgentScope 的 AgentState 有 context 和 summary 等状态字段。它保存状态,压缩工作由 Agent 的执行逻辑与 ContextConfig 共同完成。AgentState 源码
v2.0.10 的核心处理顺序是:
- 准备模型输入并估算 token,判断是否到阈值。
- 按预算划分较早的历史和要保留的近期消息,保护尚未完成的工具调用及调用结果关系。
- 把系统提示、已有摘要、较早历史和摘要指令交给当前配置的模型,生成结构化延续摘要。
- 更新
state.summary,把保留的近期消息写回state.context。 - 下一次模型请求使用新摘要和保留的消息,继续任务。
摘要包含任务概况、当前进度、重要发现、下一步和需要保留的细节。它是有损的语义整理,无法据此完整还原原始对话。压缩与输入组装实现
例如,原来二十轮查订单的记录可以整理为:
text
目标:判断 O-1001 是否明天到货。
已确认:已出库;最近一次轨迹位于中转站。
未确认:尚无配送站入站记录,不能承诺明日送达。
下一步:重新查询物流,并按最新轨迹回答。
保留约束:用户要求简短;订单号必须保留原值。
系统提示词和工具定义需要占用预算,但默认历史摘要不会把它们改写掉。较早的工具输出可以进入摘要,大工具结果还有独立长度限制。若固定规则和工具定义本身过大,需要精简规则或按任务只暴露必要工具,光压缩聊天记录无法解决。
默认配置还包括 reserve_ratio=0.1 和摘要失败后允许截断。前者是预算参数,不能解释为"固定保留 10% 的消息";后者意味着摘要失败时可能直接丢弃较早上下文。配置了 offloader 时,可以保存被移出的原内容并留下路径提示;需要恢复精确证据的业务,应另行保存原始记录。压缩配置与回退
5. 记忆由谁检索 选择和更新
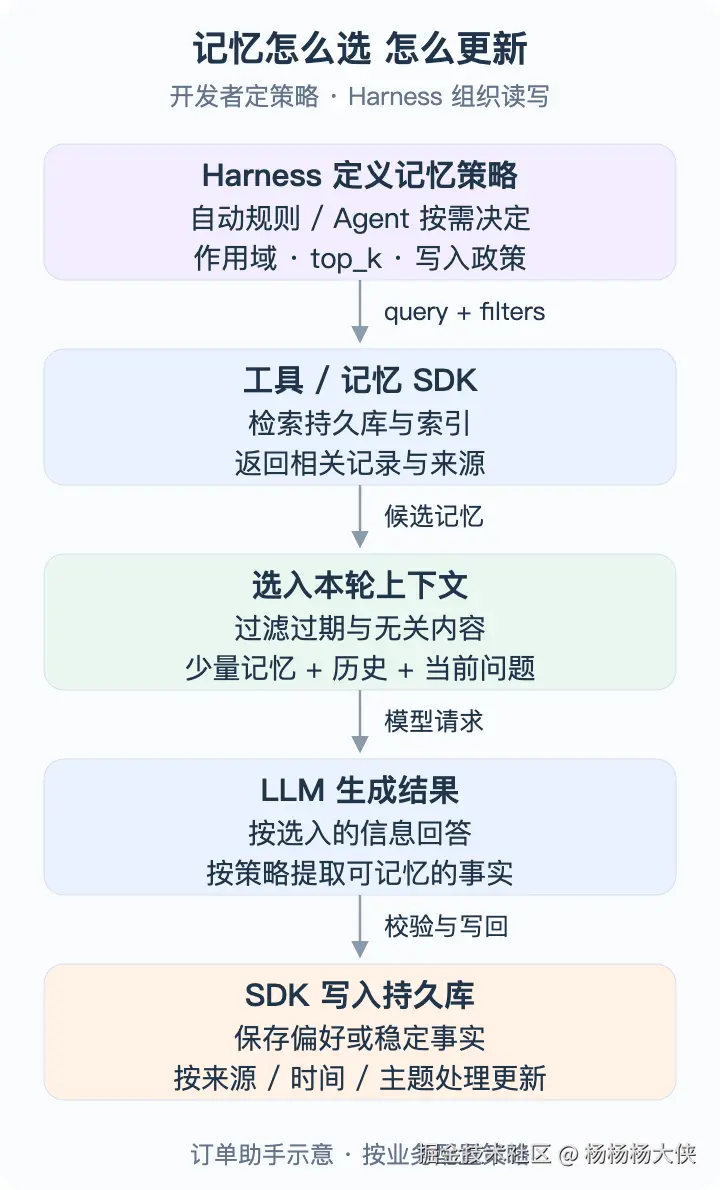
开发者定义作用域和策略;Harness 在合适的时机组织检索、注入和写回;LLM 可以判断相关性、生成检索词和提取候选记忆;工具或存储 SDK 执行读写;数据库提供存储和查询。
固定规则也可以直接做决定。比如客服请求始终按已验证用户身份检索偏好,取少量相关结果,不必先额外调用 LLM 问"要不要检索"。开放任务则可以给 Agent 一个记忆搜索工具,由模型按任务选择何时使用。
真正进入本轮上下文的记忆才会参与推理。 文件留在磁盘、记录留在数据库,都不会自动被模型看到。记忆注入之后,可能继续留在后续上下文或摘要中,所以仍需要控制重复内容和 token 预算。
Mem0Middleware 的三种控制方式
AgentScope 提供现成的 Mem0 中间件,需要显式接入。以下模式描述的是 Mem0Middleware,不要直接套到所有记忆组件上。
| 模式 | 检索方式 | 写回方式 |
|---|---|---|
static_control |
中间件用当前新输入自动检索并注入 | 完成回复后,把这轮用户与助手消息交给后端提取和保存 |
agent_control |
Agent 按需调用 search_memory |
Agent 按需调用 add_memory |
both 默认 |
自动检索,同时提供搜索工具 | 自动写回,同时提供保存工具 |
中间件支持 user_id、可选的 agent_id、top_k 和 threshold。自动检索结果会加入 state.context,长会话中可能累积,仍需压缩或清理。后端负责记忆提取与存储,应用继续定义事实来源、过期和纠错政策。Mem0Middleware 源码
下面只展示接线。model 和异步 mem0_client 是已经按服务能力与存储配置创建好的对象;身份参数来自服务端验证后的会话,不直接信任用户请求里的自报身份。
python
from agentscope.agent import Agent, ContextConfig
from agentscope.message import UserMsg
from agentscope.middleware import Mem0Middleware
from agentscope.state import AgentState
from agentscope.tool import Toolkit


async def build_order_agent(model, mem0_client, verified_user_id, session_id):
    # 使用已验证用户的作用域,并按订单 Agent 类型隔离记忆。
    memory = Mem0Middleware(
        user_id=verified_user_id,
        agent_id="order-assistant",
        client=mem0_client,
        mode="both",
        top_k=3,
    )
    # 显式将记忆搜索和保存工具加入 Toolkit。
    toolkit = Toolkit(tools=await memory.list_tools())
    # 在正常 Agent 执行路径上启用历史压缩和记忆中间件。
    return Agent(
        name="order-assistant",
        system_prompt="根据订单证据回答,保持简短,不承诺未确认的到货时间。",
        model=model,
        toolkit=toolkit,
        state=AgentState(session_id=session_id),
        context_config=ContextConfig(trigger_ratio=0.8),
        middlewares=[memory],
    )


async def ask(agent, text):
    # 把新输入交给 Agent 的正常执行路径,复用或事先恢复该会话状态。
    reply = await agent.reply(UserMsg(name="user", content=text))
    # 从回复消息提取正文,供业务入口展示。
    return reply.get_text_content() or ""
middlewares=[memory] 接入执行钩子,list_tools() 把相应模式的工具接到 Toolkit。示例只接了记忆工具,真实订单查询工具按应用需要加入。只有创建一个中间件对象,不会让它自动管理所有 Agent。每次请求都重新创建 Agent,也无法直接延续此前的内存状态,需要恢复对应会话的 AgentState;单独设置相同 session_id 并不等于已经加载历史。
AgenticMemory 和 ReMe 适合什么情况
AgenticMemoryMiddleware 使用文件记忆:简短的 MEMORY.md 索引加按主题组织的 Markdown。Agent 可通过 Read、Write、Edit 等工具读取和维护内容,也支持异步的相关记忆选择路径。这个方式直观,适合希望查看和编辑记忆内容的应用。
ReMeMiddleware 使用文件工作区,并提供 memory_search。其模式控制检索路径,回复后自动写回适用于所有模式,不能把 agent_control 理解为"只有 Agent 主动调用工具才保存"。它没有与 Mem0 相同的手动 add_memory 工具。
异步检索需要等到结果完成后的推理检查点才能注入,短回复可能来不及使用;新写入内容也可能要等索引后才能检索到。ReMe 的生命周期还需要应用在结束时调用 await memory.close()。选择组件时,需要关注实际注入时机和可见性,而不只看"支持记忆"四个字。AgentScope 长期记忆文档
更新旧事实仍要有业务规则
"添加一条记忆"和"覆盖一条旧事实"是两个问题。用户把"喜欢详细解释"改成"默认简短",系统需要知道这是一次偏好修改。
一个可落地的记录可以保存作用域、主题、值、来源、更新时间和有效期。检索时先限定授权范围,再处理过期或被替代的记录,最后按相关性选择。写入时对稳定偏好按主题更新;实时订单状态保留来源和时间,并优先重新查询。这些是应用设计选择,不是框架替所有业务保证的统一语义。
6. Codex 的本地文件能说明什么
Codex 提供了一个具体的本地运行例子,但几类文件承担不同用途。在本地安装中,会话 rollout 使用 JSONL 记录,SQLite 保存线程元数据等运行状态,Markdown 文件承载规则和长期记忆。"Codex 的上下文全在 MD 里"会把这几层混到一起。
官方 app-server 提供线程历史读取、恢复和压缩接口,明确存在 SQLite 支持的线程元数据,以及活动、归档会话日志目录。Codex app-server
本地记忆位于 ~/.codex/memories/,可以在以后符合条件的会话中注入;后台记忆生成与当前会话历史保存是两条流程,结束一轮对话不等于立即生成新记忆。Codex 本地记忆
上下文方面,Codex 配置区分 model_context_window、model_auto_compact_token_limit 和 tool_output_token_limit,分别涉及窗口、自动压缩阈值和工具输出预算。不能据此推定 Codex 固定按 AgentScope 的 80% 压缩。Codex 配置参考
压缩产物也不一定都是可读的文本摘要。OpenAI Responses 的 compaction 支持携带加密状态的 compaction item;具体 Harness 使用哪条路径,应按它的实现判断。Responses compaction
7. 多实例以后状态怎么共享
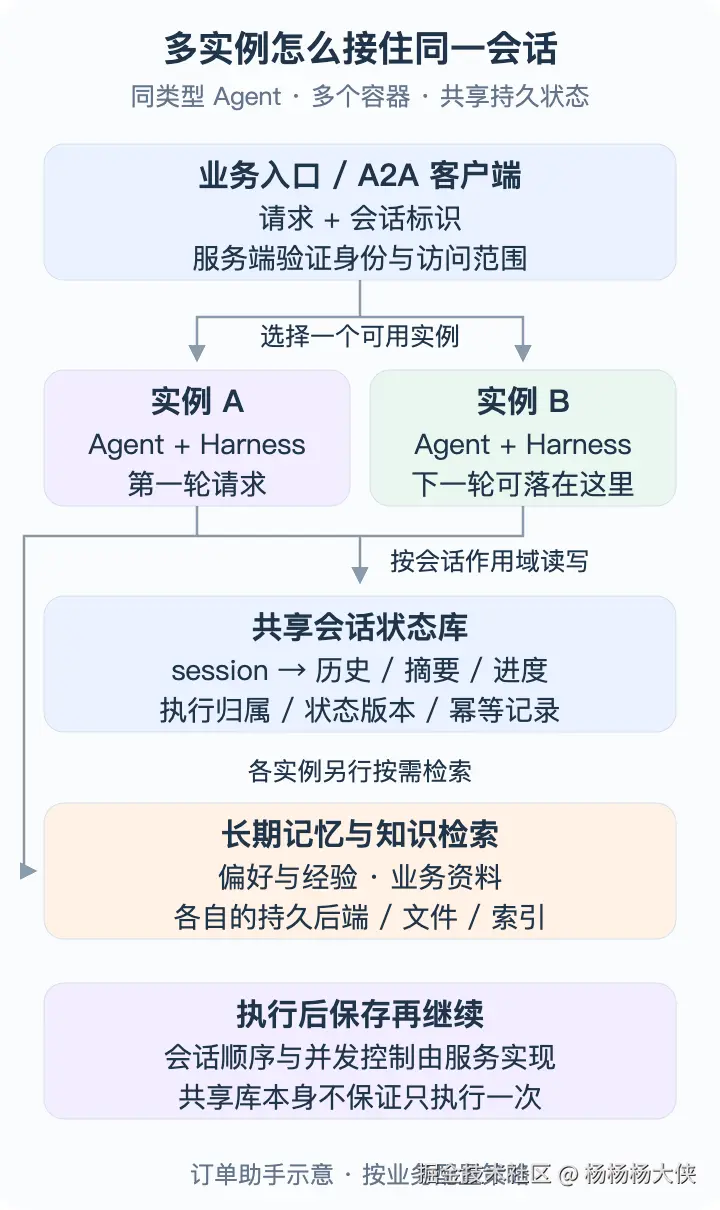
第一轮进实例 A,第二轮进实例 B,如果状态只在 A 的 Python 对象中,B 就接不上前面的订单讨论。单机内存适合进程内连续执行,生产服务需要按会话恢复共享状态,或有清晰的会话亲和与故障恢复机制。
可以采用这样一条请求路径:
- 入口验证用户身份,取得会话标识,按授权范围加载状态。
- 取得该会话的执行归属或并发控制,避免两个副本同时推进同一份状态。
- 恢复历史、摘要和待执行信息,检索相关长期记忆,组装模型上下文。
- 执行模型与工具循环,保存新的状态与历史,并按政策更新记忆。
- 返回结果,释放执行归属;其他副本按已保存的状态继续。
会话状态可以放在 PostgreSQL、MySQL 或文档数据库中;长期记忆使用合适的持久化后端与检索索引;大资料通常结合文件或对象存储、元数据和全文或向量索引。这是部署设计选择,不要求知识库只能存在一张向量表里。
多租户应用按租户、用户、Agent 类型和 session 等已验证作用域隔离。Mem0 的 user_id/agent_id 过滤不能替代整个业务系统的授权。不同用户也不能复用同一份可变的 AgentState。
共享数据库解决"其他实例能读取"的问题,执行锁、版本控制和业务幂等处理"是否重复执行"。会话顺序尤其重要:第二句到得很快,也不能在第一轮结果尚未保存时读到旧状态后继续推进。涉及创建订单、退款等副作用,要使用业务自己的幂等记录。
Nacos 负责发现服务和实例,A2A 负责交换消息、任务状态与产物。业务 Harness 仍需实现会话恢复和状态读写;知道一个 contextId,不会自动拿到全部内部模型上下文。
8. 从一个可控的实现开始
先保存完整历史和任务状态,再明确本轮模型的输入预算。超过阈值时摘要较早记录,把必须精确保留的订单号、约束、证据来源和下一步写清楚。
记忆先收窄到少量稳定事实,配置作用域、数量限制和写入政策。知识库另行提供资料检索。等单会话的读写和恢复验证清楚,再扩容到多个实例,同时处理并发推进与副作用幂等。
可以用三个问题检查设计是否完整:新请求怎么找到上一轮状态?进入模型的信息是怎样选出来的?写回以后,另一个实例能否正确继续? 能把这三条路径讲清,框架、模型和数据库的责任就落到了实际实现上。