决策滞后不是速度问题,是权责错配
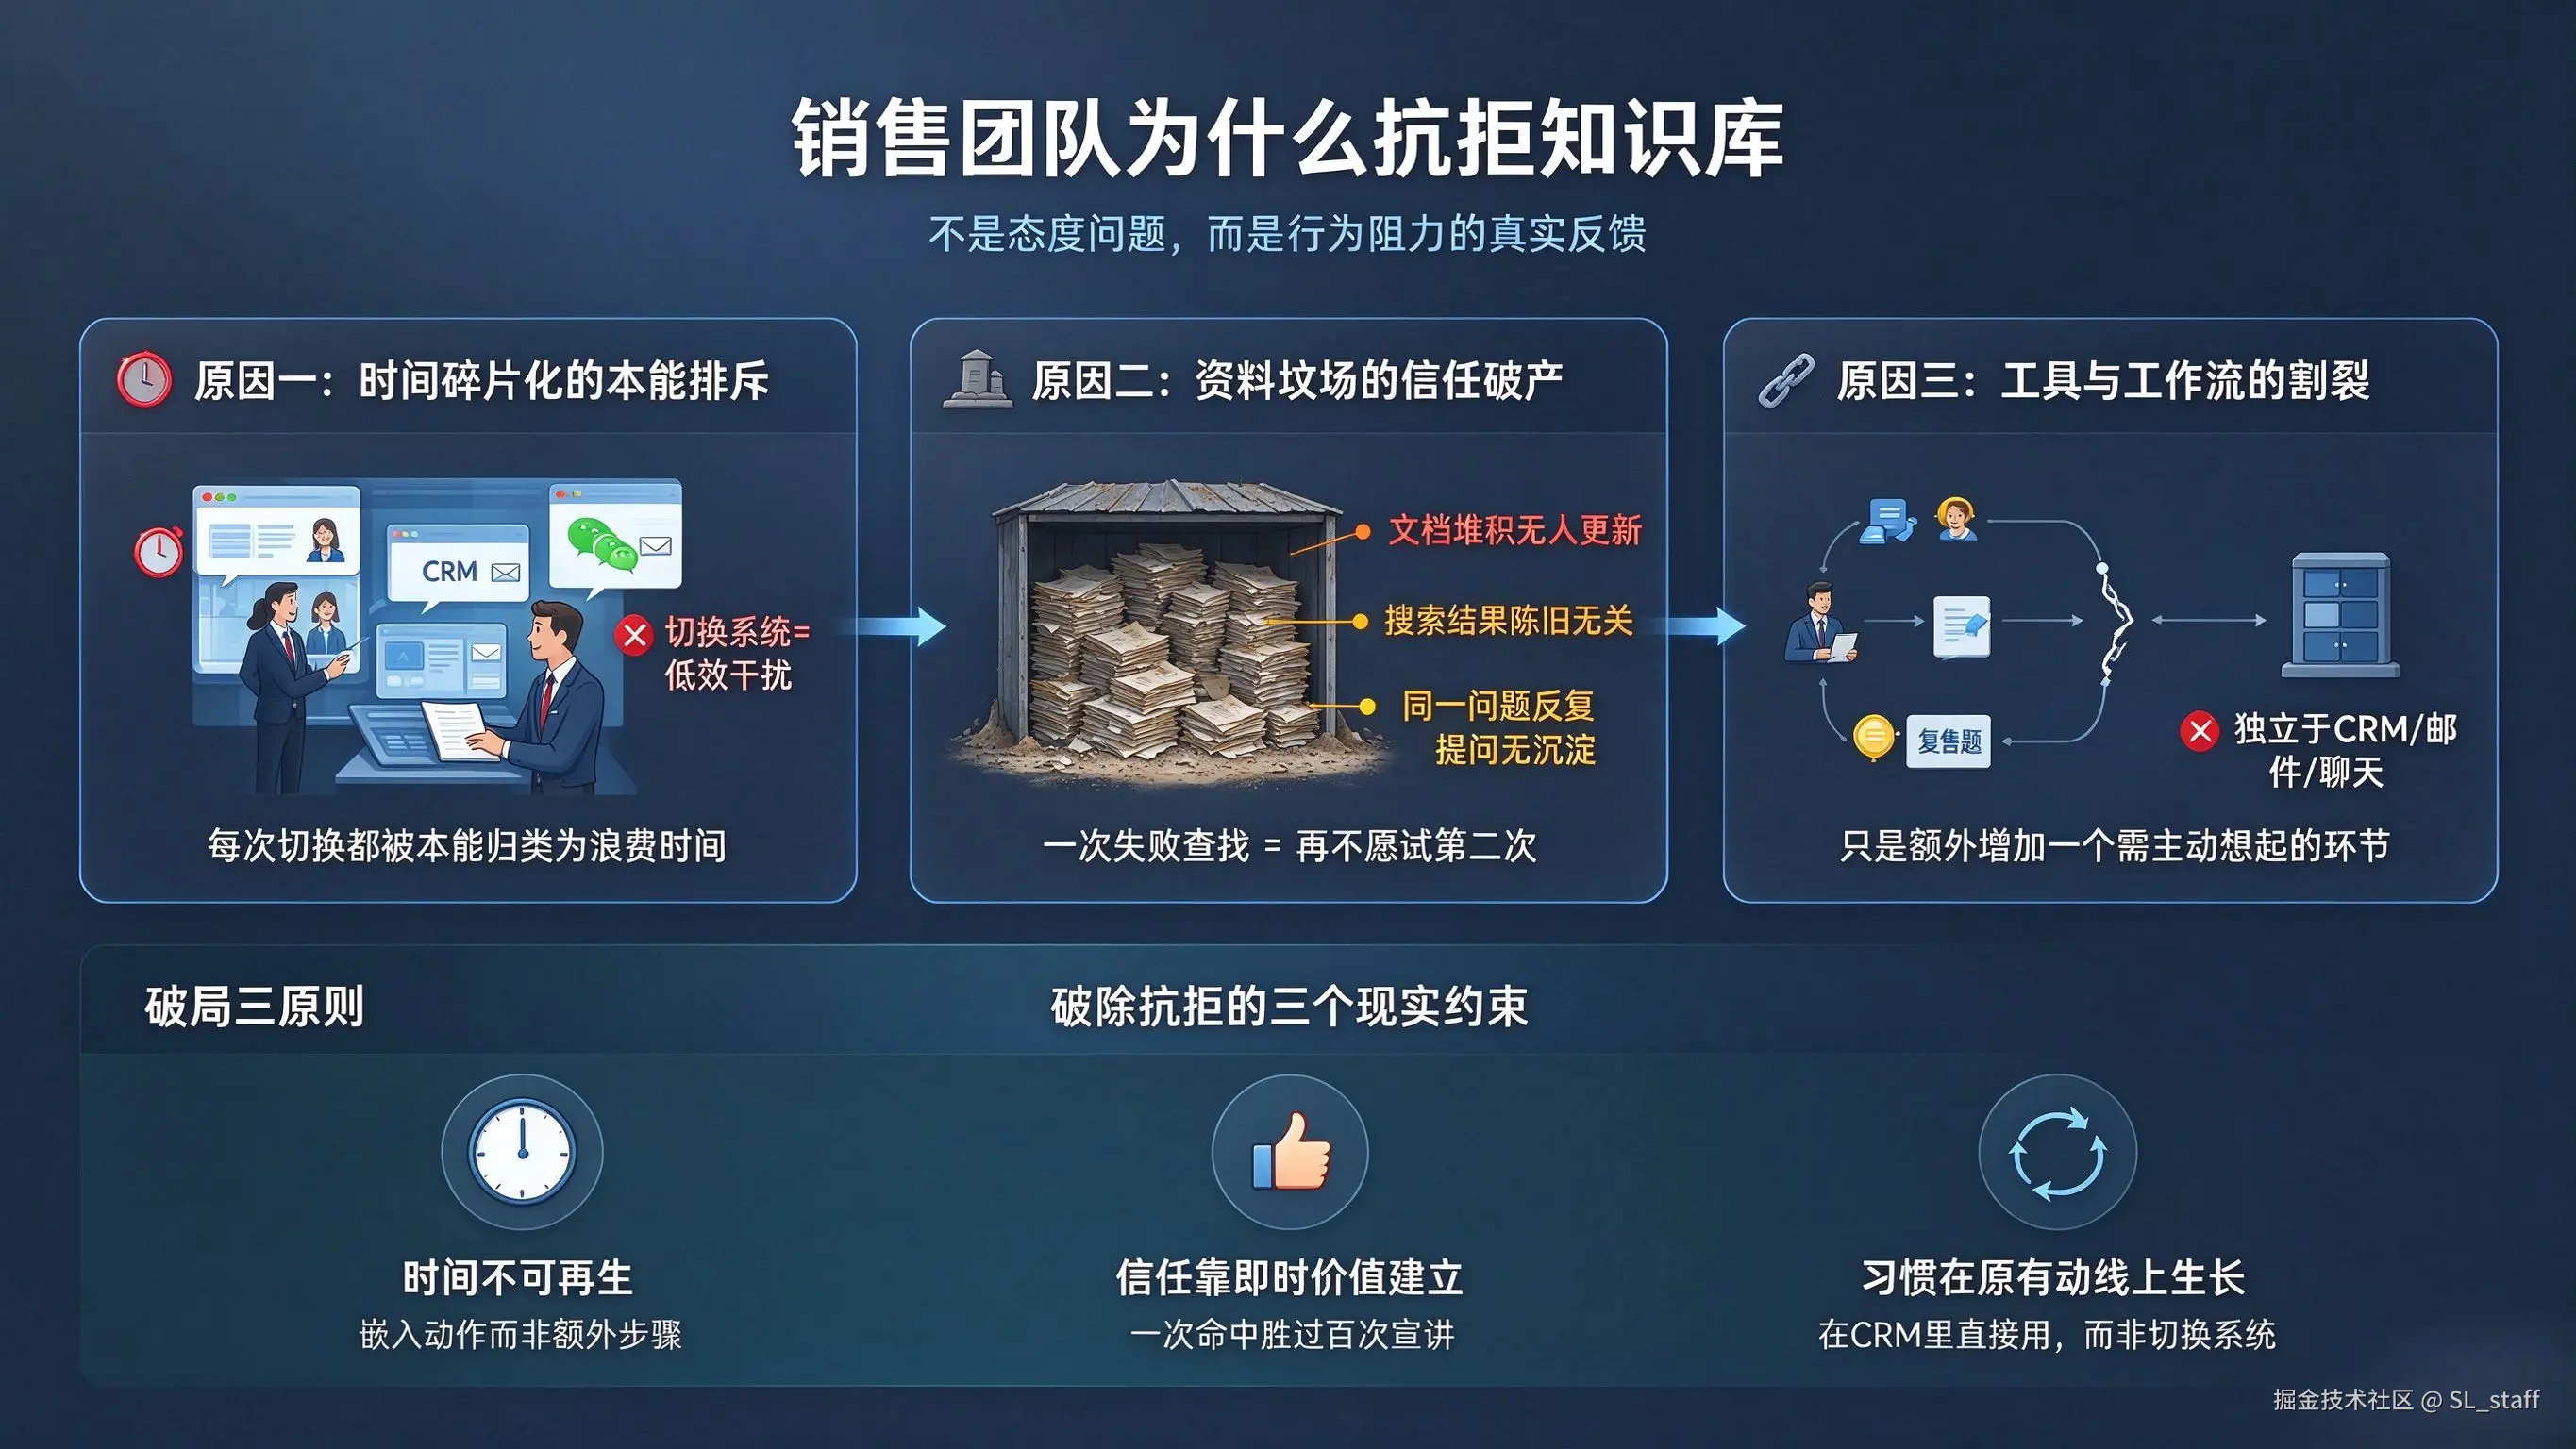
业务部门等待BI报表,本质是分析权与判断力被系统性隔离。销售主管发现客户流失加速却需等3天看渠道归因;生产经理感知交付风险上升却排队等IT开发临时看板------表面响应慢,实则是需求翻译损耗、优先级博弈与隐性数据加工(如ERP/WMS/售后三源关联、退货口径校准)无法被业务侧直接掌控。
制造业常见问题:重复取数、报表口径反复修改、权限粗放,根源在于数据准备缺乏共识机制与可复用能力。等待报表,不是技术不够快,而是最懂问题的人无法直接获取答案。
传统BI卡在哪儿?数据准备才是真瓶颈
Power BI、Tableau强于可视化探索,FineBI、Smartbi侧重模板复用,但它们普遍预设一个前提:数据已清洗好、口径已统一、模型已建好。而企业真实场景中,这恰恰是最耗时、最易出错的'看不见的后端'。
报表项目常陷入'提需求→改口径→重开发→再测试'循环,核心症结在于:
- 加工逻辑未沉淀为标准数据集,同一指标被多部门各自SQL处理,结果不一致;
- 修改筛选条件即需重跑SQL、重配权限、重测血缘,自助分析沦为开发外包;
- 运维支撑缺位:任务失败靠'报表空了'才发现,字段变更影响范围不可追溯,权限依赖数据库账号粗放控制。
这些治理缺位导致业务人员不敢改、不敢用、不敢信,最终仍将分析权让渡给IT。
JVS-BI怎么做?用配置化闭环替代代码依赖
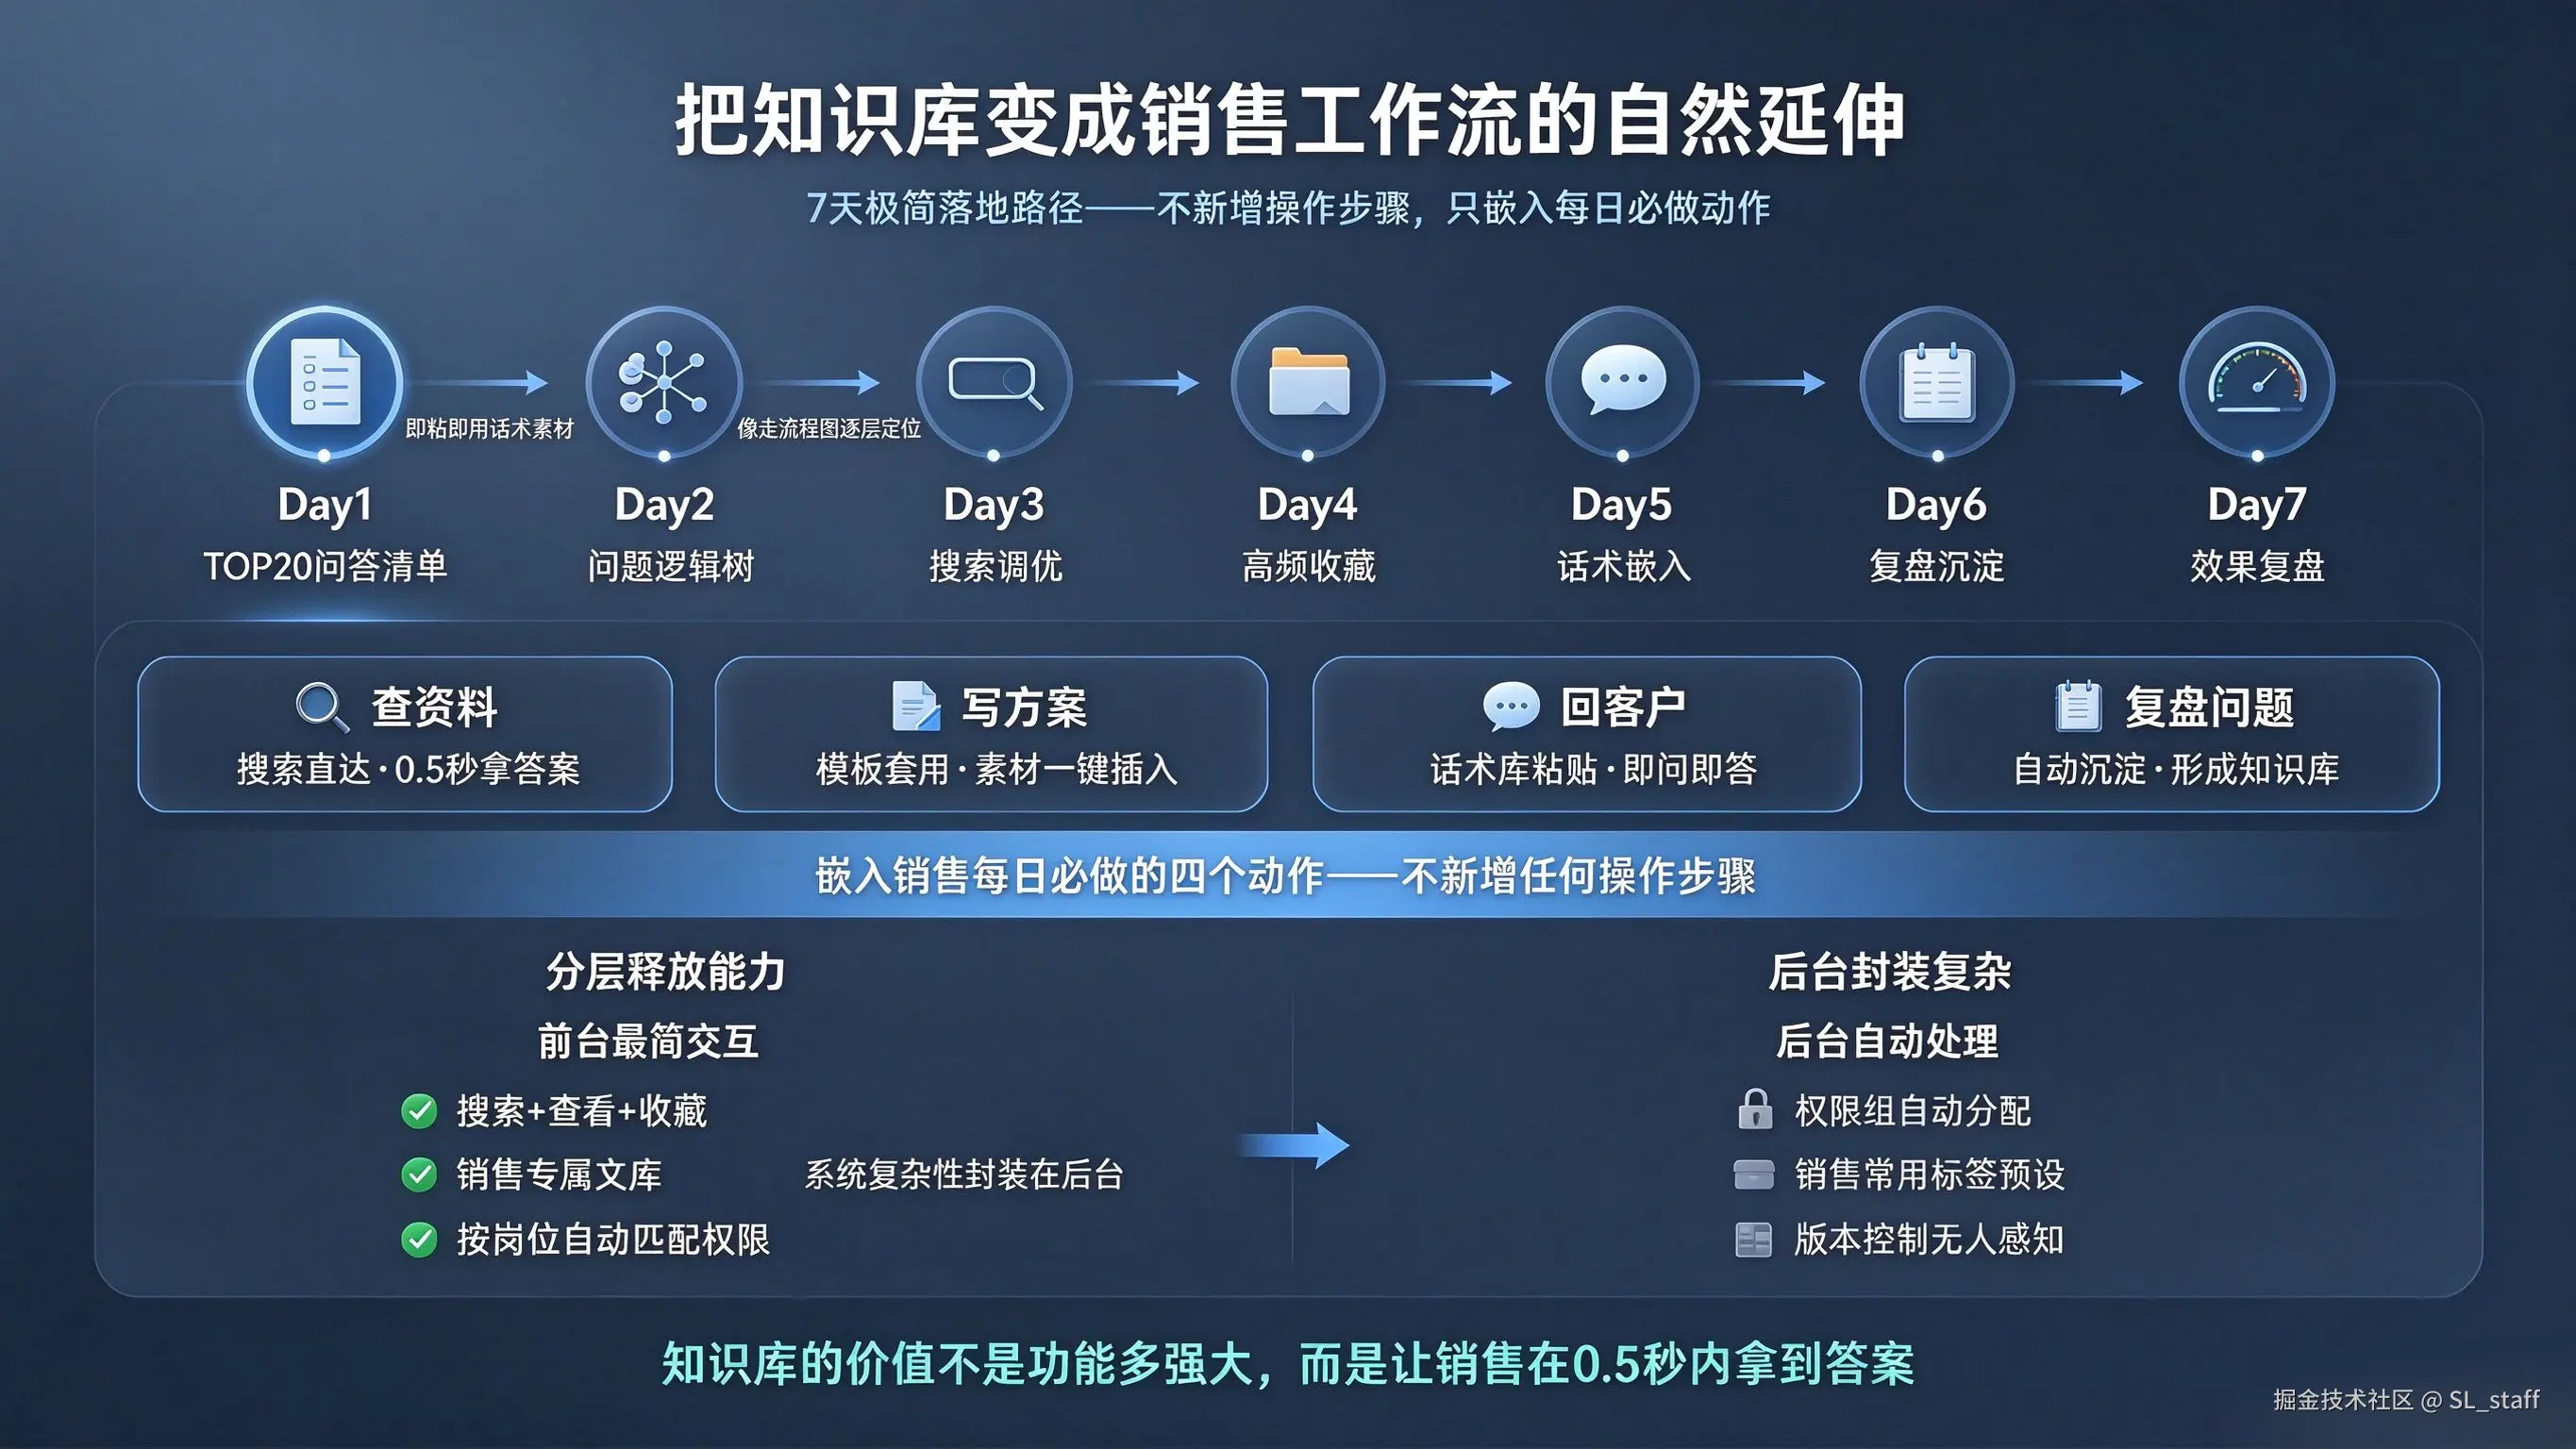
JVS-BI的解法是构建面向业务人员的可视化ELT配置闭环,关键不在展示层,而在降低数据加工门槛:
- 可视化ELT引擎:拖拽节点完成字段筛选、跨库关联、分组聚合、同环比计算,每步支持实时预览,无需写SQL,也无需理解底层DB结构;
- 标准数据集沉淀:所有加工成果自动固化为可复用数据集,一份订单履约数据集可同时驱动驾驶舱指标卡、交付趋势图、交叉报表及大屏组件;
- 配置化三件套:图表、报表、大屏全部基于界面操作------设置筛选、配置联动跳转、调整钻取路径、切换多页视图,均无需前端开发;
- 私有化底座保障:独立Doris数仓 + 微服务架构 + 统一认证 + 细粒度权限,确保业务自助不牺牲安全与治理。
分析权回归一线,带来什么真实改变
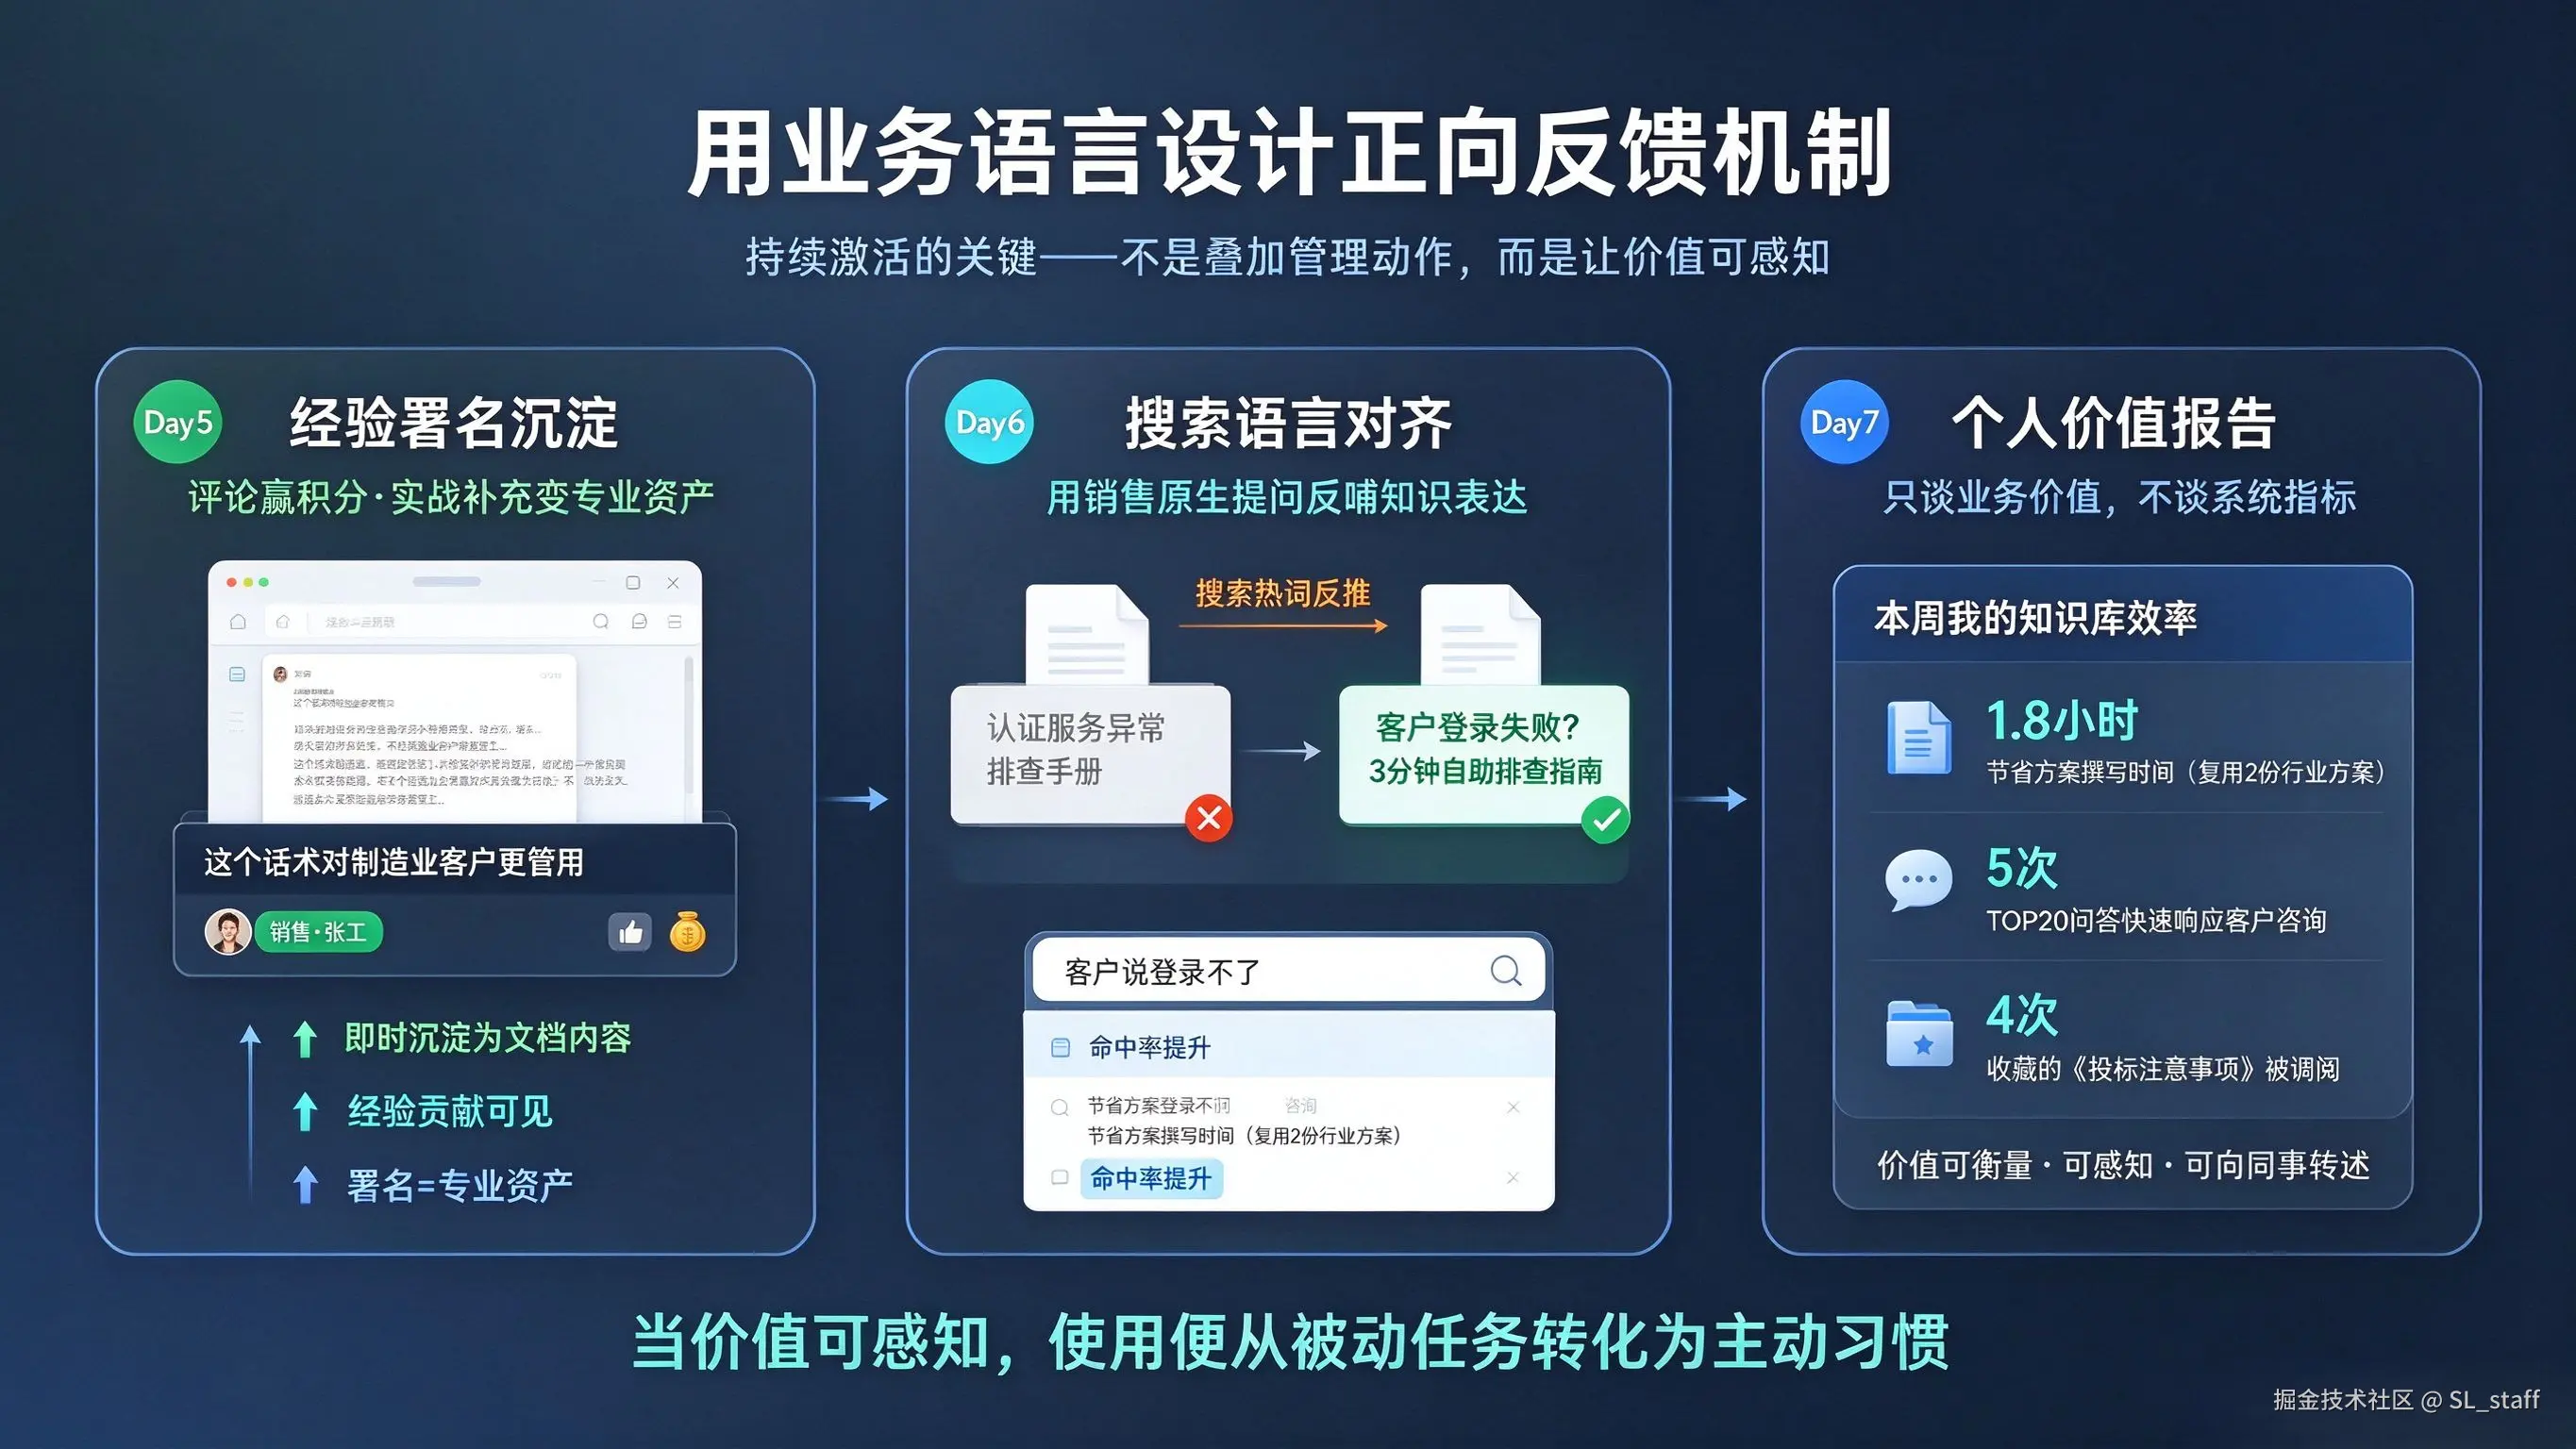
分析权下放带来的不是功能堆砌,而是决策节奏质变:
- 销售主管4分32秒内自主配置周销趋势大屏,动态筛选新品类/新区域/新渠道,不再因IT排期错过促销窗口;
- 经营分析从'会前人工拼PPT'变为'系统自动刷新驾驶舱',异常波动提前3--5天触发预警;
- 财务人员直接在界面加工科目/期间/部门维度,将月度分析口径固化为标准数据集,显著减少跨部门对账争议;
- 生产经理随时下钻查看某产线设备停机明细,定位至具体班次与故障类型,驱动现场快速响应;
- 大屏不再是'一次性项目':指标调整仅需修改数据集或配置器参数,无需重写代码、无需重启服务、无需协调开发资源。
分析,终于成为业务动作本身,而非等待审批的附加流程。