前言
在上一篇《C++中string类的部分简单实现》里,我们从零实现了一个简易的 string 类,把 C++ 动态内存管理、深拷贝、拷贝构造、迭代器这些核心概念都过了一遍。
这一篇我们把视野从"具体类型"扩展到"泛型容器"------实现一个简易的 vector。
vector 和 string 有很多相似之处:
- 底层都是一块连续的内存;
- 都用成倍扩容来应对增长;
- 都需要深拷贝来避免二次释放;
- 迭代器都是裸指针。
但 vector 又比 string 多了一层模板------它管理的不是固定的 char,而是任意类型 T。这一层泛化带来了几个全新的问题:
- 元素如何搬运 :
string的元素是char,可以用memcpy直接搬;vector<T>的元素是任意类型,必须调用T的拷贝构造或赋值; - 迭代器失效 :
vector的迭代器是T*,指向具体的内存地址------一旦扩容或删除元素,原来的迭代器就可能失效; - 构造函数的陷阱 :
vector(n, val)和vector(first, last)两个构造函数在重载决议时会互相"抢活"。
这些是本文的重点。至于 string 篇已经讲透的内容(深拷贝、Copy-Swap、成倍扩容),我们会一笔带过 ,把篇幅留给 vector 独有的知识点。
1 整体规划
和 string 篇不同,vector 是一个模板类。模板有一个重要的规则:
模板的声明和定义必须放在同一个文件里。
因为模板本身不是代码,而是"生成代码的模板"------编译器在实例化 (比如 vector<int>、vector<string>)的时候,必须能看到完整的定义才能生成对应类型的代码。如果像普通类那样声明放 .h、定义放 .cpp,当另一个 .cpp 引用 vector<int> 时,它只能看到头文件里的声明,看不到 .cpp 里的实现,链接时就会报"未定义符号"。
所以 vector 篇的文件组织是:
| 文件名 | 作用 |
|---|---|
vector.h |
类的声明 + 实现(全放一起) |
Test.cpp |
测试代码 |
命名空间仍然用 xc,避免和标准库的 std::vector 冲突。
2 搭建文件框架
2.1 vector.h ------ 类的基本框架
cpp
#pragma once
#include<iostream>
#include<assert.h>
#include<utility>       // 为 std::swap
using namespace std;     // 仅教学方便,工程中不推荐

namespace xc
{
	template <class T>
	class vector
	{
	public:
		typedef T* iterator;
		typedef const T* const_iterator;
		// ... 各种成员函数

	private:
		iterator _start = nullptr;            // 指向第一个元素
		iterator _finish = nullptr;           // 指向最后一个元素的下一个位置
		iterator _end_of_storage = nullptr;   // 指向已分配空间的末尾的下一个位置
	};
}
几个关键点:
template <class T>
类前面加上这一行,T就成了一个"占位符"------它可以被替换成int、string、MyClass等任意类型。整个类里出现的T,都会在实例化时被替换。typedef T* iterator;
和string篇里的typedef char* iterator;完全一样,只是char换成了泛化的T。这是vector泛型化最直接的体现------同一份代码,可以为任意类型提供迭代器。- 三指针模型
string用的是char* _str+size_t _size+size_t _capacity;vector 用的是三个指针:
| 成员 | 含义 | 对应 string |
|---|---|---|
_start |
指向第一个元素 | _str |
_finish |
指向最后一个元素的下一个位置 | _str + _size |
_end_of_storage |
指向已分配空间的末尾的下一个位置 | _str + _capacity |
于是:
size() = _finish - _startcapacity() = _end_of_storage - _start
为什么用指针而不是 size_t? 因为 vector 的迭代器就是 T*,用指针运算 _finish - _start 计算大小天然自然;如果用 size_t,还得额外保存 _start,反而更麻烦。标准库就是这么设计的。
-
= nullptr类内初始化这是 C++11 的语法------成员变量可以在类里直接给默认值。这样
vector() = default;就能自动得到"三个指针都是 nullptr"的默认构造,不用手写。 -
关于头文件里的
using namespace std;为了和
string篇保持一致,我们保留了它,简化代码书写。但请注意:工程中不推荐在头文件里写using namespace std;------头文件会被很多.cpp包含,一旦污染命名空间,可能在别人的代码里引发名字冲突。实际项目中应该写std::。
2.2 关于 using namespace std;
using namespace std; 的语义是"从这一行开始,把 std 里的所有名字都纳入查找范围 "。这样一来,像 std::swap、std::max、std::string 这些名字就可以省略 std:: 前缀直接使用,代码会短一些。
但问题在于:std 里的名字非常多,一旦引入查找范围,就可能和自己的名字冲突。举个例子:
cpp
// 头文件里写了 using namespace std;

namespace mylib
{
	class string { /* ... */ };   // 自己定义的 string
}

// 使用者代码
mylib::string s1;      // 我想用 mylib::string
string s2;             // ❌ 到底是 mylib::string 还是 std::string?编译器报二义性
头文件里的 using namespace std; 尤其危险 ,因为它会被所有包含这个头文件的 .cpp 文件继承 。别人只是 #include "mylib.h",就莫名其妙地被"污染"了命名空间------这不是他写的,却要承担后果。
所以在实际工程中,规范是:
头文件里绝对不写
using namespace std;(或任何using namespace xxx;)。
.cpp文件里可以用,但更推荐缩小范围,比如using std::cout;只引入具体名字,或在函数内部局部using。
本文为了教学简化,保留了 using namespace std;。但你如果要在真实项目里复用这些代码,务必把它删掉,改成写全名 std::swap、std::vector 等。
2.3 Test.cpp
cpp
#include"vector.h"

int main()
{
	// 后续在此编写测试代码
	return 0;
}到这里,vector 的基本框架就搭好了。它和 string 最大的不同是多了 template<class T> 这一层,但底层的三指针模型、迭代器思想都是相通的。
3 从 string 到 vector
在正式实现之前,我们先把 string 和 vector 做一个系统对比。明确哪些内容是重复的,哪些是 vector 独有的------这样可以避免两篇文章读起来像"重复劳动"。
3.1 一张对比表
| 维度 | string |
vector |
|---|---|---|
| 元素类型 | 固定为 char |
任意类型 T |
| 是否为模板 | 否 | 是(template<class T>) |
| 底层数据结构 | 连续内存(char*) |
连续内存(T*) |
| 成员设计 | _str + _size + _capacity |
_start + _finish + _end_of_storage |
| 迭代器 | char* |
T* |
| 扩容策略 | 成倍扩容 | 成倍扩容 |
| 元素搬运方式 | memcpy(按字节) |
T::operator=(按元素) |
| 迭代器失效 | 不常涉及 | 频繁涉及(扩容/删除时) |
| 输入输出运算符 | 有 << / >> |
无通用实现 |
| 比较运算符 | 六个都实现 | 意义不大,可不实现 |
结论 :核心思想(深拷贝、扩容、迭代器)是相通的,但元素搬运 和迭代器失效是 vector 独有的问题。
3.2 哪些内容不再重复讲?
以下内容在 string 篇已经讲透,本篇只列代码,不展开 。如果你对某一部分有疑问,请回看 string 篇对应章节。
| 内容 | string 篇对应章节 | 本篇处理方式 |
|---|---|---|
| 深拷贝vs 浅拷贝 | 5 拷贝构造与赋值 | 一句话带过 |
| 拷贝构造的三种写法 | 5.1 / 5.2 | 直接给代码 |
| Copy-Swap 惯用法 | 5.2 / 5.3 | 直接给代码 |
swap 成员函数 |
5.3 | 直接给代码 |
| 无符号下溢陷阱 | 8.1 insert | 本篇写法不同(用指针),稍作说明 |
| 成倍扩容 | 7.2 push_back | 直接给代码,重点放在元素搬运上 |
| const 重载 | 6.2 operator\[\] | 直接给代码 |
3.3 哪些内容是 vector 独有的?
这些是本篇的重点,会重点展开:
-
模板与泛型
vector<T>用template<class T>把"元素类型"抽象出来。同一个类可以管理int、double、string、自定义类型------这是 C++ 泛型编程的核心能力。 -
元素搬运不能用
memcpystring的元素是char,一个字节,直接memcpy就行。但vector<T>的元素是任意类型------如果T = string,用memcpy会让新旧两个string的_str指向同一块内存,在容器的层面重现浅拷贝问题 。正确做法是用赋值 (触发
T::operator=)或拷贝构造来搬运元素。 -
迭代器失效
vector的迭代器是T*,指向具体地址。一旦扩容,_start变了,原来的迭代器就指向了已释放的内存------继续使用会导致未定义行为。insert和erase都会导致迭代器失效,这是vector使用中最容易踩的坑。 -
构造函数的重载陷阱
cpp
vector(int n, T val = T());                        // 版本 A
vector(size_t n, T val = T());                     // 版本 A'
template<class InputIterator>
vector(InputIterator first, InputIterator last); // 版本 B当传入的两个实参既不是 int,也不是当前平台的 size_t 时,版本 B 会因为"模板的精确匹配"而被优先选中------把这两个整数当成"起始迭代器"和"结束迭代器",然后尝试解引用一个整数,程序崩溃。
这个陷阱依赖于平台 :比如 vector<size_t> v(6u, 3u) 在 32 位下正常(size_t == unsigned int,走 size_t版本),但在 64 位下会走版本 B(size_t == unsigned long long,unsigned int 与之不匹配)。
这是 vector 设计中最经典的"重载陷阱",本篇会专门讲。
resize与reserve的区别
string 篇没细讲 resize。vector 篇会讲清楚:
reserve(n)只改capacity,不改size;resize(n)改size,可能触发扩容(如果需要),也可能缩短(只改_finish)。
3.4 一句话总结
vector是string的"泛化版"------把char换成T,把"字符串"换成"任意类型的数组"。核心思想相通,但多出来的是:模板、元素搬运、迭代器失效。
接下来的章节,按"对象生命周期 → 行为接口"的顺序展开,和 string 篇保持一致的节奏。
4 构造与析构
4.1 默认构造:= default
cpp
vector() = default; // 强制编译器生成默认构造(三个指针靠类内初始化置为 nullptr)vector() 什么都不用写------因为三个成员在类里已经给了默认值 nullptr:
cpp
iterator _start = nullptr;
iterator _finish = nullptr;
iterator _end_of_storage = nullptr;
= default 的含义是"让编译器自动生成这个函数的默认实现 "。由于成员已经有类内初始化,生成的默认构造就是"三个指针都置为 nullptr"。
为什么写成 = default 而不是 vector() {}?
两者功能一样。写成 = default 有两点好处:
- 语义更清晰------告诉读者"我要的就是编译器默认行为";
- 性能更好 ------
= default的构造函数在满足条件时可以是constexpr或trivial,而手写{}会阻止这些优化。
这和 string 篇里 string(const char* str = ""); 有默认参数类似------都是一种"省事的默认构造",但 vector 的默认构造比 string 更简单,因为不用分配内存。
4.2 析构函数:delete\[\] 会调用元素的析构
cpp
~vector()
{
	delete[] _start;      // 为每个元素调用 T 的析构函数,然后释放整块内存
	_start = _finish = _end_of_storage = nullptr;
}
delete[] 有两个动作:
- 对数组里的每个元素调用
T的析构函数; - 释放整块内存。
这一点非常重要------尤其对 vector<string>:
cpp
xc::vector<string> v;
v.push_back("hello");
v.push_back("world");
// v 析构时:
//   delete[] _start;
//   → 对 v[0] 调用 ~string(),释放 "hello" 的堆内存
//   → 对 v[1] 调用 ~string(),释放 "world" 的堆内存
//   → 释放 _start 指向的整块数组内存
如果 delete[] 只释放内存、不调用元素的析构函数,那么每个 string 内部的 _str 就永远不会被释放------大量内存泄漏 。C++ 的 delete[] 专门处理了这件事,我们不需要手动遍历元素调用析构。
关于置空
cpp
_start = _finish = _end_of_storage = nullptr;和 string 篇一样,析构函数里把指针置空是好习惯------防止后续代码误用悬空指针。虽然对象马上就要销毁,但代价极小,值得保留。
4.3 拷贝构造
cpp
vector(const vector<T>& v)
{
	// 提前开好和 v 一样大的空间,避免 push_back 过程中反复扩容
	reserve(v.capacity());
	for (auto e : v)
	{
		push_back(e);   // 逐个元素拷贝构造
	}
}
和 string 篇呼应 :vector 的拷贝构造本质上也是深拷贝------为新对象申请独立内存,把源对象的元素一个一个搬过来。
具体做法:
reserve(v.capacity())------ 提前开好和v一样大的空间,避免push_back过程中反复扩容;for (auto e : v) push_back(e);------ 遍历v,把每个元素拷贝到新对象里。
为什么用 push_back 而不是 memcpy?
因为 vector<T> 的元素是任意类型。用 memcpy 搬运会触发"深层次的浅拷贝问题"(见后面第 7 节)。而 push_back 内部用的是 T 的拷贝赋值/拷贝构造,对 string 这样的类型会自动做深拷贝,完全正确。
4.4 swap 与赋值运算符
cpp
void swap(vector<T>& v)
{
	std::swap(_start, v._start);
	std::swap(_finish, v._finish);
	std::swap(_end_of_storage, v._end_of_storage);
}

vector<T>& operator=(vector<T> v)   // 传值参数:拷贝发生在传参阶段
{
	swap(v);        // 交换后 v 析构,释放 *this 的旧资源
	return *this;
}这两个函数和 string 篇完全一样 ------swap 交换三个指针(O(1)),赋值用传值参数的现代写法(Copy-Swap 惯用法)。
关于"为什么传值"、"为什么 swap 后就安全了" ------这些在 string 篇的第 5 章已经详细讲过,这里不再重复。如果你对"传值参数的拷贝构造什么时候发生"、"为什么 swap 后 v 析构就能释放旧资源"有疑问,请回看 string 篇 5.2 节。
4.5 initializer_list 构造
cpp
vector(initializer_list<T> il)
{
	reserve(il.size());
	for (auto e : il)
	{
		push_back(e);
	}
}
initializer_list<T> 是 C++11 引入的一种轻量容器,让我们可以这样写:
cpp
xc::vector<int> v = {1, 2, 3, 4, 5};它的底层是什么? initializer_list<T> 本质上是"一块只读的连续内存 + 长度",由编译器在 {} 出现时自动构造。它不拥有元素的所有权------你可以把它理解为一个"指向临时数组的只读视图"。
所以 vector(initializer_list<T> il) 的构造过程是:
-
reserve(il.size())一次性开好空间; -
遍历
il,把每个元素push_back进来。
和拷贝构造的区别:
- 拷贝构造
vector(const vector<T>& v)从一个已存在的vector拷贝; initializer_list构造从{}括起来的字面量列表构造。
4.6 迭代器区间构造
cpp
template <class InputIterator>
vector(InputIterator first, InputIterator last)
{
	while (first != last)
	{
		push_back(*first);
		++first;
	}
}
功能 :用任意类型 的一段迭代器区间来构造 vector。
比如:
cpp
xc::vector<int> v1 = {1, 2, 3, 4, 5};
xc::vector<int> v2(v1.begin() + 1, v1.end() - 1);   // 拷贝 v1 的中间一段

std::string s = "hello";
xc::vector<int> v3(s.begin(), s.end());             // 用 string 的迭代器构造
为什么用模板而不是具体类型?
因为"能用迭代器区间构造"这件事,对所有提供迭代器的容器都适用:
- 从
vector的区间构造; - 从
list的区间构造; - 从
string的区间构造; - 甚至从原生数组指针构造(数组名就是首地址)。
如果写死成 vector(const vector<T>& first, ...),就只能从同类 vector 构造;用模板参数 InputIterator,就能接收任意迭代器。
"InputIterator"是一个约定俗成的名字 ------它表示"输入迭代器",即至少要支持 *first(解引用)和 ++first(自增)操作。标准库自己也是用这个名字。
4.7 (n, val) 构造
cpp
vector(int n, T val = T())
{
	resize(n, val);
}
功能 :构造一个有 n 个元素的 vector,每个元素初始化为 val。
cpp
xc::vector<int> v1(10, 1);        // 10 个元素,都是 1
xc::vector<int> v2(10);           // 10 个元素,都是 0(默认值 T())
T val = T() 里的 T() 是默认构造的匿名对象 ------对 int 来说是 0,对 string 来说是空串,对自定义类型来说是默认构造的对象。
为什么写成 T val = T() 而不是 T val = 0?
因为 T 是任意类型,可能是 string、MyClass------0 无法赋给它们。用 T() 是"创建一个 T 类型的默认对象"的通用写法。
小结 :vector 的构造与析构大部分 和 string 相通,但多了三个新接口:
-
initializer_list构造------支持{}语法; -
迭代器区间构造------支持从任意区间构造;
-
(n, val)构造------批量填充。
同时,这一节也埋下了两个伏笔:
- 析构函数里
delete[] _start;会为每个元素调用T的析构函数 ------对vector<string>至关重要; vector(int n, T val = T())和迭代器区间构造的重载冲突------第 10 节专门讲。
下一节我们会讲迭代器 ------从 char* 到 T* 的泛化,以及 const_iterator 的意义。这部分相对简短,重点是把"泛化"的直觉讲清楚。
6 迭代器
vector 的迭代器非常朴素------就是 T*:
cpp
typedef T* iterator;
typedef const T* const_iterator;
和 string 篇的对比:
string 里我们用 typedef char* iterator;------同样是裸指针;
vector 里换成 typedef T* iterator;------形式一样,意义却大了一级。
因为 T 是模板参数,同一个 vector 类可以为任意类型提供迭代器。vector<int>::iterator 是 int*,vector<string>::iterator 是 string*,vector<vector<int>>::iterator 是 vector<int>*------一份代码,适配所有类型。这就是 C++ 泛型编程的魅力。
6.1 begin / end 的四个版本
cpp
iterator begin()              { return _start; }    // 指向第一个元素
iterator end()                { return _finish; }   // 指向末尾的下一个位置
const_iterator begin() const  { return _start; }
const_iterator end() const { return _finish; }两个返回类型的意义:
- 非
const版本 :返回T*,可以读写元素; const版本 :返回const T*,只能读,不能写。
这和string篇里的operator[]完全对称------const 重载是C++里非常常见的一种模式:
cpp
// 非 const 对象 → 用非 const 版本 → 可以修改
vector<int> v1 = {1, 2, 3};
*v1.begin() = 100;      // OK

// const 对象 → 用 const 版本 → 只能读
const vector<int> v2 = {1, 2, 3};
*v2.begin() = 100;      // ❌ 编译错误
6.2 const_iterator 的意义
为什么要有 const_iterator?看这个场景:
cpp
template<class Container>
void Print(const Container& con)
{
	for (auto e : con)
	{
		cout << e << ' ';
	}
	cout << endl;
}
它接收 const Container&------容器本身是 const。此时范围 for 会调用const 版本的 begin() 和 end():
cpp
// 编译器展开成:
for (auto it = con.begin(); it != con.end(); ++it)
{
	auto e = *it;
	cout << e << ' ';
}- 如果没有 const 版本的
begin(),const Container&就无法调用 begin()(非 const 成员函数不能作用于 const 对象)------Print直接编译失败; - 有了const版本 ,返回
const T*(即const_iterator)---保证遍历过程中不会意外修改元素。
在 string 篇里,我们没有实现 const_iterator(当时作为"留待扩展")。vector 篇正好把它补全------这也是两篇文章的一个小呼应。
另一层意义:类型安全。
cpp
template<class T>
void f(const vector<T>& v)
{
	for (auto& e : v)
	{
		e = T();     // ❌ 如果 v 是 const,这里编译报错
	}
}
当函数接收 const vector<T>& 时,迭代器类型自动变成 const_iterator,任何修改元素的尝试都会在编译期被拦住。这是 C++ 通过类型系统保证 const 正确性的经典应用。
6.3 范围 for 循环的原理
有了 begin() 和 end(),就可以用范围 for:
cpp
vector<int> v = {1, 2, 3, 4, 5};
for (auto e : v)
{
	cout << e << ' ';
}
编译器会把它展开成:
cpp
for (auto it = v.begin(); it != v.end(); ++it)
{
	auto e = *it;
	cout << e << ' ';
}
所以任何同时提供 begin() 和 end() 的类型,都能被范围 for 遍历------这一点在 string 篇里讲过,vector 里完全一致。
如果 v 是 const 对象 ,范围 for 会调用 begin() const 和 end() const,自动使用 const_iterator。这就是为什么我们必须实现 const 版本------否则 const 对象就无法用范围 for。
6.4 迭代器的本质:指针的抽象
到这一步,你应该能看清一个事实:
迭代器就是对指针的一层抽象。
string的迭代器是char*------指向一个char;vector<int>的迭代器是int*------指向一个int;vector<string>的迭代器是string*------指向一个string;list的迭代器是"节点指针的封装"------不再是裸指针,但行为仍然是指向一个元素。
标准库的算法 (sort、find、reverse 等)正是通过迭代器这个"统一接口",才能同时作用于 string、vector、list、map 等所有容器:
cpp
std::sort(v.begin(), v.end());         // 对 vector 排序
std::reverse(s.begin(), s.end()); // 对 string 反转算法只关心"能不能 *it、能不能 ++it、能不能比大小" ,不关心底层容器是什么------这就是迭代器设计的核心价值。
string 篇我们已经接触过这个概念,vector 篇里它以更彻底的形式出现。
7 扩容:reserve 与元素搬运
vector 和 string 一样,都需要成倍扩容 来应对增长。但 vector 的扩容比 string 多一个关键问题:元素如何从旧空间搬到新空间。
string 的元素是 char,一个字节,直接 memcpy 就行。但 vector<T> 的元素是任意类型 T------如果 T 是 string,用 memcpy 会出大问题。
这一节围绕这个核心问题展开。
7.1 reserve------扩容与三指针更新
cpp
void reserve(size_t n)
{
	if (n > capacity())
	{
		// 先记下当前的元素个数:
		// 后面 _start 会被重新赋值,_finish - _start 就不再是旧的大小了
		size_t old_size = size();
		T* tmp = new T[n];

		// 逐个把旧元素搬过来
		// 注意:这里不能用 memcpy------见正文"为什么不能用 memcpy"
		for (size_t i = 0; i < old_size; i++)
		{
			tmp[i] = _start[i];     // 对 T = string 会调用 operator=,完成深拷贝
		}

		delete[] _start;            // 释放旧空间(并为每个旧元素调用析构)
		_start = tmp;
		_finish = _start + old_size;
		_end_of_storage = _start + n;
	}
}
(1)为什么要先保存 old_size?
因为重新定位 _finish 的时候,不能再依赖 _finish - _start ------_start 已经被改成了新空间的首地址,而 _finish 还指着旧空间,两者相减得到的是垃圾值。
看下面这个错误写法:
cpp
T* tmp = new T[n];
for (size_t i = 0; i < size(); i++)     // size() = _finish - _start
{
	tmp[i] = _start[i];
}
delete[] _start;
_start = tmp;                                   // _start 指向新空间
_finish = _start + (_finish - _start);          // ❌ _finish 还指向旧空间!
_finish - _start 这一步:_finish 是"旧空间里的某个地址",_start 是"新空间的首地址"------两个不相关地址相减,结果毫无意义。
正确做法 :在 _start 改变之前 ,先把元素个数保存到 old_size:
cpp
size_t old_size = size();       // ← 在 _start 被覆盖前先算好
...
delete[] _start;
_start = tmp;
_finish = _start + old_size;    // ✅ 用旧大小,正确
(2)为什么需要 delete\[\] _start?
扩容的本质是"申请新空间 → 搬数据 → 释放旧空间"。delete[] _start 就是最后一步------释放旧空间。
注意 delete[] 会为旧空间里的每个元素调用析构函数 。这一点很重要:对 vector<string>,它会析构每个旧 string,释放各自的堆内存。
(3)三指针如何更新?
扩容完成后,需要重新定位三个指针:
cpp
_start = tmp;                       // 起点:新空间首地址
_finish = _start + old_size;        // 终点:新空间首地址偏移 old_size
_end_of_storage = _start + n;       // 容量末:新空间首地址偏移 n
_finish = _start + old_size:因为搬过来了old_size个元素;_end_of_storage = _start + n:因为新容量就是n。
7.2 核心问题:为什么不能用 memcpy?
现在来看本节最重要的问题:搬元素为什么不能用 memcpy?
先看"错"的写法:
cpp
// ❌ 错误示范
T* tmp = new T[n];
memcpy(tmp, _start, sizeof(T) * old_size);
delete[] _start;
问题分析 :memcpy 是按字节复制 ------它把 _start 指向的那段字节,原样拷贝 到 tmp。对于简单类型(int、double、指针),这没问题------复制字节就是复制值。
但 string 不简单 。它的内部有一个 char* _str 指针------memcpy 会把这个指针的值直接复制过去。
结果:
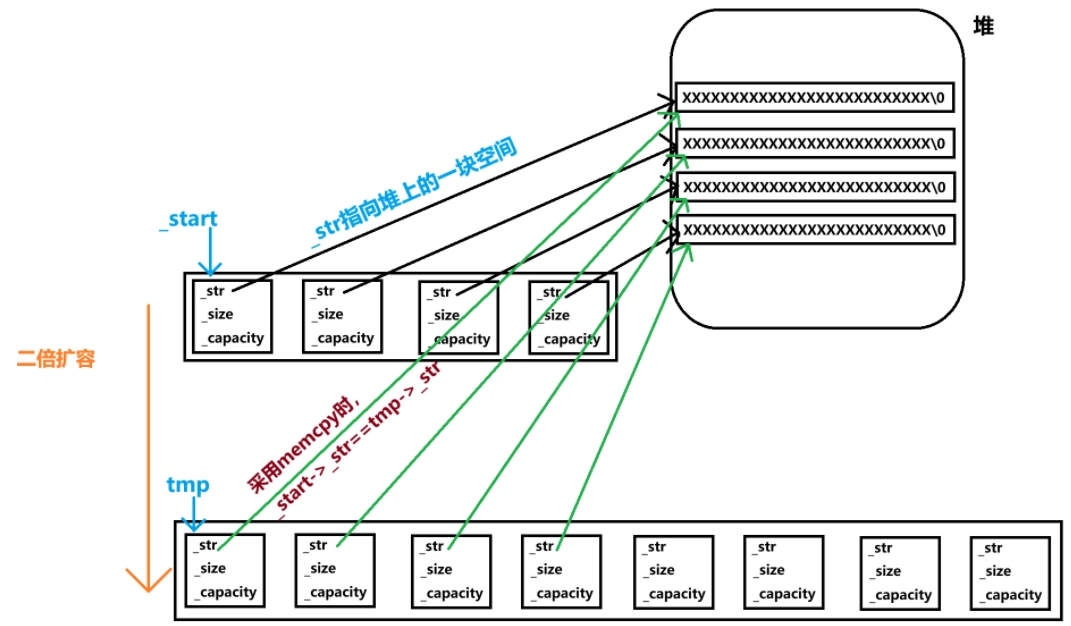
这就出了两个问题:
问题一:共享资源
新旧的 string 都指向同一块 _str 内存------修改任何一个,另一个也变。
问题二:二次释放
扩容完成后执行 delete[] _start------它会析构旧空间的 string,释放 _str 指向的堆内存。然后程序运行下去,新空间的 string 析构时,又会 delete[] _str------同一块内存被释放两次,程序崩溃。
这就是"深层次的浅拷贝问题":memcpy 做的是浅拷贝(复制字节),但 string 内部还有更深一层的资源(堆上的字符数组)------浅拷贝让两个对象共享了这块资源。
7.3 正确做法:用赋值触发 T::operator=
正确的做法是逐个元素赋值:
cpp
for (size_t i = 0; i < old_size; i++)
{
	tmp[i] = _start[i];
}
tmp[i] = _start[i] 调用的是 T 的 operator=:
- 对
int,就是普通的整数赋值(浅拷贝一个整数); - 对
string,是string::operator=------它会重新申请一块独立的内存 ,把字符内容拷过去。这就是深拷贝; - 对
vector<int>,同理,内部会递归地做深拷贝。
这就是为什么 string 篇讲过的"深拷贝"在 vector 里依然重要 ------只不过这次它发生在容器的层面:
string篇讲的是"类自身"的深拷贝(拷贝构造、赋值运算符);vector篇讲的是"容器在搬运元素"时的深拷贝(赋值触发T::operator=)。
两者本质是同一个问题:只要涉及指针,就不能简单复制字节,要让对象自己决定如何复制。
7.4 关于 tmpi = _starti 的一个细节
你可能会问:tmp[i] = _start[i] 是"赋值",而 tmp 里的元素是未初始化的 (new T[n] 会调用 T 的默认构造)。给一个未初始化对象"赋值"有意义吗?
有意义的 ------因为 new T[n] 已经调用了默认构造 ,tmp[i] 已经是一个有效的 T 对象了。然后 tmp[i] = _start[i] 调用 T::operator=,用 _start[i] 覆盖它。
更高效的做法 是用拷贝构造(直接构造,不用先默认构造再赋值):
cpp
// 伪代码
for (size_t i = 0; i < old_size; i++)
{
	new (&tmp[i]) T(_start[i]);   // 定位 new,用拷贝构造直接构造 tmp[i]
}但这就涉及定位 new 的语法,超出本文范围。而且对于教学实现来说,tmp[i] = _start[i] 完全够用------现代编译器可能也会优化掉那次默认构造的开销。
标准库用的是另一套办法 :它把 new T[n] 拆成"分配原始内存"(operator new)+"用 std::uninitialized_copy 在原始内存上构造"两步。这样能保证"分配内存"和"构造对象"分离,效率更高、更灵活。但代价是代码复杂很多,不适合教学入门。
所以我们采用new T[n] + 赋值的方案------牺牲一点效率,换来代码的简洁清晰。
7.5 一个对比:string vs vector 的 reserve
| 维度 | string::reserve | vector::reserve |
|---|---|---|
| 分配内存 | new char[n + 1] |
new T[n] |
| 搬运元素 | memcpy(str, _str, _size + 1) |
tmp[i] = _start[i];(逐个赋值) |
| 为什么 | char 是简单类型,直接按字节拷贝 |
T 可能是 string 等复杂类型,必须调用 T::operator= |
| 更新状态 | _capacity = n; |
_start, _finish, _end_of_storage 三个指针全部更新 |
一句话对比:
string::reserve关心的是"拷贝多少字节";vector<T>::reserve关心的是"如何让每个元素自己决定怎么复制"。
这就是泛化带来的本质区别。
小结 :reserve 是 vector 里最能体现泛型优势与陷阱的函数:
- 三指针更新 :
_start变了之后,_finish - _start就不再是旧的大小,所以要先保存old_size; - 不能用
memcpy:T可能是string,memcpy会导致"深层次的浅拷贝"------两个string共享堆内存、二次释放; - 用赋值触发
T::operator=:对string自动深拷贝,正确安全; - 教学版牺牲一点效率 :
new T[n]会先默认构造再赋值,标准库用定位 new 避免这个开销。
8 push_back、pop_back 与 resize
这一节讲三个"改变大小"的接口:
push_back/pop_back:在末尾追加/删除一个元素;resize:一次性把size调整到指定值。
它们都依赖 reserve,所以放在 reserve 之后讲。
8.1 push_back------末尾追加
cpp
void push_back(const T& x)
{
	if (_finish == _end_of_storage)
	{
		reserve(capacity() == 0 ? 4 : 2 * capacity());   // 成倍扩容
	}
	*_finish = x;      // 在末尾位置构造新元素
	++_finish;
}三个要点:
- 判断条件是
_finish == _end_of_storage
_finish 指向"末尾的下一个位置",_end_of_storage 指向"容量的末尾"。两者相等,说明已经用完了当前所有容量,必须扩容。
这和 string 篇里的 if (_size >= _capacity) 是同一个判断------只是用指针表达更自然。
- 成倍扩容
cpp
capacity() == 0 ? 4 : 2 * capacity()和 string 完全一样:第一次分配 4 个元素的位置,之后每次翻倍。原因(string 篇 7.2 已经讲过)不再重复。
*_finish = x;是赋值,不是构造
注意这里:
cpp
*_finish = x;_finish 指向的是已经构造好的对象(new T[n] 时调用过 T 的默认构造),所以这里是赋值------调用 T::operator=。
- 对
int:普通整数赋值; - 对
string:string::operator=,深拷贝字符串内容。
这和标准库的 push_back 略有不同 :标准库用定位 new 直接在"原始内存"上构造对象,避免先默认构造再赋值。但那涉及 operator new 和定位 new,本篇为了简化,统一用"new T[n] + 赋值"。
8.2 pop_back------末尾删除
cpp
void pop_back()
{
	assert(!empty());  // 空 vector 不允许再删
	--_finish;
}
极其简单 ------只要把 _finish 往前挪一格。
8.3 empty / size / capacity
cpp
bool empty() const
{
	return _start == _finish;
}
size_t size() const
{
	return _finish - _start;
}
size_t capacity() const
{
	return _end_of_storage - _start;
}三个函数都是一行------用指针减法直接得到结果。这也体现了三指针模型的优势:不额外保存大小,需要时算一下就行。
8.4 resize------调整 size
cpp
void resize(size_t n, T val = T())    // T() 是"默认构造的临时对象"
{
	if (n > size())
	{
		if (n > capacity())
		{
			reserve(n);                // 先扩容
		}
		while (_finish < _start + n)
		{
			*_finish = val;            // 多余的位置用 val 填充
			++_finish;
		}
	}
	else
	{
		_finish = _start + n;          // 缩短:只改 _finish,不动内存
	}
}
resize 的语义 :把 vector 的元素个数调整到 n。
三种情况:
情况一: n < size()(缩短)
cpp
_finish = _start + n;直接把 _finish 前移,逻辑上"丢掉"后面的元素。不释放内存 ------capacity 不变。所以 resize 缩小是 O(1) 的。
情况二: size() < n <= capacity()(填充,不扩容)
cpp
while (_finish < _start + n)
{
	*_finish = val;
	++_finish;
}
用 val 依次填充 [_finish, _start + n) 范围内的位置。
情况三: n > capacity()(填充,要扩容)
cpp
if (n > capacity())
{
	reserve(n);      // 先扩容
}
while (...) { ... } // 再填充调用示例:
cpp
xc::vector<int> v;
v.push_back(1);
v.push_back(2);
v.push_back(3);
// v = [1, 2, 3]

v.resize(10, 0);     // 扩容到 10 个元素,新增的是 0
// v = [1, 2, 3, 0, 0, 0, 0, 0, 0, 0]

v.resize(5, 1);      // 缩短到 5 个元素
// v = [1, 2, 3, 0, 0]

v.resize(2, 1);      // 再缩短到 2 个元素
// v = [1, 2]
8.5 resize 与 reserve 的区别
这是 string 篇没细讲、vector 篇需要补上的知识点。
| 接口 | 改变 size? | 改变 capacity? | 是否初始化元素? |
|---|---|---|---|
| reserve(n) | 否 | 是(只扩,缩时不处理) | 否 |
| resize(n) | 是 | 可能(只有 n > capacity() 时扩) | 是(用 val 填充) |
一句话理解:
reserve只动容量,不动元素 ------它只是"预留空间",size不变;resize动元素个数 ------多的填val,少的丢弃。
典型用途:
reserve(n):提前一次性开好空间,避免后续多次push_back过程中反复扩容;resize(n):把vector当作"定长数组"使用,一次性设置元素数量。
9 insert、erase 与迭代器失效
insert 和 erase 是 vector 里最容易踩坑 的两个接口,因为它们的实现涉及数据挪动,而数据挪动又会导致迭代器失效。
这是 vector 独有的问题------string 篇没遇到,因为 string 的迭代器我们用得少,而且 string 内部的坑主要是"无符号下溢"。
9.1 insert------在指定位置插入元素
cpp
iterator insert(iterator pos, const T& x)
{
	assert(pos >= _start);
	assert(pos <= _finish);

	if (_finish == _end_of_storage)
	{
		// 扩容会更换 _start,导致 pos 失效
		// 先用下标把 pos 的位置记下来,扩容后再重新定位
		size_t len = pos - _start;
		reserve(capacity() == 0 ? 4 : 2 * capacity());
		pos = _start + len;
	}

	// 从后往前挪动数据,给 pos 腾出空位
	iterator end = _finish;      // 从"末尾的下一个位置"开始
	while (end > pos)
	{
		*end = *(end - 1);
		--end;
	}
	*pos = x;
	++_finish;
	return pos;                  // 返回插入位置的新迭代器
}
数据的方向和 string::insert 一致------从后往前,避免覆盖还没处理的数据,这里不再重复。
需要注意的一个小细节 :循环条件用 end > pos 而不是 end >= pos。
- 用
>=的话,end会从pos继续减到pos - 1------如果pos == _start,就会越界到数组前面,是未定义行为; - 用
>则让循环在end == pos时自然退出,不会越界。
这和 string 篇里"多预留一个位置"的技巧是同一个思想的两种表达------都是为了避免边界处的越界。
迭代器失效:扩容让 pos 变成野指针
这是本节最重要的坑。
insert 里如果触发扩容,reserve 会重新申请一块内存 ,然后 _start 指向新空间。此时原来的 pos 还指向旧空间 ------它变成了悬空指针(野指针):
扩容前:  _start ──► [10][20][30][40] ...
                      ↑
                      pos

扩容后:  _start ──► [10][20][30][40][ ]...   ← 新空间

          pos ──► (旧空间已被 delete[] 释放)  ← 悬空!
如果继续用 pos 挪数据,就会往已释放的内存里写------未定义行为,可能静默破坏数据,也可能直接崩溃。
正确做法 :在扩容之前 ,先把 pos 的相对位置 (下标)存下来;扩容完成后,用 _start + 下标 重新算出 pos:
cpp
if (_finish == _end_of_storage)
{
	size_t len = pos - _start;                    // 存下标
	reserve(...);                                 // 扩容,_start 变了
	pos = _start + len;                           // 重新定位 pos
}
这就是 vector 里"迭代器失效"最经典的一种场景 ------不是迭代器本身坏了,而是它指向的地址在扩容后已经被释放。
9.2 erase------删除指定位置的元素
cpp
iterator erase(iterator pos)
{
	assert(pos >= _start);
	assert(pos < _finish);

	// 把 pos 之后的数据整体前移一格
	iterator it = pos + 1;
	while (it < _finish)
	{
		*(it - 1) = *(it);
		++it;
	}
	--_finish;

	return pos;                  // 返回"被删除位置"的新迭代器(即原来 pos+1 处的元素)
}
挪数据的方向和 string::erase 一致 ------从前往后,把 pos 之后的数据整体前移一格,覆盖掉被删除的元素。这里不再重复。
返回值是 pos,不是 pos + 1。erase 返回的是"被删除位置的新迭代器":
-
删除
pos位置的元素后,原来pos + 1位置的元素会前移到pos; -
所以"下一个有效元素"就是
pos本身(它现在指向原来的pos + 1)。
这在循环删除时非常重要:
cpp
auto it = v.begin();
while (it != v.end())
{
	if (*it % 2 == 0)
	{
		it = v.erase(it);    // ✅ 用 erase 的返回值更新 it
	}
	else
	{
		++it;
	}
}
如果写 v.erase(it); 而不接收返回值,it 就失效了 ------不能再 ++it 或 *it。这就是第二种迭代器失效。
9.3 迭代器失效:两种典型场景
总结一下 vector 里最容易踩的两种迭代器失效:
场景一:扩容导致所有迭代器失效
insert 或 push_back 触发 reserve → _start 变了 → 之前拿到的所有迭代器(包括 begin()、 end()、以及任何指向 vector 的指针)全部失效。
场景二:erase 导致删除位置之后的迭代器失效
erase(pos) 删掉 pos 位置的元素后,pos 之后的元素整体前移 ------所以 pos 及其之后的迭代器全部失效(它们指向的地址虽然还有效,但指向的元素已经变了)。
两个使用建议:
- 别让迭代器的生命周期跨越可能扩容的操作------拿到一个迭代器后,如果中间做了 push_back、insert、reserve 等操作,这个迭代器就可能失效。比如:
cpp
auto it = v.begin();
v.push_back(100);      // 可能扩容
*it = 200; // ❌ it 可能已经失效erase一定要接收返回值:
cpp
it = v.erase(it);      // ✅ 正确
v.erase(it);           // ❌ it 失效,后续不能再使用
为什么 vector 这么容易失效? 因为它的元素是连续存储 的------扩容就要换一块内存,删除就要整体前移。而 list、map 这类容器的元素在内存里是分散的,所以它们的迭代器通常只在删除被删元素本身时才失效。
这也是 vector 和 list 的核心权衡:
vector:访问快(连续内存、随机访问 O(1)),但插入删除代价大(要挪数据);list:插入删除快(改指针 O(1)),但访问慢(只能顺序遍历 O(N))。
9.4 和 string 篇的一个对比
| 对比项 | string::insert |
vector::insert |
|---|---|---|
| 返回值 | string&(自身引用) |
iterator(新位置迭代器) |
| 挪动方向 | 从后往前 | 从后往前 |
| 无符号下溢 | 用"多预留一个位置"规避 | 指针不会下溢,只需用 > 条件 |
| 迭代器失效 | 不常涉及 | 主要问题 (扩容更换 _start) |
| 扩容后如何处理旧 pos | 不涉及(string 没有"pos 迭代器"概念) | 先存下标,扩容后重新算 |
核心差异 :string 的 insert 参数是 pos(下标),vector 的 insert 参数是 pos(迭代器)------下标在扩容后依然有效 ,但迭代器在扩容后会失效。
这也是为什么 vector 的实现里多了一步"存下标、扩容、重新定位"------它必须处理迭代器失效的问题。
小结 :insert 和 erase 的核心要点:
- 数据挪动方向 :
insert从后往前,erase从前往后; - 迭代器失效 :扩容或删除都会导致迭代器失效------这是
vector独有的坑; insert里必须"存下标 → 扩容 → 重新定位" ,避免用悬空的pos;erase必须接收返回值 ,it = v.erase(it);是循环删除的正确姿势;- 和
string对比 :string的insert用下标,vector的insert用迭代器------这就是"迭代器失效"只在vector里成为大问题的原因。
10 构造函数重载陷阱
这是 vector 设计上的一个著名事故------两个看起来很正常的构造函数:
cpp
vector(int n, T val = T());                        // 版本 A:n 个元素,每个都是 val
vector(size_t n, T val = T());                     // 版本 A':同上,只是参数类型不同
template<class InputIterator>
vector(InputIterator first, InputIterator last); // 版本 B:从迭代器区间构造单独看都没问题。但在某些情况下,用户明明想调用版本 A("n 个元素,每个都是 val"),编译器却选了版本 B ------把两个整数当成"起始迭代器"和"结束迭代器",然后尝试解引用一个整数------程序崩溃。
这不是理论上的可能性,而是真实发生过的 bug。下面我们看它到底怎么触发。
10.1 重载决议:什么条件下会"选错"?
要理解这个陷阱,先要知道 C++ 重载决议的两条规则:
规则一:精确匹配 > 类型转换匹配
如果两个候选函数都能匹配实参,但一个需要类型转换、另一个不需要,那么不需要转换的胜出。
规则二:非模板 > 模板
如果两个候选函数的匹配程度完全相同 ,那么非模板函数优先。
这两条规则组合起来,决定了 (n, val) 和迭代器区间这两个构造函数谁会被选中:
| 候选函数 | 匹配情况 |
|---|---|
vector(int n, T val) |
实参类型必须能"精确匹配"或"转换匹配" int |
vector(size_t n, T val) |
实参类型必须能"精确匹配"或"转换匹配" size_t |
vector(InputIterator, InputIterator)(模板) |
实参类型可以被推导为 InputIterator,几乎总能"精确匹配" |
关键点 :模板版本对任何 类型都是"精确匹配"------int、double、char*,甚至指针都能被推导成 InputIterator。所以只要 (n, val) 版本需要类型转换(即传入的类型和 int /size_t 不完全一样),模板就会以"精确匹配"胜出。
换句话说:
只要两个实参的类型既不是
int,也不是当前平台的size_t,模板版本就会"抢走"调用。
这就是陷阱的触发条件。它依赖于平台 ------因为 size_t 在不同平台下类型不同,所以同一段代码可能 32 位正常、64 位崩溃。
10.2 为什么 32 位能跑,64 位崩溃?
我们的代码里额外加了一个 size_t 版本:
cpp
vector(int n, T val = T());       // ①
vector(size_t n, T val = T());    // ②
template<class InputIterator>
vector(InputIterator first, InputIterator last);   // ③
Test.cpp 里演示了两种调用:
cpp
xc::vector<int>    v6(6, 3);      // 两个 int
xc::vector<size_t> v7(6u, 3u);    // 两个 unsigned int
诡异的现象 :在 X86(32 位)上,程序能跑 ;在 X64(64 位)上, v7 崩溃 。原因在于 size_t 在两种平台下类型不同:
| 平台 | size_t 实际类型 |
6u 与 size_t 的关系 |
|---|---|---|
| X86 | unsigned int(4 字节) |
6u 和 size_t 类型完全相同 |
| X64 | unsigned long long(8 字节) |
6u(unsigned int)和 size_t 类型不同 |
逐个分析:
v6(6, 3)------所有平台都正常
两个参数都是 int,直接精确匹配 ① vector(int, T)。模板 ③ 虽然也能匹配(InputIterator = int),但 ①是非模板函数 ------在两个都是精确匹配时,编译器优先选非模板 。所以 v6 在任何平台都走 ①。
v7(6u, 3u)------X86 正常,X64 崩溃
- X86 :
size_t == unsigned int,所以 6u 精确匹配 ② 的 size_t。② 和 ③ 都是精确匹配------非模板 ② 优先。走 ②,正常; - X64 :
size_t == unsigned long long,6u是unsigned int------需要转换 。而 ③ 模板对6u是精确匹配(InputIterator = unsigned int)。精确匹配 > 类型转换,所以 ③ 胜出------走迭代器区间,崩溃。
换成表格:
| 平台 | size_t 类型 |
v6(6, 3) |
v7(6u, 3u) |
|---|---|---|---|
| X86 | unsigned int |
走 ① (int, T) ✅ |
走 ② (size_t, T) ✅ |
| X64 | unsigned long long |
走 ① (int, T) ✅ |
走 ③ 迭代器区间 ❌ |
这个现象说明一件重要的事:
加
size_t重载并没有真正解决问题,只是让 32 位平台"碰巧"过关。
因为 32 位平台的 size_t 恰好等于 unsigned int,所以 6u 精确匹配了 ②;但 64 位平台下 size_t 变成了 8 字节,这个"巧合"就消失了。
再举两个例子(都是在 64 位平台下):
cpp
xc::vector<int>  v8(6u, 3u);      // ⚠️ 走 ③ 迭代器区间------崩溃
xc::vector<long> v9(6L, 3L);      // ⚠️ 走 ③ 迭代器区间------崩溃
xc::vector<char> v10(6, 'a');     // ✅ 走 ① (int, T)------正常
规律是:
只要两个实参的类型不是
int或当前平台的size_t,模板版本 ③ 就会"抢走"调用。
这就是为什么标准库要约束版本 ③ 只在真正的迭代器传入时才生效------否则任何整数都会触发这个陷阱。
10.3 标准库是怎么彻底解决的?
标准库不靠"加 size_t 重载"来绕开,而是约束版本 B 只在 InputIterator 真的是迭代器时才生效 ------用 SFINAE 或 C++20 的 concept。
SFINAE 写法:
cpp
template<class InputIterator,
         class = std::enable_if_t<is_iterator_v<InputIterator>>>
vector(InputIterator first, InputIterator last);
C++20 的 concept 写法:
cpp
template<std::input_iterator InputIterator>
vector(InputIterator first, InputIterator last);核心思想是一样的:给 InputIterator 加一个"必须是迭代器"的约束 。6 和 6u 都是整数,不是迭代器,所以版本 B 被踢出候选集 ------只剩下版本 A 参与重载------问题彻底解决。
C++20 的 concept 就是为了解决这类问题而生的------给模板参数加约束,把"看起来能匹配"变成"必须真的满足语义要求"。
我们的代码没有引入 SFINAE / concept------那样会引入 enable_if_t、iterator_traits 等偏底层的语法,超出"实现一个简易 vector"的范围。如果读者对这方面知识感兴趣可以自行查阅。
总结 :这个陷阱是 vector 设计上的历史遗留问题,标准库后来通过 SFINAE / concept 修复了;但在用户代码里同时写 (n, val) 和迭代器区间两种构造函数时,要小心这个坑。
10.5 一个启示
vector 的这个坑说明:
泛型和重载放在一起,很容易产生意外。
模板构造函数 vector(InputIterator, InputIterator) 本意是"从任意区间构造",但它泛化得太宽了------int、double、甚至指针都能被当作 InputIterator 推导出来。于是和 (n, val) 构造函数撞车。
这也解释了一个 C++ 演进的方向 ------从 C++98 的裸模板,到 C++11 的 SFINAE,再到 C++20 的 concept,本质上都是在解决同一个问题:如何给泛型代码加约束,让"看起来能匹配"变成"必须真的满足语义要求"。
12 写在最后
到这里,一个功能相对完整的 vector 类就实现完毕了。从三文件框架,到构造、析构、拷贝、扩容、插入、删除、迭代器失效------vector 的核心接口我们几乎都过了一遍。
回顾全程,最值得记住的是这几件事:
- 模板带来的泛化
vector<T>把"元素类型"抽象出来,同一份代码可以管理int、string、vector<int>等任意类型。迭代器从char*泛化到了T*,算法从"针对某种容器"泛化到了"针对任意容器"。 - 元素搬运不能用
memcpy
string的元素是char,可以直接memcpy;vector<T>的元素是任意类型------如果T = string,memcpy会让新旧两个string的_str指向同一块内存,在容器层面重现浅拷贝问题 。正确做法是用赋值(触发T::operator=)逐个搬运。 - 迭代器失效
vector的迭代器是T*,指向具体地址。扩容换了一块内存,所有迭代器都失效;erase让后面的元素前移,被删位置之后的迭代器都失效。这是vector独有的坑------因为它的元素是连续存储的。 - 构造函数重载陷阱
vector(int n, T val)和vector(InputIterator, InputIterator)在传两个整数时会互相"抢活"。标准库用 SFINAE / concept 约束模板只接受真正的迭代器------这也是 C++ 从 C++98 到 C++20 一直在演进的方向:给泛型代码加约束。
结语
`vector` 是 C++ 里最常用的容器之一,也是**从"具体类型"跨越到"泛型编程"** 的第一步。
string 让你理解了动态数组 的封装;vector 让你理解了模板如何把封装泛化到任意类型 。这两步走下来,你已经摸到了 C++ 泛型编程的门槛------vector 之后,list、map、set 的实现思路都是相通的。
更重要的是,通过实现 string 和 vector,你学会的不只是这两个容器------深拷贝的思想可以应用到你写的每一个自定义类型,迭代器失效的规则可以帮你避开工程里的隐蔽 bug,重载陷阱的分析方法可以帮你在设计 API 时少踩坑。
希望这篇文章对你有帮助。
本文代码环境:Visual Studio 2022 / C++11 及以上
完整代码仓库:见评论区
如果本文对你有帮助,欢迎点赞、收藏、关注------你的支持是我持续更新的最大动力!如有疑问,欢迎在评论区留言讨论~