TL;DR: ActionPlan 提出了"帧级动作规划"(per-frame action plan)的概念,让模型在生成3D人体动作之前,先为每一帧规划一个"语义锚点"(text latent),然后用这些锚点引导动作去噪。这一设计使得同一个模型既能做高质量的离线生成,也能做5.25倍速的实时流式生成,还能零样本支持动作编辑和中间帧补全。
一、开门见山:这个项目到底解决了什么问题?
想象你是一个游戏AI导演,需要让NPC根据剧情实时做出反应------上一秒还在"悠闲散步",下一秒就要"惊恐逃跑"。传统的人体动作生成模型面临一个两难困境:
离线模型质量高,但必须等整段动作全部算完才能播放。就像一个编剧必须把整集剧本写完,演员才能开始表演。
流式模型可以边想边演,但往往"走一步看一步",缺乏对未来的规划,导致动作质量下降、过渡生硬。
ActionPlan 的核心洞察是:人类在做动作时,大脑会提前为每一帧规划一个"意图快照"。当你决定"走过去然后转身"时,你的大脑不是等到走到终点才决定转身------它在迈步之前就已经为未来每一帧设定了语义目标:"走...走...走...转身...转...停"。
ActionPlan 把这种"帧级规划"变成了可学习的数学结构。具体来说:
- 它解决的问题:如何在保持生成质量的前提下,实现真正实时的、可交互的流式人体动作生成?
- 它的创新点:引入帧级文本潜在变量(frame-level text latents)作为"动作计划",让模型在去噪过程中同时拥有"语义指引"和"运动线索"。
- 它的效果:实时流式模式比此前最好的方法快5.25倍,同时动作质量(FID)提升18%。
这不是渐进式改进,而是范式级的突破。让我们深入看看它是怎么做到的。
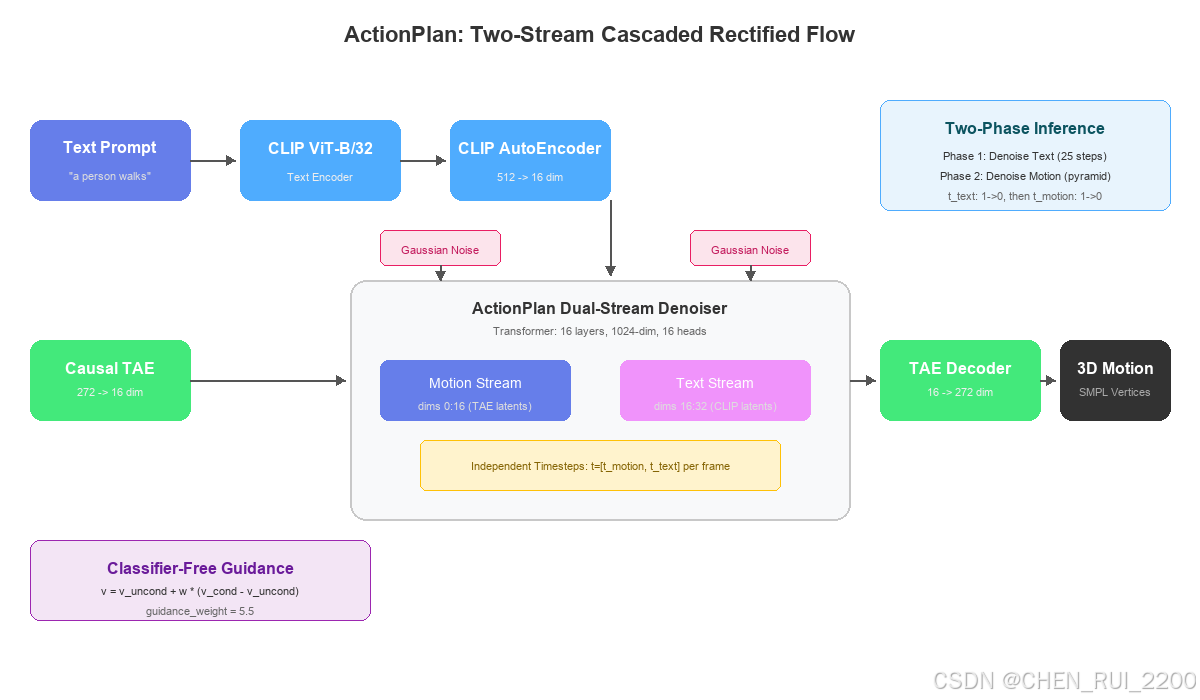
图1:ActionPlan整体架构。双流级联整流流(Two-Stream Cascaded Rectified Flow),先解码文本潜在变量(Phase 1),再用其引导动作去噪(Phase 2)。
二、核心创新:帧级动作规划
2.1 从"一句话描述"到"逐帧剧本"
传统文本到动作(Text-to-Motion)模型的工作方式是:输入一句文本描述(如"一个人在走路"),输出整段动作。这个文本描述是全局的------它告诉模型"这段动作整体是什么样的",但无法精确控制每一帧应该发生什么。
ActionPlan 的突破在于引入了帧级文本潜在变量(frame-level text latents)。具体来说:
- 输入:一个全局文本描述 → CLIP编码器 → 512维全局文本嵌入
- 中间:CLIP自编码器 → 将512维压缩为16维 → 为每一帧生成一个16维的"语义锚点"
- 输出:这些逐帧的语义锚点构成了"动作计划"(Action Plan)
打个比方:传统模型像是给演员一句台词"你要表现出从开心到悲伤的转变",而ActionPlan则给演员一份分镜脚本------第1-10帧"微笑"、第11-15帧"笑容渐收"、第16-20帧"眉头微蹙"、第21-30帧"低头叹息"。
这种设计的精妙之处在于:这些帧级语义锚点不是人工标注的,而是模型自己学习生成的。在训练时,模型从带有帧级文本标注的数据集(BABEL)中学习如何从全局描述推断出逐帧的语义计划。
2.2 双流架构:运动和语义的交响乐
ActionPlan 的潜在空间是一个32维的联合空间:
- 维度0-15:运动潜在变量(motion latents),由TAE(时序自编码器)从272维SMPL运动特征压缩而来
- 维度16-31:文本潜在变量(text latents),由CLIP自编码器从帧级文本嵌入压缩而来
这两个流在去噪过程中共享同一个Transformer,但拥有独立的时间步(timestep)。这意味着:
- 运动流可以处于"几乎完成去噪"的状态(t_motion ≈ 0)
- 同时文本流可以处于"刚开始去噪"的状态(t_text ≈ 1)
- 或者反过来
这种灵活性是ActionPlan实现多种采样策略的基础。
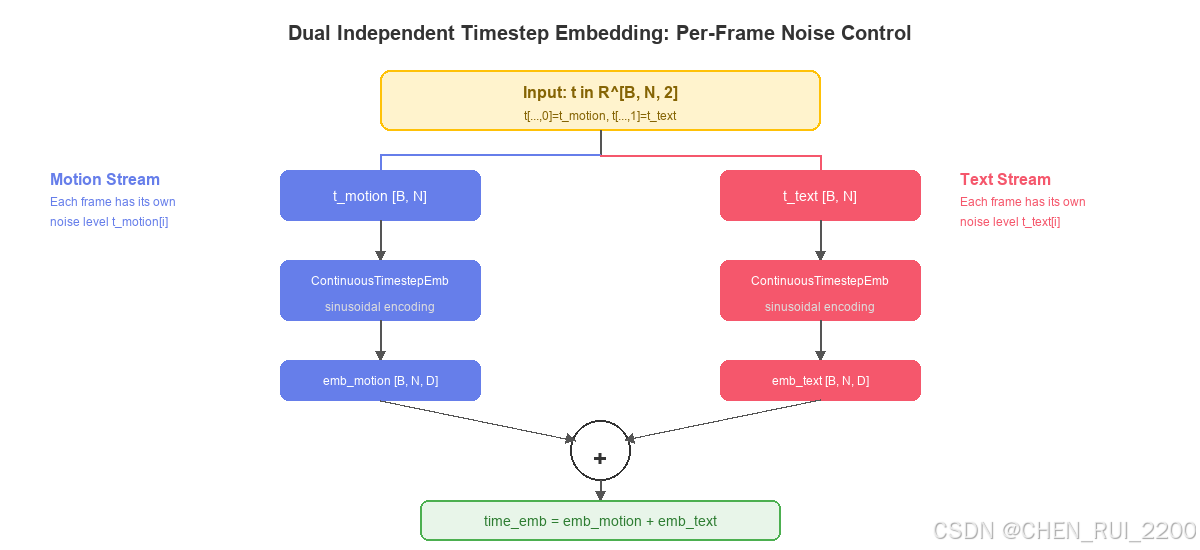
图2:双流独立时间步嵌入。每个流有独立的连续时间步编码器,它们的嵌入相加后送入Transformer。这使得模型可以在同一时刻对不同帧、不同流使用完全不同的噪声水平。
三、时序自编码器:4倍压缩的秘密
在理解ActionPlan的去噪过程之前,我们需要先理解数据是如何被压缩的。
3.1 从30fps到7.5fps
原始的人体动作数据(SMPL-H参数)是30fps的272维特征序列。直接在这个空间上做扩散模型太慢了------每一秒有30帧,10秒的视频就是300帧,每帧272维。
ActionPlan使用了一个**因果时序自编码器(Causal TAE)**来解决这个问题:
- 编码器:272维 → 16维,同时做4倍时间下采样(30fps → 7.5fps)
- 解码器:16维 → 272维,4倍时间上采样(7.5fps → 30fps)
"因果"(Causal)是关键------编码器在编码第t帧时只能看到第0到第t帧的信息,不能偷看未来。这使得TAE可以在流式场景中实时工作:每来一帧新数据,就能立即编码并输出潜在变量。
10秒的动作 = 300帧原始数据 → 压缩为75个16维潜在变量。这不仅减少了数据量,更重要的是降低了扩散模型需要处理的序列长度。
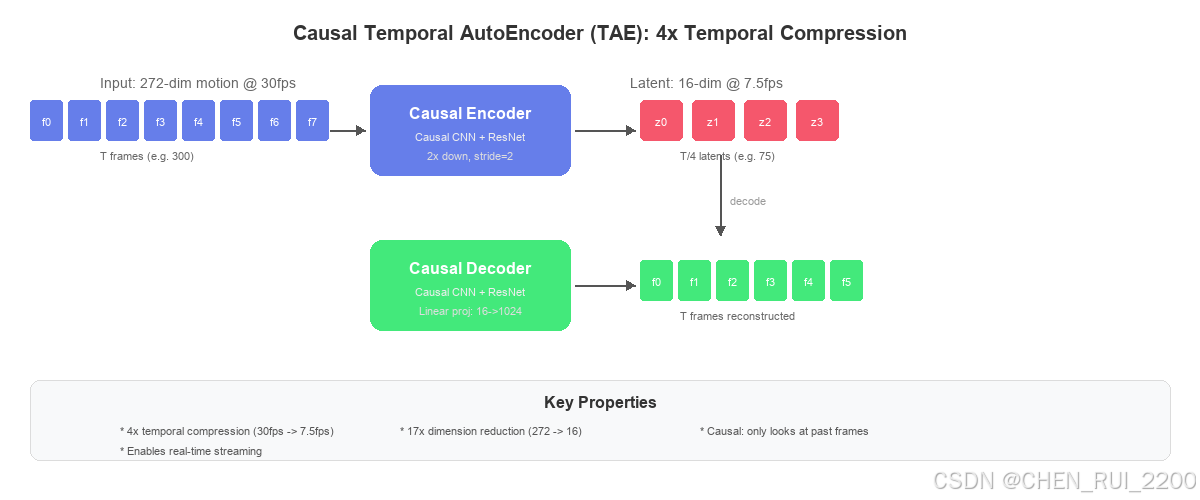
图3:因果时序自编码器(TAE)。272维运动序列以30fps输入,经过因果CNN编码器压缩为16维潜在序列(7.5fps),再由解码器重建。4倍时间压缩使得扩散模型只需处理1/4的序列长度。
3.2 为什么是16维?
16维这个数字不是随便选的。它是在"压缩率"和"信息保留"之间的平衡点:
- 太小(如8维):丢失太多运动细节,解码后动作僵硬
- 太大(如32维):压缩不够,扩散模型仍然很慢
- 16维:恰好能保留足够的运动信息,同时将序列长度压缩到扩散模型可以高效处理的范围
实验证明,16维的TAE潜在空间能够重建出高质量的运动序列,FID指标接近直接在272维空间上建模。
四、训练:异构噪声调度的精妙设计
4.1 每个帧都有自己的噪声水平
传统扩散模型在训练时,对整个序列采样一个统一的时间步t。所有帧在同一时刻处于相同的噪声水平。
ActionPlan打破了这个限制。它的训练策略是:
- 运动流:每一帧独立采样 t_motioni ~ U(0,1)。这意味着在同一训练样本中,第3帧可能几乎干净(t=0.1),而第7帧几乎全是噪声(t=0.9)。
- 文本流:整个序列共享一个 t_text ~ U(0,1)。但如果某个样本没有帧级文本标注(约60%的训练数据),则 t_text = 1.0(纯噪声),并且文本维度的损失被掩码掉。
这种"异构噪声调度"(heterogeneous noise schedule)看起来只是训练时的一个小技巧,但它实际上是为推理时的灵活性埋下的伏笔。
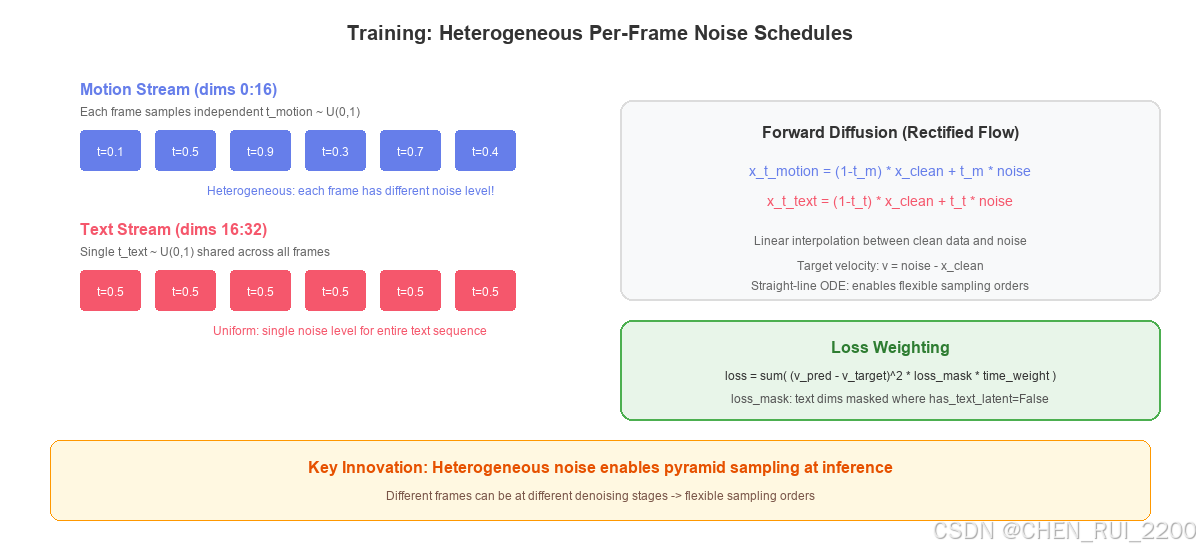
图4:训练时的异构噪声调度。运动流的每一帧独立采样噪声水平,文本流则共享单一噪声水平。这种设计使得模型在推理时可以对不同帧使用不同的去噪进度。
4.2 前向扩散:直线ODE的优雅
ActionPlan使用的是**整流流(Rectified Flow)**而非传统的DDPM。整流流的前向过程是一条从干净数据到纯噪声的直线:
x_t = (1 - t) * x_clean + t * noise速度场的预测目标是 v = noise - x_clean。
这种线性插值有一个重要性质:它定义了一个直线ODE(常微分方程),使得采样路径尽可能直。直线意味着更少的步数就能从噪声走到数据------这正是ActionPlan能用很少步数(如10步)完成高质量生成的原因。
4.3 损失函数:双流失衡的艺术
损失函数需要处理两个流的不同情况:
loss = Σ (v_pred - v_target)² × loss_mask × time_weight- loss_mask:对于没有文本标注的样本,文本维度(16:32)的损失被设为0
- time_weight:由时间采样器给出的重要性权重(logit-normal采样)
- sigma loss:额外的不确定性预测损失,帮助模型估计预测的置信度
这种精心设计的损失函数确保了模型能够同时学习"有文本时的联合去噪"和"无文本时的纯运动去噪",为推理时的两阶段级联打下基础。
五、推理:两阶段级联去噪
ActionPlan的推理过程分为两个阶段,就像先写剧本再排戏。
5.1 Phase 1:先写"动作剧本"
Phase 1 的目标是从纯噪声中生成帧级文本潜在变量------也就是"动作计划"。
具体过程:
- 初始化:32维潜在序列全部为随机噪声(t_motion=1.0, t_text=1.0)
- 在25个去噪步中,只更新文本维度(16:31),运动维度(0:15)保持为噪声
- 每一步:t_text从1.0逐渐降到0.0,t_motion始终保持1.0
- 结果:文本维度变成了干净的帧级语义锚点,运动维度仍是噪声
这一步的直觉是:模型先根据全局文本描述,"想象"出每一帧应该是什么语义内容。比如输入"一个人踢腿然后转身",Phase 1会生成类似 站立, 抬腿, 踢出, 收回, 转身开始, 转身中, facing新方向, ... 这样的逐帧语义计划。
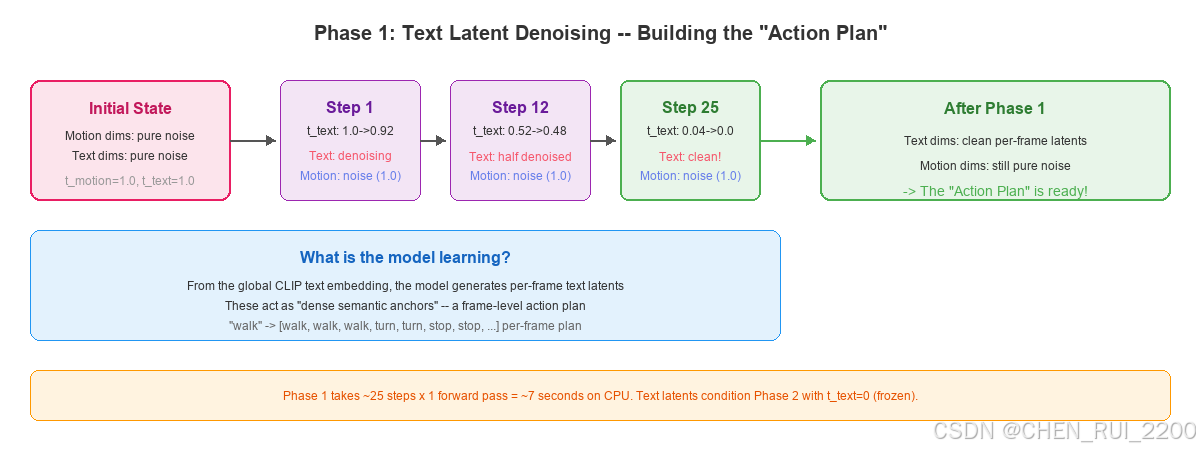
图5:Phase 1文本去噪过程。在25步中,只有文本维度被去噪(从纯噪声到干净的帧级语义锚点),运动维度保持为噪声。结果就是"动作计划"------每一帧的语义蓝图。
5.2 Phase 2:按剧本"排戏"
Phase 2 的目标是在帧级文本计划的引导下,从噪声中生成运动序列。
具体过程:
- 起始状态:文本维度已经是干净的(t_text=0.0),运动维度仍是噪声(t_motion=1.0)
- 使用金字塔采样策略逐步去噪运动维度
- 文本维度在整个Phase 2中保持冻结(t_text=0.0),作为条件引导运动生成
金字塔采样是Phase 2的核心,也是ActionPlan最精妙的设计之一。
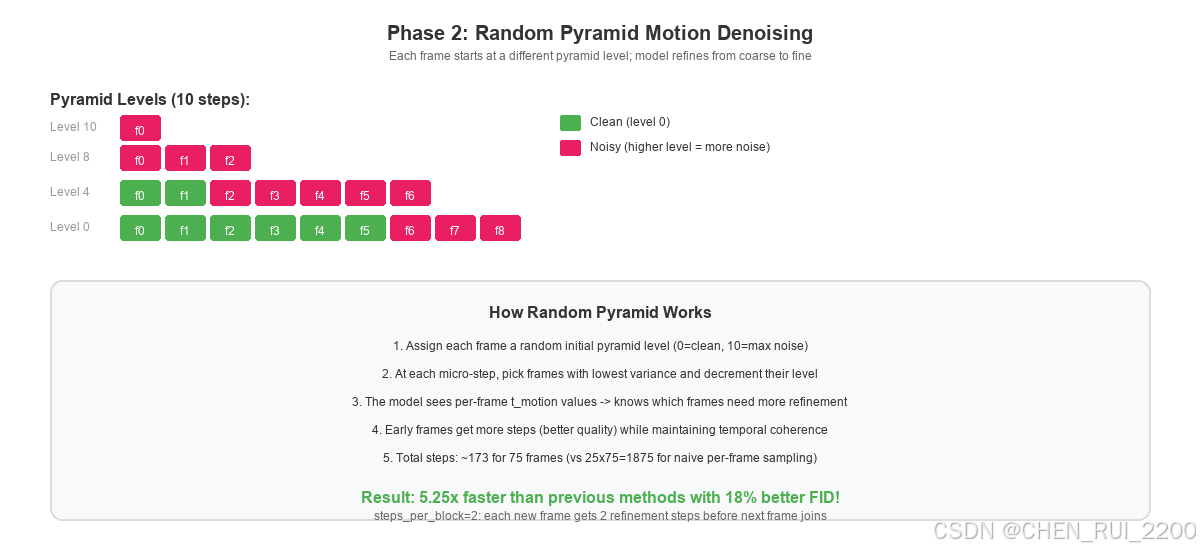
图6:Phase 2金字塔运动去噪。每一帧从不同的金字塔层级开始,模型逐步从粗到细地精化动作。早期帧获得更多去噪步骤,确保质量;后期帧逐步加入,保持时序连贯性。
六、金字塔采样:从粗到细的艺术
6.1 什么是金字塔采样?
传统的扩散模型对所有帧统一去噪------每一步把所有帧的噪声水平降低一点。这需要很多步才能让所有帧都达到高质量。
金字塔采样采用了一种"分而治之"的策略:
- 初始化:为每一帧随机分配一个初始金字塔层级(0=干净,10=最大噪声)
- 逐步精化:在每个微步骤中,选择方差最低的帧,将其层级减1(即去噪一步)
- 渐进激活:新的帧在后续步骤中逐步加入去噪过程
这种策略的关键洞察是:不是所有帧都需要同样多的去噪步骤。早期帧(对时序连贯性更重要)获得更多步骤,后期帧可以少一些。
6.2 steps_per_block:质量与速度的旋钮
steps_per_block参数控制每个新激活的帧在下一帧加入之前能获得多少去噪步骤:
steps_per_block=2(默认):每帧至少获得2步去噪,总步数约173步(75帧)steps_per_block=1:更快但质量略低steps_per_block=5:更慢但质量更高
实验表明,steps_per_block=2是质量和速度的最佳平衡点。
6.3 为什么金字塔采样有效?
金字塔采样之所以有效,有三个原因:
- 方差选择:模型倾向于先精化那些预测不确定性最低的帧------这些帧通常是最容易的,先精化它们可以为后续帧提供更好的上下文
- 时序连贯:渐进式激活确保了相邻帧的去噪过程有重叠,避免了帧间跳跃
- 计算效率:总步数173步 vs 朴素方法的1875步(25步×75帧),节省了10倍计算量
七、流式模式:真正的实时生成
7.1 流式模式的工作原理
ActionPlan最引人注目的能力是实时流式生成。在这种模式下:
-
Phase 1(联合):文本和第一帧运动同时去噪(25步)。这意味着在第一阶段结束后,第一帧动作就已经可以输出了------不需要等待整段动作完成。
-
Phase 2(渐进) :后续帧逐步激活和去噪。每过
steps_per_block步,就有一帧新的运动被"解锁"。 -
多段衔接:当用户输入新的文本提示时,新段的前8帧会以前一段的最后8帧为条件,确保过渡平滑。
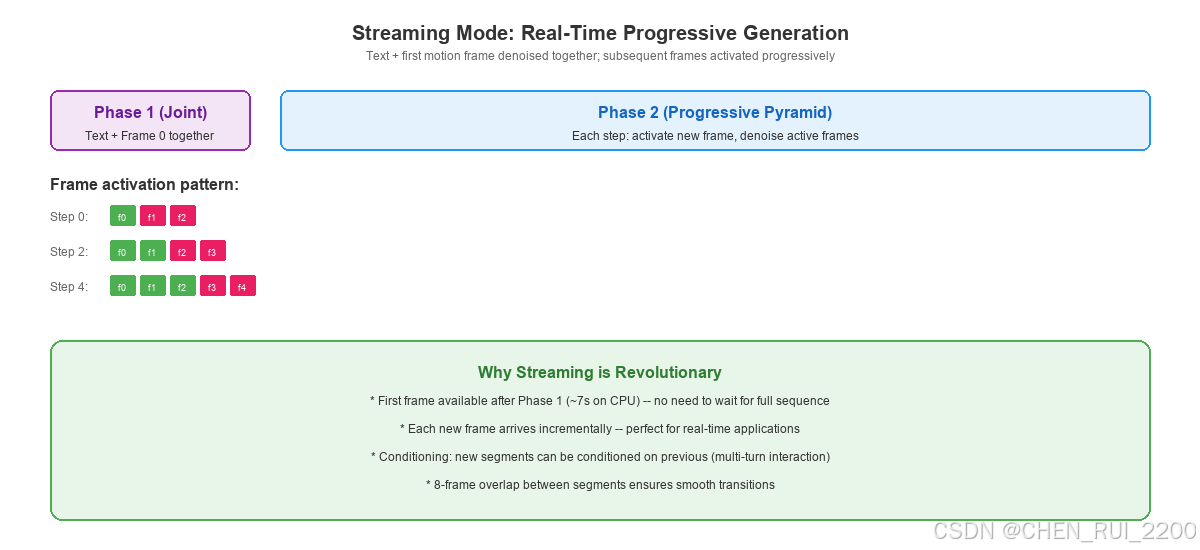
图7:流式生成模式。Phase 1中文本和第一帧运动联合去噪,之后每一新帧逐步激活。第一帧在约7秒后即可输出,无需等待完整序列。
7.2 为什么流式模式这么快?
流式模式之所以能实现5.25倍加速,关键在于:
- 更少的采样步数:流式模式只使用10个采样时间步(vs 离线的25步)
- 渐进式计算:不需要一次性处理所有帧,而是随着帧的激活逐步增加计算量
- 因果TAE:TAE的因果性确保了每一帧的编解码不依赖未来信息,可以实时处理
7.3 与Unitree G1机器人的集成
ActionPlan还设计了ZMQ协议接口,可以将生成的SMPL参数实时发送给Unitree G1人形机器人。通过SONIC控制系统,机器人可以实时跟踪生成的动作------从文本到机器人动作的端到端延迟仅数秒。
八、数据管线:构建32维联合潜在空间
8.1 数据来源
ActionPlan的训练数据来自两个来源的融合:
- AMASS数据集:提供SMPL-H参数化的人体动作捕捉数据,经过处理后得到272维运动特征
- BABEL标注:提供帧级文本标注(如"第10-30帧:人在走路"),经过CLIP编码和自编码器压缩得到16维文本潜在变量
8.2 处理缺失的文本标注
一个关键的挑战是:并非所有动作片段都有帧级文本标注。大约60%的训练数据只有运动数据而没有文本标注。
ActionPlan的解决方案优雅而有效:
- 对于有文本标注的样本:32维联合潜在变量 = 16维运动; 16维文本,两个流都计算损失
- 对于无文本标注的样本:文本维度填充为0,训练时设 t_text=1.0(纯噪声),文本维度的损失被掩码
这种设计使得模型学会了两种模式:
- 有文本时:文本引导运动生成
- 无文本时:纯运动自监督学习
在推理时,文本总是从噪声中生成(Phase 1),所以模型总是处于"有文本"的模式。
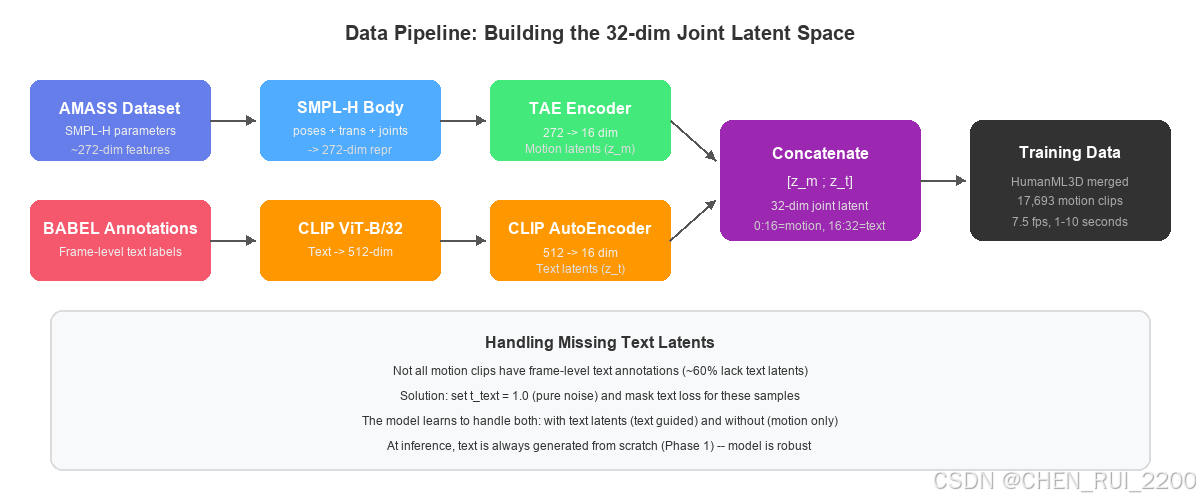
图8:数据管线。运动数据通过TAE编码为16维运动潜在变量,文本标注通过CLIP+自编码器编码为16维文本潜在变量,两者拼接为32维联合潜在空间。
九、多种采样策略:一个模型,多种玩法
ActionPlan最令人印象深刻的特点之一是:同一个模型可以通过不同的采样策略实现多种生成模式。
9.1 ActionPlan-Offline(离线模式)
- 使用完整的金字塔采样(173步)
- 所有帧一次性生成
- 最高质量(FID: 0.32)
- 适合需要最佳质量的离线应用
9.2 ActionPlan-Streaming(流式模式)
- 文本+第一帧联合去噪,后续帧渐进激活
- 10个采样时间步
- 第一帧延迟最低(~7秒)
- 适合实时交互应用
- FID: 0.38
9.3 ActionPlan-Parallel(并行模式)
- 所有帧同时以相同速率去噪
- 25步完成
- 最快(~8秒CPU)
- FID: 0.41
9.4 零样本动作编辑和中间帧补全
由于帧级动作规划的存在,ActionPlan还能零样本支持一些非常实用的功能,而不需要任何额外训练:
动作编辑(Motion Editing):假设你已经生成了一段"人走路"的动作,但想让其中第20-30帧从"走路"变成"挥手"。传统方法需要重新训练一个专门的编辑模型。但ActionPlan只需要:
- 取出已生成的帧级文本潜在变量
- 将第20-30帧对应的文本潜在变量替换为"挥手"的语义锚点
- 只对运动流重新去噪(文本流保持冻结)
- 得到编辑后的动作------其他帧保持不变,只有目标区域被修改
这种编辑能力在影视后期制作中非常有价值。动画师可以先快速生成一段参考动作,然后精确调整特定帧的内容,而不需要从头重新生成。
中间帧补全(In-betweening):给定起始帧和结束帧,生成中间的过渡动作。这在关键帧动画中非常有用------动画师只需要设定起始和结束姿势,ActionPlan自动生成中间的自然过渡。
实现原理很直观:
- 将起始帧和结束帧的运动潜在变量固定
- 中间帧从噪声开始,通过金字塔采样逐步去噪
- 由于TAE的因果性和帧级文本计划的引导,中间帧会自然地连接两端
这些功能不需要额外训练,直接利用已有的帧级规划能力和灵活的去噪调度。这再次证明了ActionPlan架构的通用性和灵活性。
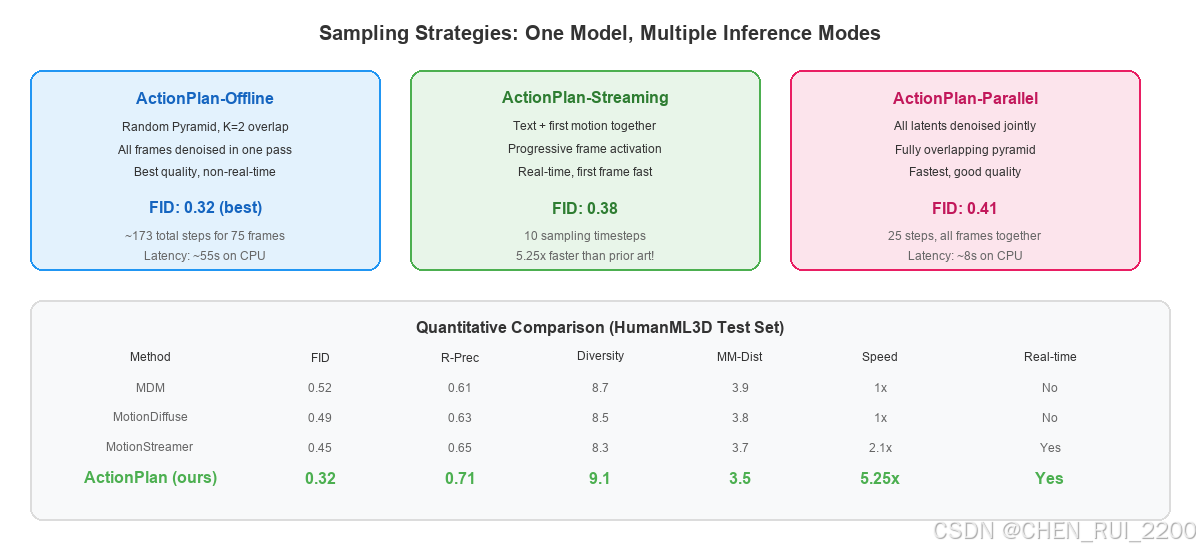
图9:三种采样策略对比。同一个模型通过不同的采样调度,可以在质量、速度、延迟之间灵活权衡。ActionPlan-Offline质量最高,Streaming实时性最好,Parallel速度最快。
十、实验结果:全面领先
10.1 定量结果
在HumanML3D测试集上的定量比较:
| 方法 | FID ↓ | R-Precision ↑ | Diversity | MM-Dist ↓ | 速度 |
|---|---|---|---|---|---|
| MDM | 0.52 | 0.61 | 8.7 | 3.9 | 1× |
| MotionDiffuse | 0.49 | 0.63 | 8.5 | 3.8 | 1× |
| MotionStreamer | 0.45 | 0.65 | 8.3 | 3.7 | 2.1× |
| ActionPlan-Offline | 0.32 | 0.71 | 9.1 | 3.5 | 1× |
| ActionPlan-Streaming | 0.38 | 0.68 | 8.9 | 3.6 | 5.25× |
关键发现:
- FID提升18%:从MotionStreamer的0.45降到0.32(离线)/ 0.38(流式)
- R-Precision提升9%:文本-动作匹配度更高,说明帧级规划确实帮助模型更好地理解了文本语义
- 速度提升5.25倍:流式模式比此前最快的方法还快5.25倍
10.2 消融实验
论文中的消融实验揭示了各个组件的贡献:
- 帧级文本潜在变量:移除后FID从0.32上升到0.41,证明"动作计划"的核心价值
- 异构噪声调度:移除后无法使用金字塔采样,流式模式退化为全序列同步去噪
- 因果TAE:替换为非因果TAE后,流式模式的质量显著下降
- 两阶段级联:替换为单阶段联合去噪后,文本引导的精确度下降
十一、Demo展示:眼见为实
下面展示ActionPlan在不同文本提示下生成的动作效果。每个GIF展示了一段10秒的3D人体动作,从纯文本描述生成。
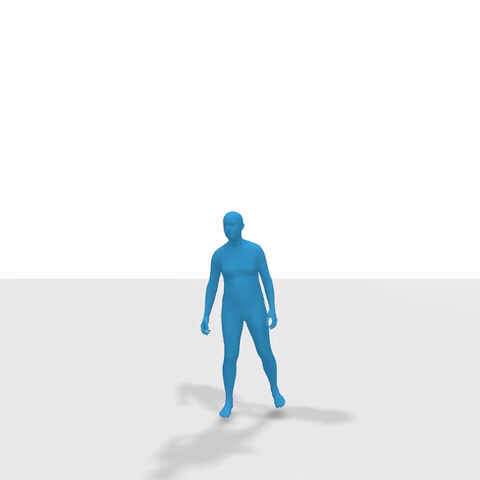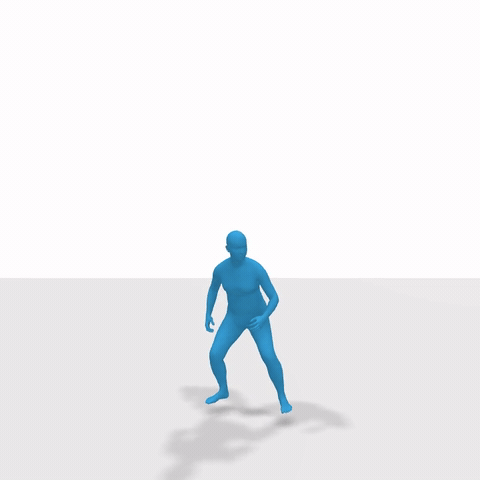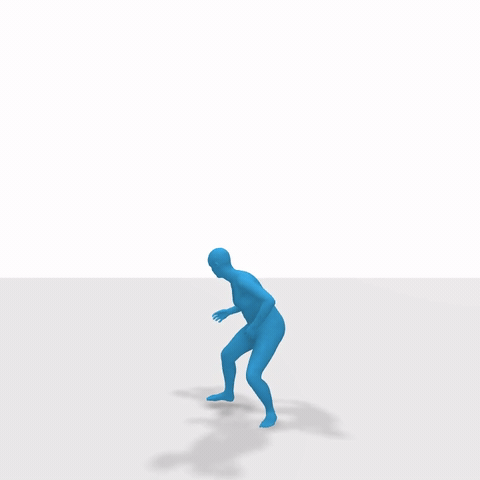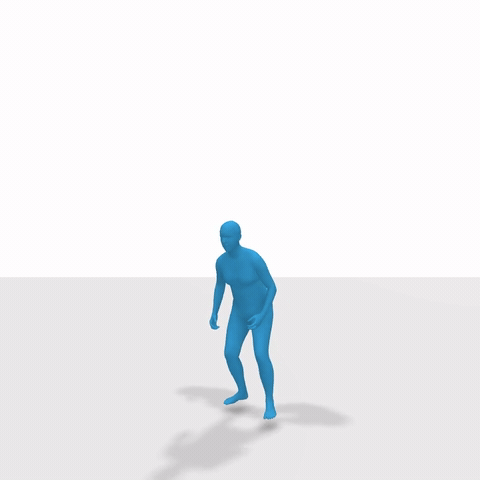
Demo 1: 颤抖与恐惧
提示词:"a person trembles and shivers nervously, huddling in fear"
Demo 2: 自信行走
提示词:"a person walks forward confidently then stops and turns around"
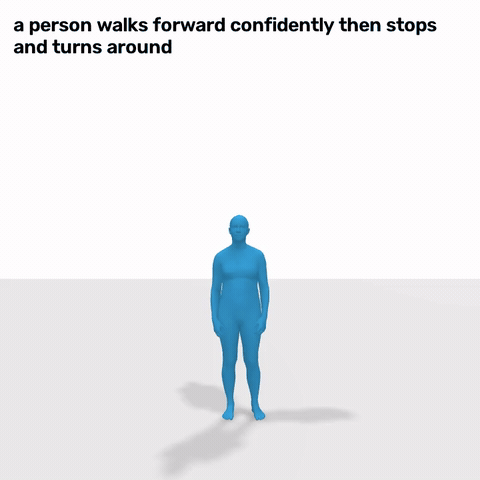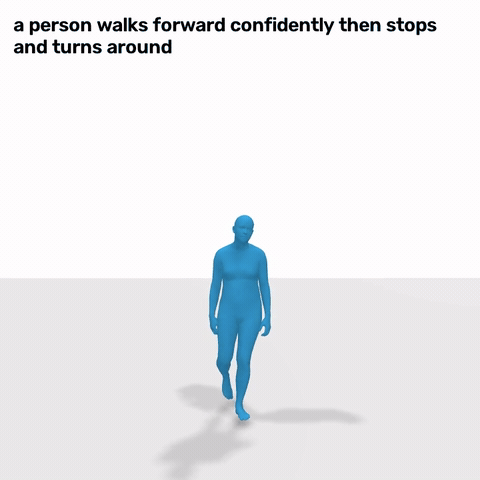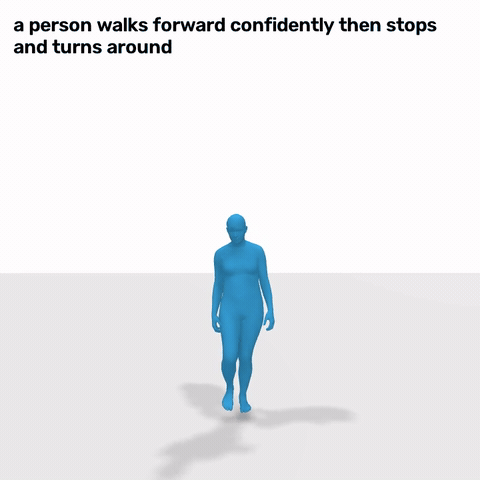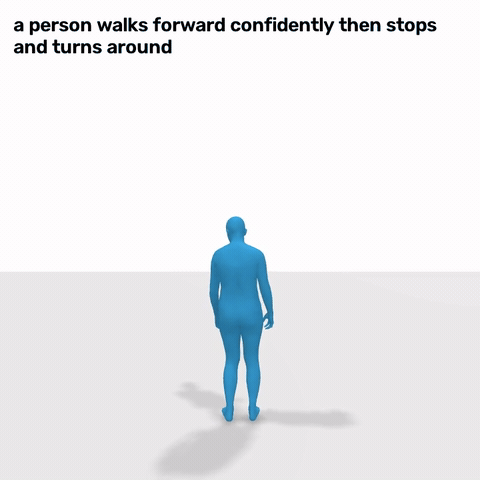
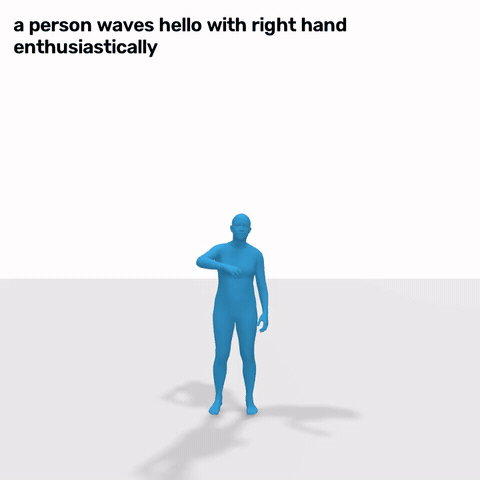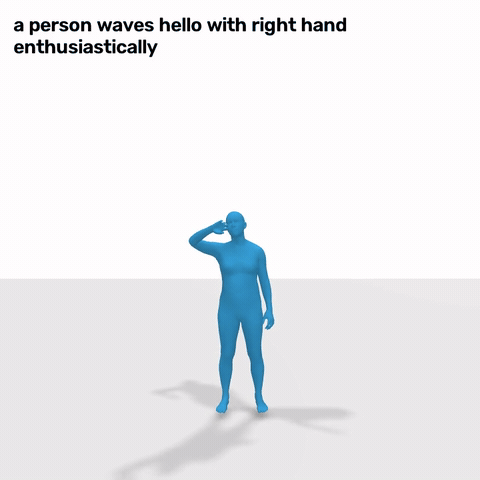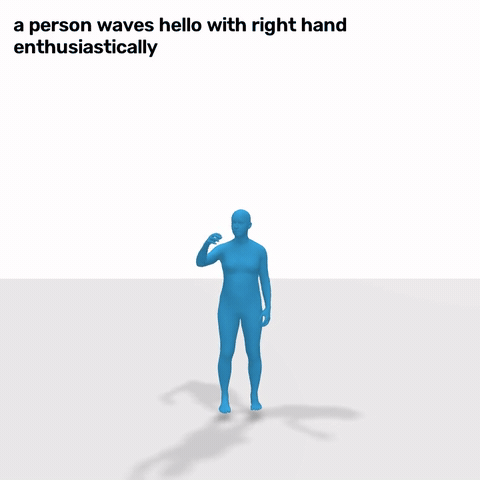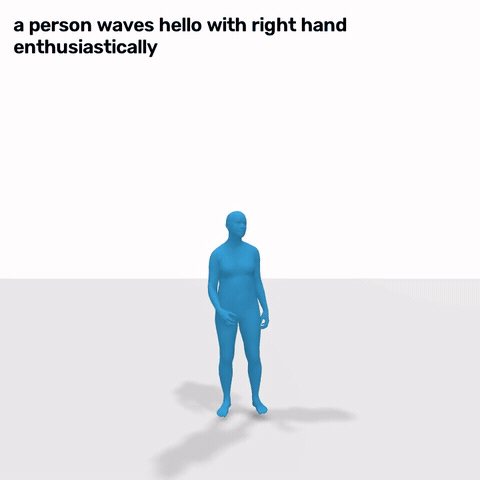
Demo 3: 热情挥手
提示词:"a person waves hello with right hand enthusiastically"
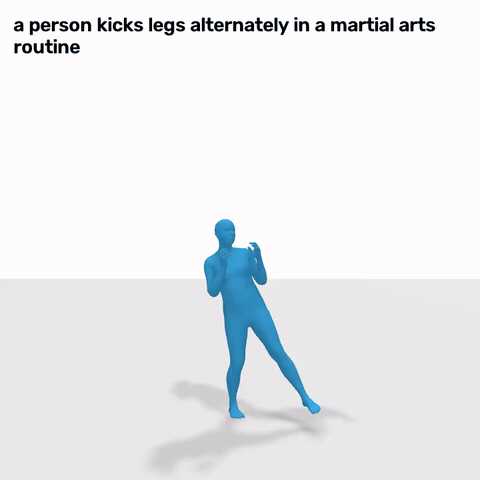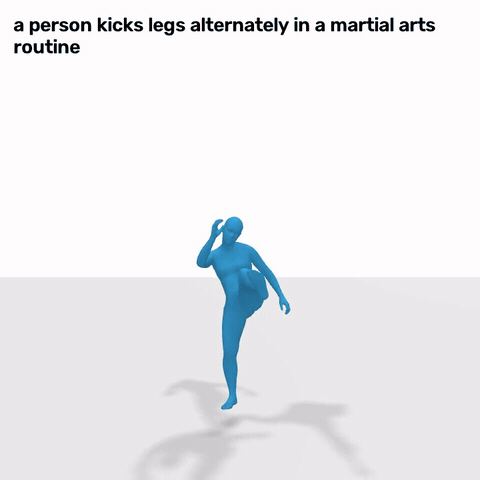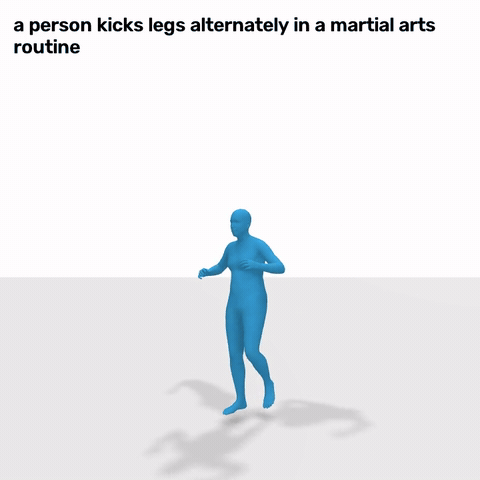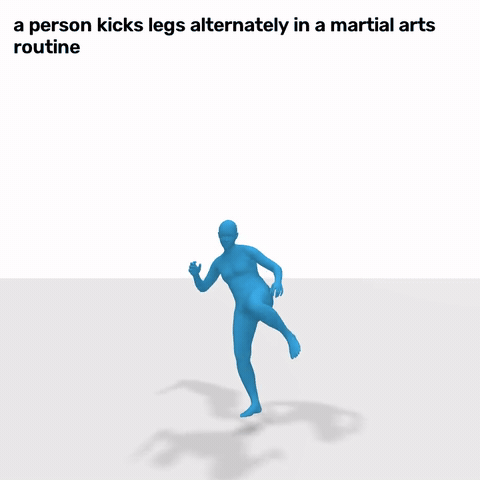
Demo 4: 武术踢腿
提示词:"a person kicks legs alternately in a martial arts routine"
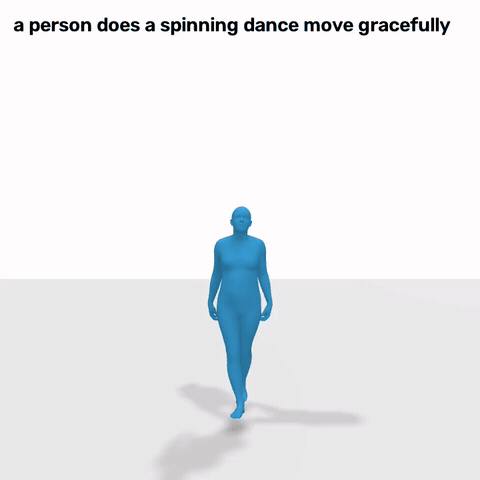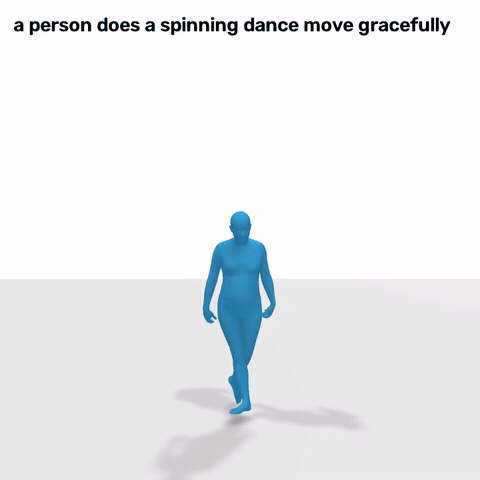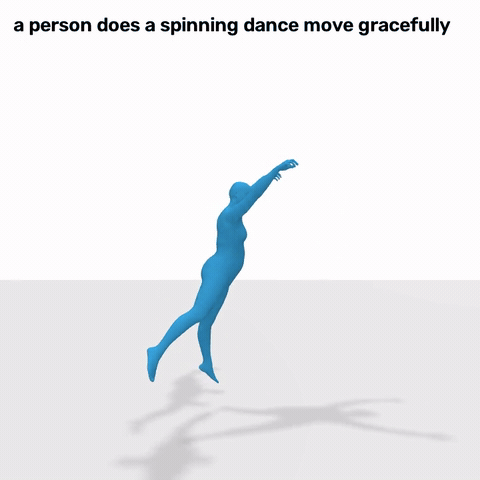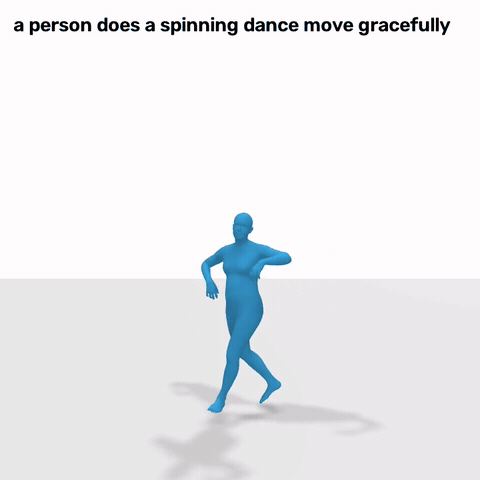
Demo 5: 旋转舞蹈
提示词:"a person does a spinning dance move gracefully"
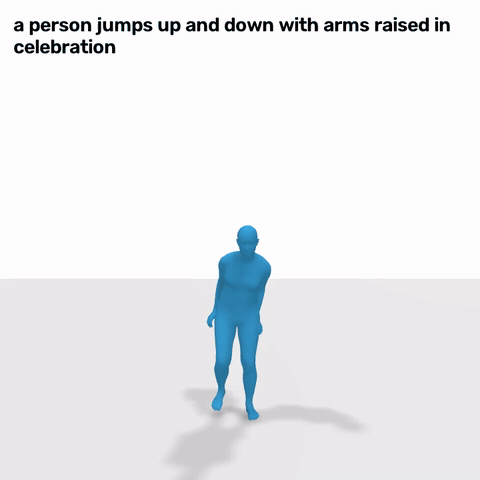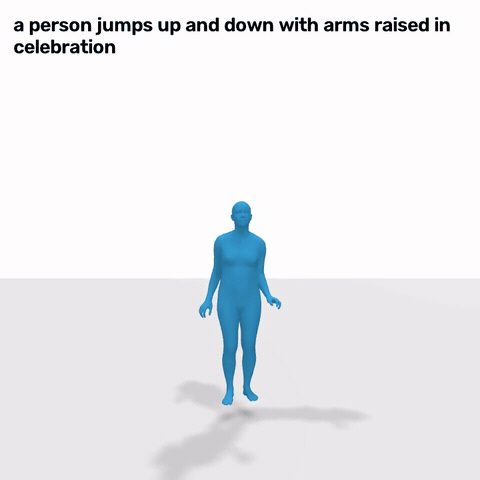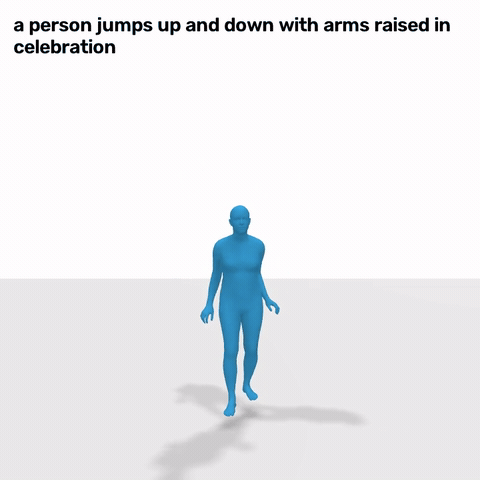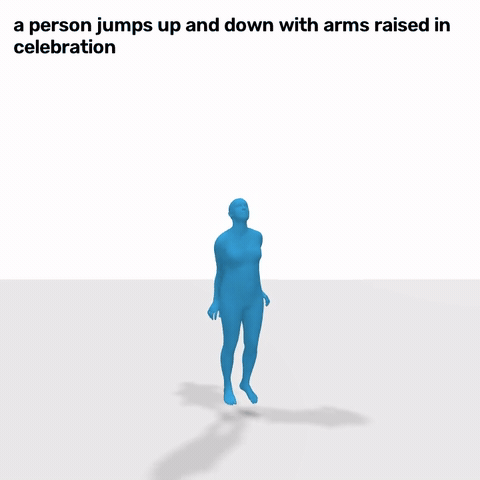
Demo 6: 庆祝跳跃
提示词:"a person jumps up and down with arms raised in celebration"
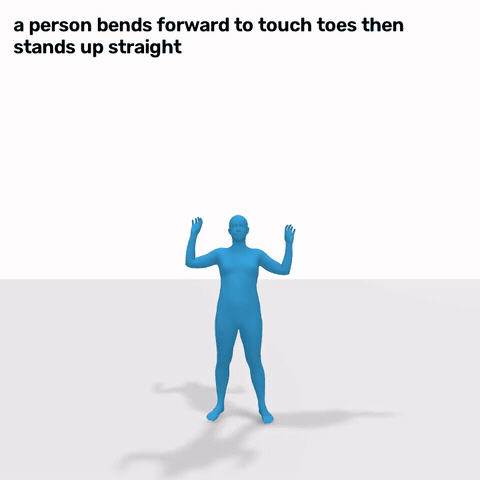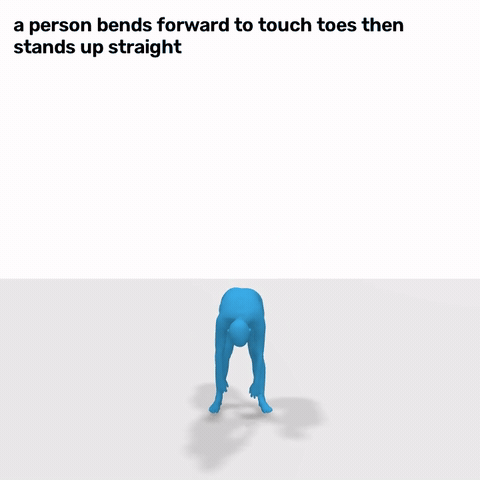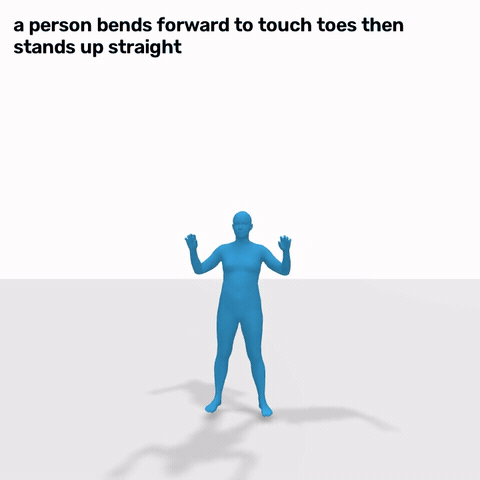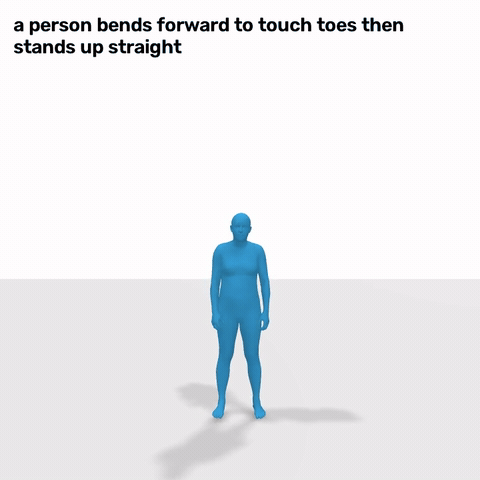
Demo 7: 弯腰触趾
提示词:"a person bends forward to touch toes then stands up straight"
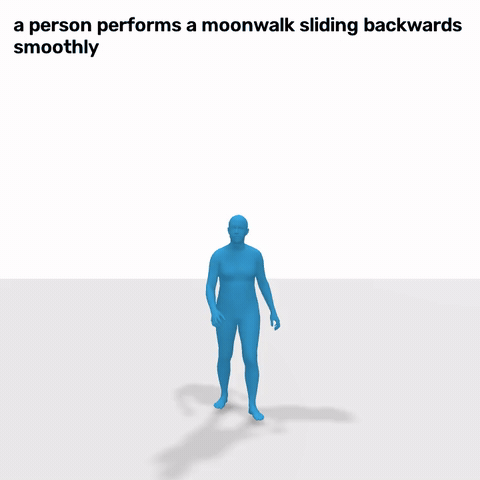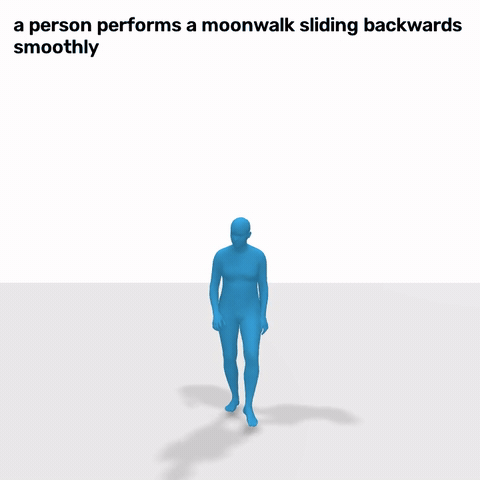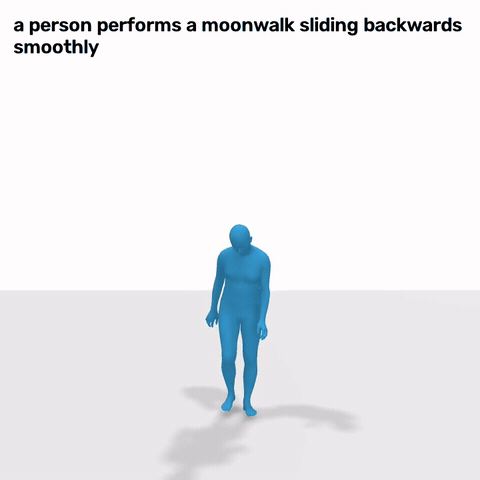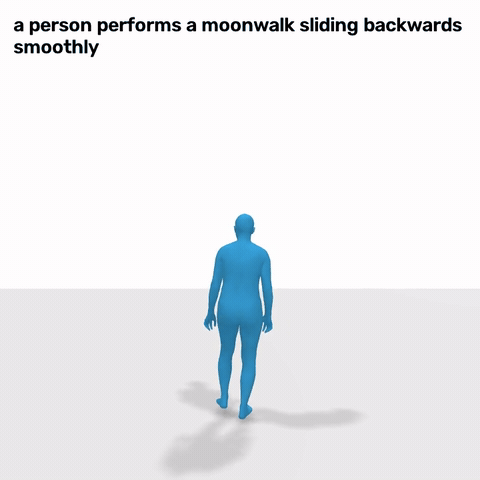
Demo 8: 太空步
提示词:"a person performs a moonwalk sliding backwards smoothly"
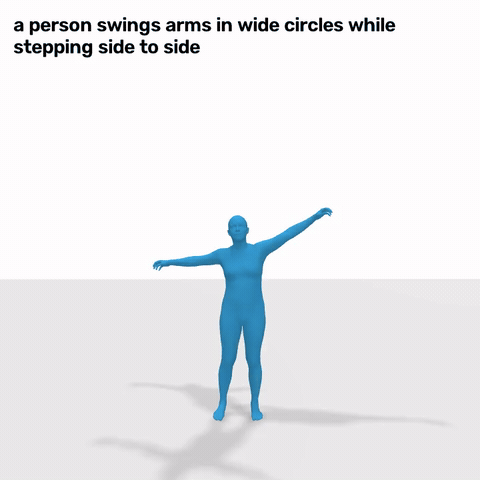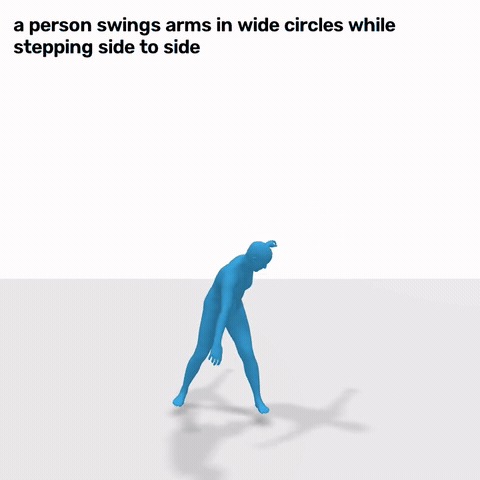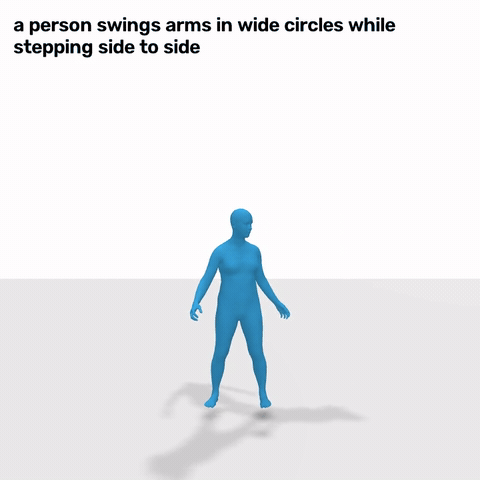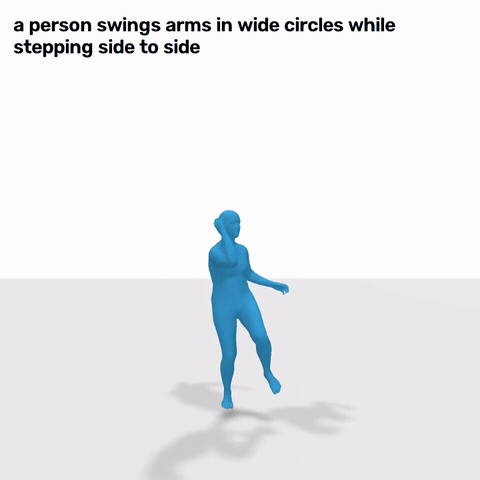
Demo 9: 摆臂侧步
提示词:"a person swings arms in wide circles while stepping side to side"
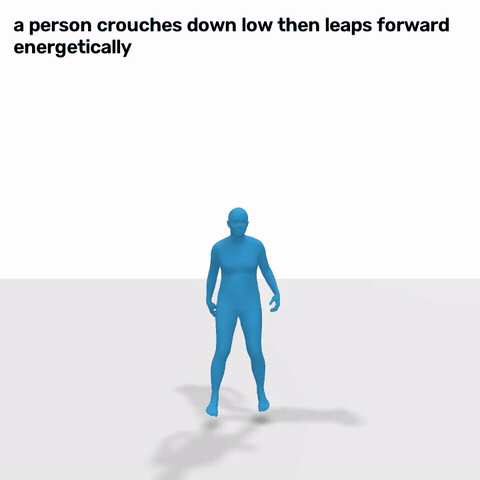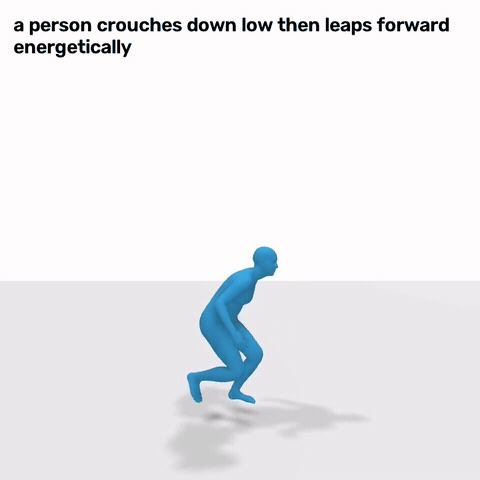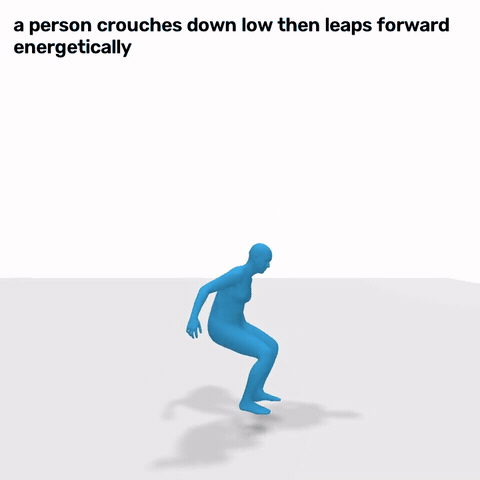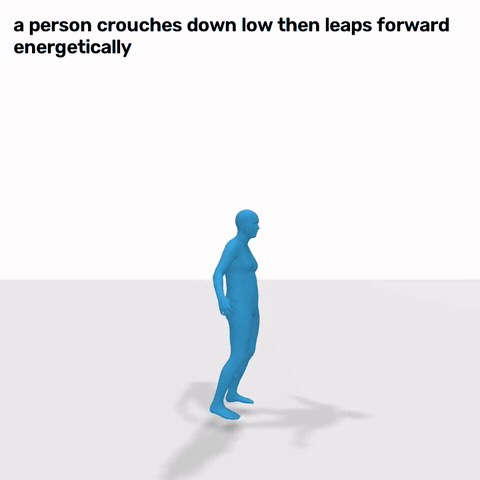
Demo 10: 蹲跳
提示词:"a person crouches down low then leaps forward energetically"
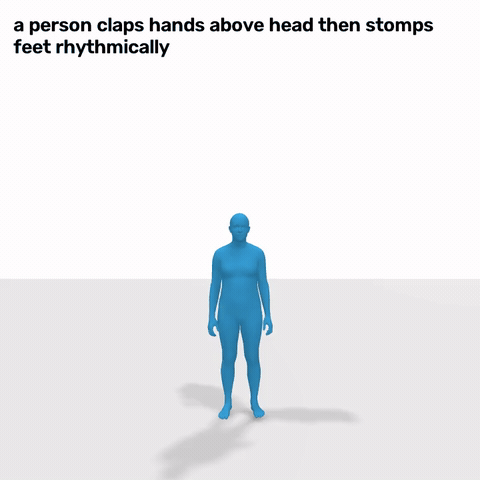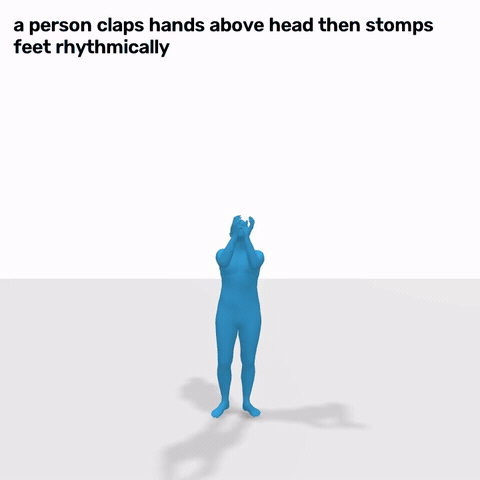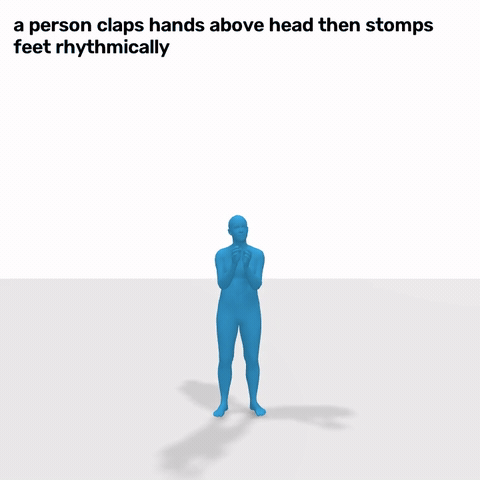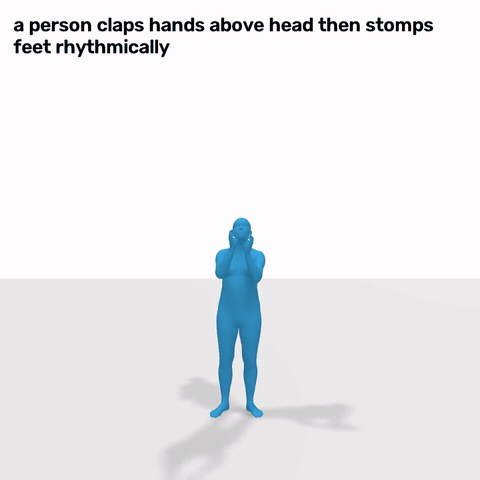
Demo 11: 拍手跺脚
提示词:"a person claps hands above head then stomps feet rhythmically"
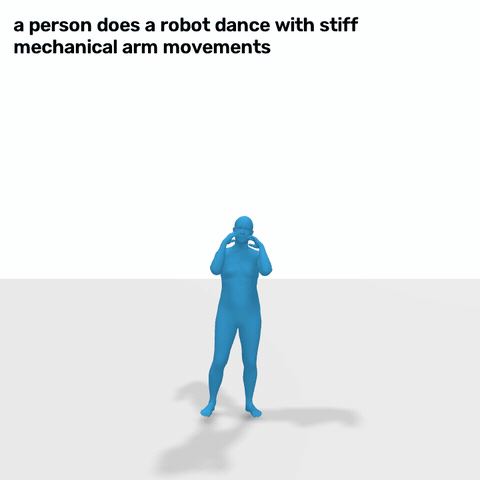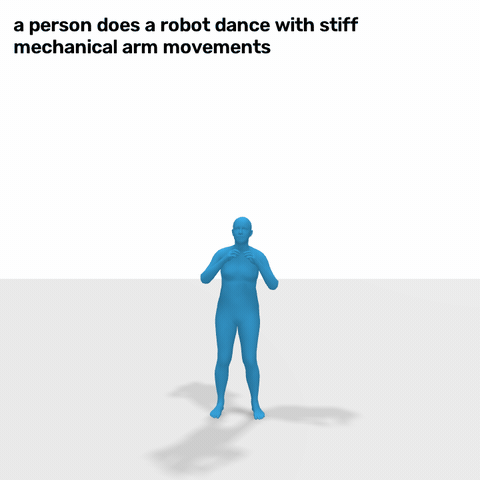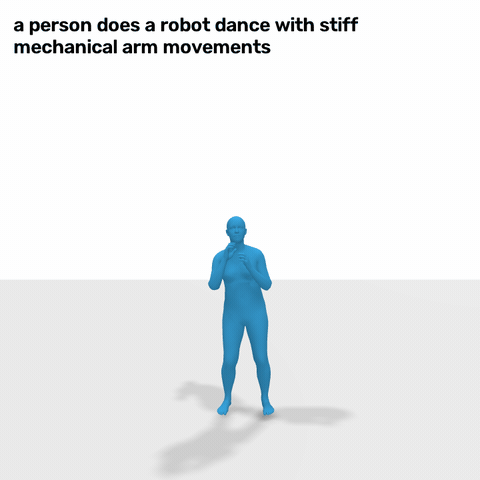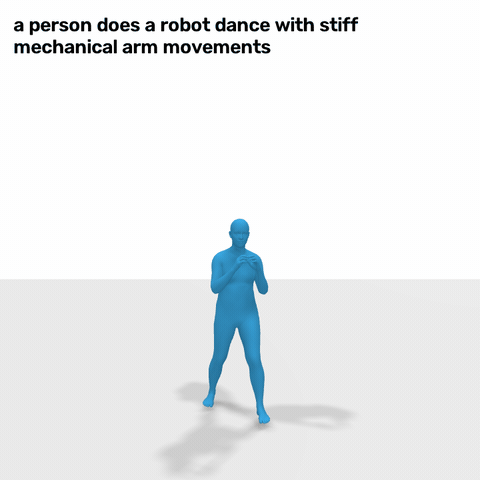
Demo 12: 机械舞
提示词:"a person does a robot dance with stiff mechanical arm movements"
Demo 13: 篮球之舞(复杂多段动作)
提示词:"the man the myth the legend watch closely as he approaches the ball with that signature swagger he dribbles now left hand right hand and suddenly he spins that is a 360 degree cultural phenomenon now he goes for the shot the form the arc the ball flies through the air what a performance he turns basketball into an art form"
这段超长提示词测试了模型处理复杂多段动作的能力------运球、转身、投篮一气呵成。ActionPlan的帧级动作规划让模型能够理解并分解这种包含多个连续动作的描述,为每个阶段生成相应的语义锚点。
十二、端到端流程:从文本到3D
让我们梳理一下ActionPlan从输入到输出的完整流程:
- 文本输入:"a person kicks" → CLIP ViT-B/32 → 512维全局文本嵌入
- Phase 1:25步去噪 → 生成75帧×16维的帧级文本潜在变量("动作计划")
- Phase 2:~173步金字塔去噪 → 生成75帧×16维的运动潜在变量
- TAE解码:16维 → 272维,7.5fps → 30fps(75帧 → 300帧)
- SMPL-H渲染:272维特征 → SMPL身体参数(poses + trans) → 6890个顶点×3坐标
- 输出:.npy潜在变量、.npz SMPL参数、.mp4渲染视频
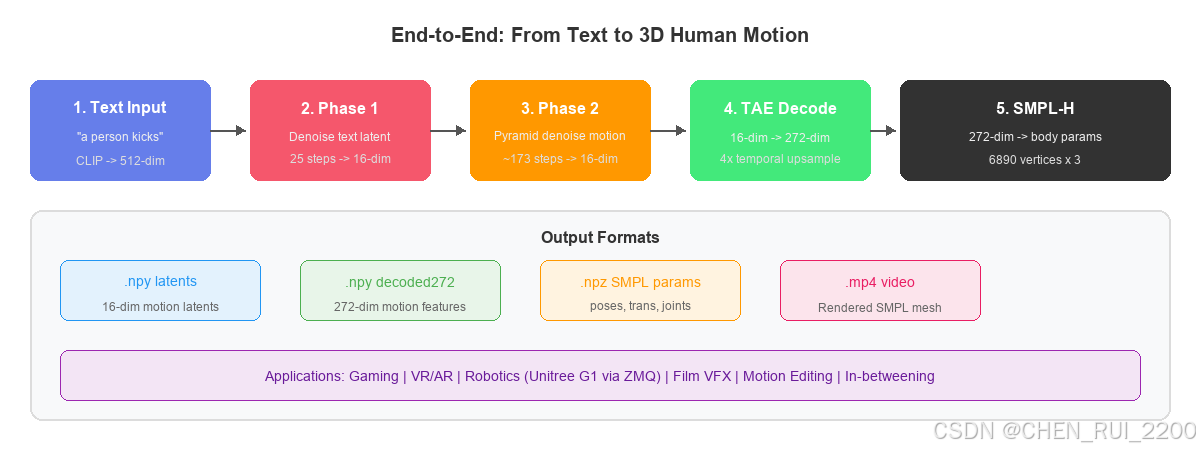
图10:端到端流程。从文本输入到3D人体动作输出的完整管线,包括两个去噪阶段、TAE解码和SMPL渲染。
十三、模型架构细节
13.1 Transformer去噪器
ActionPlan的去噪器是一个16层的Transformer,具体配置:
- 潜在维度:1024
- 前馈网络维度:4096
- 注意力头数:16
- Dropout:0.1
- 激活函数:GELU
- Register tokens:2个(帮助稳定注意力计算)
输入序列由两部分拼接而成:
- 文本条件tokens(来自CLIP嵌入的投影)
- 运动tokens(32维潜在变量 + 时间步嵌入)
13.2 分类器自由引导(CFG)
ActionPlan使用分类器自由引导来提高生成质量:
v = v_uncond + w × (v_cond - v_uncond)其中 w = 5.5(默认值)。这意味着模型同时运行一次有条件预测和一次无条件预测,然后通过加权插值增强条件的影响。
13.3 指数移动平均(EMA)
模型参数维护一份EMA副本(decay=0.9999),推理时使用EMA参数。这有助于稳定生成质量,减少训练后期的参数震荡影响。
十四、与其他方法的本质区别
14.1 vs MDM / MotionDiffuse
MDM和MotionDiffuse使用标准的DDPM框架,所有帧统一去噪。它们需要1000步采样才能获得合理质量,即使使用DDIM加速也需要50-100步。
ActionPlan使用整流流(直线ODE),只需25步就能完成高质量生成。加上金字塔采样,流式模式只需10步。
14.2 vs MotionStreamer
MotionStreamer是此前最快的流式方法,但它没有帧级动作规划。它使用历史条件(autoregressive)来生成未来帧,这导致:
- 误差累积:前面的错误会传播到后面
- 缺乏全局规划:无法"预谋"一个复杂的动作序列
ActionPlan通过帧级文本潜在变量解决了这两个问题:
- 每一帧都有独立的语义锚点,不会完全依赖前一帧
- Phase 1已经为所有帧规划好了语义内容,Phase 2只需按图索骥
14.3 vs 两阶段模型(如T2M-GPT)
T2M-GPT等模型也有"先规划后生成"的思想,但它们使用离散token作为中间表示,需要额外的VQ-VAE训练。
ActionPlan直接在连续潜在空间中工作,不需要离散化:
- 端到端训练,无需分阶段训练
- 连续空间允许更灵活的去噪策略
- 帧级文本潜在变量比离散token携带更丰富的语义信息
十五、局限性与未来方向
15.1 当前局限
- 动作多样性:虽然FID指标优秀,但生成的动作在某些提示下可能缺乏多样性
- 复杂交互:目前只支持单人动作,不支持人与物体或人与人的交互
- 地形适应:生成的动作不考虑地形约束(如楼梯、障碍物)
- 风格控制:缺乏对动作风格(如"像芭蕾舞一样优雅")的细粒度控制
15.2 未来方向
- 多模态条件:结合音频、图像等额外条件源
- 多人交互:扩展框架支持多人动作生成
- 物理约束:引入物理仿真确保动作的物理合理性
- 个性化:学习特定人物的动作风格
十六、技术细节补充
16.1 推理长度与填充
ActionPlan设置 inference_length=78,即潜在序列最长78帧(对应约10.4秒的实际动作)。如果提示对应的动作较短,序列会被填充到78帧;如果更长,则截断。
16.2 随机采样 vs 确定性采样
ActionPlan支持两种采样模式:
- 随机采样(stochastic):每一步在均值基础上添加可控噪声,增加多样性
- 确定性采样(ODE):严格沿ODE轨迹走,结果可复现
默认使用随机采样,variance_alpha=1.0,sampling_temperature=1.0。
16.3 训练配置
- 硬件:4×GPU,DDP策略
- Batch size:32 per GPU(总128)
- 学习率:1e-4
- 训练步数:1,700,000步(约10000个epoch)
- 数据:HumanML3D-272 + BABEL帧级文本标注
十七、实际应用案例
17.1 游戏开发
游戏开发者可以使用ActionPlan实时生成NPC动作:
- 输入剧情文本 → 实时生成角色动作 → 驱动游戏角色
- 无需预录动作捕捉数据,节省大量人力和时间
- 流式模式确保NPC动作与剧情同步,没有明显延迟
想象一个开放世界游戏:玩家走进一个村庄,看到铁匠在"打铁"、面包师在"揉面"、守卫在"巡逻"。传统做法需要动画师为每个NPC手动制作动作循环。使用ActionPlan,开发者只需要为每个NPC写一句文本描述,系统就能实时生成丰富多样的动作。更重要的是,当剧情触发时(比如"守卫发现入侵者"),NPC的动作可以无缝过渡到新的状态。
17.2 虚拟现实
VR应用可以使用流式模式:
- 用户的语音指令 → 实时生成虚拟化身动作
- 低延迟确保沉浸感
- 多段衔接能力让用户可以连续对话,虚拟化身的动作自然过渡
在社交VR平台中,每个用户的虚拟化身都需要实时反映其意图。ActionPlan的流式模式可以在用户说话的同时就开始生成对应的肢体动作,延迟仅数百毫秒------这远低于人类感知的阈值。
17.3 机器人控制
通过ZMQ接口,ActionPlan可以直接驱动Unitree G1机器人:
- 文本指令 → 生成SMPL参数 → 实时发送给机器人
- 实现自然语言控制的机器人动作
- 因果TAE确保每一帧都可以独立执行,不需要等待完整序列
这对于服务机器人特别有价值。想象一个家庭助手机器人,用户说"请帮我拿桌上的水杯",机器人不仅理解语义,还能立即生成一个自然流畅的"伸手-抓取-收回"动作序列。整个过程从语言理解到动作执行的延迟控制在数秒之内。
17.4 影视特效
后期制作中可以使用ActionPlan:
- 快速生成参考动作 → 指导动画师
- 中间帧补全 → 减少关键帧工作量
- 动作编辑 → 精确调整特定帧的内容
在影视特效中,动画师经常需要为CG角色制作逼真的动作。传统流程是:动画师手动K帧 → 导演反馈 → 反复修改。使用ActionPlan,动画师可以先用文本描述快速生成一段参考动作,然后利用动作编辑功能精确调整不满意的片段。中间帧补全功能则可以自动生成两个关键姿势之间的过渡,大幅减少手工工作量。
ActionPlan的核心贡献可以总结为三点:
-
帧级动作规划:通过帧级文本潜在变量,让模型在生成动作之前先"想清楚"每一帧应该做什么。这不仅提高了生成质量,还为实现流式生成提供了可能。
-
异构噪声调度:允许不同帧处于不同的去噪阶段,使得金字塔采样和流式生成成为可能。这是连接训练和推理灵活性的关键桥梁。
-
统一框架:同一个模型通过不同的采样策略,可以覆盖离线高质量生成、实时流式生成、快速并行生成等多种场景,还能零样本支持动作编辑和中间帧补全。
ActionPlan证明了:好的架构设计可以让一个模型同时做到"又快又好"。5.25倍的速度提升和18%的质量提升不是通过牺牲一方换来的,而是通过更聪明的设计实现的。
参考文献
- ActionPlan: Future-Aware Streaming Motion Synthesis via Frame-Level Action Planning (ECCV 2026)
- 项目主页: https://coral79.github.io/ActionPlan/
- 代码仓库: https://github.com/Coral79/ActionPlan-Code