👋 关于作者
你好,这里是一条 泥憨鱼 | 专注于 后端开发 、AI 前沿技术与计算机基础 。
🏠 个人主页 :一条泥憨鱼
通过技术博客记录技术成长,分享学习心得与经验。期待与您共同交流!
📚精选技术专栏:
|-------------------------------------------------------------------------------------------|--------------------------------------------------------------------------------------------|
| ❄️后端开发 | ❄️Redis| 黑马点评 |
| ❄️从0开始学习计算机网络 | ❄️数据结构与算法 |
| ❄️苍穹外卖 | ❄️探秘AI与agent |
ping 是排查网络问题时最先敲下的命令,但它背后串起的东西比想象中多。这篇顺着一次 ping 的数据流,把 ICMP 差错报告、ARP 地址解析、路由表下一跳决策走一遍,再解释路由协议为什么分成内部网关和外部网关两类。
ICMP 干什么
IP 协议本身是"尽力而为"的:它把数据报发出去,但不保证送达,也不负责在失败时通知发送方。如果一台路由器发现目的网络不可达,它不会替 IP 报错,因为 IP 头里根本没有"报告失败"这个字段。所以需要一个独立的协议来承担差错通知和控制功能,这就是ICMP(Internet Control Message Protocol)。
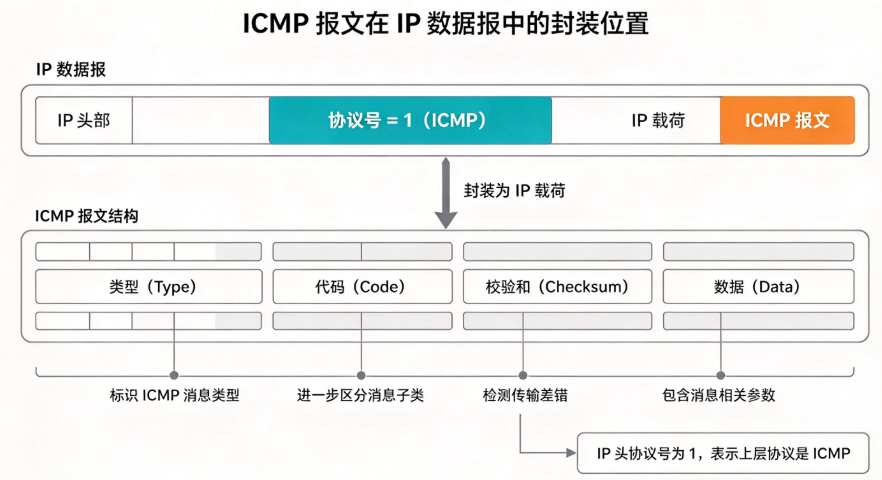
ICMP 的定位容易被误解。它不是传输层协议,不和 TCP、UDP 并列。ICMP 报文直接封装在 IP 数据报里,IP 头的协议号字段填 1,表示"载荷是 ICMP"。ICMP 和 IP 是同一层的搭档,而不是架在 IP 之上的独立层。
一个 ICMP 报文结构很简单:前 4 个字节是类型(Type)、代码(Code)和校验和,之后的内容随类型变化。Type 决定这是哪类报文,Code 在同一类型下进一步细分原因。常见的几组:
Type 8 / Type 0:Echo Request 和 Echo Reply,就是 ping 用的收发配对。
Type 11:Time Exceeded,TTL 减到 0 时路由器回送的报文,traceroute 靠它工作。
Type 3:Destination Unreachable,目的不可达,Code 里区分是网络不可达、主机不可达还是端口不可达。
Echo Request 的载荷里可以塞任意数据,接收方必须在 Echo Reply 里原样带回。ping 正是利用这一点:发送时记录时间戳和序列号,收到回包后比对,就能算出往返时延和丢包率。校验和字段保证报文在传输中没有被破坏。
那为什么 ping 用 ICMP 而不是直接发 TCP 或 UDP?因为要探测的往往是一个还没建立任何连接的目标。发 TCP 需要三次握手,目标端口不一定开放,失败原因混在一起分不清是网络不通还是服务没起;发 UDP 则可能被对端直接丢弃,什么反馈都没有。ICMP Echo 不依赖任何端口和连接状态,只要 IP 层可达,对端协议栈就会回应,这是最干净的连通性探测方式。
一次 ping 的完整过程
敲下 `ping 192.168.1.20` 之后,协议栈做的事比表面复杂。核心分歧点在于:目的地址是不是本机直连的网段?这决定了要不要经过网关。
同网段:先 ARP,再 ICMP
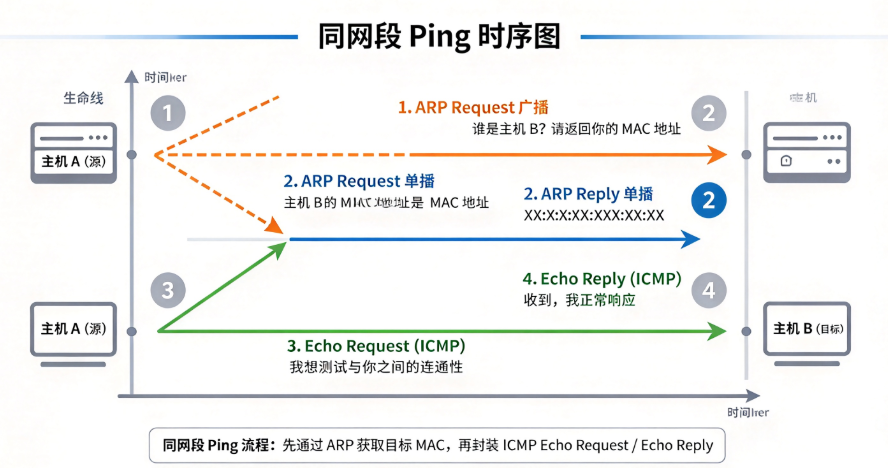
假设本机是 192.168.1.10/24,目标是 192.168.1.20/24。协议栈先拿目的 IP 和本机子网掩码做与运算,发现两者在同一网段,说明可以直接在链路上送达,不需要网关。
但链路层(以太网)只认 MAC 地址,不认 IP。于是需要 ARP 把 192.168.1.20 解析成 MAC。本机先查 ARP 缓存,没有记录就广播一个 ARP Request:"谁是 192.168.1.20?请把 MAC 告诉我。"这个广播帧的源 MAC 是本机,目的 MAC 是全 F(广播地址)。同网段所有主机都会收到,但只有 192.168.1.20 会回应一个 ARP Reply,单播回本机,带上自己的 MAC。
拿到 MAC 后,ICMP Echo Request 被封装进 IP 数据报,再封装进以太网帧,目的 MAC 填 192.168.1.20 的地址,发出去。对端收到后构造 Echo Reply,同样查 ARP 缓存或反向解析本机 MAC,单播回来。
跨网段:解析的是网关的 MAC
如果目标是 10.0.0.5,本机 192.168.1.10/24 一算发现不在同一网段,那就必须交给网关。此时查路由表,通常会命中一条默认路由(0.0.0.0/0),下一跳是网关 192.168.1.1。
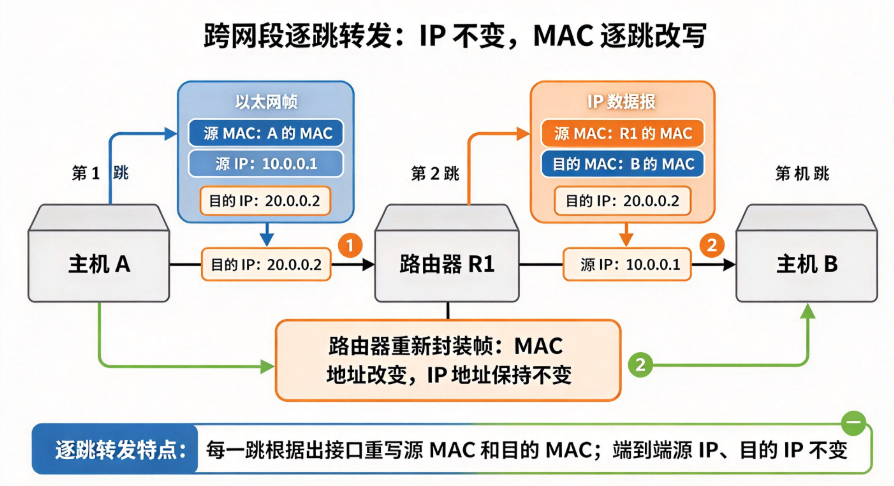
关键点在这里:ARP 解析的对象是网关 IP,而非最终目的 IP。本机广播 ARP 问"谁是 192.168.1.1",拿到网关 MAC,然后把 ICMP 报文发给网关。IP 头里的目的 IP 仍然是 10.0.0.5,只有以太网帧的目的 MAC 是网关的。
网关收到帧后,拆开发现目的 IP 不是自己,于是查自己的路由表决定下一跳,重新封装成新帧发出去。这个过程中有一个容易搞混的地方:
源 IP 和目的 IP 在整个转发过程中保持不变,端到端始终是 192.168.1.10 到 10.0.0.5。
源 MAC 和目的 MAC 每一跳都重写,只反映当前这一段链路的相邻两端。
回程与常见误区
回程是独立的过程。10.0.0.5 收到 Echo Request 后,看源 IP 是 192.168.1.10,查自己的路由表决定怎么回。如果它和本机之间没有对称的路由,回包可能走另一条路径,甚至回不来。这也是为什么 ping 通不代表双向可达,有些防火墙只放行入向不回出向。
几个实际排查时常见的误区:
ping 通只证明 IP 层可达,不代表 TCP 端口开放。目标可能防火墙拦了 80 端口但允许 ICMP。
ARP 缓存会制造假象。如果对端换了网卡但 IP 没变,旧 MAC 还在缓存里,ping 会失败,直到缓存老化或手动清理。Linux 用 `ip neigh flush all` 清空。
本机 ping 自己(127.0.0.1)完全走回环接口,不经过网卡和 ARP,测不出任何链路问题。
traceroute 是怎么"骗"出路径的
traceroute 不依赖任何特殊协议,它利用的是 IP 头里一个本来就存在的字段:TTL(Time To Live)。
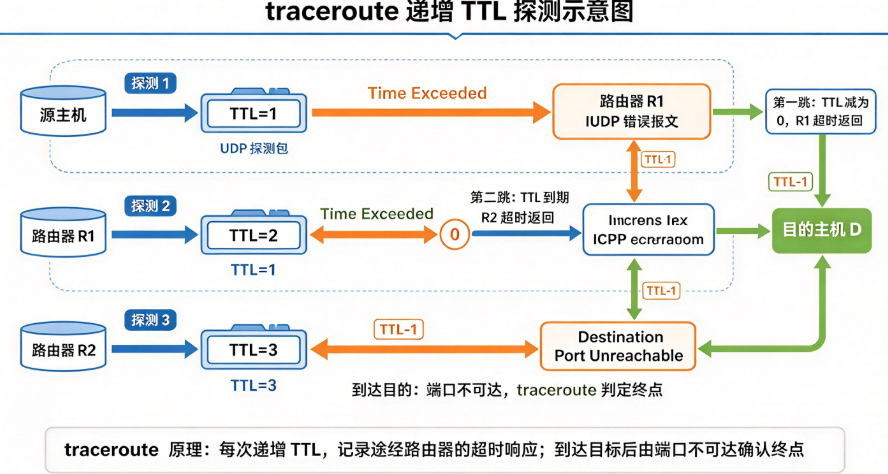
TTL 每经过一台路由器减 1,减到 0 时路由器丢弃该报文,并回送一个 ICMP Time Exceeded(Type 11)给源地址。正常情况下这是防止报文在环路里无限转的机制,traceroute 把它变成了探测工具:先发一个 TTL=1 的报文,第一跳路由器减到 0 就回 Time Exceeded,源地址就是第一跳;再发 TTL=2,第二跳回包;如此递增,直到报文到达最终目的。
Linux 的 traceroute 默认发 UDP 报文,目的端口从一个高端口(如 33434)开始递增。为什么用 UDP?因为目标主机收到后,端口大概率没监听,会回一个 ICMP Destination Unreachable(Type 3,Code 3:端口不可达),traceroute 据此判断"到了"。Windows 的 tracert 则直接发 ICMP Echo,靠 Echo Reply 判断到达。两者机制不同但思路一致。
中间出现星号 `* * *` 是排查时最常见的困惑。原因通常是:
路由器配置了不回 ICMP,或对 ICMP 做了限速,探测包被丢弃。
防火墙只放行特定类型,Time Exceeded 被拦。
路径不对称,回包走了另一条路。
星号不代表这一跳不存在,只是没拿到回应。路径后面的跳数如果还能显示,说明转发本身是通的。
路由协议为什么分两类
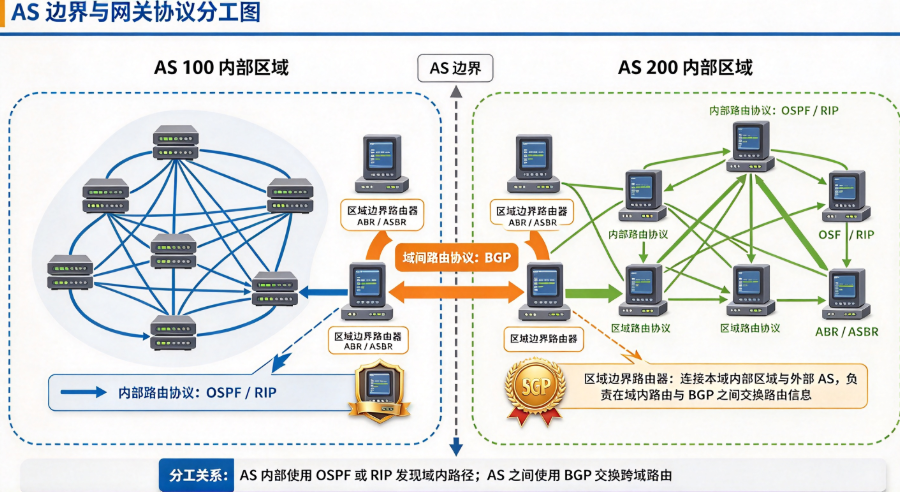
前面讲的路由表不是凭空来的。直连网段是协议栈根据网卡配置自动生成的,但更远的网络怎么走,需要路由协议去学习。这里就引出了自治系统(AS)的概念。
一个 AS 是一组由单一机构管理、采用统一路由策略的网络。划分 AS 的动机有两个:一是可扩展性,互联网规模太大,不可能让每台路由器知道所有网段;二是策略与信任边界,不同机构之间要能各自决定流量怎么走、哪些流量放行。于是路由协议分成两类:AS 内部用的叫内部网关协议(IGP),AS 之间用的叫外部网关协议(EGP)。
RIP:距离向量
RIP 是最早的一类距离向量协议。它的工作方式很直白:每台路由器周期性(默认 30 秒)把自己的整张路由表发给邻居,表里记录"到某个网段要几跳"。邻居收到后,如果发现经过你这台路由器能更短地到达某网段,就更新自己的表。跳数就是度量值,最大 15 跳,16 跳视为不可达。
距离向量的问题在于收敛慢。一条链路断了,坏消息传得比好消息慢,容易产生路由环路。RIP 用几个机制缓解:水平分割(从某接口学到的路由不再从这个接口发回去)、毒性逆转(把从某接口学到的路由标记为 16 跳再发回去)、触发更新(拓扑变化时立即发,不等周期)。但即便这样,RIP 在大网络里依然力不从心,15 跳的上限也限制了规模。
OSPF:链路状态
OSPF 换了个思路。每台路由器不发送自己的路由表,而是描述"我直连了哪些链路、状态如何",这就是链路状态通告(LSA)。LSA 通过洪泛(flooding)传播到同一区域内的所有路由器,最终每台路由器都拿到一份完整的区域拓扑图。
拿到完整拓扑后,每台路由器独立运行 Dijkstra 的最短路径优先(SPF)算法,以自己为根算出到所有网段的最短路径树,再据此生成路由表。因为大家看到的是同一张图,算出来的结果一致,不会出现距离向量那种"你听我的、我听你的"互相误导。
OSPF 还引入区域(Area)划分。所有区域必须连到骨干区域 Area 0,区域边界路由器负责在区域间汇总路由。这样单个区域内的拓扑变化不会洪泛到全网,既控制了大网络里 LSA 的数量,也加快了收敛。
两者核心差异可以这样对照:
信息交换:RIP 交换"我到各网段的距离",OSPF 交换"我周围的链路状态"。
收敛方式:RIP 靠邻居逐步传播,OSPF 靠洪泛加本地 SPF 计算。
适用规模:RIP 适合小型网络,OSPF 能支撑大型企业网。
BGP 与边界
BGP 是当前唯一在用的外部网关协议。它和 OSPF 的根本区别在于目标不同:OSPF 找的是最短路径,BGP 找的是符合策略的路径。
互联网上的 AS 之间不是简单的"谁近走谁"。一个运营商可能因为商业协议,宁愿让流量绕远也不经过某个竞争对手的网络。BGP 要表达的就是这类策略。所以 BGP 是路径向量协议:它传播的是到达某网段所经过的 AS 序列(AS_PATH),而非距离。路由器收到多条路径时,按一套优先级规则选择,而不是单纯比长度。
AS_PATH 还顺带解决了环路问题------如果一条路径里已经包含自己的 AS 号,直接丢弃,不会形成环。
BGP 分两种会话:
eBGP:运行在不同 AS 的边界路由器之间,用来交换跨 AS 的路由。
iBGP:运行在同一 AS 内部的路由器之间,用来把从外部学到的路由同步给 AS 内的其他边界路由器。
一个 AS 内部通常同时跑 OSPF(负责 AS 内可达)和 iBGP(负责把外部路由传进来)。这也是为什么大型网络里 OSPF 和 BGP 会共存:一个管内部,一个管边界。
那为什么互联网不用 OSPF 替代 BGP?因为 OSPF 假设所有路由器属于同一管理域,信任彼此、共享拓扑,这在单一机构内成立,在跨机构场景下完全不成立。不同 AS 之间不会把内部拓扑暴露给对方,也不接受对方替自己算最短路径,只能通过 BGP 交换经过策略过滤的路由。
收束
一次 ping 把 ICMP 的差错与控制、ARP 的地址解析、路由表的下一跳决策、MAC 的逐跳改写串成了一条完整的链,而路由表背后又是 OSPF、BGP 这些协议在持续填充。分层协作的每一环都只解决自己那一层的问题,合起来才让"ping 一下通不通"变得可能。
排查网络问题时,可以按这个顺序定位:先看路由表有没有到目的网段的路(`ip route get`),再看 ARP 能不能解析出下一跳的 MAC(`ip neigh`),最后看 ICMP 回包是否被限速或屏蔽。最容易误判的坑是 ICMP 被中间设备限速------此时 ping 丢包率高甚至全丢,但 TCP 业务可能完全正常,因为 ICMP 的优先级和 TCP 根本不在一个通道里。