前面把数据采集、Pandas分析、可视化基础都拆开讲了。这最后一篇串起来------模拟真实场景,从拿到一份原始CSV开始,走完读取、清洗、分析、可视化,最后产出有结论的报告。假设你是电商数据分析师,老板扔给你半年销售数据:"你看看,出个分析。"
第一步:先看看数据长什么样
拿到数据第一件事不是分析,是先摸清基本情况。
python
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
import matplotlib

matplotlib.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei', 'PingFang SC']
matplotlib.rcParams['axes.unicode_minus'] = False
sns.set_theme(style='whitegrid', font='SimHei')

np.random.seed(42)
n = 1000
dates = pd.date_range('2026-01-01', '2026-06-30', freq='D')
categories = ['食品', '服装', '数码', '美妆', '家居']
avg_price = {'食品': 80, '服装': 200, '数码': 800, '美妆': 150, '家居': 350}

df = pd.DataFrame({
    '订单号': [f'ORD{str(i).zfill(6)}' for i in range(1, n+1)],
    '下单时间': np.random.choice(dates, n),
    '品类': np.random.choice(categories, n),
    '数量': np.random.randint(1, 5, n),
    '支付状态': np.random.choice(['已支付','已支付','已支付','已退款','待支付'], n),
    '用户等级': np.random.choice(['普通会员','银卡','金卡','钻石'], n, p=[0.5,0.25,0.15,0.1]),
    '所在地区': np.random.choice(['华东','华南','华北','华中','西南','其他'], n),
})
for cat in categories:
    mask = df['品类'] == cat
    df.loc[mask, '单价'] = np.random.normal(avg_price[cat], avg_price[cat]*0.2, mask.sum()).round(2)
df['订单金额'] = (df['数量'] * df['单价']).round(2)
df['月份'] = df['下单时间'].dt.month.astype(str) + '月'
# 真实场景:df = pd.read_csv('销售数据.csv', parse_dates=['下单时间'])
快速摸底:
python
print(df.shape, df.head(), df.info(), df.describe())
for col in ['品类', '支付状态', '用户等级', '所在地区']:
    print(df[col].value_counts())
回答三个问题:数据量多大?各列什么类型、有空值吗?分类列值分布偏不偏?这步别省------一上来就画图,画到一半才发现空值、类型错,前面全白干。
第二步:数据清洗
1. 只看已支付订单
python
df_paid = df[df['支付状态'] == '已支付'].copy()
print(f"清洗后:{len(df_paid)} 条有效订单")
2. 检查异常值
python
print(df_paid['订单金额'].describe())
print(df_paid.nlargest(5, '订单金额')[['订单号','品类','数量','单价','订单金额']])
print(df_paid.nsmallest(5, '订单金额')[['订单号','品类','数量','单价','订单金额']])
真实场景可能碰到:单价为0或负数(录入错误)、金额特别大(B端或测试数据)、空值(删/填均值/单独标记)。
3. 时间格式确认
python
df_paid.loc[:, '星期'] = df_paid['下单时间'].dt.day_name()
df_paid.loc[:, '是否周末'] = df_paid['下单时间'].dt.dayofweek >= 5清洗完,后面所有分析都基于这份df_paid。
第三步:先看大盘------整体趋势怎么样
分析从大到小。第一个问题:整体销售走势是涨是跌?
python
daily_sales = df_paid.groupby('下单时间')['订单金额'].sum().reset_index()
daily_sales.columns = ['日期', '销售额']
daily_sales['7日均值'] = daily_sales['销售额'].rolling(7).mean()

fig, ax = plt.subplots(figsize=(11, 5))
ax.plot(daily_sales['日期'], daily_sales['销售额'],
        color='#91d5ff', linewidth=1, alpha=0.7, label='每日销售额')
ax.plot(daily_sales['日期'], daily_sales['7日均值'],
        color='#ff4d4f', linewidth=2.5, label='7日移动平均')
ax.set_title('2026年上半年每日销售额走势', fontsize=15, fontweight='bold', loc='left', pad=12)
ax.set_ylabel('销售额(元)')
ax.legend(loc='upper left', frameon=False)
ax.grid(alpha=0.3, linestyle='--')
sns.despine()
plt.tight_layout()
plt.show()
每日销售额波动大,7日移动平均把波动平滑掉,整体走向一目了然。
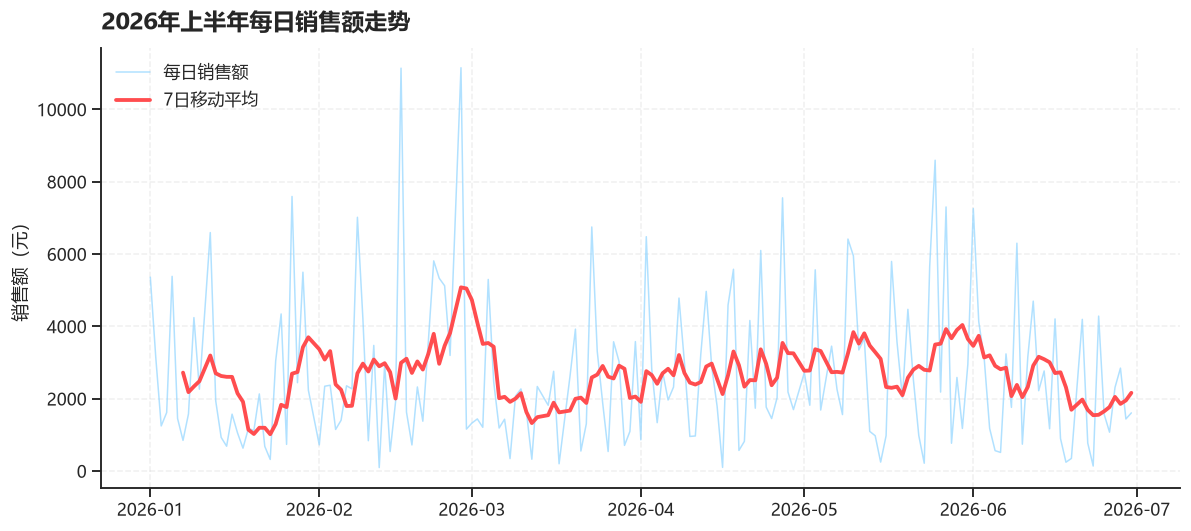
这张图看:整体升还是降?有无周期性波动?有无异常高峰低谷?突然爆或塌要记下来挖原因------大促?系统bug?数据问题?按月再汇总看更宏观:
python
monthly = df_paid.groupby('月份')['订单金额'].agg(['sum','count','mean']).round(2)
monthly.columns = ['总销售额', '订单数', '客单价']
monthly = monthly.reindex(['1月','2月','3月','4月','5月','6月'])
print(monthly)
数字也得看,光看图容易有视觉误差。
第四步:拆结构------钱都是从哪来的
第二个问题:销售额由哪些品类、地区、用户构成?
品类贡献
python
category_sales = df_paid.groupby('品类')['订单金额'].agg(['sum','count']).round(2)
category_sales.columns = ['销售额', '订单数']
category_sales = category_sales.sort_values('销售额', ascending=False)
category_sales['占比'] = (category_sales['销售额']/category_sales['销售额'].sum()*100).round(1)
print(category_sales)
画张图更直观:
python
fig, axes = plt.subplots(1, 2, figsize=(13, 5))
sns.barplot(data=category_sales, x=category_sales.index, y='销售额', ax=axes[0],
            palette='Set2', hue=category_sales.index, legend=False)
axes[0].set_title('各品类销售额对比', fontsize=13)
axes[0].set_ylabel('销售额(元)'); axes[0].set_xlabel('')
for i, v in enumerate(category_sales['销售额']):
    axes[0].text(i, v+500, f'{v/10000:.1f}万', ha='center', fontsize=9)
sns.barplot(data=category_sales, x=category_sales.index, y='订单数', ax=axes[1],
            palette='Set2', hue=category_sales.index, legend=False)
axes[1].set_title('各品类订单数对比', fontsize=13)
axes[1].set_ylabel('订单数'); axes[1].set_xlabel('')
for i, v in enumerate(category_sales['订单数']):
    axes[1].text(i, v+5, str(v), ha='center', fontsize=9)
for ax in axes:
    sns.despine(ax=ax); ax.grid(axis='y', alpha=0.3, linestyle='--')
plt.suptitle('品类销售结构分析', fontsize=15, fontweight='bold', y=1.02)
plt.tight_layout()
plt.show()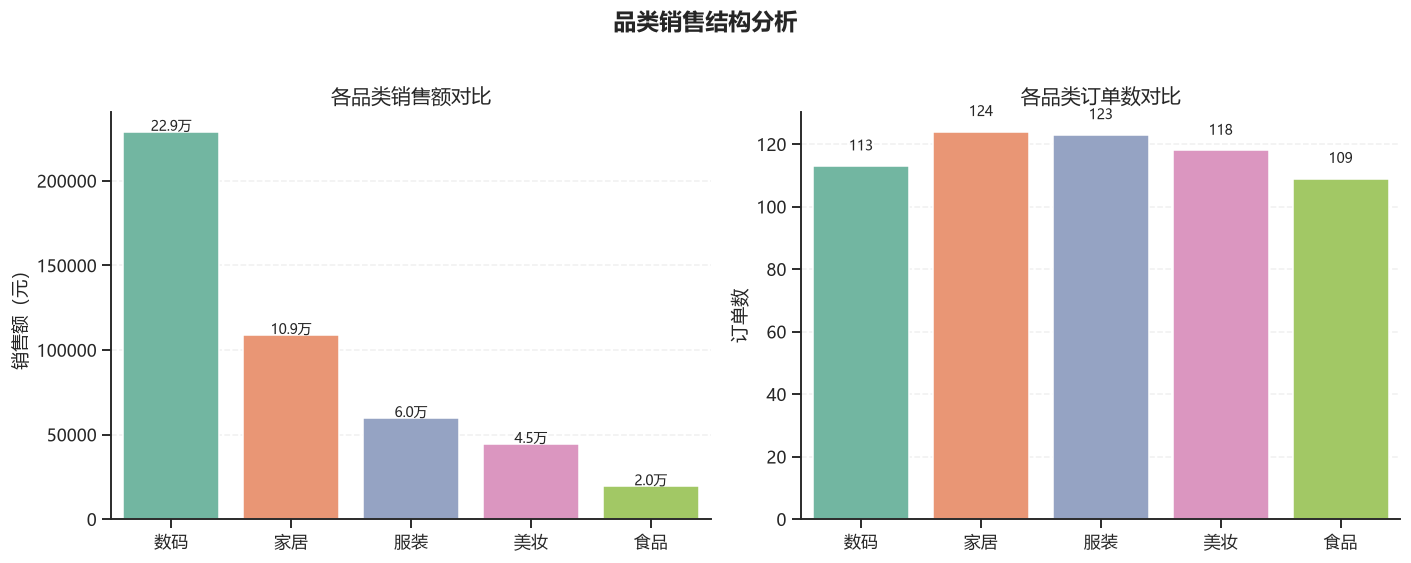
销售额和订单数两个维度一起看,才知道品类真实角色:销售额高+订单少=高价值品类;销售额低+订单多=流量品类;两个都高=明星品类;两个都低=边缘品类。
用户等级结构
python
level_sales = df_paid.groupby('用户等级')['订单金额'].agg(['sum','count']).round(2)
level_sales.columns = ['销售额', '订单数']
level_sales['客单价'] = (level_sales['销售额']/level_sales['订单数']).round(2)
print(level_sales.sort_values('销售额', ascending=False))
这组数据判断高价值用户贡献------比如钻石会员只占10%却贡献30%销售额,就是经典二八法则。
第五步:挖关系------什么因素影响了销售
这是分析最有价值的部分------从描述"是什么"走向探索"为什么"。
客单价和用户等级有关系吗
python
plt.figure(figsize=(8, 5))
order = ['普通会员', '银卡', '金卡', '钻石']
sns.boxplot(data=df_paid, x='用户等级', y='订单金额', order=order, palette='Blues', width=0.6)
plt.title('不同用户等级的订单金额分布', fontsize=14)
plt.ylabel('订单金额(元)'); plt.xlabel('')
sns.despine()
plt.tight_layout()
plt.show()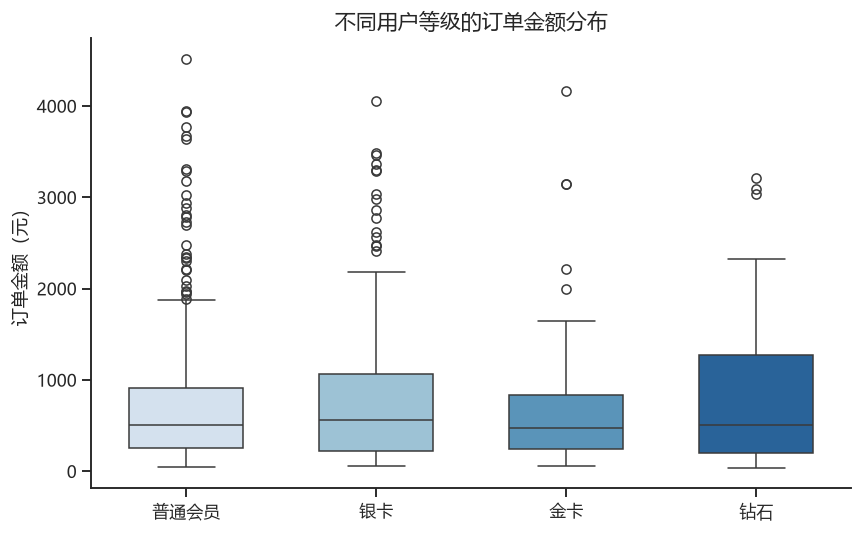
等级越高客单价越高的趋势很明显。但注意是相关不是因果------是等级高所以花得多,还是花得多所以等级高?光看图回答不了,但知道关系存在就有了下一步方向。
周末和工作日有差别吗
python
weekend_sales = df_paid.groupby('是否周末')['订单金额'].agg(['mean','count'])
weekend_sales.columns = ['平均客单价', '订单数']
weekend_sales.index = ['工作日', '周末']
print(weekend_sales)
数值变量关系全景
python
corr = df_paid[['数量','单价','订单金额']].corr()
plt.figure(figsize=(6, 5))
sns.heatmap(corr, annot=True, fmt='.2f', cmap='RdBu_r',
            vmin=-1, vmax=1, center=0, square=True, linewidths=0.5)
plt.title('数值变量相关性', fontsize=14, pad=12)
plt.tight_layout()
plt.show()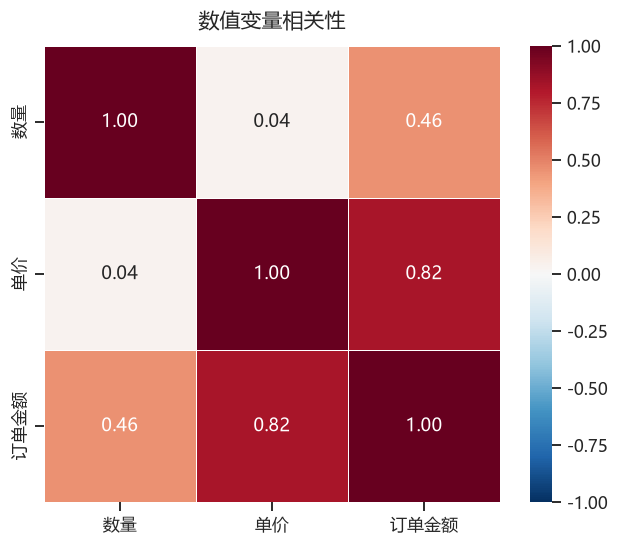
真实运行效果
整条分析链路真跑一遍,控制台关键输出如下:
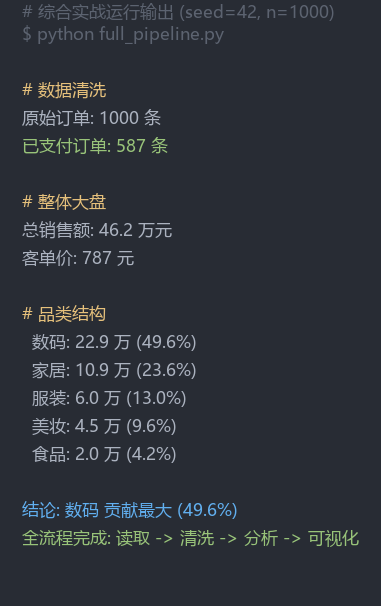
587 条已支付订单、总销售额约 46.2 万元,数码品类占比近半,与正文分析一致。
第六步:出结论------把发现串成故事
分析不能停在一堆图表上,最后要回答"所以呢?"。例如:
- 整体情况:上半年销售额总体上升,6月达峰值,主因XXX
- 品类结构:数码贡献最大销售额但订单量仅第三,属高客单价品类;食品订单最多但销售额低,是引流品类
- 用户结构:钻石会员占比小却贡献高销售额,二八效应明显,会员体系有效
- 运营建议:周末单量高就加大周末营销;增速快的品类增加SKU和推广;高价值会员做好留存
思路统一:先总后分,先描述后解释,最后落到行动建议。
写在最后:整个系列收尾
从第1篇requests入门到这第15篇综合实战,走完了完整路径:01-05数据采集、06-10 Pandas分析、11-14数据可视化、15综合实战。
这个系列不是教你记住所有参数,而是建立认知框架:拿到一份数据,知道第一步干什么、每步有什么工具、大概会遇到什么坑。 后面做项目遇到具体问题再查具体用法就行,但框架必须先有。
数据分析光看学不会------找一份你自己工作或生活里的数据,从头到尾走一遍流程,哪怕只是分析自己的账单,收获也比看十篇文章大。动手去做,比什么都强。
梅雅达编程工作室 · Python数据实战系列第15篇(完)
师傅领进门,修行在个人。后面有项目了随时回来翻。