数据集成软件不能只看"同步成功":聊聊金仓 KFS 和订单数据同步这件事
做后台开发,经常会接到这样一个需求:业务库里的订单数据,要再同步一份给报表系统。业务照常运行,报表最好别落后太多,顺便还不能影响线上接口。
第一次听到这个需求,很容易觉得,一个定时任务就能解决。按更新时间查订单,分批写到另一边,失败了重试。可等到删除、退款、历史数据订正这些情况都加进来,才发现自己正在给项目补一套数据同步系统。
数据集成软件值不值得用,我觉得就应该从这些地方讨论。本文拿订单数据同步到金仓数据库这个场景,聊聊电科金仓异构数据同步软件 KFS,以及选型和落地时容易漏掉的几件事。
这里的订单场景是用于分析的示例,不是实际客户案例。
一、先别急着装软件,把"同步"两个字问清楚
假设业务方说:"我们想把订单同步到报表库。"
这句话还不足以开始设计。
报表是每天看一次,还是客服处理退款时也要实时查?只需要订单当前状态,还是要保留从创建、支付到退款的每次变化?目标库能不能修改数据?历史订单调整后,报表要不要跟着重新计算?
不同答案,对应的方案可能差很多。
例如,只看前一天营业额,每晚跑一次批处理也许就够了。为了这个需求引入持续运行的同步链路,还要安排监控、告警和故障处理,未必划算。
但如果订单还在持续修改,下游需要尽快看到变化,情况就不同了。同步程序除了搬运已有记录,还得长期跟踪后续的增删改。
KFS 的全称是 Kingbase FlySync。按照电科金仓官网的介绍,它是一款基于增量日志解析的数据同步产品,面向数据库迁移、数据共享与分发等场景。这里最值得关注的,是它获取变化的方式:从数据库日志入手,而不是要求业务代码在每次修改数据时,额外通知一下同步程序。www.kingbase.com.cn
当然,采用日志方式也不意味着接上数据库就能用。源库版本、日志设置、账号权限、字段类型以及同步方向,还是要逐项确认。产品支持某类数据库,与某个具体环境已经满足部署条件,是两回事。
二、按更新时间轮询,麻烦往往出在后面
先看一种很常见的实现:
sql
SELECT order_id, order_status, pay_amount, updated_at
FROM biz_order
WHERE updated_at >= :start_time
  AND updated_at < :end_time;
其中 :start_time 和 :end_time 是应用层绑定参数,实际使用时需要按开发框架的方式传入。
每分钟执行一次,查到结果后更新报表库。代码不多,也容易理解。
问题是,updated_at 只有在所有写入入口都遵守规则时,才能比较完整地反映数据修改。正常业务接口会更新这个字段,临时执行的订正脚本未必会;新代码做了统一处理,几年以前的老任务也未必做了。
删除更加直接。一条记录从源表物理删除以后,再查询更新时间,已经没有这条记录可查了。目标端如果没有额外的删除处理,它就会一直留在那里。
有人会问,那把查询窗口往前多取几分钟,再做去重,是不是就行了?
可以改善一部分情况,但窗口要重叠多久,仍然需要依据。比如事务开始时写入了更新时间,却过了较长时间才提交,扫描任务有可能已经越过对应窗口。把窗口改大,还会增加重复扫描和目标端写入的开销。
这些都不代表定时同步不能用,而是要承认它有适用范围。数据量不大、时效要求宽松、业务变更也简单时,自己写脚本很正常。可如果为了补齐边界,已经需要维护删除标记、扫描游标、补数队列和异常重放,就应该重新算一下维护成本。
还有一点要分清:数据库行同步和业务事件分发并不完全相同。订单一分钟内先支付、再退款,下游如果只是看当前状态,最终同步成"已退款"就可能满足需求;如果要分别触发发货和退款处理,则需要明确的事件语义,不能只盯着最终那一行数据。
三、全量搬完了,不代表可以直接接增量
一张不再变化的表,复制起来比较省心。真正麻烦的是,全量搬迁期间源库仍然在写。
举个简单例子。
全量任务读到订单 1001 时,它还是"待支付"。几秒钟后,用户支付完成,源库把状态改成"已支付"。
目标端最后应该是什么状态?当然是已支付。但要做到这一点,就必须处理好全量读取和增量应用之间的关系。
如果这次修改没有进入增量范围,目标端就会保留旧状态。反过来,如果增量先写入"已支付",随后全量又把旧记录覆盖过去,同样有问题。
所以,全量和增量不能被理解成两个随意拼接的任务。实施时必须明确:全量对应什么一致性边界,增量从哪里衔接,重叠的数据如何处理。
KFS 的公开管理手册将初始搬迁分为结构搬迁和数据搬迁,并提供了不同搬迁模式的说明。具体采用哪种方式,要结合实际安装版本和源、目标数据库组合判断,不能把某个版本的命令直接当作通用操作步骤。help.kingbase.com.cn
我会要求实施方案把这部分单独写清楚。哪怕只是一页纸,也应该能解释数据为什么不会在衔接处漏掉或被旧值覆盖。
下面这张图表示需要完成的工作,不对应某个版本控制台的操作顺序:
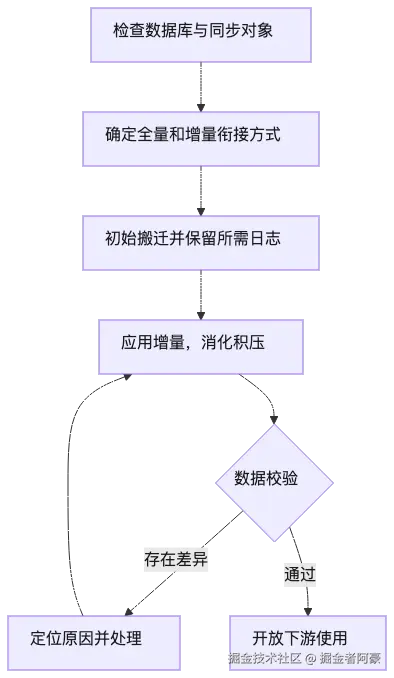
说到日志保留,还要考虑全量实际需要多久。平时几个小时的日志空间看起来很充足,遇到大表搬迁,再叠加一次网络故障,未必够用。需要保留多长时间,应该根据搬迁、故障处理和追赶耗时来估算。
四、先拿小表验一遍,比直接接大表更容易发现问题
我不太赞成第一次验证就把全部业务表接进去。
数据多、字段多,看起来很接近生产,出了问题却不容易定位。先用一张字段含义清楚的小表,把基本行为跑通,再扩大范围,通常更省时间。
例如准备下面这张测试表:
sql
CREATE TABLE demo_order_sync (
    order_id     BIGINT PRIMARY KEY,
    order_status VARCHAR(20) NOT NULL,
    pay_amount   DECIMAL(12, 2) NOT NULL,
    remark       VARCHAR(100)
);
这里使用的是常见基础类型,没有依赖自增或专有函数。实际执行前,仍需在独立测试环境确认数据库兼容模式和语法,并完成同步所需的权限、日志及表映射配置。以下 SQL 是验证样例,不是已经在指定 KFS 版本上实测过的部署脚本。
先确保两端表结构匹配,再在源端插入两条记录:
sql
INSERT INTO demo_order_sync
    (order_id, order_status, pay_amount, remark)
VALUES
    (1001, 'CREATED', 99.90, NULL);

INSERT INTO demo_order_sync
    (order_id, order_status, pay_amount, remark)
VALUES
    (1002, 'CREATED', 29.90, 'delete-test');

COMMIT;
确认目标端已经收到两条记录之后,再修改第一条、删除第二条:
sql
UPDATE demo_order_sync
SET order_status = 'PAID',
    remark = 'paid-test'
WHERE order_id = 1001;

DELETE FROM demo_order_sync
WHERE order_id = 1002;

COMMIT;
客户端的自动提交设置需要提前确认,确保上述修改已经提交。
等同步应用完成,在两端分别查询:
sql
SELECT order_id, order_status, pay_amount, remark
FROM demo_order_sync
ORDER BY order_id;
预期只剩订单 1001,状态为 PAID,金额为 99.90,备注为 paid-test。
这个实验没什么花哨的地方,但插入、更新、删除以及空值到非空值的变化,都能观察到。尤其是删除,不能因为平时业务主要使用软删除,就完全不测试。
接下来再补一个回滚实验:在源端开启事务,修改记录后执行回滚,确认目标端没有出现这次被撤销的修改。事务开启方式需要按源数据库和客户端来写。
基础行为确认以后,再加入中文、长字符串、金额边界和业务实际使用的时间类型。不要等正式大表出现异常,才发现测试数据里从来没有覆盖过这些值。
五、校验最怕的,是拿一个数字就宣布通过
两边行数相同,是一个好信号,但还不足以说明数据一致。
一条订单丢了,另一条订单多了,总数可以不变。某笔金额由 99.90 变成 9.99,行数也不会告诉你。
对订单数据,可以先做一层简单汇总:
sql
SELECT
    order_status,
    COUNT(*) AS order_count,
    SUM(pay_amount) AS amount_total
FROM demo_order_sync
GROUP BY order_status
ORDER BY order_status;
按状态比较数量和金额,能比单纯统计总行数多发现一些问题。不过,总金额相同也不是最终证明,两条记录的金额刚好一增一减,汇总结果仍然可能一致。
因此,比较合理的顺序是先缩小范围,再核对明细。先看总量,再按业务日期或主键范围分段,发现哪一段不一致以后,继续检查具体记录。
这里还有一个前提:两边查询时,数据是不是处在可以比较的状态?
源库一直在修改,目标端有正常同步延迟,你先查源端、过几秒再查目标端,出现差异未必意味着同步出错。对于前面的小表实验,可以暂时停止测试写入,等对应变更在目标端应用完成后再比较。
生产环境如果需要不停业务地校验,则要使用适合该场景的一致性校验机制。KFS 官方产品资料介绍了在线校验与修复能力,也列出了详细比对、抽样比对和摘要比对等方式;具体使用条件仍应以部署版本为准。www.kingbase.com.cn
我尤其建议在启用修复前,先确认谁是权威数据源。
假如目标端有人手工修改过订单备注,这种修改到底应该保留,还是应该被源端覆盖?没有约定,就不能仅凭"存在差异"判断哪边错了。
更稳妥的设计,是让目标端同步表保持明确的写入归属。报表系统需要自己的备注或标签,可以放在扩展表里,通过订单编号关联,少让两套程序同时争夺一个字段的修改权。
六、同步速度够不够,要看落后以后追不追得上
讨论性能时,容易只看正常情况下的延迟。
平时跟得上,确实是基本要求。但如果网络中断半小时,恢复以后能不能消化积压,同样重要。
不妨算一笔简单的账。下面的数字仅用于演算,不是 KFS 的性能指标。
假设源端每秒产生 8000 条变更,目标端实际每秒能应用 10000 条。表面上看,处理能力比业务压力高了 2000 条。
如果故障期间已经积压了 1200 万条,恢复后业务还在继续运行,那么每秒真正用于减少历史积压的能力,只有这多出来的 2000 条。
理想情况下,追平需要:
text
12,000,000 ÷ (10,000 - 8,000)
= 6,000 秒
= 100 分钟
业务方可能以为"网络好了,数据马上就正常",实际却还要等一个多小时。
真实环境比这个算式复杂。不同记录的大小不同,大事务和零散小事务也不能简单按条数等价;目标端的索引、锁等待、磁盘和提交开销,都会影响有效应用速度。
这个计算的意义,是提醒我们给恢复留出余量。把同步链路压到日常勉强够用,遇到一次故障,就可能长时间追不上。
监控也不要只看同步进程是否存活。源端采集到了,不代表目标端已经提交;目标端提交了,下游缓存也可能还没刷新。延迟指标究竟测量哪一段,必须说清楚。
如果只能优先看几项,我会先看目标端应用延迟、积压是否持续增长、日志可用空间,以及目标库有没有明显的写入等待。这些信息,比一个绿色的"运行中"更有助于判断当前是否正常。
七、上线之后,开发还会继续改表
同步验证通过,并不意味着这条链路以后不需要维护。
订单表增加字段、扩大字段长度、调整索引,都是常见需求。源端能执行成功,不代表对应变更一定能直接在异构目标端执行。
KFS 的公开手册和社区 FAQ 中有 DDL 过滤相关说明,但"可以配置过滤规则"和"某条 DDL 能被目标数据库兼容执行",不是同一件事。help.kingbase.com.cn
这部分最好纳入数据库变更流程。开发提结构变更时,顺手确认同步范围、目标端兼容情况以及两端执行顺序,比上线后再排查同步任务为什么停了,要省事得多。
故障演练也不用一开始就做得很复杂。先测试短时断网、同步服务重启、目标库短时不可用,观察恢复过程是否符合预期。
每次测试前后都保留一组明确的数据,确认有没有遗漏、重复或旧值覆盖,同时记录积压消化时间。不要只验证"服务能重启",还要看重启以后数据有没有回到正确状态。
如果所需源日志已经被清理,处理方式可能涉及重建数据基线。不能把断点恢复理解为,无论中断多久都一定可以直接续上。
八、用于迁移时,最后还有一道应用切换
如果只是建设报表库,满足一致性和延迟要求后,就可以持续运行了。
如果目的是把业务迁到金仓数据库,事情还没结束。新库最终要接收应用写入,这需要单独设计切换窗口。
停止旧入口写入、处理在途事务、确认最后一批变更已应用、校验关键数据、切换连接并验证业务,这些步骤都要有明确负责人。
特别要检查定时任务、消息消费者和后台脚本。网页入口停止接单,不代表旧数据库已经停止写入。
回退也不能简单写成"把连接地址改回来"。一旦新库已经产生业务数据,旧库未必拥有这些变化。回退之前如何处理这段新增数据,需要事先约定并演练。
数据同步软件能承担数据流转工作,应用如何交接写入权限,仍然需要开发和运维共同处理。
我看 KFS 这类产品时,更在意的始终是这些具体问题:一条更新会不会漏,一次删除能不能到,故障恢复以后多久追平,发现差异以后如何定位。
这些问题有了可复查的结果,再去比较吞吐和部署成本,选型才有依据。至于控制台里显示的"同步成功",可以作为开始检查的信号,但不应该成为验收的全部理由。