上周处理了一起数据库连接池被打满的线上故障,复盘完直接把跑了快一年的号源刷新任务,从外部分布式调度中心的 HTTP 调用模式,改成了 Spring 自带的本地 @Scheduled。改造本身不算大,但选型背后的判断逻辑值得单独唠一篇。
这篇文章会把出事现场、问题根因、两种调度模式到底差在哪、什么场景该用哪个、改造时踩了哪些坑全讲透,尽量用例子说话,刚入行的同学也能跟上。
先给个一句话结论:调度方式没有高低之分,只有合不合适。任务少、频率高、怕外部干扰的,本地调度更稳;任务多、要管控、要分片的,外部调度省心。
一、先还原一下事故现场
1.1 改造前的架构
我们项目里有个号源刷新任务,之前托管在 XXL-JOB 调度中心上。调度中心每 3 秒发一次 HTTP 请求,调用患者端服务暴露的 /api/refresh/source 接口,全量刷新所有自建医院的号源缓存。
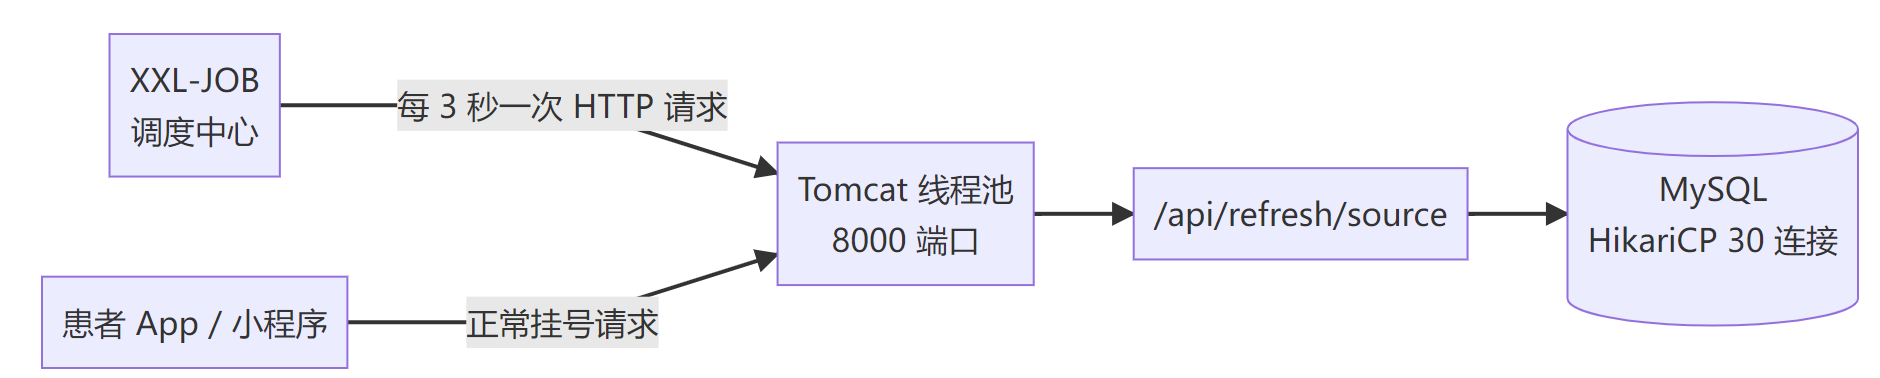
注意看这张图,问题就藏在里面:定时任务的流量和正常用户的挂号流量,进了同一个大门(Tomcat 线程池),抢同一批数据库连接。
1.2 出事那天
一开始医院少、科室少的时候完全没问题。后来医院越接越多,号源刷新的频率也往上调,某天凌晨批处理高峰期直接炸了:
| 时间 | 现象 | 处理 |
|---|---|---|
| 02:00 | 监控告警:HikariCP 活跃连接数打满 30/30 | 开始排查 |
| 02:05 | 患者端页面大面积打不开,接口疯狂抛 SQLTransientConnectionException |
确认是连接池耗尽 |
| 02:08 | 定位到号源刷新任务每次全量刷新,单次要跑 200+ 条 SQL | 紧急停掉刷新任务 |
| 02:15 | 连接池回落,患者访问恢复 | 事故止血 |
| 03:00~ | 复盘 + 评估改造方案 | 第二天开始改造 |
事后拉日志看了下,那个刷新任务高峰期一次执行要独占连接池 20 分钟,把 30 个连接吃得死死的,正常挂号请求排队都排不上。
1.3 复盘出来的三个致命问题
问题一:定时任务和正常业务抢线程、抢连接
外部调度发过来的 HTTP 请求,和正常用户的挂号请求走的是同一个 Tomcat 线程池。任务流量一上来,正常业务的线程直接被挤没。
问题二:每次 HTTP 调用都白付一堆"过路费"
一次远程触发,实际要经过这些环节:
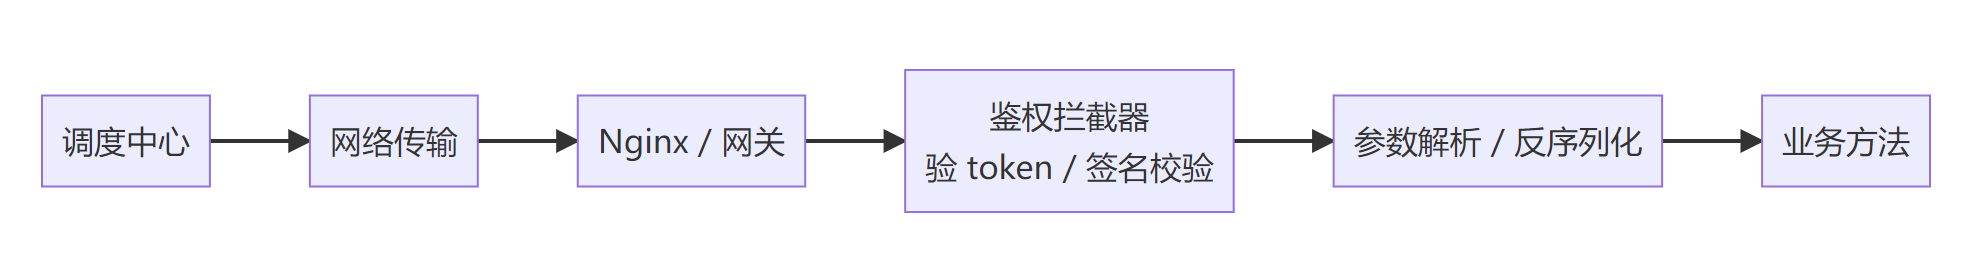
一个 3 秒跑一次的高频任务,每小时要白跑 1200 次网络 + 鉴权 + 解析,全是无谓开销。
问题三:网络一抖,任务就不可控
之前出过一次事故:运维更新防火墙策略,调度中心发的请求全被拦截,号源缓存整整 6 小时没刷新,患者看到的全是过期号源。而这 6 小时里,业务服务本身完全健康,就是"闹钟打不进来"。
二、先把两个概念讲明白,别搞混
很多刚入行的同学分不清这两种模式,我用大白话解释一下。
2.1 什么是外部调度(HTTP/RPC 远程触发)
打个比方:你雇了个闹钟助理,他不住你家,在隔壁楼办公室。到点了给你打个电话喊你干活。
放到代码里:有一个独立部署的分布式调度中心(XXL-JOB、SchedulerX、Elastic-Job 这类),到了预设时间,它通过 HTTP 或 RPC 远程调用你业务服务暴露的接口,触发任务执行。任务的配置、启停、日志查看都在调度中心后台操作,业务代码本身不关心"什么时候跑"。
典型例子: 公司有 5 个微服务,每个服务里 10 个定时任务。你不想改个执行时间就得挨个服务改代码发版,就搭一个统一的 XXL-JOB,所有任务在后台统一管理,到点调度中心分别调 5 个服务的接口。这就是标准的外部调度。
2.2 什么是本地调度
打个比方:你自己手机上定的闹钟,就搁枕头边,到点直接响铃,不需要谁从外面打电话通知你。
放到代码里:定时任务的触发逻辑完全跑在当前业务应用的进程内部,最常用的就是 Spring 的 @EnableScheduling + @Scheduled。不需要对接任何外部平台,不需要暴露任何对外接口,Spring 自带的调度线程池到点直接调你写好的业务方法。
典型例子: 你写个小项目,每天凌晨 2 点清理 30 天前的过期日志。在方法上加个 @Scheduled(cron = "0 0 2 * * ?"),启动后到点自动跑,连第三方依赖都不用加。
2.3 一张表看懂核心区别
| 对比维度 | 外部调度(XXL-JOB 等) | 本地调度(@Scheduled) |
|---|---|---|
| 触发方式 | 调度中心远程调用(HTTP/RPC) | 进程内直接方法调用 |
| 部署形态 | 需要单独部署调度中心 + 执行器 | 无额外部署,跟着应用走 |
| 代码侵入性 | 要写执行器 Handler、暴露接口 | 一个注解搞定 |
| 修改任务时间 | 后台改配置,不用发版 | 改代码 + 发版(或读配置中心) |
| 网络依赖 | 依赖调度中心 ↔ 服务的网络 | 不依赖任何外部网络 |
| 集群去重 | 原生支持(路由策略/锁) | 需自己处理(ShedLock/DB 锁) |
| 分片并行 | 原生支持 | 需自己写分片逻辑 |
| 失败重试/告警 | 平台自带 | 自己写 |
| 可视化管控 | 有完整后台 | 无(看日志) |
| 额外运维成本 | 高(多一个高可用中间件) | 几乎为零 |
| 额外性能开销 | 网络 + 鉴权 + 序列化 | 进程内调用,几乎无 |
| 额外故障点 | 调度中心、网络、防火墙、鉴权 | 只有应用自身 |
三、这次为什么改成本地调度?四个理由
理由一:高频任务走 HTTP 是纯浪费
号源刷新 3 秒一次,一天要跑 28800 次。每次都要过网络、过网关、过鉴权拦截器、反序列化参数,这些开销乘上 28800 就很可观了。
改成本地调度后,就是进程里到点调一个方法,开销可以忽略不计。
理由二:线程池隔离,任务再忙也拖不垮用户
这是最关键的一点。看下改造前后的对比:
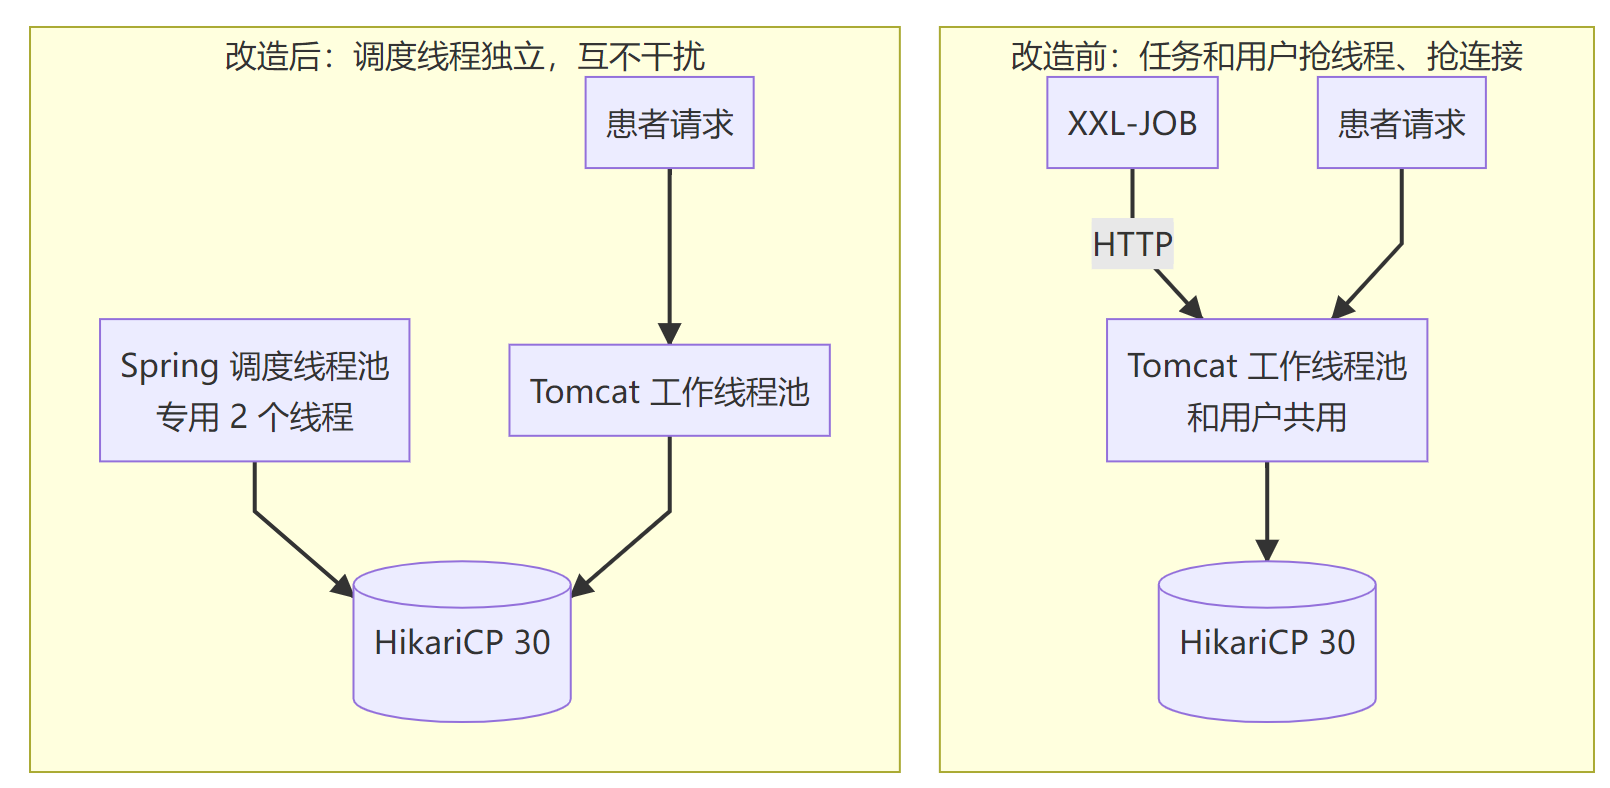
改造后,定时任务跑在专用的调度线程池里,和 Tomcat 的工作线程池物理隔离。哪怕任务跑慢了,也只是任务自己排队,患者挂号接口一点不受影响。
理由三:核心接口不再对外暴露,更安全
改造前 /api/refresh/source 是对外暴露的,加了鉴权也担心被人刷。改成本地调度后,这个方法就是个普通的内部方法,外部根本摸不到,从源头上消除了被恶意调用的风险。
理由四:砍掉一整条外部依赖链
改造前任务能不能跑,取决于:调度中心活着 + 网络通畅 + 防火墙放行 + 鉴权正常。任何一环出问题任务就停摆,而且停摆了你可能还不知道。
改造后只取决于一件事:业务服务自己活着。
改造效果(数据说话)
| 指标 | 改造前 | 改造后 | 变化 |
|---|---|---|---|
| 数据库连接占用(高峰) | 30/30 打满 | 2 以内 | ↓ 90%+ |
| 单次触发额外开销 | 网络往返 + 鉴权 + 解析 ≈ 50~200ms | 进程内调用 < 1ms | 基本归零 |
| Tomcat 线程占用 | 每次触发占 1 个工作线程 | 0 | 彻底隔离 |
| 外部依赖 | 调度中心 + 网关 + 防火墙 + 鉴权 | 无 | 减少 4 个故障点 |
| 对外暴露接口数 | 1 个 | 0 个 | 攻击面减小 |
| 额外运维成本 | 需维护调度中心集群 | 0 | --- |
四、改造前后代码对比
4.1 改造前:被 HTTP 调用的 Controller
@RestController
@RequestMapping("/api/refresh")
public class SourceRefreshController {
@Autowired
private SourceRefreshService sourceRefreshService;
/**
* 对外暴露的接口,被 XXL-JOB 每 3 秒调用一次
* 问题:占用 Tomcat 线程、每次都要过鉴权拦截器、接口暴露在公网
*/
@PostMapping("/source")
@AuthCheck(roles = "job") // 还得专门写一套鉴权
public Result refresh() {
sourceRefreshService.refreshAllSource();
return Result.ok();
}
}配套还得有:调度中心的任务配置、执行器注册、鉴权拦截器、白名单配置、防火墙规则......一整套东西。
4.2 改造后:本地 @Scheduled
@Slf4j
@Service
public class SourceRefreshTask {
@Autowired
private SourceRefreshService sourceRefreshService;
/**
* 每 3 秒执行一次(fixedDelay = 上一次执行结束后再等 3 秒)
* 注意:这里必须捕获异常,否则一次报错会影响后续执行的可观测性
*/
@Scheduled(fixedDelay = 3_000, initialDelay = 5_000)
public void refreshSource() {
long start = System.currentTimeMillis();
try {
sourceRefreshService.refreshAllSource();
log.info("号源刷新完成,耗时 {}ms", System.currentTimeMillis() - start);
} catch (Exception e) {
log.error("号源刷新任务执行失败", e);
}
}
}启动类加上开关:
@SpringBootApplication
@EnableScheduling
public class PatientApplication {
    public static void main(String[] args) {
        SpringApplication.run(PatientApplication.class, args);
    }
}
4.3 关键一步:配置专用调度线程池
这一步千万别省! Spring 的 @Scheduled 默认是单线程的,如果任务跑得慢会互相阻塞。必须显式配置线程池:
@Configuration
public class SchedulerConfig implements SchedulingConfigurer {
@Override
public void configureTasks(ScheduledTaskRegistrar registrar) {
ThreadPoolTaskScheduler scheduler = new ThreadPoolTaskScheduler();
// 号源刷新是独立任务,给 2 个线程足够,别开太大
scheduler.setPoolSize(2);
scheduler.setThreadNamePrefix("local-scheduler-");
scheduler.setWaitForTasksToCompleteOnShutdown(true);
scheduler.setAwaitTerminationSeconds(10);
scheduler.initialize();
registrar.setTaskScheduler(scheduler);
}
}划重点:这个线程池是给定时任务专用的,和 Tomcat 处理用户请求的线程池是两回事。哪怕定时任务全卡死,用户的挂号请求照样正常。
五、什么时候老老实实用外部调度?
别看了这篇文章就把 XXL-JOB 全下线了。下面这些场景,外部调度就是比本地调度强,别硬撑。
场景 1:任务数量多且分散在多个服务
比如 10 个微服务加起来 100 多个定时任务。用本地 @Scheduled 的话,改个执行时间要挨个服务改代码、重新发版,效率极低。外部调度后台点两下就完事。
判断口诀:任务数 > 30 或涉及服务数 > 3,优先外部调度。
场景 2:需要分片并行跑大数据批处理
例子: 每天凌晨跑千万级数据的日终结算,单节点要 2 小时。用 XXL-JOB 的分片路由,把任务拆成 10 个分片分给 10 个节点并行,20 分钟跑完。
本地调度要做同样的事,得自己写分片逻辑 + 分布式协调,成本高太多。
场景 3:任务绝对不能丢,需要重试 + 告警 + 全链路日志
例子: 金融的日终对账、医疗的医保数据上报。这类任务必须有失败自动重试、失败发钉钉告警、在线查看每次执行日志的能力。这些能力调度平台是自带的,自己从零写一套不现实。
场景 4:需要动态启停、临时手动触发
例子: 运营搞活动,要临时手动触发一次全量优惠券补发。外部调度后台点"立即执行"就完事;本地调度你得重启服务或者额外写个临时后台接口,还得多考虑权限问题。
场景 5:需要集群部署下保证只执行一次 + 负载均衡
例子: 订单超时自动关闭,部署了 4 个节点。用本地调度,4 个节点会各跑一次,要么加分布式锁要么改架构。外部调度的路由策略天然解决这个问题。
六、什么时候本地调度更香?
场景 1:任务简单、数量少,不想引入额外中间件
例子: 就两三个任务,每天清理过期缓存、刷新本地字典、导出个日报。为这几个任务单独部署一套 XXL-JOB 集群(还得做高可用),多一个中间件就多一个故障点。哪天调度中心挂了,所有任务全停,得不偿失。
场景 2:高频任务,对性能敏感
例子: 就是本文的号源刷新,3 秒一次。每次跨网络 HTTP 调用的开销远大于任务本身,改成本地调度后性能提升非常明显。
判断口诀:执行间隔 < 1 分钟的高频任务,优先本地调度。
场景 3:核心业务逻辑不想对外暴露接口
例子: 涉及资金、患者数据、内部缓存重建的敏感任务。本地调度后方法不再对外暴露,攻击面直接归零,也不用维护鉴权白名单。
场景 4:网络环境复杂或不可靠
例子: 我们那次防火墙误改导致 6 小时任务中断。如果业务服务部署在专有云/医院内网,和调度中心之间隔着好几层网络设备,那本地调度的稳定性优势会被进一步放大。
场景 5:团队小、没专人维护调度平台
例子: 三五个后端的小团队。搭 XXL-JOB 不难,难的是长期维护:版本升级、执行器注册异常、任务调度不执行的排查......本地调度这些问题基本不存在。
七、一张速查表,选型直接对照
| 你的实际情况 | 推荐方案 | 理由 |
|---|---|---|
| 任务 ≤ 10 个,集中在 1~2 个服务 | 本地调度 | 引入调度平台不划算 |
| 任务执行间隔 < 1 分钟 | 本地调度 | 避免高频网络开销 |
| 核心接口不想对外暴露 | 本地调度 | 从源头消除攻击面 |
| 网络环境复杂/跨机房 | 本地调度 | 少一个网络依赖 |
| 小团队,无专人运维 | 本地调度 | 零运维成本 |
| 任务 30+,分布在 5 个以上服务 | 外部调度 | 统一管控效率高 |
| 需要分片并行跑批处理 | 外部调度 | 原生支持,别自己造轮子 |
| 任务要求不丢、要有告警重试 | 外部调度 | 平台自带能力 |
| 需要动态启停 / 手动触发 | 外部调度 | 后台一键操作 |
| 集群部署且不能重复执行 | 外部调度 | 路由策略天然解决 |
| 金融/医疗合规要求审计日志 | 外部调度 | 有完整执行记录 |
八、选型流程图
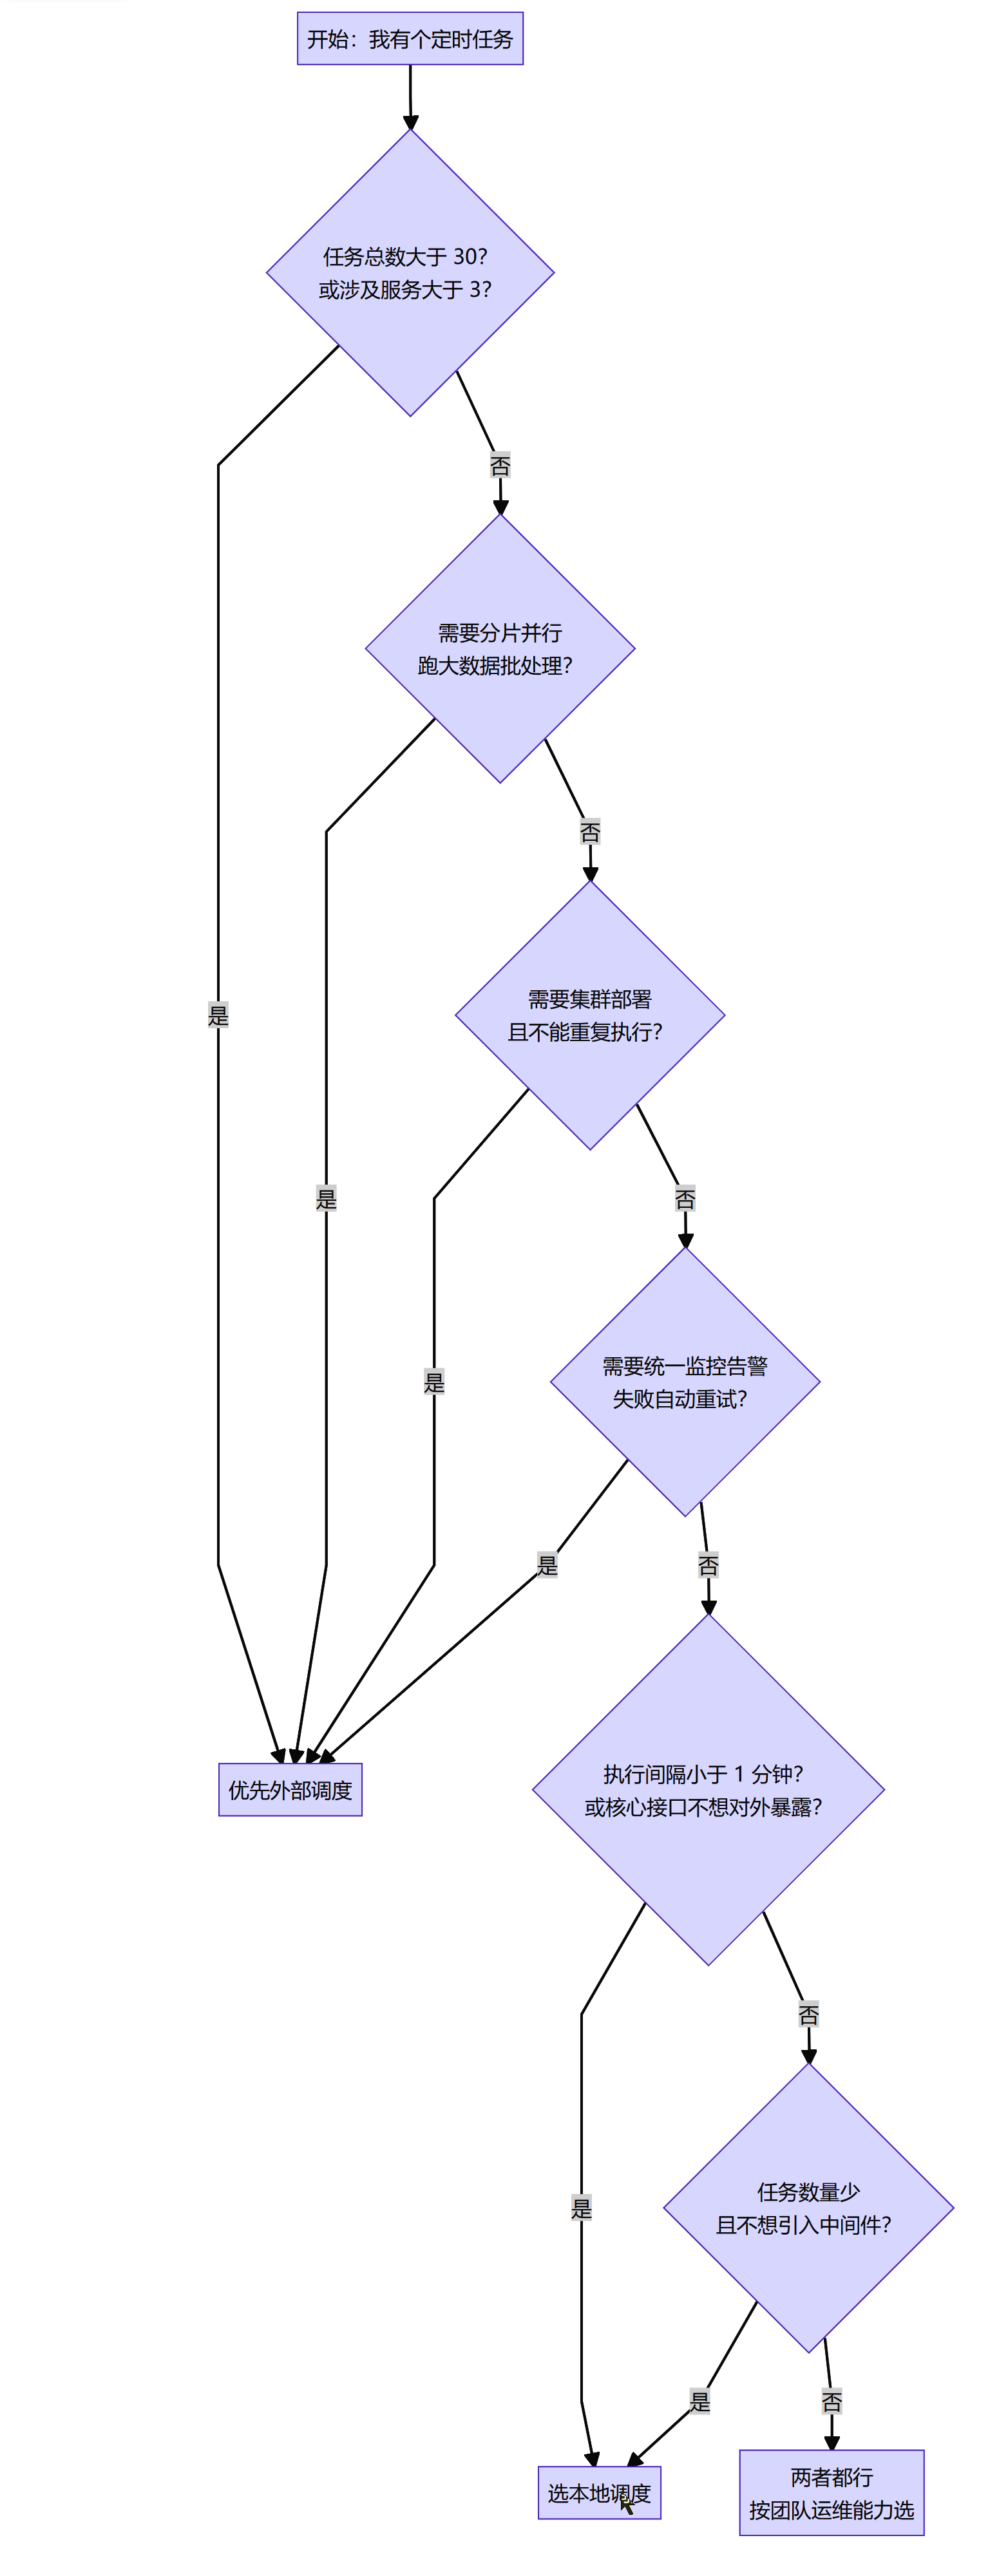
嫌看图麻烦的,记这几条就够:
-
任务少于 10 个、集中在单服务 → 本地调度
-
执行间隔小于 1 分钟的高频任务 → 本地调度
-
核心逻辑不想对外暴露接口 → 本地调度
-
任务超 30 个、分布在 5 个以上微服务 → 外部调度
-
要分片并行、要告警重试、要可视化管控 → 外部调度
九、本地调度的 6 个避坑点(很多人栽在这)
改成 @Scheduled 不是加个注解就完事了,这几个坑我建议提前避开。
坑 1:默认单线程,任务会互相阻塞
@Scheduled 默认只有一个调度线程。如果你有 3 个任务,其中一个跑 10 分钟,另外两个会被卡住。
解决: 按第四节的方式配置 ThreadPoolTaskScheduler,按任务量给线程数。
坑 2:多实例部署会重复执行
这是最容易踩的坑。 应用部署了 3 个节点,@Scheduled 就会跑 3 次。如果任务是"发送短信""扣库存"这类有副作用的,后果很严重。
解决方案(按推荐顺序):
| 方案 | 适用场景 | 说明 |
|---|---|---|
| ShedLock | 最常用 | 用 Redis/DB 做分布式锁,加个注解 |
| 数据库乐观锁 | 无额外依赖 | 任务开始前 UPDATE ... SET locked_by=... 抢锁 |
| 只在一台节点开启 | 简单粗暴 | 用 @ConditionalOnProperty 或配置中心开关控制 |
| 任务本身幂等 | 首要前提 | 无论用哪种方案,任务都要保证幂等 |
// ShedLock 示例:加个注解,多实例下同一时刻只跑一个
@Scheduled(cron = "0 0 2 * * ?")
@SchedulerLock(name = "cleanExpiredCache", lockAtMostFor = "PT30M", lockAtLeastFor = "PT5M")
public void cleanExpiredCache() {
    // ...
}
坑 3:fixedRate 和 fixedDelay 别用混
| 注解参数 | 含义 | 适合场景 |
|---|---|---|
fixedRate = 3000 |
每 3 秒触发一次(从上次开始算) | 任务必须按固定节奏跑,如心跳上报 |
fixedDelay = 3000 |
上次结束后再等 3 秒 | 任务耗时不定,如刷缓存、拉数据 |
cron |
按表达式定时 | 定点任务,如每天凌晨 2 点 |
号源刷新我们用的 fixedDelay,因为它一次执行耗时不定,从开始计时容易堆积。
坑 4:cron 表达式是 6 位不是 7 位
Spring 的 @Scheduled cron 是 6 位(秒 分 时 日 月 周),和 Linux 的 5 位不一样,也没有 Quartz 的"年"位。
// 错误:写成 5 位会直接报错
@Scheduled(cron = "0 2 * * *") // ×
// 正确:秒 分 时 日 月 周
@Scheduled(cron = "0 0 2 * * ?") // √ 每天凌晨 2 点坑 5:任务抛异常会影响后续执行
任务里抛了未捕获的异常,Spring 会打日志然后继续调度,但下次执行的时间点可能受影响(fixedDelay 场景),而且排查起来很痛苦。建议统一 try-catch + 告警日志。
坑 6:高频任务一定要控制单次执行时长
3 秒一次的任务,如果单次要跑 5 秒,任务就会堆积。经验值:单次执行时长应小于调度间隔的 50%。 超了就改成增量刷新、分批处理,或者调低频率。
十、还有个更优解:能不能不做全量刷新?
补充一个思路。号源刷新这类场景,其实还有第三条路------事件驱动 + 增量刷新。
| 方案 | 实时性 | 数据库压力 | 复杂度 |
|---|---|---|---|
| 外部 HTTP 全量刷新 | 一般(3 秒延迟) | 高(全量查) | 中 |
| 本地 @Scheduled 全量刷新 | 一般(3 秒延迟) | 高(全量查) | 低 |
| MQ 事件驱动增量刷新 | 高(毫秒级) | 低(只刷变更) | 高 |
| 本地 @Scheduled 增量刷新 | 较好 | 低 | 中 |
我们这次改造先选了本地 + 增量刷新 :只刷新最近有变动的号源(用 update_time 做游标),数据库压力直接从 200+ 条 SQL 降到 10 条以内。
技术选型从来不是"非此即彼",调度方式确定后,任务本身的实现还有优化空间。
最后说两句真心话
我见过太多项目,明明就几个简单的定时任务,为了"技术先进"强行上分布式调度,最后调度中心出的故障比定时任务本身的问题还多,完全是本末倒置。
也见过反过来的:几十个任务散落在七八个服务里,全靠 @Scheduled 硬撑,改个时间要发七八个版本,运维同学苦不堪言。
选型的核心不是哪个技术更新,而是哪个更适合你当下的业务规模和团队配置。 这次改造我们没用什么高大上的新技术,只是把一个高频核心任务从外部迁回本地,顺手做了增量优化,就解决了困扰我们大半年的连接池问题,改造成本不到两天,收益却是实打实的。
如果这篇文章能帮你少踩一个坑,那就值了。
参考代码: 完整可运行的 Spring Boot 示例(含调度线程池配置、ShedLock 集成、增量刷新 SQL)我整理好放在文末了,需要的同学评论区留言。
我是老于,一个在医疗后端踩坑多年的普通开发。主要分享线上事故复盘、架构选型和性能优化,欢迎关注。
附录:Mermaid 渲染失败时的 ASCII 备用图
如果发布后某张图还是渲染不出来(个别 CSDN 编辑器版本对 Mermaid 支持不全),把对应位置换成下面的代码块图即可,任何 Markdown 渲染器都能正常显示。
备用图 1(对应 1.1 改造前的架构):
        ┌──────────────┐   每 3 秒一次 HTTP 请求   ┌──────────────────────┐
        │  XXL-JOB     │ ────────────────────────▶ │  Tomcat 线程池       │
        │  调度中心    │                           │  8000 端口(共用)   │
        └──────────────┘                           └──────────┬───────────┘
                                                              │
        ┌──────────────┐   正常挂号请求             ┌─────────▼───────────┐
        │ 患者 App /   │ ────────────────────────▶ │ /api/refresh/source │
        │   小程序     │                           └─────────┬───────────┘
        └──────────────┘                                     │
                                                   ┌─────────▼───────────┐
                                                   │ MySQL · HikariCP    │
                                                   │   30 连接(打满)   │
                                                   └─────────────────────┘
备用图 2(对应 1.3 问题二的链路图):
 调度中心 → 网络传输 → Nginx/网关 → 鉴权拦截器 → 参数解析/反序列化 → 业务方法
            └──────────── 每 3 秒白跑一遍的"过路费" ────────────┘
备用图 3(对应理由二的改造前后对比):
【改造前】任务和用户抢线程、抢连接
XXL-JOB ──HTTP──▶ Tomcat 工作线程池(共用)──▶ HikariCP 30
患者请求 ────────▶ ▲
【改造后】调度线程独立,互不干扰
Spring 调度线程池(专用 2 线程)──▶ HikariCP 30
患者请求 ─▶ Tomcat 工作线程池 ────▶ HikariCP 30备用图 4(对应第八节选型流程图):
                    ┌─────────────────────┐
                    │  我有个定时任务      │
                    └──────────┬──────────┘
                               ▼
              任务总数>30 或 涉及服务>3 ?──是──▶ 【外部调度】
                               │否
                               ▼
              需要分片并行跑大数据批处理?──是──▶ 【外部调度】
                               │否
                               ▼
              需要集群部署且不能重复执行?──是──▶ 【外部调度】
                               │否
                               ▼
              需要统一监控告警+失败重试?──是──▶ 【外部调度】
                               │否
                               ▼
          执行间隔<1分钟 或 核心接口不想对外暴露?─是─▶ 【本地调度】
                               │否
                               ▼
              任务少且不想引入中间件?──是──▶ 【本地调度】
                               │否
                               ▼
两者都行,按团队运维能力选需要的话,我可以把第九节的避坑示例代码(ShedLock 完整配置 + 增量刷新 SQL)单独整理成一篇续文,方便这篇保持精简、代码细节另开一篇。