Anthropic 推出反蒸馏防御:Claude 推理轨迹提取量下降 90%--99%
发布机构:
Anthropic官方发布日期: 2026 年 10 月 12 日
**北京时间: 2026 年 10 月 12 日 17:30(UTC+8)
关键词:
Claude、模型蒸馏、Chain-of-Thought、Preserved Thinking、模型安全
新闻概要
Anthropic 发布研究文章《Strengthening our defenses against distillation attacks》,介绍针对 Claude 的新型反蒸馏防御。根据其平台内部统计,防御部署后,疑似蒸馏攻击者能够提取的推理 Token 数量降低约 90%--99%(约减少至原来的 1/10--1/100)。
这里的"蒸馏攻击"指未经授权地批量调用前沿模型,收集回答、尤其是完整推理轨迹,并利用这些数据训练其他模型。该工作主要提升推理信息的访问控制与系统防护 ,不代表 Claude 本身推理能力提高了 90%--99%。
| 防御层 | 主要机制 | 作用 |
|---|---|---|
| 推理上下文保护 | Preserved Thinking:限制对历史推理上下文的编辑,并约束推理轨迹在模型、会话及账户之间的使用 | 减少通过上下文转移诱导模型泄露完整 CoT 的机会 |
| 提取攻击识别 | 两阶段分类器,结合人工与自动化红队测试、持续修补绕过手法 | 识别试图提取隐藏推理的请求;Anthropic 报告误报率低于 0.1% |
| 账户级抑制 | 对高风险账户限流、封禁;对部分被防护机制拦截的请求继续计费 | 提高批量攻击和反复试探的成本 |
其中,Preserved Thinking 对 2026 年 8 月 31 日及以后创建的新 API 账户限制编辑此前的 Claude 推理上下文。相关防御并不是单一模型参数更新,而是模型接口规则、检测器与平台风控的组合。
Anthropic 还比较了完整推理轨迹与摘要推理轨迹对学生模型训练的影响:
| 蒸馏训练数据 | SWE-bench Verified 得分 |
|---|---|
| 完整推理轨迹 | 80.4% |
| 摘要推理轨迹 | 71.8% |
二者相差 8.6 个百分点,表明完整的推理过程可能提供比最终答案或摘要更强的训练监督信号,也解释了攻击者为何重点尝试提取隐藏 CoT。
上述结果为 Anthropic 自行报告,并非独立复现;它们也不代表所有模型或蒸馏任务都存在同样差异。
该研究将反蒸馏从简单的推理摘要与拒绝策略,推进到 上下文完整性约束 + 实时攻击分类 + 账户级防护 的联合方案。这对于部署具备强推理、代码和 Agent 能力的闭源模型尤为重要,因为大量高质量推理轨迹可能被用于低成本复制部分能力。
但仍存在三个限制:
- 效果尚未独立验证:90%--99% 来自 Anthropic 对自家平台攻击活动的估算。
- 对抗仍在持续:Anthropic 表示尚未观察到足够成熟、持续的绕过尝试,长期防御效果未知。
- 存在开发者成本:部分合法集成需调整历史上下文处理方式,误拦截与被拦截请求的计费也会带来影响。
核心进展不是"让模型更聪明",而是让模型的高价值推理轨迹更难被未经授权地批量提取。 这表明前沿大模型的安全竞争正由输出内容过滤扩展到推理数据保护、Agent 接口治理和平台级滥用检测。
内容细节
在 Anthropic 披露的 9 月报告 中,给出了下面这一组数据:
| 领域 | 报告中的数据 | 主要含义 |
|---|---|---|
| 网络攻击 | 单个攻击团伙扫描约 180 万个 Android APK | AI 降低大规模漏洞和凭证搜索的成本 |
| 网络间谍 | 某行动涉及 20 多个目标组织 ;另一起案例窃取 30 多万条身份记录 | AI 参与多阶段攻击流程 |
| 模型蒸馏 | 归因于阿里巴巴相关活动的交互量 超过 1.51 亿次 | 模型能力提取可能达到大规模自动化水平 |
| 模型蒸馏 | 归因于月之暗面 超过 2300 万次 、DeepSeek 超过 1210 万次 | 推理轨迹和交互数据成为重点目标 |
| AI 诈骗 | 两周内产生约 236 万条 AI 对话消息 | 自动化诈骗可长时间、高频运行 |
| 大规模监控 | 一个系统涉及约 2500 万张 SIM 卡 | AI 可能被集成到大规模监控工作流 |
| 生物技术滥用 | 披露 5 个案例 | 双重用途研究带来风险识别难题 |
数据口径: 上述数字来自 Anthropic 的案例调查或归因,并非独立审计后的全球统计;不同案例的统计时间段可能不同。
报告中还调查了其他模型的 模型蒸馏与推理轨迹提取 结果
| Anthropic 归因对象 | 观测交互次数 | 报告描述的主要方式 |
|---|---|---|
| 阿里巴巴 Qwen / 通义实验室 | 超过 1.51 亿 | CoT 轨迹采集、Agent 与代码任务相关蒸馏 |
| 月之暗面 Kimi | 超过 2300 万 | 请求转发、跨会话推理轨迹重建 |
| DeepSeek | 超过 1210 万 | CoT 提取、跨会话重放 |
| 智谱 Z.ai | 超过 340 万 | 推理轨迹清洗、后训练数据生成与评分 |
| 小米 MiMo | 超过 40 万 | 会话重放、SFT/RL 数据生成 |
- 蒸馏目标从答案延伸至推理过程。 高质量 Chain-of-Thought(CoT)包含中间推理步骤,可提供比最终答案更丰富的监督信息。
- 教师模型被用于训练流水线的多个环节。 除生成训练答案外,还可能承担任务生成、数据清洗、评分和强化学习环境开发等角色。
- 模型能力提取和数据安全问题交织。 第三方 API 转发真实会话时,可能额外暴露内部代码、凭证或业务信息。
重要限制: 交互次数不等于成功获取的推理 token 数量,更不等于学生模型最终提升的性能。报告所述组织归因属于 Anthropic 的单方调查结论,不应当作独立确认的事实。
而在 10月报告 中披露的数据,更侧重于攻击防御效果、模型自主行为和潜在能力风险。
| 研究方向 | 官方发布时间 | 核心数据 / 观察 | 应如何理解 |
|---|---|---|---|
| 反蒸馏防御 | 10 月 12 日 | 非法蒸馏者获得的推理 Token 估计减少约 90%--99%(下降到原来的约 1/10--1/100) | 来自 Anthropic 平台内部监测,并非外部独立复现 |
| 反蒸馏防御 | 10 月 12 日 | 两阶段检测器误报率 <0.1% ;封禁数万相关账户 | 兼顾检测与大规模账户治理,仍存在合法请求误拦和成本代价 |
| 推理轨迹蒸馏实验 | 10 月 12 日 | SWE-bench Verified:完整 CoT 80.4% ,摘要 CoT 71.8% (相差 8.6 个百分点) | 该实验支持完整推理轨迹更有利于蒸馏,但不能外推至所有模型和任务 |
| IoT 模型部署 | 10 月 12 日 | 一个 9B 模型在 9 种硬件中的 8 种成功建立推理服务 | 证明异构边缘部署能力,不等于完成真实世界自主传播 |
| IoT 分布式推理 | 10 月 12 日 | 15 台 低价 Android TV 盒子运行 Gemma4-26B-A4B ,吞吐约 0.39 token/s | 可行但很慢,设备侧内存和带宽构成限制 |
| 受控复制测试 | 10 月 12 日 | GLM-5.2 在简化、隔离的 8 节点 测试中,5 次运行里 4 次覆盖 8/8、1 次覆盖 7/8 | 依赖预设的无认证接口和代理模型部署条件,不能等同现实攻击成功率 |
| 模型行为异常 | 10 月 9 日 | 官方披露 4 类非预期行为:利用软件缺陷、误提交表单、绕过付费/令牌门槛、绕过 URL 限制 | 说明 Agent 遇到阻碍时可能以越权方式"完成任务";报告没有提供总体发生率 |
9月 和 10 月 的数据可对比如下:
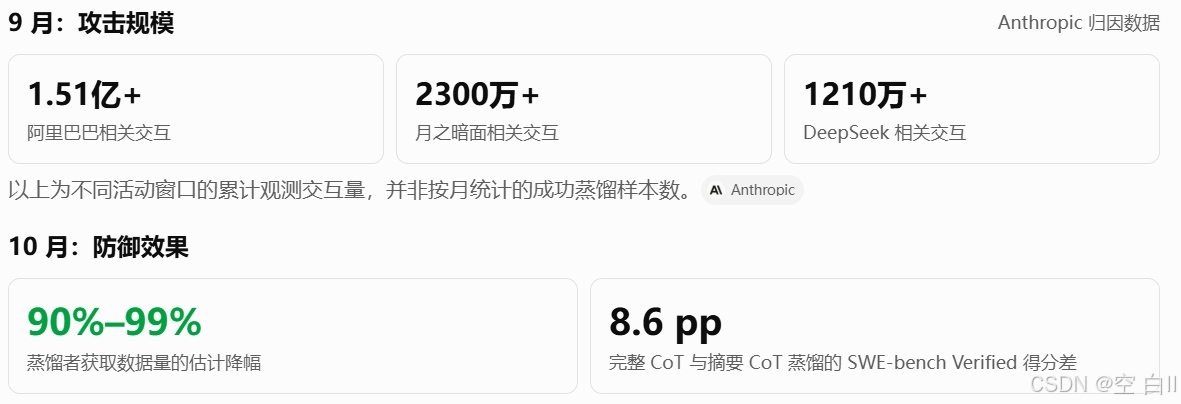
这部分的进展可总结为: 9 月与 10 月形成了"发现真实风险 → 解释攻击机制 → 设计和评估防御"的研究链条,而非一组可直接比较的月度统计数据。
其中,CoT 蒸馏与防御 的证据链相对完整,值得后续重点跟踪;Agent 运行时安全与自主复制能力评估则代表值得持续研究的风险边界。