如一 Agent 架构解读(十九):错误的修养------工具报错是 Agent 唯一的自纠教材
今年 8 月,我们的 web 工具在线上连挂了 6 次。不是网络抖动,不是服务不可用------同一个模型、同一个任务、同一个工具,六次调用,六次
invalid_type。排查到最后,原因有点荒唐:qwen 系列模型遇到顶层 anyOf 的工具时,会把数组、对象参数序列化成 JSON 字符串发过来。它发的不是错参,是穿了件字符串外衣的参数。复盘时最扎眼的不是 bug 本身,而是那六次报错:每一次都准确、结构化、如实回到了模型面前------从协议角度看全是"正确"的错误。但六次自纠机会全废了,因为这个错根本不该由模型来纠。教材编得再好,也救不了一道出错的题。
这个事故是这篇的入口。传统软件里,错误信息是 UX,写给人看,最好连堆栈都附上;Agent 系统里,错误信息是教材,写给一个会读、会改、但没有任何外部信息渠道的学生。模型没有 IDE,没有文档站,没有同事可以问------它自纠的依据,几乎只有你返回的那条 tool_result。教材怎么编,直接决定它下次考多少分。
错误信息换了个读者
Anthropic 在《Writing effective tools for agents》里给过一个用词很激进的建议:错误响应也要 prompt-engineer------prompt-engineer your error responses to clearly communicate specific and actionable improvements,别丢给 agent 一堆不透明的错误码和堆栈。注意这个措辞:错误信息不是"执行结果的说明",它是下一轮 prompt 的一部分,是你对这个学生说的下一句话。
对照行业现状,大多数系统给模型的还是写给人的错误。Claude Code 的工具结果是 content blocks 加一个 is_error 布尔,错误能不能自纠全押在文本质量上;MCP 的 isError 本体也只有成功和失败两态,细分状态得靠 structured content 另想办法。薄不是问题------问题是薄薄的那几行字,是不是按"教材"的标准写的。
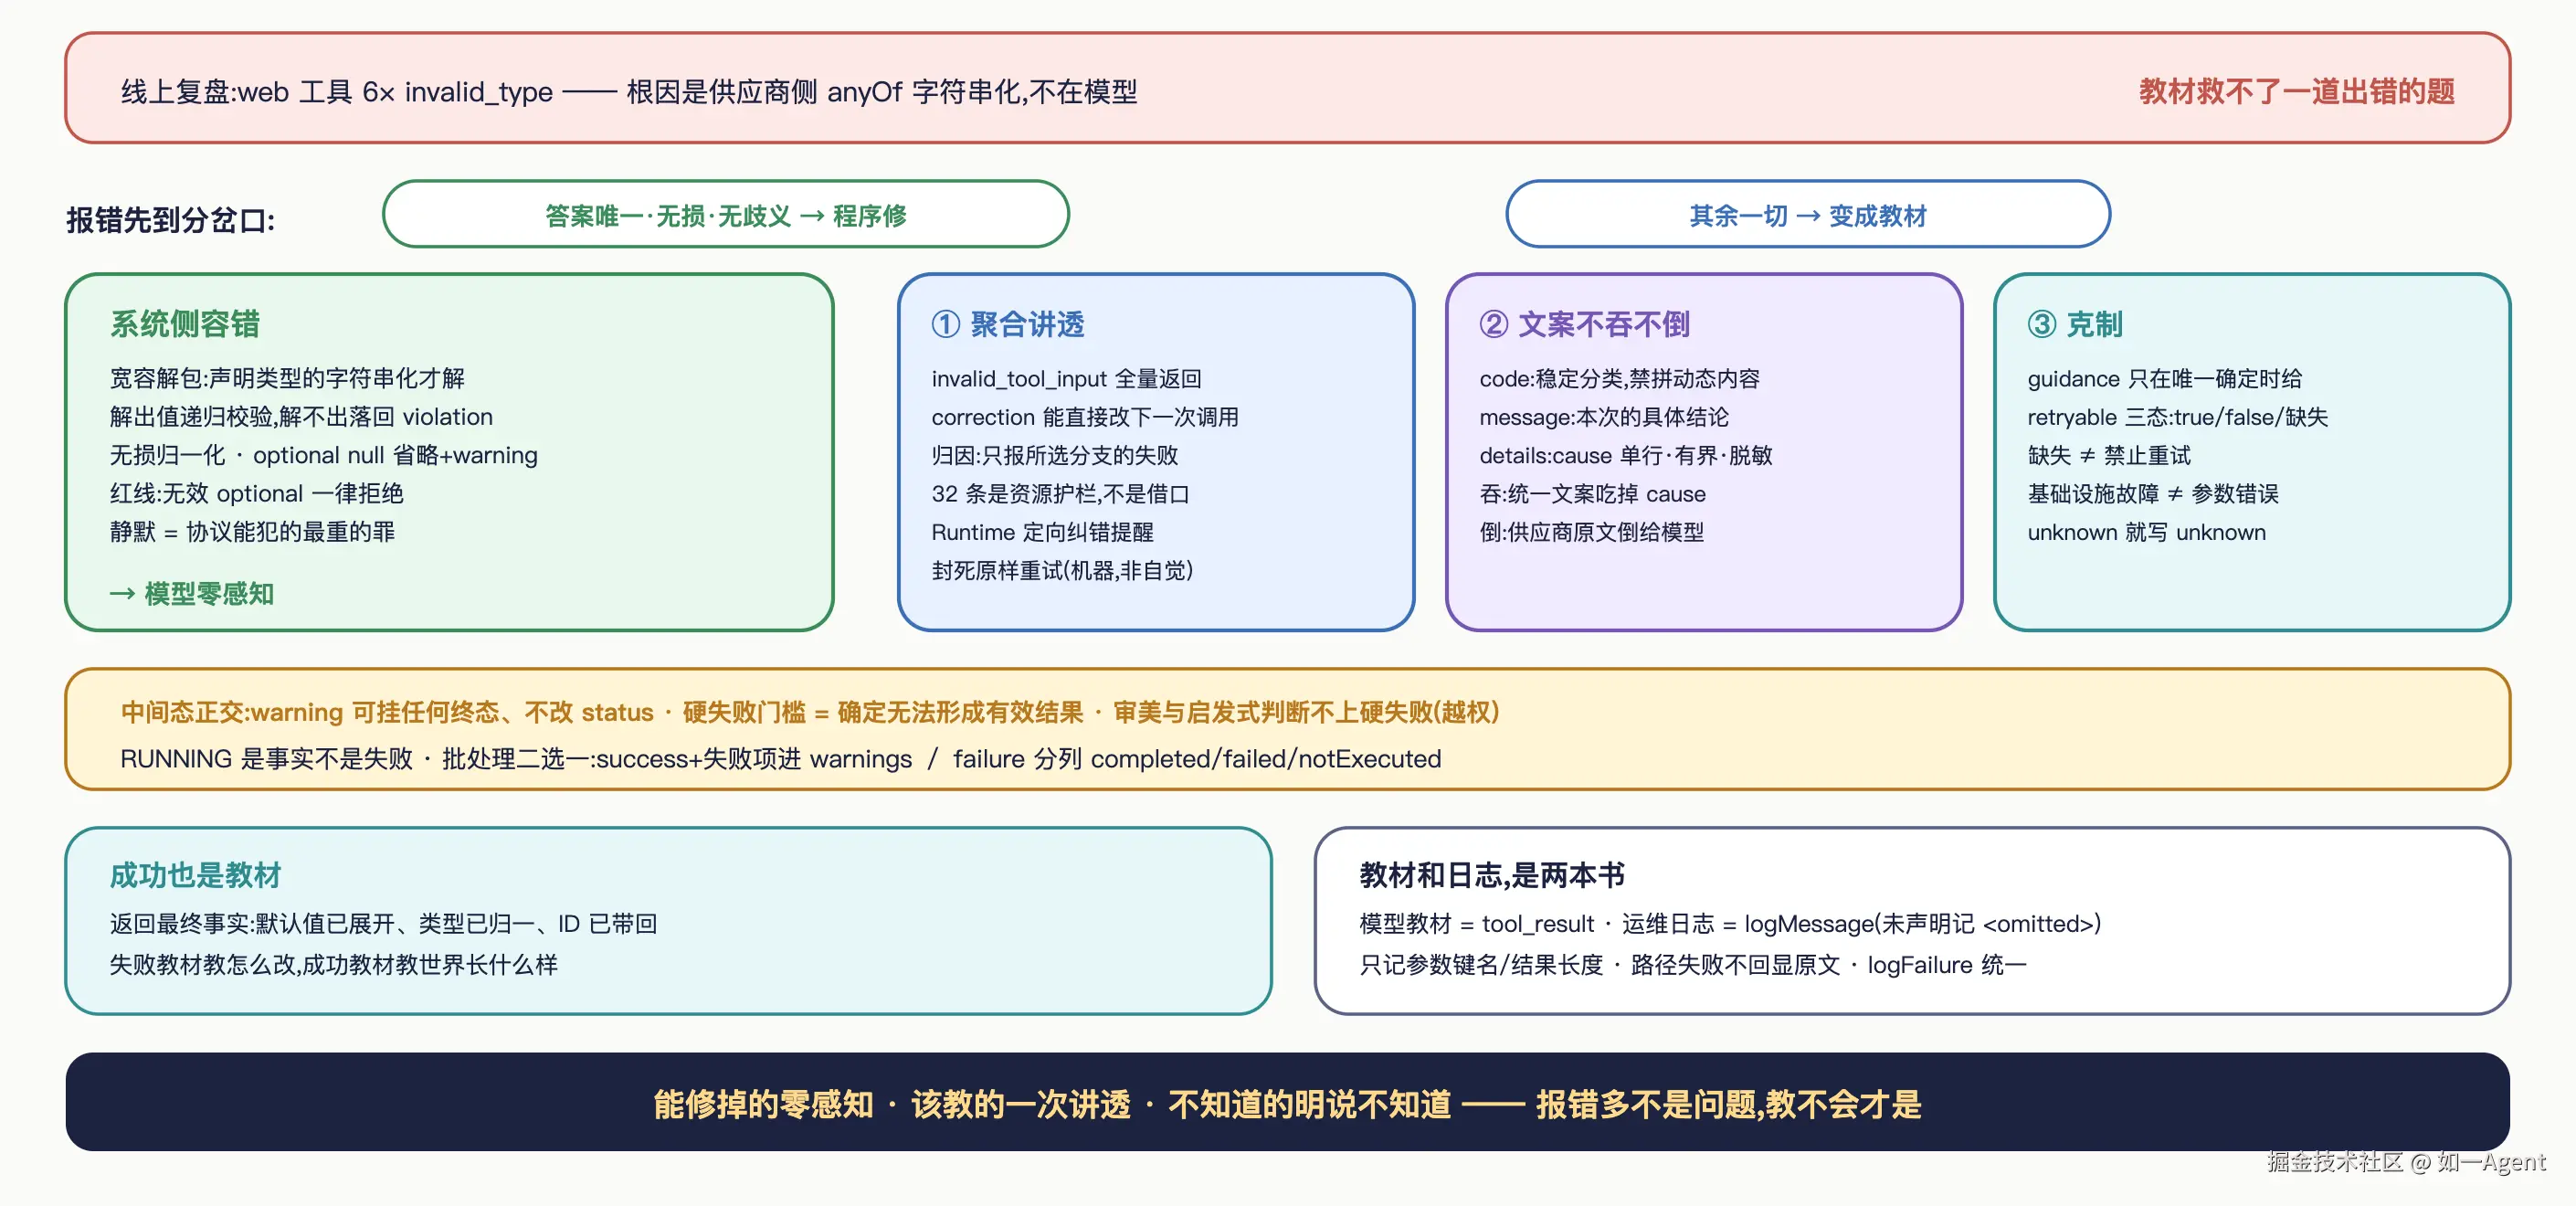
所以错误设计的第一课不是怎么写错误,而是这个错误该不该存在。Agent 系统里的错误有两个去处:系统侧容错------程序自己能修,模型零感知;模型侧自纠------必须教给模型,让它下一次调用改对。分类错了,两边都是灾难:该修掉的拿去教,是浪费 turn 还教不会;该教给的静默吞掉,模型会拿着一个它以为生效了的世界继续走。
该修掉的,别拿出来教
回到那六次报错。期望数组而收到数组的 JSON 文本,这件事只有一个合理解释------无歧义、无损。模型侧和 Skill 侧都修不了(这是模型供应商侧的序列化行为,模型自己毫无觉察),正解落在输入准备层:判 invalid_type 之前,先做一步有边界的解包。
边界是这条规则能成立的原因:仅当 schema 声明的期望类型是 array/object/number、而实际收到字符串时触发;字符串内容是合法 JSON 且形态匹配期望类型才解出,解出的值递归走完整校验------不是换个类型就放行;解不出就落回原来的 violation,不做猜测。只解包声明类型的字符串化形态,不做字符串和类型之间的任何其他转换。平台修一次,所有模型、所有 Skill、所有调用点同时受益,模型对这次修复零感知。
同类可以静默修掉的还有:无损且唯一的归一化;optional 传 null 时的安全省略------schema 声明了 default 就应用默认值,否则省略,两种都附一条 warning 备查。但注意反面:非 null 的无效 optional 一律拒绝。模型把一个 60 秒的等待参数写成非法值,系统"贴心"地改成默认值继续跑,它这辈子都不知道自己的意图被篡改了。第九篇立过那条规矩:静默是协议能犯的最重的罪,它把错误变成谎言。容错和静默的分界就在一句话里------答案唯一、无损、无歧义的,程序修;其余一切,变成教材。
该教的一次讲透
模型真填错参数的时候,教材质量决定自纠效率。三条纪律。
第一,聚合,不让闯关。invalid_tool_input 一次返回全部 violation,每条带 path、code 和 correction------correction 必须能直接改变下一次调用,是"Remove confidence or change epistemic_type to INFERRED"这种,而不是"参数有误"这种。逐字段闯关是错误设计里最贵的浪费:报一个错、模型改一个、再报下一个,每次往返烧掉一整个 turn,还往上下文里灌一串失败记录。投影设了 32 条上限,那只是防异常参数放大上下文的资源护栏,不是不聚合的借口。聚合还包括归因:模型已经选定了判别分支,就只报那个分支的失败------把所有分支的 violation 平铺,等于暗示它去改本来做对的地方,第九篇说的"错误的归因质量决定自纠的效率"就是这个意思。
第二,文案既别吞也别倒。吞的反面是统一文案:"写入失败"四个字,把 is a directory、refusing to replace symbolic link、file too large 这种一句话就能点醒模型的 cause 全吞掉,模型只能瞎试。倒的反面是把供应商原文、异常类名、动态路径原样倾倒进错误------code 必须是稳定分类,拼进动态内容就没法做机器判断。正确的形态是三层各就各位:code 稳定,message 说本次的具体结论,details 里的 cause 单行、有界、脱敏。
第三,教材发出去要有人盯。Runtime 自己就是 error 的机器消费者:invalid_tool_input 之后,下一轮自动注入一条不持久化的定向纠错提醒,要求逐项按 correction 修改,并且明确禁止原样重试。工具教一遍,管道再盯一遍------原样重试这条路,是被机器封死的,不是靠模型自觉。
不知道的,就说不知道
教得起的地方要教透,教不起的地方要克制。guidance 只在工具能唯一确定下一步时出现;retryable 是三态而不是布尔------true 是按指导修正后值得重试,false 是明确知道没用(比如确定的安全拒绝),缺失是工具不知道。缺失不等于禁止重试,也不诱导模型瞎猜。
最常见的破戒,是把基础设施故障报成参数错误。沙箱不可用、I/O 失败,模型拿着 invalid_arg 改参数改到天荒地老也修不好------这类错误只返回有界的诊断事实,除非能唯一确定修法,否则省略 guidance,绝不能把环境的锅猜成模型的错。超时同理,副作用状态已知就写已知,不知道就写 unknown(第十八篇的纪律:只陈述事实,不指导行动)。
Anthropic 说错误要 actionable,这话没错,但得补个后半句:给不出 actionable 的错误,诚实就是它唯一的 actionable。编一条模型执行不了的"建议",比不给建议更贵。
成功和失败之间,还有第三种诚实
warning 是任意终态都可以携带的附加事实,不改变 status------这个正交结构第九篇立过。这里讲的是 warning 的准入纪律:什么配当 warning,什么必须失败,什么压根不该出现。
硬失败的门槛要高:只用于确定无法形成有效结果------安全违规、输入缺失、产物不存在或损坏。工具已经产出可检查的结果、但偏差可能有合理解释的时候,比如内容超出画布被裁掉、布局轻微溢出,正确做法是退出 0、在 warnings 里给稳定分类和诊断事实,让 Agent 看着真实产物自己判断。我们的 QA 纪律是:确定无法形成有效结果才阻断交付;存在多种合理解释的偏差一律 warning。把启发式质量判断和审美偏好升级成硬失败,等于脚本替模型做作品判断------这是越权,越权的代价比漏报大。
warning 也有下限:���塞纯提示、下一步推荐和审美偏好,更不能拿 warning 伪装"执行失败但想让流程继续"。中间态同样别报成错误:一条命令超窗口没跑完是事实,RUNNING 加句柄是事实(第十八篇),都不是失败。
批处理是这个纪律的试金石。部分失败后产物仍完整可用,就 success、失败项进 warnings;用户要的结果不成立,就 failure,details 里分列 completed、failed、notExecuted。只有"部分成功"四个字的结果,等于让模型猜残局------隐瞒残局比失败本身更伤。
成功也是教材
最容易被忽视的一条:成功结果也在教模型。成功必须返回最终事实------落库后的完整记录、默认值已展开、类型已归一、数据库生成的 ID 已带回------而不是"成功"两个字。模型以成功结果为事实来源向用户回执,返回"成功"两个字,等于逼它自己脑补事实,脑补错了就是幻觉。失败的教材教它怎么改,成功的教材教它世界现在长什么样。两本都不能省。
教材和运维日志,是两本书
最后一条边界:给模型看的 message 和给运维看的日志分离。工具要显式声明仅供日志的 logMessage,没声明的旧工具,日志里记 message=<omitted>,绝不能默认把面向模型的文案写进日志。反过来,日志也不能污染教材:details 里有界裁剪密码、token、cookie,路径解析失败不回显非法原始路径------敏感路径跟着错误进了 transcript,等于错误协议自己开了个泄密口。
日志侧的纪律同样硬:工具开始只记参数键名不记参数值,成功只记结果长度不记内容预览,所有失败走同一个 logFailure,不按工具名维护日志白名单。模型自纠需要的全部材料都在 tool_result 里------它不需要、也不能依赖服务端日志。
错误的修养
回到开头那六次报错。修完之后,web 工具再没因为这个原因失败过------不是模型学乖了,是那道题从考卷上被撕掉了:它本来就不该出。
能无损修掉的,模型零感知;必须模型改的,一次讲透,correction 能直接改变下一次调用;系统不知道的,明说不知道,不编修法;中间态如实呈现,不让审美伪装成错误,不让遗憾伪装成失败;成功返回世界的完整样子,而不是"成功"两个字。这就是错误的全部修养。
第十八篇说,耗时长从来不是错误,失控才是。这篇补上半句:报错多也不是问题,教不会才是。