成为全栈·Flutter App 篇·Flutter Markdown 阅读器:支持范围与渲染边界
做阅读器之前我先问了一个问题:App 里渲染的 Markdown,和 Web 上渲染的,是同一样东西吗?
想当然是。但写完第一版就发现不对,而且不对的地方比想象的多。
用户的文章是从 Web 后台写的 Markdown,编辑器支持 GFM。Web 端渲染得好好的,搬到 App 里却出四类问题:代码块在手机上溢出了、表格被裁掉一半、目录点击跳错位置、深色模式下代码颜色几乎看不清。
这四类问题的共同点是------它们都不在"Markdown 语法"的范畴里,而在"渲染环境"的范畴里。
这篇讲 core/markdown/ 那三百多行是怎么处理这些的,以及一个我一开始完全没意识到、后来变成整个模块最核心的问题:目录锚点到底由谁定义。
为什么不是同一个东西
Web 浏览器里渲染 Markdown,本质是把它转成 HTML 字符串,交给浏览器。浏览器有完整的 CSS、DOM、以及十六年的排版经验------表格会自动换行、图片会自动缩放、代码块自带横向滚动。
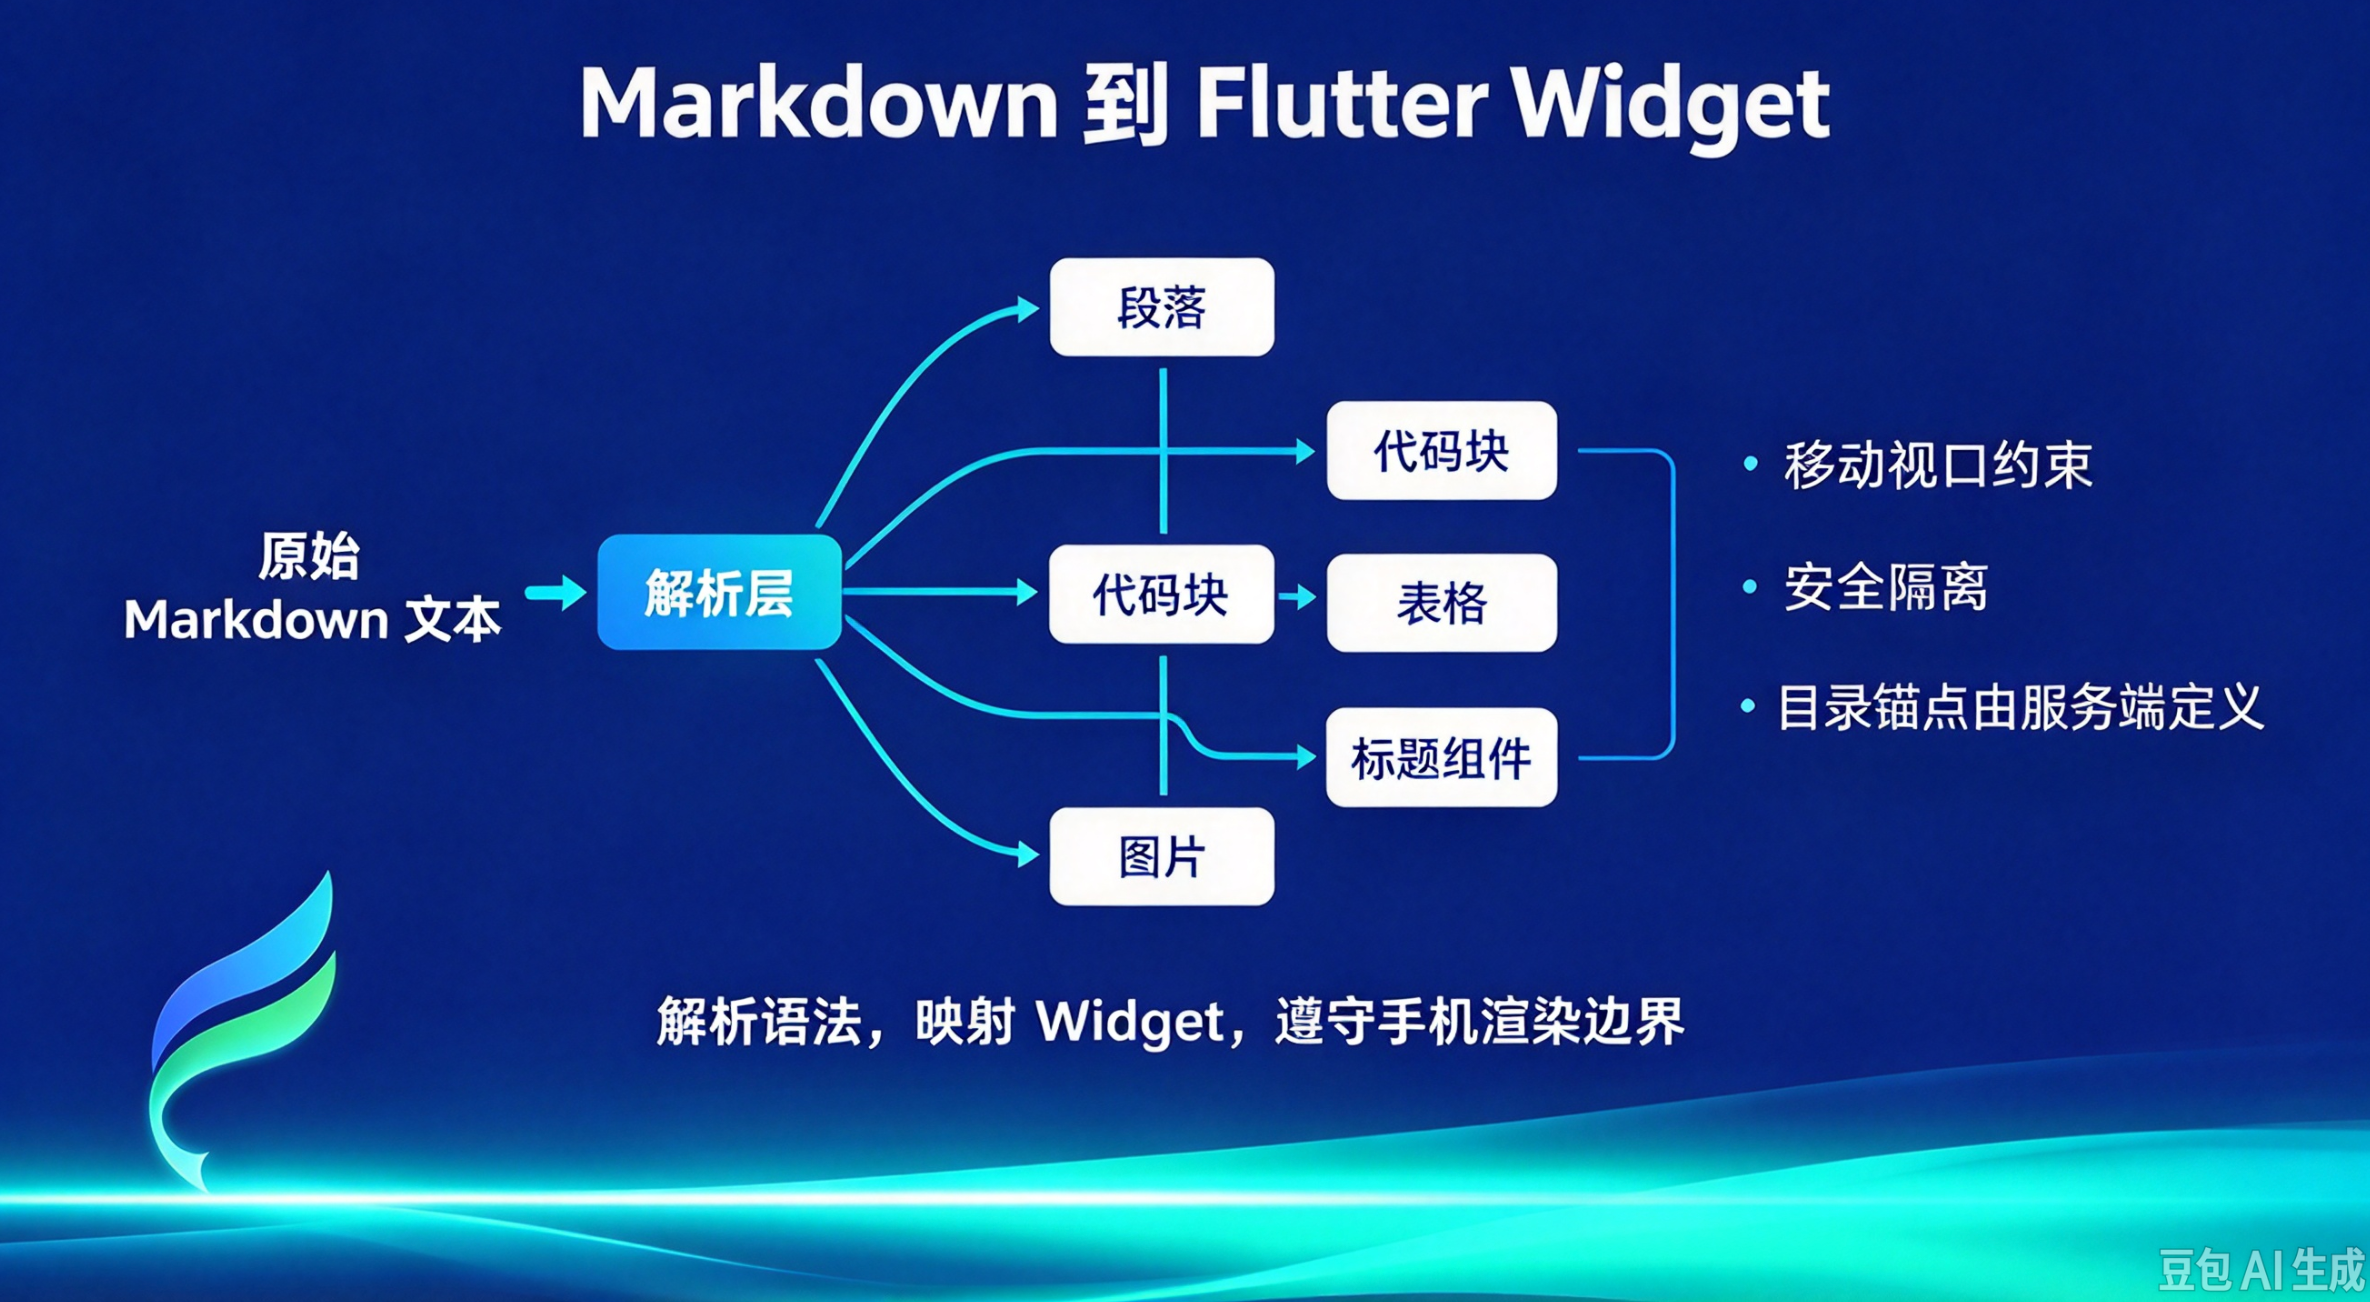
Flutter 没有这些东西。它有 Widget,而 Markdown 库要做的事是把语法节点翻译成 Widget。
差别可以用一个问题来概括:在浏览器里,"一个宽度为 400px 的表格"是一句 CSS;在 Flutter 里,它是一个需要你手动实现的滚动容器。
所以 M4-13 这件事的难点不在解析 Markdown(那是库的工作),而在渲染约束:手机屏幕窄、用户可能开大字号、主题会变、内容不可信。
不可信的内容是第一约束
先说安全,因为它决定了后面所有取舍。
文章正文来自用户投稿,是外部输入。这意味着:
dart
class _CodeBuilder extends MarkdownElementBuilder {
  _CodeBuilder(this.public);
  final bool public;
  ...
  return _CodeBlock(source: source, language: language, public: public);
}
这个 public 参数一路传到代码块,用来决定这段代码能不能进共享缓存 。看 CodeCache 的实现:
dart
/// 仅共享公开正文的词法节点,不缓存主题颜色、组件或目录定位键。
class CodeCache {
  static final _nodes = <String, List<hl.Node>>{};
  static int _characters = 0;

  static List<hl.Node> parse(
    String source,
    String language, {
    required bool public,
  }) {
    final key = '$language\u0000$source';
    final existing = public ? _nodes.remove(key) : null;
    if (existing != null && public) {
      _nodes[key] = existing;       // ← 命中后放回队尾,实现 LRU
      return existing;
    }
    final nodes =
        hl.highlight.parse(source, language: language.toLowerCase()).nodes ?? [];
    if (public && key.length <= CacheLimits.highlightEntryCharacters) {
      _nodes[key] = nodes;
      _characters += key.length;
      while (_nodes.length > CacheLimits.highlightEntries ||
          _characters > CacheLimits.highlightCharacters) {
        final first = _nodes.keys.first;
        _characters -= first.length;
        _nodes.remove(first);
      }
    }
    return nodes;
  }
三个设计点:
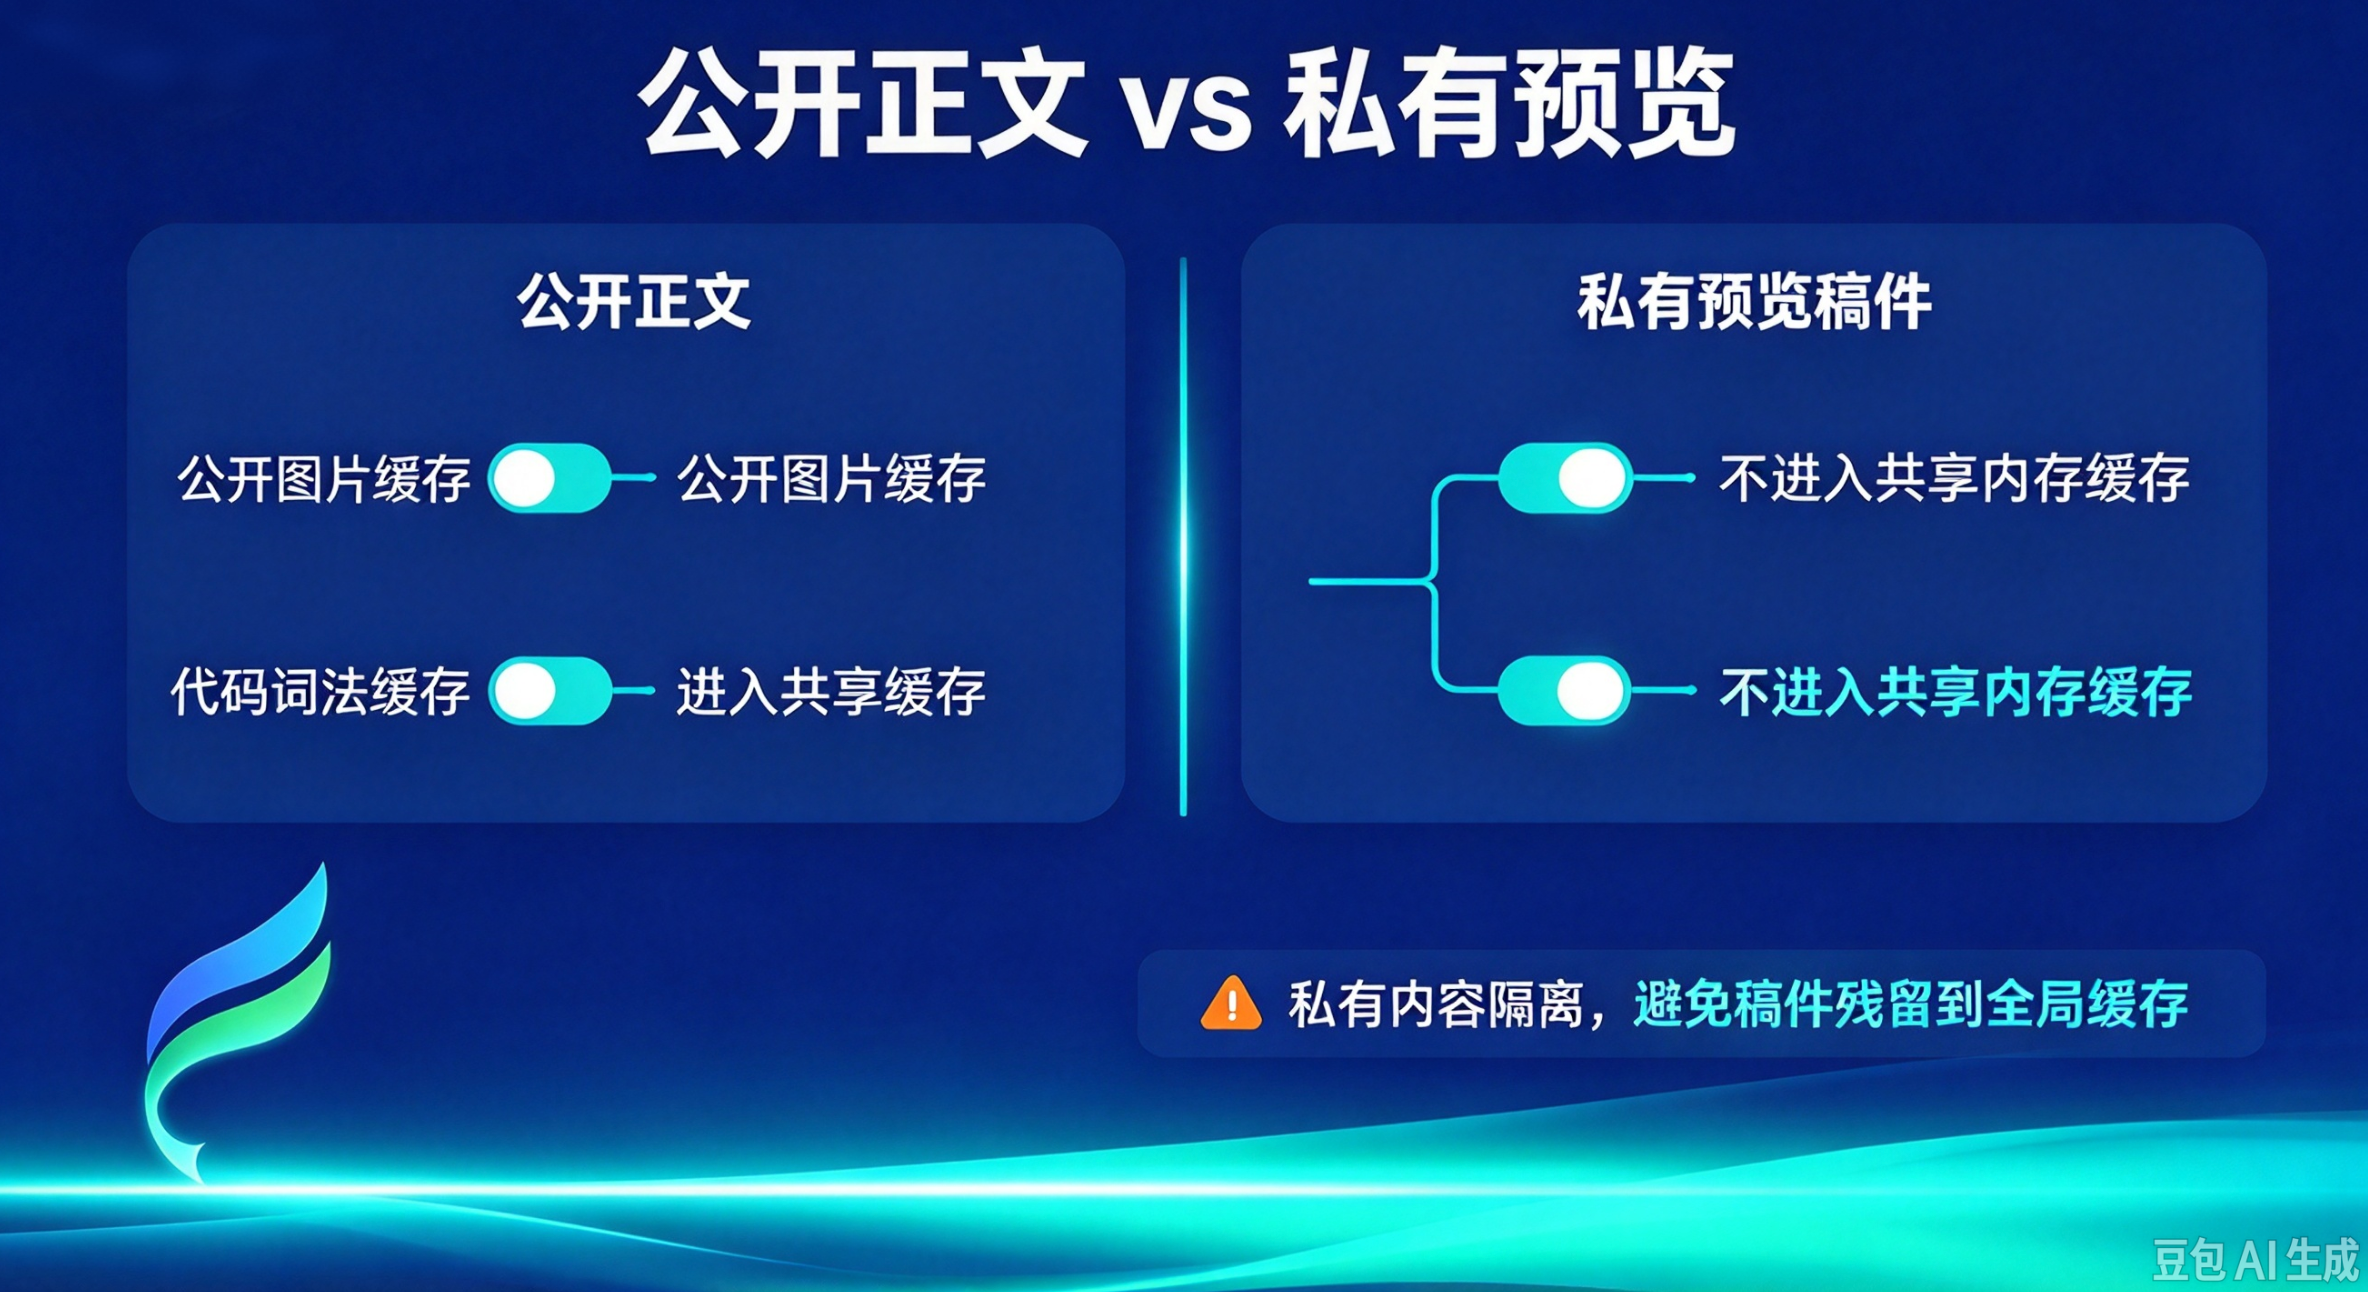
public 决定进不进缓存。 私有预览(自己看自己的待审核稿件)传 public: false,代码内容完全不过缓存。因为如果进了共享缓存,一个用户读过的私有稿件内容可能留在全局内存里,被下一个用户的相同代码命中。
缓存的是词法节点,不是颜色。 hl.highlight.parse 产出的是"这个 token 是关键字、这个是字符串"这样的结构,不包含具体颜色。颜色在构建 Widget 时按当前主题算。
如果直接缓存带颜色的结果,切换深浅色主题时旧颜色会被复用------用户切到深色模式,代码块还是浅色的。这个 bug 我遇到过,表现很怪,因为刷新一下又好了。
双重容量限制。 既限制条目数,也限制总字符数:
dart
while (_nodes.length > CacheLimits.highlightEntries ||
    _characters > CacheLimits.highlightCharacters) {
只限制条目数不够------一个超长代码块可能是别的十个条目那么重,两个限制一起才能保证内存有界。
那行 remove 再 _nodes[key] = existing 是标准 LRU 实现:命中时把 key 移到队尾,这样最久没用的自然在队首,淘汰时删它。
至于原始 HTML------无条件不执行 。flutter_markdown 默认不解析 raw HTML,这是正确的默认值。因为一旦执行了 <script> 或 <iframe>,就等于在 App 里开了一个不受控的浏览器。
目录锚点:整个模块最难的地方
现在说那个我一开始完全没想到的问题。
用户点目录里的"接口设计",页面应该滚到正文对应的那一行。但客户端怎么知道"接口设计"这个标题在正文的哪一行?
我最初的方案很自然:客户端自己给标题生成锚点。Web 上就是这么干的------github-slugger 把标题文字转成小写连字符,比如"接口设计" → #接口设计。
写完发现点不动。
原因有两个,都很致命:
第一,客户端不知道服务端用什么算法。 M1 定的契约里 TocItem 是这么定义的:
text
TocItem = { level, text, anchor }anchor 是服务端生成 的,用什么规则、是否唯一、遇到重名标题怎么处理------契约没有写,也没打算写。
第二,客户端数出来的标题顺序可能和服务端不一样。 这个问题更隐蔽,也更容易漏。
比如正文里有一段代码:
text
```bash
# 这是注释,不是标题
echo hello
```
代码块里那个 # 开头的行,是注释,不是标题。但如果客户端的解析逻辑不小心把它当成标题,那目录就会多出一项、和后续标题全部错位一位。
还有 Setext 风格标题:
text
接口设计
=========
它用的是下划线而不是 #。有的解析器支持,有的不支持------只要客户端和服务端的支持范围不一致,目录就全错。
所以现在的方案是:客户端不再自己猜,直接用服务端给的 anchor。
dart
/// 仅 ATX 标题消耗服务端目录项;代码围栏和 Setext 标题不冒充目录锚点。
class ServerHeadingSyntax extends md.HeaderSyntax {
  ServerHeadingSyntax(this.toc);
  final List<ApiTocItem> toc;
  int cursor = 0;
  Object? document;

  @override
  md.Node parse(md.BlockParser parser) {
    if (!identical(document, parser.document)) {
      cursor = 0;                      // 换了文档,游标归零
      document = parser.document;
    }
    final raw = parser.current.content;
    final node = super.parse(parser) as md.Element;
    final match = RegExp(r'^(#{1,6})\s+(.+?)\s*#*\s*$').firstMatch(raw);
    if (match != null && cursor < toc.length) {
      final item = toc[cursor];
      if (item.level == match[1]!.length && item.text == match[2]!.trim()) {
        node.attributes['reader-anchor'] = item.anchor!;
        cursor++;
      }
    }
    return node;
  }
}这段代码的核心是一个游标对齐 算法。逐条解析标题时,拿当前的标题和 toc[cursor] 比:
| 检查 | 不一致时 |
|---|---|
level 相等吗 |
不消耗目录项,游标不动 |
text 相等吗 |
同上 |
| 都相等 | 打上 reader-anchor,cursor++ |
为什么要这么保守? 因为一旦错位,后面全部错位。所以只在层级和文字都完全一致时才认。
注意 cursor++ 只在匹配成功时执行------这意味着如果客户端多解析出一个标题(理论上不该发生),游标会一直卡在那一项,后面全对不上。这是"宁可全错也不局部错"的取舍,因为局部对局部错的体验更糟(用户点前三个能跳,点第四个跳到别处)。
而 if (!identical(document, parser.document)) 这个判断是必需的:解析器可能被复用(比如列表切换时复用了同一个对象),而游标是实例字段。不重置的话,第二篇文章的锚点会接着第一篇的游标走,全错。
顺带说 item.anchor! 这个非空断言。它是安全的------anchor 由服务端保证存在,而生成模型把它定义成了可空(M4-03 讲过为什么所有字段都可空)。所以这里的 ! 是在已知边界条件下收窄类型 ,和 M4-03 里 Article.id! 是同一个模式。
标题渲染:key 绑在服务端 anchor 上
拿到 anchor 之后,标题组件要挂一个 GlobalKey,供目录点击时定位:
dart
class _HeadingBuilder extends MarkdownElementBuilder {
  final Map<String, GlobalKey> keys;

  @override
  Widget? visitElementAfterWithContext(...) {
    final anchor = element.attributes['reader-anchor'];
    final h2 = element.tag == 'h2';
    return Container(
      key: anchor == null ? null : keys[anchor],
      margin: EdgeInsets.only(
        top: h2 ? AppSpacing.s8 : AppSpacing.s6,
        bottom: AppSpacing.s3,
      ),
      padding: EdgeInsets.only(left: h2 ? 10 : 0),
      decoration: h2
          ? BoxDecoration(
              border: Border(
                left: BorderSide(color: context.colors.brand, width: 3),
              ),
            )
          : null,
      child: Text(element.textContent, style: preferredStyle),
    );
  }
}
注意 key: anchor == null ? null : keys[anchor]------只有成功匹配到服务端 anchor 的标题才挂 key。没匹配上的标题(如果真的出现了)就是普通文本,点目录时不会尝试定位它。
宁可让某个标题点不动,也不要跳到错误的位置。 一个跳错的目录比一个失效的目录糟糕得多------跳错了用户会以为是内容错了。
h2 的特殊处理(左边框 + 更大间距)纯粹是视觉决策:用左边框把二级标题和三级标题区分开,长文章里层级关系一眼可见。
大字号:缓存必须跟着失效
这是另一个我一开始漏掉的坑,而且很难发现。
ReaderMarkdown 是个 StatefulWidget,内部缓存了构建好的 body:
dart
class _ReaderMarkdownState extends State<ReaderMarkdown> {
  Widget? body;

  @override
  void didChangeDependencies() {
    super.didChangeDependencies();
    Theme.of(context);
    MediaQuery.textScalerOf(context);
    body = null;              // ← 依赖变了,缓存作废
  }

  @override
  void didUpdateWidget(covariant ReaderMarkdown old) {
    super.didUpdateWidget(old);
    if (old.content != widget.content ||
        !identical(old.headingKeys, widget.headingKeys) ||
        old.publicImages != widget.publicImages) {
      body = null;
    }
}为什么必须这样?因为Flutter 的 Widget 是不可变的,一旦构建完成就固定了。 字号变大之后,旧 body 里的 Text 还是旧字号------用户调了字体大小,但文章看起来没变。
didChangeDependencies 那一行 Theme.of(context); 和 MediaQuery.textScalerOf(context); 看起来是"取了值但没用",实际上它们的作用是建立依赖 。读一次,InheritedWidget 变化时这个 build 上下文就会重新执行,于是 body = null 触发重建。
而 didUpdateWidget 里的 !identical(old.headingKeys, widget.headingKeys) 用的是恒等比较而不是内容比较。因为 heading keys 是个 Map,内容相同但实例不同时也要重建------key 变了意味着 GlobalKey 的绑定变了,不重建会串位。恒等比较比深度比较快得多,而且这里语义上要的正是"是不是同一个对象"。
这也解释了 M4-10 里 AsyncPane 那个 loadKey 为什么存在------同一个道理:Widget 复用但输入变了,必须能识别。
私有预览要关掉的东西
最后回到安全。ReaderMarkdown 有个 publicImages 参数:
dart
/// 正文渲染依赖内容、目录定位键与主题,私有预览禁用公开图片和词法缓存。
class ReaderMarkdown extends StatefulWidget {
  const ReaderMarkdown(
    this.content, {
    this.toc = const [],
    this.headingKeys = const {},
    this.publicImages = true,
  });
两个开关一起关:
| 开关 | 私有预览时的值 | 为什么 |
|---|---|---|
publicImages |
false | 待审核稿件的图片不能进公开图片缓存 |
代码块 public |
false | 稿件内容不进共享词法缓存 |
两个都是"缓存隔离",而缓存隔离比权限校验更容易被忽略------因为权限校验是显式的代码,而缓存是隐式的副作用。写代码时很容易想"这个请求带了 token,所以是安全的",忘了它的结果还会留在本地。
验收该看什么
阅读器的测试有个特殊之处:大部分视觉问题在单测里看不出来。
| 场景 | 怎么验 |
|---|---|
| 代码块在窄屏能横向滚动 | Widget 测试里设一个 320 宽的约束 |
| 表格不撑破布局 | 同上,且要构造一个 5 列宽表 |
| 目录跳转位置正确 | 集成测试,真渲染后检查滚动位置 |
围栏里的 # 不进目录 |
构造含代码块的正文,断言 toc 匹配数 |
| 深色模式代码可读 | 必须真机看截图,对比度算不出来 |
| 大字号布局不崩 | 集成测试里把 textScaler 设成 2.0 |
最后两条要单独说:
深色模式的代码配色没法用断言验。 你没法在测试里写"这个颜色对比度要大于 4.5",因为主题是高亮库生成的,token 到颜色的映射由第三方库决定。只能看。 这是我在这个项目里最不愿意承认但必须承认的事------有一类问题只能靠人眼。
大字号是最容易崩的场景。 因为绝大多数设计是在默认字号下做的。字号放大到 2.0 后,标题可能换行、代码块高度暴涨、目录项被挤到两行------全都在正常字号下看不见。
一条我一开始想省掉的事
ServerHeadingSyntax 里那个游标对齐算法,我第一版写的是"客户端自己 slug 化标题",简单得多。切换到服务端 anchor 之后多出来二十行,我当时觉得这个复杂度不值得。
然后我遇到一个具体场景:用户写了两篇标题相同的文章,各自内部还有一个同名的小节。
比如文章里出现两次"总结":
text
## 总结
...
## 实现
...
## 总结        ← 客户端 slug 化会生成同一个 anchor
...
客户端 slug 化会得到两个完全相同的 #总结,点目录跳到哪个全靠运气。服务端给的 anchor 则保证唯一(它知道这是第几个)。
这就是那个多出来的二十行在解决什么:把"唯一性"的责任交给唯一能保证它的一方。
类似的还有 item.text == match[2]!.trim() 这个严格比较。我一度想放宽成"包含关系"------万一服务端对标题文字做了某种处理(比如把 **加粗** 里的标记去掉),客户端解析出来的文字就对不上了。
放宽的代价是:文本相似但不同的两个标题会被误认,于是游标错位,后续全部锚点混乱。
而严格比较的代价只是"这个标题没有 anchor,点不了"。一个失效的目录项 vs 整个目录错位,代价差着好几个数量级。
小结
Markdown 阅读器这个模块,技术上不难,但它把三个别的模块没碰过的约束集中到了一起:
- 不可信输入 ------ 原始 HTML 不执行,私有内容不进共享缓存。
- 渲染环境 ------ 窄屏要滚动、大字号要失效缓存、主题要重算颜色。
- 跨端契约 ------ 锚点由服务端定义,客户端只做严格对齐。
第二点里最反直觉的是大字号会让缓存失效 。直觉上"字号是显示层的属性,和内容无关",但因为 Widget 不可变,一旦构建完成字号就固化在组件里了。这意味着"内容没变"不等于"渲染结果可以复用"。
第三点的教训则是:当客户端需要某个"唯一标识"时,先问它是不是自己能生成的。 如果不能(比如算法未公开),就让它来自契约的作者,不要自己实现一个近似版本。近似版本在简单情况下能工作,在边界情况下会静默出错------而静默出错的目录跳转,用户是查不出原因的。
下一篇讲服务端目录的具体使用------上下篇、锚点、阅读量和阅读历史,它们共享同一份缓存策略但行为各不相同。
延伸阅读
如果这篇文章对你有帮助,欢迎订阅我的 CSDN 专栏 「成为全栈」:
🔗 专栏地址:https://blog.csdn.net/fungleo/category_13204651.html
📦 本系列配套代码仓库:https://github.com/fengcms/become-a-full-stack-developer