二、2024.5 --- DeepSeek-V2:MoE + MLA 的双重革命
DeepSeek于2024年5月7日发布DeepSeek-V2 ,这是DeepSeek首个大规模Mixture-of-Experts(MoE,混合专家) 语言模型。模型总参数236B ,每token激活21B ,支持128K 上下文长度。V2沿用了V1验证过的Pre-Norm Decoder-only Transformer骨架,但在两个核心模块上做了彻底替换:Attention模块被替换为MLA,FFN模块被替换为DeepSeekMoE
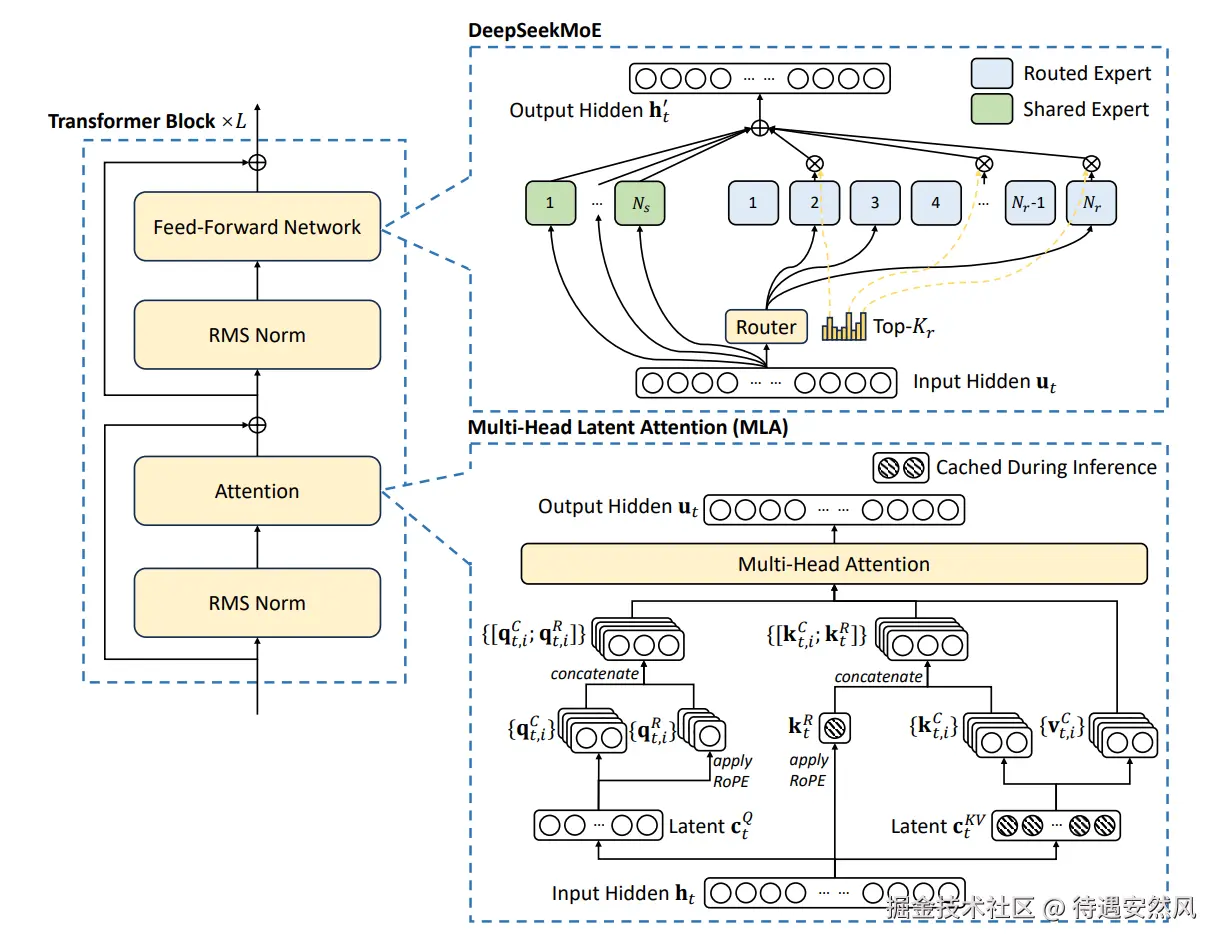
在 DeepSeek-V2 中,L=60,即主模型为 60 层 Decoder
核心效率指标(V2 vs V1-67B Dense):
| 指标 | 变化 |
|---|---|
| 训练成本 | 节省 42.5% |
| KV Cache | 减少 93.3% |
| 最大生成吞吐量 | 提升 5.76倍 |
预训练语料规模为8.1T token,后经SFT和RL对齐。MLA的低秩KV联合压缩是KV Cache大幅下降的直接原因,而DeepSeekMoE的稀疏计算则是训练成本节省的主要来源。
(一)RMS Norm(均方根归一化)
核心公式:
RMS(x)=d1i=1∑dxi2
RMSNorm(x)=RMS(x)x⋅γ
注: d 是特征维度; γ 是可学习缩放参数。
| 对比项 | 标准差 σ | RMS(均方根) |
|---|---|---|
| 公式 | σ=d1∑(xi−μ)2 | RMS(x)=d1∑xi2 |
| 计算步骤 | 先减去均值 μ,再平方、求平均,最后开根号 | 不减去均值,直接对原始值平方、求平均,再开根号 |
| 是否需先中心化 | 是 | 否 |
| 含义 | 数据偏离均值的程度 | 向量自身的幅值大小 |
| 两者关系 | 当且仅当均值 μ=0 时,RMS 数值等于标准差 | --- |
作用: 对比 LayerNorm:LayerNorm 需要同时减去均值、除以标准差; RMSNorm 直接省去均值中心化这一步,只做幅值缩放。
一句话总结:RMSNorm 是 LayerNorm 的轻量化简化版本,归一化向量长度,提升训练速度,效果接近 LayerNorm。
(二)DeepSeekMoE(Mixture of Experts)DeepSeek混合专家模型
在 DeepSeek‑V2 模型中,研究人员对传统 MoE 架构进行改进,提出DeepSeekMoE模块;该模块替代原 Decoder Block 内的稠密前馈网络(FFN),完成对隐藏特征的非线性变换。
1.传统 MoE 的公式(基础版)
假设有 N个专家,每个专家是一个 FFN,记作 E_i(x)。 对于输入 token x,路由器计算它和每个专家的得分,选出Top-K个,然后加权求和:
MoE(x)=i∈T∑gi⋅Ei(x)
其中:
T=TopK(Softmax(Wrx),K)
T:选出的 K个专家索引集合。
gi:Top‑K 内部重新归一化后的门控权重:
gi=∑j∈Texp((Wrx)j)exp((Wrx)i)
Ei(x):第 i 个专家的输出。
TopK:挑出得分最高的 K 个专家的索引
exp(x):exp(x)=ex
完整流程
- 第一层:路由计算(Router / Gate)------ MoE 特有的分诊台
输入 token X(维度为 d),不是直接进入 FFN,而是先经过一个路由网络 Wr:
计算路由得分: logits=X×Wr ( Wr 的维度通常是 d→N, N 是专家总数,比如 64 个)
选出 TopK 专家:对 logits 做 Softmax,然后使用 TopK 选出得分最高的 K 个专家,以K=2为例,得到集合 T。
计算门控权重:在选出的 K 个专家内部进行重新归一化,得到每个被选中专家的权重 gi。
- 第二层:专家计算(Expert Processing)------ 并行执行稠密 FFN
假设选中的 K 个专家索引是 {3,7},那么输入 token X 会同时送入专家 3 和专家 7。 这两个专家各自独立执行 FFN 流程:
上投影:专家 3 有 Wgate3,Wup3;专家 7 有 Wgate7,Wup7。
激活: G3=SiLU(X×Wgate3) G7=SiLU(X×Wgate7)
哈达玛积: H3=G3⊙(X×Wup3) H7=G7⊙(X×Wup7)
下投影: Y3=H3×Wdown3 Y7=H7×Wdown7
- 第三层:加权合并(Weighted Sum)------ MoE 特有的汇总
将两个专家的输出,按照路由算出的权重 gi 进行加权求和,得到最终的 FFN 输出: Y=g3×Y3+g7×Y7
核心特点: 所有专家都是路由专家,都要通过路由器打分和选择。不存在必然会被用到的专家。
2.DeepSeekMoE 的完整公式:
htl=i=1∑KsFFNi(utl)+i=Ks+1∑mNgi,tFFNi(utl)+utl
其中路由权重:
gi,t={si,t,0,si,t∈Topk({sj,t∣Ks+1≤j≤mN},mK−Ks)otherwise
si,t=Softmaxi((utl)⊤eil)
公式项含义说明:
i=1∑KsFFNi(utl):共享专家,始终全部激活,无门控,输出直接相加i=Ks+1∑mNgi,t⋅FFNi(utl):路由专家,从mN−Ks个路由专家中选出mK−Ks个做加权求和utl:残差连接项,MoE模块输入直接回加
革新①:细粒度专家分割
针对知识混杂
做法:在保持激活参数量和计算量不变 的前提下,把每个大专家切成更小的专家 ,同时等比例增加激活数量。
具体来说:
专家中间维度:稠密dff→MoE dff/m总专家数:稠密N→MoE N×m理论总激活专家数:稠密K→mK
其中 Ks 个为无条件激活的共享专家,实际路由专家激活数量 = mK−Ks。
论文举了一个直观的例子: 传统 MoE 有 16 个专家,Top-2 路由,可能的专家组合数是 (216)=120。(16里面选两个) 如果把每个专家切成 4 个小专家( m=4),变成 64 个专家,Top-8 路由,组合数暴涨到 (864)≈44.26 亿。
革新②:共享专家隔离
针对知识冗余。
做法:划出一部分专家作为共享专家(Shared Experts) ,它们始终被激活,不经过路由。所有 token 都必须经过这些共享专家。
共享专家专门负责捕获跨上下文的通用知识 。这样,路由专家就不再需要重复学习这些通用知识,可以真正专注于各自的专业领域,参数冗余大幅减少。
为了保持总计算量不变,共享专家的数量 Ks 会从路由专家的激活数中扣除
3.DeepSeekMoE与传统MoE的联系
DeepSeekMoE 并没有推翻传统 MoE,而是对其进行了两项"加法改造"。
联系①:路由专家的计算逻辑完全继承传统 MoE
对比二者公式: 传统 MoE:
i∈TopK∑gi⋅Ei(x)
DeepSeekMoE 的路由专家部分:
i=Ks+1∑mNgi,t⋅FFNi(utl)
可以看到,DeepSeekMoE 的第二部分本质就是传统 MoE 的计算逻辑,仅存在如下几点改动:
- 专家总数量变为 mN,由对专家做细粒度分割得到;
- 路由的候选范围限定在 Ks+1 至 mN,将共享专家排除在外;
- 实际激活的路由专家数量变为 mK−Ks,共享专家占用了 Ks 个激活名额。
联系②:共享专家是针对传统 MoE 的补丁式改进
传统 MoE 全部专家均为路由专家,由此带来知识冗余问题:各类 token 均需要的通用语法、基础语义知识,被分散存储在大量不同路由专家之中。
DeepSeekMoE 新增公式第一项:
i=1∑KsFFNi(utl)
该部分不经过路由器筛选,所有 token 都会无条件经过共享专家进行计算。相当于把模型需要的通用知识从路由专家里剥离出来,交由共享专家统一承载。
联系③: m 与 Ks 是传统 MoE 不存在的新增超参数
- m:细粒度分割倍数。传统 MoE 专家总数为 N,单步激活专家数量为 K;DeepSeekMoE 将原有每个专家切分为 m 份,专家总数扩充至 mN,理论总激活数变为 mK。
- Ks:共享专家数量。传统 MoE 该值等价为 0;在 DeepSeekMoE 中一般设置为 1 或者 2。
4.稠密 FFN&普通 MoE&DeepSeek MoE 对比表
| 对比维度 | 稠密 FFN (如 LLaMA-7B) | 普通 MoE (如 Mixtral 8x7B) | DeepSeek MoE (如 DeepSeek-V2) |
|---|---|---|---|
| 输入向量维度 d | 4096 | 4096 | 5120 |
| 单个权重矩阵维度 | 4096×11008 | 4096×14336 | 5120×1536 |
| 单个专家内部变化 | 4096→11008→4096 | 4096→14336→4096 | 5120→1536→5120(每个微专家) |
| 专家数量 | 1 个(全量) | 8 个 | 160 路由专家 + 2 共享专家 |
| 路由策略 | 无 | Top-2(选2个) | 2个共享专家无条件强制激活(不参与路由打分);路由器在160个路由专家内部Top-6选出路由专家 |
| 单层总参数量 | 约 1.35 亿 | 约 14 亿 | MoE层含2共享+160路由专家(无官方公开单层总参数字) |
| 单 Token 激活参数量(模型整体) | 约 6.7B(100%激活) | 约 12.9B(激活2个专家) | 约 21B |
| 单 Token 计算量 (FLOPs,模型整体) | 极大(6.7B参数全算) | 中等(12.9B参数参与计算) | 由整体21B激活参数量决定 |
| 核心思想 | 一个大胖子干活 | 8个专家,每次挑2个干活 | 160个微专家,每次挑6个,外加2个通用助手 |
(三)MLA(Multi-head Latent Attention)多头潜在注意力
DeepSeek-V1 的注意力机制是 GQA(分组查询注意力) ,而 DeepSeek-V2 则彻底替换为 MLA(多头潜在注意力)
整体公式:
MLA有两个创新点,1.低秩 KV 联合压缩,2.解耦RoPE
1.低秩 KV 联合压缩
MLA 是 DeepSeek-V2 的核心架构,旨在同时解决传统 MHA 的"显存爆炸"和 GQA 的"表达能力下降"问题。
核心公式
-
降维压缩: cKV=X⋅WDKV
-
升维解压: K=cKV⋅WUK V=cKV⋅WUV
X 为输入特征 ; WDKV 为降维矩阵 ; WUK,WUV 为升维矩阵; cKV 为压缩后的潜在向量
作用: 缓存对象改变:推理时,不再缓存庞大的 K 和 V,只需缓存极小的潜在向量 cKV。
单个 token 的 cKV∈R512,为共享隐向量,不包含注意力头维度。
但由此产生一个问题,我们现在想要的是
score=(Rm⋅Q)⋅Rn⋅(cKV⋅WUK)T
但不解耦RoPE的情况下,实际上走过程算出来的结果是:
score=(Rm⋅Q)⋅(Rn⋅cKV)⋅WUKT
位置信息Rn被打散了,所以要进行位置信息的调整,也就是对RoPE进行解耦
2.解耦RoPE
大模型的实验证明:只要有一小部分高精度旋转维度提供相对位置,剩下的语义维度不加位置,模型依然能学得很好
理想原公式(全维度旋转):
Scoreideal=(Rm⋅Qc,Qr)⋅(Rn⋅Kc,Kr)T
现根据线性代数展开:
内容部分也被旋转了 (RmQc)⋅(RnKc)T+位置部分被旋转 (RmQr)⋅(RnKr)T
两个部分都存在相同的位置信息,所以去掉第一部分的位置信息Rm、Rn,最后得分公式变为(局部维度旋转,MLA):
Scoredecoupled=内容部分不做RoPE旋转 Qc⋅KcT+位置部分单独做RoPE旋转 (RmQr)⋅(RnKr)T
核心公式
- 拆分 Q 和 K把"内容"和"位置"强行分开 : Q=Qcontent, Qrope K=Kcontent, Krope
- 注意力分数计算(两部分相加): Score=Qcontent⋅Kcontent⊤+Qrope⋅Krope⊤
注: content 部分参与低秩压缩,不施加 RoPE; rope 部分不参与压缩,专门施加 RoPE 旋转位置编码。
Qcontent=X⋅WQ_content
Qrope=X⋅WQ_rope
📌 传统RoPE 与 MLA解耦RoPE 的Q生成对比示例(以总维度128维举例)
传统做法(先合后算) Q=X⋅WQ
注:直接输出完整128维Q向量,全部维度统一施加RoPE旋转。
MLA做法(源头分家,两路独立生成) Qcontent=X⋅WQ_content Qrope=X⋅WQ_rope 注:分开两路投影:
- Qcontent:64维,语义分支,不做RoPE,可以低秩压缩
- Qrope:64维,位置分支,单独施加RoPE,不压缩 拼接得到完整Q: Q=Qcontent, Qrope(64+64=128)