Top-K 与 Top-P:大模型采样参数详解
适用范围:所有自回归大语言模型(GPT / Llama / Qwen / DeepSeek / Claude 等)在 生成解码阶段的候选词过滤策略。
置信度:⭐⭐⭐⭐⭐(这是 Transformer 推理的标准组件,HuggingFace
transformers、OpenAI API、vLLM 等实现完全一致)。
1. 前置概念:token /logits/softmax
后面反复出现这三个词,先一次性讲清楚。
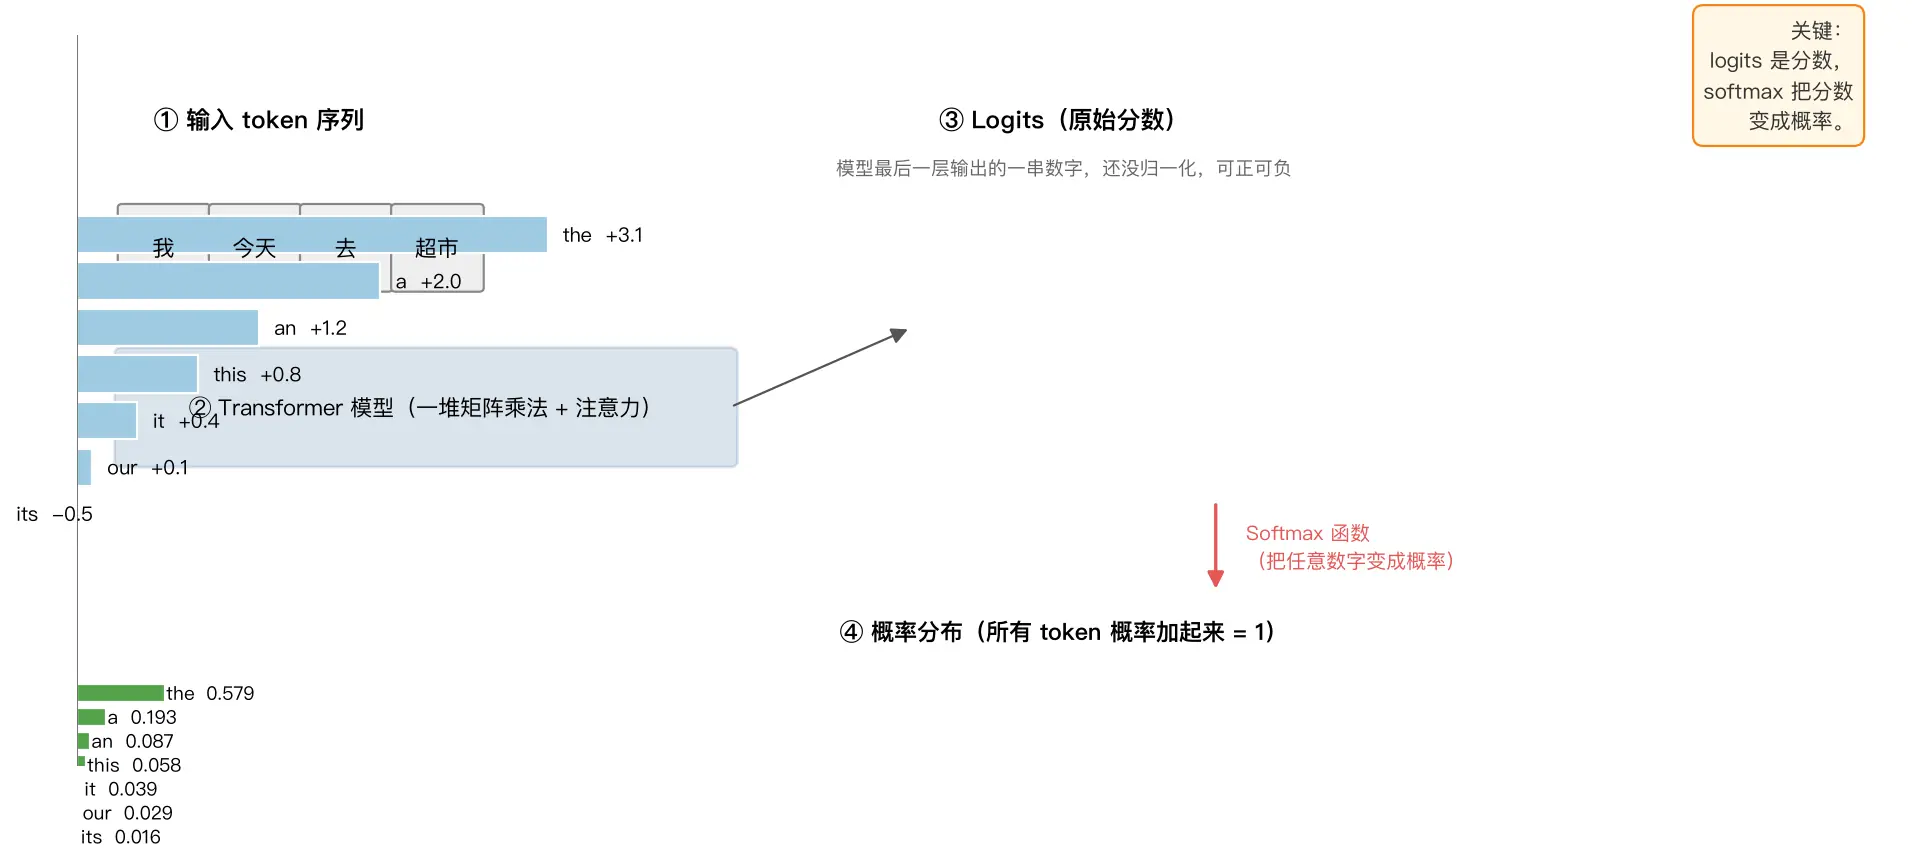
1.1 token(词元)
模型眼里没有 "字" 也没有 "词",只有 token------ 它把文本切成最小处理单元,可能是一个字、一个词、半个词,甚至一个标点。
-
英文里
"playing"可能被切成"play" + "ing"两个 token。 -
中文里
"我今天去超市"大致切成我 / 今天 / 去 / 超市4 个 token。 -
所有可能出现的 token 组成一个词表(vocabulary),大小通常 3 万~12 万。
1.2 logits(原始分数)
模型最后一层输出的是一个长度 = 词表大小的数字向量,每个数字对应一个 token 的 "得分"。
-
这些数字还没归一化,可正可负、可大可小(比如 +3.1、-0.5、+12.7)。
-
它们只是 "原始分数",不是概率------ 不能直接拿来采样。
-
学术上叫 logits(log-odds 的缩写),工程里直接叫 "logits" 或 "原始输出"。
1.3 softmax(归一化函数)
一个数学函数,作用是把任意大小的一组数字变成一组概率(每个数在 0~1 之间,加起来 = 1)。
公式:
softmax(zi)=∑jezjezi
-
它把 logits 里的 "相对大小" 放大:分高的 token 概率被推得更高,分低的被压得更低。
-
经过 softmax 之后,这组数字才是真正的 "概率分布",才能用来采样。
1.4 整条链路一句话
输入 token 序列
   ↓
Transformer 算一遍
   ↓
输出 logits(一串原始分数,可正可负)
   ↓
softmax 归一化
   ↓
得到概率分布(加起来 = 1)
   ↓
按 top_k / top_p / temperature 调整后采样一个 token
后面讲的所有参数,都是作用在 "概率分布" 这一步 ------ 所以必须先理解 logits → softmax 这一步。
1.5 两个常用描述词:分布尖锐 vs 平坦
后面反复出现这两个词,说的是概率分布的形状------也就是模型对下一步该选哪个词有多大把握。
分布尖锐(peaked / 集中) :一个或几个词概率特别高,其他词几乎是零。模型很确定。
分布平坦(flat / 扩散) :很多词概率都差不多,没有哪个特别突出。模型很犹豫。
| 语境 | 模型看到的分布 | 形状 |
|---|---|---|
| "天空是 ___" | blue=0.95,其他=0.05 总和 | 尖锐(几乎只选 blue) |
| "今天我想 ___" | go=0.12、eat=0.11、work=0.10、sleep=0.09、read=0.08... | 平坦(谁都有可能) |
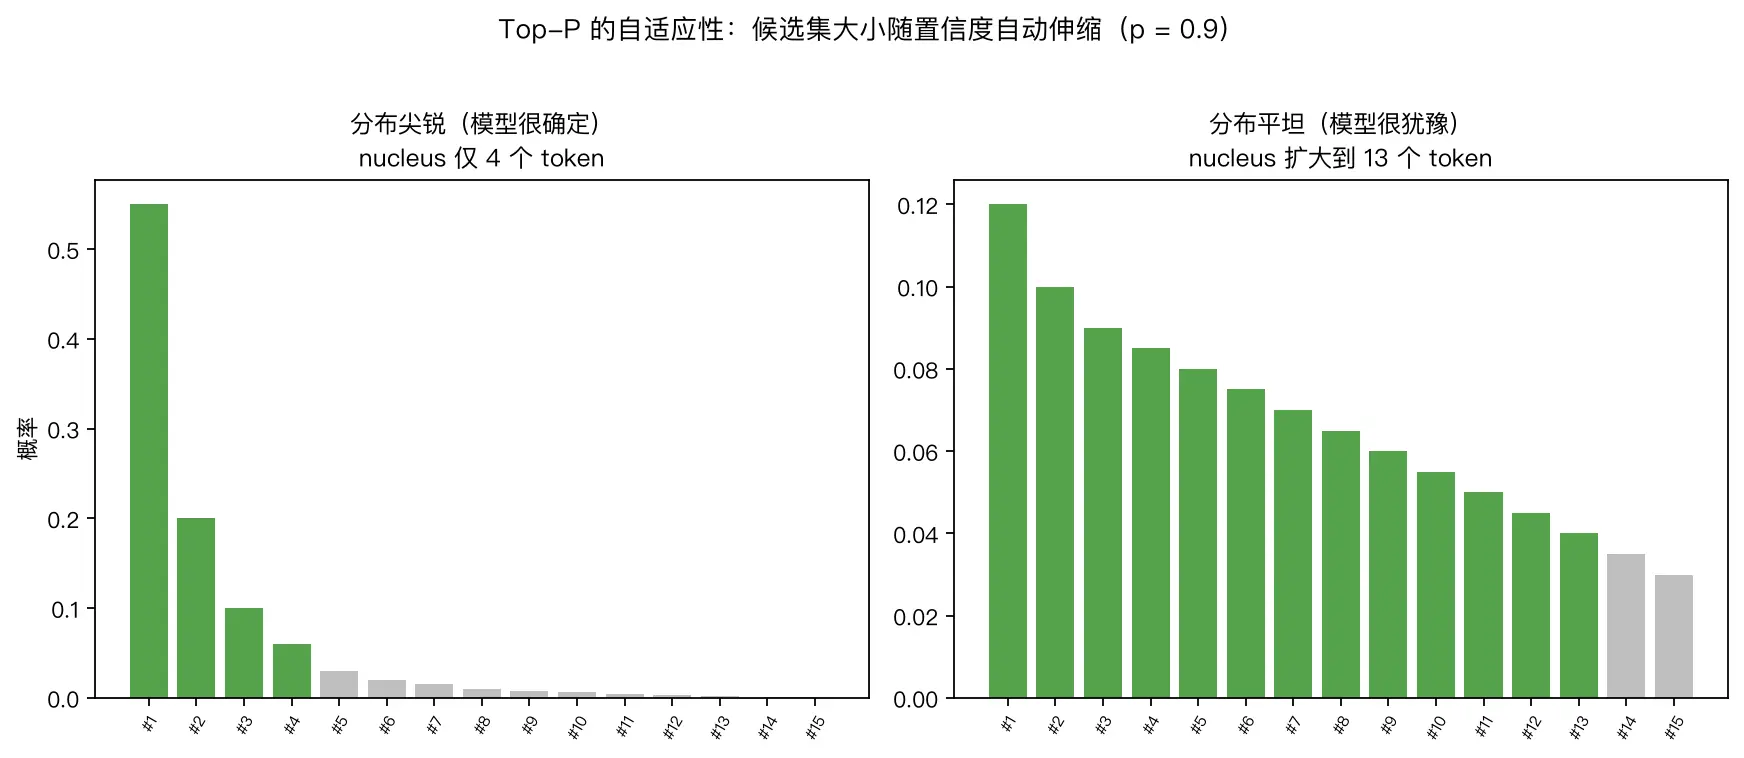
- 左图(尖锐):第一根柱子 0.55,第二根 0.20,后面越来越小------前 4 个词累计就到 90%,Top-P 核只有 4 个词。
- 右图(平坦):13 根柱子高度都差不多------要累到第 13 个词才到 90%,Top-P 核自动扩大到 13 个词。
为什么这个区分重要:
- Top-P 的自适应性就是利用这个:尖锐时自动收窄,平坦时自动放宽。
- Temperature 的效果就是主动改变形状:低温压尖→更确定,高温压平→更发散。
- RAG / Agent 用低温就是要让输出"尖锐"------别让模型在多个合理答案之间犹豫。
学术上这叫分布的熵(entropy):尖锐 = 低熵 = 确定;平坦 = 高熵 = 不确定。
2. 先搞清楚它们在解决什么问题
大模型每生成一个 token,都会先在整个词表(通常 3 万~12 万个 token)上算出一组概率分布 p(v∣context),再从中挑一个 token 输出。
问题:直接按原始概率采样 会偶尔抽到概率极低的长尾词(拼写错误、语义不通的词),导致输出 "翻车"。Top-K 和 Top-P 都是为了在采样前先把候选词表裁小,只从 "最靠谱的一小撮词" 里抽。
下图就是一个典型的、按概率降序排好的词表分布:
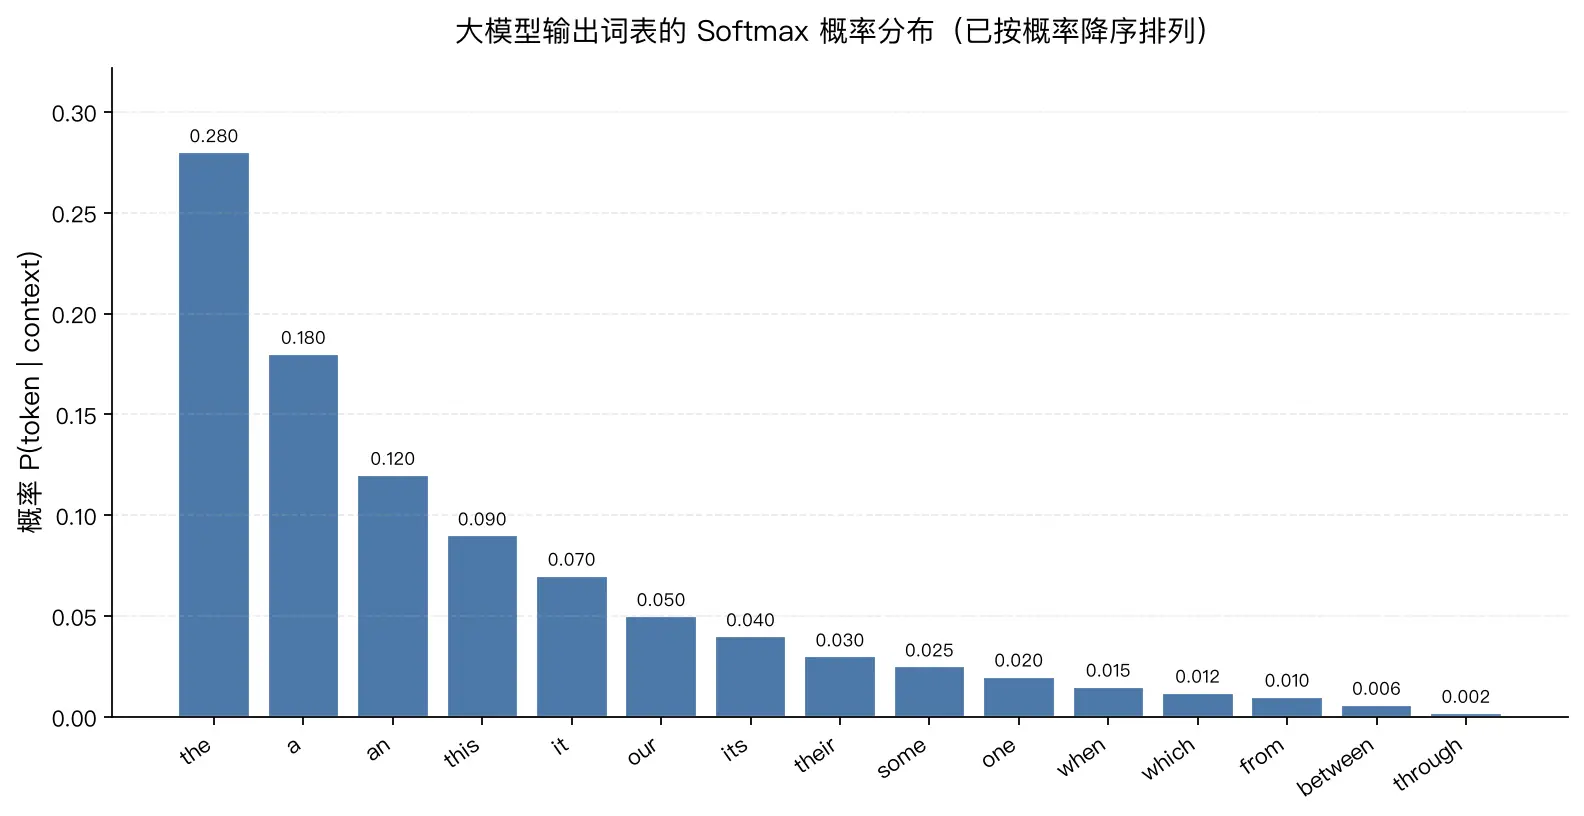
可以看到头部几个词吃掉了绝大部分概率质量,后面一长串词概率极小 ------Top-K / Top-P 要做的就是把这一长串 "长尾" 砍掉。
3. Top-K(K 采样 / 限定候选集)
2.1 定义
只保留概率最高的 K 个 token,其余全部概率置 0;再把这 K 个 token 的概率重新归一化,从中采样。
2.2 算法
markdown
输入:原始概率分布 p[1..V],参数 K
1. 将所有 token 按概率从大到小排序
2. 只保留前 K 个,其他 token 概率 = 0
3. 对这 K 个 token 的概率做 softmax 归一化(使它们加和 = 1)
4. 按归一化后的概率采样一个 token
2.3 图示
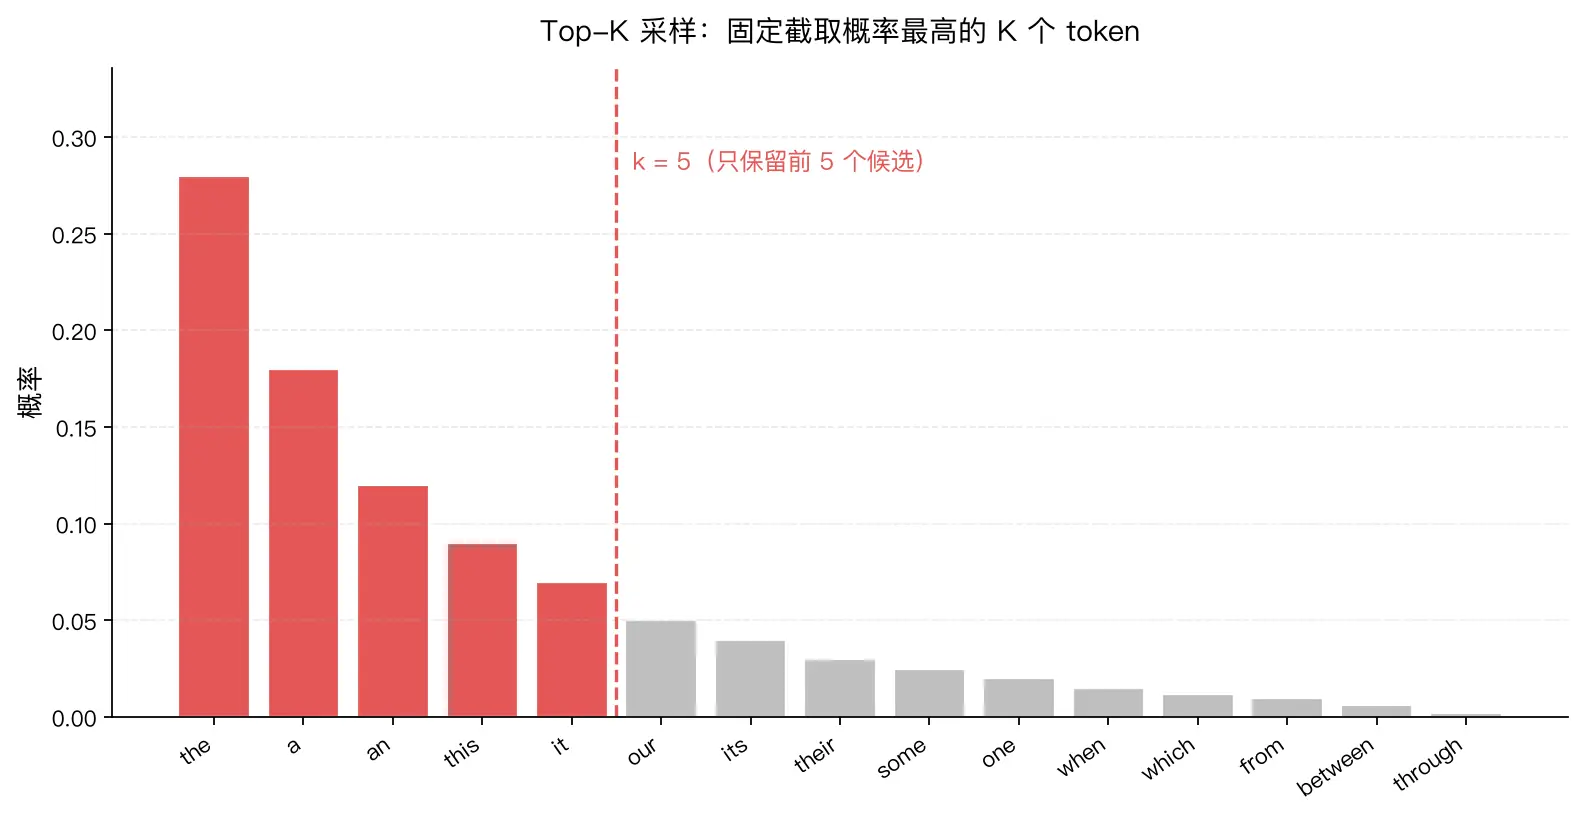
上图中 K=5:不管后面 10 个词概率多高多低,一律不让它们被选中;最终只能从红色这 5 个词里抽。
2.4 关键点
| 取值 | 行为 |
|---|---|
| K = 1 | 退化为 贪心解码(greedy),永远取概率最大的词,输出最确定、最枯燥 |
| K 很小(5~10) | 输出保守、重复、容易卡死 |
| K 常见值(40 ~ 100) | 通用区间,HuggingFace 默认常取 top_k = 50 |
| K ≥ 词表大小 | 退化为原始随机采样,完全不做截断 |
4. Top-P(核采样 / Nucleus Sampling)
3.1 定义
从概率最高的 token 开始累加,一旦累计概率首次达到阈值 P,就把这一组(动态数量的)token 作为候选集;其余 token 概率置 0,再归一化采样。
这一组动态集合叫 "核"(nucleus),所以叫核采样。
3.2 算法
markdown
输入:原始概率分布 p[1..V],参数 P(如 0.9)
1. 将所有 token 按概率从大到小排序
2. 从第 1 个开始累加概率,直到累计和 ≥ P
3. 记下此时用了前 k 个 token(k 是自适应的,每一步都不一样)
4. 只保留这 k 个 token,其他置 0
5. 归一化后从中采样
3.3 图示
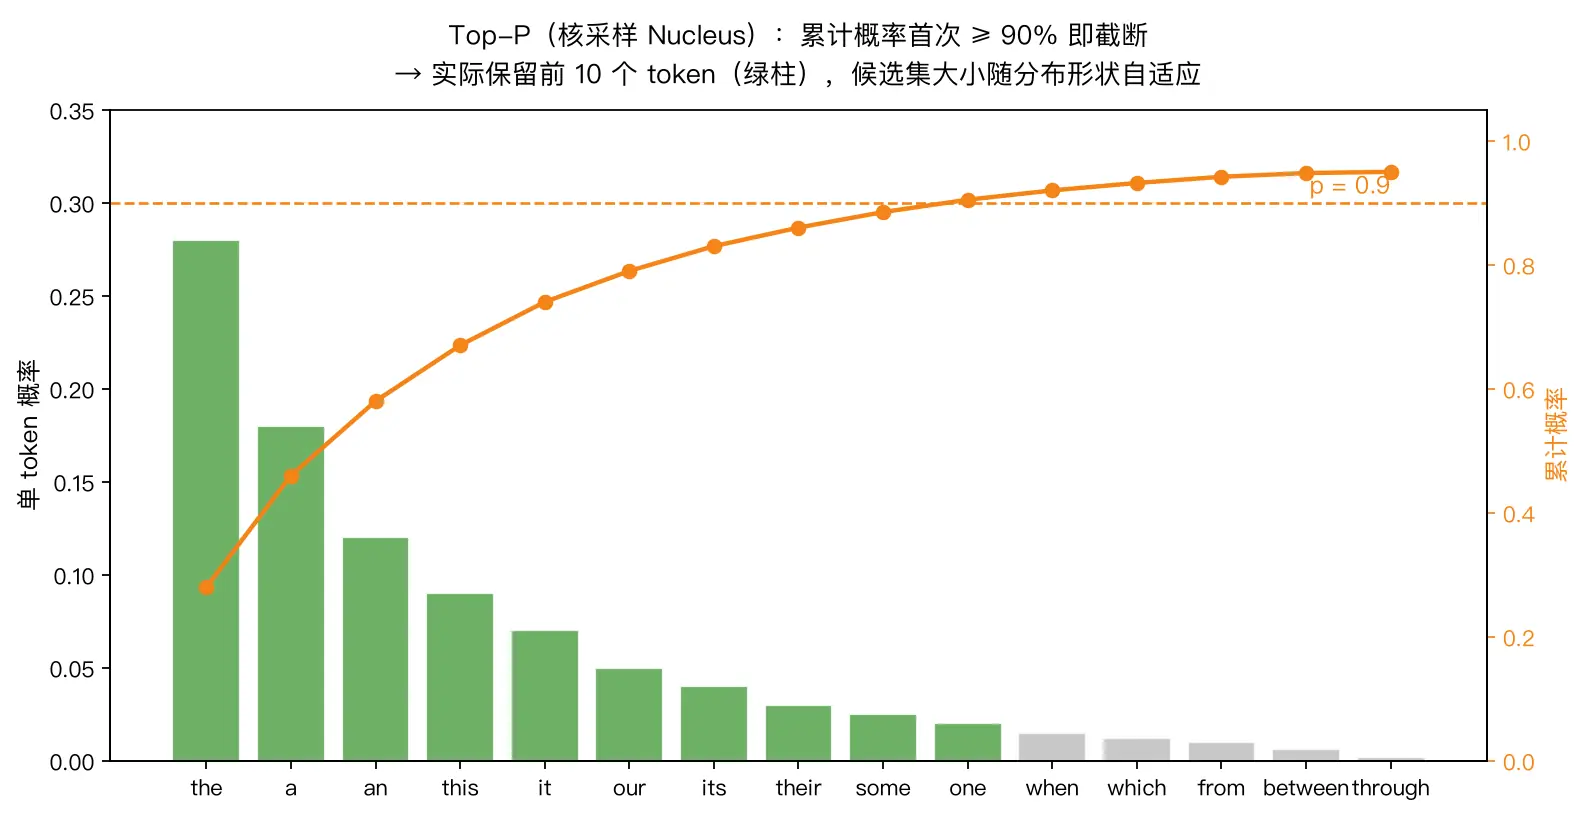
上图 P = 0.9:从左往右累加,累到第 10 个 token("one")时累计概率才第一次 ≥ 90%,所以绿色这 10 个 token 是候选集,灰色的 5 个被丢弃。
3.4 核心优势:候选集大小自适应
Top-K 是 "固定大小 ",Top-P 是"按概率质量动态伸缩"------ 这是两者最本质的区别:
-
模型很确定时(分布尖锐):前 4 个词累计就到 90% → 候选集只有 4 个,输出接近确定性,不会乱跳。
-
模型很犹豫时(分布平坦):要累到 13 个词才到 90% → 候选集自动扩大到 13 个,保留足够多样性,避免说车轱辘话。
这正是 Top-P 比 Top-K 更受青睐的原因:它根据当前语境的 "不确定性" 自动调节创造性。
5. Temperature(温度):缩放整个概率分布
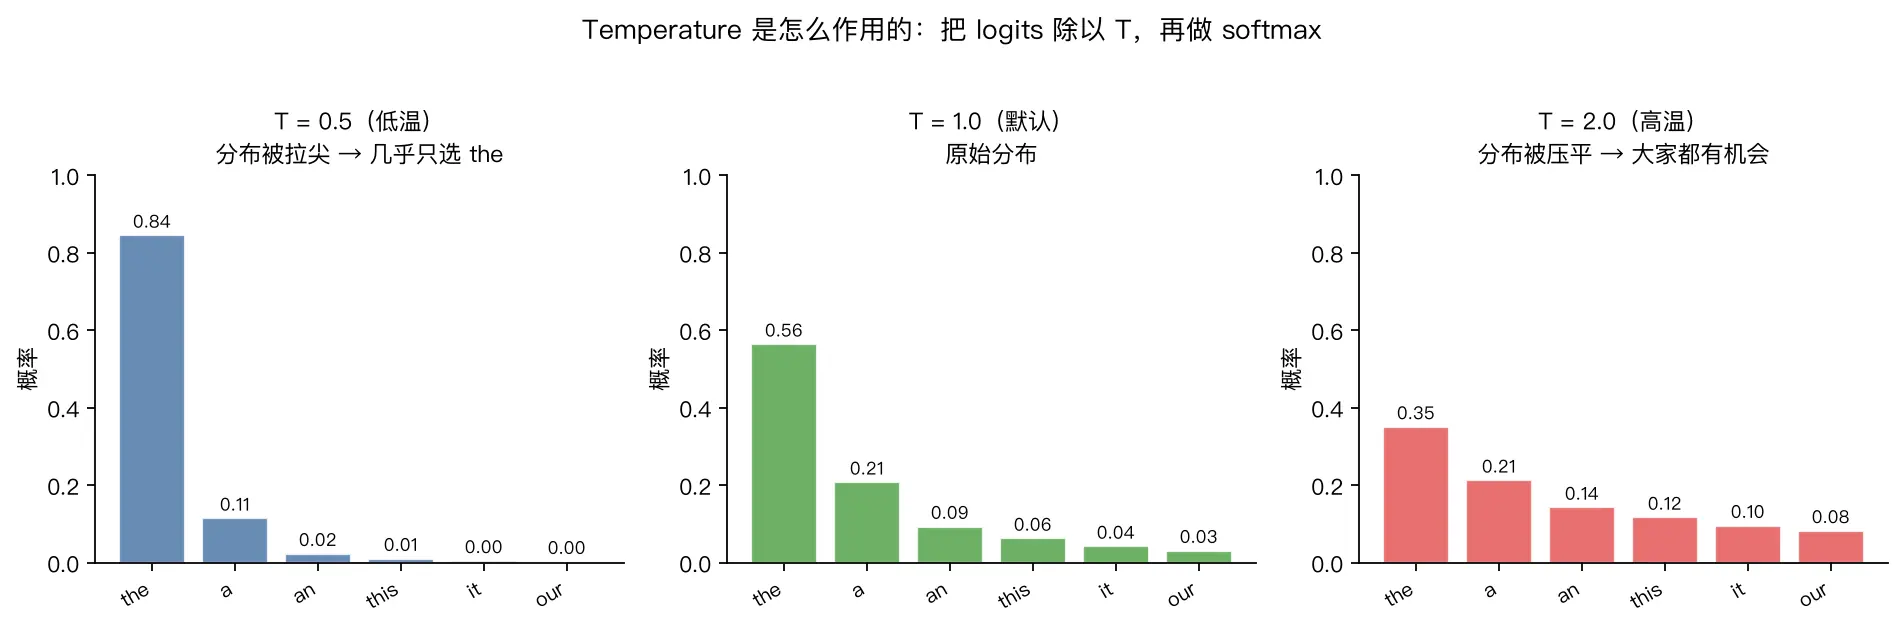
前面一直提到 temperature,这里单独讲清楚。它和 top_k /top_p 不是一回事:top_k /top_p 是 "砍候选集",temperature 是 "缩放概率分布的形状"。
4.1 它怎么作用
r
原始 logits z  →  除以 T  →  softmax  →  概率分布
logits/T-
T < 1:logits 被放大 → softmax 后分布更尖 → 高概率词更确定、低概率词被压死 → 输出保守。
-
T > 1:logits 被缩小 → softmax 后分布更平 → 大家概率都差不多 → 输出随机、发散。
-
T → 0:退化为贪心解码(永远取最大概率词)。
-
T → ∞:退化为均匀采样。
4.2 它和 top_p /top_k 的关系
它们作用顺序是:
r
logits → 除以 T → softmax → 按 top_k 砍 → 按 top_p 砍 → 采样-
temperature 是第一步,先把分布形状拉尖或压平。
-
top_k /top_p 是第二、三步,在缩放后的分布上再砍候选集。
-
所以 temperature=0 时,后两步设什么都不影响结果 ------ 直接退化为贪心。
4.3 直觉理解
| T 值 | 感觉像什么 |
|---|---|
| 0.0 | 照本宣科,背课文 |
| 0.3 | 认真回答,不跑偏 |
| 0.7 | 正常聊天,有一定发挥 |
| 1.0 | 比较放飞 |
| 1.2+ | 胡说八道,开始乱讲 |
6. Top-K vs Top-P 对比
| 维度 | Top-K | Top-P(Nucleus) |
|---|---|---|
| 截断依据 | 固定数量 K | 累计概率阈值 P |
| 候选集大小 | 恒定 | 随分布形状自适应 |
| 分布尖锐时 | 仍保留 K 个,可能引入噪声 | 自动缩小,更稳 |
| 分布平坦时 | 只有 K 个,多样性不足 | 自动扩大,更自然 |
| 典型取值 | K = 40 ~ 100 | P = 0.8 ~ 0.95 |
| 极端情况 | K=1 → greedy;K=V → 全采样 | P=0 → 永远取首词;P=1 → 全采样 |
| 提出时间 | 早期 transformer 标配 | Holtzman et al. 2019《The Curious Case of Neural Text Degeneration》 |
7. 为什么 "先按 Top-K 截一道,再按 Top-P 截一道"
这是 HuggingFace TopKTopPLogitsWarper、vLLM、TGI 等开源推理引擎的标准流水线:
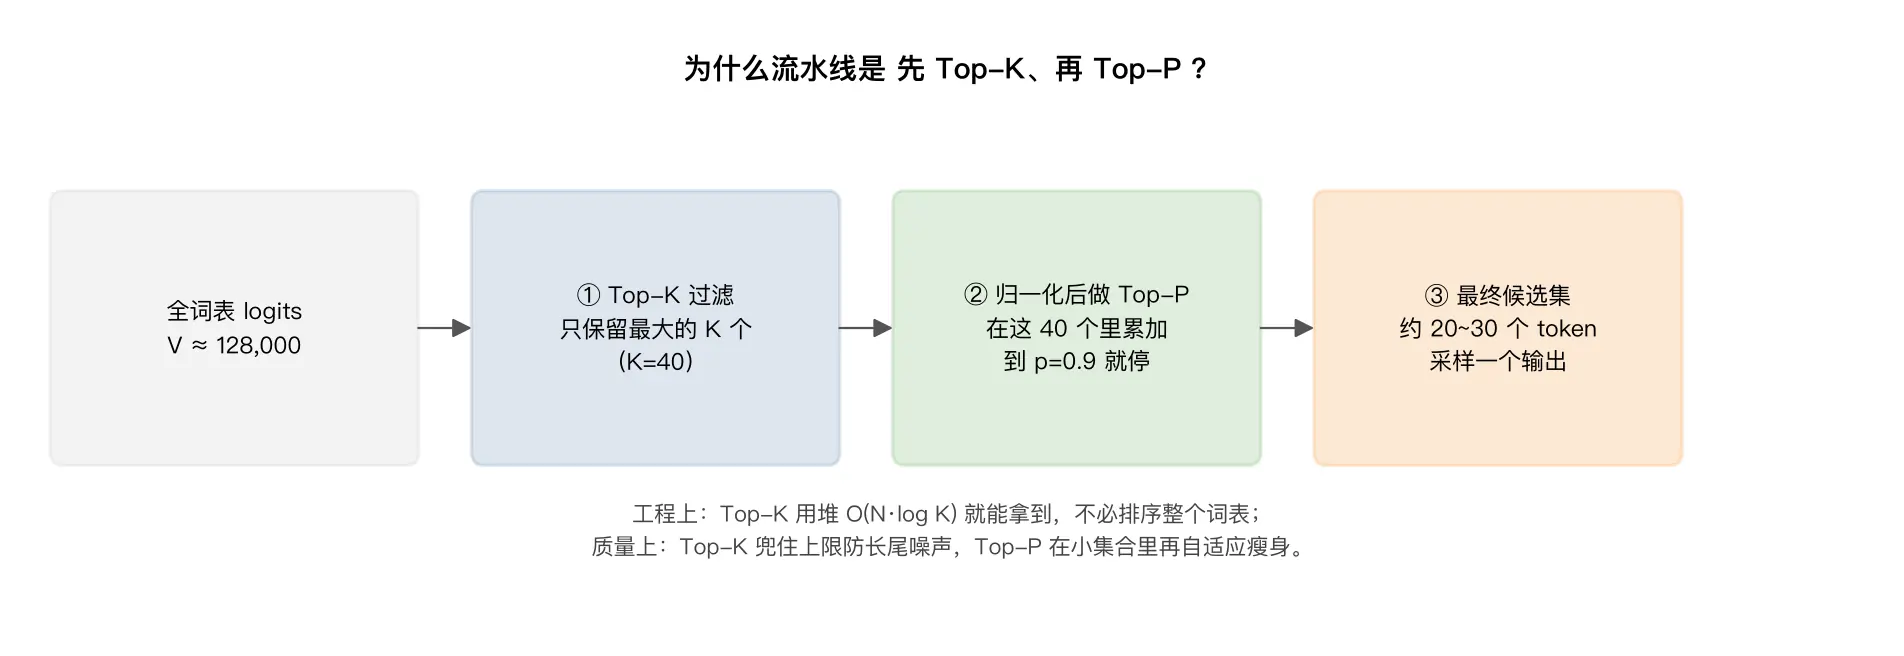
要回答这个问题,得先看清 "只开一个" 各自的短板。
5.1 单独用 Top-K 的问题
Top-K 是固定名额 ,它不管这 K 个词的概率加起来是多少。在分布平坦的句子里(模型在犹豫),前 40 个词每个概率都很低,第 30~40 名加起来可能只有 0.5%------ 它们本质是噪声,却仍有机会被采到。等于为了 "留多样性" 硬塞了一堆不该出现的词。
5.2 单独用 Top-P 的问题
Top-P 是累计概率阈值 ,它不管候选集最后膨胀到多大。在分布极度平坦的极端情况下,要累到 90% 可能要把前几百个 token 都算上 ------ 这就把 Top-P 当初想砍掉的长尾又请回来了,候选集从几个膨胀到几百个,采样成本上去,质量反而下降。
5.3 两者合用:互补 + 工程最优
scss
最终候选集 = Top-K 集合 ∩ Top-P 核
= 概率排序后第 min(K, n_p) 个前缀-
Top-K 是上限挡板:再怎么自适应,候选集也不会超过 K 个,既控制计算量,也防止极端平坦分布下核膨胀。
-
Top-P 是尾部修剪器:在这 K 个里,把那些 "凑概率" 的边缘小词再砍掉一刀,只保留真正占主导地位的 "核"。
-
数学上:因为 S_K 和 S_P 都是 "按概率降序排好的前缀",先做哪个结果都一样 ------ 最终候选就是
min(K, n_p)个最高概率词。
5.4 为什么工程上偏偏把 Top-K 放第一
纯粹是算得快:
-
从 12.8 万个 logits 里取 Top-K,用一个大小为 K 的最小堆即可,复杂度 O(N log K) ,不需要给整个词表排序。
-
拿到 K 个候选后,再在这 K 个小集合上做累计概率扫描,O (K) 秒出结果。
-
如果反过来先做 Top-P,就得按概率从高到低累加扫描整个词表直到累计到 P,是 O (N) 甚至 O (N log N)------ 更贵。
所以 "先 Top-K 再 Top-P" 是结果等价、但计算最便宜的实现顺序,不是数学上必须的顺序。
5.5 一个直观数字例子
假设某一步词表概率排序后前 10 名是:
| 排名 | token | 概率 | 累计 |
|---|---|---|---|
| 1 | the | 0.28 | 0.28 |
| 2 | a | 0.18 | 0.46 |
| 3 | an | 0.12 | 0.58 |
| 4 | this | 0.09 | 0.67 |
| 5 | it | 0.07 | 0.74 |
| 6 | our | 0.05 | 0.79 |
| 7 | its | 0.04 | 0.83 |
| 8 | their | 0.03 | 0.86 |
| 9 | some | 0.025 | 0.885 |
| 10 | one | 0.02 | 0.905 ← 首次 ≥ 0.9 |
设 top_k = 8、top_p = 0.9:
-
Top-K 先砍:保留前 8 个。
-
Top-P 再砍:在这 8 个里累计到第 8 名才 0.86,还没到 0.9,本想补第 9 名 ------ 但第 9 名已被 Top-K 屏蔽,不会跨回去捞。
-
结果:最终候选 = 前 8 个 token。
这就是 "两道筛子取交集" 的真实含义:Top-K 把后面的词永久屏蔽之后,Top-P 只能在被屏蔽剩下的小集合里做累计,不会把已经被 Top-K 扔掉的词再捡回来 。
8. 实际怎么用(高置信度经验值)
6.1 各推理引擎到底支持什么参数
并不是所有引擎都 "两者同时开启"------ 这是上一节那句话需要补全的地方:
| 引擎 / API | top_k | top_p | temperature | 默认值 |
|---|---|---|---|---|
HuggingFace transformers.generate |
✅ | ✅ | ✅ | top_k=50, top_p=1.0, temp=1.0 |
vLLM SamplingParams |
✅ | ✅ | ✅ | top_k=-1(关), top_p=1.0, temp=1.0 |
| TGI(HuggingFace 推理服务) | ✅ | ✅ | ✅ | top_k=0(关), top_p=1.0 |
| Ollama | ✅ | ✅ | ✅ | top_k=40, top_p=0.9, temp=0.8 |
Google Gemini GenerationConfig |
✅ | ✅ | ✅ | top_k、top_p 都需显式给 |
| OpenAI Chat Completions | ❌ 不暴露 | ✅ | ✅ | top_p=1.0, temp=1.0 |
| Anthropic Messages API(现行) | ❌ 不暴露 | ✅ | ✅ | top_p=1.0, temp=1.0 |
要点:
-
开源推理栈(HF /vLLM/ TGI / Ollama / Gemini):两个参数都给,按上一节的 "先 Top-K 再 Top-P 取交集" 流水线跑。
-
闭源 SaaS API(OpenAI / Anthropic) :只暴露
top_p和temperature,不让你调 top_k------ 它们把 top_k 锁死在服务端(一般不开或用一个很大的值),对外只让你控制 nucleus。 -
所以上一节说的 "两道筛子" 主要是开源栈的行为;在 OpenAI / Anthropic 上你只会感受到一道 top_p。
6.2 按场景调参经验值(开源栈,两个都能调)
| 场景 | top_p | top_k | temperature | 说明 |
|---|---|---|---|---|
| 代码、数学、事实问答 | 0.1 ~ 0.3 | 关闭或 ≤ 10 | 0.0 ~ 0.2 | 要确定性,少犯错 |
| 通用对话 / 写作(默认) | 0.85 ~ 0.95 | 40 ~ 60 | 0.7 | 大多数人该用的区间 |
| 创意写作 / 头脑风暴 | 0.95 ~ 0.99 | 80 ~ 100 | 0.9 ~ 1.1 | 要发散 |
| 摘要 / 翻译 / 改写 | 0.5 ~ 0.7 | 20 ~ 30 | 0.3 ~ 0.5 | 要保留忠实度 |
如果用的是 OpenAI / Anthropic,跳过
top_k列,只按top_p+temperature调即可 ------ 效果差异不大。
6.3 经验法则
-
优先调 temperature,它是 "整体缩放"(把概率分布拉尖或压平);top_p 是 "局部筛选"(砍候选集)。
-
想更稳 → 同时把
top_p降到 0.5 左右,temperature 降到 0.2。 -
想更有创造性 → 推
top_p到 0.95,temperature 推到 1.0。 -
不要把 top_p 和 top_k 都设得很极端(比如 top_p=0.99 同时 top_k=5),等于自相矛盾。
-
temperature=0 时,top_k/top_p 设什么都不影响结果 ------ 会直接退化为贪心解码。
9. 在 RAG 和 Agent 里到底用不用?
用,但取值和纯聊天完全不一样------ 趋势是把 temperature 和 top_p 都压得很低,因为 RAG 和 Agent 都要 "可靠、不跑题"。
7.1 RAG 里的两个 "top_k",别搞混
RAG 流程如下,先看流程图再看参数:
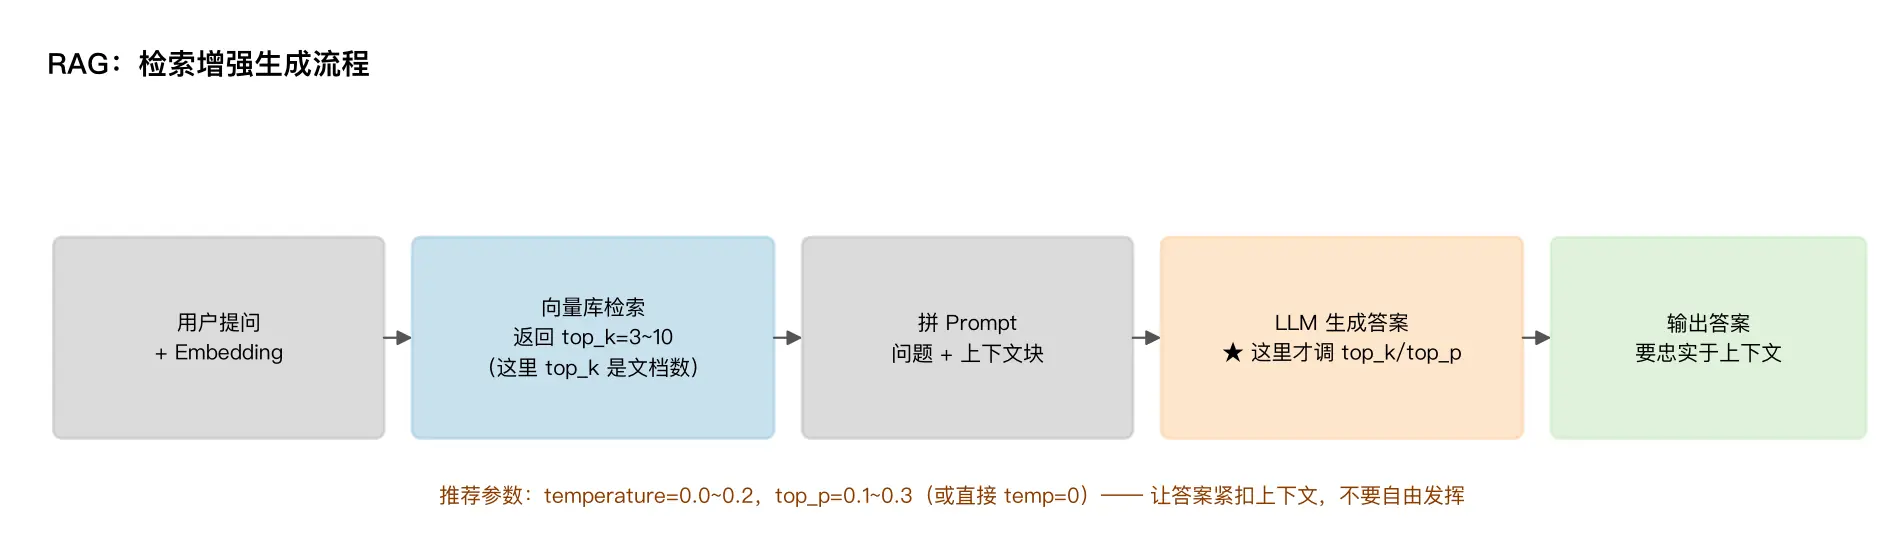
RAG 流程里有两处出现 "top_k",同名不同物:
| 位置 | 它指什么 | 典型值 |
|---|---|---|
向量库检索时的 top_k |
返回多少个文档块(chunk) | 3 ~ 10 |
LLM 生成时的 top_k |
采样时保留多少个 token | 40 ~ 60,或关闭 |
工程文档里写 "调 top_k" 时要先问一句:是检索 k 还是采样 k? 这是 RAG 新人最常见的踩坑点。
7.2 RAG 生成阶段的采样参数
RAG 的核心诉求是答案忠实于检索到的上下文,不要自由发挥、不要幻觉。所以:
| 参数 | 推荐值 | 原因 |
|---|---|---|
| temperature | 0.0 ~ 0.2 | 让输出贴近上下文,不跑偏 |
| top_p | 0.1 ~ 0.3 | 候选集压到最小 |
| top_k | 关闭或 ≤ 10 | 配合低 temperature |
| 常见做法 | 直接 temperature=0 | 一步到位,top_k/top_p 都不用管 |
LangChain / LlamaIndex / RAGFlow 等框架默认 RAG 场景都是低 temperature,就是这个道理。
7.3 Agent 里要分两种 LLM 调用
Agent 的工具调用循环如下:
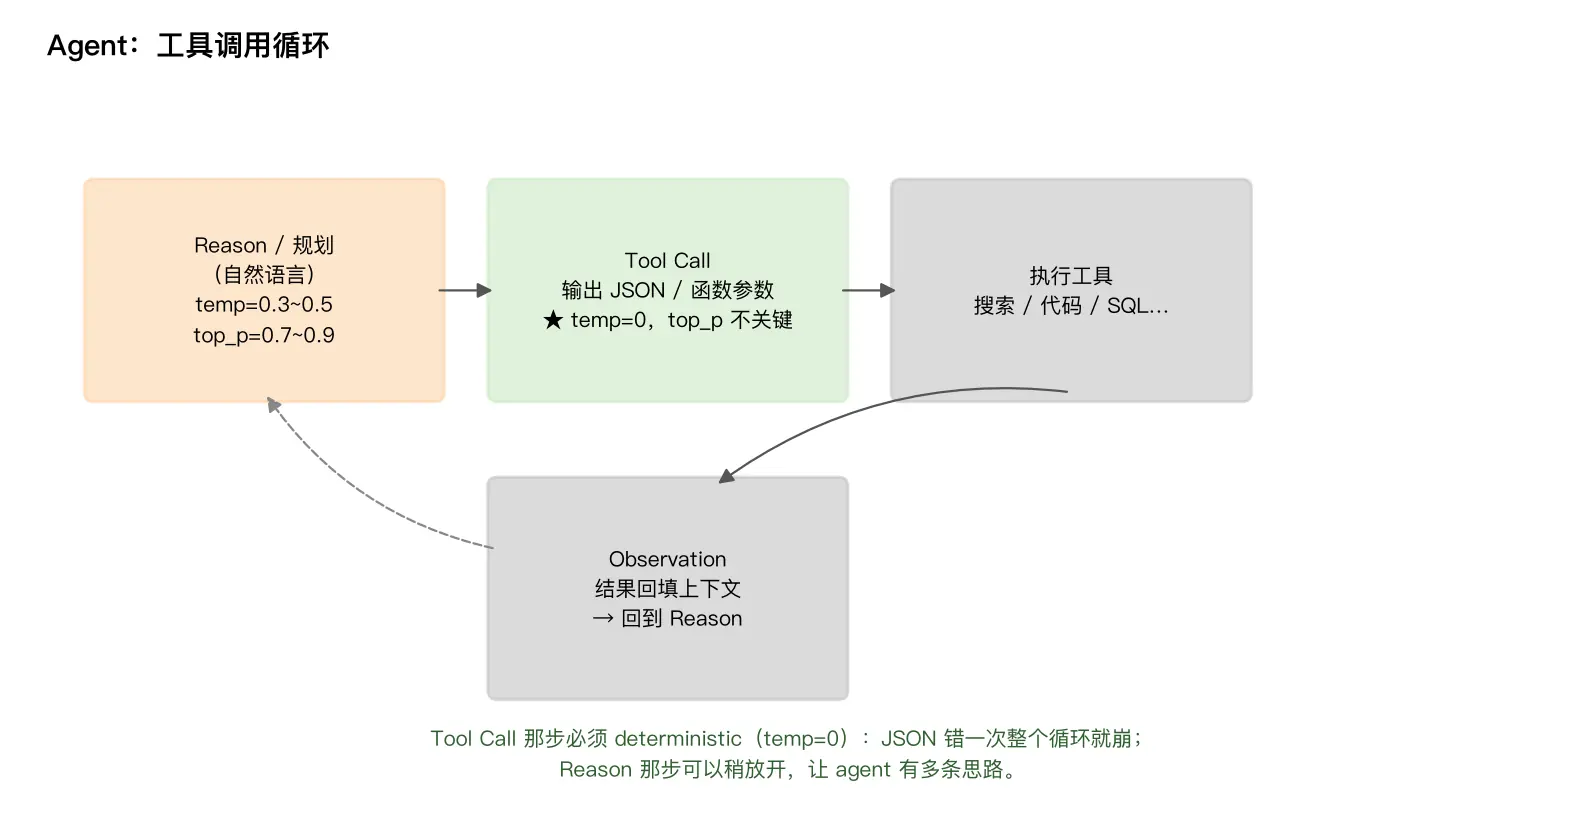
Agent 每一轮循环里至少有两类 LLM 调用,参数要区别对待:
| 调用类型 | 作用 | temperature | top_p | 说明 |
|---|---|---|---|---|
| Tool Call / 结构化输出 | 输出 JSON / 函数参数 | 0.0 ~ 0.1 | 0.1 或不管 | JSON 格式错一次整个循环就崩,必须 deterministic |
| Reason / 规划 | 自然语言推理、跟用户解释 | 0.3 ~ 0.5 | 0.7 ~ 0.9 | 可以稍微放开,让 agent 有多条思路 |
| 最终回答用户 | 输出最终结论 | 0.2 ~ 0.4 | 0.5 ~ 0.7 | 要准确,也要可读 |
关键认知:
-
Tool Call 那步几乎都是 temperature=0,top_k/top_p 设什么都无所谓 ------ 会直接退化为贪心解码。
-
OpenAI / Claude 的 function calling 已经在解码层做了受限生成(constrained decoding),输出格式被服务端锁死,top_k/top_p 对结果影响很小。
-
Reason 那步是 Agent 里唯一值得稍微放开采样的地方,但也比创意写作保守得多。
一个具体例子:ReAct 循环长什么样
用户输入:"帮我查一下北京明天天气,顺便订一张后天去上海的机票。"
Agent 一轮一轮跑出来是这样(这就是学术界说的 ReAct = Reasoning + Acting 格式):
ini
Thought 1: 用户要做两件事:查天气 + 订机票。
          先查天气,再订机票。先调用天气 API。
Action 1: weather_api(city="北京", date="明天")
Observation 1: 晴,22°C

Thought 2: 天气拿到了。下一步订机票。
          但我还不知道用户想要几点起飞、什么舱位,得先问一下。
Action 2: ask_user(question="后天去上海,偏好几点起飞?")
Observation 2: 用户说上午出发,经济舱

Thought 3: 信息齐了,可以调订票 API 了。
Action 3: book_flight(from="北京", to="上海", date="后天",
                      time="上午", class="经济舱")
Observation 3: 订单已确认,订单号 ABC123

Thought 4: 任务完成,给用户汇报。
Final Answer: 北京明天晴 22°C;已订后天上午北京→上海经济舱机票,订单号 ABC123。
对应到图里:
| 图里的步骤 | 例子里的什么 | 干什么 |
|---|---|---|
| Reason / 规划 | 所有 Thought 行 |
想、决定、解释为什么 |
| Tool Call | 所有 Action 行 |
输出结构化 JSON 调工具 |
| 执行工具 | (系统调 API) | 真正跑 |
| Observation | 所有 Observation 行 |
工具结果回填,进入下一轮 |
为什么需要 Reason 这一步:
-
没有它,Agent 就是个 "瞎调 API 的壳"------ 不知道该调哪个、为什么调。
-
它就是 LLM 智能真正起作用的地方:判断当前状态、回顾已试过的路径、规划下一步、拒绝走不通的分支。
-
学术上这也叫 Chain-of-Thought(思维链)。
为什么 Reason 的 temperature 比 Tool Call 稍高:
-
Tool Call 必须输出合法 JSON → temp=0,一个字符都不能错。
-
Reason 这步可能有多条合理的下一步(比如先问用户还是先查数据库),稍微放开一点让 Agent 能探索不同思路,不至于卡死。
-
但也不会放到创意写作那种 0.9------ 再开放就会想飞了。
7.4 一句话对比
| 场景 | temperature | top_p | top_k |
|---|---|---|---|
| 创意写作(前面讲的) | 0.9 ~ 1.1 | 0.95 ~ 0.99 | 80 ~ 100 |
| RAG 问答 | 0.0 ~ 0.2 | 0.1 ~ 0.3 | 关闭 |
| Agent 工具调用 | 0.0 | 不管 | 不管 |
| Agent 推理 | 0.3 ~ 0.5 | 0.7 ~ 0.9 | 40 |
记忆法:越靠近 "结构化输出" 和 "忠实于上下文",越往 temperature=0、top_p→0 走;越靠近 "自由表达",越往大开。
7.5 实战:自己做 RAG / Agent 项目,要动态调这些参数吗?
直接结论:90% 的项目设一次就不再动。 动态调节是少数场景,不是主流做法。
大多数项目的真实做法
启动时定好 → 跑完整个任务 → 结束-
RAG:
temperature=0.0写死在配置里,从不改。 -
Agent:Tool Call 那步
temperature=0写死,Reason 那步temperature=0.4写死。 -
上线后几乎没人动这些值。
为什么不调:
-
可复现性:调过之后你没法复现 bug------"这次为什么输出乱了?" 因为 temperature 在中途被改过。
-
调试噩梦:采样参数是隐式变量,动态改等于在黑盒里再加一个旋钮。
-
收益小:真正影响质量的是 prompt、检索质量、工具设计,不是这几个旋钮。把 prompt 从 70 分调到 90 分,比把 temperature 从 0.7 调到 0.6 有用 10 倍。
真正会动态调的少数场景
| 场景 | 怎么调 | 常见度 |
|---|---|---|
| 失败重试:JSON 解析失败 / 答案幻觉 | 自动把 temperature 从 0.4 降到 0.1 重试一次 | ⭐⭐⭐ 常见 |
| 按任务路由:router 判断是代码任务就 temp=0,是创意任务就 temp=0.9 | 在调 LLM 之前先选预设,不是 "动态",是 "分流" | ⭐⭐ 常见 |
| 用户交互滑块:产品里给用户一个 "创造力 / 严谨度" 滑块 | 用户显式控制,不是 Agent 自己调 | ⭐ 产品里才有 |
| 自适应 Agent:观察自己输出质量自动调参 | 学术原型多,生产几乎不见 | ⭐ 罕见 |
| 多轮对话中用户反馈:用户说 "再有趣点" 就调高 | 实际很少实现,多数产品用预设模板 | ⭐ 罕见 |
给你项目的具体建议
-
默认就用上一节表里的预设 ,写在配置文件里,别做自动调节逻辑。
-
唯一值得加的 "动态" 逻辑是失败重试 :当 Tool Call 返回的 JSON 解析失败时,把
temperature临时降到 0.0 重试一次 ------ 这是工程上最划算的一招。 -
真要给用户控制感 ,就在产品 UI 放一个滑块("严谨 ↔ 发散"),映射到
temperature0.2 ~ 0.9,不要让 Agent 自己决定。 -
别做的事:让 Agent 每一轮都 "观察上一轮输出质量" 然后自己调 temperature------ 这是研究 demo,不是生产代码,会把你 debug 到怀疑人生。
10. 一句话记忆
-
Top-K = "只准从概率榜前 K 名里挑"(名额固定)。
-
Top-P = "挑到累计概率凑够 P 就停"(名额浮动,按把握度自动伸缩)。
-
实践中 top_p 比 top_k 更常用、更鲁棒;要 "稳" 就把 top_p 调小,要 "活" 就调大。