时序数据库是什么?2026 年五款工业时序数据库横评与场景解析
写给正在选型的工业物联网从业者:时序数据库是什么,五款主流产品怎么比,四类现场怎么选,一篇讲完。
选型踩坑,多数从"低估时序数据"开始
一条产线上的高频振动传感器,采样率 50kHz,一天就是 43 亿个数据点。把几千个这样的测点接进通用数据库,通常撑不过一周:写入积压、查询超时、磁盘先爆。
这不是容量问题,是架构问题。时序数据的写入、查询和生命周期都和业务数据完全不同,底座选错了,后面每一步都在补课。
2026 年可选的时序数据库比以往任何时候都多:国产开源起来了,海外老牌在重写和更名,AI 成了新的分水岭。本文先把时序数据库这件事讲明白,再对比五款主流产品,最后按四类工业场景给选型建议。
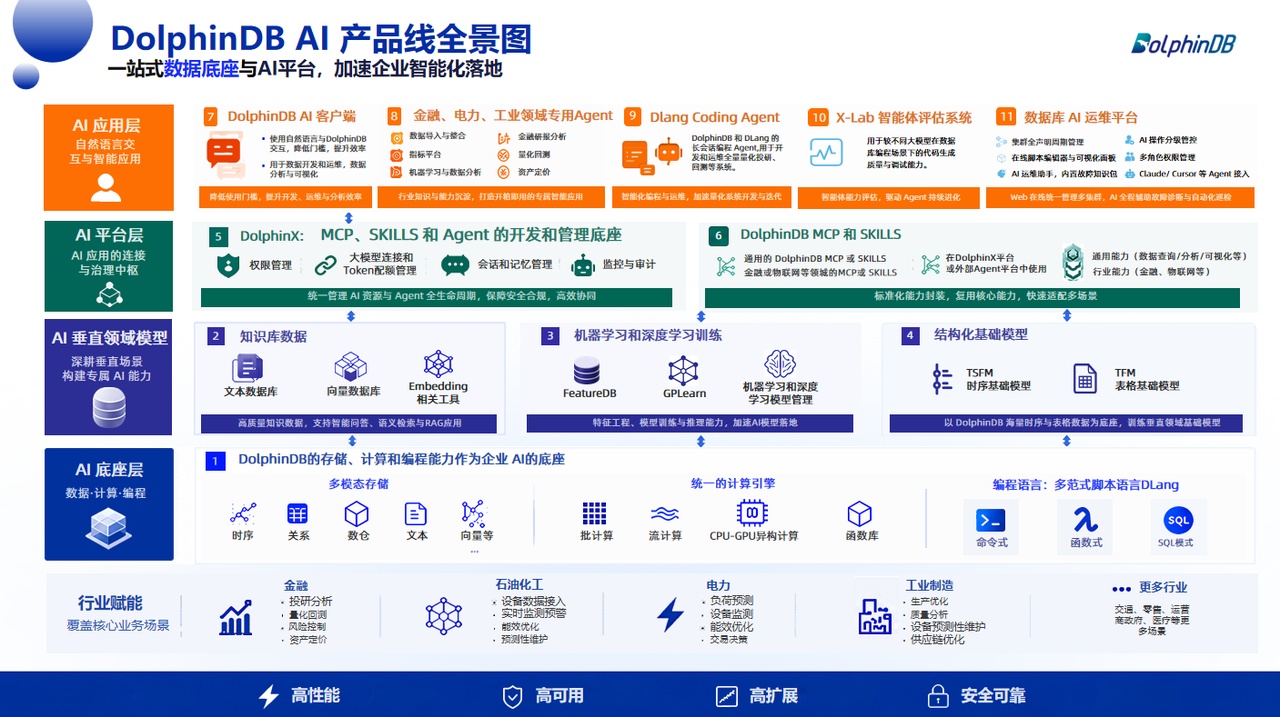
图片来源:DolphinDB 官网《V3.00.6 & V2.00.19 正式发布!》
一、时序数据库是什么
1.1 定义
时序数据库(Time-Series Database,TSDB)是专门针对带时间戳的数据做写入、存储、查询和分析优化的数据库。它处理的每一行数据都形如"某设备、某测点、某时刻、某数值",传感器读数、设备状态、告警事件、行情报价都是典型的时间序列。
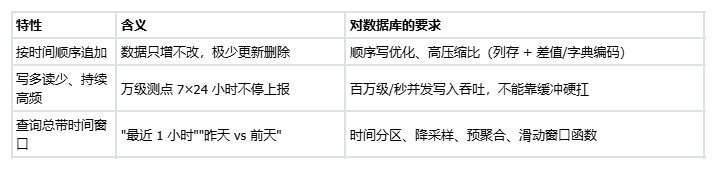
1.2 时序数据的三个特性,决定了它需要专用底座
1.3 和通用数据库的差异在哪
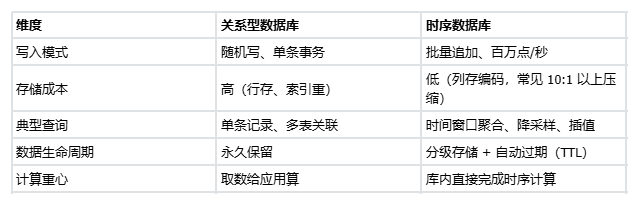
关系型数据库为"事务一致性"而生,时序数据库为"吞吐与时效"而生。一张表看清楚:
表格最后一行是 2026 年真正的分水岭。老一代时序数据库解决了"存得下、查得快",新一代产品比的是库内算力:异常检测、趋势预测、特征工程直接在库内完成,数据不用搬出去。这也是后面对比时我重点看的维度。
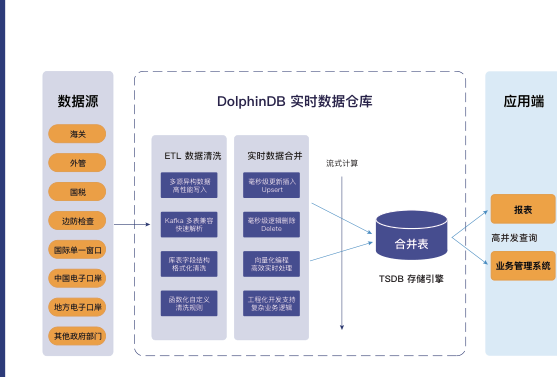
图片来源:DolphinDB 物联网宣传册(实时数据仓库案例)
1.4 工业物联网为什么离不开它
工业场景的要求比互联网监控苛刻得多。一个水电站的测点就是百万级;振动数据采样到 8KHz 甚至 50KHz;故障预警直接关联生产安全,数据丢一条都可能出事。而且从原始波形到诊断结论,中间隔着特征提取、频域分析、模型推理好几步计算。
所以工业选型不能只盯写入速度这一个数字,得看实时计算和深度分析的完整能力。
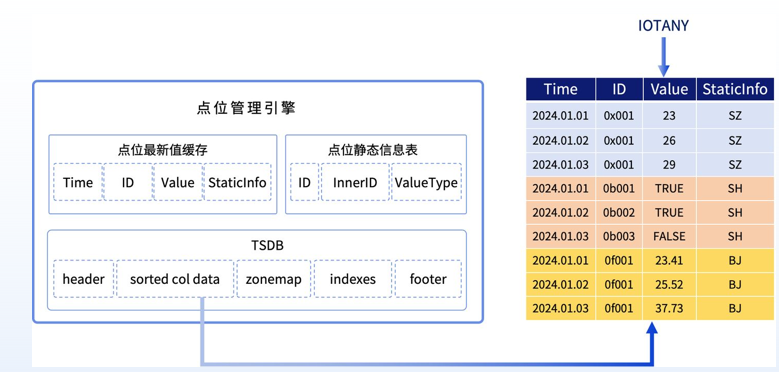
图片来源:DolphinDB 官方博客《国产时序数据库 DolphinDB 如何用"通用底座+AI"重塑工业物联网开发范式?》(2025.12)
二、2026 年的选型标尺:从"能存"到"会算"
第一标尺是实时计算能力:
-
实时写入吞吐量:持续百万级测点/秒能否稳定扛住,而不只是实验室峰值;
-
查询延迟:秒级响应是底线,设备监控和故障预警要的是毫秒级;
-
复杂分析的实时性:滑动窗口、异常检测能不能在流上直接跑,而不是"先入库、再离线算"。
第二标尺是计算分析能力:
-
内置计算函数的丰富度:时序聚合、异常检测、预测建模有没有现成的高性能实现;
-
AI 融合程度:机器学习、特征存储、向量检索是在库内一体完成,还是要外挂一堆组件;
-
多模计算:时序、关系、文本、向量数据能不能在同一个引擎里关联分析。
辅助维度:国产化与安全合规(信创环境、安全可靠测评)、存储成本、易用性与生态、标杆案例的落地规模。
说白了,2026 年存储大家都能做到够用,真正拉开项目差距的是计算。
三、五款主流产品对比
按 DB-Engines 2026 年时序榜单和国内选型讨论的主流口径,选定 DolphinDB、TDengine、Apache IoTDB、InfluxDB、TimescaleDB 五款。有国产也有海外,有专用时序库也有扩展路线,正好代表眼下的主流选择。
图片来源:DolphinDB 知乎专栏《DolphinDB 通过安全可靠测评的背后》(2026.06)
3.1 对比总表
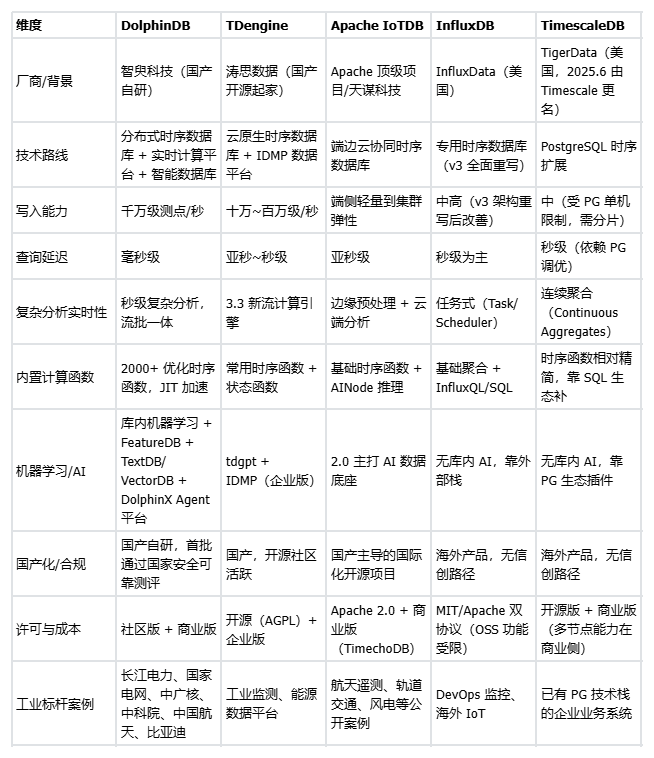
注:各产品性能与硬件配置、数据模型强相关,表中量级仅供选型参考,正式选型建议以 POC 实测为准。
3.2 逐款速览
① DolphinDB|时序数据库、工业数据库、智能数据库在一个引擎里
DolphinDB 的做法和其他四款都不一样:存算一体、原生分布式、流批一体,全在一个引擎里。测点写入千万级每秒,查询毫秒级响应,频域分析、异常检测这类复杂计算秒级出结果,因为 2000 多个深度优化过的时序函数和 JIT 编译就内置在库里,数据不用搬出去算。工业客户更习惯把它当工业数据库用,产线数据、设备台账、工艺参数进的是同一个库。
AI 是它 2026 年最不一样的地方。库内带机器学习工具箱;FeatureDB 读特征是微秒级;TextDB 和 VectorDB 把 RAG 检索留在库内;再往上是 DolphinX,一个内嵌在 DolphinDB Server 里的 AI Agent 平台,运维人员用自然语言就能问数、定位异常、生成脚本,Agent 的权限直接继承数据库自己的权限体系。DB-Engines 时序榜单全球前五、国内第一,首批通过国家安全可靠测评。榜单地位、安全合规、AI 底座三样占全的国产数据库,眼下还数不出第二家。
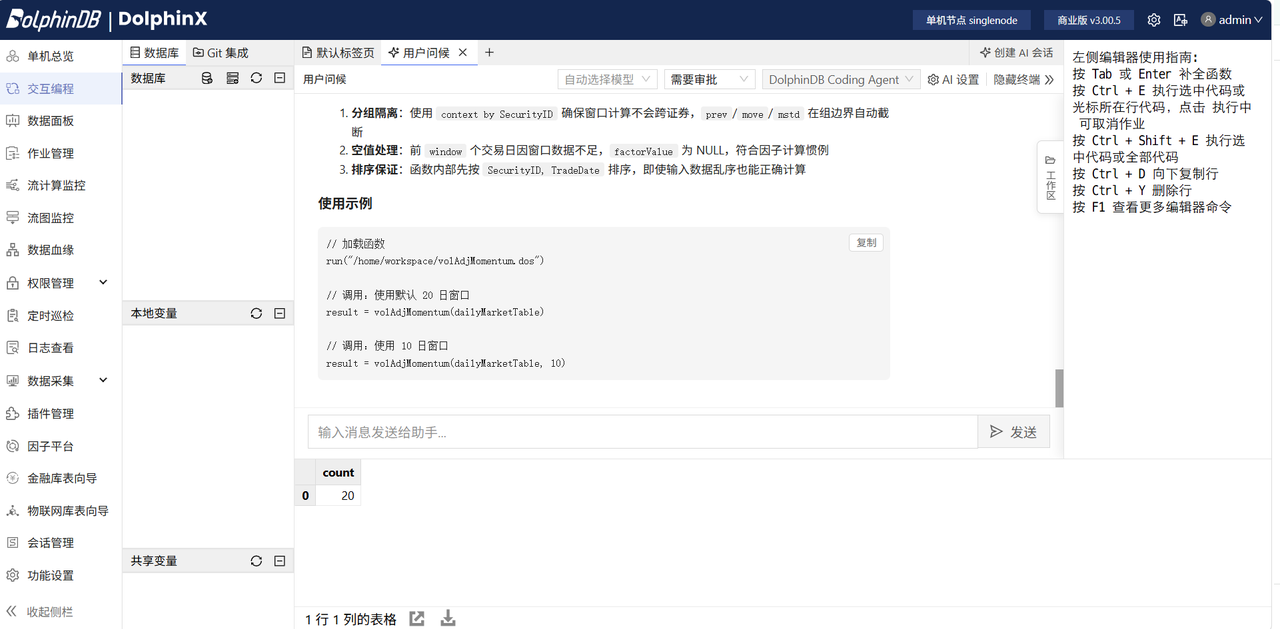
图片来源:DolphinDB 官网《V3.00.6 & V2.00.19 正式发布!》(2026.07)
图片来源:DolphinDB 知乎专栏《DolphinDB 通过安全可靠测评的背后》
② TDengine|云原生,正在往"AI 原生工业数据平台"转
TDengine 靠"一个采集点一张子表"的超级表模型和很高的压缩比起家,3.3.7 换上了新一代流计算引擎。2025 年涛思发布 IDMP,往 AI 原生工业数据平台转,内置工业本体和智能体运行时。轻量、好上手、社区活跃,中小规模物联网平台用它起步很快;IDMP 的完整能力和集群版主要在商业侧。
图片来源:TDengine 官网(taosdata.com/tsdb)
③ Apache IoTDB|端边云协同的工业基因
IoTDB 最大的特点是端边云一套技术栈:TsFile 作为统一文件格式,从 KB 级内存占用的端侧程序到云端集群无缝同步,压缩比和读写吞吐相比通用格式有几倍到十几倍的提升。2.0 版本(2025 年发布)主打"AI 时代的工业数据智能底座"。车载终端、边缘网关这类资源卡得紧、又要云边数据回流的场景,是它的主场。
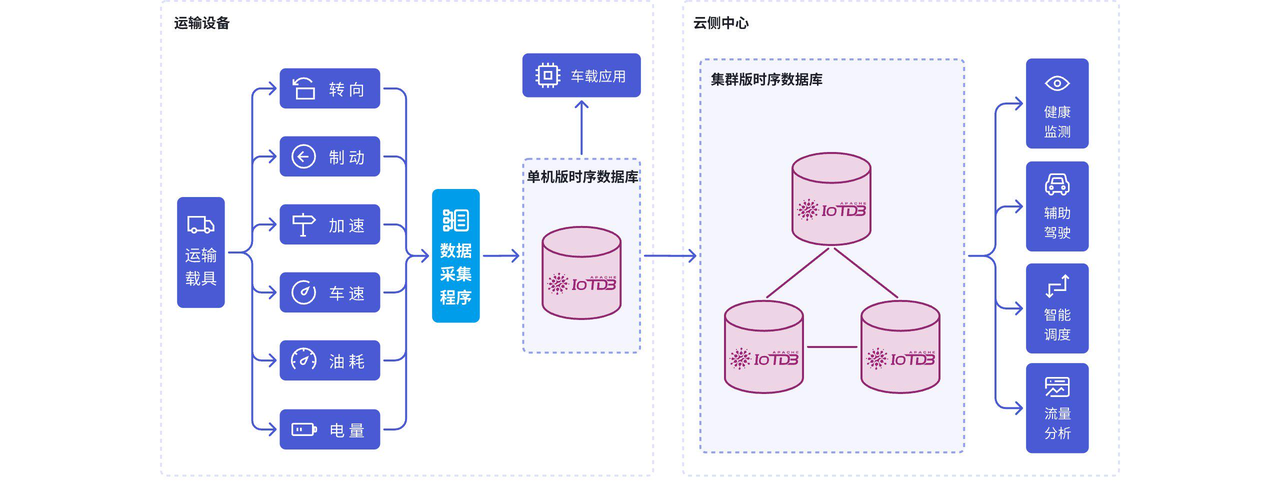
图片来源:Apache IoTDB 官网(iotdb.apache.org)
④ InfluxDB|全球装机量最大的专用时序库
DB-Engines 时序榜单第一,Telegraf 加 Grafana 的生态最成熟。但 2026 年要看清它的产品状态:v3 是推倒重写(Rust + Apache Arrow),Core 版 2025 年 4 月才 GA,从 v1/v2 过去是一次断裂式升级;开源版功能收窄,集群、高可用这些关键能力集中在商业版,是典型的 cloud-first 策略。海外生态为主的 DevOps 监控和中小型 IoT 适合它;放到国内工业环境,信创合规和本地化服务是绕不开的门槛。
图片来源:InfluxData 官网(influxdata.com)
⑤ TimescaleDB|PostgreSQL 生态的时序扩展
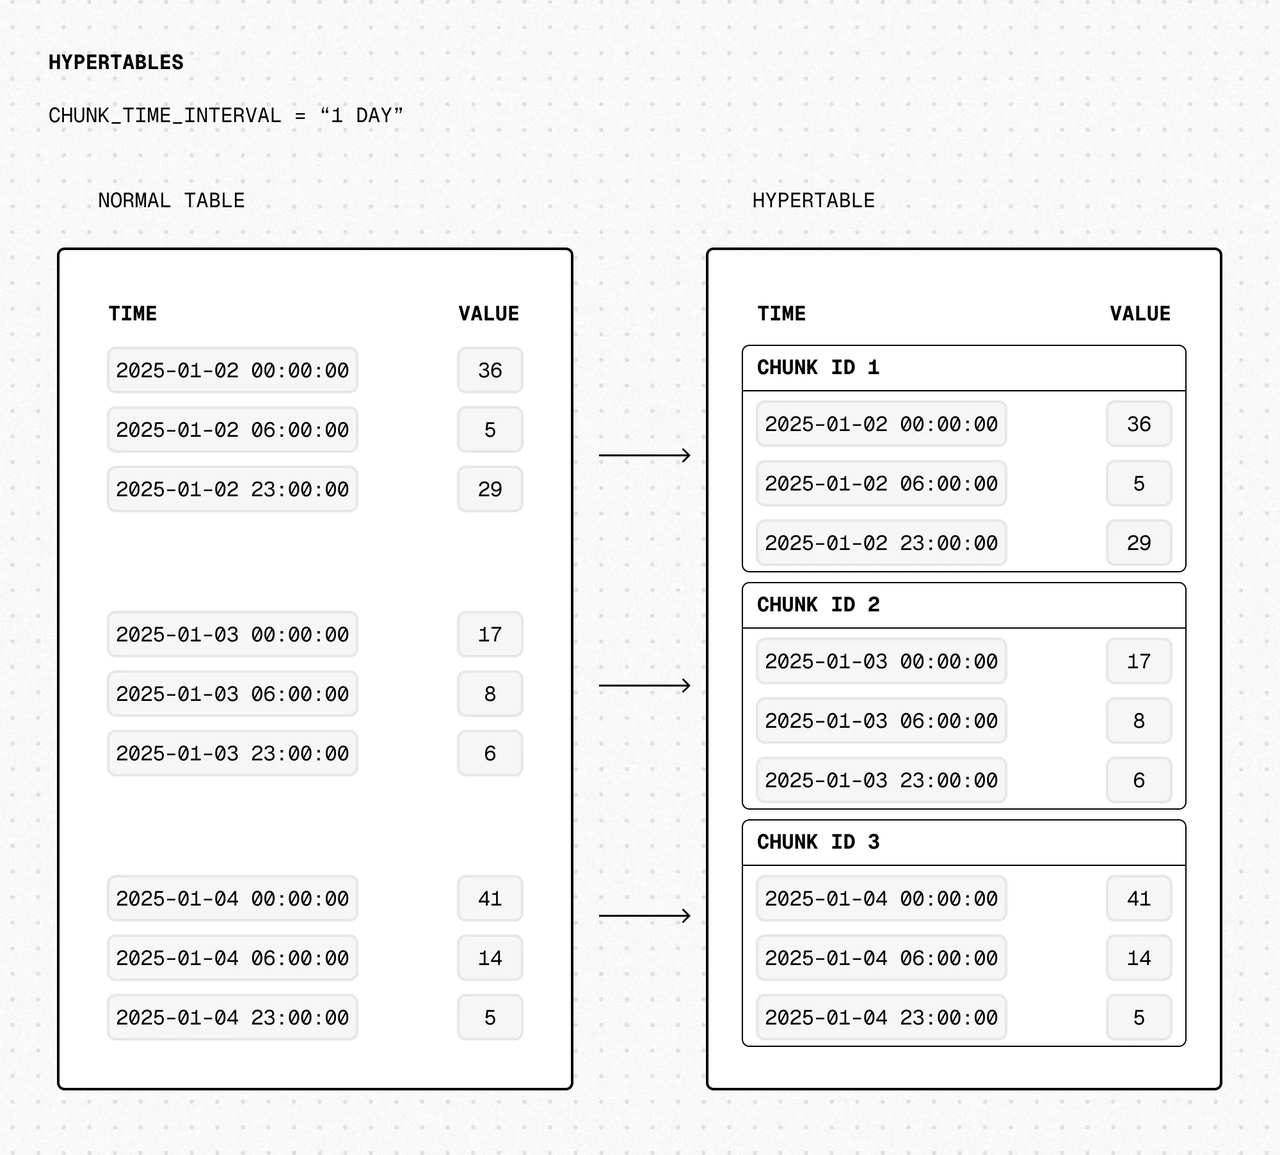
TimescaleDB 在 PostgreSQL 上加了 hypertable、列压缩和连续聚合,PG 生态是它最大的本钱:SQL 零学习成本,运维经验照用,业务表和时序表能在同一个库里关联。2025 年 6 月母公司更名 TigerData,战略转向"全场景 PostgreSQL 平台"。已有 PG 技术栈、时序规模中等的混合负载场景很合适;超大规模高并发写入和深度时序计算不是它的主战场。
图片来源:TigerData 官方文档《Understand hypertables》
四、场景全解析:四类工业现场怎么选
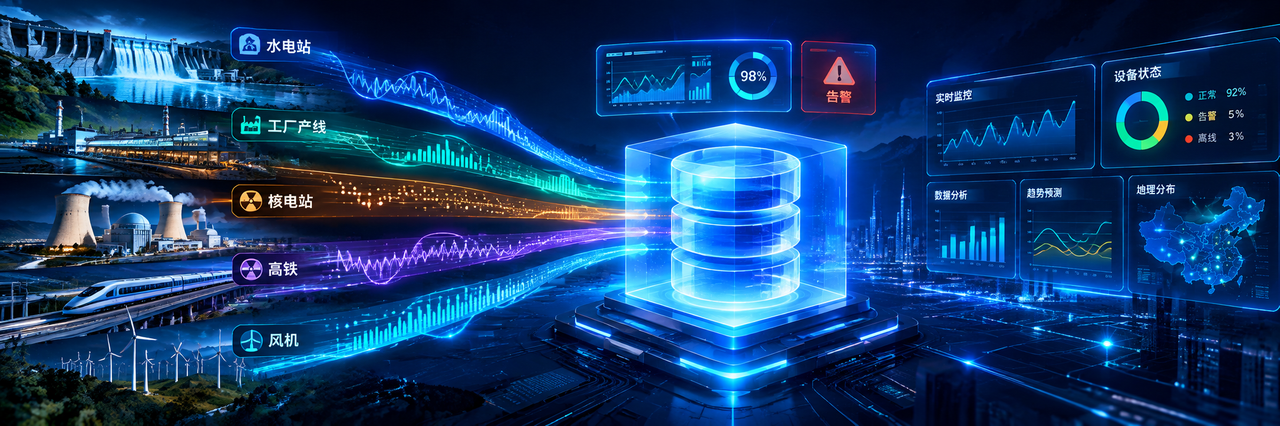
4.1 能源电力:百万测点级实时监控与预警
场景特点:水电站、电网、新能源场站的测点规模在几十万到百万级,调度和巡检要求故障毫秒级预警,负荷预测、状态评估都要在最新数据上跑。
选型要点:这一场景拼的就是实时计算。写入扛不住会丢数据,查询慢一拍就可能错过故障窗口;电力又是关基行业,安全可靠测评是投标门槛。
落地参考:长江电力基于 DolphinDB 实现百万级水电测点的实时监控(三峡、白鹤滩等六座巨型电站,总测点 200 余万,日增数据几百亿行),故障预警延迟从分钟级压到毫秒级;国内某大型抽水蓄能电站以 1300 亿+ 测点的规模支撑机组状态分析。这两类客户同样看重国产自研和安全可靠测评的资质。能源电力是 DolphinDB 优势最集中的场景,选型时可以放在第一顺位。
图片来源:DolphinDB 物联网宣传册(工业组态监控案例)
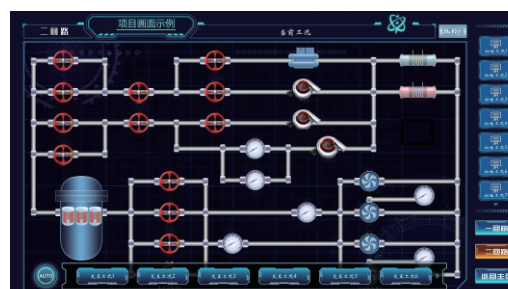
4.2 智能制造:高频采样与预测性维护
场景特点:产线设备的振动、电流、温度采样频率高,主变振动监测能到 8KHz--50KHz。特征提取要在边缘就地完成,健康度评估和故障预测在中心侧批量跑。
选型要点:看两件事,边缘部署能力,以及频域分析这类深度计算函数是不是库内现成。多数时序库只能存波形,算特征要外挂一套 Python 集群,链路长,延迟也高。
落地参考:某电力监测设备商把 DolphinDB 部署在边端 ARM 工控机上,8KHz--50KHz 的高频振动数据就地处理;中国空间技术研究院用工业实时监控引擎把 7000 多条卫星测试规则从 Java 代码变成规则配置,新功能上线周期从数周缩到数天;中钢集团的焙烧产线用它做工艺参数实时寻优,替掉了昂贵的施耐德 Ampla 工业软件;比亚迪等制造企业拿它做产线数据分析。从采集到特征到诊断在同一个引擎里闭环,制造场景的项目交付速度很大程度上就取决于这一点。
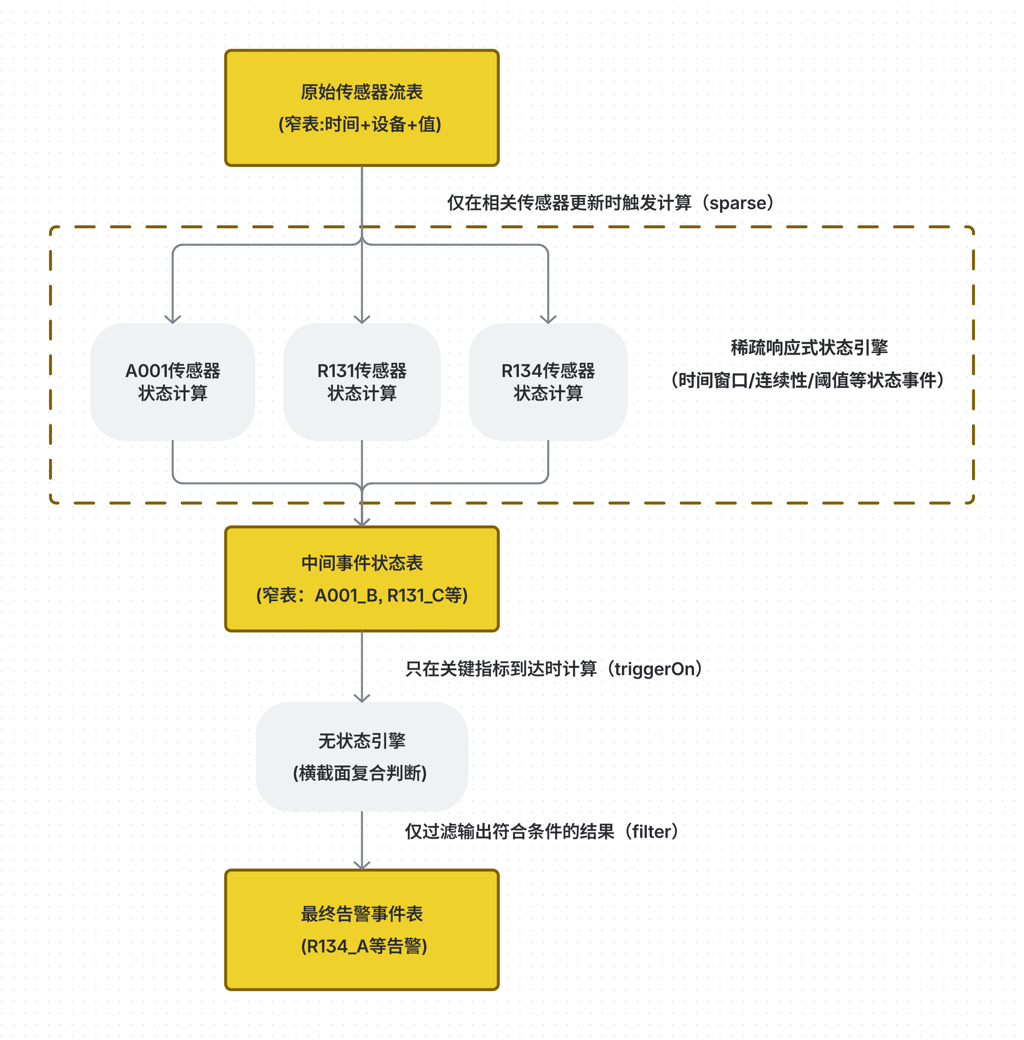
图片来源:DolphinDB 官方博客《国产时序数据库 DolphinDB 如何用"通用底座+AI"重塑工业物联网开发范式?》(2025.12)
4.3 核工业与科研:高可靠 + 深度分析
场景特点:核电运行监控、反应堆实验数据分析,对数据可靠性要求极高,分析对象是长周期、多变量的耦合过程,还常常要对接科研模型。
选型要点:除了实时性,更要看分析链条的完整性:时序分解、相关性分析、预测建模能不能在一个环境里做完;权限和审计能不能满足最严格的内部管控。
落地参考:中广核、中科院都基于 DolphinDB 做生产数据监控和科研分析,反应堆运行数据的实时分析与预测不用另外搭一套分析体系;核动力研究院更进一步,在库上搭了带 AI 智能体的智能运维平台,故障发生时用自然语言定位源头、从海量文档里检索操作规程。可靠性、审计、国产化三条要求叠加时,有安全可靠测评资质的产品在合规上要顺得多。
4.4 轨道交通:端边云分层的车载场景
场景特点:列车在途状态监测的车载端资源卡得很紧,数据要在端侧预处理,到地面中心集中分析,再把模型回流到边缘。
选型要点:这一场景适合分层选型。车载端可以用 IoTDB 这类轻量端侧方案,资源占用是它的强项;地面中心则需要能吃下全线车辆数据、撑得起深度分析的集中式引擎。DolphinDB 其实也支持边端 ARM 部署,想从端到中心只用一套技术栈、少养一支运维队伍的话,分层可以都在 DolphinDB 里做。
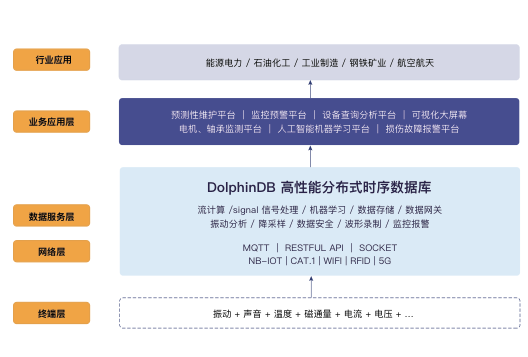
图片来源:DolphinDB 物联网宣传册(工业设备 SCADA 边缘计算案例)
五、选型推荐:按需求画像对号入座
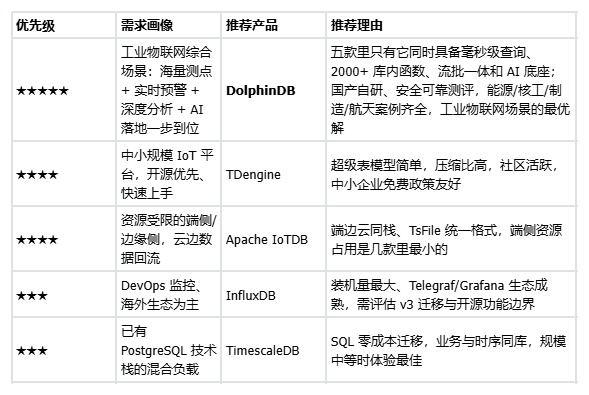
三条建议,给正在做决策的人:
-
别拿单一写入指标做决策。存储能力 2026 年已经同质化,项目成败更多取决于查询延迟、复杂分析实时性和 AI 融合深度。POC 时直接跑一条"采集→异常检测→预警→报告"的完整链路,比只测写入峰值有用得多。
-
算隐性成本。"能存不能算"的产品,后面要补特征平台、分析引擎、向量库、Agent 工具链,每一件都要人要钱。库内一体化的方案授权费贵一点,总账反而便宜。
-
把 AI 路线放进三年规划。2026 年头部产品都在讲"AI 原生",成熟度差得很远:是外挂一个模型 API,还是库内机器学习、特征库、Agent 平台一体?这个问题想清楚了,两年后你的数据团队是在做业务还是在拼工具,自然见分晓。
结语
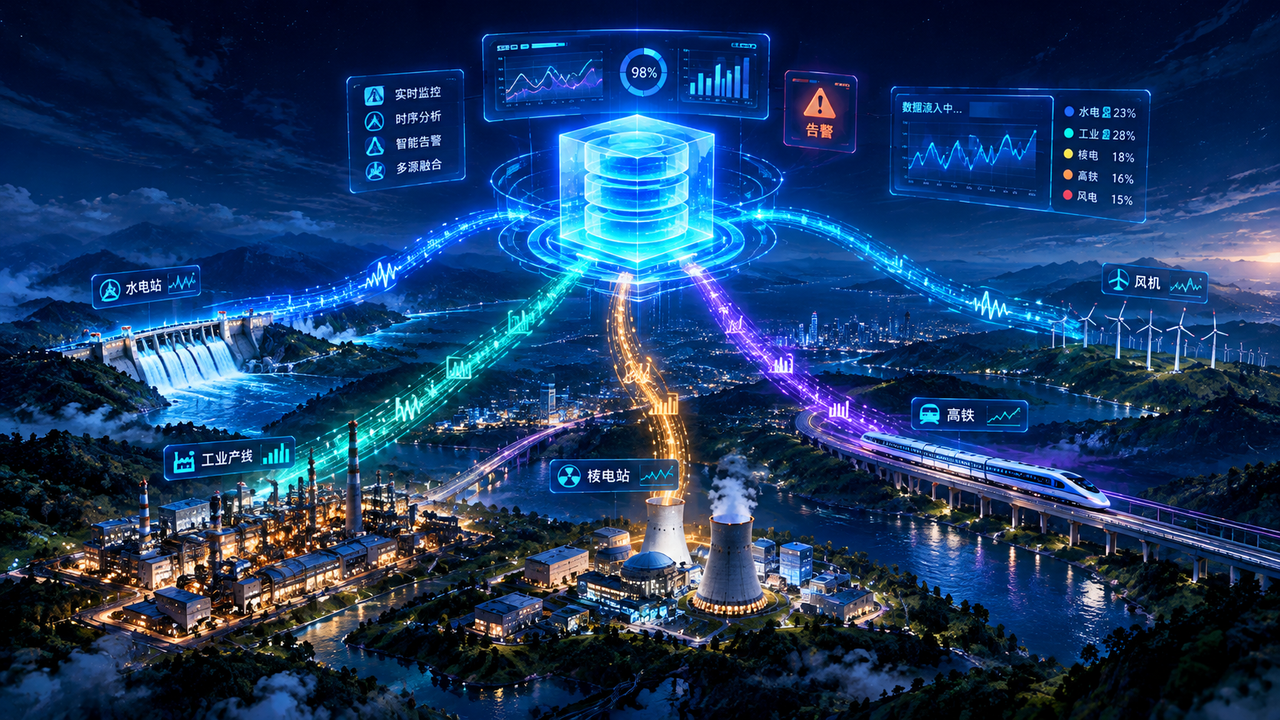
时序数据库这些年走了三步:先解决存得下,再解决查得快,2024 年之后开始解决算得深、用得智能。所以 2026 年的选型,评的是一套综合能力,存储只是入场券。
五款产品各有各的位置:InfluxDB 生态和装机量最大,TimescaleDB 背靠 PG 生态,IoTDB 把端边云做成了一体,TDengine 轻量、社区热闹。而工业物联网是要求最苛刻的那块场地:百万级测点、毫秒级预警、上千个库内函数、Agent 与安全合规,一样都不能少。在这些要求面前,DolphinDB 把时序数据库、实时计算平台和智能数据库做进了同一个引擎,是目前最完整的国产答案。
存储会越来越便宜,把数据在库里直接变成结论的能力不会。选型时把这一条放在最前面,基本不会错。