Gemini4 是铺垫了很久很久,吹了好一阵了。
从预期的角度来说,肯定是让人失望的。
但是从实用性的角度来考虑,还是有一定用处的。
G4 的综合能力并不差!
今天我们就按标准流程来分享一下 Gemini 4 的情况,然后和它自家的 Flash,以及隔壁家旗舰模型,做个简单直观的对比。
我尽量多给一些参考内容,方便大家根据自己的情况选择模型!
基础信息
为了方便大家全面地了解这个模型,先来看一下基础信息。
我们就不看任何第三方的添油加醋的消息了,就看官方的发布信息!
官方博客的核心描述是:
Gemini 4 Argon:专为解决您最棘手的问题而打造
然后来看看它擅长的领域:
Argon 在处理复杂的实际任务方面表现出色,其应用领域涵盖编码、金融、法律、网络安全和科学等。凭借其在多步骤任务中的深度和精准度,Argon 在各领域的基准测试中均超越了其他前沿模型,并在 Vals 指数中排名第一。
这里面主要是提到了编码、金融、法律、网络安全和科学。
具体的基准数据如下:
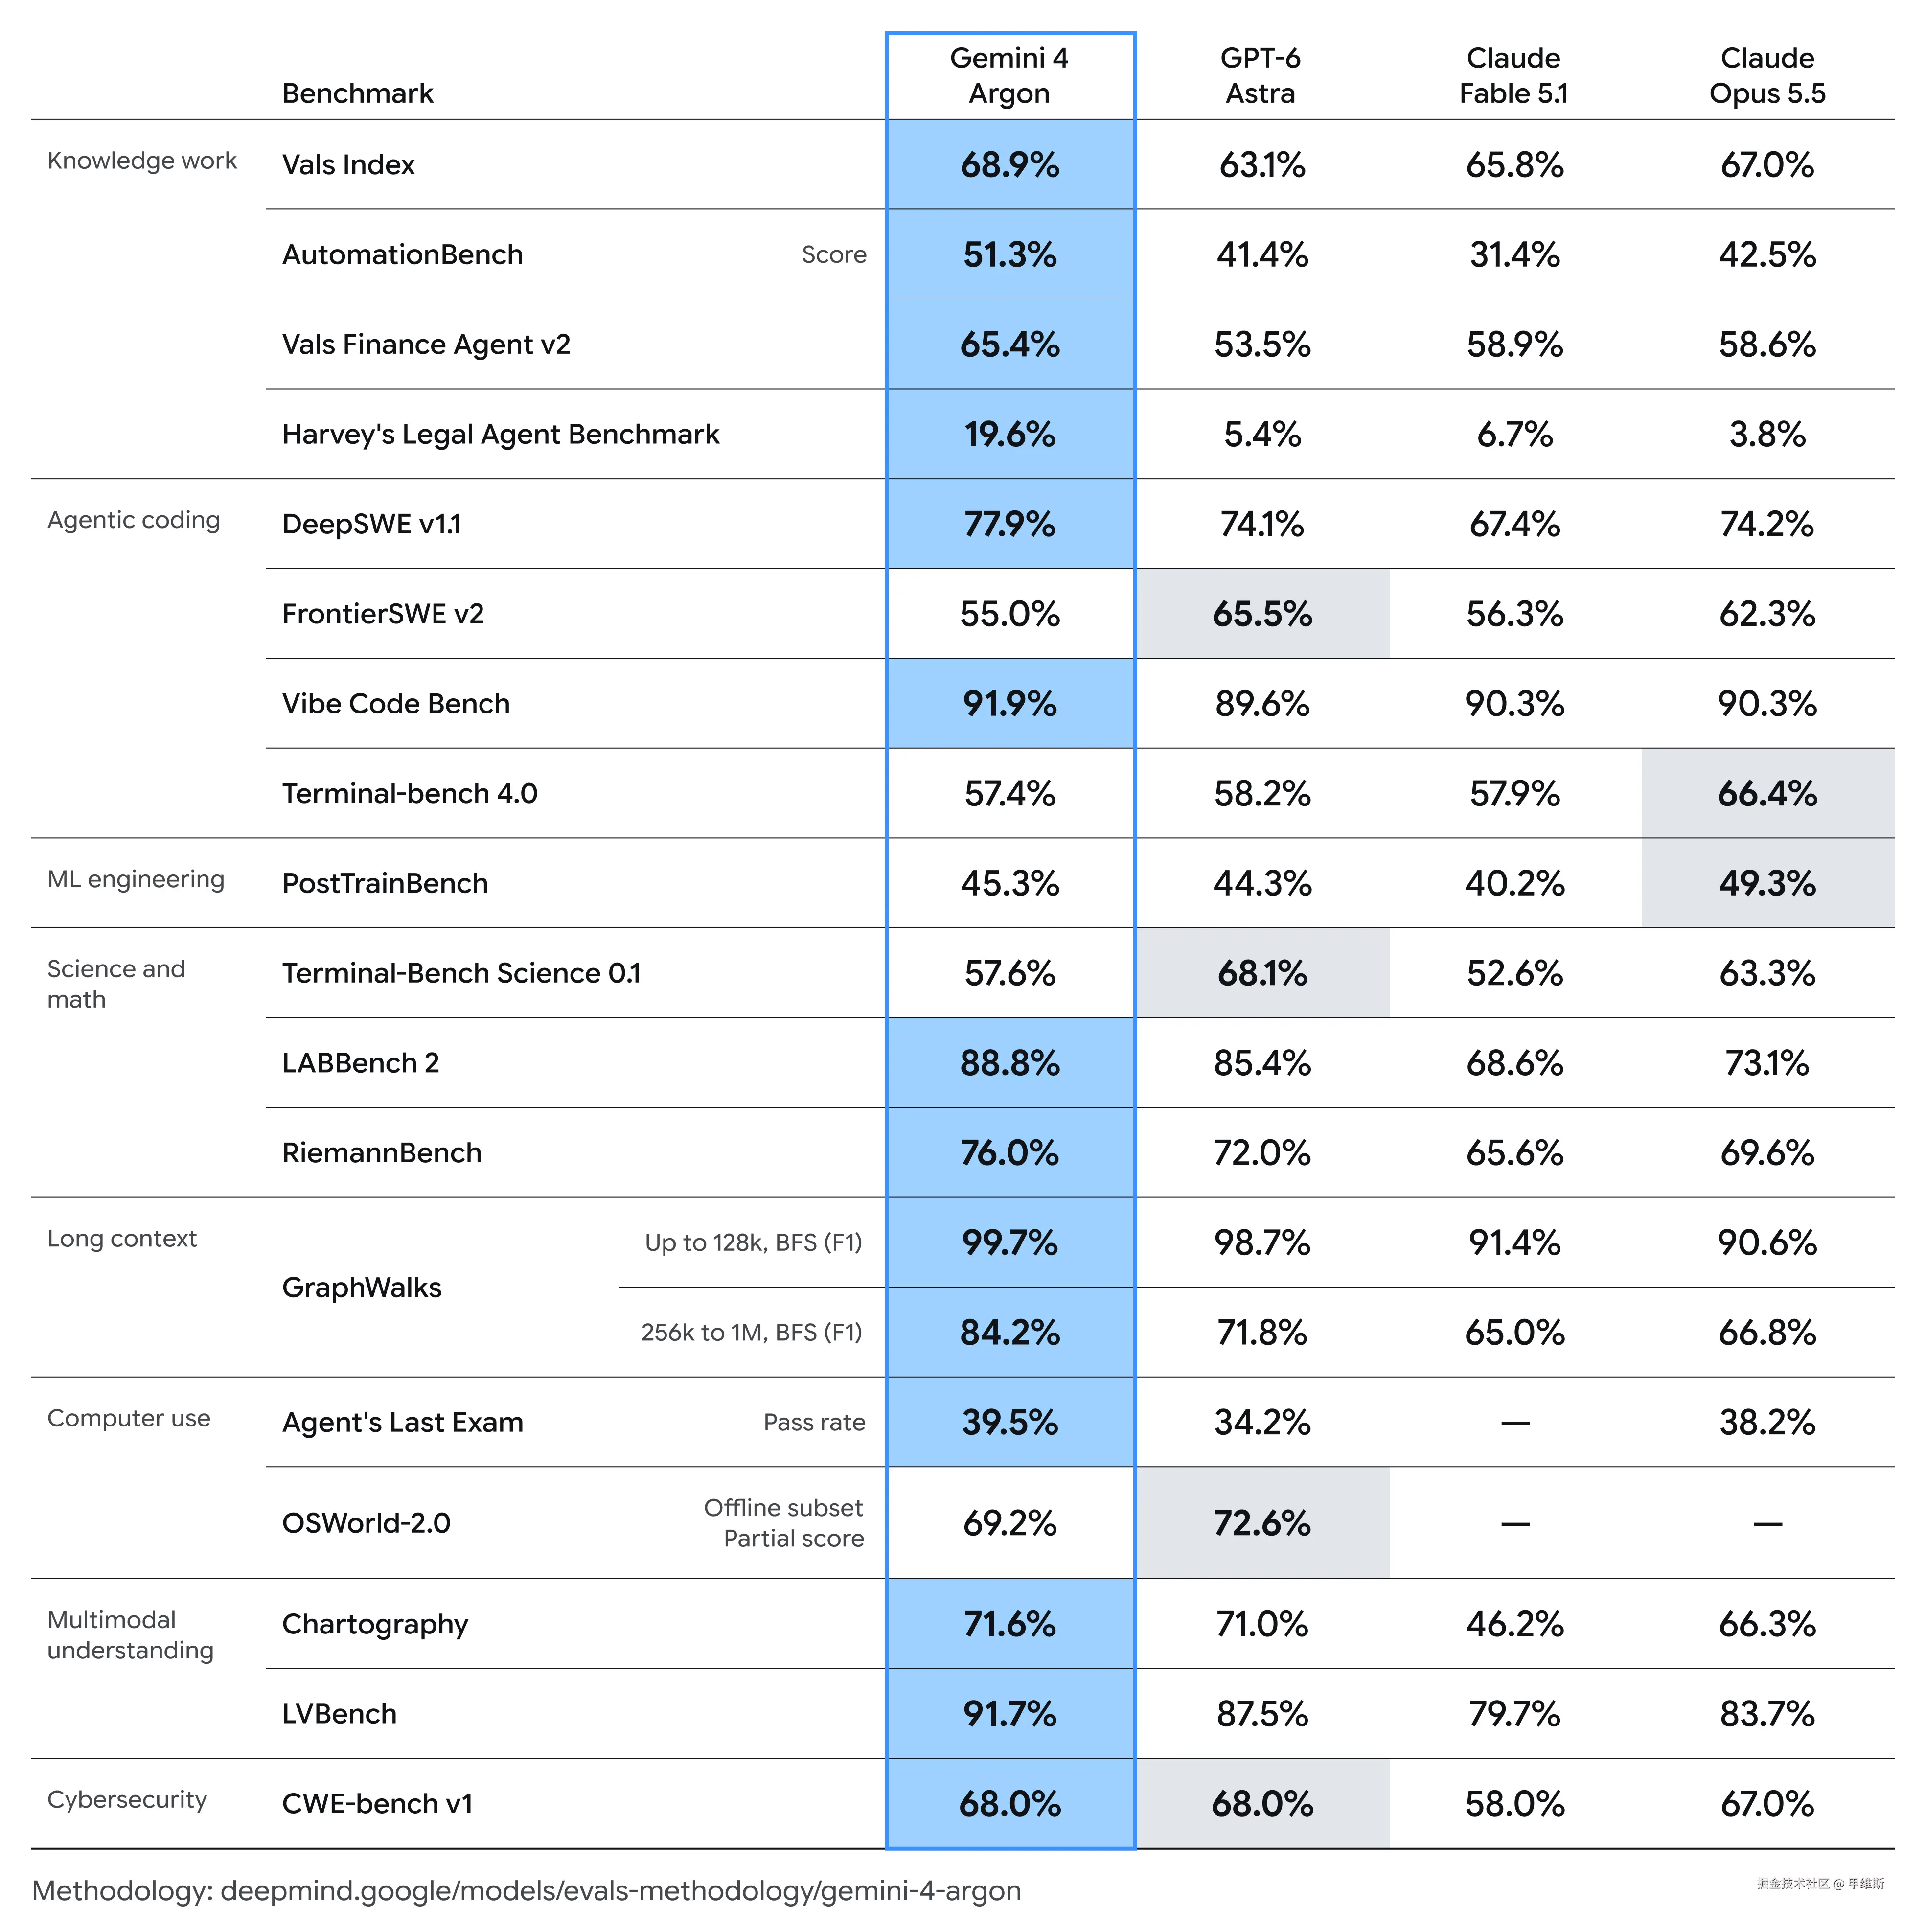
账面数据非常亮眼!
从这个可以看出,"知识工作"方面确实遥遥领先!
编码方面有两项领先,两项落后,所以它的编码能力,并不会太强,但是也不能算很弱。
DeepSWE 这个基准的结果,其实和真实的编码能力是有比较大差距的。我记得 DS 这个基准分都很高,但是实际并不强,Claude 发布的时候都不强调这个基准。 另外还有很多领域基准数据,可以根据上图对号入座。
基准这个东西,可能是有参水的,但是可以作为一个参考!
博客的第二大标题叫"解决复杂的工程任务"。
其中提到了几个例子。
比如理顺自家的 Chrome 浏览器功能代码,Argon 帮助 Chrome 团队将核心网页处理代码从 Chromium 4000 万行代码库中约 600 万行的浏览器功能遗留代码文件夹中分离出来。
比如仅需数小时即可优化生产环境的 Python 代码库。
比如量子化学开源软件包优化。
比如我们的开源 Gemma 模型速度提升近三倍。
这些内容专业性还是比较强的,属于秀肌肉,但是大家不一定有直观感受。
下面来说说一个很直观的例子:实现复杂的 3D 可视化
这也是这次谷歌重点强调的一部分。
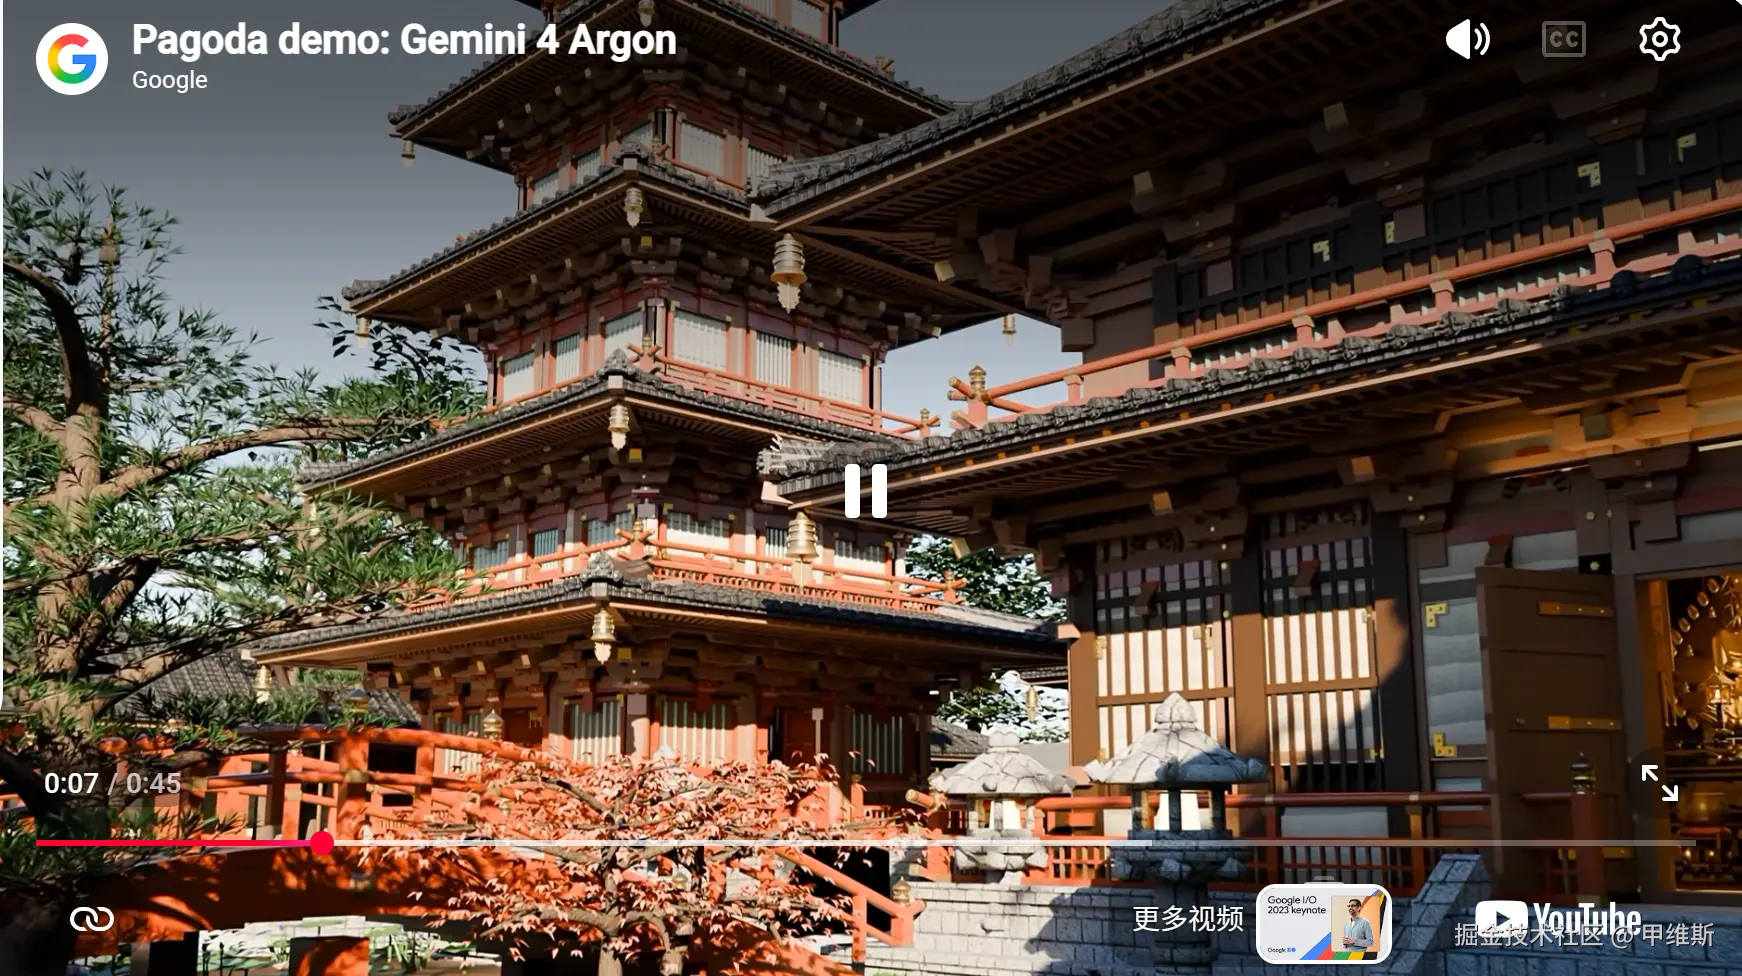
构建高精度的宝塔模型,就是他们官方主推的例子。
根据描述,G4 在 Blender 中自主地雕刻出了一个包含多座建筑的寺庙群,并实现了逼真的建筑、植被和光照效果。
还有一个例子是在桌面上创建一个 3D 的赛道,小车可以跑在这个赛道上,看起来很有创意。
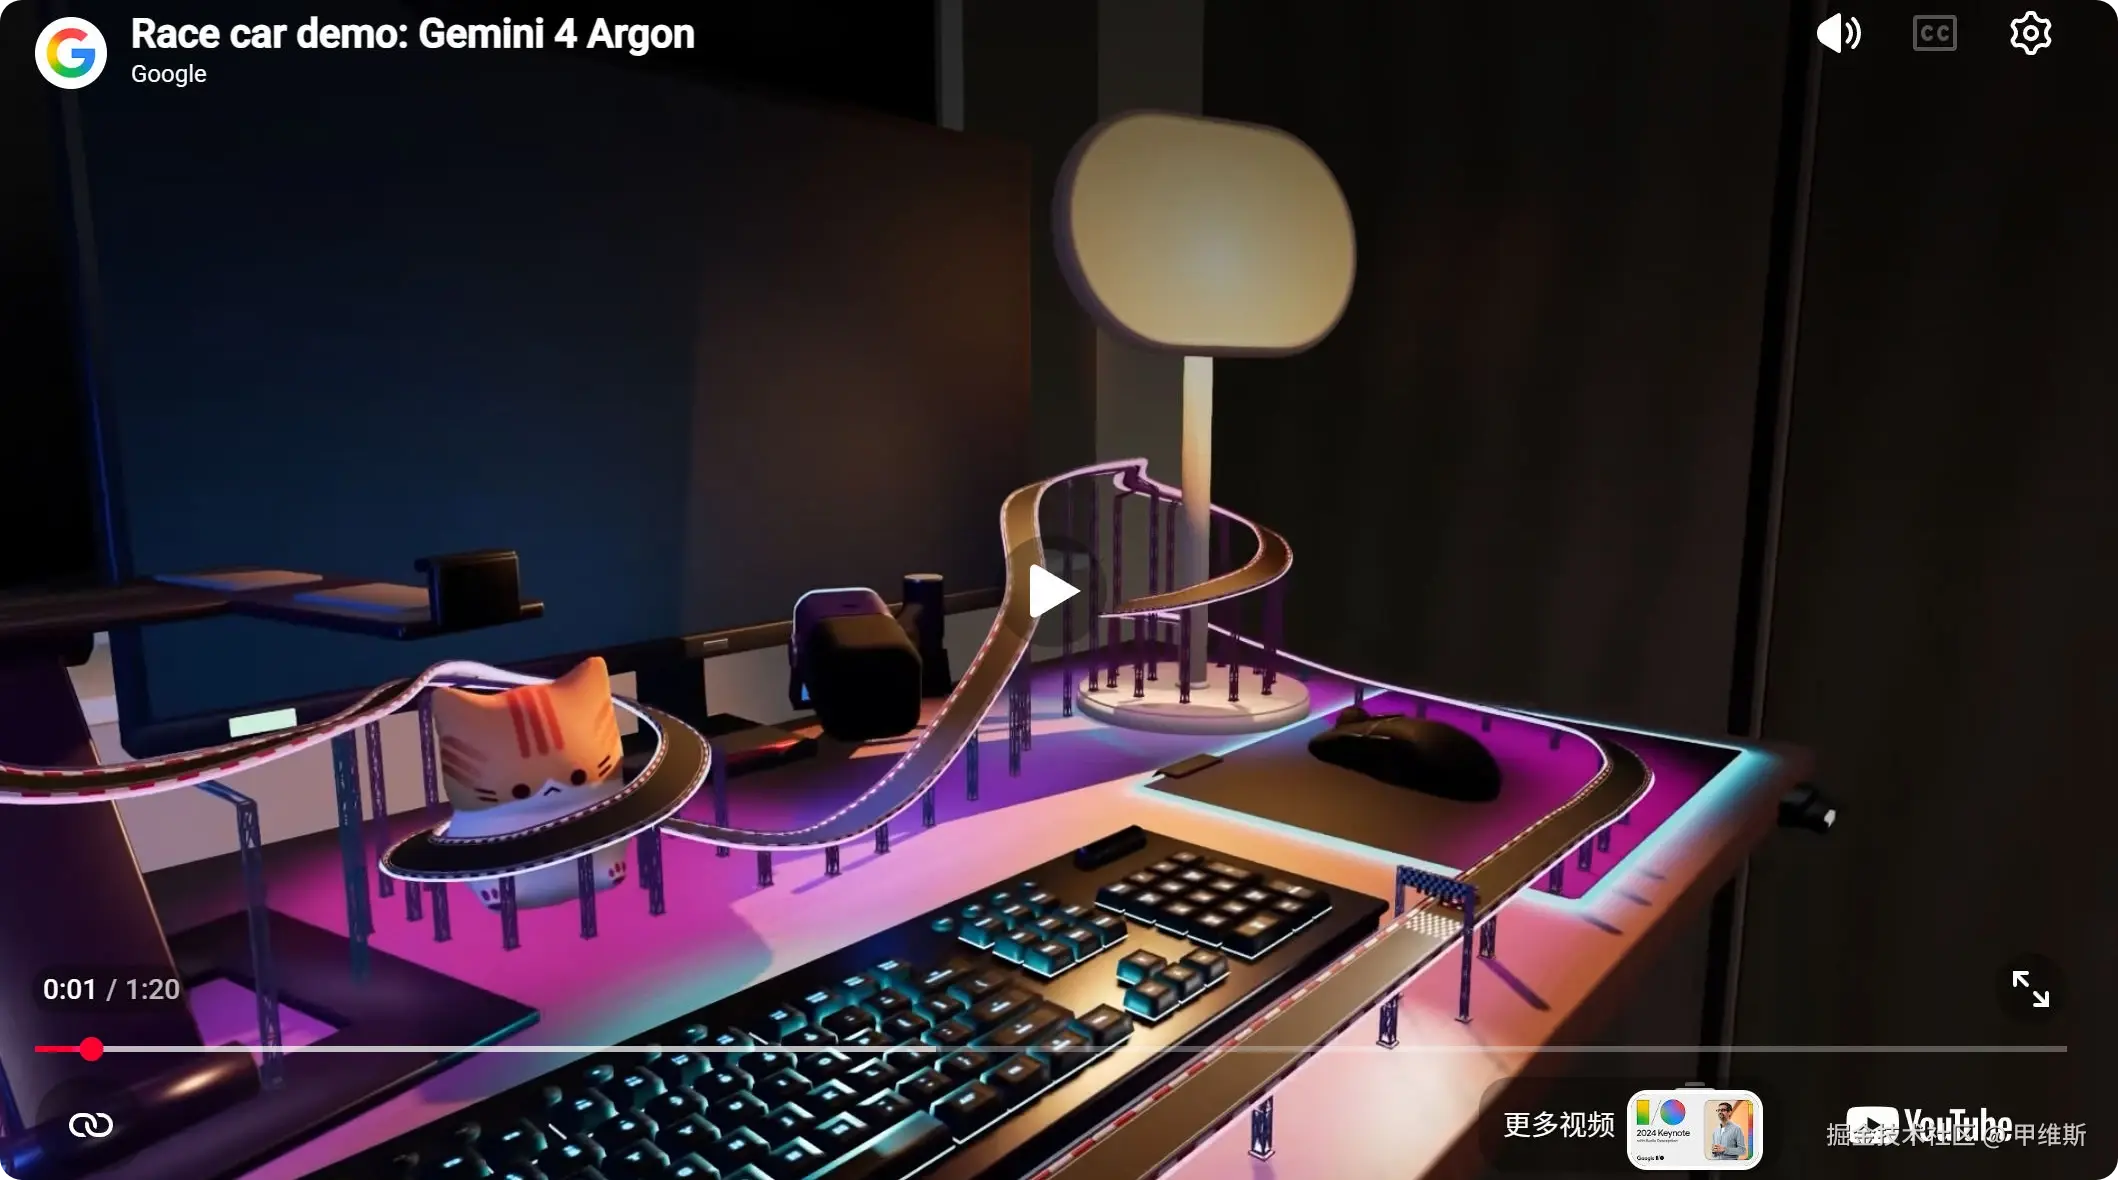
使用 Antigravity+Argon,将一张真实办公桌的照片转换成了一款可玩的微型赛车游戏。办公桌、房间和赛道的建模和碰撞检测均使用 Blender MCP 完成,纹理贴图使用 Nano Banana,物理引擎、自定义着色器和汽车引擎音效则通过 Three.js 中的 Gemini Omni Flash 实现。
这个例子我感觉 Opus 能做得更好,但是谷歌展示了一个非常全面的流程。
智能体 Anti+建模软件 Blender+贴图 Banana+物理引擎 three.js+音色 Omni!
如果要快速制作这种在线网页或者游戏,可以参考一下这个组合!
另外还举了一个 3D 象棋、3D 光线追踪引擎、3D 场景等例子。 这些例子看起来都不错,但是以我的见闻来看,并不算特别出众。
还有一个看起来很庞大的项目:
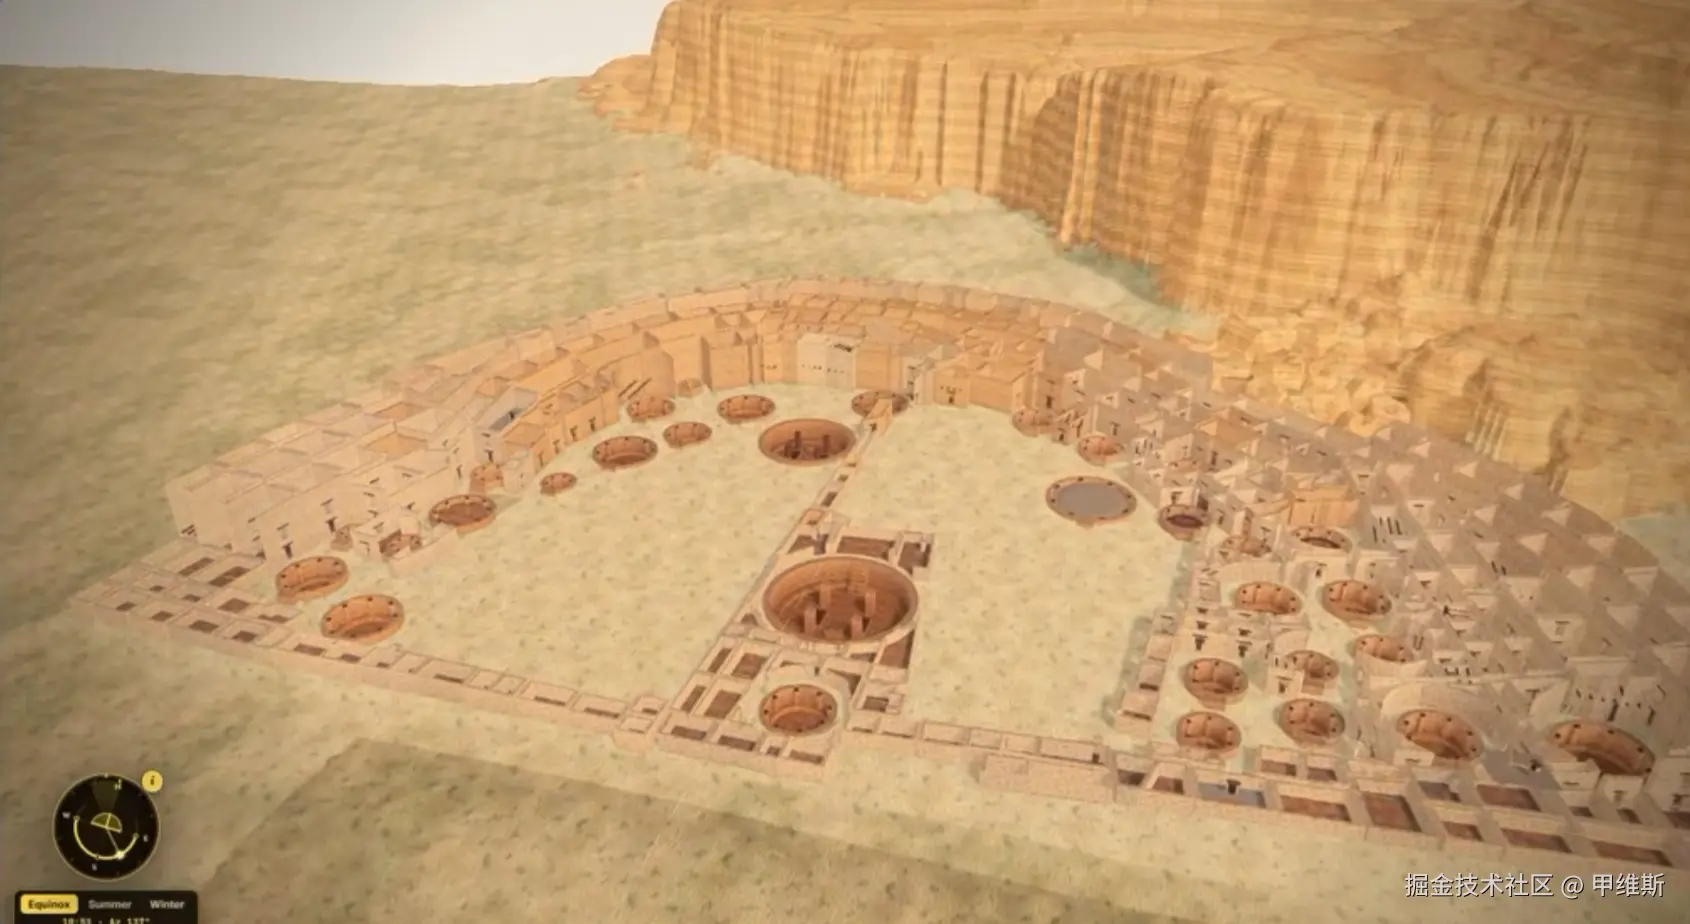
Argon 整合约 50 GB 的机载激光雷达扫描数据、GIS 房间矢量图、美国国会图书馆 CAD 图纸和美国国家公园管理局(NPS)档案,重建查科峡谷的 3D 模型,将零散的考古记录转化为可探索的数字遗产。
看起来非常不错,建模质量其实一般!
大概看了下,以目前主流的水准来说,确实应该在 top3 了,但是 GPT-6 和 Claude 5.5 也很强。实战能力,还是得实测。
官方博客还有很多细节,有些是细分领域的,大众可能不关心,但是专业人士会比较感兴趣。
具体内容可以参见:
上面是官方发布的信息,然后再看两个第三方的榜单吧!
竞技场的 Text 榜单:
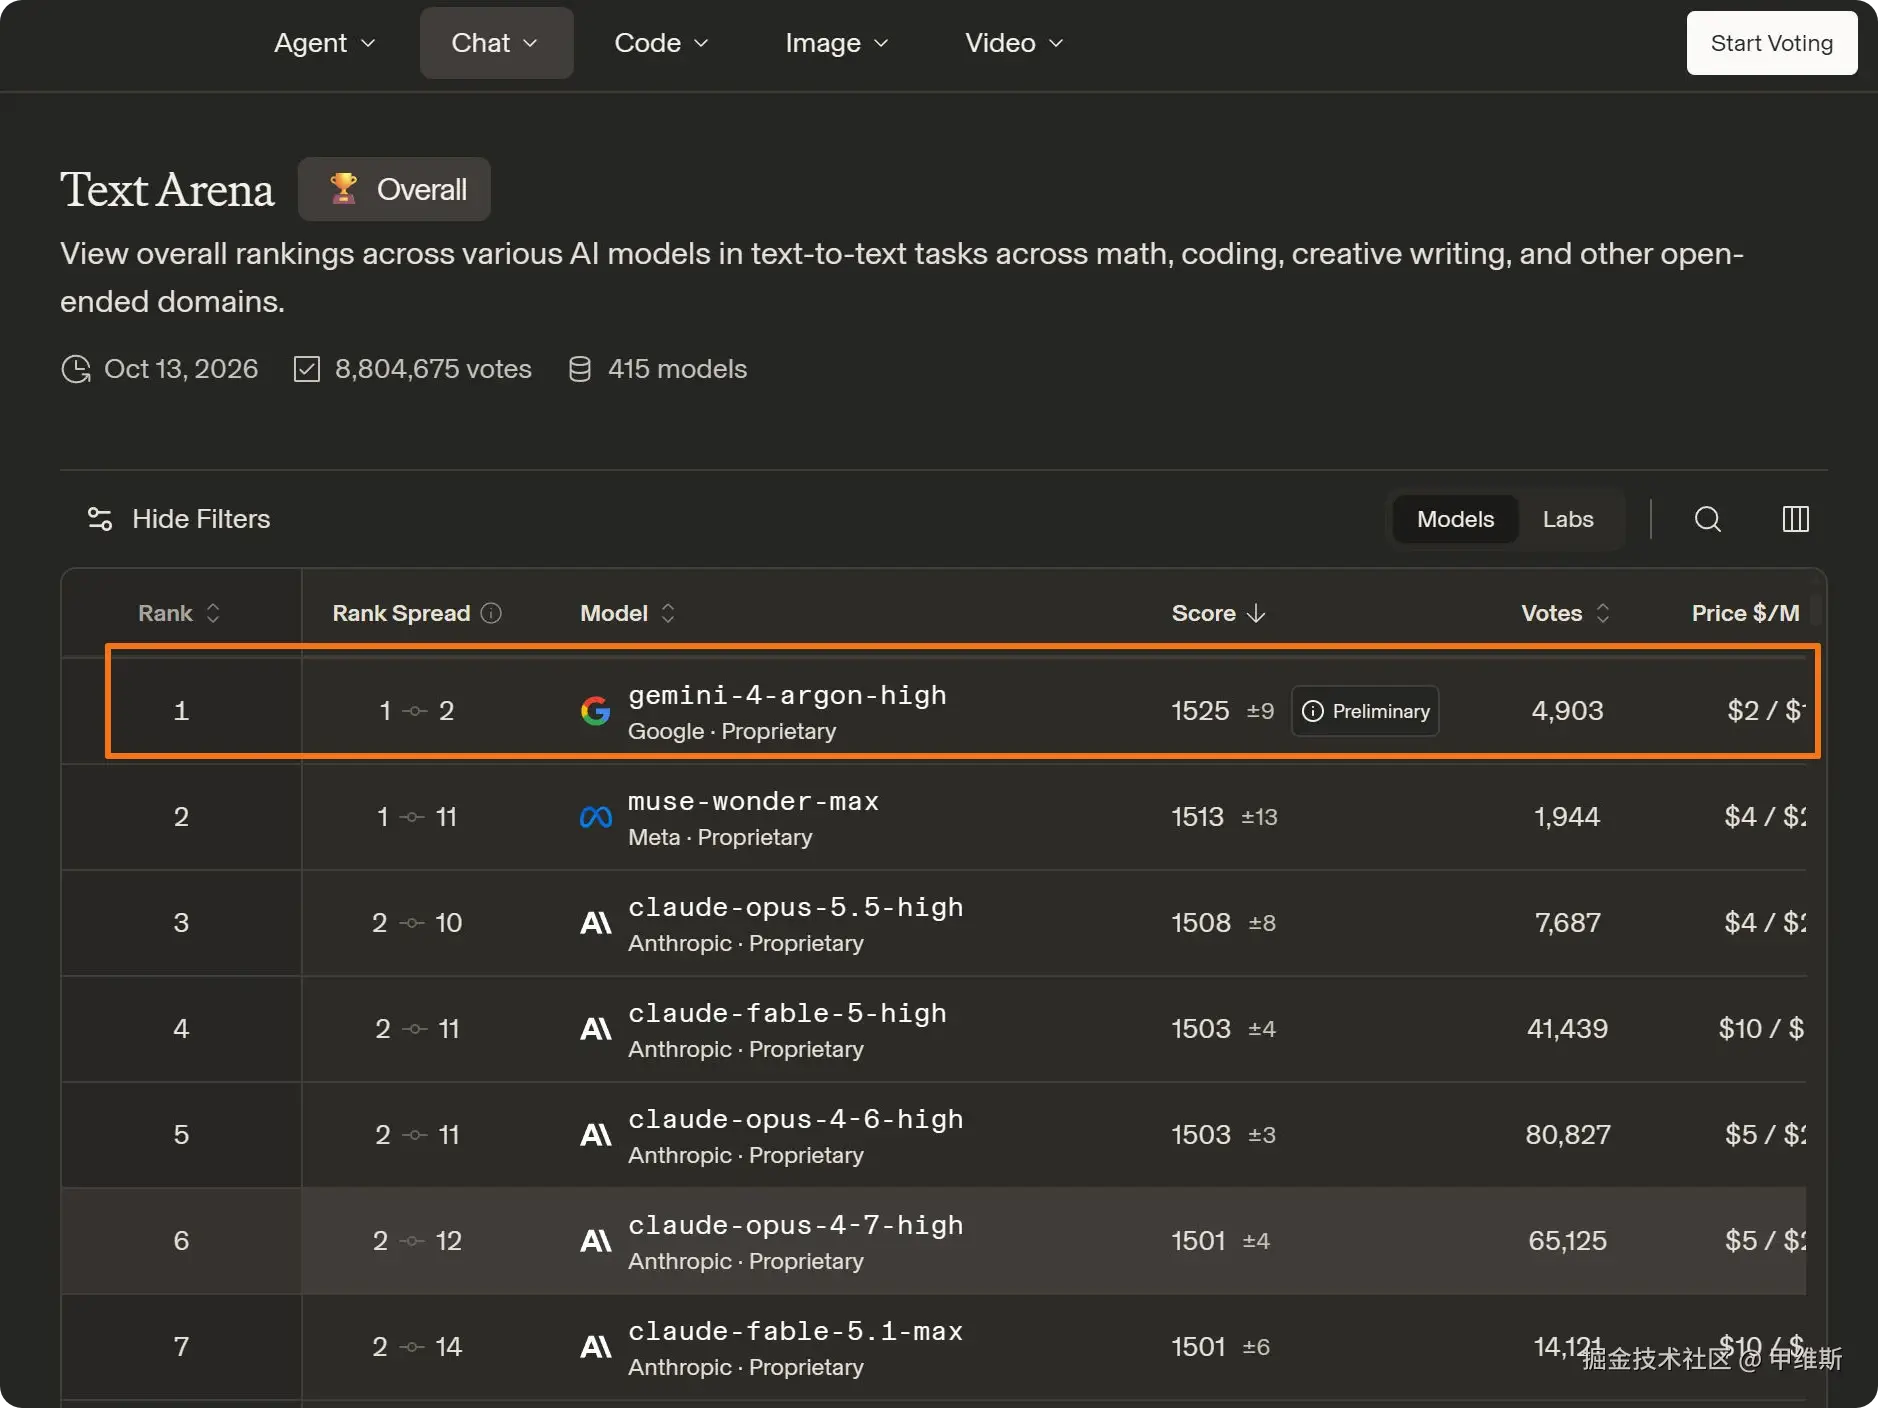
谷歌这个直接拿下第一名,第二名是 Meta 的 Muse。 这一部分主要是传统意义的对话(Chat)部分。因为这两家大厂都有大量的对话场景。所以做到第一,也不意外。
这是竞技场的编码排名:
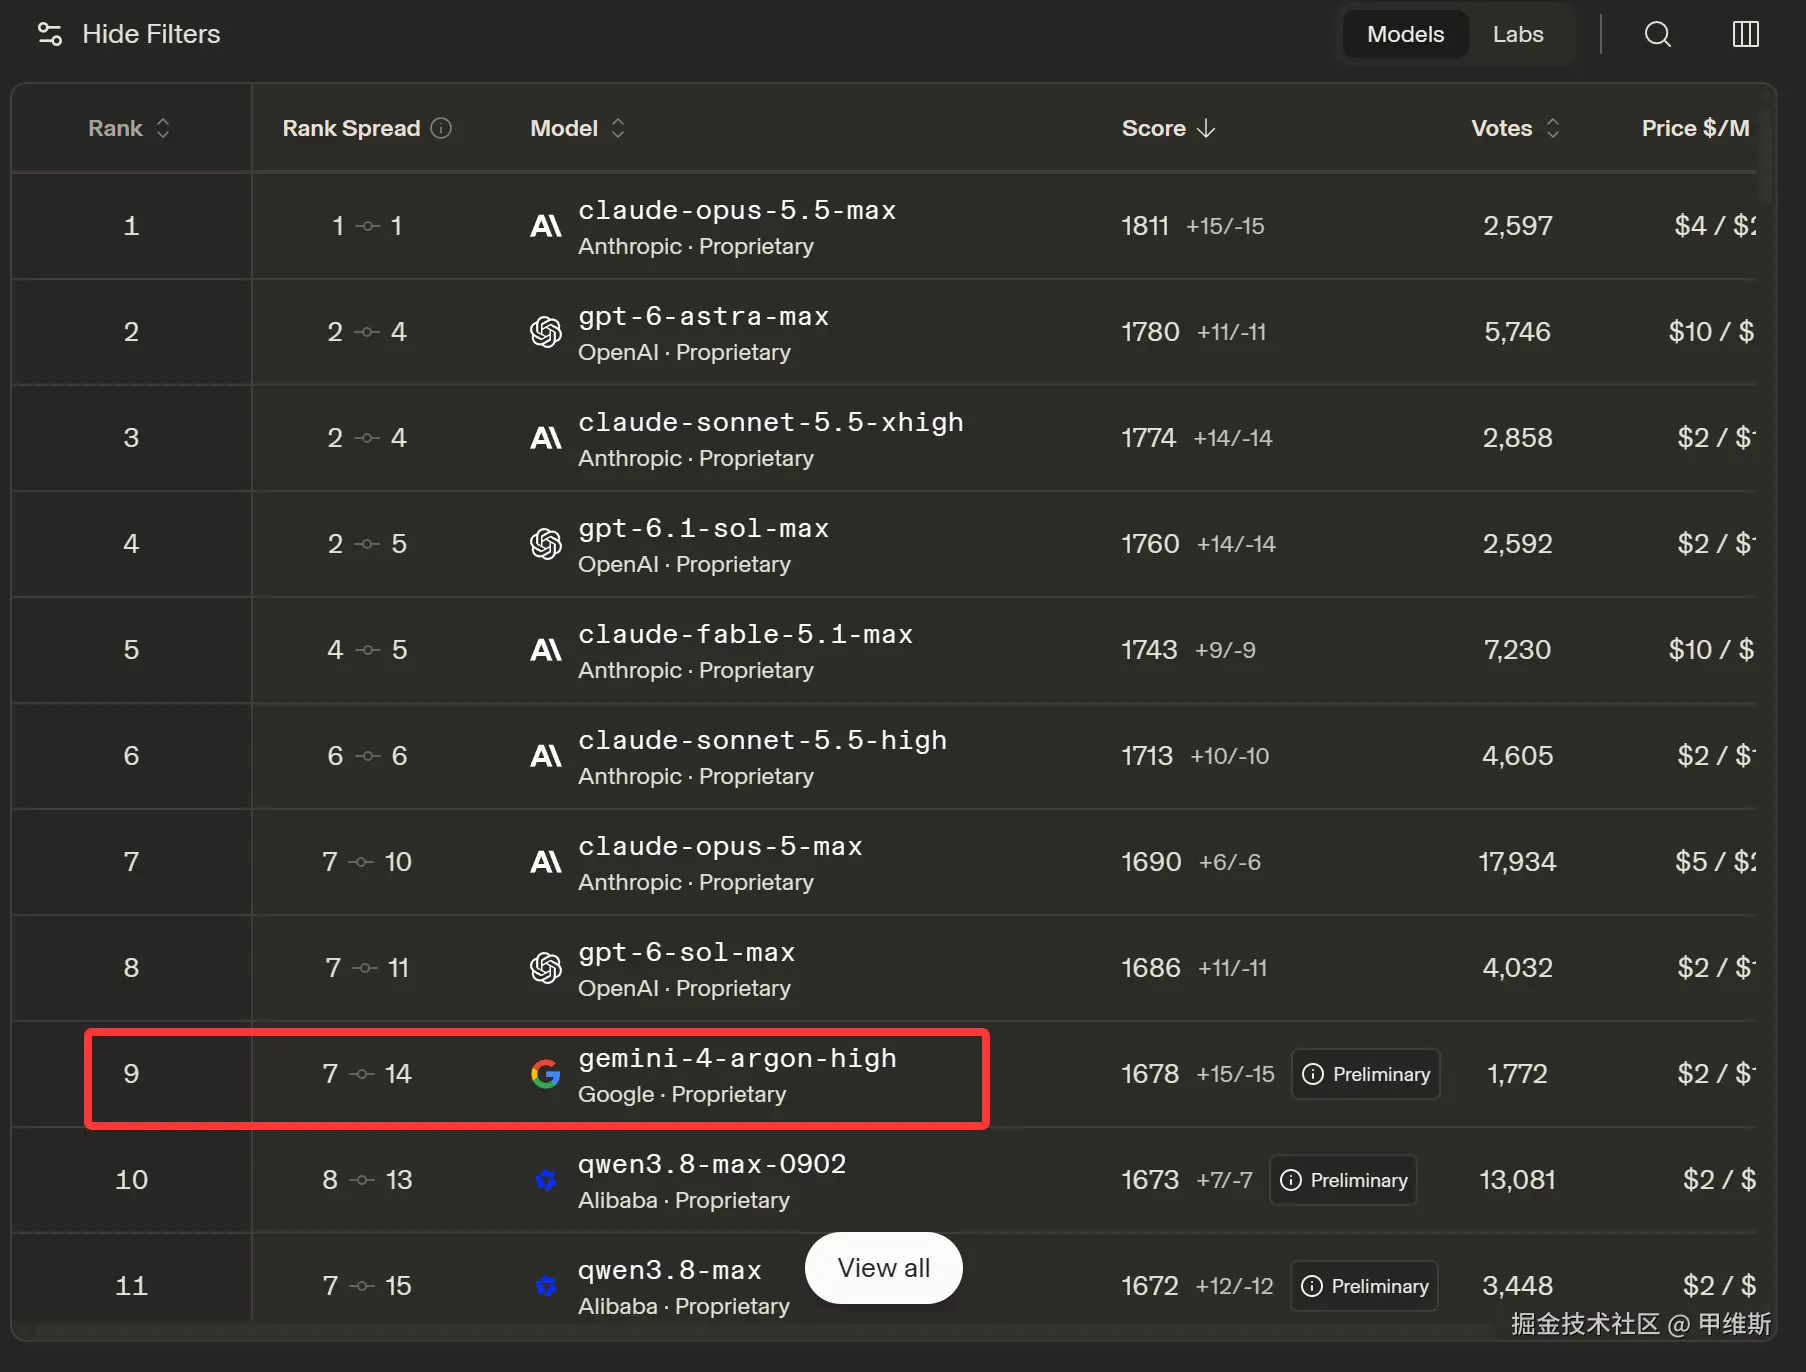
现在 top10 基本上被 Claude、GPT、Gemini 包圆了。 这次 G4 搞了个第九名。从大的角度来看,国产垫底,国际前三了。
竞技场的智能体排名:
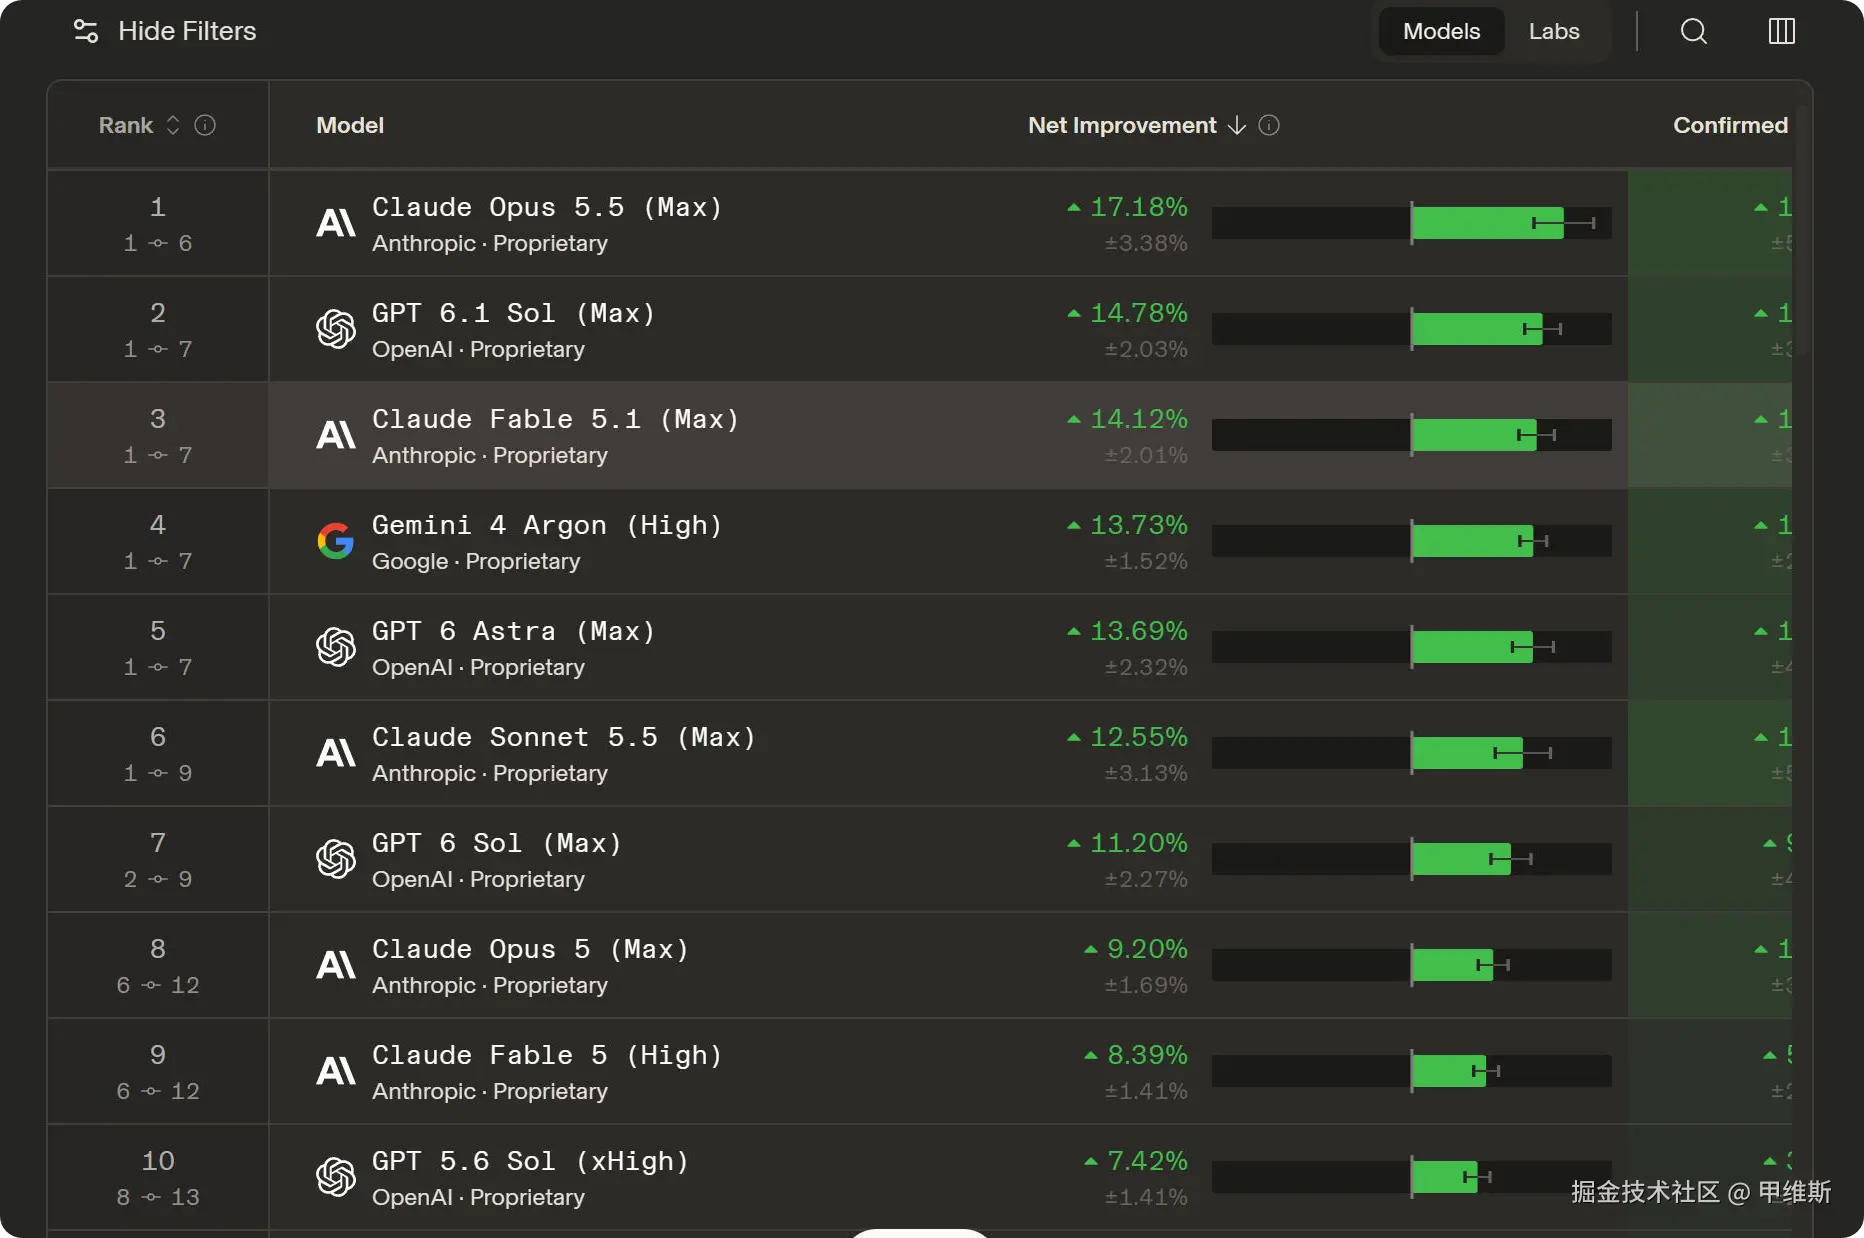
这个榜单中排名来到了第四名。 已经排到 GPT-6 Astra 和 Sonnet5.5 前面了。 谷歌模型的智能体能力其实一直不太行,Flash 特别喜欢一轮对话搞定。这次的旗舰模型,终于在智能体方面有了一些提升。
单从这些排名看,有很强的地方,整体也不差。
但是竞技场的排名历来都是受情绪波动的。新上的模型都会上浮一些。
下面看一下 AA 的智能排名:
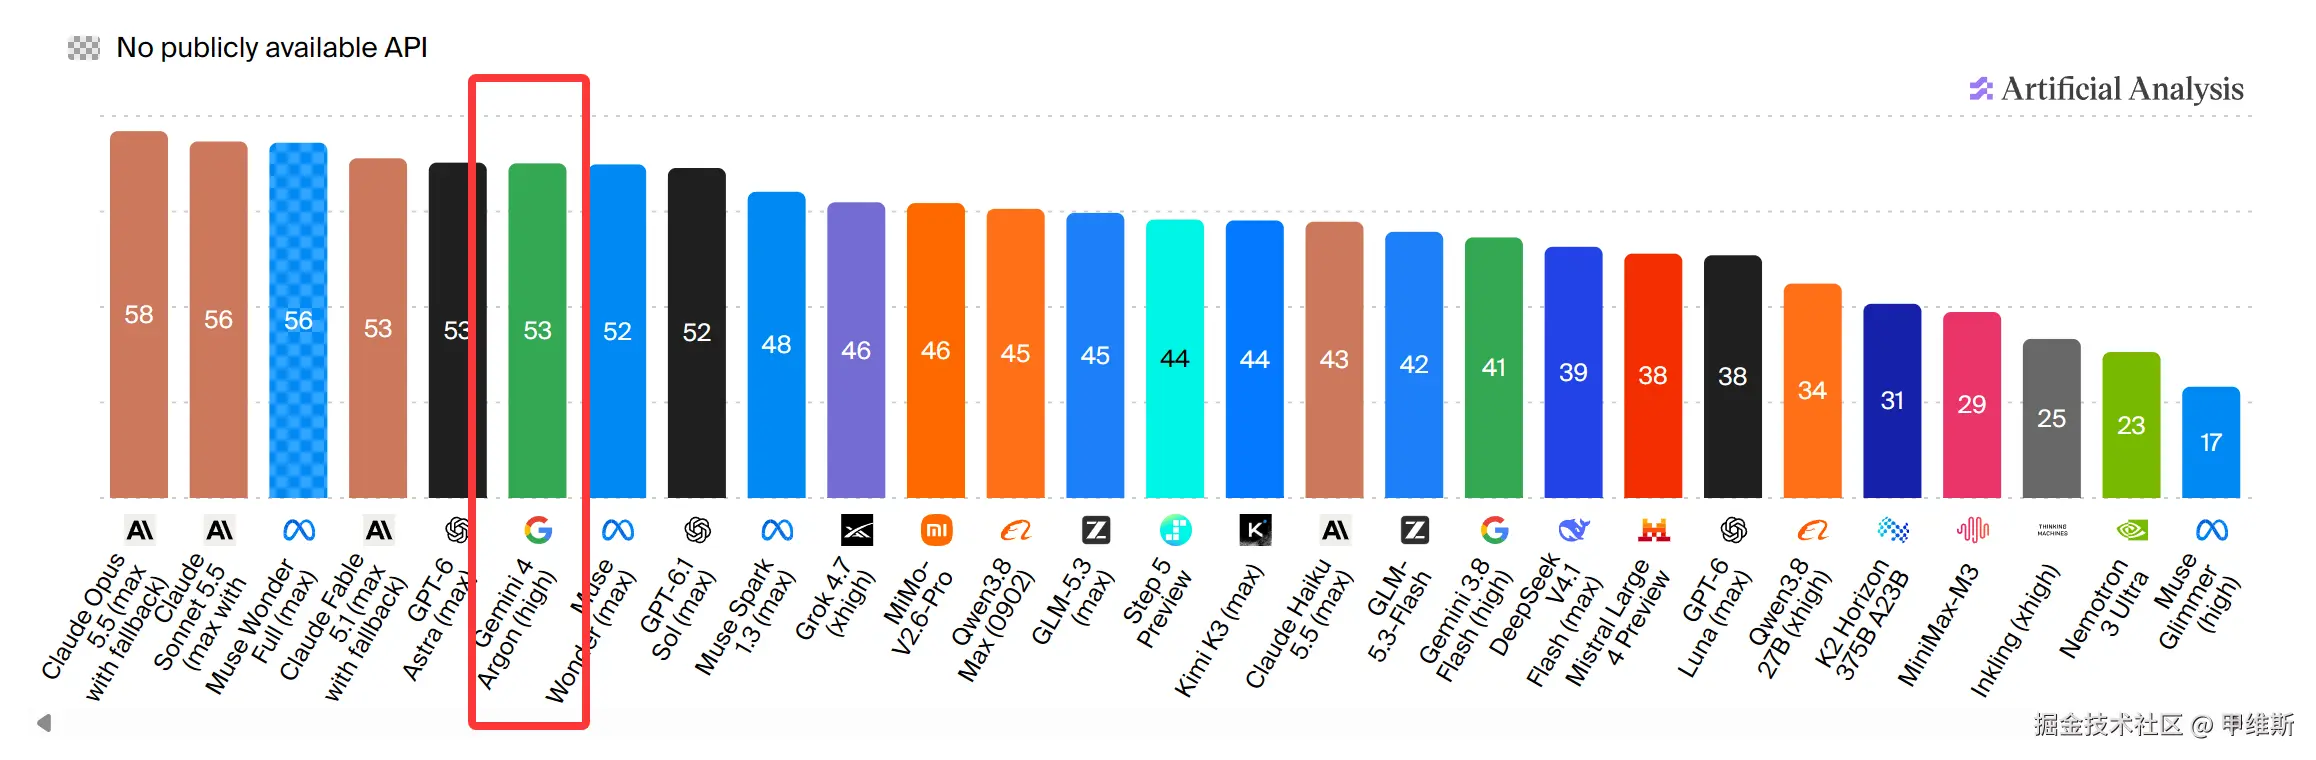
这名次也算不错了,排在 Astra 后面,Muse 前面。
最后放一张性价比的图:
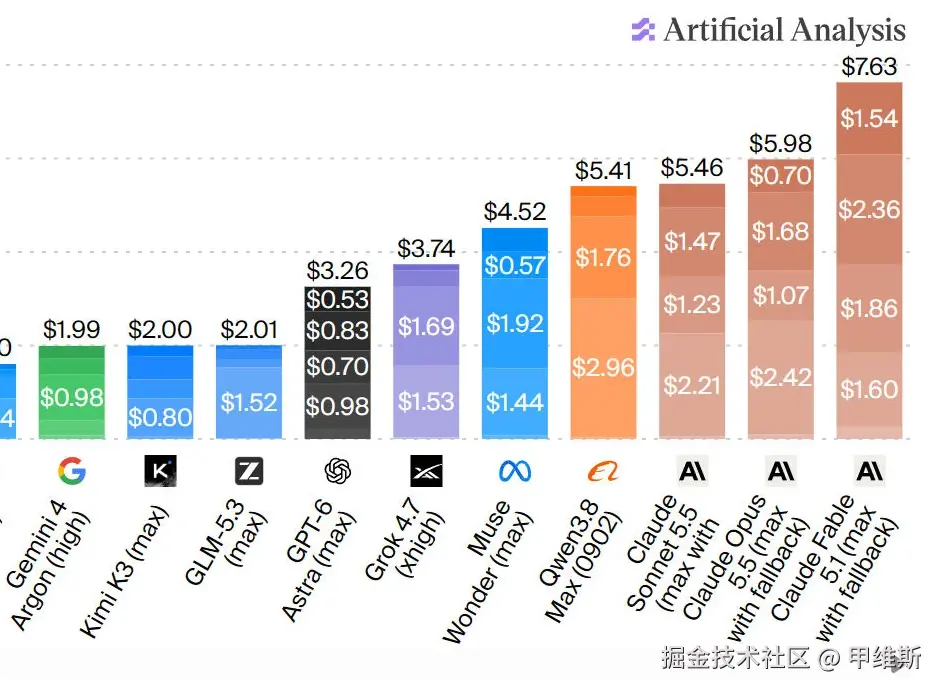
最左边的是 G4,单任务消耗要比 K3、GLM5.3、Grok 4.7、Qwen3.8 这些都低!
从自己的描述,以及第三方榜单来说,这绝对不算差了。以品牌区分的话,基本上都在 top3 里面了。
情况就是这个情况了。下面我们就上手试一下。
测试结果
我们先来看一下,比较考验创意、审美、空间感的题目《赛博朋克版清明上河图》!
结果如下:
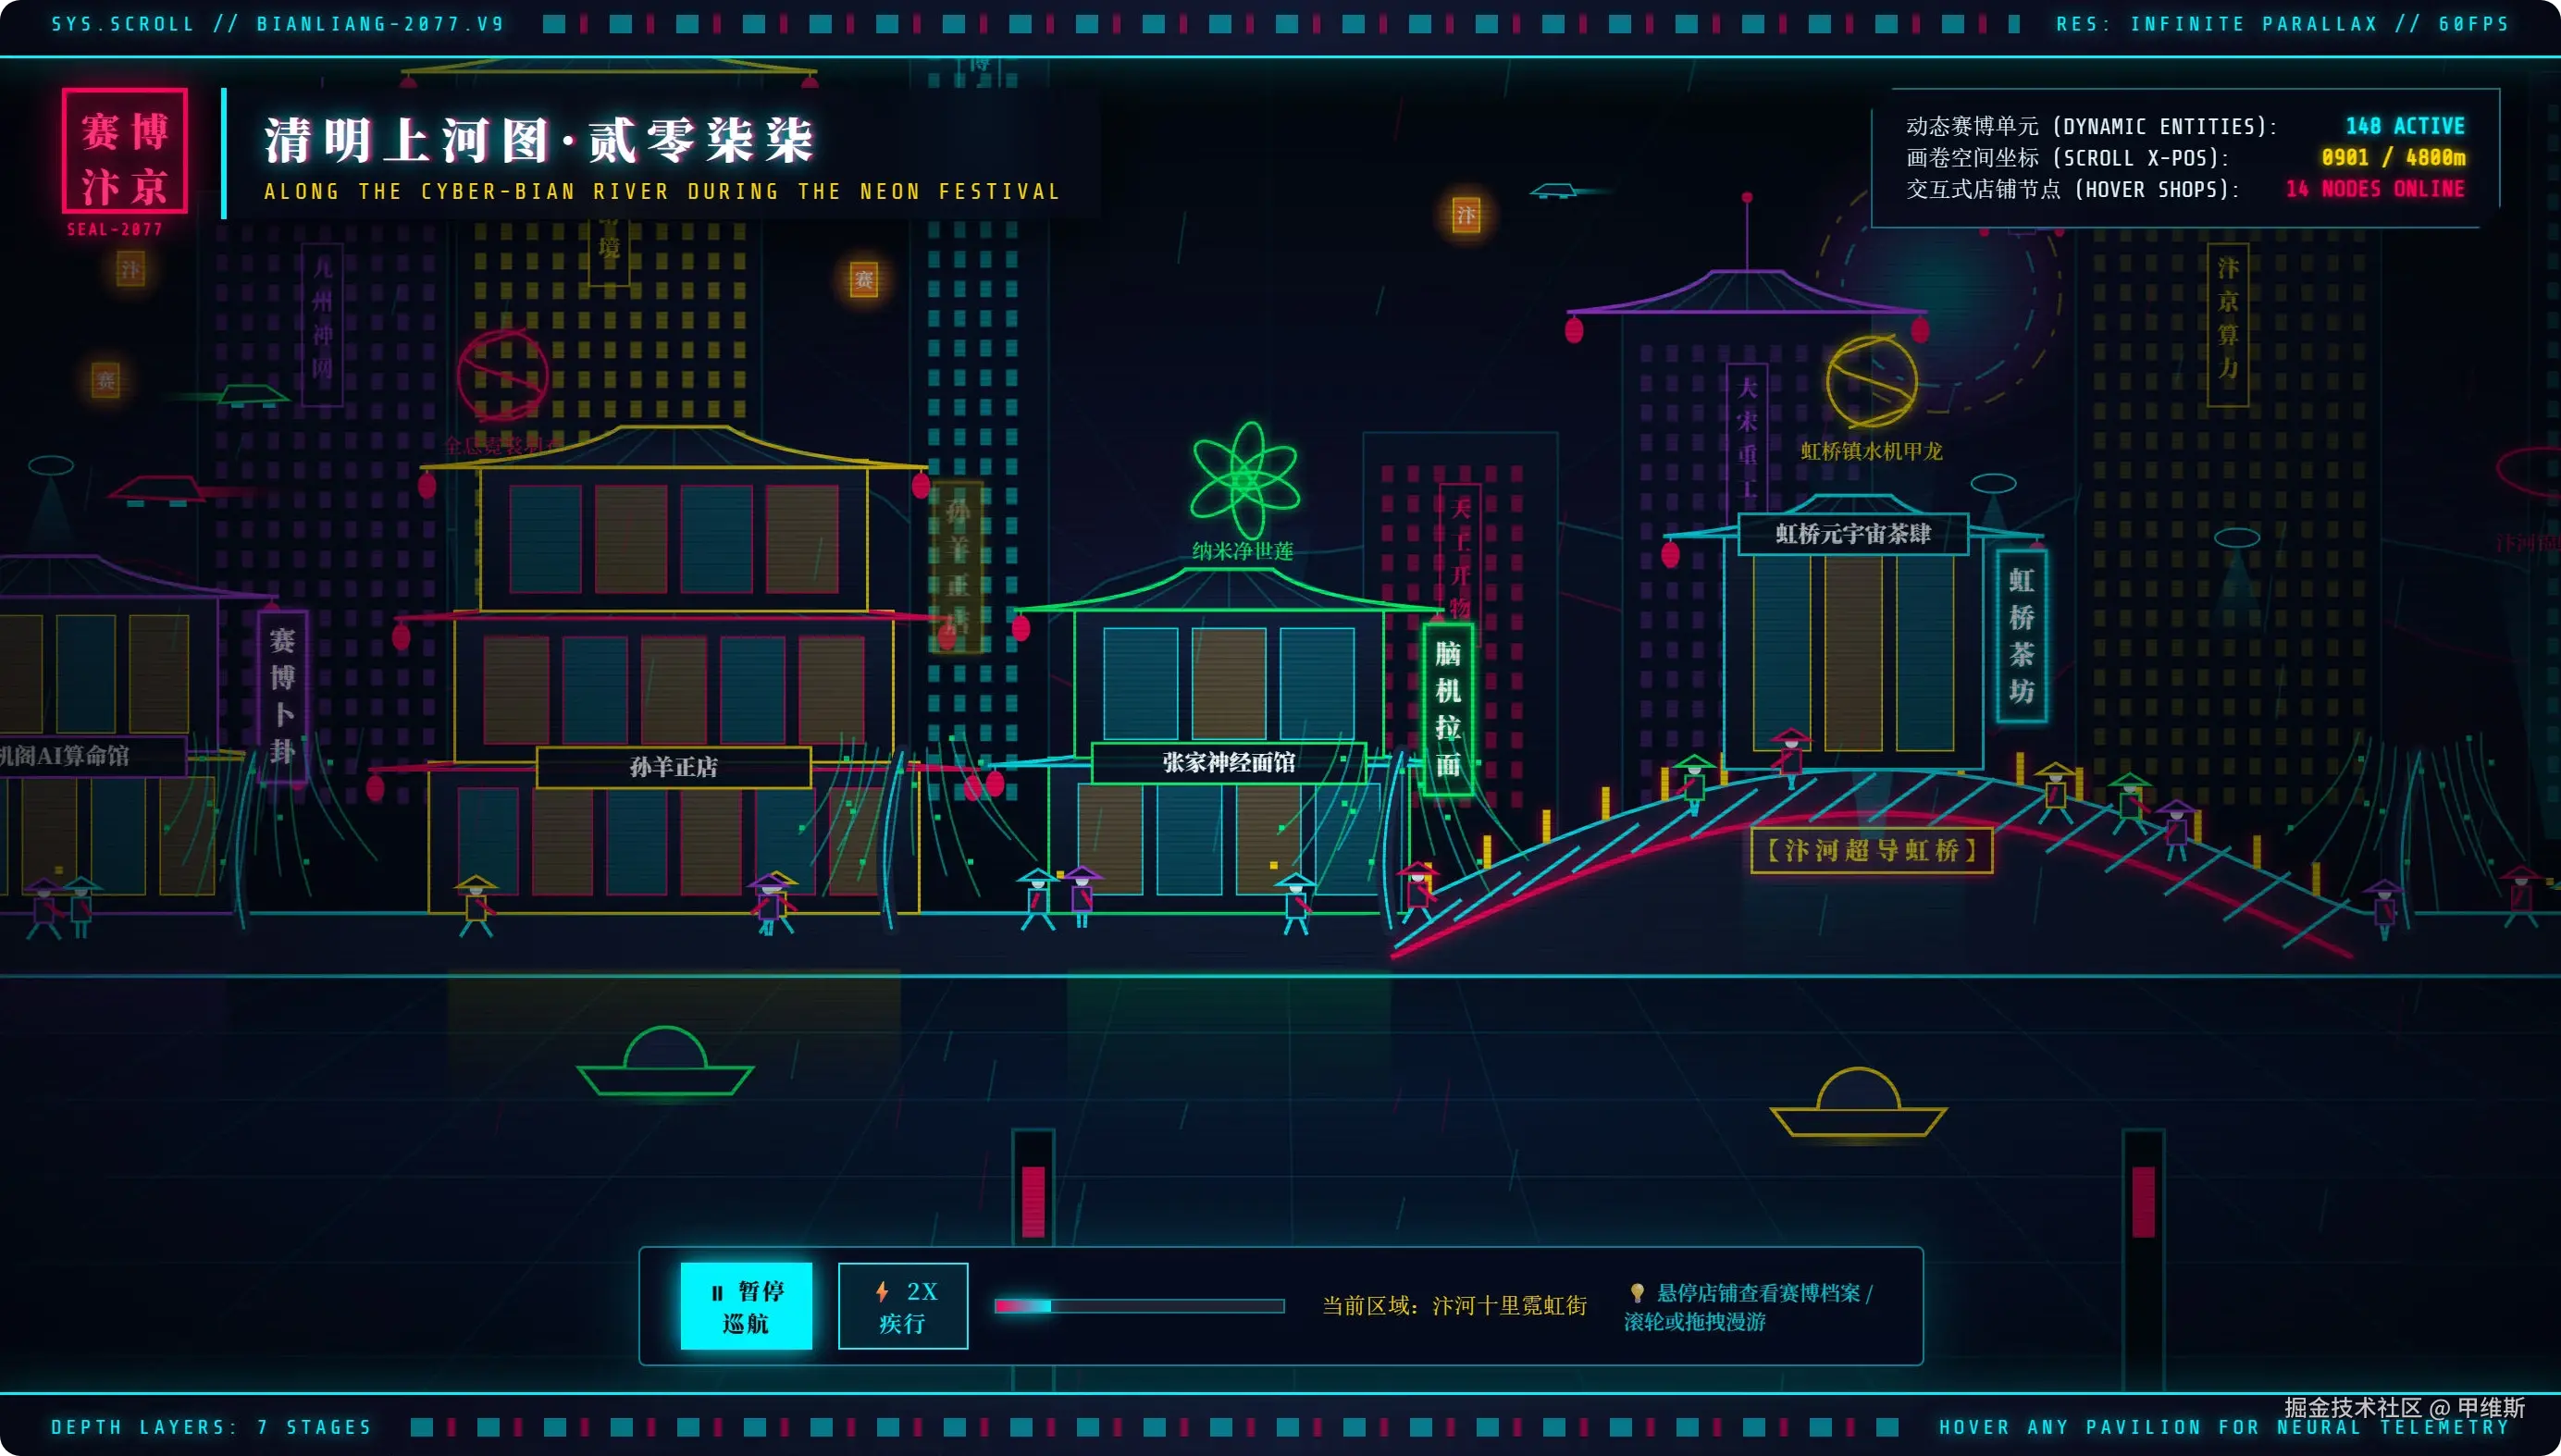
这个我有点难评!
好像该有的也有,空间感么也有一些,但是吧,就是感觉很简陋,全是线条为主。河面细节、桥的摆放这些细节都是有问题的!
这个比自家 Flash 好了一些,比 GPT-6 Luna 好一些,但是和同样的旗舰模型 GPT-6 Astra 和 Claude Opus 5.5 还是没法比的!
纵观我测试过的所有模型来说,不能特别算差,但是很难说好。
接下来看第二个例子,天文机械表。
效果如下:
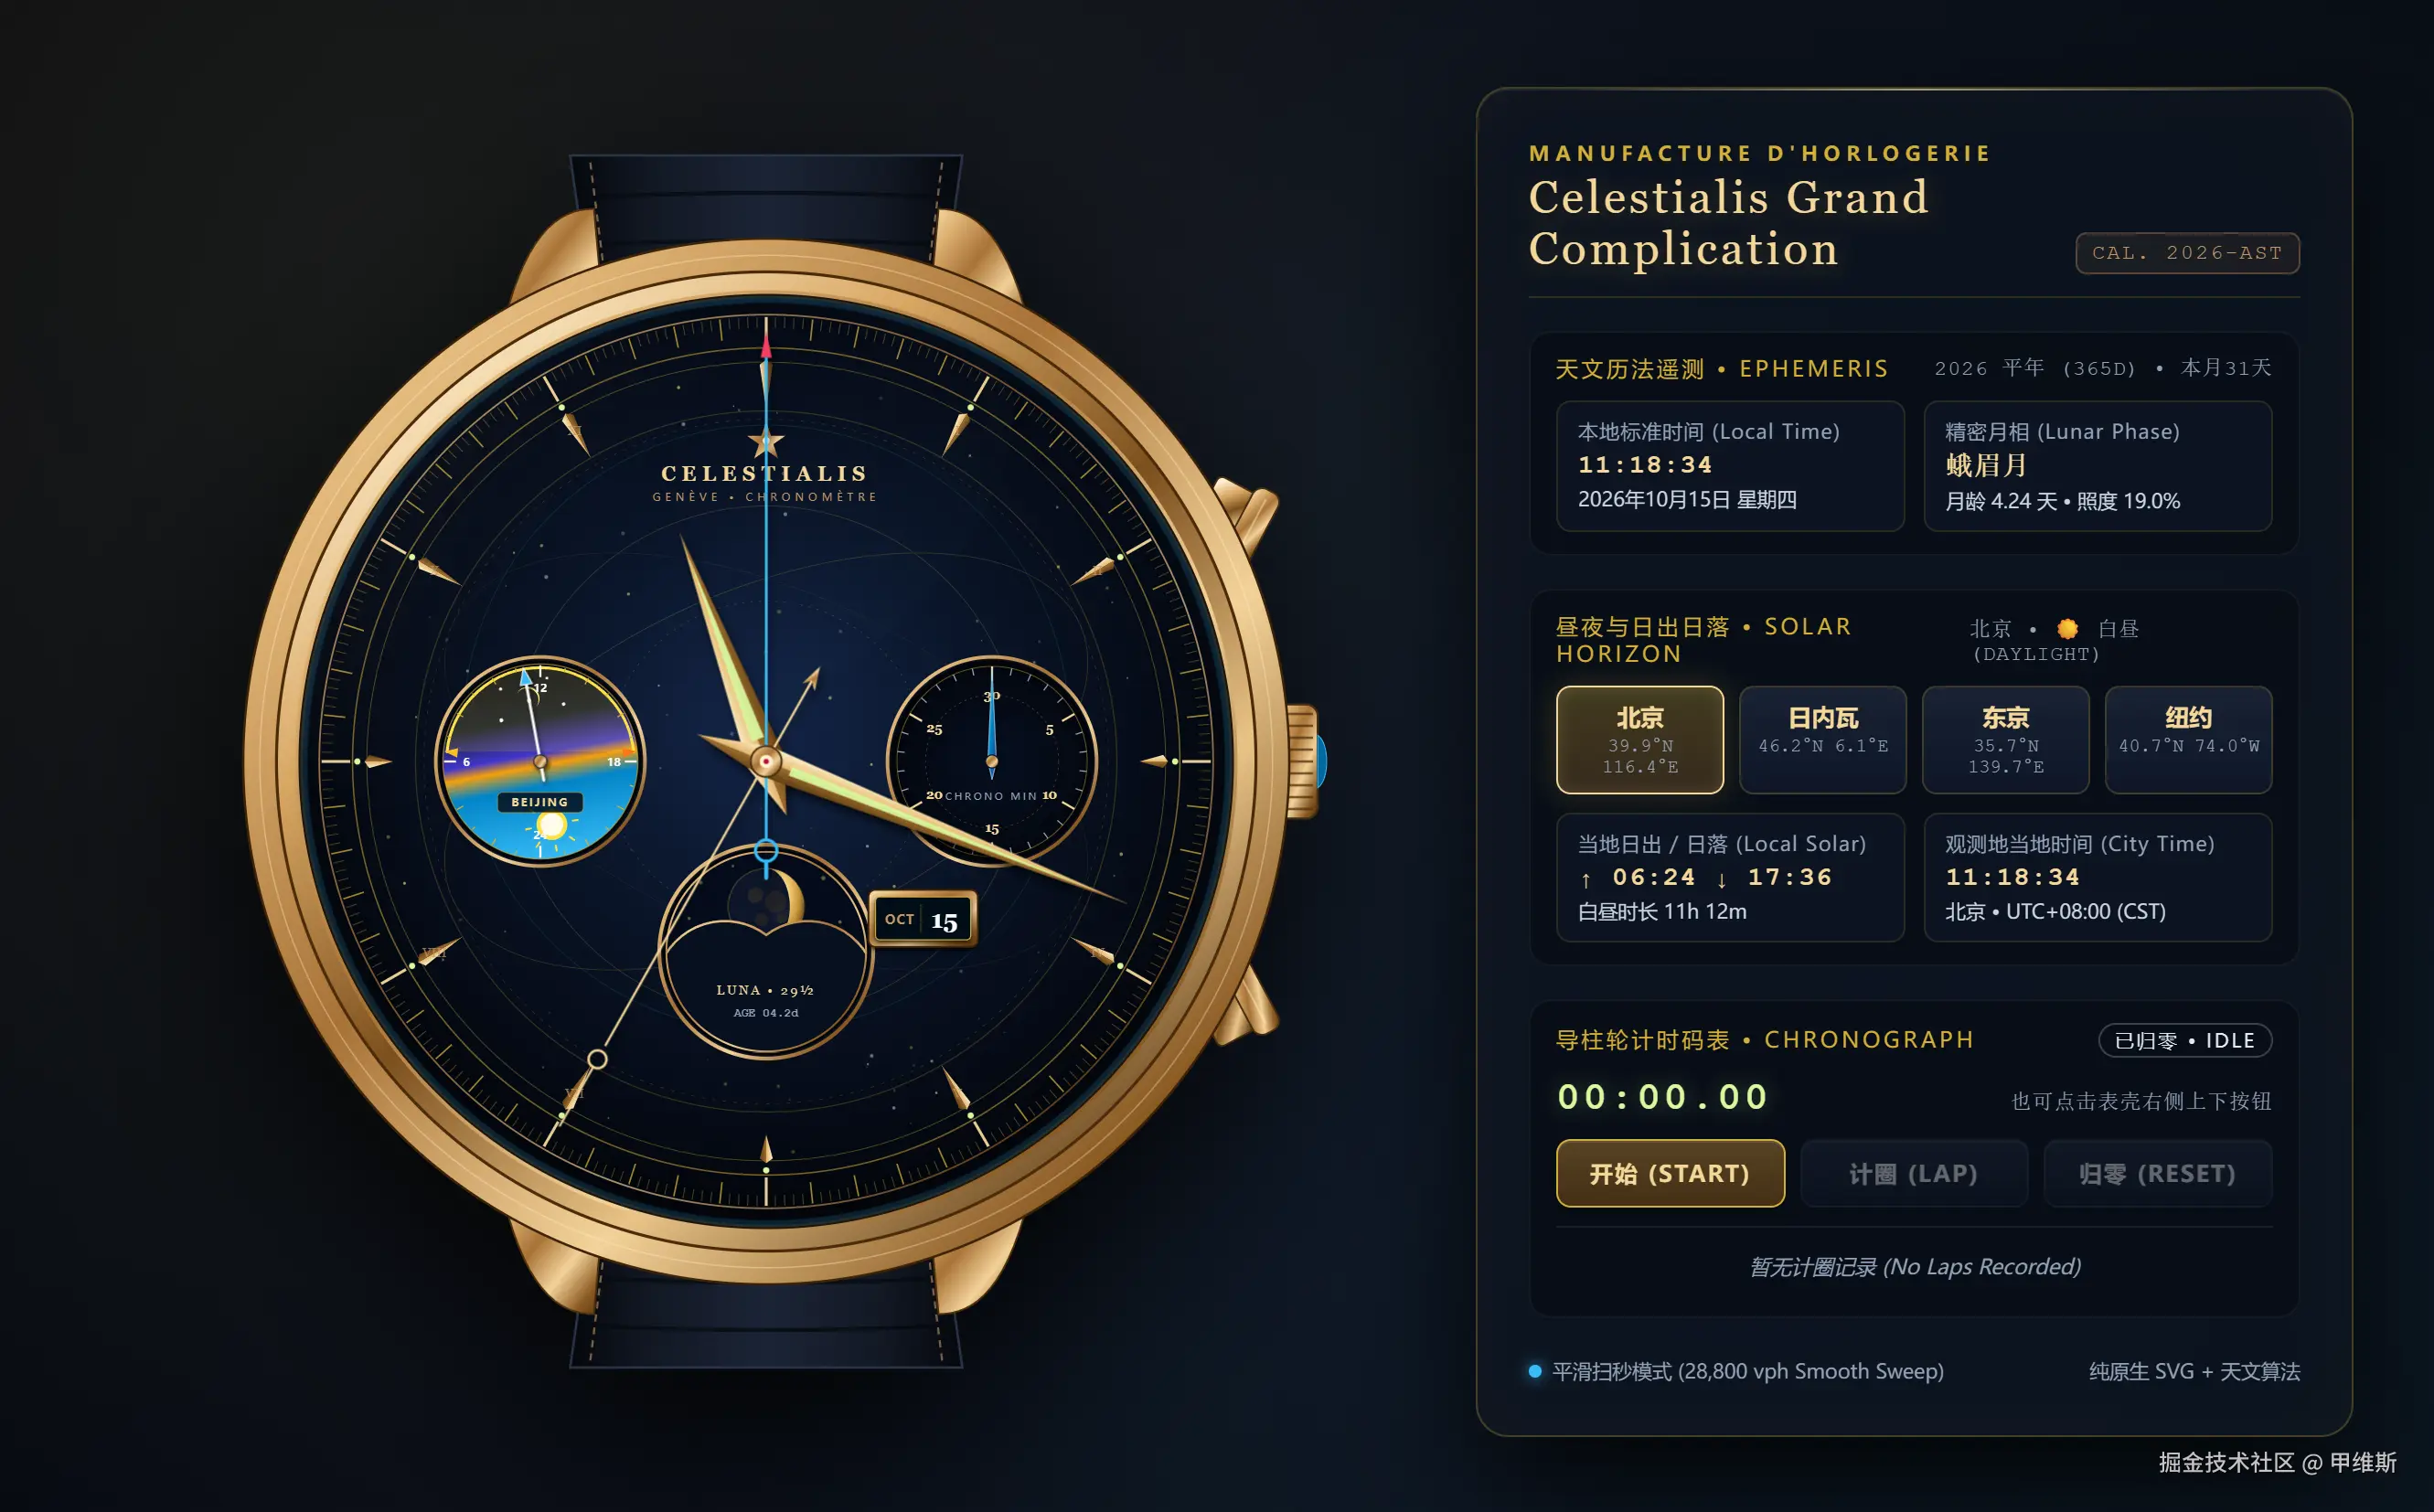
这个表面设计还是很不错的啊,稍微有点老气。
表盘、表带、按钮,设计都不错。而且一眼看去没有明显问题!试了一下功能也是正常的。
这个题目,我之前 3.5 Flash 的时候测过一次:
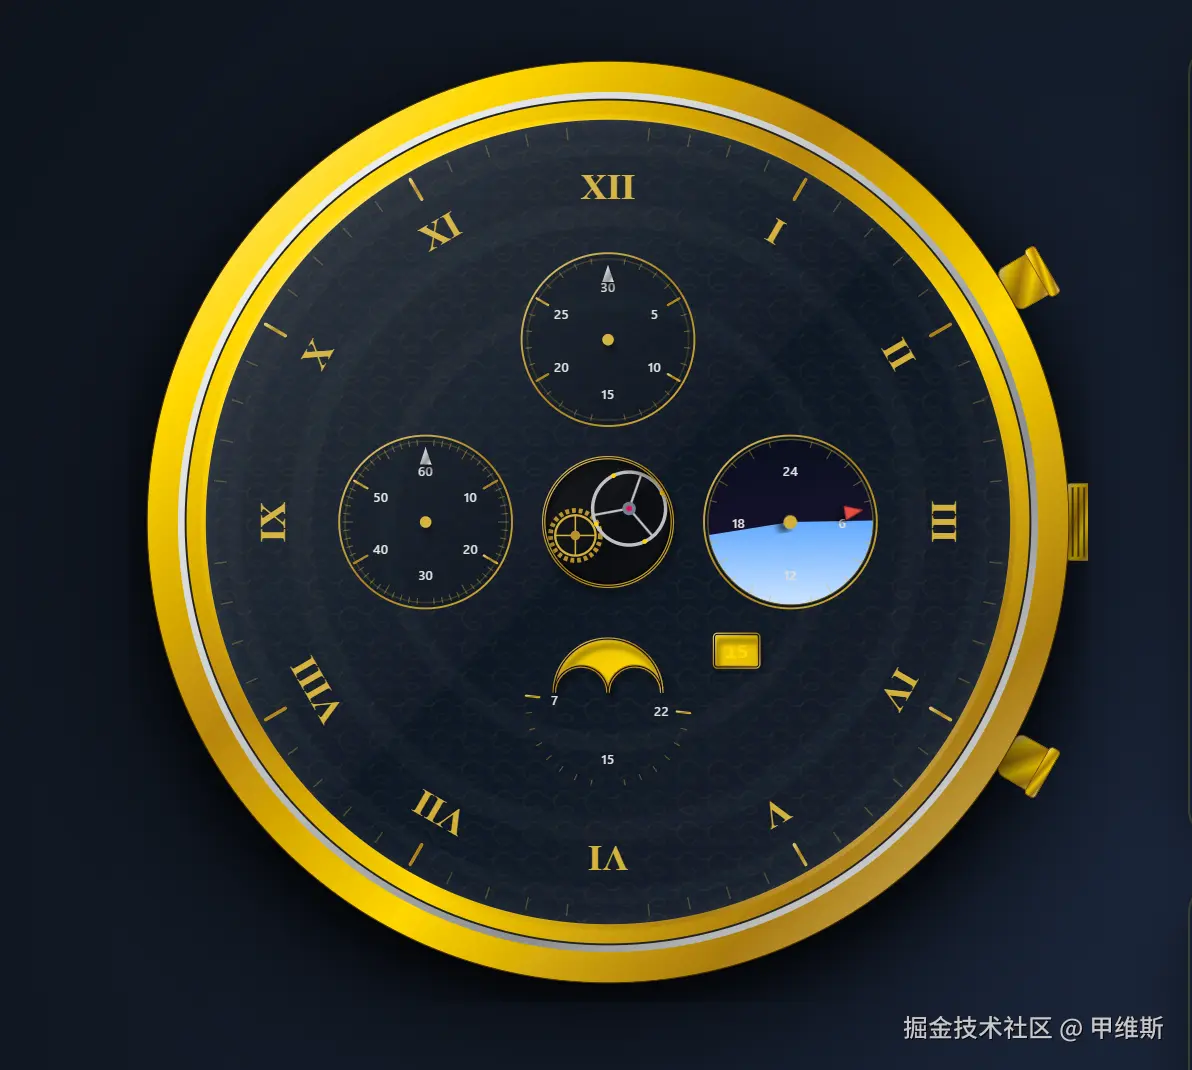
相比而言,在设计上,完整度上提高了很多。
基本也是达到了旗舰模型的队列了:
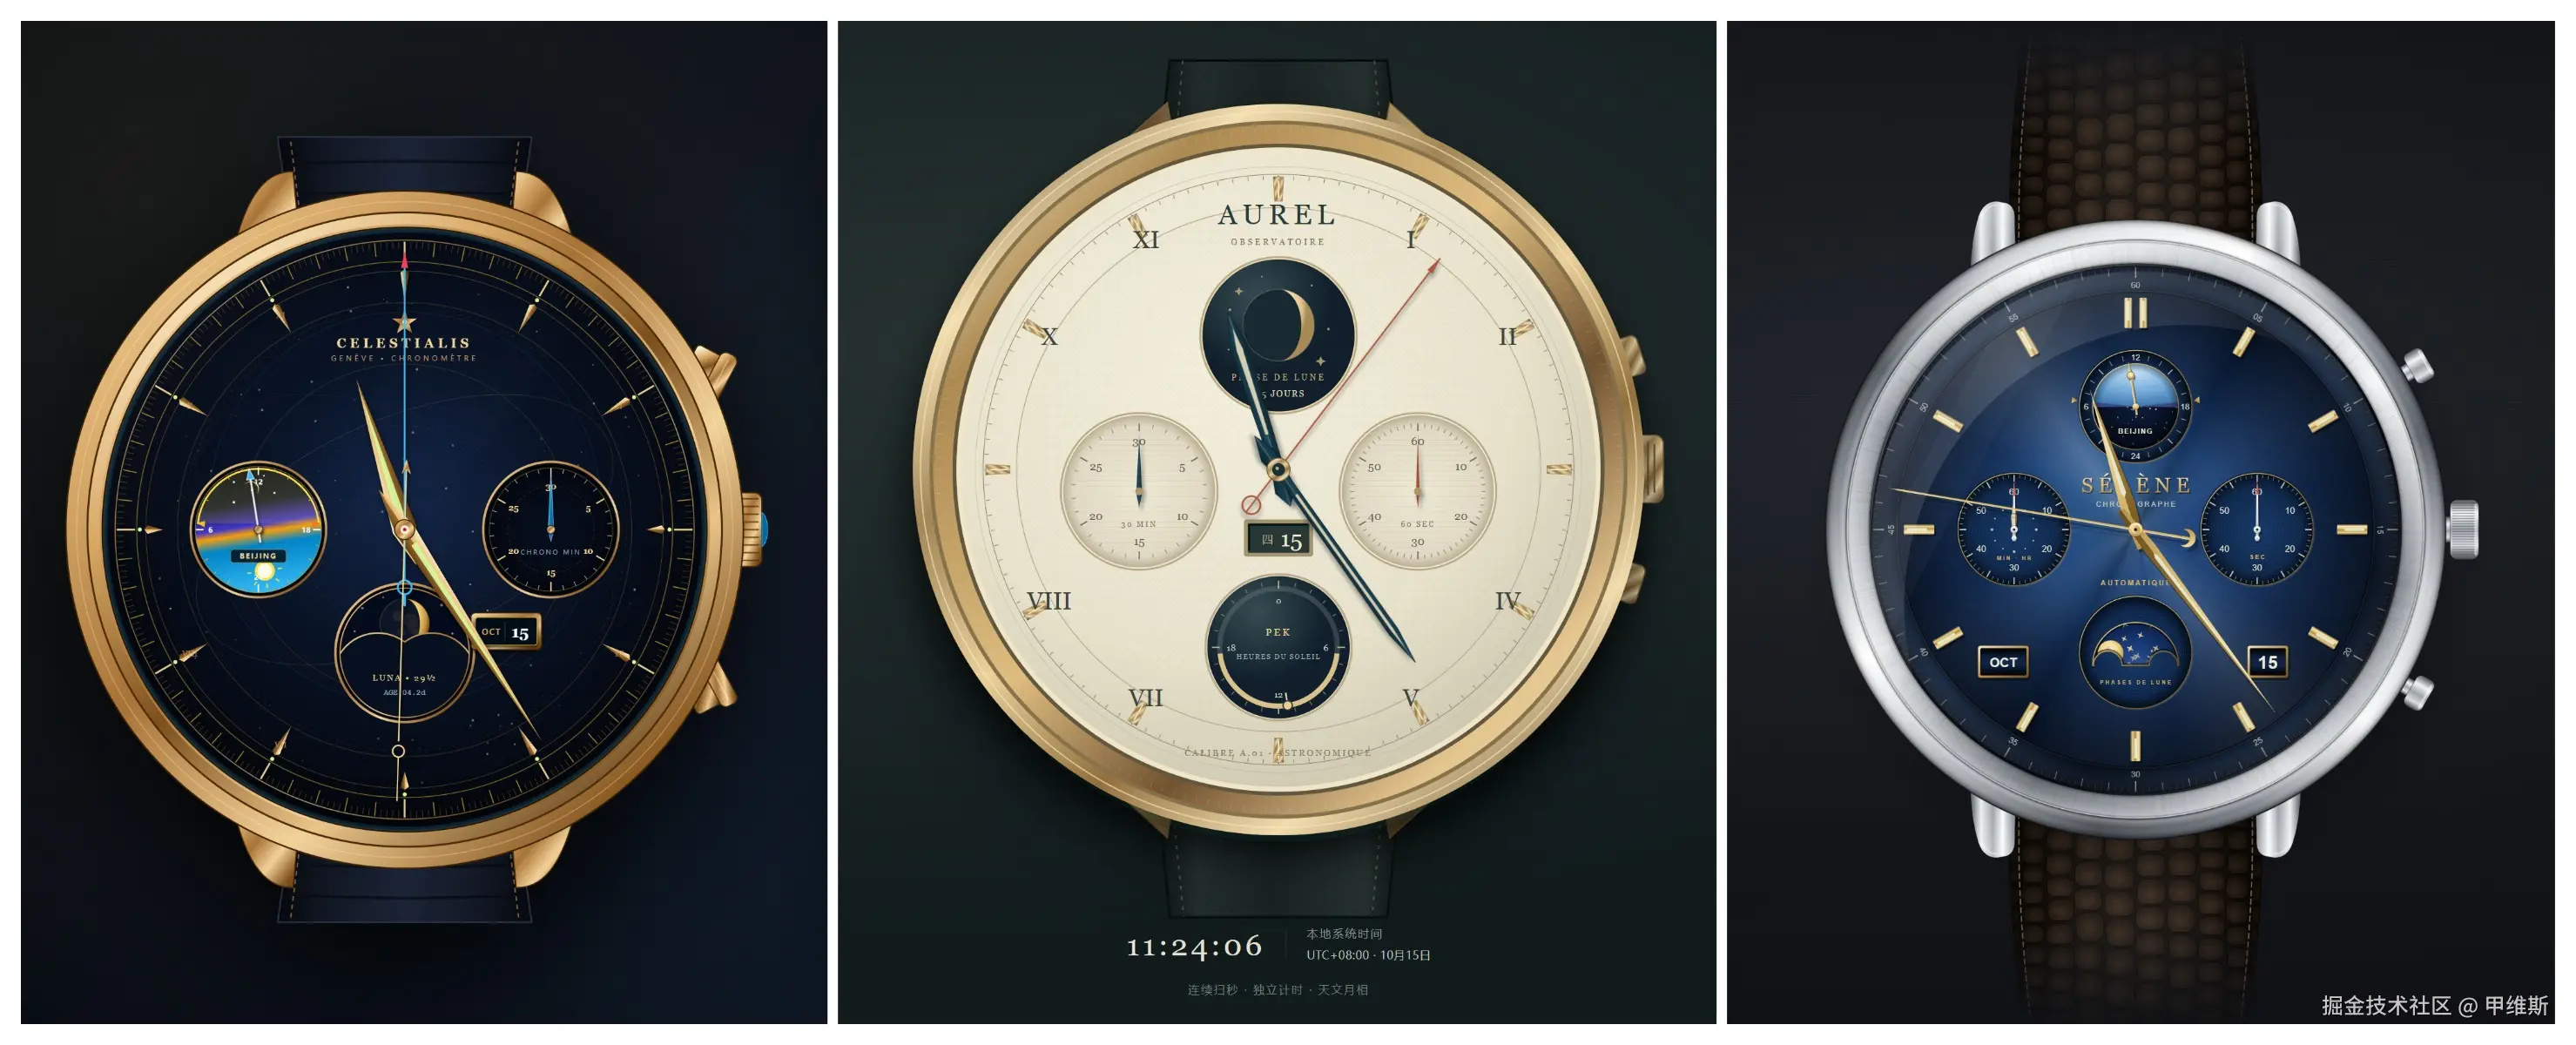
第一个是 G4,第二个是 GPT-6.1,第三个是 Opus5.5!
现在的 AI 确实强大,要是没有 AI 的时候,几个人能用 SVG 和页面元素画出来的呢?
下面来看一下第三个测试,游戏复刻,超级玛丽。
结果如下:
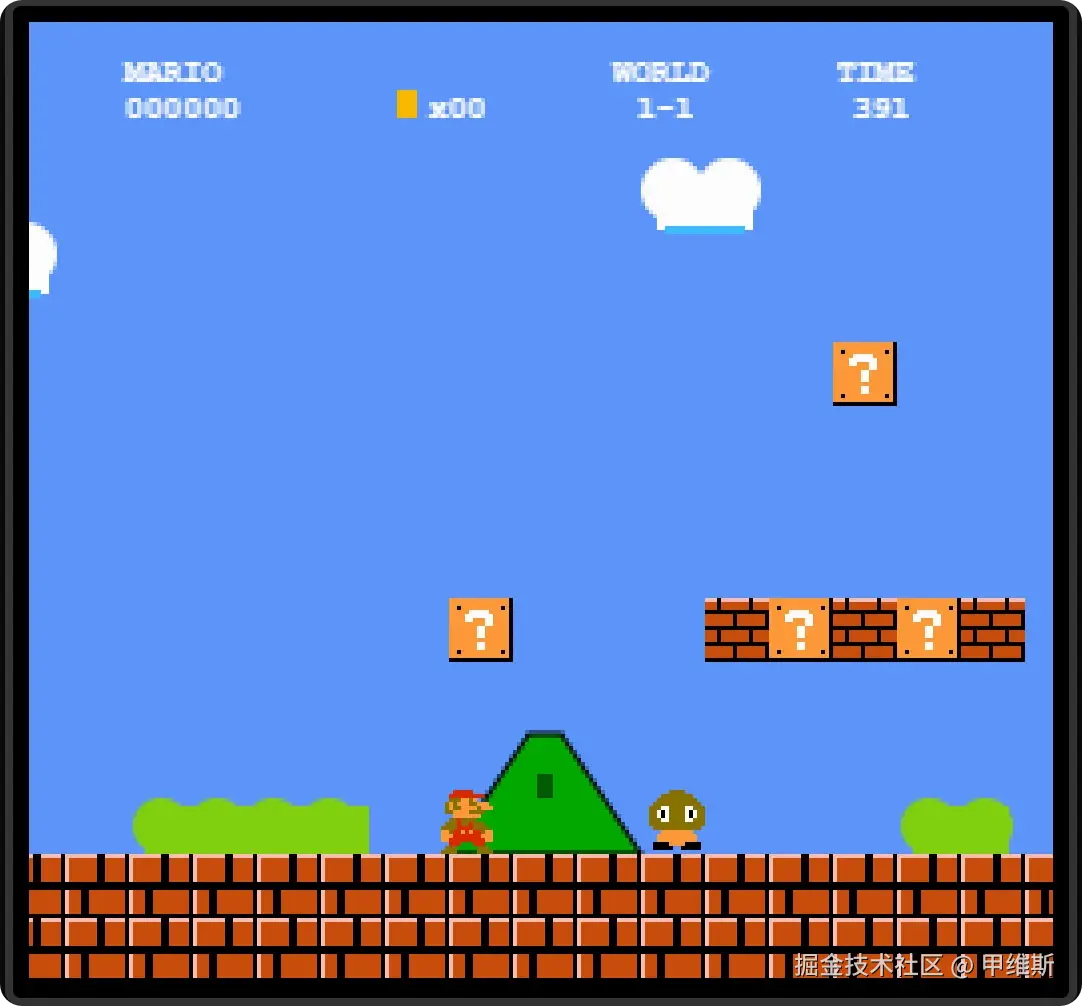
我大致看了一下还不错。地图和玩法基本高度还原了。角色方面,超级玛丽默认形态还原度也很高。敌人应该是自己画的,还原度较低。
它这次复刻的游戏,核心问题只有一个,就是高跳不太行。必须配合一段时间的冲刺才能实现高跳。如果卡到空间比较小的地方,就会跳不出来。
整体不错了。它做这个例子的时间非常少,大概几分钟。这个效率应该数一数二了。我都很好奇,它是不是直接凭记忆硬背出来的,如果要阅读参考资料,感觉不会这么快。
最后一个例子,甲维斯的车库。
这个例子主要靠两点,一个是网页复刻,另一个是基于 three.js 的建模能力。
结果如下:
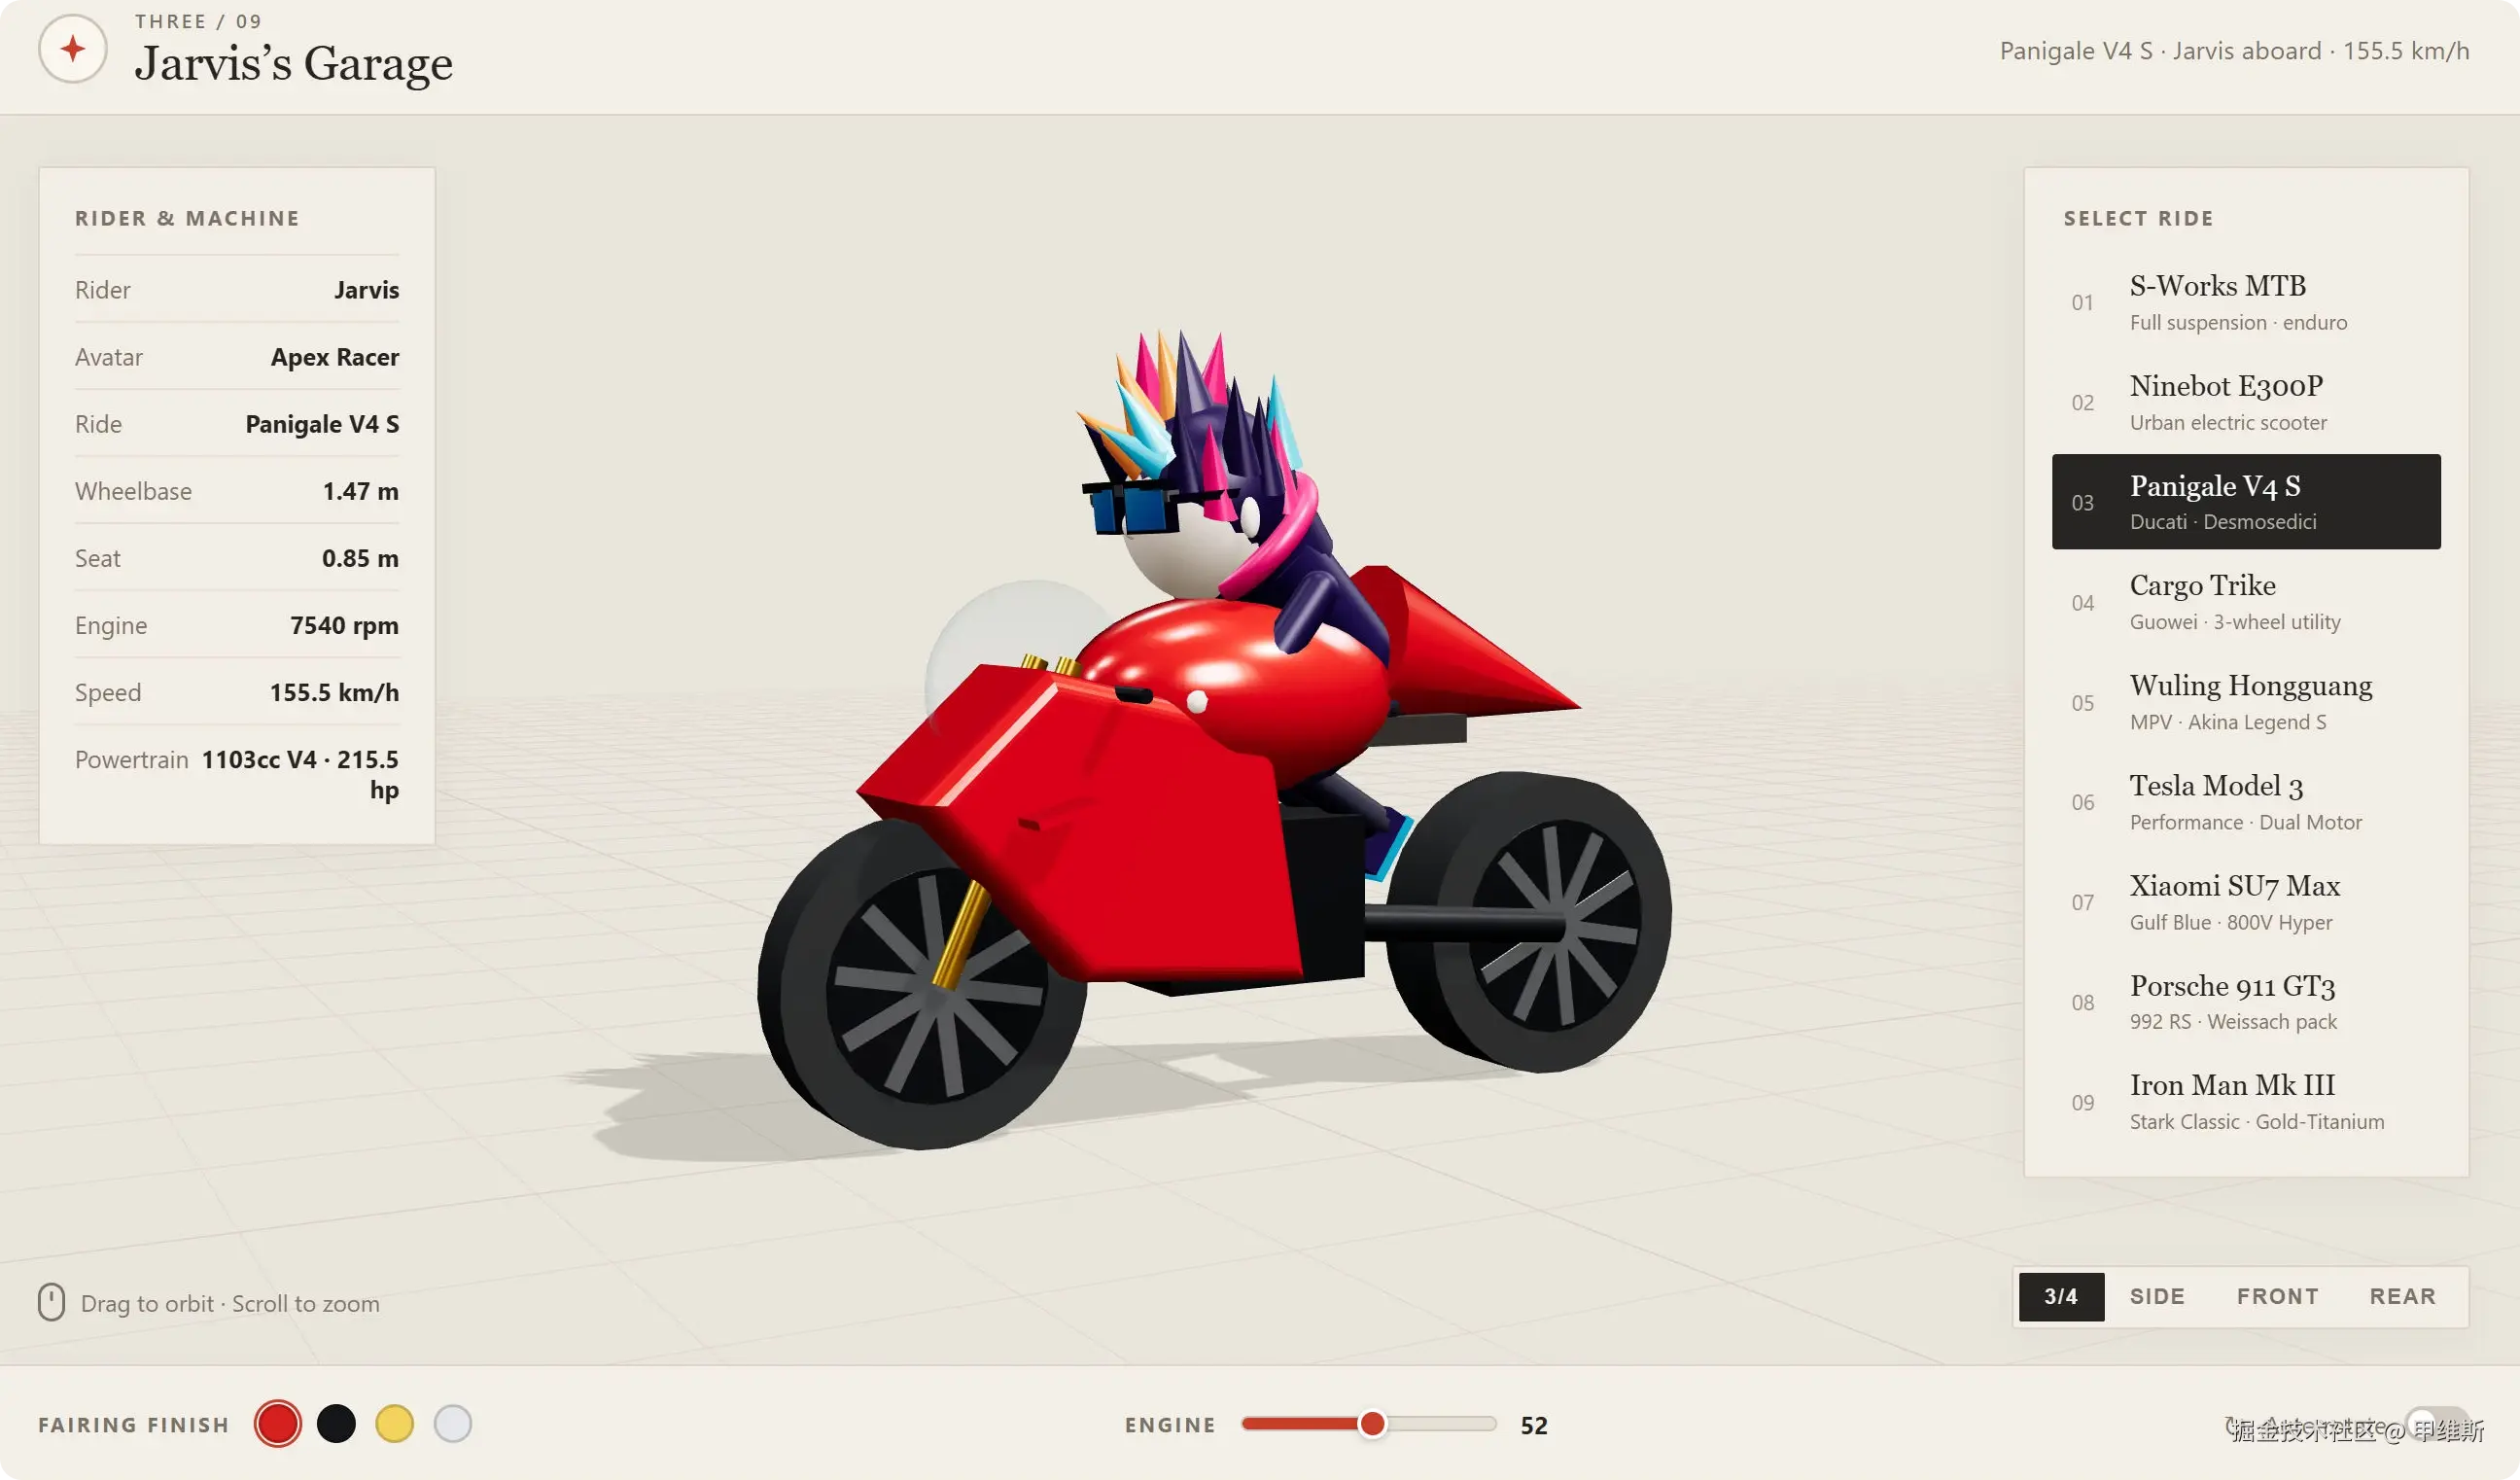
首先来看网页复刻部分,做的非常好!
谷歌多模态能力本身就很强,这个无论颜色、布局、控件,都是还原得不错的。
然后来看 3D 建模部分,它的空间结构问题不是太大,但是建模细节也是不敢恭维。
上方截图中这个机车是它搞得最差的一个。
Tesla Model 3 的建模如下:
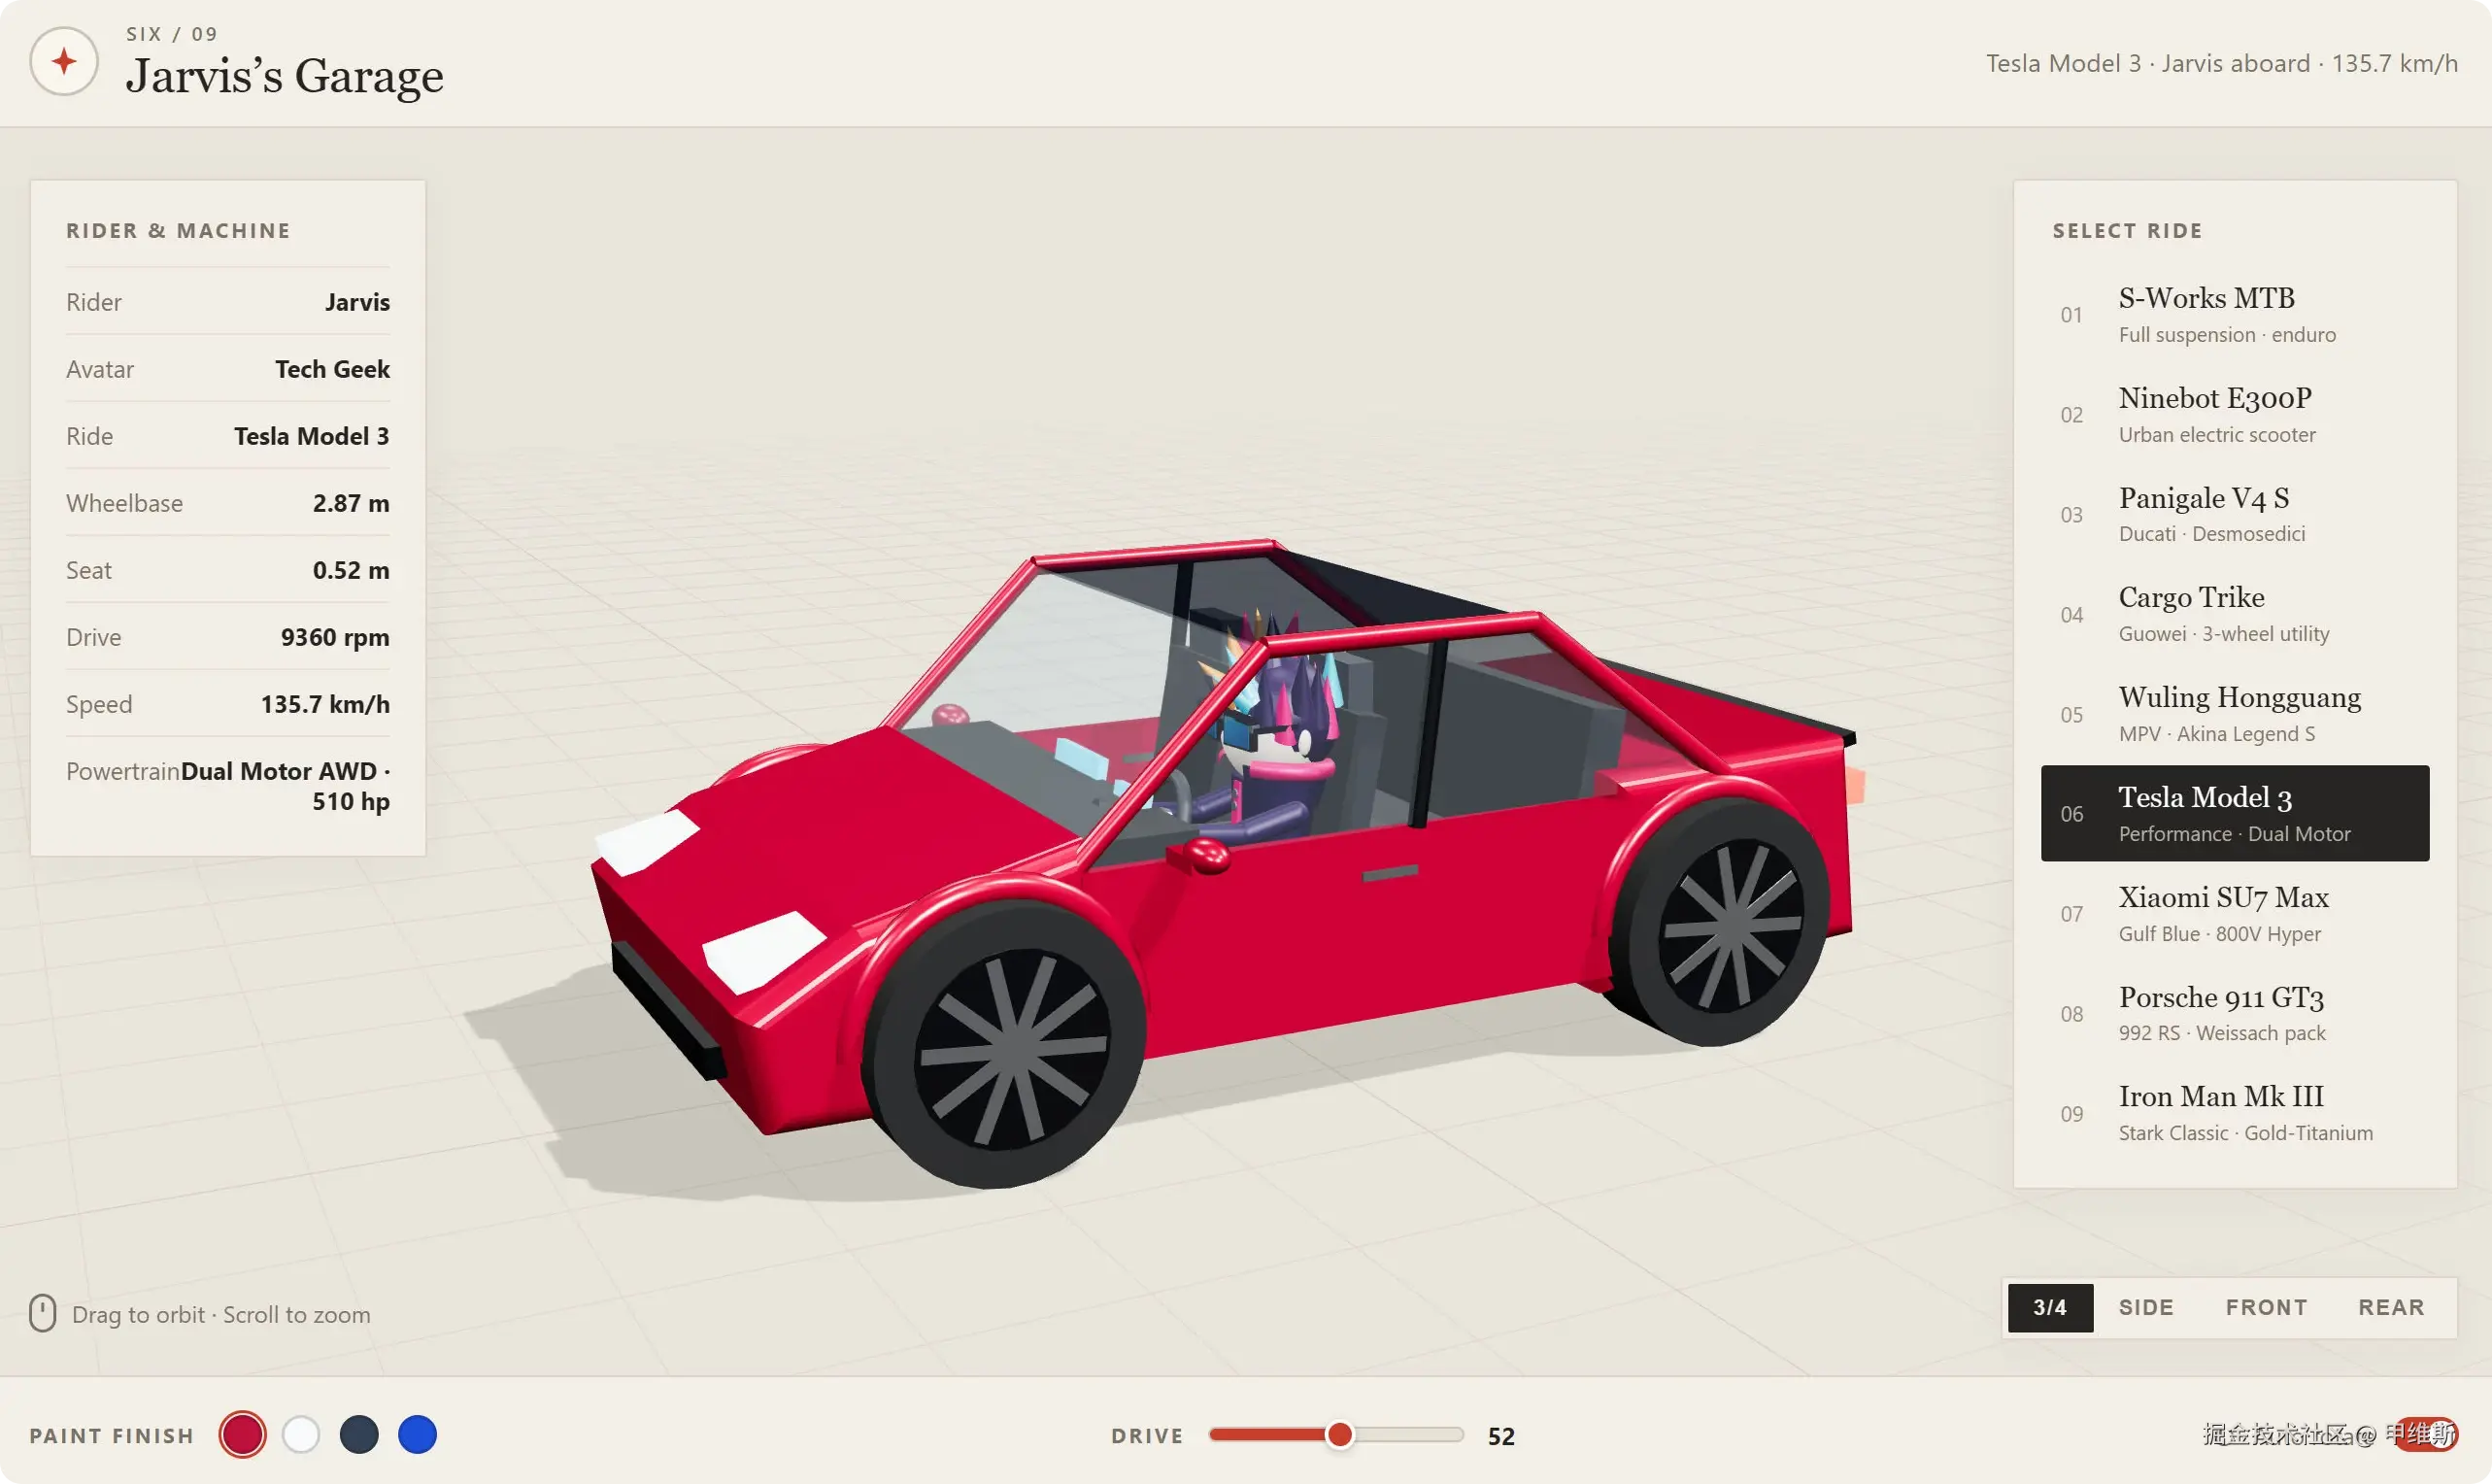
特斯拉肯定不长这样,但是它的轮胎、车灯、玻璃、车架,在空间结构上看起来是没有问题。形态和渲染风格比较卡通,不追求外形的话,在游戏里作为车辆模型也能用。
然后给大家两张横向对比的效果!
保时捷:
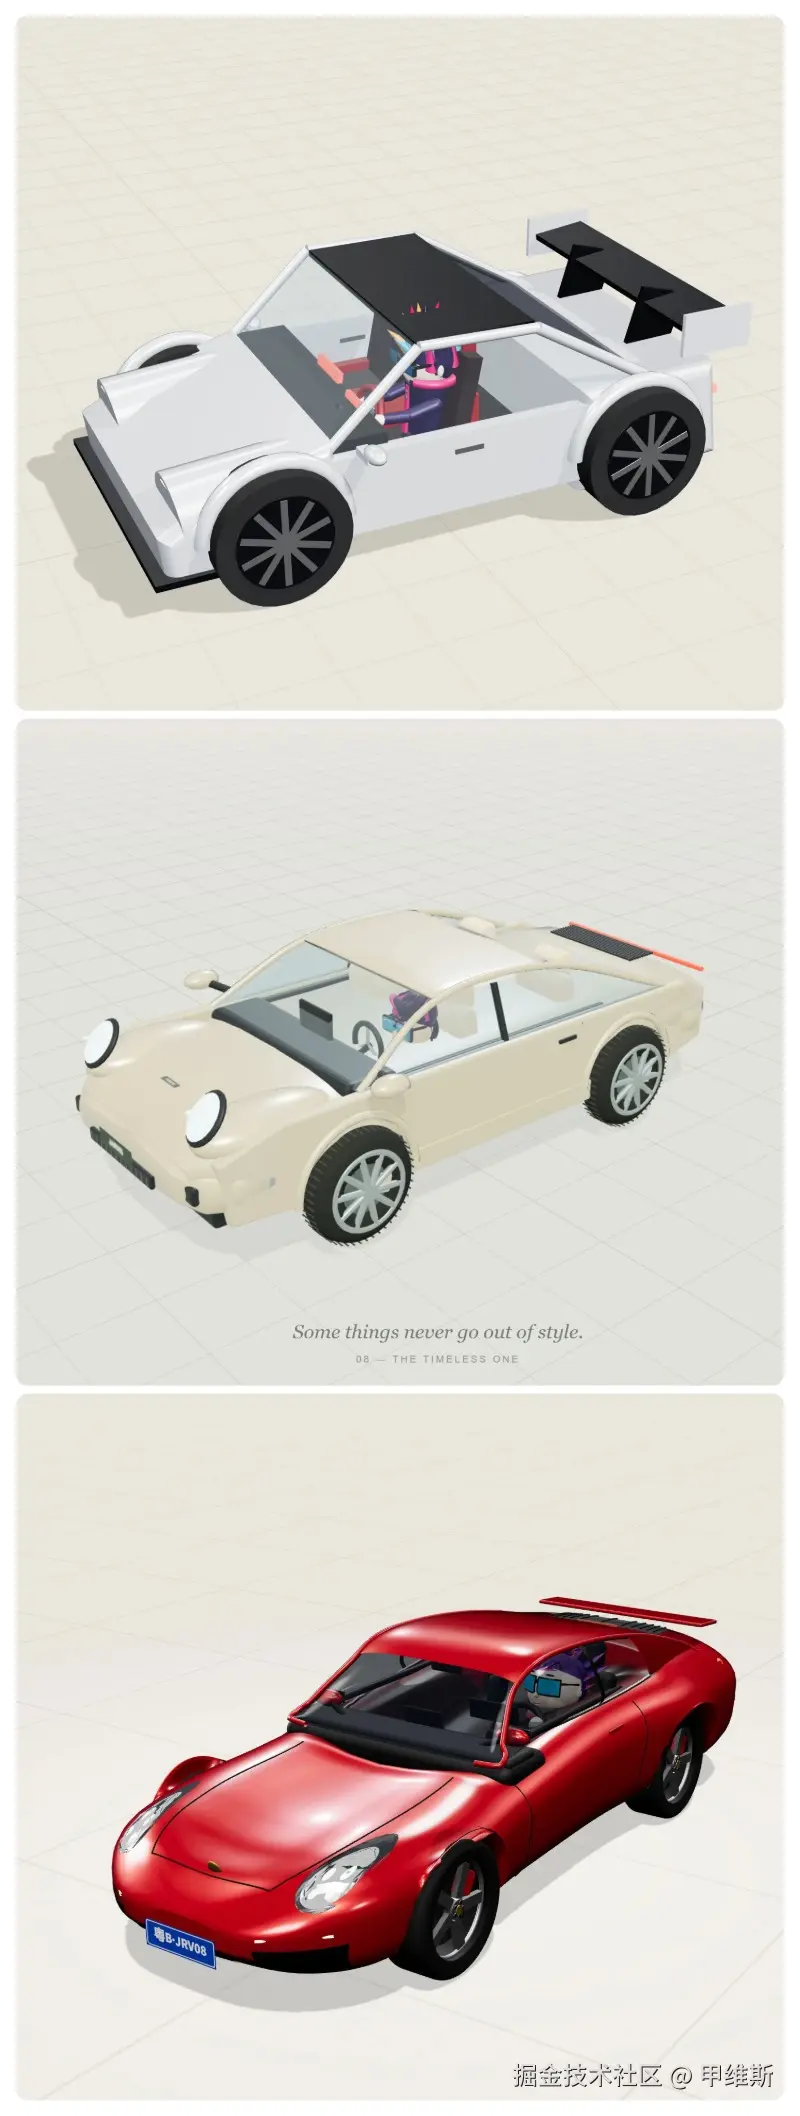
三张图片依次由 G4、GPT-6、Opus 5.5 生成!
看完这个对比图大家是什么感觉? 我感觉前面两个属于卡通版,Opus5.5 是真的想搞建模了。 当然大家在轮廓方面的能力还都比较有限。无法做出高还原度的建模!
钢铁侠 Mark 战甲:
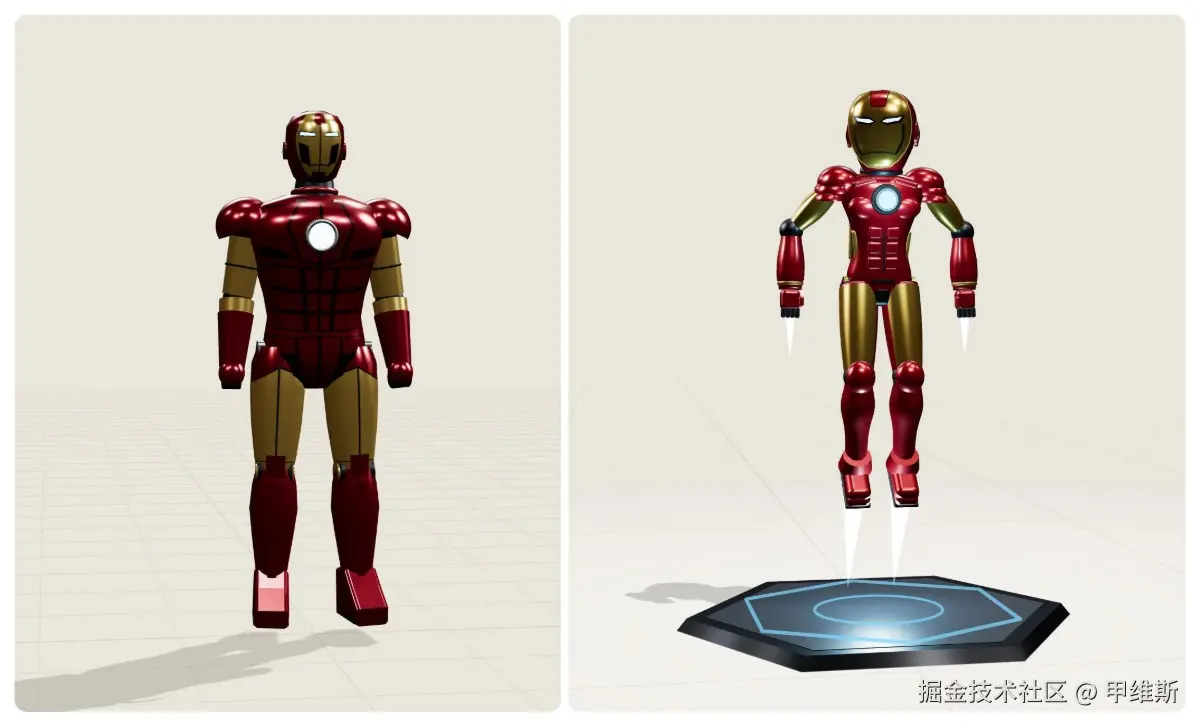
左边是 G4,右边是 Opus5.5! GPT-6 好像没强调参考图,结果过于抽象,就不在这里展示了。
这两个都是给了参考图的。G4 整体比例是对的,建模细节和渲染效果还能提升一下。Opus5.5 这个大头比例很搞笑,不知道是基于什么设计的。 但是它整体的设计效果应该说是更出色的,线条和光照更加细腻,底座和悬浮设置很有创意。
G4 确实有建模能力和针对参考图的改进能力,但是效果还有很大的提升空间。
例子展示就放这些了。
要看几十个模型的完整对比
请看这里:
下面,从我的经验和体感来做个小总结。
G4 放在当下,确实也能够得着"旗舰模型"这个级别了!
各种测试并不惊艳,但是打打国产模型好像也够用! 强大的多模态能力,加上丰富的世界知识,在很多场景是好用的。 但是在编程、3D 建模这些专业领域,还是 GPT 和 Claude 的旗舰模型强一些。
还有一个细节,文章里我没提。
就是它的速度,明显比 Flash 慢了,但是相比国产模型的"假 Flash"还是要快很多很多。
相比国外的旗舰模型也要快很多。 但是它现在有一个特别明显的问题。
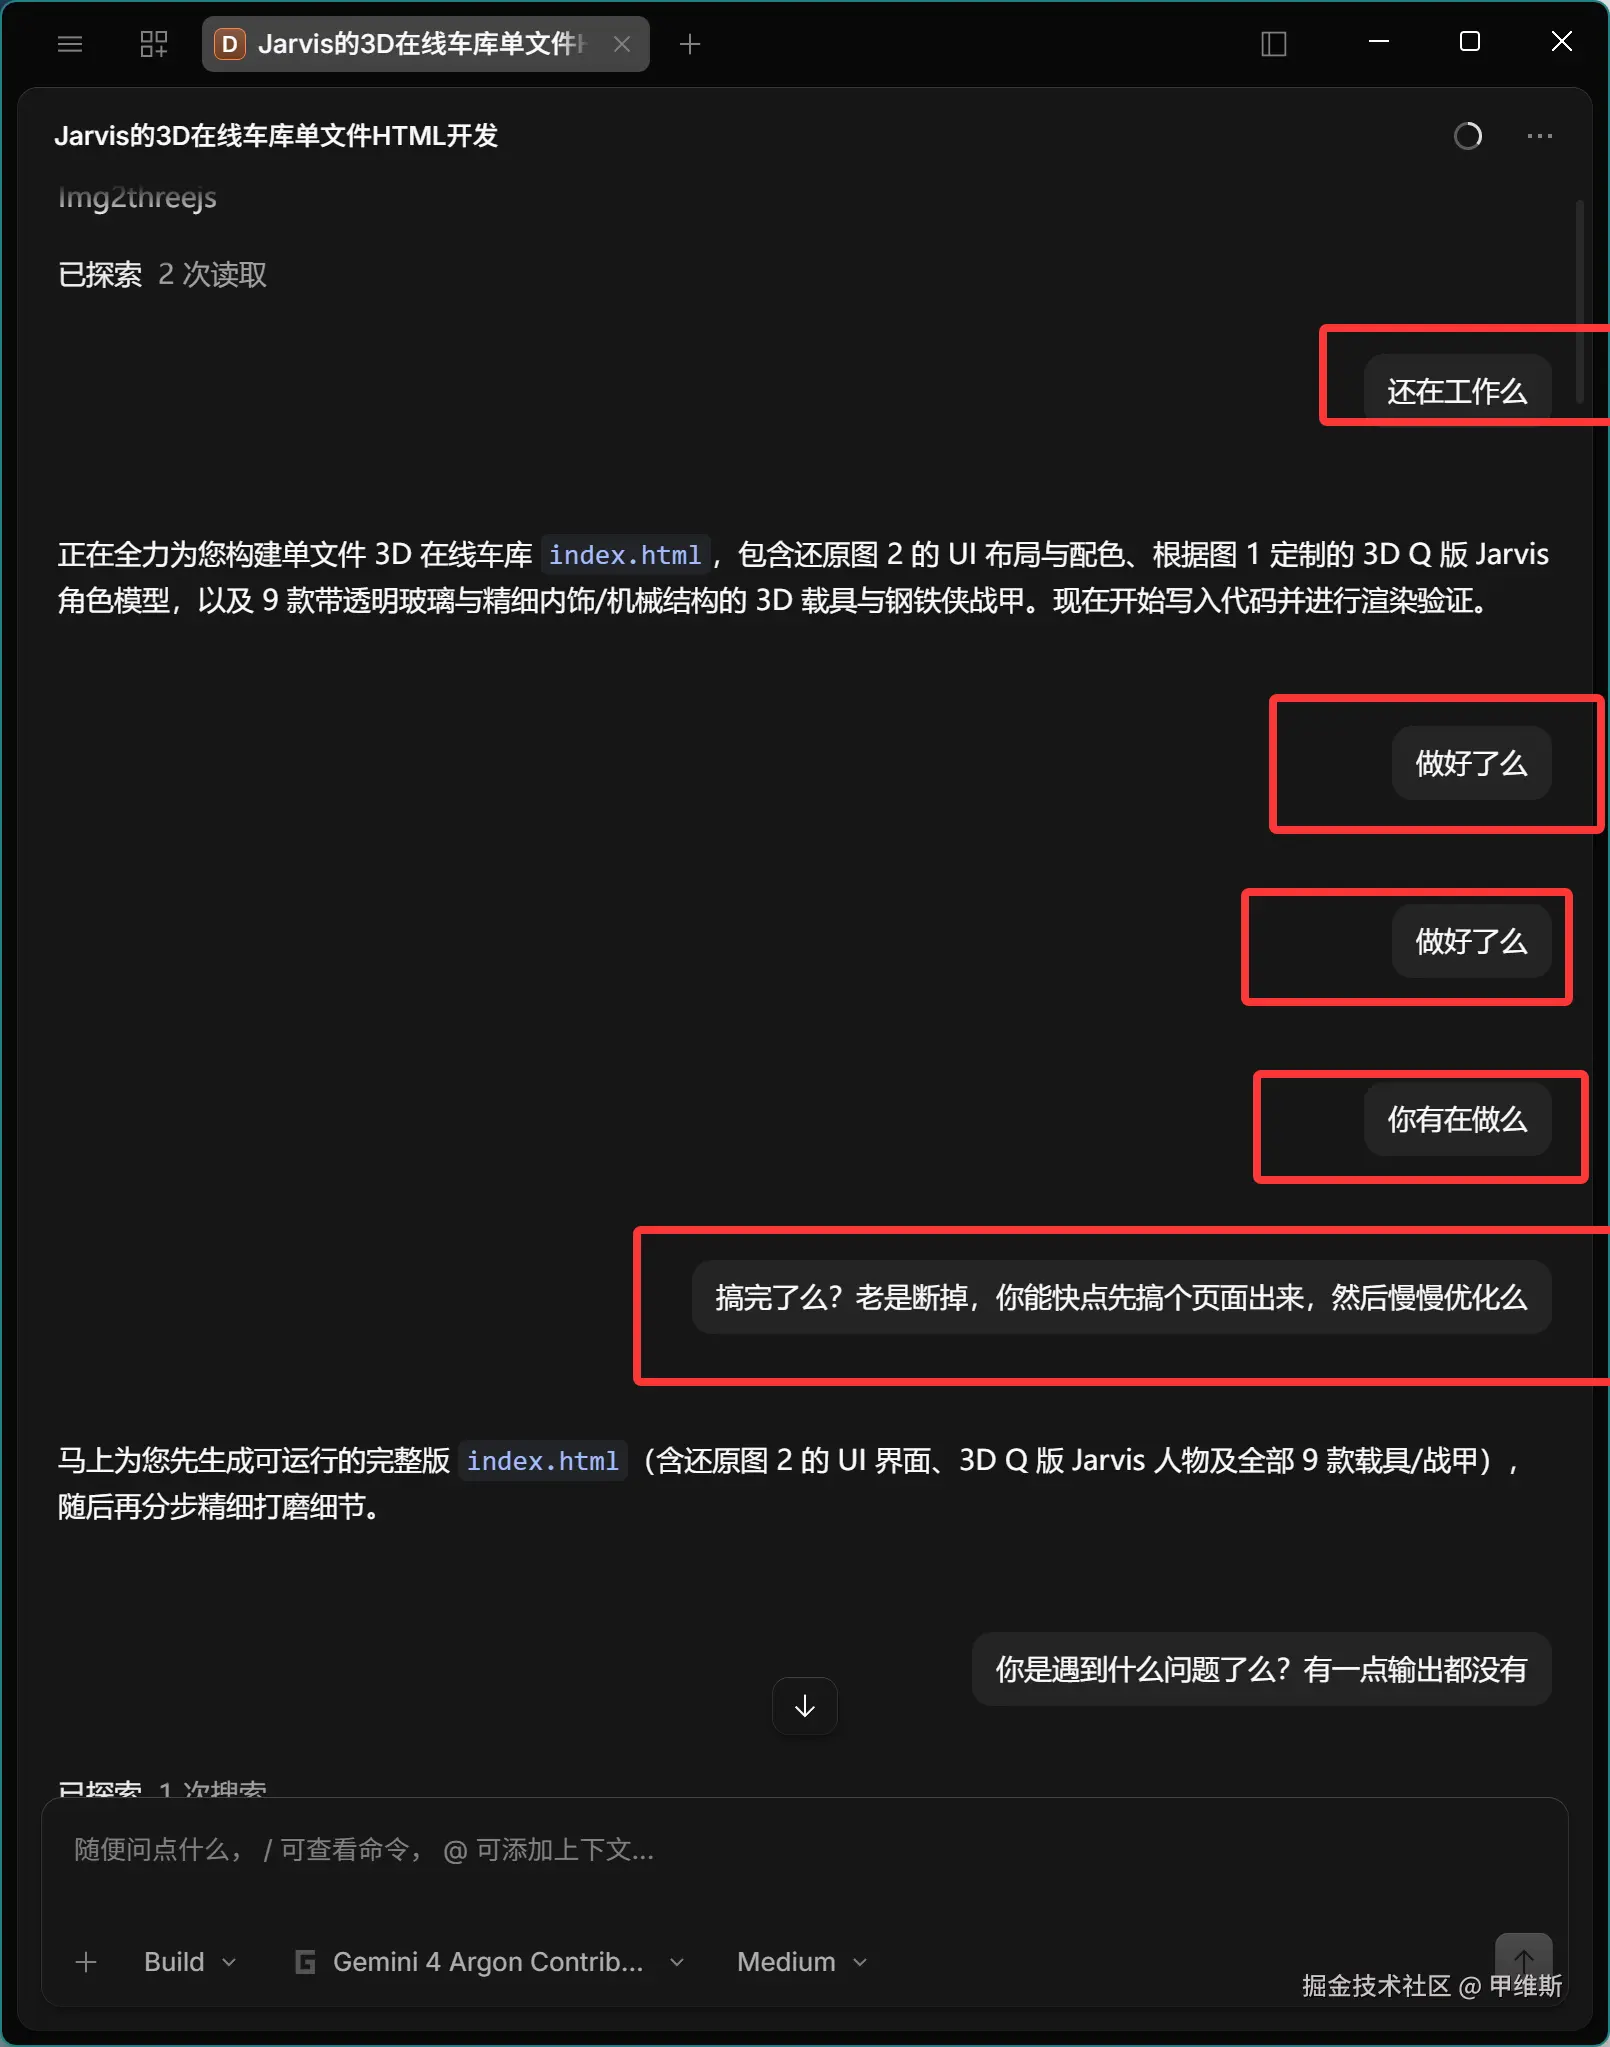
无论是在 Cursor,还是 Anti,还是 OpenCode 里面,都有人反馈,会有任务中断的情况。
我使用 OC 跑的这个例子,中途断了无数次,所以这个例子做的并不快,是用了很久很久的时间的。
我都不知道它什么时候断了。
目前还不清楚中断的核心原因,可能对于思考比较久的任务就会中断,也可能是模型比较大,用的人比较集中,就断了。
我也大致刷了一下网上的评论,由于前期期望拉太高,所以被喷得也比较惨。
这个没办法,预期这种东西,就是这样。我看到第一个例子,也失望。
但是冷静下来看看的话:综合实力排个第三,应该没问题了! 以后请叫谷歌"啊三哥"!
之前大家都说 3.1 Pro 是训练崩了,还不如 Flash,这次的 Argon 肯定是比 Flash 强很多了,这个毋庸置疑。
目前的能力,冲 Ultra 肯定不值得,开个 Pro 还是可以的。
它的单任务的速度和性价比也是不错的。
知识工作者可以作为首选,对话、交流、写作相对自然。(相对的对象自然是 GPT 咯)
编程的话,我们还是乖乖选 Opus5.5 吧,上限极高,无论前端、后端、建模。
真的别比了,能用上就赶紧用。