文章目录
-
- 一、处理连续变化的数据,需要另一类模型
- [二、Timer 的演进,解决了哪些实际问题](#二、Timer 的演进,解决了哪些实际问题)
-
- [2.1 从单个任务建模,走向预训练后的任务适配](#2.1 从单个任务建模,走向预训练后的任务适配)
- [2.2 把更长的历史和更多变量放进预测过程](#2.2 把更长的历史和更多变量放进预测过程)
- [2.3 从一个预测值,扩展到多个可能的未来](#2.3 从一个预测值,扩展到多个可能的未来)
- [2.4 更大规模的模型,继续拓展预测能力](#2.4 更大规模的模型,继续拓展预测能力)
- 三、时序分析不只是把曲线往后延长
-
- [3.1 趋势预测:根据任务选择输入信息](#3.1 趋势预测:根据任务选择输入信息)
- [3.2 异常识别:把实际表现与预期状态放在一起看](#3.2 异常识别:把实际表现与预期状态放在一起看)
- [3.3 缺失填补:补齐分析输入,也要保留数据来历](#3.3 缺失填补:补齐分析输入,也要保留数据来历)
- [3.4 不确定性分析:预测区间比一条线提供更多信息](#3.4 不确定性分析:预测区间比一条线提供更多信息)
- 四、先在页面中验证,再把调用写进程序
-
- [4.1 Web 控制台:先跑通一条真实曲线](#4.1 Web 控制台:先跑通一条真实曲线)
- [4.2 Python SDK:明确目标列和预测边界](#4.2 Python SDK:明确目标列和预测边界)
- [4.3 REST API:把预测作为一个独立服务调用](#4.3 REST API:把预测作为一个独立服务调用)
- 五、用风机主轴承温度串起一次完整应用
- [六、TimechoDB 与 TimechoAI:让预测结果回到数据流程中](#六、TimechoDB 与 TimechoAI:让预测结果回到数据流程中)
- 七、模型怎么选,最好让同一份数据来回答
- 八、先解决一个值得预测的问题
一台风机的主轴承温度正在上升,监控大屏上还没有出现红色告警。对运维人员来说,此时最想知道的往往不是"现在多少度",而是:照这个趋势发展,明天会不会过热?有没有必要提前安排检查?
类似的问题每天都在发生。电网需要提前估计负荷,工厂希望减少非计划停机,业务团队想为销量和流量变化留出准备空间。历史数据已经存了不少,可从"看见过去"走到"判断接下来会怎样",中间仍然隔着数据处理、模型选择、训练部署和系统集成等一系列工作。
TimechoAI 所切入的,正是这段距离。它把专门处理时间序列的模型能力做成服务,让企业可以先拿真实数据验证预测效果,再决定是否投入更深入的业务适配。
本文围绕四个问题展开:TimechoAI 的技术基础是什么,它能帮助分析哪些问题,如何接入,以及预测结果怎样进入日常业务流程。
一、处理连续变化的数据,需要另一类模型
把设备日志交给通用大语言模型,让它归纳故障原因,是一种合理的用法。但把数千个温度数值贴进对话框,让它稳定地预测未来曲线,就是另一回事了。
时间序列不只有数值大小,还包含采样间隔、趋势、周期、变量之间的关联,以及运行状态切换带来的变化。同样一次温度升高,可能对应环境变热、设备负荷增加,也可能意味着散热系统出了问题。脱离时间和工况,很难判断它究竟代表什么。
专门的时序基础模型,会通过大量时间序列学习这些变化特征,再把已有能力用于新的预测任务。相比每个场景都从头建模,这为企业提供了一条更容易开始的路线。
TimechoAI 是天谋科技推出的时序大模型服务平台,Timer 系列是其核心模型基础。 两者的分工可以这样理解:Timer 提供时序建模能力,TimechoAI 则负责把模型变成可在界面中使用、也能通过程序调用的产品。
这种服务方式对不同团队有不同意义:
- 没有专职算法人员,可以先通过零样本预测了解数据是否具备应用潜力;
- 已有数据分析流程,可以用 SDK 或 API 把预测接进去,与原来的方法做对照;
- 对行业和设备工况有更深要求,可以进一步考虑领域训练或场景适配。
这里的"零样本"指不必先针对当前任务训练模型,并不是不需要历史输入,更不代表任何数据都能直接得到可靠结果。
二、Timer 的演进,解决了哪些实际问题
评价时序模型,参数量只是其中一个维度。更值得关注的是:它能看多长的历史,是否能处理多个变量,以及能不能表达未来的不确定性。
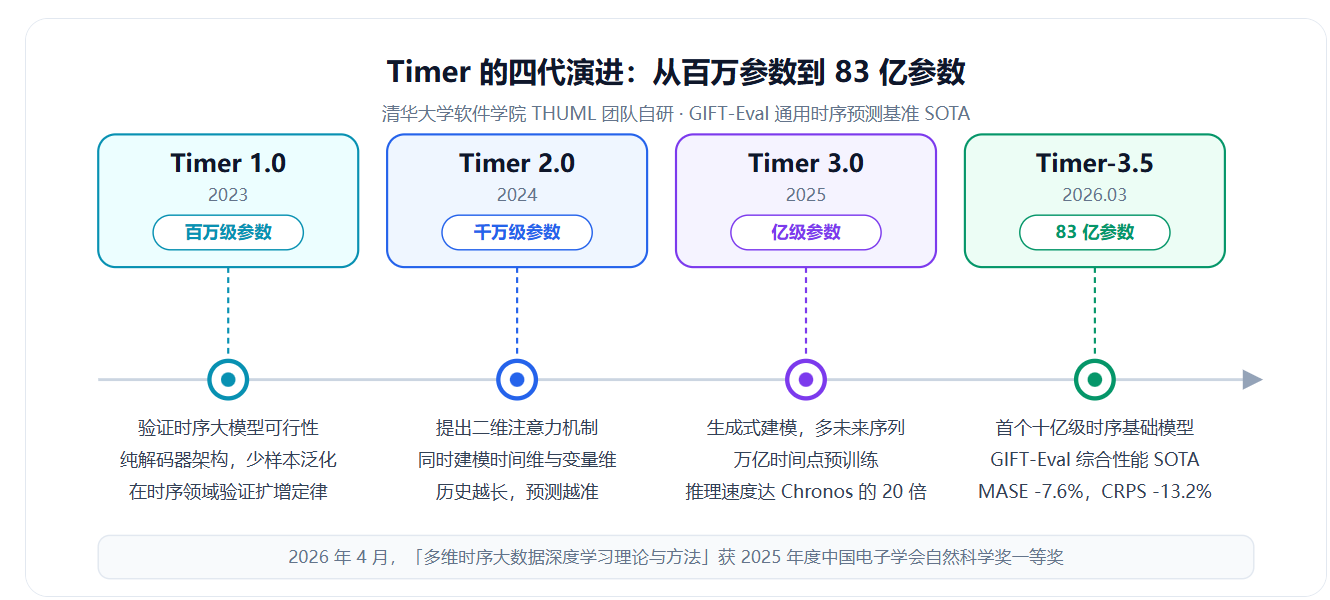
Timer 发源于清华大学软件学院 THUML 团队,其技术演进也可以沿着这些问题来理解。
2.1 从单个任务建模,走向预训练后的任务适配
早期 Timer 采用纯解码器架构,探索将不同来源的时序数据用于统一预训练。它的意义在于,模型不必只围绕某一台设备、某一种业务学习,而是有机会积累可迁移的时序特征。
对用户而言,这意味着面对新数据时,可以先尝试预训练模型,再根据实际效果判断是否需要微调。
2.2 把更长的历史和更多变量放进预测过程
Timer-XL 进一步扩展长上下文与多变量建模能力,同时考虑时间维度和变量维度的关系。
这与工业场景很贴近。设备今天的表现,可能与过去几个工作周期有关;轴承温度的变化,也往往不能脱离风速、功率和环境温度单独解释。
更长的输入窗口为模型提供了更多线索,但实际效果仍取决于历史数据的相关性。把已经失效的旧工况一股脑加入,并不一定比使用较短、较相关的历史更好。
2.3 从一个预测值,扩展到多个可能的未来
Timer 3.0 / Sundial 引入生成式建模,可以针对同一段历史生成不同的未来轨迹。
这让预测结果不再局限于"明天温度是多少",还可以进一步讨论"合理的波动范围有多大"。在负荷调度、设备运维等场景中,后一个问题往往更接近决策需求。
2.4 更大规模的模型,继续拓展预测能力
根据天谋科技的产品介绍,2026 年 3 月发布的 Timer-3.5 将模型规模扩展至 83 亿总参数,上下文长度达到约 11.5K 时间点。官方披露的发布时评测显示,其在 GIFT-Eval 上取得领先成绩,MASE 和 CRPS 相比前代分别降低 7.6% 和 13.2%。
这些指标分别帮助衡量预测误差与概率预测质量。不过,公开基准上的提升不能直接等同于某家企业的业务收益。模型是否适合某类机组、某条产线,最终还是要用相同数据窗口、相同预测目标进行验证。
三、时序分析不只是把曲线往后延长
预测是最直观的入口,但围绕预测建立起来的分析方法,还能帮助团队理解异常、处理缺失,以及评估风险。
需要区分的是:模型技术能够支持某类任务,不代表云平台的每个版本、每个模型都以相同接口开放该能力。 使用时应分别确认模型限制、平台功能和账户权限。
3.1 趋势预测:根据任务选择输入信息
TimechoAI 的预测任务可以从只使用目标历史开始,再逐步加入相关变量。
| 输入方式 | 提供给模型的信息 | 典型用途 |
|---|---|---|
| 只提供目标序列 | 过去的温度、负荷或销量 | 快速建立预测基线 |
| 加入历史协变量 | 同期天气、工况、功率等 | 让模型参考外部因素与目标的关系 |
| 加入未来协变量 | 已知的排产、节假日或可获得的天气预报 | 在预测时引入未来条件 |
例如,预测明天的用电负荷,过去几天的用电量只是部分依据。如果明天是假日,或者排产计划明显减少,这些信息同样重要。
未来协变量必须是预测发生时真正能够获得的信息。回测时把事后才知道的真实天气、真实产量传进去,会造成数据泄漏,让离线成绩显得过于乐观。
当前 SDK 文档列出的预测步长范围为 1---720 步,具体还要遵守所选模型的限制。"步"不是固定的时间单位:按小时采样时,24 步代表一天;按分钟采样时,24 步只代表 24 分钟。
3.2 异常识别:把实际表现与预期状态放在一起看
固定阈值适合监测明确的安全边界,却未必能覆盖所有异常。
例如,某台设备正常运行时温度一直在 50℃ 附近,突然升到 70℃。即使没有达到 80℃ 的告警线,这种变化也值得检查。相反,另一台设备在高负荷工况下短暂接近 80℃,可能符合它的正常运行规律。
基于模型的分析思路,是先建立预期状态,再观察实际值与预期的偏差。偏差持续扩大、周期形态明显变化,或多个测点之间原有的关系被打破,都可以成为进一步排查的线索。
不过,模型发现偏离,并不等于已经判断出故障原因。设备老化、工艺调整和传感器漂移,也都可能让原有基线失效。因此,动态分析适合与固定安全阈值、工况规则配合,而不是直接替代它们。
3.3 缺失填补:补齐分析输入,也要保留数据来历
采集链路中断后,历史曲线上会出现空洞。短时间缺失可以尝试插值,较长缺口则往往需要参考更广的上下文与相关变量。
Timer 相关技术可用于时序缺失填补,TimechoAI 的数据治理流程也涉及缺失数据处理。实际使用时,需要确认平台当前提供的具体方法,不能默认所有填补都由同一种大模型完成。
无论采用哪种方法,都应保留原始观测与估计值的区别。填补后的曲线再平滑,也不是设备当时真实采集到的数据。对长段缺失尤其如此:如果关键状态变化恰好发生在缺口里,任何方法都可能恢复不出真实过程。
3.4 不确定性分析:预测区间比一条线提供更多信息
如果两个模型都预测明天的温度为 72℃,但一个给出的范围很窄,另一个覆盖了接近告警阈值的高温区间,它们对运维决策的含义并不相同。
概率预测可以通过分位数或预测区间呈现这种差异,帮助使用者区分"中心预测看起来正常"和"高温风险值得关注"。
这里更准确的说法是"预测区间",不宜一概称为参数估计意义上的"置信区间"。同时,单个时间点的分位数也不能直接换算成"未来 72 小时内至少超温一次的概率";后者需要考虑整段轨迹的联合行为。
四、先在页面中验证,再把调用写进程序
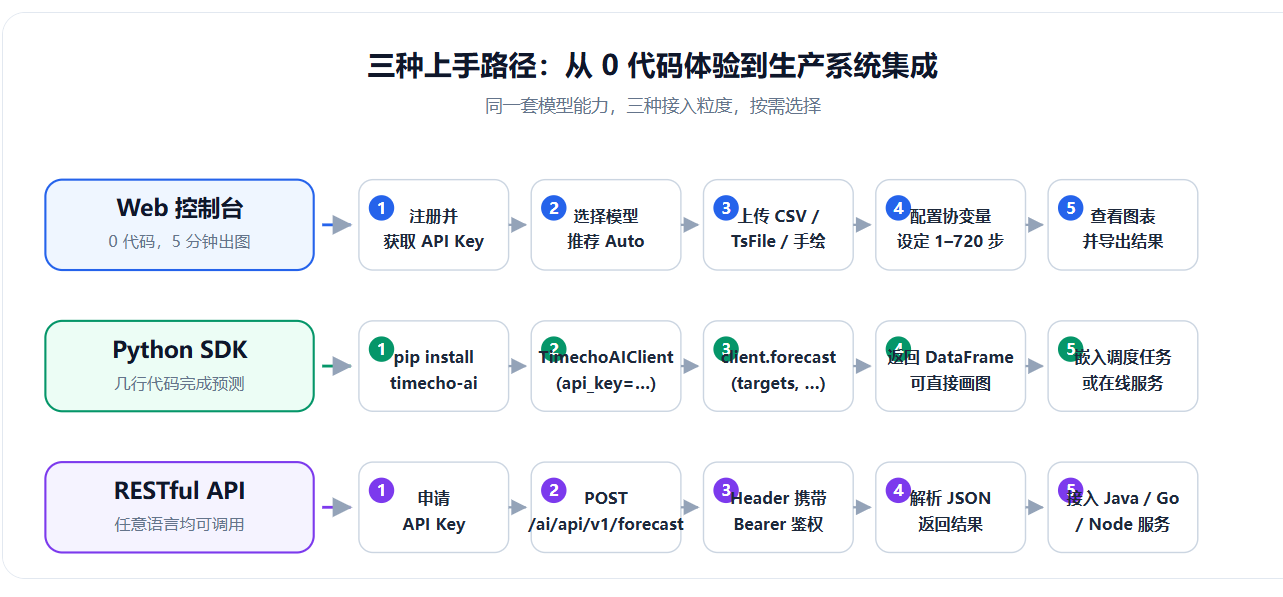
TimechoAI 提供 Web 控制台、Python SDK 和 REST API 三种常用接入路径。它们面向不同阶段:页面适合体验与验证,SDK 便于数据分析,HTTP 接口则方便连接其他技术栈。
4.1 Web 控制台:先跑通一条真实曲线
第一次使用,可以从一个边界清楚的小任务开始,例如预测一台设备未来一天的温度,而不是一开始就覆盖整个工厂。
基本过程如下:
- 访问 TimechoAI 平台,按当前页面要求完成注册或申请访问;
- 选择预测模型,暂时无法判断时可先尝试 Auto;
- 上传 CSV 或 TsFile,检查时间列、目标列及采样间隔;
- 根据任务配置协变量、预测起点和输出长度;
- 查看预测结果,并与留出的真实数据进行比较。
平台也提供示例数据,以及手动输入、绘制曲线等体验方式。手绘曲线有助于了解操作,但不能据此判断实际业务效果。真正的评估应使用来自目标场景的数据,并覆盖不同运行状态。
原文所涉及的模型选择,可以按以下思路理解:
| 模型或模式 | 可以怎样使用 |
|---|---|
| Timer-3.5 | 作为复杂场景的重点候选模型 |
| Timer-3.0 | 与新版本做对照,检查既有任务上的表现 |
| Chronos-2 | 引入另一类时序预训练模型作为参考 |
| AutoARIMA | 为较简单的序列建立统计方法基线 |
| Holt-Winters | 检验明显趋势和季节性是否已足以支撑预测 |
| Auto | 在初次体验时减少手动选择的负担 |
模型列表会随平台更新,页面选项与 SDK 支持范围也可能不同,具体以当前产品和文档为准。
4.2 Python SDK:明确目标列和预测边界
Python 用户可以通过 SDK 直接传入 DataFrame。以下示例按当前 PyPI 文档中的接口形式编写,与旧版示例的 targets、model 等参数有所区别。
先安装依赖:
bash
pip install timecho-ai pandas假设 CSV 中包含 time 和 temperature 两列,数据已经整理为连续、等间隔的小时序列。使用最近 168 小时预测未来 24 小时:
python
import os
import pandas as pd
from timecho_ai import TimechoAIClient

# 事先在环境变量中配置 API Key,不将密钥写入代码
client = TimechoAIClient(api_key=os.environ["TIMER_CLIENT_API_KEY"])

history = pd.read_csv("bearing_temperature.csv", parse_dates=["time"])
history = history.sort_values("time").tail(168)
forecast_start = history["time"].iloc[-1] + pd.Timedelta(hours=1)

results = client.forecast(
    data=history[["time", "temperature"]],
    target="temperature",
    time_col="time",
    output_start_time=forecast_start,
    output_length=24,
    model_id="auto",
)

prediction = results[0]
print(prediction.head())
这段调用中,最重要的是明确三个边界:哪些数据属于历史,预测哪一列,从什么时间开始预测。
如果要参考环境温度、风速和功率,应把这些列真正放进输入表,再声明它们的角色:
python
columns = ["time", "temperature", "ambient_temp", "wind_speed", "power"]

results = client.forecast(
    data=history[columns],
    target="temperature",
    history_cov=["ambient_temp", "wind_speed", "power"],
    time_col="time",
    output_start_time=forecast_start,
    output_length=24,
    model_id="auto",
)
这一示例要求 CSV 已包含上述数值列。不能只在参数中写出协变量名称,却不提供相应数据。未来协变量还需要覆盖对应的预测时段,并满足 SDK 对字段角色的要求。
代码用于展示接入方式,未在真实账户上执行。运行前需准备 API Key、符合要求的数据,并确认安装版本与服务端的模型支持情况。
4.3 REST API:把预测作为一个独立服务调用
如果业务系统使用 Java、Go 或 Node.js,没有必要为了调用模型而重写整个应用。
REST 接入的核心流程仍然是:从业务数据中整理输入,按接口要求携带认证信息发起预测请求,再解析输出并保存结果。区别只在于数据由 SDK 自动封装,还是由应用自己构造请求体。
这里不把 Python 参数简单改写成 JSON 示例,因为 SDK 侧的易用参数与 REST 协议字段不一定一一对应。实际集成时,应直接参考平台 API 文档中的请求格式、返回结构和版本要求。
上线还需要关注超时、限流、失败重试,以及重复请求是否会触发重复告警。能成功调用一次,只证明接入路径可用;它与生产环境中的持续稳定运行是两件事。
五、用风机主轴承温度串起一次完整应用
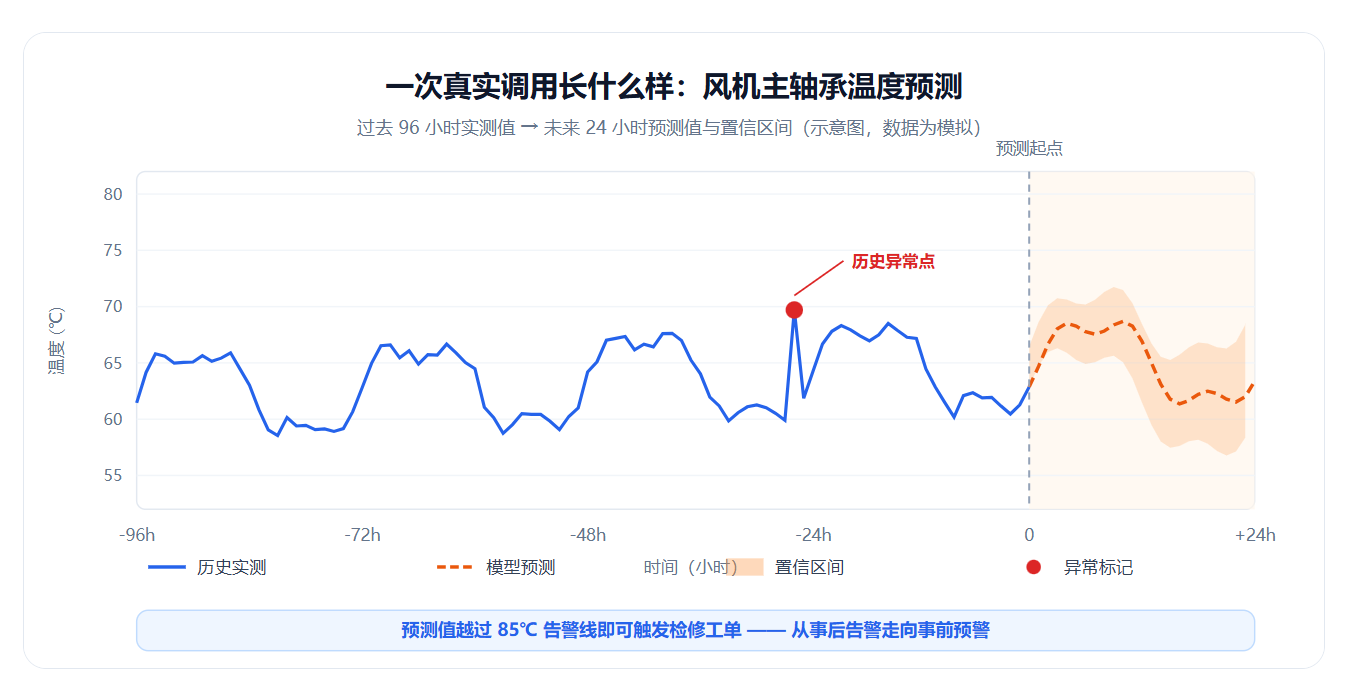
回到开头的例子。假设我们拿到了某台风机过去 96 小时的主轴承温度,以及同期的环境温度、风速和功率,希望预测未来 24 小时的温度趋势。
这个任务不需要一开始就追求复杂。先把目标定为:预测结果能否帮助运维人员更早注意到潜在高温风险。
第一步:保证输入对应同一段运行过程
四类测点应按相同时间尺度对齐。如果温度每小时记录一次,风速每分钟记录一次,就需要按业务含义聚合和对齐,而不是直接把两列拼在一起。
停机、检修、传感器更换等事件也需要结合现场记录判断。它们可能造成曲线突变,却未必属于应当删除的"脏数据"。
第二步:生成预测,并保留任务上下文
沿用前面的客户端,读取包含完整协变量的文件:
python
history = pd.read_csv("wind_turbine_history.csv", parse_dates=["time"])
history = history.sort_values("time").tail(96)
forecast_start = history["time"].iloc[-1] + pd.Timedelta(hours=1)

prediction = client.forecast(
    data=history[["time", "temperature", "ambient_temp", "wind_speed", "power"]],
    target="temperature",
    history_cov=["ambient_temp", "wind_speed", "power"],
    time_col="time",
    output_start_time=forecast_start,
    output_length=24,
    model_id="auto",
)[0]

print(prediction)
结果保存时,应同时记录机组编号、预测发起时间、输入窗口和模型配置。否则,同一台机组每小时滚动预测一次,很容易把不同批次的结果混在一起。
第三步:把预测转成待复核的风险提示
假设业务将 85℃ 设为一个检查参考阈值,那么可以观察:预测中心值是否接近阈值,高分位数是否触及阈值,以及升温趋势是否持续。
图中的历史实线用于说明设备已经发生了什么,预测虚线用于展示模型估计的后续走势,区间带则帮助判断估计的波动范围。这里的配图用于说明分析方式,并非本文实际调用产生的结果。
只做点预测的调用不会自动生成概率区间。需要区间时,应选择支持概率预测的模型,按对应接口请求分位数或覆盖率;返回对象也可能与普通 DataFrame 不同。
对风机这样的工业设备,更稳妥的早期用法是生成风险清单,让运维人员复核,再决定是否建立检查工单。不要仅凭一条模型预测就自动执行停机等高影响操作。
第四步:用后续实测验证提前量是否有价值
一天之后,真实温度出来了,还要回头检查模型有没有抓住变化。
除了 MAE、RMSE 等误差指标,运维场景更关心另外几个问题:真正的异常有没有被提前发现,提前量够不够安排人员,误报会不会让班组疲于应付。
模型曲线与实测曲线贴得更近,是值得关注的进步;能让现场更合理地安排检查,才是这项能力进入业务的理由。
六、TimechoDB 与 TimechoAI:让预测结果回到数据流程中
一次文件上传适合验证。如果每天都要对大量设备重复预测,手动导出、上传和复制结果就会成为新的负担。
TimechoDB 是基于 Apache IoTDB 的企业级时序数据库产品,承担采集数据的存储、查询和管理;TimechoAI 则提供模型相关能力。两者结合,可以把预测纳入已有的数据处理流程。
一条典型链路包括:
- 从数据库查询某台设备最近一段时间的目标与协变量;
- 完成采样对齐和必要的数据检查;
- 调用模型生成预测;
- 将预测值及任务信息写回独立的结果路径或表;
- 由监控页面、告警规则和工单系统读取这些结果。
TsFile 在这里提供了格式层面的衔接:它是 IoTDB / TimechoDB 的原生数据文件格式,也可以作为 TimechoAI 的数据输入方式,减少额外格式转换。
但共同使用一种格式,不等于云端调用天然实现"数据零搬运"。如果数据库与模型服务位于不同环境,数据传输、权限和网络成本依然存在。数据库内的 AINode 推理与外部云服务调用,也应作为不同的部署路径分别评估。
对实际工程来说,这种组合最值得追求的是少一些重复的数据处理,以及更容易追溯结果。某次告警来自哪个预测批次、使用了哪段历史、后来是否得到实测验证,都应该能够查清楚。
七、模型怎么选,最好让同一份数据来回答
时序大模型降低了使用预训练能力的门槛,但不意味着统计模型和专用深度学习模型已经失去价值。
对于规律稳定、季节性明显的序列,简单方法可能已经足够好;对于需要跨设备复用、工况复杂的任务,基础模型则值得重点尝试。
| 比较角度 | 统计模型 | 专用深度学习模型 | 时序基础模型 |
|---|---|---|---|
| 常见优势 | 计算相对轻量,便于建立基线 | 可围绕特定任务深度定制 | 利用预训练能力,便于尝试零样本预测 |
| 主要投入 | 模型假设、特征与参数选择 | 数据准备、训练与模型维护 | 数据适配、调用集成与效果验证 |
| 适合优先尝试的场景 | 趋势和季节规律较清楚 | 任务稳定且有充足训练资源 | 多场景探索、跨设备应用或快速验证 |
| 不确定性输出 | 部分方法有成熟支持 | 取决于模型设计 | 取决于所选模型与接口 |
| 上线后仍要做的事 | 监测误差与分布变化 | 监测误差并按需更新 | 监测误差、版本变化与调用成本 |
一个实用的评估顺序是:
- 先用最近值延续、季节性朴素预测或统计方法建立参考线;
- 再运行 Auto、Timer 或其他可选模型,保持预测窗口与评估数据一致;
- 如果差距有限,先检查数据质量、历史窗口和协变量,而不是立刻扩大训练规模;
- 如果初步结果有价值,再进入更多设备、更多工况的滚动回测;
- 最后将预测收益与服务成本、误报成本、维护工作量放在一起比较。
不要把模型排名当作选型结论,也不要把一次成功预测当作上线依据。 有代表性的历史回测和持续验证,比选到一个听起来最先进的模型更重要。
八、先解决一个值得预测的问题
对已经积累大量时序数据的团队而言,困难往往不在于还能不能多存一些数据,而在于如何把现有数据用于下一次行动。
TimechoAI 提供了一个可逐步深入的入口:先在页面中体验,再用真实数据比较效果,随后通过 SDK 或 REST API 接入现有系统。如果通用能力还不够,再考虑业务适配与模型训练。
这一过程不必从"建设完整的智能运维平台"开始。选一台关键设备、一类负荷任务,或者一个有明确补货决策的销量场景,把预测对象、时间范围和评价标准说清楚,就已经有了可验证的起点。
对于缺少算法人手的业务团队,云服务降低了试验门槛;对于已有数据平台的技术团队,它提供了补充分析能力的方式;对于 IoTDB / TimechoDB 用户,数据格式和数据库生态也提供了进一步整合的基础。
最终值得追求的结果,不是监控页面上多出一条预测线,而是团队能据此更早发现风险、更有依据地安排下一步工作。