写在前面
就像进公园第一步要先看地图一样,学习大模型应用开发也要先看地图。这篇文章是我描绘的一张大模型开发地图。(不完全版本)
一、自下而上构建的地图
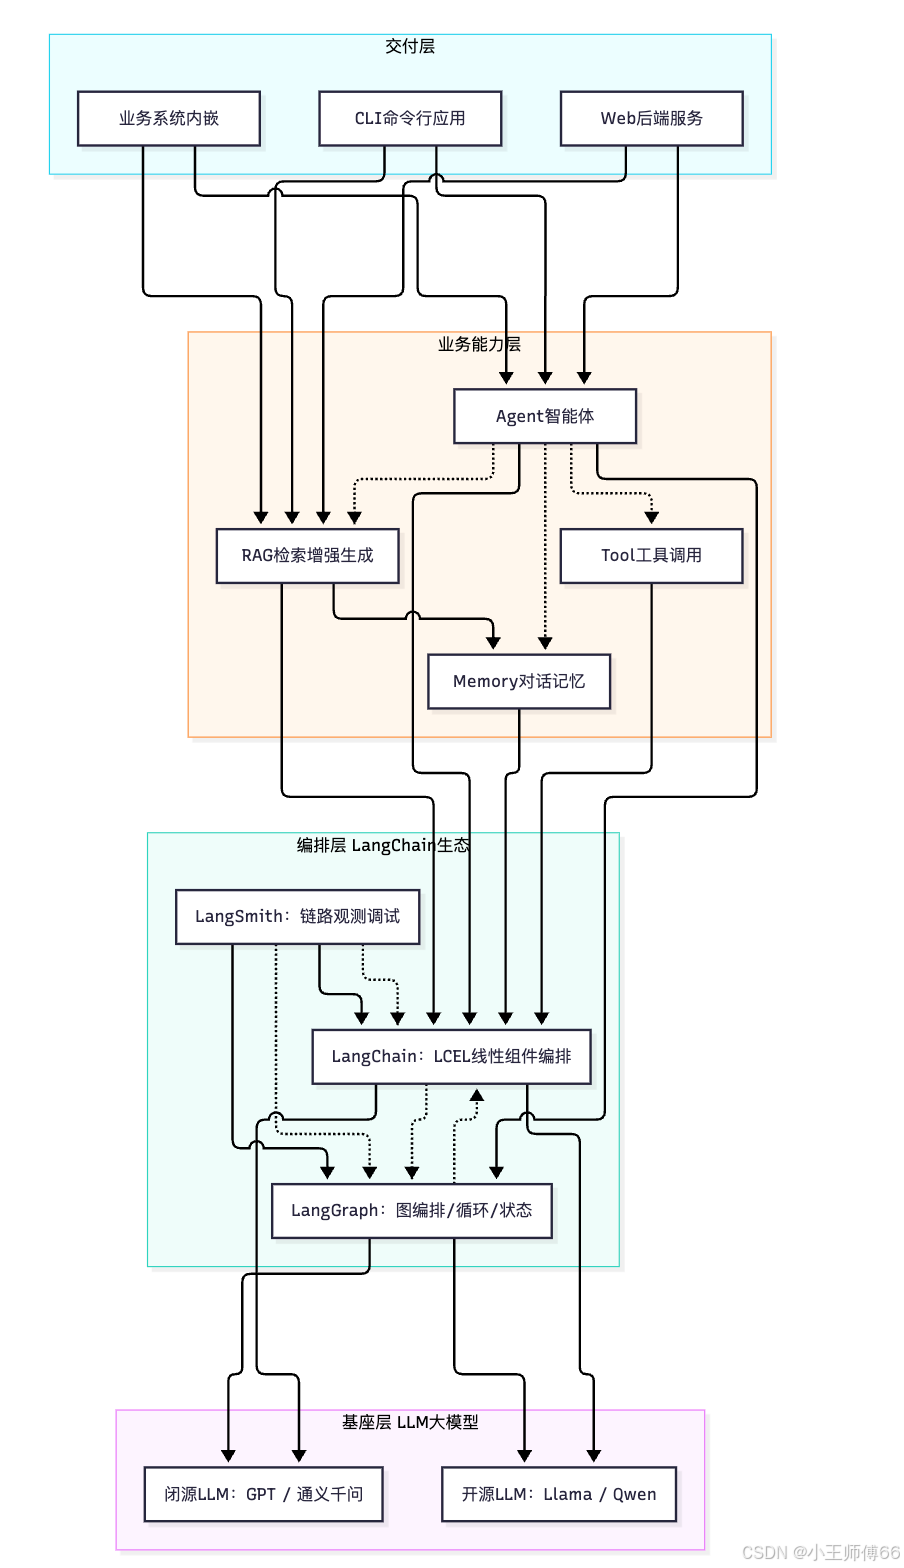
本分层是大模型应用落地的工程视角分层,面向 AI 应用开发者 。这样分层的原因是为了描述后面拿到现成 LLM 基座之后,如何一层层搭建 AI 业务应用;不是描述大模型预训练、模型训练体系 。
采用自底向上分层架构,下层为基础依赖,上层调用下层。图中包含两类关系:跨层垂直依赖 和同层水平组件协作。
-
实线
-->:跨层依赖关系(垂直方向) 上层组件运行,依赖下层提供基础能力,下层不知道上层的存在。整体依赖顺序:交付层 → 业务能力层 → 编排层 → 基座层。 -
虚线
-.->:同层组件协作关系(水平方向) 同一层级内的组件,可以按需互相组合、调用、复用,不是强制依赖。 -
二、逐层拆解
1、基座层(最底层):LLM 大模型 如通义千问、GPT、Qwen、Llama。
作为整套 AI 应用的语义推理与文本生成大脑,提供理解、推理、决策的基础能力;模型本身没有外部知识库、没有记忆,不能自主调用工具。
划分依据:所有上层 AI 能力都依赖 LLM 的推理能力,是整个应用的底层基座。
层内关系:开源 LLM、闭源 LLM 属于同类备选,项目中二选一使用,互相之间不存在调用关系。
2、编排层:LangChain 生态
- LangChain:组件库 + LCEL 线性链式编排,适合固定顺序流水线(RAG、顺序执行任务)
- LangGraph:LangChain 生态的图编排框架,支持分支、循环、状态持久化,用来实现 Agent(AI 自主决策、多次检索、多轮迭代)
- LangSmith:观测、调试、评估平台,LLM 应用领域的 APM 链路追踪系统
划分依据:属于开发框架与配套观测工具,提供组件抽象与执行编排能力,本身不具备业务功能,是搭建 AI 能力的基础设施。
层内协作:LangGraph 复用 LangChain 全部 Runnable 组件,二者可以互相嵌入;LangSmith 负责采集 LangChain 与 LangGraph 的链路数据,用于调试评估。
3、业务能力层:基于编排框架构建 AI 业务能力
- RAG 检索增强生成:外挂私有知识库,解决大模型幻觉、私有信息无法读取问题(本次 Demo 所用)
- Agent 智能体:大模型自主判断,动态选择调用工具、循环执行任务
- Tool 工具调用:调用外部 API、数据库、脚本等能力
- Memory 记忆:维护多轮对话上下文,实现连续对话
划分依据:使用编排层的框架组件组装出来,这一层定义应用拥有哪些 AI 业务功能。
层内协作:Agent 作为调度主体,可以按需调用 RAG、Tool、Memory;RAG 也可以搭配 Memory 实现带对话历史的知识库问答。
4、交付层
- CLI:交付给研发 / 运维人员,命令行直接交互
- Web 后端服务:包装成 HTTP 接口,交付给前端页面、其他服务调用
- 业务系统内嵌:把 AI 能力直接嵌入现有 Java 业务系统,交付给业务用户(运维、业务同学,无独立界面)
类比 Spring 视角,假设用 Spring 开发一个订单服务
- 业务能力:创建订单、查询订单(对应 RAG/Agent)
- Spring 框架:编排层(LangChain)
- 交付层:可以打成 Jar 本地 CLI 运行 / 发布 HTTP Web 接口 / 嵌入已有 ERP 系统。
划分依据:AI 能力的接入与包装形态,不改变底层 AI 能力本身;解决如何将已经实现好的 AI 能力交付给使用者。 交付对象:运维人员、业务用户、其他业务系统。
层内关系:三种交付形态是独立备选方案,互不调用。
三、生态演进推导图(业务痛点驱动演化)
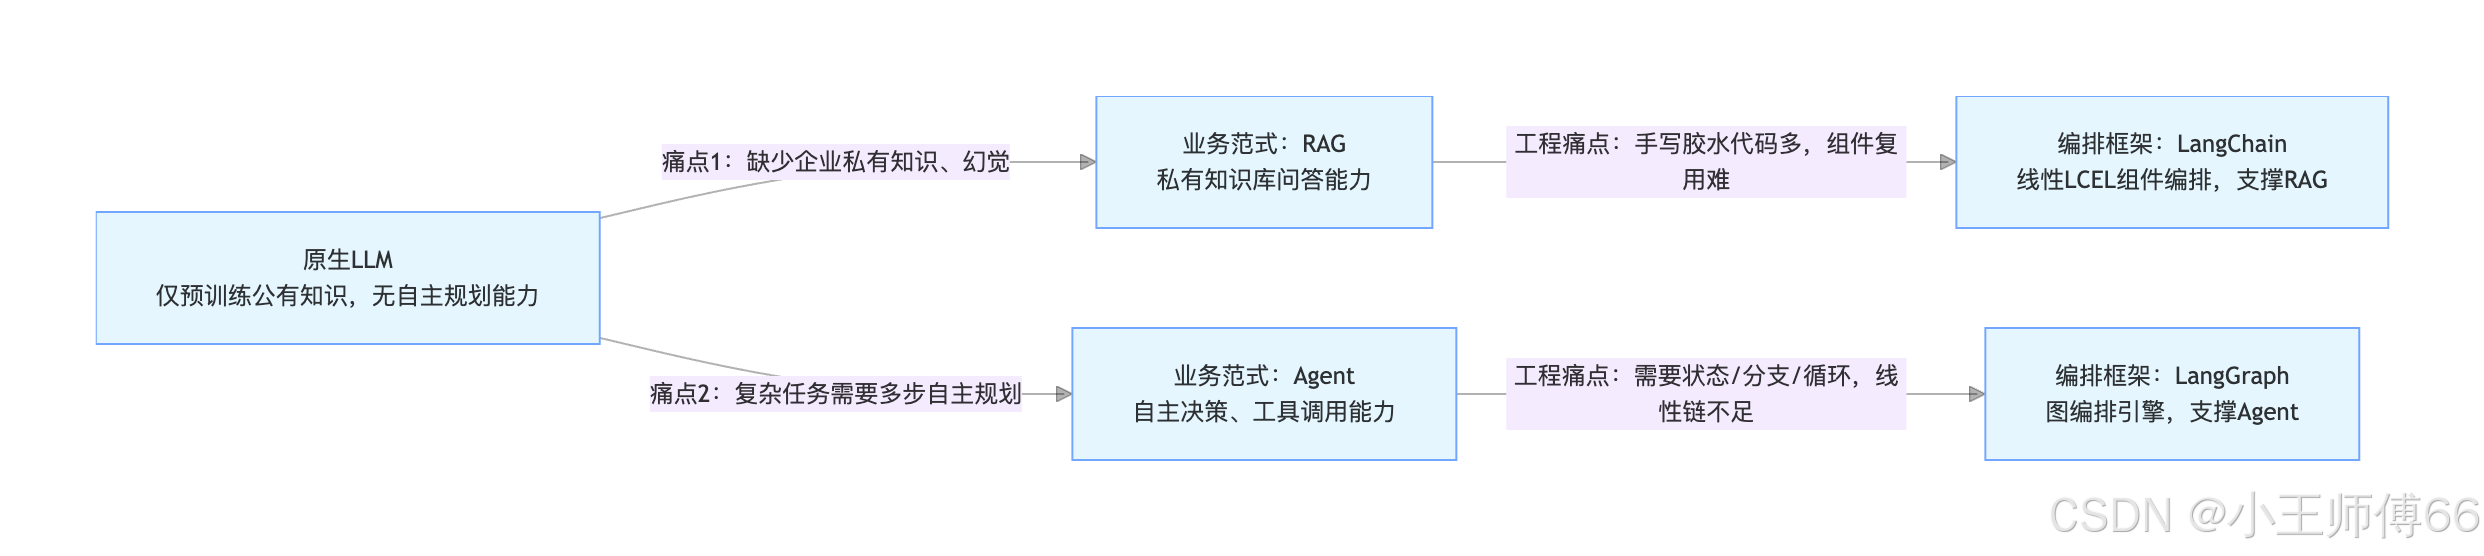
原生 LLM 能力有限,为了解决不同业务痛点,分别衍生出两类事物:业务能力范式和支撑范式落地的编排框架。
- RAG、Agent:属于业务能力范式,定义 AI 要具备什么能力;可以脱离框架手写代码实现。
- LangChain、LangGraph:属于编排框架,解决工程落地问题,用来承载上面的业务范式。
四、总结
基座层是AI 能力的大脑(LLM,语义推理生成);编排层是开发框架与观测工具,提供组件、编排执行链路;业务能力层是基于框架组装得到的 AI 功能模块;AI 能力对外暴露的接入形态,面向最终使用者。因为原生 LLM 能力有限,为了解决使用 LLM 时的不同业务痛点衍生出了两类事务:业务能力规范和实现这套规范的编程框架。