传统可观测性栈是三套系统起手:Prometheus 收指标,Loki 或 Elasticsearch 收日志,Jaeger 或 Tempo 收链路。三套系统三份运维,存储各管各的,想关联着查还要在应用层拼。GreptimeDB 的思路是把指标、日志、链路当成同一类数据:都是带时间戳的表,一个用 Rust 写的列式引擎统一吃下,SQL 查指标之外的一切,PromQL 查指标,长期数据放对象存储上。项目在 GitHub 上是 GreptimeTeam/greptimedb,Apache 2.0 协议,2026 年 10 月 star 数在 6700 上下,背后是同名的商业公司,社区版功能相当完整。
下面按架构、对象存储接入、部署验证的顺序展开,配置细节给全。只想先把它跑起来的,可以直接跳到「接 RustFS」那一节,配置原样复制就能用。读这篇只需要抓住 GreptimeDB 的一个核心取舍:把对象存储当默认持久层,而不是把数据锁在本地盘或专用存储集群里。
一个引擎吃下指标、日志、链路
GreptimeDB 对三种可观测性数据用的是同一个数据模型:都是表,都走同一个写入管道,都存在同一个列式存储引擎里。指标走 PromQL,日志和链路走 SQL,官方管这个定位叫 Observability 2.0。对使用者的意义是:Loki 迁过来的日志、Prometheus Remote Write 推过来的指标、OpenTelemetry 上报的链路,最后都落成同一套表结构,关联查询就是一句 JOIN。
接入协议覆盖得比较全:SQL(MySQL 和 PostgreSQL 线协议都能直连)、PromQL、Prometheus Remote Write、OpenTelemetry OTLP、InfluxDB line protocol,还有 Jaeger 兼容查询接口。对存量监控系统来说,切换成本主要在数据回填和告警规则迁移,客户端上报链路基本不用改。落地形态上,指标就是常见的时序表,日志表通常带一个 body 列配全文索引,链路数据落成 span 表,来源协议不同,最终都走同一条 insert 路径进表。
内置的运维能力是它的卖点之一:数据保留策略(TTL)、降采样、持续聚合,社区版都有,TTL 到期自动清,降采样和持续聚合负责把细粒度数据物化成粗粒度表,派生指标不用再搭一条数据处理链路。索引侧提供倒排、跳数和全文索引,分布式表还能按列值范围分区。存储引擎层面,默认的 Mito 引擎之外还有一个面向高基数指标的 Metric 引擎,同一份数据模型下按负载选引擎。
公平地说,对象存储这层 Loki 也在用,chunk 本来就往 S3 放。区别不在「用不用对象存储」,而在引擎统一度:Loki 只管日志,指标和链路还得另起系统,而 GreptimeDB 把三类数据的写入、索引、TTL、降采样收进一个引擎,查询面也统一成 SQL 加 PromQL。
存算分离:对象存储是主存储,但不是唯一状态
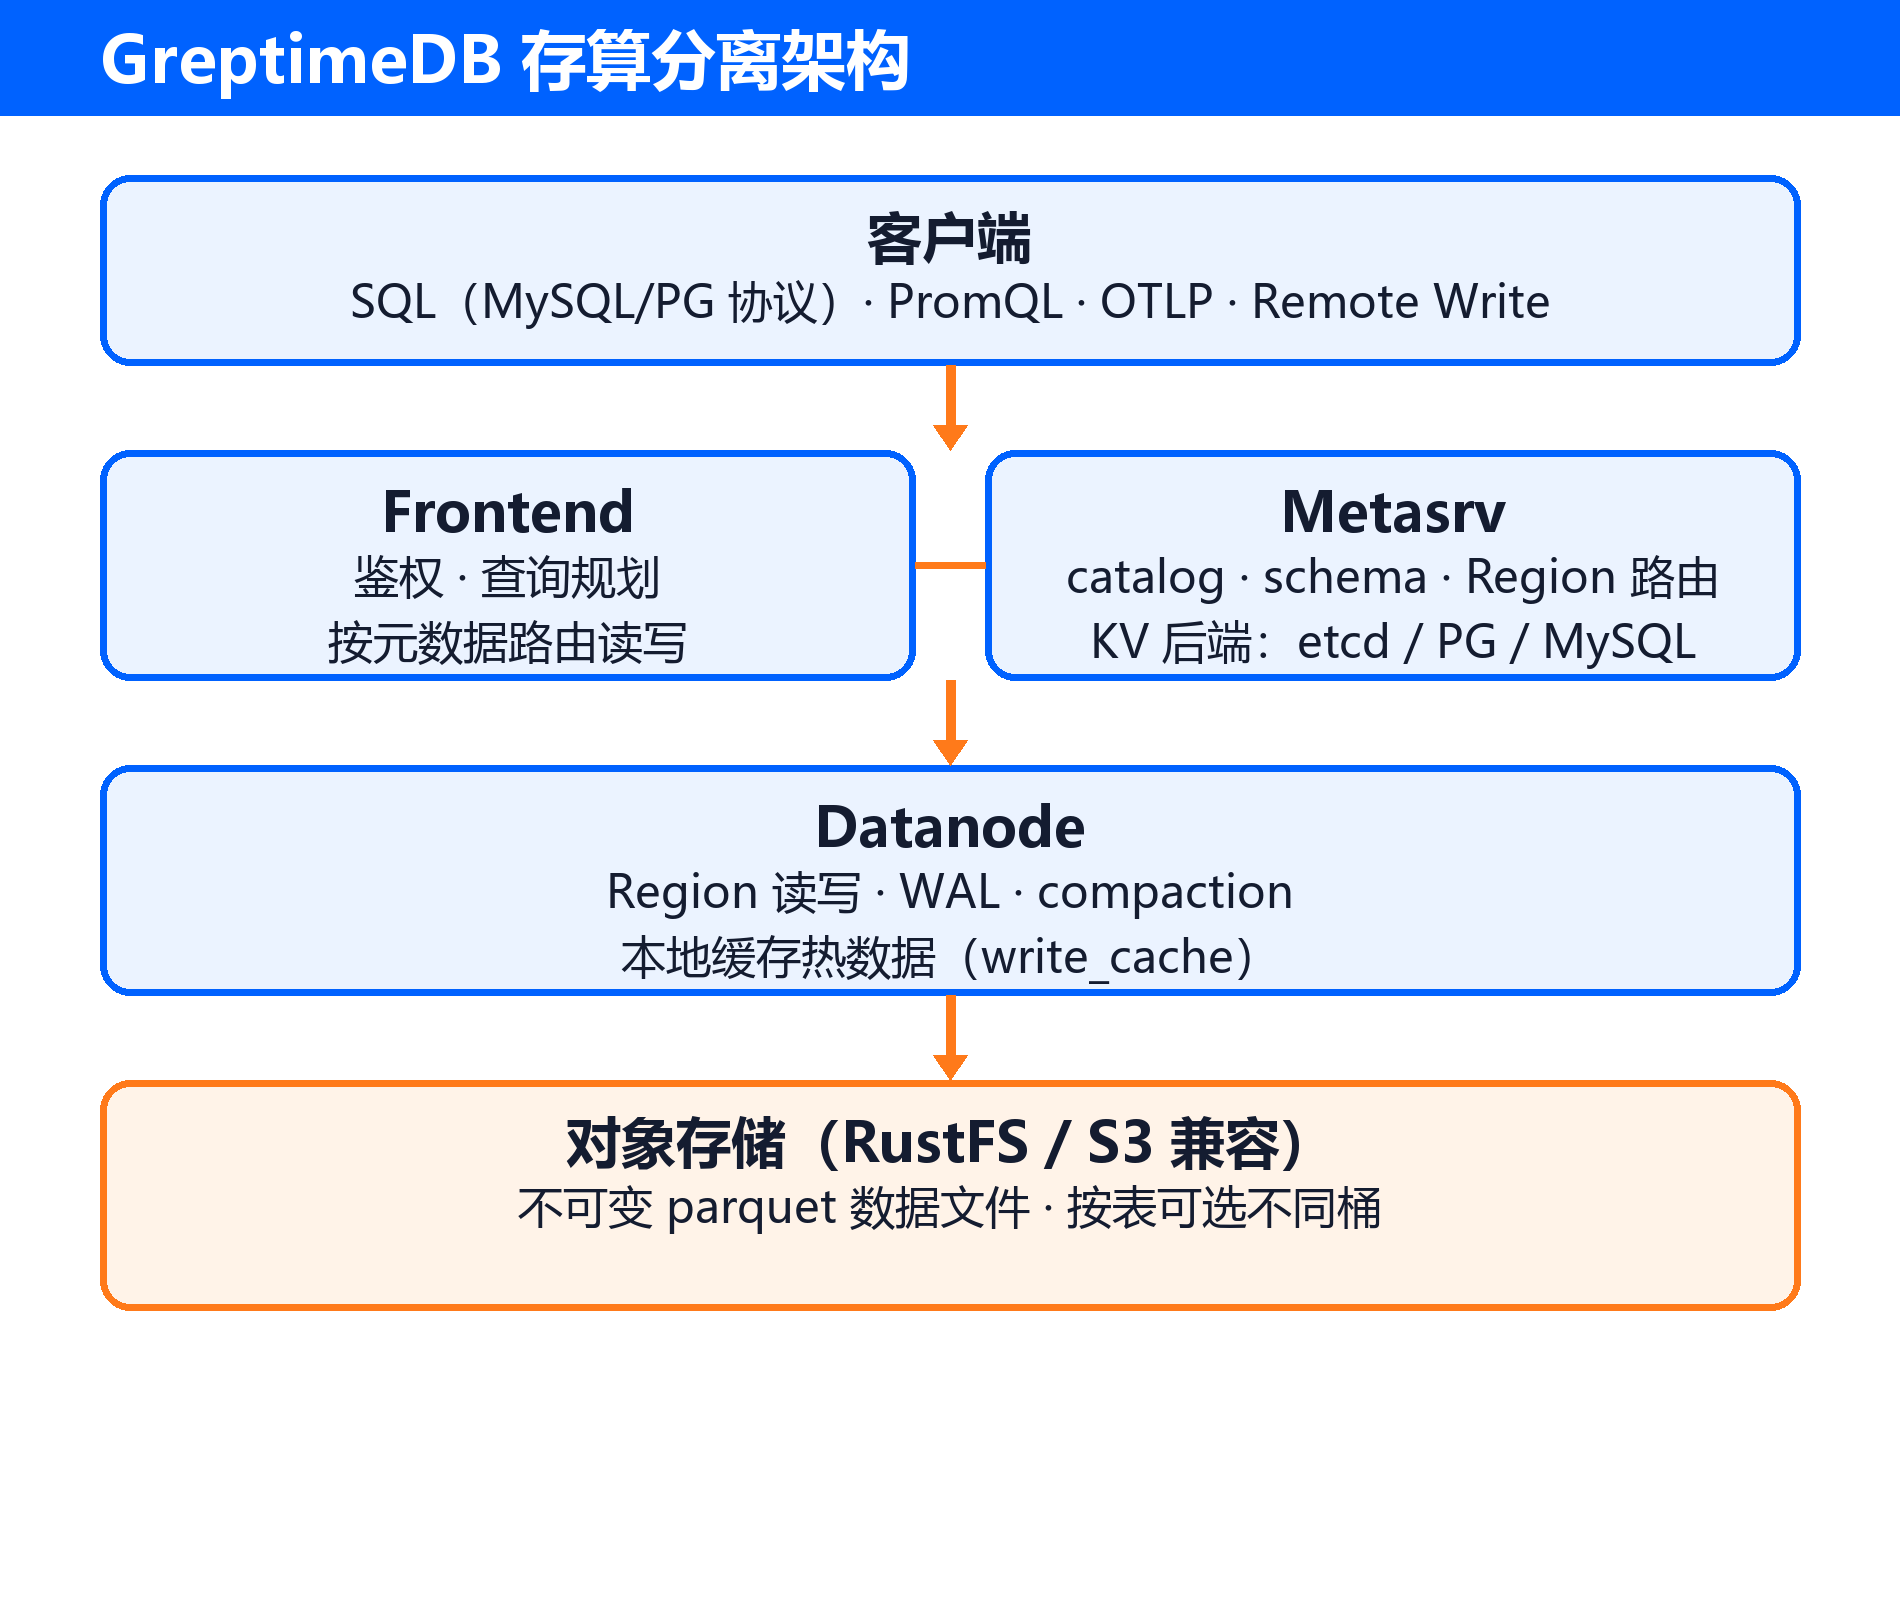
GreptimeDB 有两种跑法。Standalone 是一个进程包揽全部角色,适合开发和小规模;分布式模式拆成三个核心组件,再加一个可选的流计算运行时。
Frontend 接客户端协议、做鉴权和查询规划,按元数据路由读写;Metasrv 管 catalog、schema、表、Region 路由和调度元数据;Datanode 承载 Region、执行读写、跑 compaction(把小文件合并重写成大文件的后台任务),把不可变数据文件持久化到配置的存储后端。
Flownode(可选)跑 Flow 任务做持续计算,把派生数据物化到 sink 表,源表和 sink 表各自保有独立的 schema、TTL 和存储设置。
写入路径是标准的存算分离套路:Frontend 按元数据把数据行拆到承载目标 Region 的 Datanode,Datanode 先写内存和 WAL(写前日志,重启后靠重放它恢复还没落盘的写入),达到 flush 条件后把不可变数据文件写进存储后端。查询时 Frontend 规划、Datanode 执行,能用本地缓存就用本地缓存,最后 Frontend 汇总。
这里有个值得注意的设计声明,官方架构文档专门写了一句:对象存储不是系统中唯一的状态。WAL 记录已接收的写入,Metasrv 管集群元数据和路由,本地磁盘缓存远端数据。也就是说可用性和故障转移取决于三件事的组合:WAL 用哪种模式、Metasrv 怎么部署、Region 怎么放置。换成人话:对象存储解决了「数据不丢」,但「服务不中断」还是要自己设计 WAL 和元数据层的部署。集群部署模式下 Metasrv 需要一个 KV 后端,支持 etcd、PostgreSQL 和 MySQL,Standalone 则不需要。Region 是分布式模式下数据和负载的基本单元,一张大表按时间或列值切出多个 Region 摊到不同 Datanode 上,扩缩容和故障转移都发生在 Region 这一层。
对对象存储后端来说,它的写入模式算是天生友好:flush 产物是不可变的列存文件(parquet),对象存储上没有原地更新这回事,写入就是追加新文件,旧文件的生命周期由 compaction 管理。这正是对象存储最擅长吃的负载------大文件、顺序读写、不可变。
接 RustFS:从 storage 配置到部署验证
存储后端在配置文件的 [storage] 段里声明,支持本地文件、AWS S3 及一切 S3 兼容服务(官方文档点名 MinIO、腾讯云 COS、百度云 BOS 等)、阿里云 OSS、Azure Blob 和 GCS。接一个 S3 兼容后端的标准写法:
toml
[storage]
type = "S3"
bucket = "greptimedb-data"
root = "/greptimedb"
endpoint = "http://rustfs:9000"
region = "us-east-1"
access_key_id = "greptime-admin"
secret_access_key = "改成强密钥"两个对自托管友好的细节。第一,enable_virtual_host_style 默认是 false,也就是默认走 path-style 请求,http://rustfs:9000/bucket/key 这种形式,RustFS、MinIO 这类自建后端直连不用任何额外配置。第二,除了默认的 [storage],还能用 [[storage.providers]] 声明多个存储 provider,建表时通过 STORAGE 选项给不同的表指定不同的桶:热表和冷表、指标表和日志表分开存放,一个实例就能管多个桶。
缓存是对象存储后端的重头。官方给的读缓存配置是 mito 引擎里的两项:
toml
[[region_engine]]
[region_engine.mito]
write_cache_size = "10GiB"
enable_refill_cache_on_read = true
write_cache_size 是写缓存的容量上限,enable_refill_cache_on_read 开着时,查询遇到缓存未命中会自动把对象存储上的文件拉回本地缓存,后续访问就不再回源。官方文档的建议是默认行为已经合理,想省网络流量和存储成本再关。和这类存算分离架构的普遍现象一致:读体验高度取决于缓存命中率,热数据落在本地磁盘,冷数据访问则需要回源对象存储。
请求费用侧也可以按这个访问模式估:对桶的写入主要是 flush 时批量上传不可变文件,读取主要是查询时按需 Get 回源,命中本地缓存的部分不出网。时序负载写入吞吐大,flush 频率和对象数量随写入量线性走,compaction 会带来额外的读和写,容量规划时把对象数和请求量都按吞吐口径算,别只看存储字节数。
存储侧的配置和请求费用口径都清楚了,接下来把它部署起来实际验证一遍。standalone 模式下两容器就能跑通,一条 compose:
yaml
services:
  rustfs:
    image: rustfs/rustfs:latest
    restart: unless-stopped
    ports:
      - "9000:9000"
      - "9001:9001"
    volumes:
      - rustfs-data:/data
    environment:
      RUSTFS_ACCESS_KEY: "greptime-admin"
      RUSTFS_SECRET_KEY: "改成强密钥"
      RUSTFS_ADDRESS: ":9000"
      RUSTFS_CONSOLE_ADDRESS: ":9001"

  greptimedb:
    image: greptime/greptimedb:latest
    restart: unless-stopped
    depends_on:
      - rustfs
    ports:
      - "4000:4000"
      - "4002:4002"
    volumes:
      - ./greptimedb-standalone.toml:/etc/greptimedb/config.toml:ro
    command: standalone start --config-file /etc/greptimedb/config.toml --http-addr 0.0.0.0:4000 --rpc-addr 0.0.0.0:4001 --mysql-addr 0.0.0.0:4002

volumes:
  rustfs-data:
greptimedb-standalone.toml 就是上一节的 [storage] 配置。depends_on 只管启动顺序不等就绪,GreptimeDB 先起来连不上 RustFS 会靠 restart: unless-stopped 自动重试。端口上 4000 是 HTTP 和仪表盘,4001 是 gRPC,4002 是 MySQL 协议,4003 是 PostgreSQL 协议,上面只映射了常用的两个。这套 compose 只为本地验证,上生产还要补凭证管理、TLS、监控和分布式模式下 Metasrv 加 etcd 的部署。
验证数据真的落在 RustFS 上很简单:用任意 MySQL 客户端连 4002 端口建表写入,然后到 RustFS 控制台(9001 端口)看桶里有没有 greptimedb/ 前缀下的 parquet 文件:
sql
mysql -h 127.0.0.1 -P 4002

> CREATE TABLE demo_host (
    host STRING,
    cpu DOUBLE,
    ts TIMESTAMP TIME INDEX
  );
> INSERT INTO demo_host VALUES ('node-1', 0.42, '2026-10-11 12:00:00');
> SELECT * FROM demo_host;
GreptimeDB 的建表语法要求显式声明 TIME INDEX 列,这是它和普通 MySQL 库在 DDL 上的主要区别,其余 SQL 习惯基本平移。
成本口径与版本边界
第一,官方页面上的成本数字要按口径听:官网宣称对象存储加压缩能把存储成本降到原来的 1/50,还给了 OceanBase Cloud 从 Loki 迁移后 300TB 日志存储成本下降 60% 的案例,这些是官方口径和客户陈述,不是第三方 benchmark,自己的账要自己算。第二,standalone 模式进程挂掉时,写路径的恢复靠 WAL 重放,所以即便数据文件在对象存储上,WAL 放哪(本地盘还是远端)决定了重启后能不能把内存里没 flush 的写入捞回来,别把 WAL 和数据文件混为一谈。
第三,开源版和企业版有条能力分界线:读副本、工作负载隔离、自动重分区、Region 负载均衡在企业版,开源版跑大规模集群时,Region 的均衡和隔离要自己操心。第四,WAL 有本地、远端、Noop 三种模式,选型直接决定可用性和故障转移行为,上对象存储后端不等于可以随便关 WAL,这块要按官方 WAL 文档对场景过一遍。第五,分布式模式多一个 etcd(或 Postgres/MySQL)依赖,元数据层的运维复杂度是实打实的,小规模场景用 standalone 模式更省事。
什么团队适合
适合的场景:要把 Prometheus、Loki、Jaeger 三件套合并成一栈的团队;指标保留周期长、希望长期数据躺对象存储上的监控平台;已经在用 RustFS 或 MinIO 做数据湖、想让可观测性数据也进同一个桶的架构。采集侧不用另建管道,OpenTelemetry Collector 把 OTLP 直接指过来就行,Prometheus 的 Remote Write 也是原生接口。不合适的:纯实时告警对亚秒级写入延迟极其敏感的极端场景,先用自己工作负载压测再说;以及没有精力运维 etcd 和分布式元数据层的小团队,standalone 加对象存储是更务实的起点。
把它和 HelixDB 这类新一代数据系统放在一起看,趋势已经非常清楚:新一代数据系统不再自带存储集群,列存文件往对象存储一放,本地盘只做缓存。对象存储在这一代架构里的角色,从「归档层」变成了「主存储」。底座选一个 S3 协议实现扎实、Apache 2.0 开源的对象存储,上面跑什么引擎都有的换,RustFS 在这类组合里就是干这个的。
源码在 github.com/GreptimeTeam/greptimedb,中文文档在 docs.greptime.cn。RustFS 的 Docker 部署见 docs.rustfs.com,仓库在 github.com/rustfs/rustfs。