一文看懂大模型推理为什么需要多卡:从 TP、DP 到 Runtime 的完整演进
 作 者:吴佳浩(Alben)
引言:
并行度不是加速器,是分账方式:拆得越细,省下来的搬运越少,要付的通信账越多------所以「能不能拆」和「值不值得拆」,是两个问题。 先摆一个现象:两张 RTX 5090 开 TP2,通常拿不到两倍,甚至可能更慢。这不是驱动没调好,也不是框架不行------它是整条推理栈的分账逻辑。
阿拉把这条线从 TP 一路白相相到 Runtime,看看到底是卡越多越结棍,还是账算得越清越结棍。
🔸 一、三个被问烂了的问题
三个问题,我一年被问几十次:
- 我有两张 RTX 5090,为什么开 TP2 没有快两倍?
- 模型一张卡已经放得下了,为什么还要 Tensor Parallel?
- 大模型集群是不是就是一大堆 GPU 一起算同一个请求?
三个问题的答案指向同一个事实:大模型推理里的「多卡」不只有一种方式,不同的并行方式解决的是完全不同的问题。
混为一谈,就会得出「多卡 = 线性加速」这种直觉。而这个直觉在推理场景里几乎总是错的。 读完全文,你会知道每种并行各自在解决什么、代价落在哪、什么时候该用。
🔸 二、集群其实只解决三件事
GPU 集群的存在,不是为了「更快」。它是为了:
text
① 放得下模型        → TP / PP / EP
② 服务更多用户      → DP(多副本)
③ 支撑更长上下文    → CP
后面出现的每一个缩写,都只是这三个目标之一的实现手段。
再往下挖一层,你会发现整个推理 Runtime 的设计,本质上只有两个目标。
减少数据移动,提升 GPU 利用率。
原因很简单:Decode 是 Memory Bound,GPU 的算力大部分时间在等数据(第三章会用一张 Roofline 图把这件事讲清楚)。所以不管是并行方式,还是调度、KV Cache 管理,几乎所有设计都在回答同一个问题:怎样让每一次从显存搬来的字节,干更多的活?
| 技术 | 表面上解决什么 | 本质上在做什么 |
|---|---|---|
| TP | 放得下 | 让每卡少读权重(代价:增加通信) |
| DP | 服务更多用户 | 副本互不等待,减少排队与同步 |
| EP | 放下 MoE | 让每个专家的权重读一次、服务更多 token |
| PP | 放得下 | 分摊模型容量 |
| CP | 长上下文 | 分摊 KV Cache |
| Continuous Batching | 调度 | 消除空转,提高利用率 |
| PagedAttention | KV 管理 | 减少显存浪费与碎片,装下更大 batch |
| Prefix Cache | 复用 | 不重复计算、不重复搬运相同前缀 |
我希望你带走的不是五个缩写,而是这一条主线。
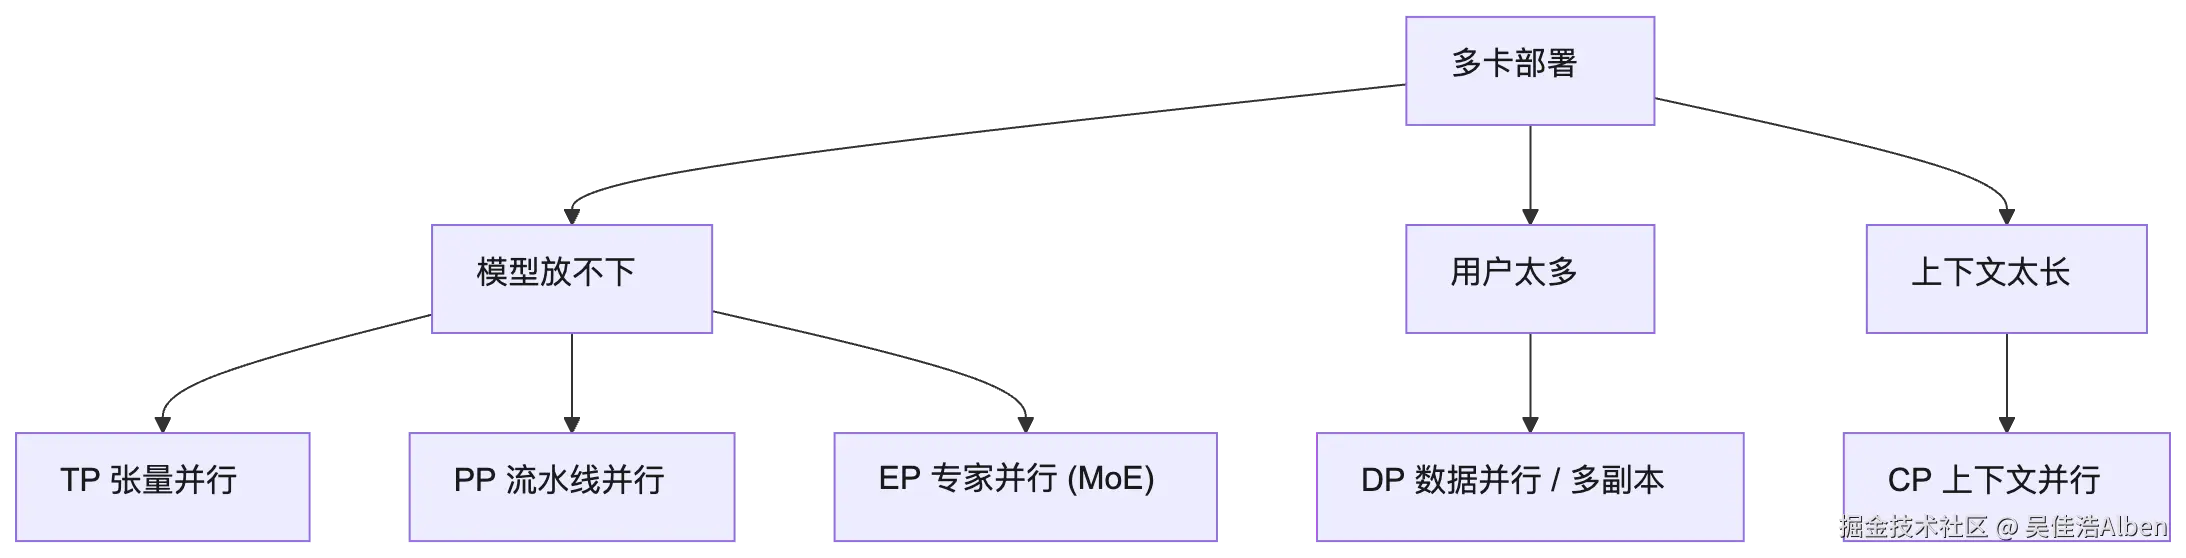
一句话对照:
| 问题 | 主要方案 | 本质 |
|---|---|---|
| 单层权重太大、单卡放不下 | TP | 把每一层的矩阵切开,多卡合力算一层 |
| MoE 专家总量太大 | EP | 把不同专家放到不同卡 |
| 网络层数太深、跨节点带宽不足 | PP | 把不同层放到不同卡,流水线接力 |
| 请求太多 | DP | 复制多份模型,各服务一部分请求 |
| 单个请求上下文太长,KV Cache 撑爆显存 | CP | 把序列切开,分到多卡 |
注意一个关键区别:TP/PP/EP/CP 是把「一个实例」拆到多卡上,DP 则是「多个实例」各自独立。 前者引入通信,后者(推理中)几乎不需要通信。这是理解后面所有内容的钥匙。
🔸 三、TP2 为什么没快两倍
这一节是全文最重要的。
很多人把 Tensor Parallel 理解成「两张 GPU 一起算,所以应该快两倍」。实际上 TP 从来不是为了线性加速设计的:它本来就是为了解决「模型放不下」,性能提升只是副作用。
3.1 TP 到底切了什么
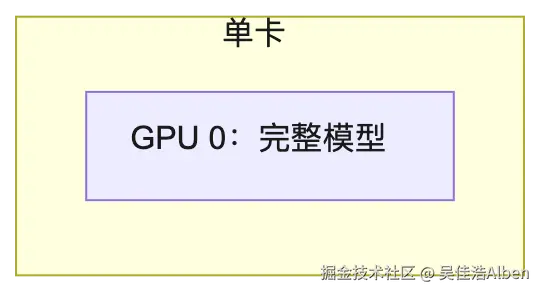
单卡时,整个模型都在一张 GPU 上:
TP2 时,每一层的权重矩阵被切成两半(Megatron-LM 的经典切法:Attention 按注意力头切,MLP 的第一个矩阵按列切、第二个矩阵按行切):
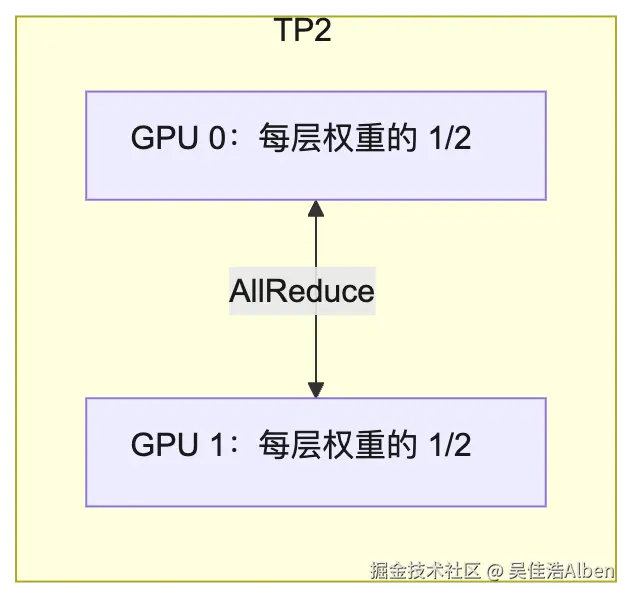
代价是:每个 Transformer 层的前向,需要做 2 次 AllReduce(Attention 输出之后一次,MLP 输出之后一次),把两张卡各自算出来的部分和加起来。
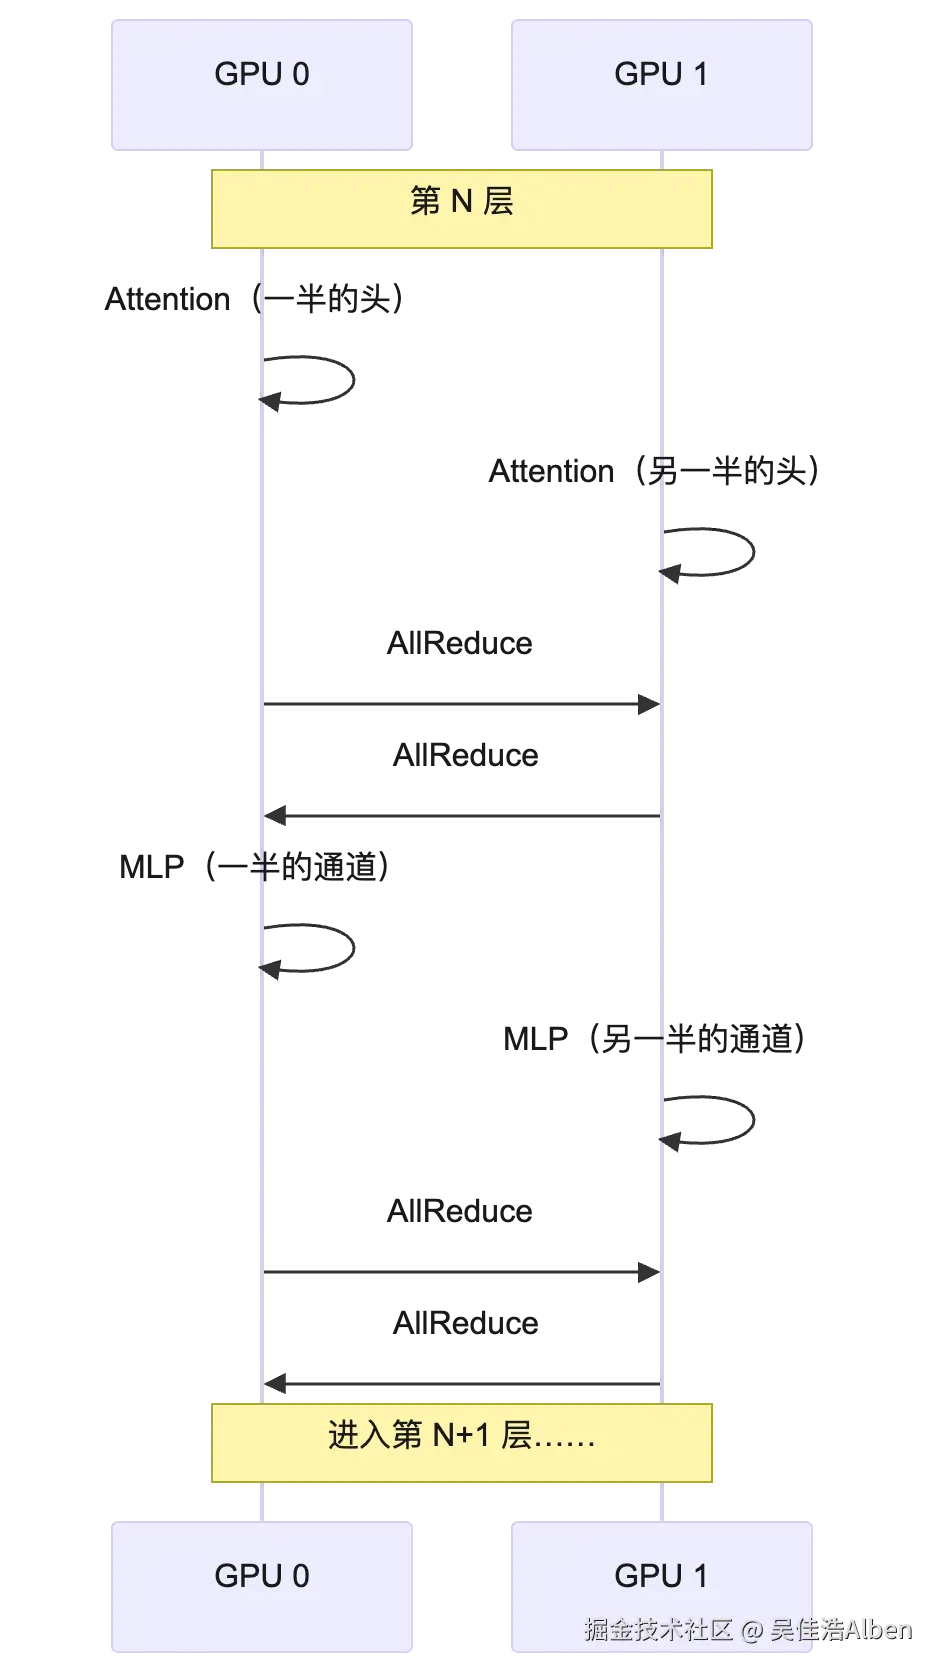
一个 32 层的模型,生成每一个 token 就要做 64 次 AllReduce;80 层的模型是 160 次。
为什么是每层两次,而不是整个网络只做一次? 因为数据依赖:
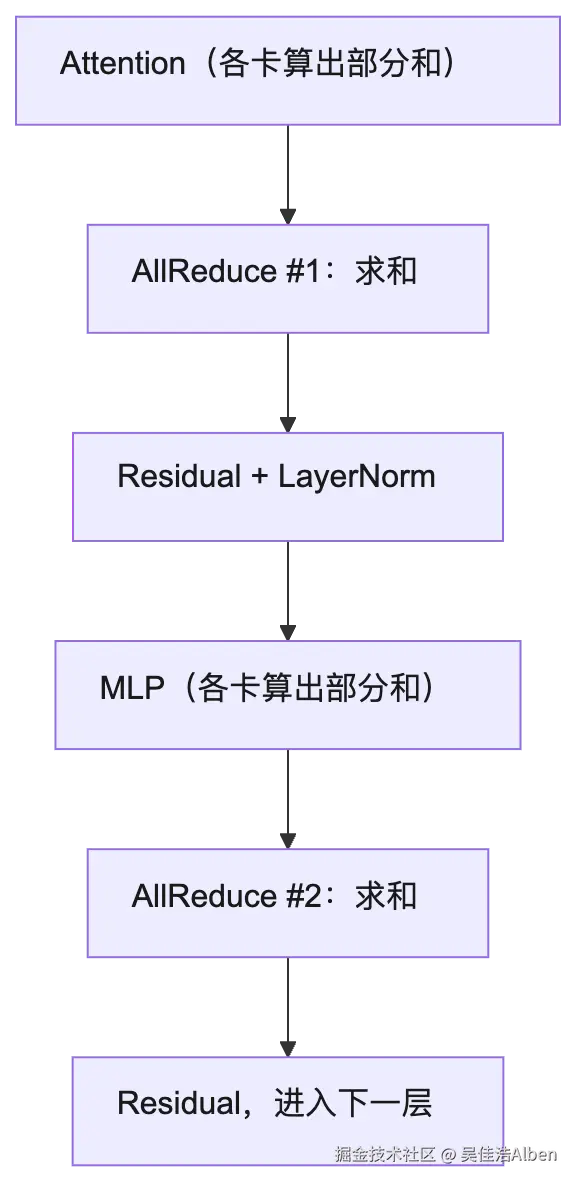
LayerNorm 需要拿到完整的隐藏向量才能算对,而各卡手里只有部分和,所以 Attention 之后必须先同步一次;MLP 之后同理,不同步下一层的输入就是错的。Megatron-LM 的切法(第一个矩阵按列切、第二个矩阵按行切)已经保证了 MLP 内部的非线性激活不需要同步,所以每层刚好压到最少的 2 次。
3.2 收益和代价,互相抵消
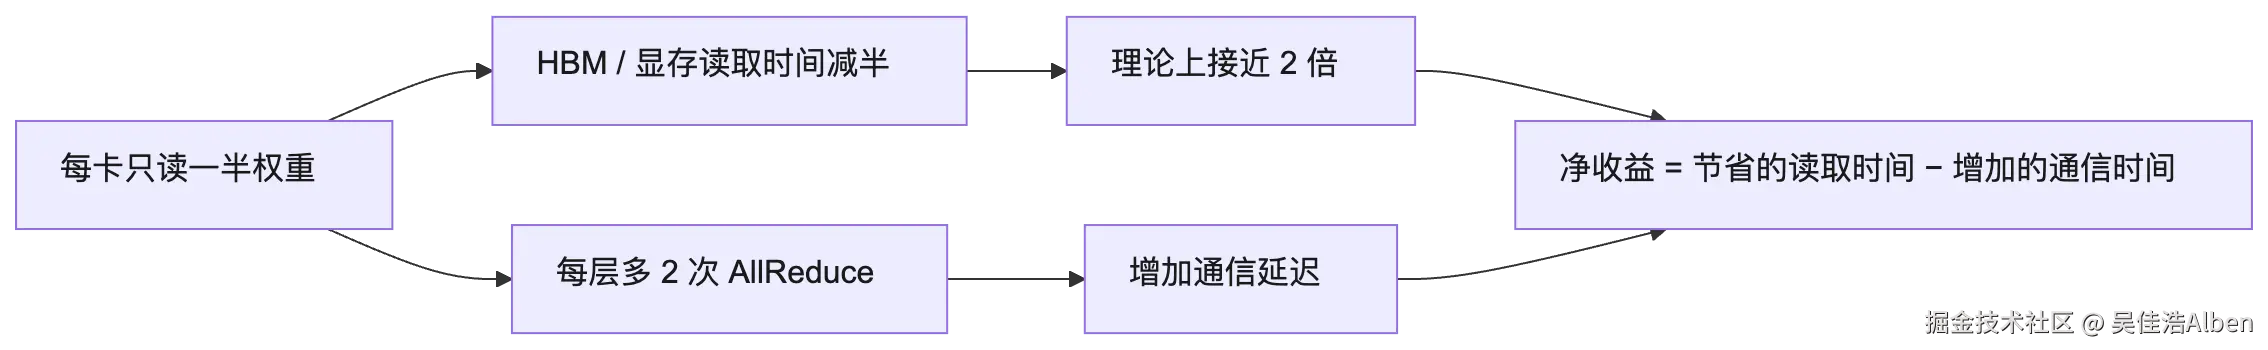
所以 TP2 的净收益取决于一个减法:省下来的显存读取时间,减去新增的通信时间。
3.3 Decode 为什么卡在带宽上
要理解「省下来的读取时间」为什么重要,得先看 Decode 的本质。
生成一个 token 时,模型的每个参数需要参与约 2 次浮点运算(一次乘、一次加),但每个参数(BF16)需要从显存里读 2 字节。在 batch 为 1 的情况下:
算术强度 ≈ 1 FLOP / 字节
而 GPU 的「拐点」远高于此。以 H100 SXM 为例:
🔸 BF16 稠密算力约 989 TFLOPS 🔸 HBM3 带宽约 3.35 TB/s 🔸 拐点 ≈ 989 / 3.35 ≈ 约 300 FLOP/字节
也就是说,在 H100 上,batch 要达到几百量级,Decode 才会从「受限于带宽」变成「受限于算力」。对单个请求或小 batch 来说,Decode 是典型的 Memory Bound:GPU 的算力大部分在等数据,瓶颈是把权重从显存搬到计算单元的速度。
用一张 Roofline 图把它画出来(H100 SXM,BF16 稠密):
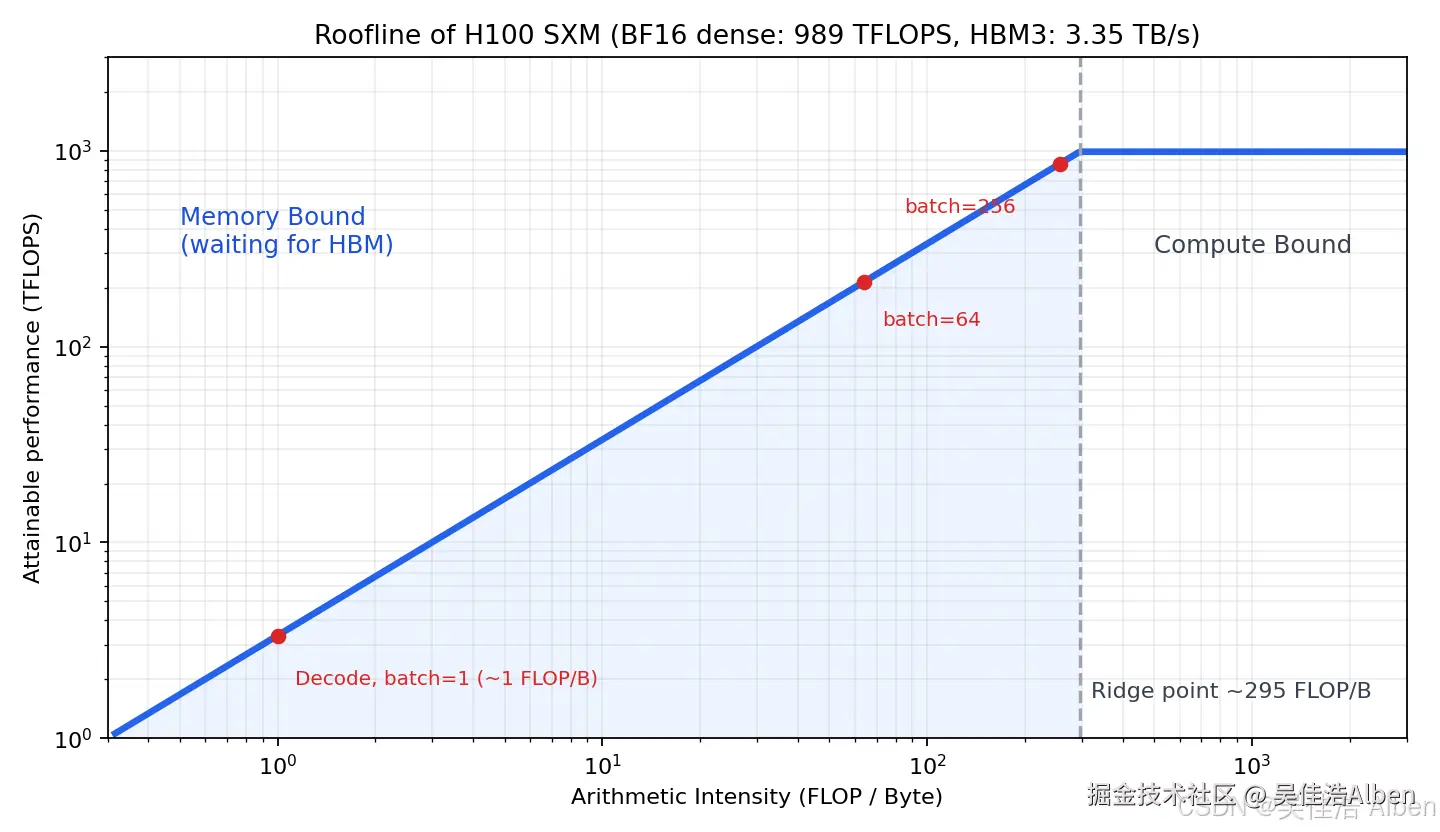
要点:
🔸 横轴是算术强度(每搬 1 字节做多少次浮点运算),纵轴是实际能达到的算力 🔸 batch=1 的 Decode 位于约 1 FLOP/B 处,只能发挥约 3.35 TFLOPS,仅为峰值 989 TFLOPS 的约 0.34% 🔸 拐点在约 295 FLOP/B,Decode 离 Compute Bound 还差两个多数量级 🔸 增大 batch 会沿着斜线向右上移动,这正是 Continuous Batching 和 DP/EP 提升利用率的原理
(图中「算术强度 ≈ batch」是对权重读取的简化:BF16,忽略 KV Cache 与激活的读取。)
这就带来一个直接的结论:Decode 的单 token 延迟,约等于「权重字节数 ÷ 显存带宽」。 TP 把每卡要读的字节数减半,确实能让这一项减半。
3.4 算一笔账:8B 模型,两张 5090
先给出硬件事实:
🔸 RTX 5090:32 GB GDDR7,显存带宽约 1.79 TB/s,接口 PCIe 5.0 x16(单向约 64 GB/s) 🔸 消费级 GeForce 卡不提供 NVLink,卡间通信走 PCIe 🔸 显存带宽是 PCIe 带宽的 约 28 倍
以 Llama-3-8B 为例(BF16,权重约 16 GB,32 层,hidden size 4096):
| 项目 | 单卡 | TP2(每卡) |
|---|---|---|
| 每 token 读取权重 | 约 16 GB | 约 8 GB |
| 读取时间(权重 ÷ 1.79 TB/s) | 约 8.9 ms | 约 4.5 ms |
| AllReduce 次数 / token | 0 | 64 次(32 层 × 2) |
| 通信时间(假设每次 20~50 μs) | 0 | 约 1.3~3.2 ms |
| 合计(理想估算) | 约 8.9 ms | 约 5.8~7.7 ms |
| 相对加速 | 1.0× | 约 1.2~1.5× |
有一条口径要先说清:以上是 batch=1、忽略 KV Cache 读取与 kernel 启动开销的粗略估算 ,只用来说明量级,不是实测数据。每次 AllReduce 的 20~50 μs 是对 PCIe 互联小消息延迟的假设------batch=1 时每次只传 hidden size × 2 字节 ≈ 8 KB,这类小消息拼的是延迟,不是带宽。实际数值取决于主板拓扑、驱动是否启用 P2P、NCCL 版本等,若经主机内存中转,会更慢。
结论很清楚:TP2 的通信开销是一笔「固定税」,随层数线性增长;模型越小、互联越慢,这笔税占比越高,加速比就越离 2× 越远。
对比之下,在 NVLink 互联的数据中心 GPU 上(H100 的 NVLink 4 带宽为 900 GB/s,双向合计),通信税小得多,所以 TP8 在 DGX/HGX 节点上是常态。
3.5 Prefill 和 Decode,两个阶段两种命
| Prefill | Decode | |
|---|---|---|
| 一次处理的 token 数 | 很多(整段 prompt) | 每个请求 1 个 |
| 算术强度 | 高 | 低 |
| 瓶颈 | 偏 Compute Bound | 偏 Memory Bound |
| TP 的效果 | 算力被均分,通常扩展性较好 | 读取减半,但被通信抵消,扩展性差 |
| AllReduce 消息大小 | 大(带宽型,吃满带宽) | 小(延迟型) |
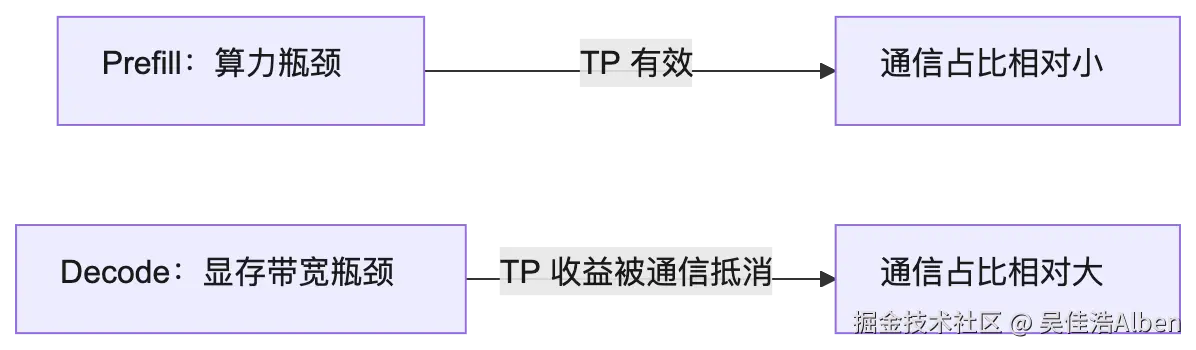
这也是 Prefill/Decode 分离部署(Disaggregated)会出现的原因:两个阶段的瓶颈不同,最优并行策略也不同。
3.6 公平起见:TP2 多出一块 KV 池
公平起见,TP2 有一个常被忽略的好处:可用显存翻倍。
仍以 8B 模型、5090(32 GB)为例:
🔸 单卡:32 GB − 16 GB 权重 ≈ 16 GB(还要扣除激活值等),留给 KV Cache 🔸 TP2:2 × 32 GB − 16 GB 权重 ≈ 48 GB,留给 KV Cache
KV Cache 每 token 的占用是 2 × 层数 × KV头数 × 头维度 × 字节数。Llama-3-8B(32 层、8 个 KV 头、头维度 128、BF16):
2 × 32 × 8 × 128 × 2 = 131,072 字节 = 128 KB / token
所以 16 GB 约能存 12 万 token,48 GB 约能存 37 万 token。如果你的场景是长上下文、高并发,TP2 换来的更大 KV Cache 池,可能比那点延迟收益更有价值。这一点,下一节会用到。
🔸 四、放得下,为什么反而不用 TP
两张 GPU,两种部署方式:
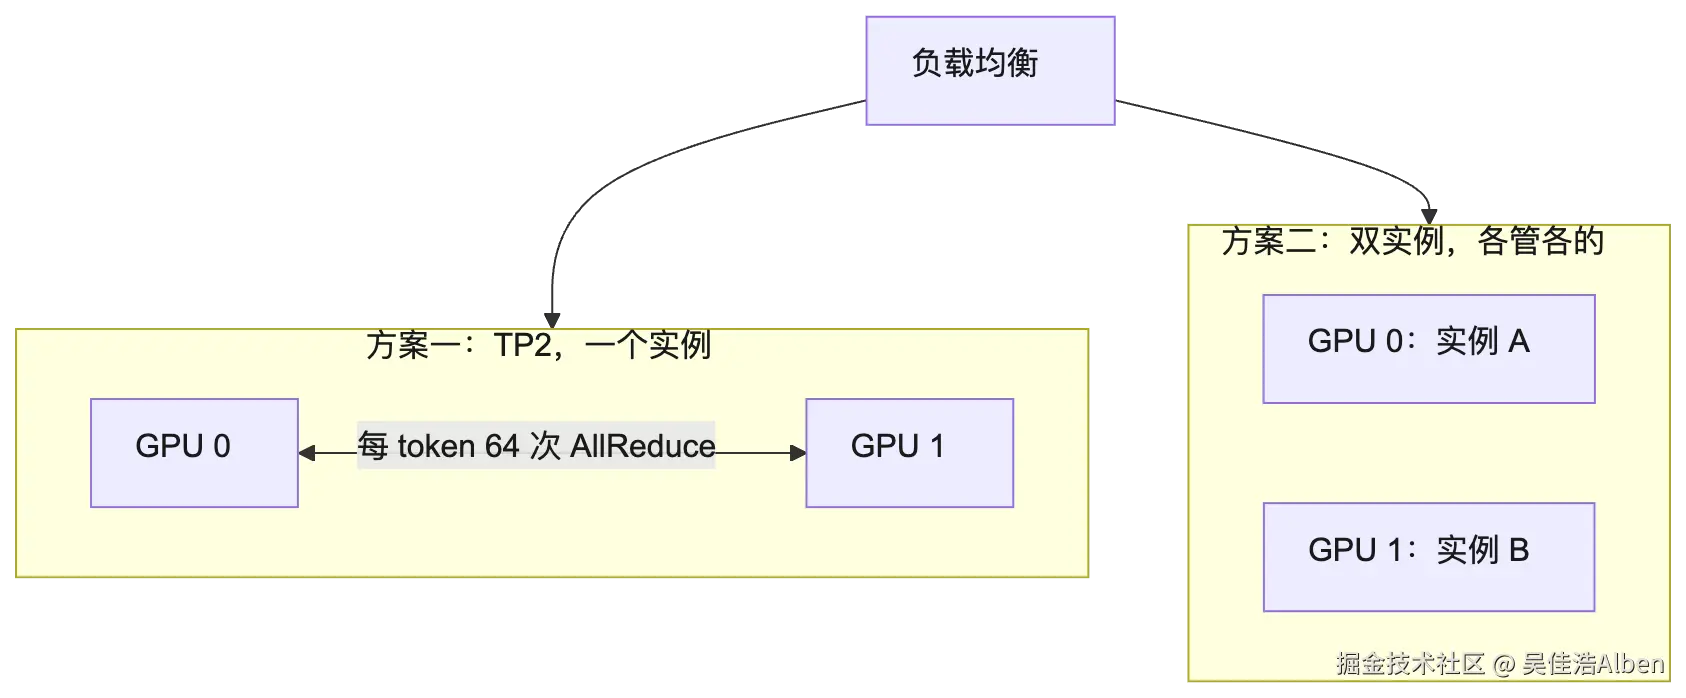
| TP2(一个实例) | 双实例(DP2) | |
|---|---|---|
| 单请求延迟 | 略好(如上例约 1.2~1.5×) | 与单卡相同 |
| 总吞吐 | 提升有限 | 接近 2× |
| 卡间通信 | 有,每层 2 次 AllReduce | 无 |
| 依赖 NCCL | 是 | 否 |
| 故障影响面 | 一张卡出问题,整个实例挂 | 只影响一个实例 |
| KV Cache 池 | 合并,更大 | 各自独立,较小 |
吞吐为什么接近 2×?因为两个实例完全独立,互不通信,各自把自己那张卡的带宽用满,总处理能力就是两者之和(前提是请求足够多,且负载均衡合理)。
所以,在模型单卡放得下 、业务目标是服务更多用户(看重吞吐、成本、稳定性)时,「一卡一实例 + 多副本」往往比 TP2 更划算。
经验规则:
TP 是「放不下」时的必需品,不是「想更快」时的首选项。能用更少的卡放下一个实例,就用更少的卡;剩下的卡用来多开副本。
当然,如果你的业务有严格的单请求延迟要求(比如交互式场景要把首 token 延迟和每 token 延迟压到极低),或者长上下文需要大 KV 池,TP 仍然有它的位置。这是工程权衡,不是教条。
🔸 五、那云厂商为什么还在用 TP
因为一旦模型规模上去,TP 就不再是「优化」,而是必须。
先看权重本身(只算权重,不含 KV Cache 和激活):
| 模型 | 参数量 | BF16 权重 | 常见部署 |
|---|---|---|---|
| Llama-3-8B | 8B | 约 16 GB | 单卡即可 |
| Llama-3-70B | 70B | 约 140 GB | 至少 2 张 80 GB 卡,常用 TP4 / TP8 |
| Llama-3.1-405B | 405B | 约 810 GB | 单节点 8×H100(640 GB)放不下 BF16;Meta 提供 FP8 版本,可放进单个 8 卡节点 |
| DeepSeek-V3 | 671B(每 token 激活约 37B) | FP8 约 671 GB | 多节点 |
再看一个极端情况:权重 1 TB 的模型。
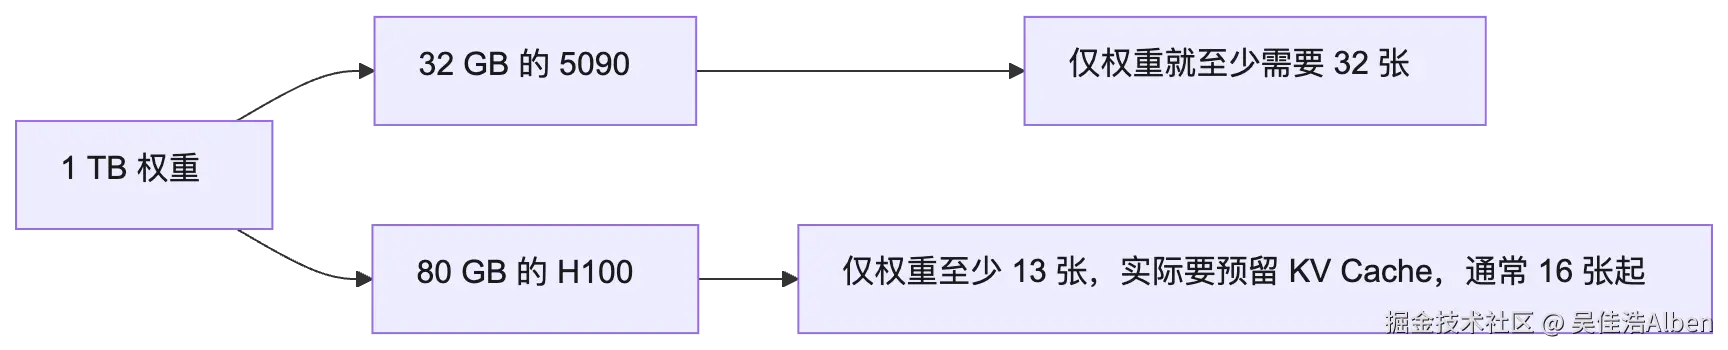
算一遍:
🔸 5090(32 GB):1000 ÷ 32 ≈ 31.25 → 至少 32 张 ,而且这还没算 KV Cache 和激活,实际远不止 🔸 H100(80 GB):1000 ÷ 80 = 12.5 → 至少 13 张 ,预留 KV Cache 后,工程上常按 16 张(两个 8 卡节点)规划
现实里 1T 参数量级的模型,比如 Kimi K2(总参数约 1T,激活约 32B),正是需要多卡甚至多节点才能部署。
此时 TP/PP/EP 不是「要不要用」的问题,而是不用就根本跑不起来。
所以不是云厂商「偏爱 TP」,是模型规模逼着他们必须把一个实例拆到多张卡上。 而一旦拆了,通信成本就必须想办法压低------这就是为什么 TP 通常被限制在同一个 NVLink 节点内。
🔸 六、真正的集群到底怎么摆
先说一个事实边界:OpenAI、Anthropic 等闭源厂商并不公开其具体并行配置,下面的架构是业界通行的抽象。可以查证的真实案例,来自公开技术报告(比如 DeepSeek-V3)。
6.1 DP 在外层,TP 在内层
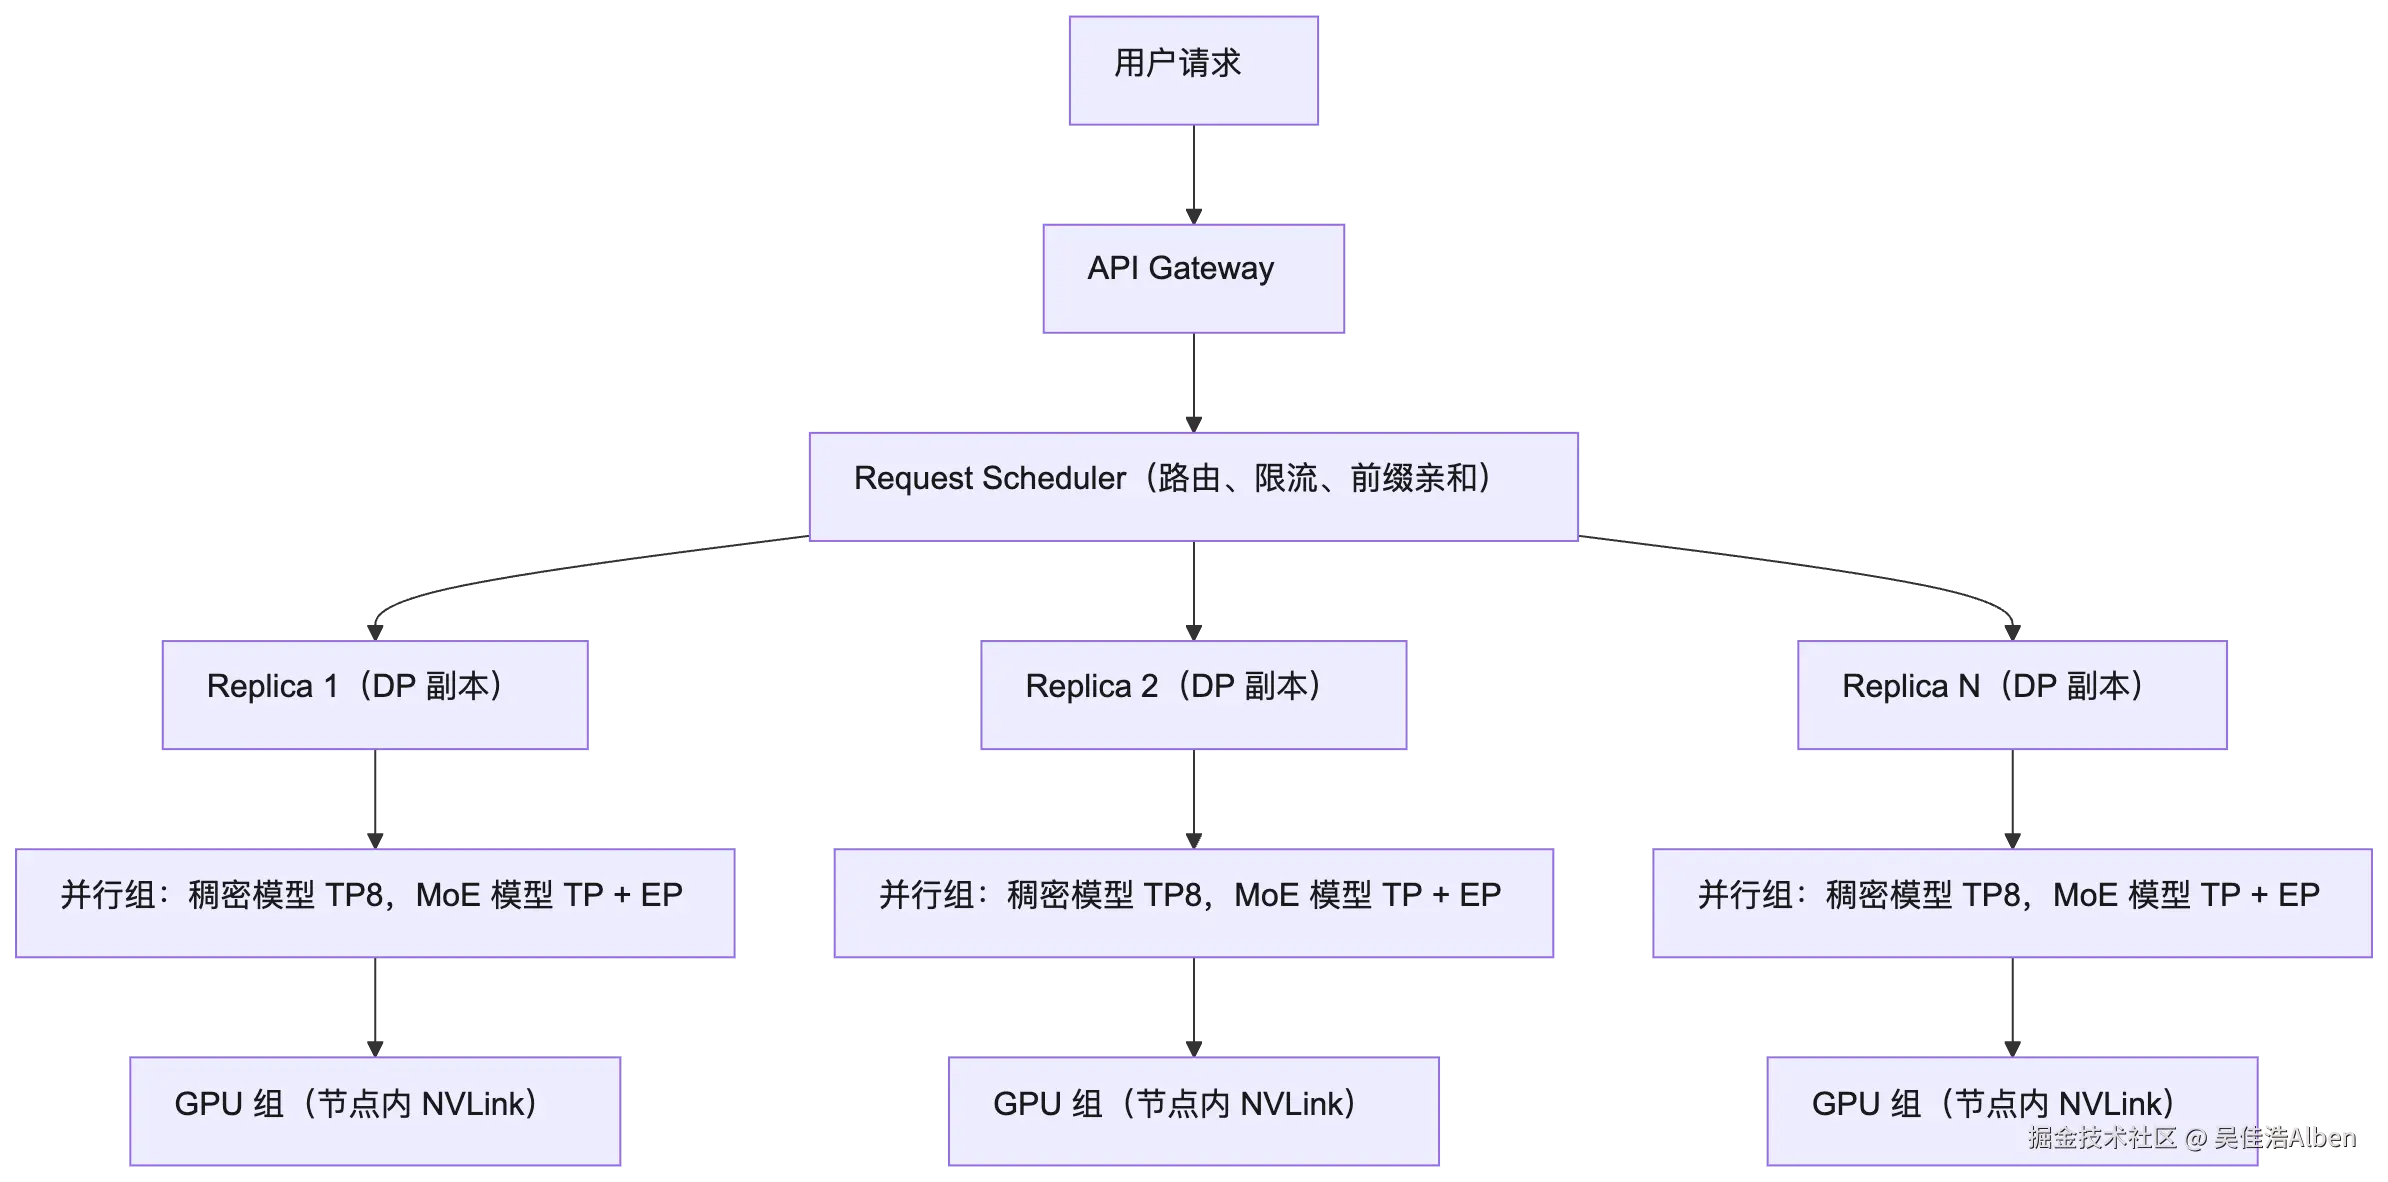
一句话读懂:DP 在外层,决定「有几个副本」;TP/EP 在内层,决定「每个副本由几张卡组成」。 每个副本内部的卡紧密协作、通信频繁;副本与副本之间互不通信。
业界常见模式是:节点内用 TP (有 NVLink,通信便宜),节点间用 DP 做多副本(节点间带宽低,副本之间不需要通信)。
用公式写就是:
text
总 GPU 数 = TP × DP (再叠加 PP、EP 时继续相乘)
例:TP8 × DP16 = 128 张 GPU,同时跑 16 个独立实例
(不会有「TP1024」这种配置:并行度越大,AllReduce 的参与方越多、跨节点越多,通信税越重,收益早早就被吃掉了。)
6.2 一个能查证的例子:DeepSeek-V3
DeepSeek-V3 技术报告披露了它的在线部署方案,把 Prefill 和 Decode 分开部署:

要点:
🔸 Prefill 最小部署单元为 4 个节点、32 张 GPU 🔸 Decode 最小部署单元为 40 个节点、320 张 GPU 🔸 注意力部分是 TP + DP 的组合,MoE 部分是 EP 🔸 Prefill 和 Decode 的并行策略不同,印证了前面说的「两个阶段瓶颈不同」
这里能看出集群真正在提升的是什么:
集群提升的是吞吐(单位时间服务多少请求、生成多少 token),而不是单个请求的速度。
一个请求在集群里,仍然是被一个实例顺序地生成 token。集群的「大」,体现在同时能并行服务多少个这样的请求。
🔸 七、除了 TP,还有哪几种多卡
7.1 DP:解决「更多用户」
训练里的 DP 是同步梯度,推理里的 DP 是复制模型。两者名字一样,工作完全不同。
训练里的 DP 要同步梯度,但推理里的 DP 就是多副本:每个副本拥有完整的模型(或完整的一个 TP/EP 组),独立处理自己的请求。
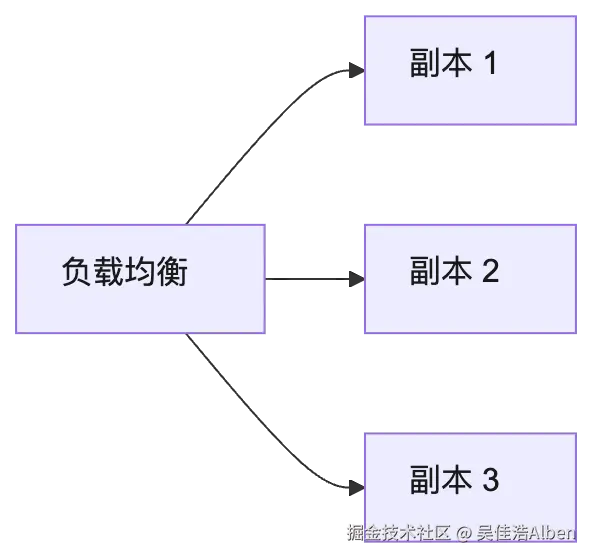
特点:几乎零通信,吞吐近似线性扩展,是最「便宜」的扩展方式。
还有一个进阶用法叫 DP Attention:对使用 MLA(Multi-head Latent Attention)的模型(如 DeepSeek 系列),KV Cache 很小且难以按头切分,若对注意力做 TP,KV 会被各卡重复保存。于是注意力部分改用 DP、MoE 部分用 EP,避免冗余。这正是上面 DeepSeek 方案里「DP8 / DP80」的由来。
7.2 EP:解决 MoE
MoE 模型的特点是:总参数很大,但每个 token 只激活一小部分专家。
以 DeepSeek-V3 为例:
🔸 总参数 671B 🔸 每个 token 只激活约 37B(约 5.5%) 🔸 每个 MoE 层有 256 个路由专家 + 1 个共享专家,每个 token 选 8 个路由专家
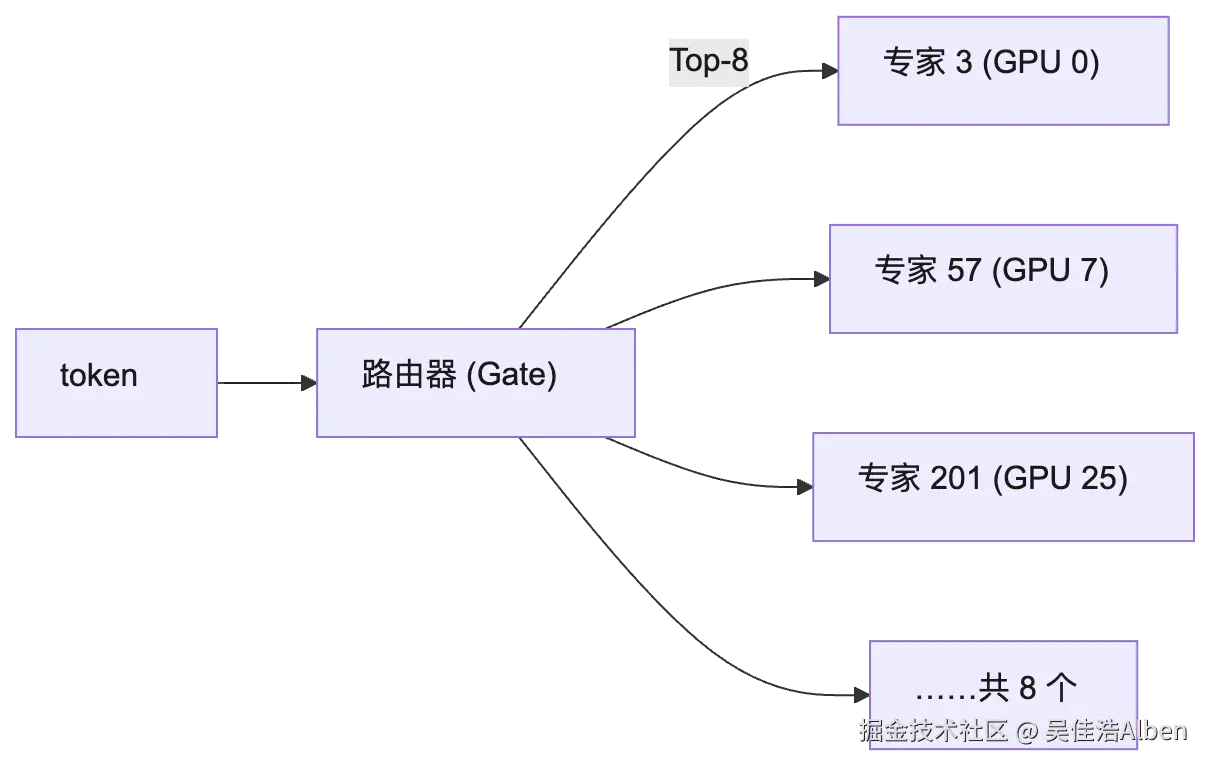
EP 把不同的专家放在不同的卡上,token 通过 All-to-All 通信被分发到对应专家所在的卡,算完再收回来。
EP 最大的收益,其实不是「把 671B 放下」,是提高权重复用(Weight Reuse)。
先算一笔账。DeepSeek-V3 每个 MoE 层 256 个路由专家、每个 token 选 8 个。假设一个副本的 Decode batch 是 64 个 token:
text
64 × 8 = 512 次专家选择,平摊到 256 个专家 → 平均每个专家只分到 2 个 token也就是说:GPU 把一个专家的权重从显存读出来,只服务 2 个 token,就结束了。读取成本被摊得很薄,效率极低。
EP 的做法是把很多个 DP 副本的 token 汇聚起来,通过 All-to-All 送到专家所在的卡:
text
全局 batch 6400 个 token → 6400 × 8 / 256 = 平均每个专家 200 个 token同样读一次专家权重,现在服务 200 个 token(上面是示意数字,实际取决于全局 batch 与负载均衡)。
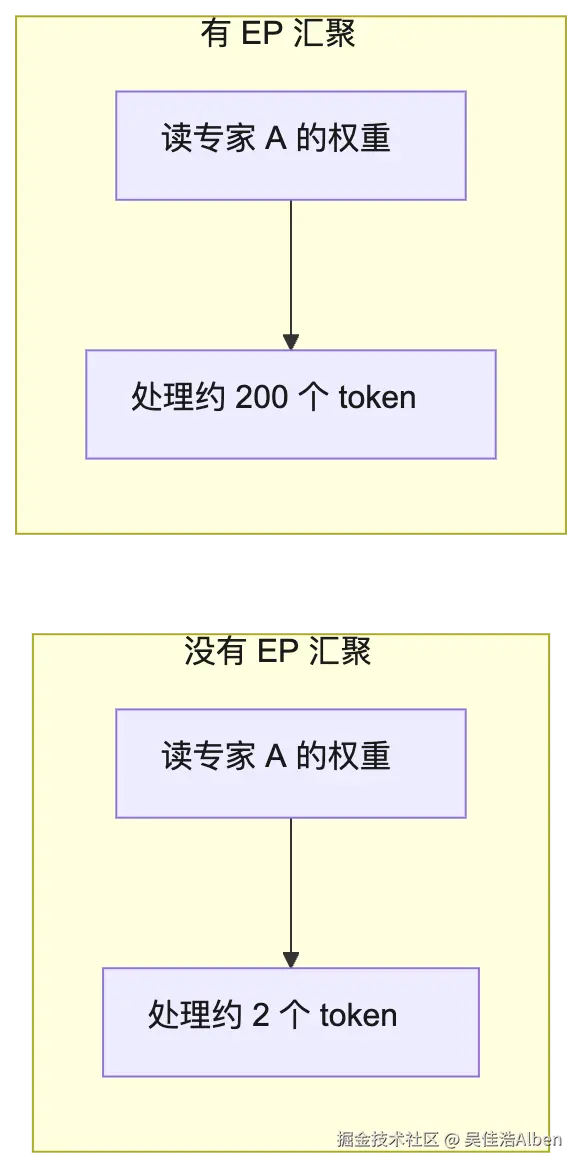
这也顺便纠正一个常见误解:「671B 模型每次只算 37B」说的是计算量;但 batch 一大,几乎所有专家都会被命中,需要读取的权重远不止 37B。 所以 MoE 想吃满 GPU,必须靠足够大的有效 batch,而 EP 正是把 batch 聚起来的手段。
🔸 好处:每张卡只放一部分专家,权重放得下;而且每个专家读一次权重就能服务一批 token,提高了单次权重读取的利用率 🔸 代价:All-to-All 通信量大,对互联带宽和延迟极其敏感,EP 规模大了就需要 RDMA/InfiniBand 以及通信与计算重叠等精细优化
7.3 PP:训练里多,推理里少
PP 把不同层放到不同的卡上,数据像流水线一样接力。

训练时有大量 micro-batch 可以填满流水线,气泡(bubble)占比小;但推理里的 Decode,每个请求一次只生成 1 个 token,且有严格的先后依赖,流水线很难填满,单请求延迟还会叠加各阶段的传输延迟。
所以 PP 在推理里主要用于跨节点、节点间带宽低、又必须把模型拆开的场景。比如 Llama-3.1-405B 在 BF16 精度下需要两个 8 卡节点,常见做法是节点内 TP8、节点间 PP2。
7.4 CP:解决长上下文
为什么长上下文流行之后,大家突然开始做 CP?一句话:
模型的权重没怎么变大,KV Cache 却随上下文线性增长。长上下文场景下,KV Cache 会先于权重,成为显存的主体。
对 Llama-3-8B 来说,权重约 16 GB,而 KV Cache 每 token 128 KB,所以大约在 12.8 万 token 处两者相等;超过之后,KV Cache 就比整个模型还大。(对 70B:权重约 140 GB,每 token 320 KB,临界点约 44 万 token。)
上下文越长,KV Cache 越大。看两个真实的量级:
| 模型 | KV Cache / token(BF16) | 128K 上下文 | 1M 上下文 |
|---|---|---|---|
| Llama-3-8B(32 层,8 KV 头,头维 128) | 128 KB | 约 16 GB | 约 128 GB |
| Llama-3-70B(80 层,8 KV 头,头维 128) | 320 KB | 约 40 GB | 约 320 GB |
把 70B 这一行算一遍:2 × 80 × 8 × 128 × 2 = 327,680 字节 ≈ 320 KB/token;128K = 131,072 token,约 40 GB(按 1 GB = 10⁹ 字节约 43 GB,按 GiB 约 40 GiB)。
可以看到:一个 1M 上下文的单个请求,KV Cache 就能超过单张卡甚至单个节点的显存。CP(如 Ring Attention 一类的方法)把序列维度切到多张卡,每张卡只保存和计算一段,通过环形传递 KV 块来完成完整的注意力。
7.5 混合并行:没有只靠 TP 的大模型
前面把各种并行拆开讲,是为了便于理解。真实的大规模部署几乎都是混合并行:不同的并行维度,被放在带宽不同的互联层级上。
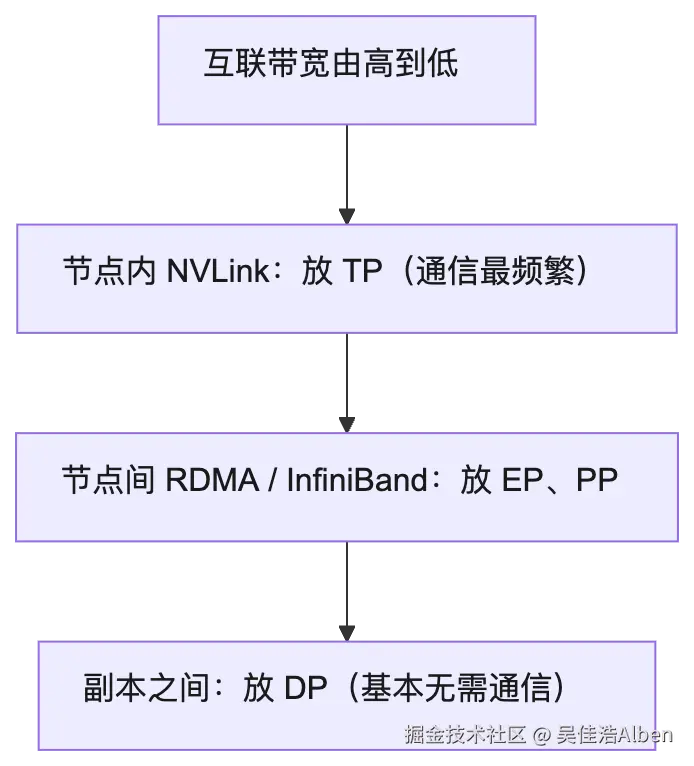
设计原则就一条:通信越频繁的并行维度,越要放在带宽越高的链路上。
两个可以核实的公开例子:
| 案例 | 并行组合 | 来源 |
|---|---|---|
| DeepSeek-V3 Decode 阶段 | Attention:TP4 + SP,配合 DP80;MoE:EP320;共 320 卡 | DeepSeek-V3 技术报告 |
| Llama-3.1-405B(BF16,两个 8 卡节点) | 节点内 TP8,节点间 PP2 | 业界常见做法,Meta 官方另提供 FP8 版本可放进单节点 |
公式化表示:
text
总 GPU 数 = TP × PP × DP         (稠密模型)
MoE 模型的 MoE 层用 EP 取代 TP,注意力层可继续用 TP 或 DP
至于 OpenAI、Anthropic、Google 等闭源厂商具体怎么组合,它们没有公开 ,不能下断言;但从公开的开源案例可以确定:规模一上去,单一并行策略就不够用了。
7.6 一张总表
| 技术 | 解决什么 | 切分对象 | 主要通信 | 推理是否常用 |
|---|---|---|---|---|
| TP | 单实例放不下 / 降延迟 | 每层权重 | AllReduce | ⭐⭐⭐⭐⭐ |
| DP | 请求太多 | 请求(模型多副本) | 基本无 | ⭐⭐⭐⭐⭐ |
| EP | MoE 专家太多 | 专家 | All-to-All | ⭐⭐⭐⭐⭐(MoE 模型) |
| PP | 跨节点拆分超深网络 | 层 | 点对点传激活 | ⭐⭐ |
| CP | 超长上下文 | 序列 | KV 环形传递 | ⭐⭐⭐ |
(星级是我的经验性判断,只用来说明相对常用程度,不是严格统计。)
🔸 八、真正决定性能的不是 TP
先看一张演进图。每一步都是在上一步之后,遇到新的瓶颈,再被新技术解决:
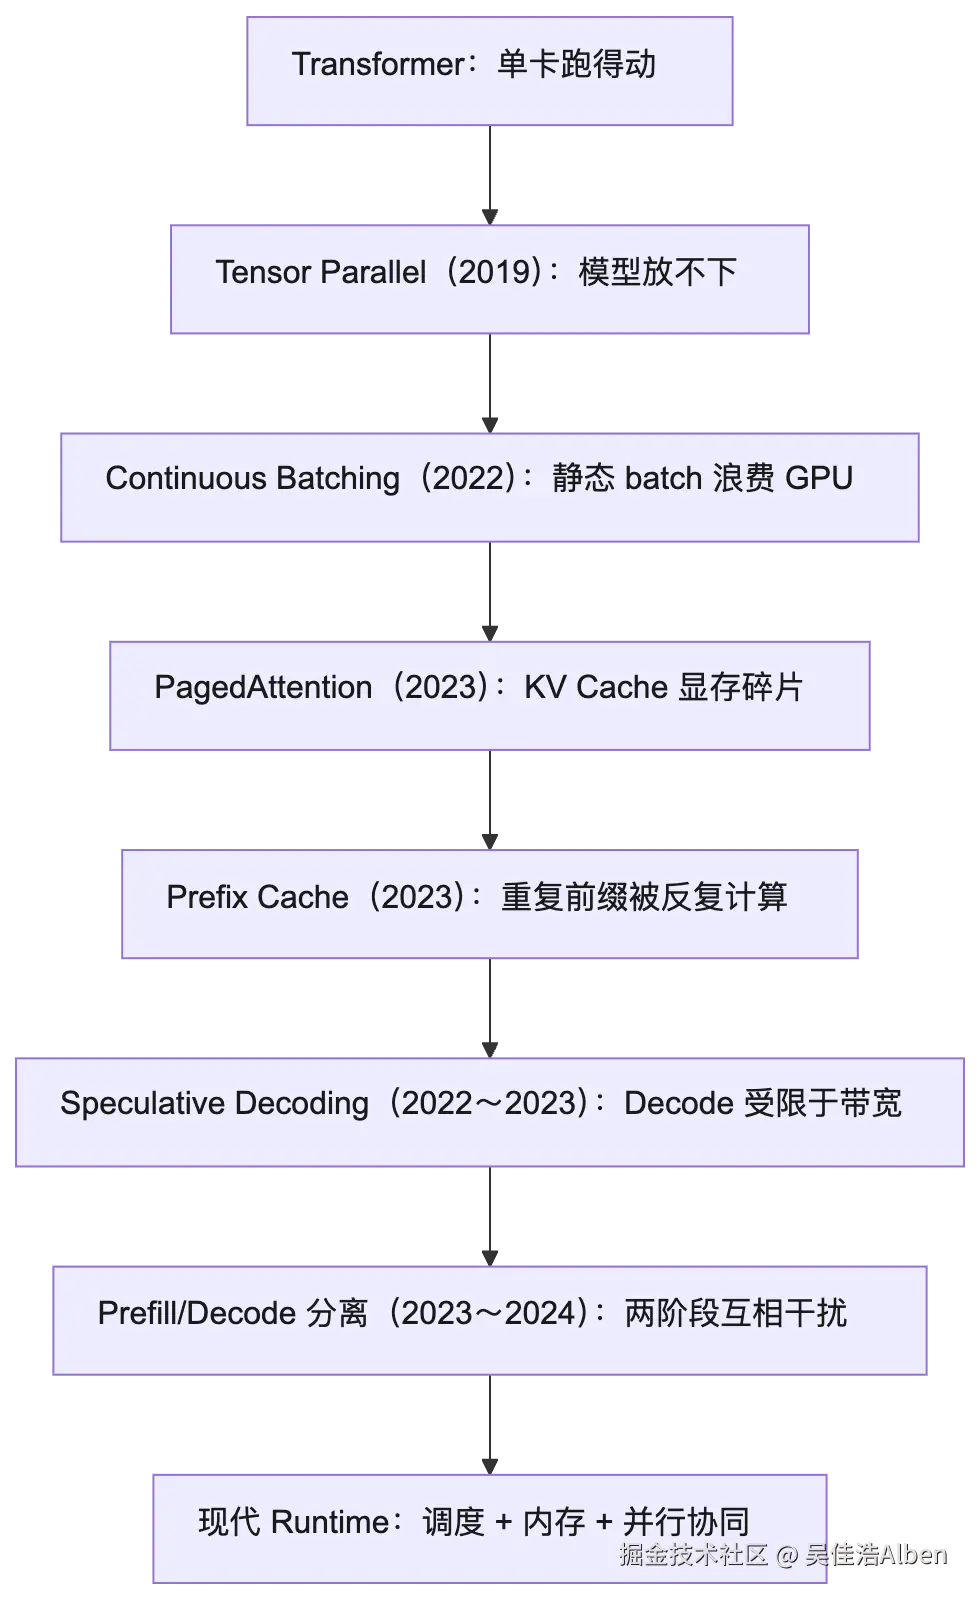
对应的真实里程碑:
| 时间 | 技术 | 代表工作 | 解决的瓶颈 |
|---|---|---|---|
| 2019 | Tensor Parallel | Megatron-LM | 单层权重放不下单卡 |
| 2022 | Continuous Batching | Orca(OSDI 2022) | 静态 batch 要等最慢的请求 |
| 2022~2023 | Speculative Decoding | Leviathan 等(2022)、Chen 等(2023) | Decode 的 Memory Bound |
| 2023 | PagedAttention | vLLM(SOSP 2023) | KV Cache 碎片与浪费 |
| 2023 | Prefix Cache(RadixAttention) | SGLang | 共享前缀重复计算 |
| 2023~2024 | Chunked Prefill | Sarathi-Serve | 长 Prefill 阻塞 Decode |
| 2023~2024 | Prefill/Decode 分离 | Splitwise、DistServe、Mooncake | 两阶段瓶颈不同、互相干扰 |
| 2024~2025 | 大规模 EP 与分离部署的工程化 | DeepSeek-V3 技术报告 | MoE 的通信与负载均衡 |
(年份是论文或技术报告的首次公开时间,同一技术在工业界的普及往往晚一两年。)
沿着这条线往下看,趋势是:瓶颈从「算力」,逐步转移到「显存带宽、KV Cache、通信、调度」。 下一步的方向(这是我的判断,不是定论)大概率是围绕 KV Cache 的分层存储与跨节点共享,Mooncake 等工作已经在这个方向上做了公开探索。
Runtime 技术速查
| 技术 | 解决什么问题 | 出处/代表 |
|---|---|---|
| Continuous Batching | 静态 batch 要等最慢的请求,GPU 空转 | Orca(OSDI 2022) |
| KV Cache 管理(PagedAttention) | 显存碎片,KV 浪费,限制并发 | vLLM(SOSP 2023) |
| Prefix Cache | 重复的 prompt 前缀被反复计算 | SGLang 的 RadixAttention 等 |
| Chunked Prefill | 长 prefill 阻塞 decode,造成卡顿 | Sarathi-Serve |
| Speculative Decoding | 把 Memory Bound 的 Decode 变成并行验证 | Leviathan 等,2022 |
| Disaggregated Prefill/Decode | 两个阶段瓶颈不同,互相干扰 | DistServe、Splitwise、Mooncake |
| Scheduler | 在吞吐、首 token 延迟、公平性间权衡 | 各引擎核心模块 |
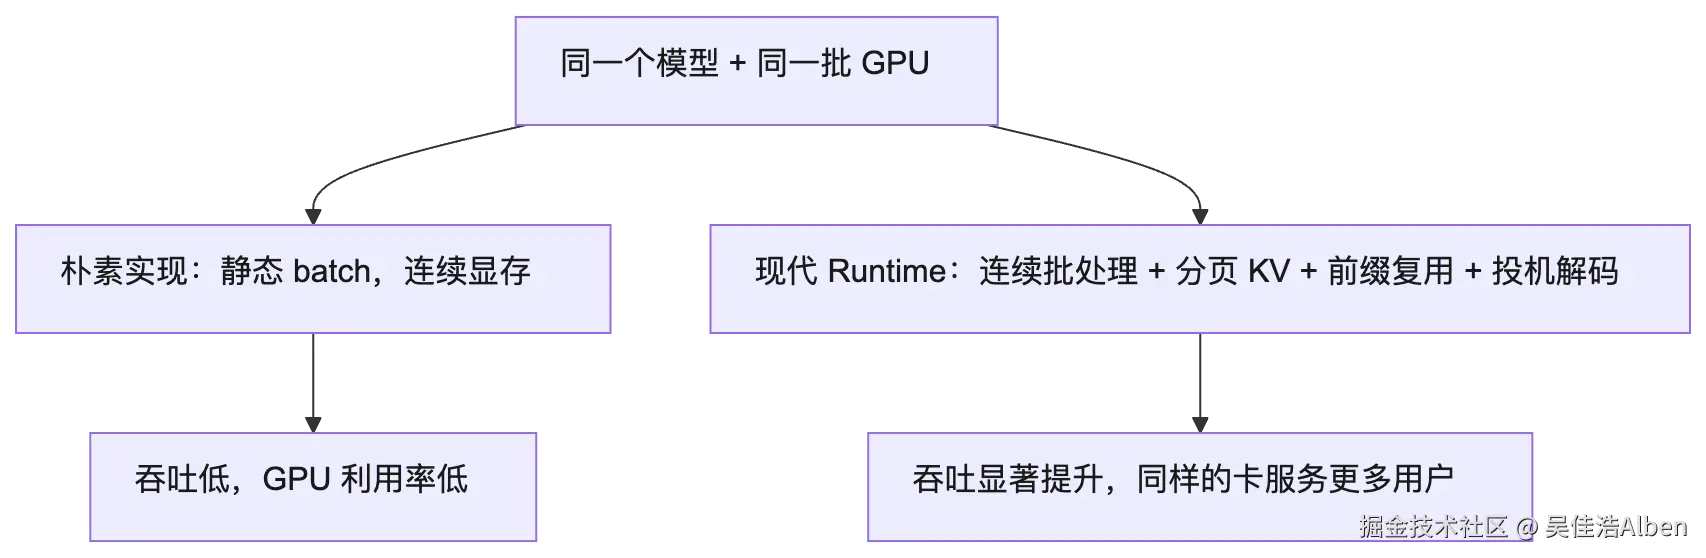
TP、DP、EP 只回答了一个问题:模型怎么摆到 GPU 上。 但「摆好了」之后,性能的差距主要来自 Runtime 在做的事。
举两个有代表性的数据(都来自论文自述,且与具体基线、负载、模型有关,应当看作「量级」而不是通用承诺):
🔸 vLLM 论文报告:相比当时的 FasterTransformer 和 Orca,在相近延迟下吞吐提升约 2~4 倍 🔸 Orca 论文报告:相对 FasterTransformer,在相近延迟下吞吐最高可达约 36.9 倍(GPT-3 175B 的特定设置)
这些提升,没有一项来自改动 Transformer 的结构,而是来自对「请求怎么进、KV 怎么放、GPU 怎么喂」的重新设计。
这也解释了为什么 vLLM、SGLang、TensorRT-LLM 等推理引擎竞争的焦点是 Runtime,而不是继续优化模型结构本身。
Runtime
Transformer 的主体结构这些年没有发生本质变化,真正越来越复杂的是 Runtime。
早期,GPU 的活很简单:把一个 batch 跑完。今天,Runtime 要同时负责:
text
Continuous Batching、PagedAttention、Prefix Cache、Chunked Prefill、
Speculative Decoding、KV 迁移与卸载、Scheduler、
TP / EP / PP / CP 的通信编排、RDMA 传输 ......
这和操作系统的职责高度同构。vLLM 论文本身就明确借用了操作系统虚拟内存与分页的思想:
| 操作系统 | 推理 Runtime |
|---|---|
| 进程调度 | Continuous Batching、Scheduler |
| 虚拟内存 / 分页 | PagedAttention |
| 页缓存 / 共享页 | Prefix Cache |
| 换入换出(Swap) | KV Cache 卸载到 CPU / 存储 |
| 进程间通信 | TP / EP 的集合通信、KV 迁移 |
Runtime 已经越来越像一个操作系统,而不是一个「推理框架」。
(这里讲的是职责的增长。关于代码行数,我没有可靠的公开数据,所以不做断言。)
🔸 九、一张图看懂整条链
这是全文的"毕业图"。从上到下,每一层都在做同一件事:减少数据移动,提升 GPU 利用率。
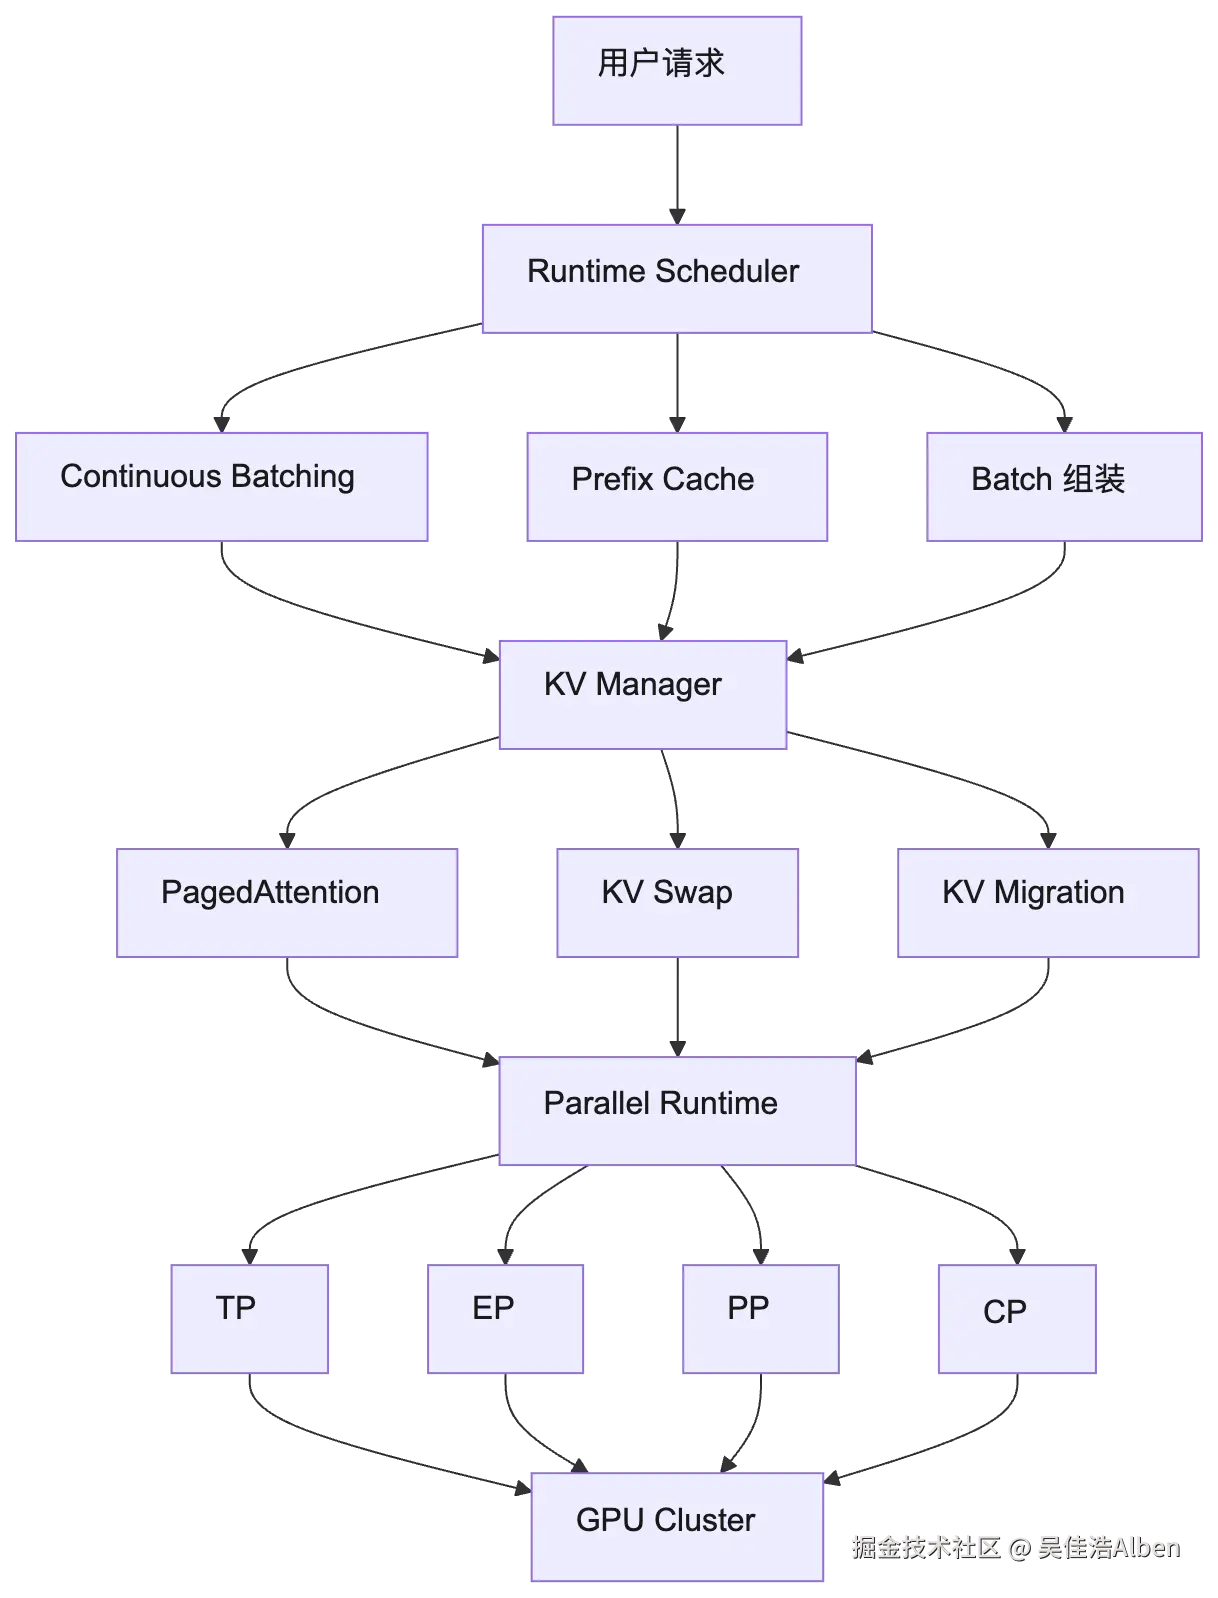
回到开篇的三个问题,现在可以逐个回答:
- 两张 5090 的 TP2 为什么没有 2 倍? 因为 Decode 受限于显存带宽,TP 只是让每卡少读一半权重,而每个 token 要付出 2 × 层数 次 AllReduce 的通信税;5090 之间还只能走 PCIe,没有 NVLink,通信税更重。
- 模型放得下为什么还要 TP? 多数时候不需要。除非你要更低延迟,或者需要合并出更大的 KV Cache 池;以吞吐为目标时,多副本 DP 通常更划算。
- 大模型集群是不是很多卡算一个请求? 不是。它是「每个实例用若干卡(TP/EP/PP)放下模型」,再用大量副本(DP)去服务大量请求。
说回你手上那几张卡。这一篇讲的都是「怎么摆」------摆的部分只决定你能不能跑起来;跑得值不值,取决于摆好之后 Runtime 在干什么:谁先进、KV 放哪、前缀有没有复用。 这几件事,是系列后面几篇要一层层拆开的东西,这一篇只负责把地基铺平。
过去,大模型竞争的是参数规模;今天,大模型竞争的是 Runtime。模型决定能力上限,而 Runtime 决定同样一套 GPU 能服务多少用户。
模型负责生成 Token,而 Runtime 决定每一个 Token 的成本。
如果你也在算「多卡到底怎么摆」这笔账,点个关注,《全栈架构师笔记》会接着把调度、KV 管理和分离部署一层层拆下去。
总结: 「多卡」不是一种:TP/PP/EP/CP 是把一个实例拆到多卡、用来「放得下」,DP 是把模型复制多份、用来「服务更多人」;Decode 受显存带宽约束,所以 TP2 省下的读取时间会被每层两次 AllReduce 的通信税吃掉大半,加速比通常只有一倍出头,换来的是更大的 KV Cache 池;真正决定同一套卡能服务多少用户的不是 TP,而是 Runtime 对请求、KV 和前缀的调度------这也解释了为什么 vLLM、SGLang、TensorRT-LLM 竞争的焦点在 Runtime,而不是模型结构本身。